
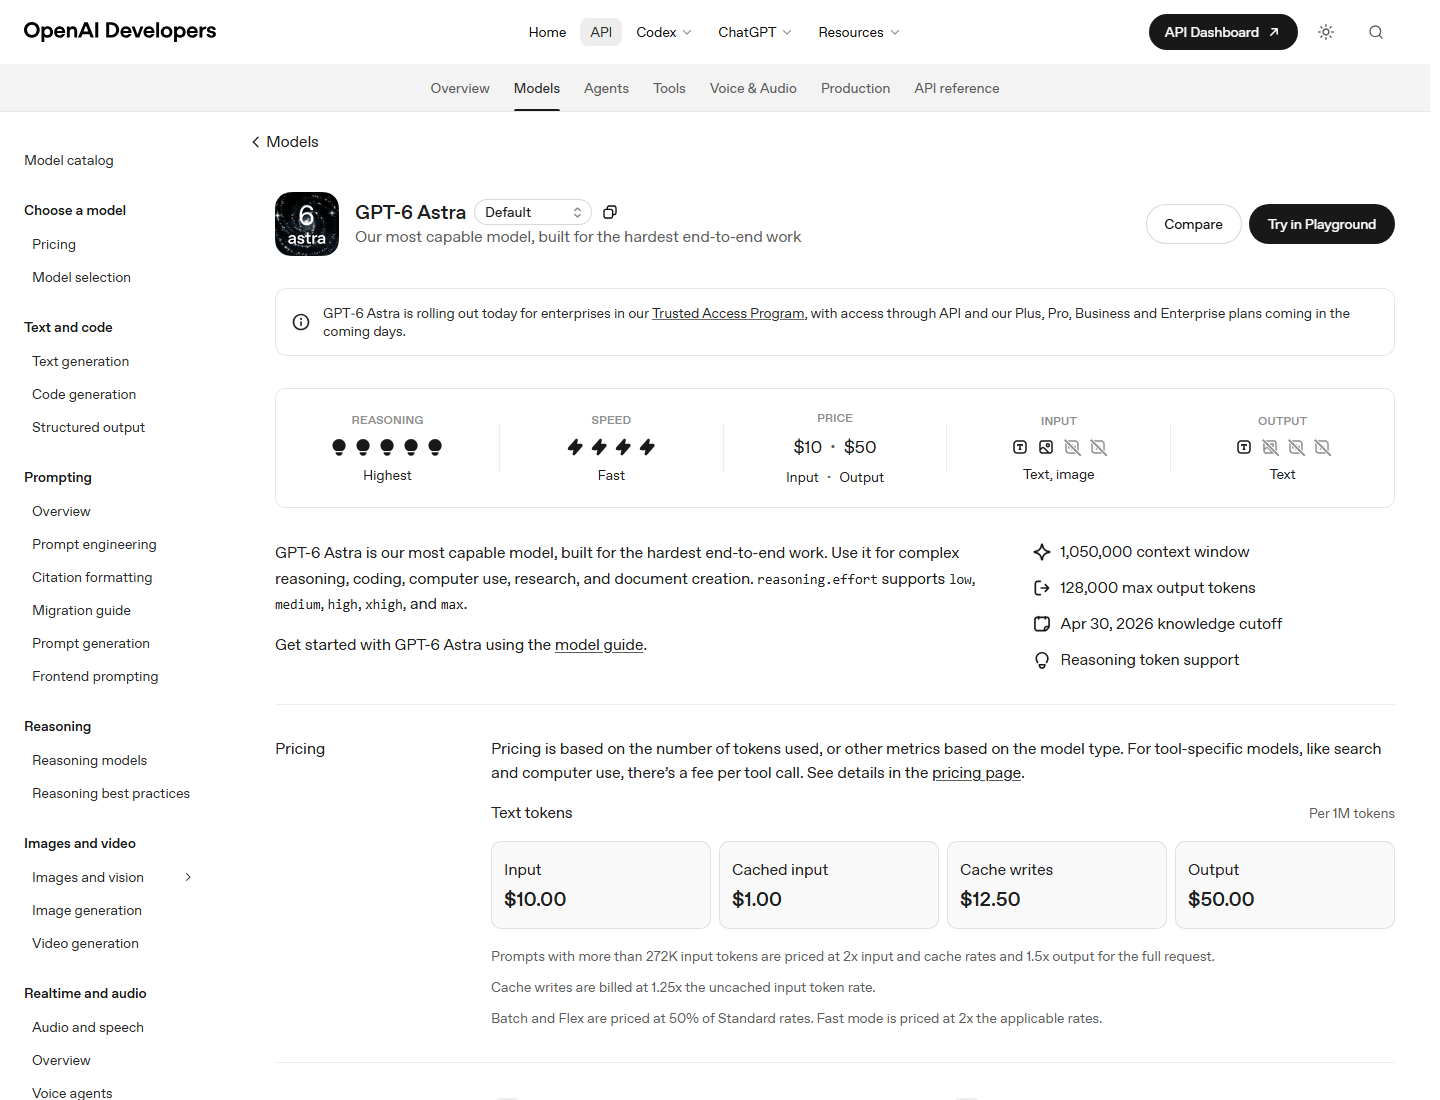
GPT-6.1 Sol correspond à la valeur par défaut ; GPT-6 Astra représente le niveau de qualité maximal. Les deux proposent la même fenêtre de contexte de 1 050 000 tokens, la même limite de sortie de 128 000 tokens, une entrée multimodale et un large éventail d’outils. La différence décisive réside dans le positionnement et le prix : Sol coûte $2 par million de tokens d’entrée et $10 par million de tokens de sortie, tandis qu’Astra coûte respectivement $10 et $50. En d’autres termes, Astra doit créer suffisamment de valeur ajoutée pour justifier un coût en jetons Standard cinq fois plus élevé.
Cela ne fait pas pour autant de Sol “ le même modèle à moindre coût ”. OpenAI qualifie Astra de modèle le plus performant pour les tâches les plus exigeantes de bout en bout et décrit Sol comme offrant des performances proches de celles d’Astra pour les tâches complexes, à un coût moindre. Le choix approprié relève donc d’une question d’évaluation, et non d’un simple classement des marques. Cette comparaison s’appuie sur les données actuelles Documentation de GPT-6.1 Sol, le Page du modèle GPT-6 Astra, ainsi que des scénarios de coûts identiques vérifiés le 9 octobre 2026.
GPT-6.1 Sol vs GPT-6 Astra : comparaison rapide
Le tableau facilite le premier choix : si vous ne disposez pas encore de données spécifiques à la tâche, Sol mérite d'être testé en premier, car il conserve les principales fonctionnalités d'interface et de capacité tout en réduisant considérablement le coût des jetons. Astra devient le choix rationnel lorsque la tâche est particulièrement difficile, que les conséquences d'une mauvaise réponse sont importantes, ou que son résultat plus fiable permet d'éviter plusieurs itérations de révision par un humain ou par le modèle.
Cela diffère d'une comparaison entre le Sol et un modèle compact et rapide. Selon les prévisions actuelles de la gamme établies par OpenAI, le Sol se situe parmi les meilleurs modèles, et non au bas de l'échelle des prix. Les lecteurs qui souhaitent choisir parmi l'ensemble de la gamme peuvent également utiliser notre Guide des meilleurs modèles d'IA et le Test du GPT-6 Luna pour savoir dans quels cas un modèle plus léger suffit.
Ce que partagent le GPT-6.1 Sol et le GPT-6 Astra
Les deux pages officielles des modèles présentent les mêmes caractéristiques : fenêtre de contexte, entrée maximale, sortie maximale et seuil de connaissance. Les deux acceptent du texte et des images et génèrent du texte. Aucune des deux ne mentionne l’audio ou la vidéo comme entrée ou sortie native du modèle. Elles partagent également les niveaux d’effort de raisonnement « faible », « moyen », « élevé », « très élevé » et « maximal », le niveau « moyen » étant celui par défaut. Cette symétrie simplifie les tests A/B, car une application peut maintenir la plupart des paramètres de requête constants tout en ne modifiant que l’identifiant du modèle.
Les deux modèles prennent en charge les sorties structurées, l'appel de fonctions, la recherche sur le Web, la recherche de fichiers, la génération d'images, l'interpréteur de code, le shell hébergé, l'application de correctifs, l'utilisation de l'ordinateur, le MCP, les compétences et la recherche d'outils. OpenAI répertorie l'appel d'outils via l'API Responses ; la fonctionnalité « Chat Completions » est disponible lorsque les outils ne sont pas impliqués. Le réglage fin n’est pris en charge sur aucune des deux pages de modèle. Il s’agit de déclarations de capacités, et non de promesses selon lesquelles les deux modèles choisiront des outils avec une précision identique.
Une fenêtre de contexte d’un million de tokens correspond à une capacité, et non à une autorisation d’ignorer la conception de la récupération. Les requêtes très longues sont plus coûteuses, plus difficiles à déboguer et soumises à la tarification applicable au-delà de 272 000 tokens d’entrée. Le fractionnement en blocs, la récupération, les résumés et la mise en cache des prompts restent essentiels. La même mise en garde s’applique au plafond de 128 000 tokens en sortie : il est généralement plus sûr de produire plusieurs artefacts vérifiables de petite taille plutôt qu’une seule réponse volumineuse.
Tarification : l'écart quintuple
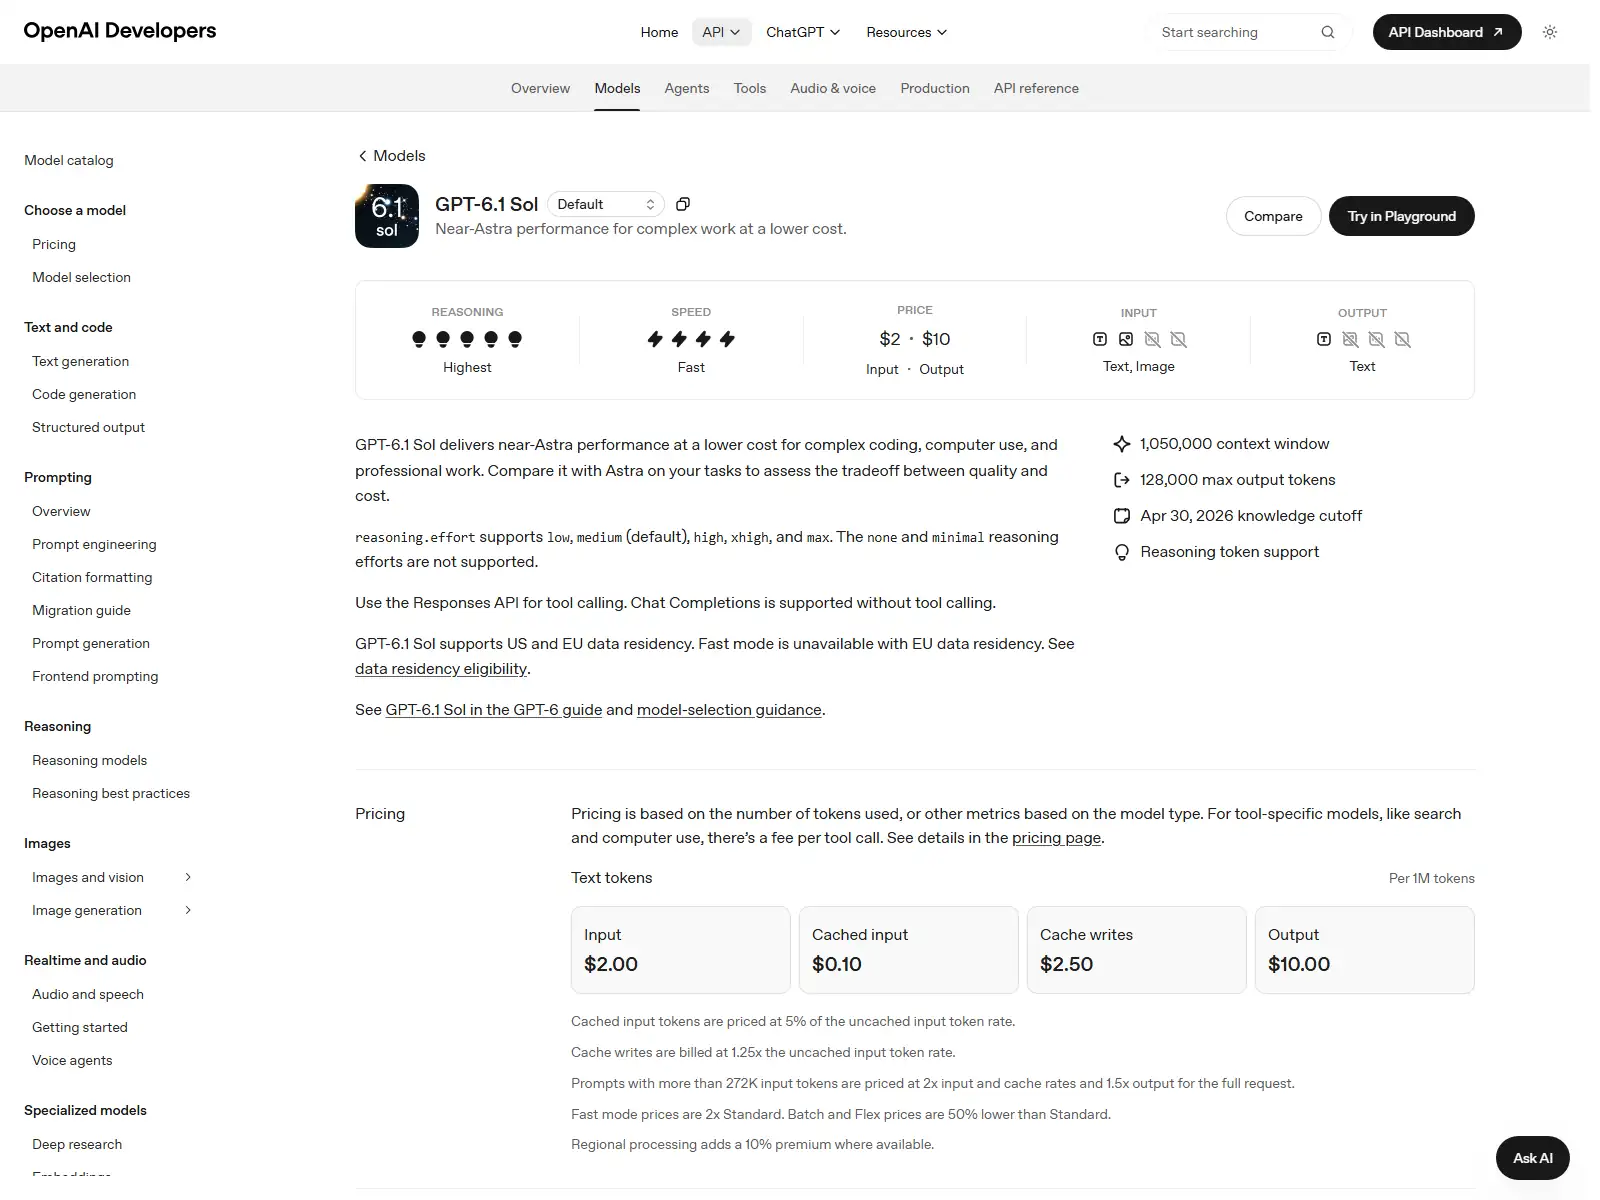
Aux tarifs standard, GPT-6.1 Sol coûte $2 par million de jetons d'entrée non mis en cache, $0,10 pour les entrées mises en cache, $2,50 pour les écritures dans le cache et $10 pour les sorties. GPT-6 Astra coûte respectivement $10, $1, $12,50 et $50. Sol est cinq fois moins cher pour les entrées non mises en cache, les écritures en cache et les sorties ; les entrées mises en cache sont dix fois moins chères. Les chiffres actuels proviennent directement des pages de présentation des modèles de OpenAI et Documentation sur la tarification de l'API.
Le tarif de base ne reflète pas le coût total. Dès qu’une requête dépasse 272 000 jetons d’entrée, le tarif OpenAI applique le double des taux normaux d’entrée et de mise en cache, ainsi que 1,5 fois le taux normal de sortie, à l’ensemble de la requête. Les tarifs « Batch » et « Flex » s’élèvent à 501 TP 40 T en Standard, tandis que le tarif « Fast » est le double du tarif applicable. Astra propose également un niveau « Ultrafast ». Comparez ce qui est comparable : une requête Sol « Batch » et une requête Astra « Fast » ne révèlent pas le rapport modèle-prix sous-jacent.
Pour une analyse plus détaillée de la gamme phare, consultez notre Guide des tarifs du GPT-6 Astra. Le précédent Analyse des prix du GPT-6 Sol Cela s'avère utile lors de la planification d'une migration depuis la génération précédente de Sol, mais les estimations de production doivent s'appuyer sur l'identifiant exact du modèle actuel et sur les taux en vigueur.
Conception à long terme : même capacité, dynamique économique différente
La fenêtre de contexte identique de 1 050 000 tokens peut donner l’impression que Sol et Astra sont interchangeables pour les tâches impliquant un volume important de documents, mais la capacité n’est que la première contrainte. Une requête proche de cette limite doit tout de même localiser les éléments pertinents, distinguer les instructions des passages cités, préserver les relations entre de nombreux fichiers et renvoyer un résultat qu’une personne ou un programme puisse vérifier. Le modèle au nom le plus imposant ne supprime pas la nécessité d’une architecture de l’information. Il faut organiser les sources, marquer les limites et exiger des citations renvoyant à des identifiants de documents stables.
Le tarif réduit de Sol rend économiquement viables les expériences à long terme. Une équipe peut tester plusieurs stratégies de regroupement, seuils de récupération et formats de résumé pour le coût d’une seule exécution d’Astra. Cette recherche plus large peut améliorer le système même si Astra l’emporte sur une seule requête. Astra s’avère plus intéressante une fois que le flux de travail est stabilisé et que les erreurs non résolues relèvent véritablement des limites du modèle. Au début du développement, consacrer l’intégralité du budget à quelques requêtes phares peut s’avérer moins enrichissant en termes d’apprentissage que de mener une évaluation rigoureuse avec Sol sur de nombreux cas représentatifs.
Le seuil des 272 000 tokens mérite une surveillance particulière. Une requête comportant 271 000 tokens et une autre en comptant 273 000 sont de taille similaire, mais la seconde fait passer l’intégralité de la requête dans la tranche tarifaire supérieure. Établissez une estimation préalable du nombre de tokens et notez la tranche de prix utilisée par chaque tâche. Si une entrée dépasse légèrement la limite, la suppression des passages répétitifs, de l’historique de conversation obsolète ou des extraits de faible valeur peut réduire considérablement le coût sans nuire à la qualité. Cette optimisation s’applique aux deux modèles, bien que les tarifs de base plus élevés d’Astra rendent les erreurs plus coûteuses.
La mise en cache rapide est particulièrement utile lorsqu’un préfixe volumineux reste stable d’un appel à l’autre. Citons par exemple les manuels de politiques, les normes de codage, un catalogue de produits ou un schéma d’outil partagé par de nombreuses tâches. Placez d’abord le contenu stable, puis les instructions variables, lorsque le comportement de mise en cache de l’API prend en charge cette structure. Mesurez ensuite les accès au cache plutôt que de les supposer. L’avantage lié aux entrées mises en cache de Sol est particulièrement important, mais un préfixe en constante évolution peut l’annuler. La conception de la mise en cache doit figurer dans le rapport de benchmark aux côtés de la précision et de la latence.
Pour la recherche et l’analyse de documents, adoptez un processus par étapes : récupérez les éléments probants potentiels, demandez au modèle une carte structurée des éléments probants, validez les citations, puis seulement ensuite demandez une synthèse. Utilisez Astra lorsque la synthèse reste insuffisante alors que le pipeline de preuves est solide, ou lorsque l’ensemble des sources contient des contradictions inhabituellement subtiles. Cela permet de distinguer les échecs de recherche des échecs de raisonnement. Sans cette distinction, les équipes finissent souvent par investir dans un modèle plus performant pour compenser un problème évitable de construction du contexte.
Codage et utilisation des outils
En matière de codage, la question pertinente n’est pas “ quel modèle est capable d’écrire du code ? ” Les deux en sont capables. La question est de savoir dans quels cas les capacités supplémentaires d’Astra modifient le résultat. Sol est particulièrement adapté aux tâches courantes liées au dépôt de code : implémentation de fonctionnalités limitées à un certain périmètre, diagnostic de bogues reproductibles, révision des pull requests, rédaction de tests, transformation de données et exécution de boucles d’outils itératives. Son coût réduit permet d’effectuer davantage de tentatives, de vérifications et d’utiliser des ensembles d’évaluation plus importants pour un budget identique.
Il vaut mieux réserver Astra aux tâches où l'ambiguïté et la coordination jouent un rôle prépondérant : une migration vers un monorepo peu familier, une revue d'architecture sensible en matière de sécurité, une utilisation informatique à long terme, un portage interlangage complexe ou un incident en production dont les éléments de preuve sont incomplets. Le modèle le plus performant peut valoir son prix lorsque un seul plan correct permet d'éviter des heures de travail supplémentaire. Notre Meilleur modèle d'IA pour la comparaison de codes explique pourquoi les tests de référentiels ont plus d'importance que les impressions générales sur le code.
- Fonctionnalités bien délimitées, accompagnées de tests d'acceptation clairs
- Débogage courant et révision du code
- Boucles d'agents à haut volume
- Projets de migration et de refactorisation
- Génération et documentation des tests
- Échecs définitifs après une tentative de « Sol »
- Modifications à haut risque en matière de sécurité ou de données
- Architecture intersystèmes ambiguë
- Tâches informatiques de longue durée nécessitant une autonomie
- Vérification finale lorsque les erreurs coûtent cher
Ne jugez aucun des deux modèles sur la base d’un code qui semble simplement plausible. Fournissez aux deux modèles le même instantané du référentiel, les mêmes instructions, les mêmes outils, le même temps alloué et les mêmes tests. Enregistrez le taux de réussite, les corrections humaines, les échecs des appels d’outils, le nombre de tokens, la latence et le coût. Un modèle qui coûte cinq fois plus cher mais qui réduit de moitié le nombre d’échecs peut se justifier ; un modèle qui améliore le style sans améliorer l’acceptation ne se justifie pas.
Données sur les performances : ce que l'on peut et ce que l'on ne peut pas en conclure
Le positionnement de OpenAI fournit l’argumentaire le plus solide : Astra est le modèle le plus performant pour les tâches de bout en bout les plus difficiles, tandis que GPT-6.1 Sol vise des performances proches de celles d’Astra sur des tâches complexes, à moindre coût. Ces affirmations viennent étayer une hypothèse de sélection, et non un écart en pourcentage universel. Aucun benchmark public ne peut à lui seul prédire les performances sur vos documents, outils, politiques ou base de code propriétaires.
Les vidéos de lancement sont utiles pour comprendre comment une entreprise présente un produit, mais elles ne constituent pas des évaluations indépendantes. De même, les avis des créateurs montrent des interfaces réelles et des exemples concrets, mais chaque avis reflète un ensemble de consignes, une configuration d’outils et une date limite de publication spécifiques. Considérez une vignette flatteuse ou un premier avis favorable comme un point de départ pour votre propre plan de test, et non comme la preuve qu'Astra ou Sol l'emporte dans toutes les catégories.
La vidéo officielle OpenAI ci-dessus retrace le lancement d’Astra. La page indépendante consacrée à Matt Wolfe ci-dessous montre que l’attention du public s’est rapidement portée sur l’ampleur de cette sortie. Aucune de ces deux captures d’écran n’est utilisée ici comme référence chiffrée. L’article évite délibérément de transformer l’enthousiasme, le nombre de vues ou le titre d’un créateur en un indicateur de performance non étayé.
Une comparaison pertinente repose sur un ensemble d'évaluation privé qui reflète l'environnement de production. Il convient d'y inclure des tâches simples, des tâches courantes et des cas d'échec coûteux. Masquez les résultats lorsque les préférences humaines entrent en ligne de compte. Pour les agents, testez la capacité à mener à bien une tâche et à se remettre d'un échec plutôt que la première réponse donnée. OpenAI’s conseils pour la sélection d'un modèle recommande également de comparer les modèles sur des tâches identiques et de retenir le modèle le plus léger et l'effort de raisonnement qui permettent d'atteindre le seuil de qualité requis.
Comment mener une évaluation équitable entre Sol et Astra
Commencez par définir la décision que l'évaluation devra prendre. “ Quel modèle est le plus performant ? ” est une question trop vague. Une question utile serait : “ Quel modèle devrait gérer les révisions des pull requests pour ce dépôt avec un niveau de raisonnement moyen ? ” ou “ La synthèse finale du contrat devrait-elle passer de Sol à Astra ? ” Définissez la famille de tâches, le niveau de service, l’effort de raisonnement, les outils, le délai et les critères d’acceptation avant de générer des résultats. Sinon, un résultat favorable pourrait s’expliquer par la configuration plutôt que par le modèle.
Constituez un ensemble suffisamment vaste pour inclure les cas courants et les cas limites significatifs. Vingt exemples soigneusement sélectionnés peuvent mettre en évidence des échecs évidents, mais une politique de routage en production nécessite généralement davantage. Prélevez des exemples tirés de travaux récents et concrets après avoir supprimé les données sensibles, puis classez chaque cas en fonction de sa difficulté et de son risque. Conservez un ensemble de test verrouillé afin que l’ajustement rapide ne conduise pas progressivement à un surapprentissage des exemples que tout le monde a déjà vus. Gérez les versions de l’ensemble de données et de l’évaluateur de la même manière que vous gérez les versions du code de l’application.
Privilégiez les vérifications déterministes chaque fois que la tâche le permet. Compilez le code, exécutez des tests, validez les fichiers JSON par rapport à un schéma, comparez les champs extraits avec les libellés et vérifiez les passages cités. Les évaluateurs humains doivent se concentrer sur les qualités que l’automatisation ne peut pas bien saisir, telles que la clarté, le jugement et la pertinence d’une recommandation par rapport au contexte métier. Masquez l’identité du modèle et randomisez l’ordre des résultats. Si les évaluateurs savent quelle réponse provient d’Astra, le prix et la réputation peuvent influencer la note sans que personne n’ait l’intention d’introduire de biais.
Suivez la gravité des problèmes, pas seulement les moyennes. Dix remarques mineures liées au style ne doivent pas l’emporter sur une recommandation critique concernant une perte de données. Définissez des critères de rejet catégorique, tels que les citations inventées, les commandes dangereuses, les champs obligatoires manquants ou le non-respect d’une contrainte légale. Présentez la répartition par catégorie de difficulté et de risque. Sol peut être à égalité avec Astra sur les tâches courantes et ne prendre du retard que sur les 5 % les plus difficiles ; ce résultat plaide fortement en faveur d’un routeur plutôt que d’une migration « tout ou rien ».
Enfin, calculez l’incertitude et relancez les cas instables. Les résultats des modèles pouvant varier, une comparaison ponctuelle surestime l’effet du hasard. Répétez l’opération sur un sous-ensemble, examinez les divergences entre les évaluateurs et conservez les résultats bruts à des fins d’audit. La recommandation finale doit mentionner la date du test, les identifiants des modèles, les paramètres, la version de l’ensemble de données, les prix utilisés et les lacunes connues. Réexaminez-la après une mise à jour du modèle, un changement de prompt ou une évolution significative de la charge de travail. Le choix d’un modèle est une décision opérationnelle qui nécessite une maintenance, et non un trophée définitif.
Ne laissez pas l’évaluateur devenir le modèle décisionnel caché. Si un juge automatisé privilégie nettement un résultat, sélectionnez un échantillon de ces décisions pour les soumettre à l’examen d’un expert et comparez le juge aux résultats d’acceptation concrets. Distinguez la qualité de la présentation de l’exactitude de la tâche : une explication soignée peut masquer une exigence non satisfaite, tandis qu’une réponse laconique peut passer tous les tests. Signalez également les abstentions et les ex aequo au lieu d’imposer un gagnant. Ces détails rendent le résultat moins spectaculaire, mais bien plus utile pour la budgétisation et l’acheminement. L’objectif est d’établir une règle de fonctionnement reproductible qu’un autre membre de l’équipe puisse examiner et reproduire. Enregistrez également les résultats rejetés ; les exemples d’échec expliquent souvent les limites de l’acheminement plus clairement qu’un tableau de notes moyennes.
Exemples de coûts réels
Prenons l'exemple d'une exécution d'un agent de codage avec 200 000 tokens d'entrée non mis en cache et 20 000 tokens de sortie. Le coût total s'élève à environ $0,60 : $0,40 pour l'entrée et $0,20 pour la sortie. Astra coûte environ $3,00 : $2,00 plus $1,00. Sur 10 000 exécutions, la différence s’élève à environ $24 000, hors frais d’outils, mise en cache, majorations régionales ou ajustements liés au niveau de service.
Considérons à présent une requête à long contexte comportant 300 000 tokens en entrée et 30 000 tokens en sortie. Le nombre de tokens en entrée dépassant 272 000, les tarifs les plus élevés s'appliquent à l'ensemble de la requête. Le taux d’entrée effectif de Sol devient $4 par million et le taux de sortie $15, ce qui donne environ $1,65. Pour Astra, le taux d’entrée est de $20 et le taux de sortie de $75, ce qui donne environ $8,25. Le rapport de cinq à un est maintenu, mais l’écart absolu s’accroît.
La mise en cache peut faire pencher davantage la balance en faveur de Sol, car son taux d’entrées mises en cache ne représente qu’un dixième de celui d’Astra. Cela a son importance pour les instructions système stables, les références répétées à grande échelle et la structure des agents. Cependant, les écritures en cache ont toujours un coût, et la modification du préfixe peut réduire la réutilisation. Il convient de se baser sur des journaux d’utilisation réels plutôt que de supposer que chaque token bénéficiera du taux de mise en cache.
Comment comparer les modèles dans l'API
Utilisez l'API Responses pour les applications utilisant des outils et veillez à ce que la configuration de comparaison reste identique. Le cadre de test le plus simple et le plus utile consiste à envoyer la même entrée aux deux identifiants de modèle, à enregistrer les métadonnées de réponse et à exécuter le même évaluateur. Ne divulguez pas les clés API dans le code source ; utilisez plutôt une variable d'environnement et votre gestionnaire de secrets habituel.
L'échantillon est volontairement restreint. Un harnais de production doit enregistrer les identifiants de requête, les versions de l'évaluateur, les commits du référentiel, les traces des outils, le nombre de tentatives et les résultats d'acceptation. Il doit également calculer le prix en fonction du niveau de service et de la bande de contexte longue effectivement utilisés. Évitez qu'un modèle ait accès à des retours d'information que l'autre n'a pas reçus, sauf si vous testez explicitement une séquence de routage.
Une stratégie pratique d'acheminement de Sol vers Astra
Un routeur à deux niveaux met en avant l'argument économique le plus convaincant en faveur de Sol, sans prétendre que toutes les requêtes se valent. Acheminez le trafic normal vers Sol avec un niveau de raisonnement moyen. Recourez à l’escalade lorsque les tests déterministes échouent, que le modèle signale un faible niveau de confiance, que la tâche correspond à une catégorie à haut risque ou qu’un humain demande explicitement une révision par un expert. Veillez à ce que les règles d’escalade restent transparentes afin que les coûts ne dérivent pas de manière imperceptible.
Utilisez la même consigne, les mêmes outils et les mêmes tests d'acceptation.
Tests, niveau de confiance, classe de risque et vérification humaine.
Transmettez à Astra les échecs ou les tâches à haut risque.
Suivre l'acceptation, les retouches, les délais et le coût total.
Le routage offre également aux équipes un moyen contrôlé de mettre à jour les valeurs par défaut. Si le taux d’acceptation de Sol s’améliore pour une famille de tâches, augmentez sa part. Si Astra évite de manière répétée des défauts coûteux, acheminez directement cette catégorie. La comparaison devient alors une politique opérationnelle étayée par des données, plutôt qu’un simple débat ponctuel sur le modèle. Pour une référence à une génération antérieure, voir GPT-6 Astra contre GPT-5.6 Sol.
La latence et la fiabilité relèvent de la même politique de routage. Un modèle peut fournir une réponse plus pertinente tout en constituant un mauvais choix par défaut si son temps de réponse perturbe un flux de travail interactif ou si la longueur de son raisonnement entraîne des délais d’exécution dépassés. Mesurez la latence du premier jeton, la durée totale, la récupération après un appel d’outil et le taux de réussite dans des conditions de concurrence réalistes. Définissez ensuite un objectif de service pour chaque classe de tâches. Sol peut prendre en charge le trafic de production sensible au temps tandis qu’Astra gère la révision asynchrone ; l’inverse peut se justifier si une tâche difficile échoue systématiquement avant d’être transmise à un niveau supérieur. La décision du modèle est opérationnelle, et non simplement éditoriale.
Qui devrait opter pour Sol, et qui devrait opter pour Astra ?
Optez pour GPT-6.1 Sol pour une production maîtrisant les coûts
Sol convient aux équipes produit, aux agences, aux chercheurs et aux développeurs qui gèrent des volumes importants de tâches complexes tout en disposant de critères d'acceptation mesurables. Il s’avère particulièrement intéressant lorsque le processus comporte des itérations : boucles « code-test-correction », révision de documents, extraction avec validation, synthèse de recherches et agents internes en plusieurs étapes. Son prix plus abordable permet d’étendre la couverture des évaluations et d’augmenter le budget alloué aux nouvelles tentatives.
Optez pour le GPT-6 Astra pour les tâches les plus exigeantes en matière de qualité
Astra convient aux équipes dont les tâches les plus complexes entraînent des coûts d'erreur élevés ou pour lesquelles les contrôles automatisés sont insuffisants. Une décision architecturale difficile, une revue finale de sécurité, une tâche de raisonnement scientifique novatrice ou une longue séquence d'utilisation de l'ordinateur peuvent justifier l'achat du modèle phare. C'est également le choix par défaut le plus judicieux au début de la phase de découverte, lorsque l'équipe ne sait pas encore ce qu'un modèle plus petit ne parvient pas à détecter et que le coût ne constitue pas une contrainte immédiate.
Utilisez les deux lorsque le niveau de difficulté des tâches varie
La plupart des systèmes bien rodés ne devraient pas imposer un seul modèle à chaque requête. Utilisez Sol pour la partie centrale, qui couvre un large éventail de cas, et Astra comme couche d’escalade. Ajoutez Luna ou un autre modèle plus petit pour la classification et la transformation prévisibles. Cette architecture à plusieurs niveaux reflète la diversité réelle des charges de travail et s’avère généralement plus économique que de chercher à désigner un seul modèle gagnant définitif. Notre méthodologie de test des modèles offre un cadre utile pour distinguer les données vérifiables des simples impressions.
Comment utiliser GPT-6.1 Sol et GPT-6 Astra sur GlobalGPT
GlobalGPT propose des parcours de développement en temps réel pour les deux modèles au sein d’un même espace de travail multimodèle. Ouvrez l’espace de travail, lancez une nouvelle conversation et sélectionnez le modèle GPT-6.1 Sol ou GPT-6 Astra dans le sélecteur de modèles actuel. Le fait de regrouper les deux modèles dans une seule interface est utile pour effectuer des travaux d’exploration en parallèle, tandis que l’évaluation via l’API reste la meilleure solution pour l’évaluation automatisée, la capture précise de l’utilisation et les contrôles de déploiement.
Commencez par Sol pour le premier passage, puis relancez la requête la plus difficile avec Astra et comparez les changements concrets observés.
Ouvert GlobalGPTPour en savoir plus sur les spécificités de chaque modèle, consultez notre Guide explicatif sur GPT-6.1 Sol et Test de l'Astra GPT-6. Ces pages présentent chaque modèle séparément ; cette page porte quant à elle sur le choix entre ces différents modèles en termes d'achat et d'acheminement.
Questions fréquemment posées
Le GPT-6.1 Sol est-il meilleur que le GPT-6 Astra ?
Pas en termes absolus. OpenAI positionne GPT-6 Astra comme son modèle le plus performant et GPT-6.1 Sol comme un modèle moins coûteux offrant des performances proches de celles d’Astra pour les tâches complexes. Sol représente le meilleur rapport qualité-prix lorsqu’il répond à vos exigences en matière de qualité ; Astra est le choix le plus sûr, axé sur la qualité, pour les tâches les plus difficiles.
Dans quelle mesure le GPT-6.1 Sol est-il moins cher que le GPT-6 Astra ?
Aux tarifs standard, Sol coûte $2 par million de jetons d'entrée et $10 par million de jetons de sortie, contre $10 et $50 pour Astra. Sol est donc cinq fois moins cher pour les entrées et sorties non mises en cache. Son prix de $0,10 pour les entrées mises en cache représente un dixième du tarif de $1 pratiqué par Astra.
Est-ce que GPT-6.1 Sol et GPT-6 Astra ont la même fenêtre de contexte ?
Oui. Le document OpenAI indique une fenêtre de contexte de 1 050 000 tokens, une entrée maximale de 922 000 tokens et une sortie maximale de 128 000 tokens pour les deux modèles. Les requêtes comportant plus de 272 000 tokens en entrée sont traitées intégralement selon des tarifs applicables aux contextes longs.
Quel modèle est le mieux adapté au codage ?
Astra est le choix idéal, axé sur la qualité, pour les tâches liées aux dépôts particulièrement complexes, ambiguës ou à haut risque. Sol est la solution par défaut la plus pratique pour les tâches courantes liées aux fonctionnalités, le débogage, les revues de code et les boucles d'agents, car son coût réduit permet de réaliser davantage d'itérations. Testez les deux sur les mêmes tests de dépôt avant de choisir une solution standard.
Ces deux modèles prennent-ils en charge les outils et la saisie d'images ?
Oui. Leurs pages officielles consacrées aux modèles mentionnent la saisie de texte et d'images, la sortie de texte, les sorties structurées, l'appel de fonctions, la recherche sur le Web, la recherche de fichiers, l'interpréteur de code, le shell hébergé, l'application de correctifs, l'utilisation d'un ordinateur, le MCP, les compétences et la recherche d'outils. L'appel d'outils doit s'effectuer via l'API Responses.
Quand dois-je payer pour GPT-6 Astra ?
Utilisez Astra lorsqu'une erreur a un coût élevé, que la tâche relève véritablement de l'avant-garde ou qu'une évaluation comparative montre que sa qualité supérieure réduit suffisamment les retouches pour justifier un coût cinq fois supérieur à celui d'un jeton. Parmi les exemples, on peut citer les migrations critiques, l'utilisation complexe de systèmes informatiques autonomes et la révision finale de livrables à enjeux élevés.
Quelle méthode de raisonnement dois-je choisir ?
Commencez par un niveau moyen, qui est la valeur par défaut indiquée pour les deux modèles. Réduisez ce niveau pour les transformations simples et augmentez-le uniquement lorsque la difficulté de la tâche ou le coût des erreurs l'exige. Le réglage optimal est celui qui, avec le moins d'effort possible, permet de réussir systématiquement vos tests d'acceptation.
Puis-je utiliser GPT-6.1 Sol et GPT-6 Astra sur GlobalGPT ?
GlobalGPT propose des routes actives pour les modèles GPT-6.1 Sol et GPT-6 Astra dans son espace de travail multimodèle. La disponibilité peut varier selon les comptes et les interfaces ; veillez donc à ouvrir l'espace de travail et à vérifier le sélecteur de modèles actuel avant de lancer un workflow de production.
Dois-je acheminer toutes les requêtes vers un seul modèle ?
En général, non. Un routeur simple peut envoyer les tâches courantes à Sol et transférer à Astra les cas présentant un faible niveau de confiance, ayant échoué aux tests ou présentant un risque élevé. Cela permet de tirer parti de la majeure partie de l'avantage en termes de coûts offert par Sol, tout en réservant Astra aux demandes pour lesquelles sa capacité marginale apporte une valeur mesurable.
Verdict final
Le modèle GPT-6.1 Sol devrait être le premier à être évalué par les équipes les plus soucieuses des coûts ; le modèle GPT-6 Astra devrait quant à lui rester la solution de référence pour les tâches les plus complexes. Leur contexte commun, leur limite de production, leurs modalités, leurs contrôles de raisonnement et leur catalogue d'outils rendent la comparaison particulièrement claire. Sol offre l'avantage économique. Astra détient l'avantage officiel en termes de capacités.
Le critère déterminant n’est pas uniquement le prix du jeton ou le prestige du modèle. Évaluez le coût par résultat accepté dans le cadre de contraintes opérationnelles et de budgets réels. Si Sol affiche un taux de réussite similaire, ses débits d’entrée et de sortie non mis en cache, cinq fois inférieurs, sont difficiles à ignorer. Si Astra évite les échecs, réduit le recours à l’examen par des experts ou résout des tâches que Sol ne peut pas accomplir, ce surcoût peut se justifier. Commencez par des tâches identiques, procédez à une évaluation en aveugle dans la mesure du possible, et ne mettez en avant que le modèle et le raisonnement qui méritent leur place.









