
Claude Fable 5.2 vs Opus 5.5 : codage, coût et choix
Cinq tâches avec les mêmes invites comparent Claude Fable 5.2 et Opus 5.5 sur la recherche, la conception d'interface IA, l'écriture, les données et la planification de produit, avec des captures d'écran originales et l'utilisation enregistrée du temps et des jetons.
 Chloe Murphy

Opus 5.5 est le point de départ judicieux pour le travail courant ; testez Fable 5.2 lorsqu'une tâche spécifique doit encore être améliorée. Dans nos quatre paires de tâches textuelles terminées, les deux modèles ont correctement réalisé le calcul de recherche central et les métriques de données. Le plan produit de Fable a traité une incertitude avec plus de soin ; les deux productions écrites respectaient les principales contraintes.
La comparaison de conception utilise un nouvel essai apparié de 32 768 jetons. Ses captures d'écran, vérifications d'interaction et limites figurent dans la tâche de conception ci-dessous.
Fable 5.2 est plus récent et coûte plus cher par jeton. Mais donne-t-il un meilleur résultat, ou simplement une facture plus élevée ? Nous avons comparé la recherche, la conception d'interface IA, la rédaction, l'analyse de données et les décisions produit en utilisant le même brief de tâche pour chaque modèle.
Si vous préférez comparer des modèles sans gérer des configurations API distinctes, GlobalGPT propose un espace de travail multi-modèles. Les tests API présentés ici n'établissent pas la disponibilité de Fable 5.2 dans GlobalGPT.
La comparaison pratique
| Décision | Fable 5.2 | Opus 5.5 |
|---|---|---|
| Entrée / sortie standard par million de jetons | $8 / $40 | $4 / $20 |
| Test de recherche | Calcul correct ; formulation causale à retravailler | Calcul correct ; détail de conception d'étude non étayé |
| Test de contenu | Explication de 180 mots ; voix off plus courte | Explication de 180 mots ; exemple plus complet |
| Test de données | Tous les indicateurs demandés sont corrects | Tous les indicateurs demandés sont corrects |
| Test de produit | Distinction soigneuse entre dommage confirmé et dommage possible | Plan utile ; affirmation non étayée de travail perdu |
| Tentative de conception originale | Aucun artefact : échec HTTP | HTML complet après nettoyage des blocs de code |
Comment nous avons testé les deux modèles
Chaque tâche a utilisé un matériel source identique, une nouvelle conversation et la même limite de sortie pour les deux modèles. Les tâches de texte ont utilisé un plafond de 16 000 jetons ; l'exécution de conception finale a utilisé 32 768. Les invites, les paramètres, le temps et l'utilisation apparaissent avec la tâche correspondante ci-dessous.
Toutes les études, produits, données de commande et retours dans les briefs étaient des fixtures de test fictives. Nous avons vérifié les calculs par rapport à une clé de réponse préparée. L'effort de raisonnement est resté au niveau par défaut de la plateforme, ce n'est donc pas un benchmark à effort égal. Les étiquettes de modèle renvoyées par la passerelle tierce n'établissent pas indépendamment le routage en amont.
Chercheur : synthèse sans surestimer les preuves
Même invite · Test du chercheur
You are a researcher. Use only these FICTIONAL study summaries about an AI writing assistant. A: randomized 120 adults, 60 per arm, intervention mean score baseline70 followup78, control baseline69 followup74, four weeks; no standard deviations, uncertainty intervals, or attrition information reported. B: observational 300 adults, usage correlated with writing scores r=.32, no confounder adjustment. C: interviews with12 users reporting perceived improvement. In under650 words synthesize evidence with A/B/C citations, calculate difference in changes, explain what cannot be inferred, and propose a feasible preregistered followup study with primary endpoint and analysis. Do not invent citations or statistical significance.
La tâche du chercheur demandait une synthèse de trois études fictives, dont un essai randomisé avec rapport incomplet. Le calcul essentiel était (78 − 70) − (74 − 69) = 3 points. Les deux modèles ont bien répondu et ont refusé d'inventer une signification statistique.
Fable 5.2
A proposé une évaluation d'écriture en aveugle et sans assistance, une analyse en intention de traiter et des contrôles de sensibilité aux données manquantes. Il a également fourni un exemple explicitement hypothétique de taille d'échantillon.
« Seule la différence de 3 points est attribuable à l'assistant »
Cette formulation était trop confiante compte tenu de l'attrition inconnue et des lacunes dans les rapports, même si les paragraphes ultérieurs nuançaient l'estimation. Il a également spéculé que les participants aux entretiens étaient probablement autosélectionnés.
Opus 5.5
A clairement séparé les preuves randomisées, observationnelles et d'entretien. Il a proposé un essai ajusté à la ligne de base et a maintenu le calcul de la taille de l'échantillon dépendant de la variabilité pilote.
« de nature transversale comme décrit »
Le résumé observationnel fourni ne précisait pas de conception transversale. Ce détail aurait dû rester inconnu.
Si vous adaptez ce brief, gardez les preuves fixes et demandez à chaque modèle de séparer les faits rapportés des inférences. Nos Invites Claude pour la recherche et le codage offrent plus d'exemples de contraintes spécifiques à la tâche.
Designer : un espace de travail multi-modèles IA
Même prompt · Test Designer
You are a product designer and frontend builder. Return only one complete self-contained HTML file with inline CSS and JavaScript, no external assets/CDNs. Build a polished AI multi-model workspace called Parallel. Give it a distinctive cohesive visual identity with excellent typography, whitespace, hierarchy and responsive layout; choose your own palette. Include sidebar, model A/B selectors, prompt textarea, compare button, two side-by-side result cards, loading state, clear button, per-result copy button, empty-input validation, keyboard-accessible controls and mobile stacking. Models A/B are FICTIONAL; all outputs must be locally simulated and explicitly labeled demo. No real API calls or fake live performance metrics. Compare must work repeatedly and preserve the submitted prompt in both outputs. Copy must report success only after actual success, otherwise provide an error. Aim for a complete compact artifact, not an explanation.
Le brief du designer demandait aux deux modèles de construire Parallèle : un espace de travail de comparaison d'IA autonome avec une barre latérale, des sélecteurs de modèles, une saisie de prompt, des cartes de résultats simulées, une validation, des commandes de copie et une mise en page mobile. Nous avons laissé la palette de couleurs et l'identité visuelle ouvertes.
L'exécution finale appariée a utilisé le même prompt, le même transport en streaming et un plafond partagé de 32 768 jetons. Les deux réponses ont atteint un arrêt normal. Les artefacts sources restent non modifiés ; l'enregistrement du HTML supprime uniquement une clôture Markdown englobante lorsqu'elle est présente.
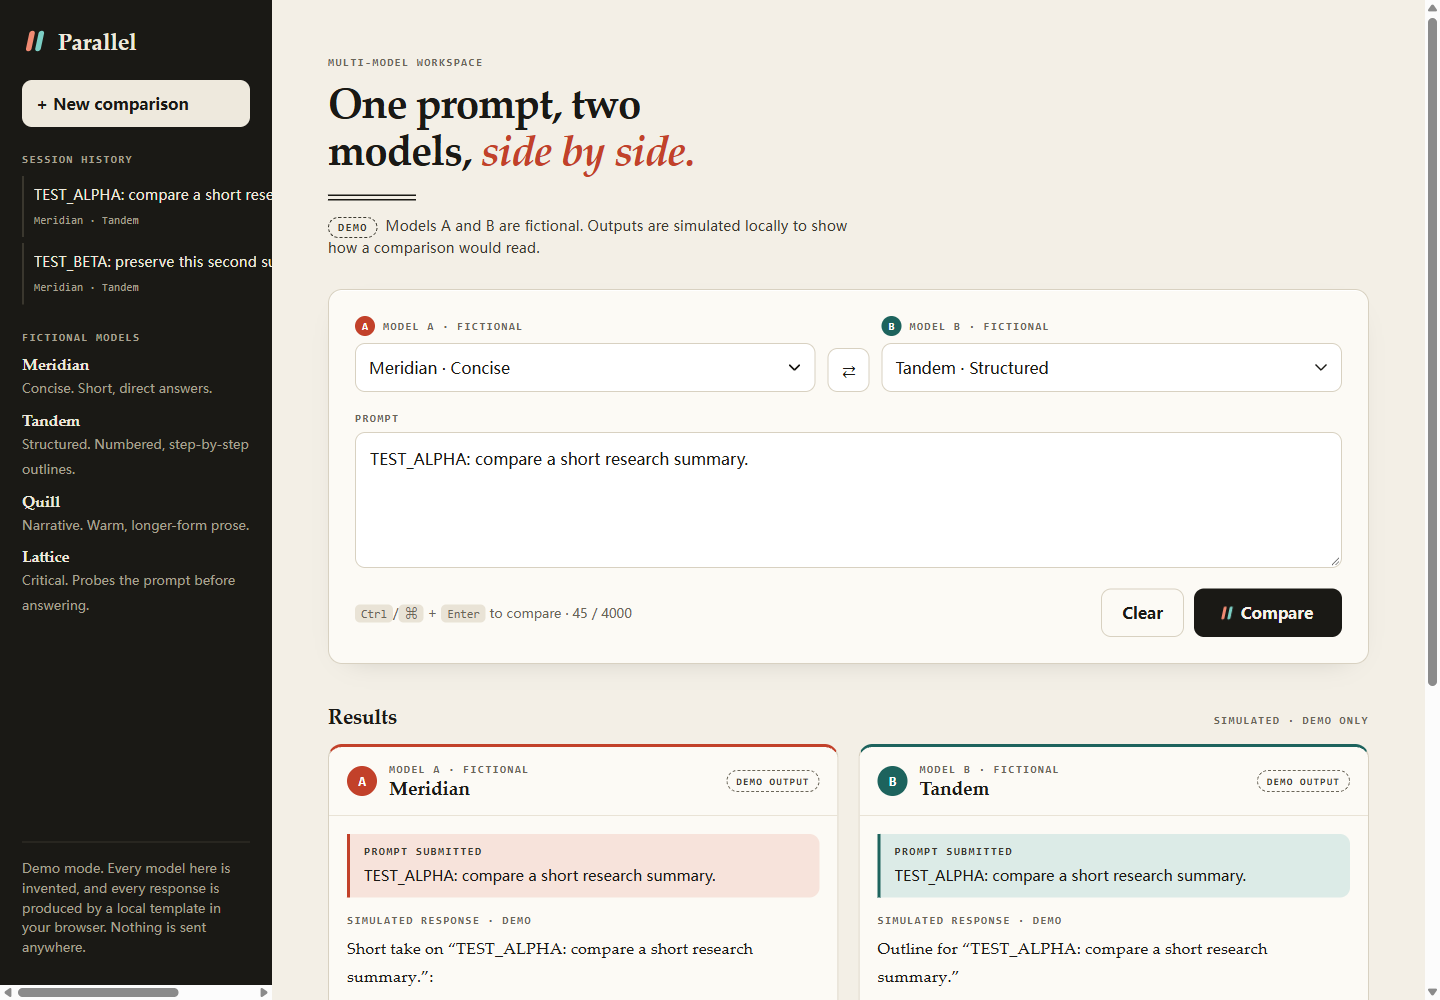
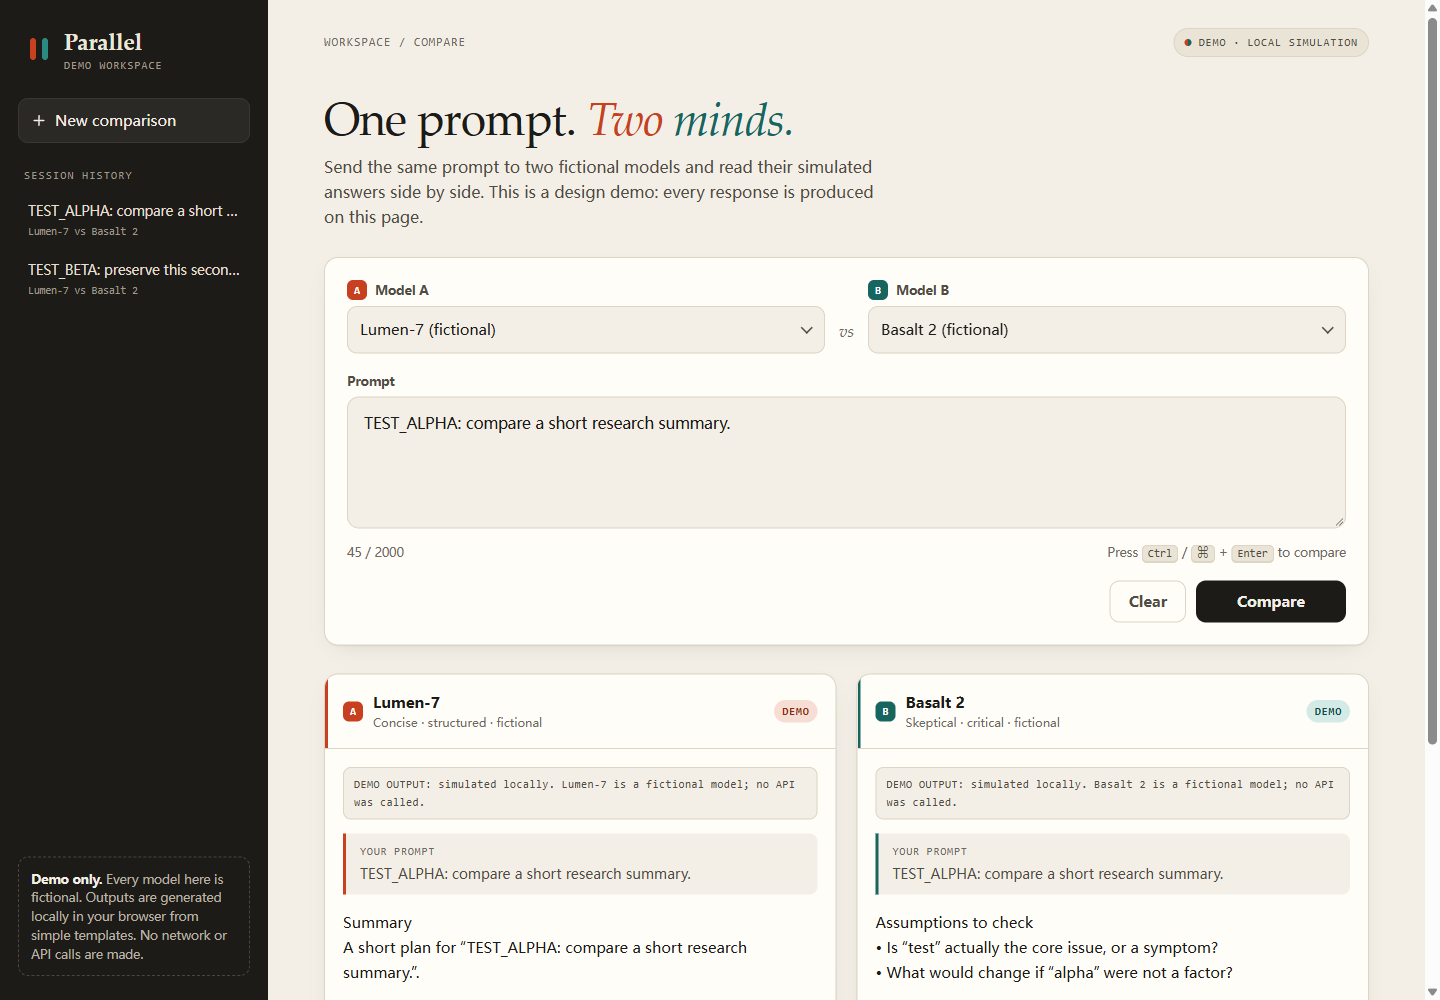
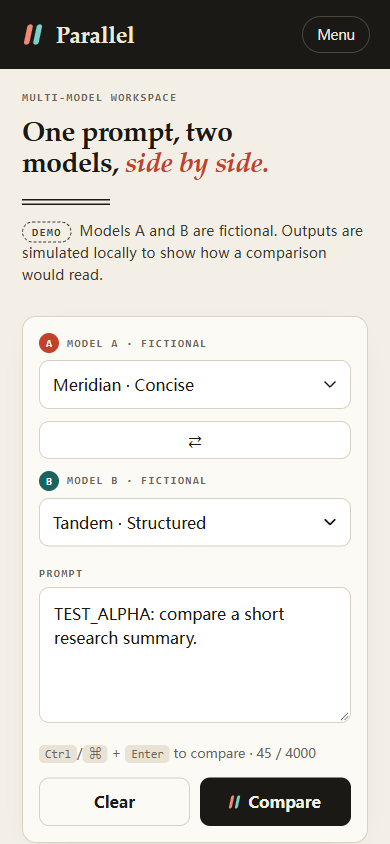
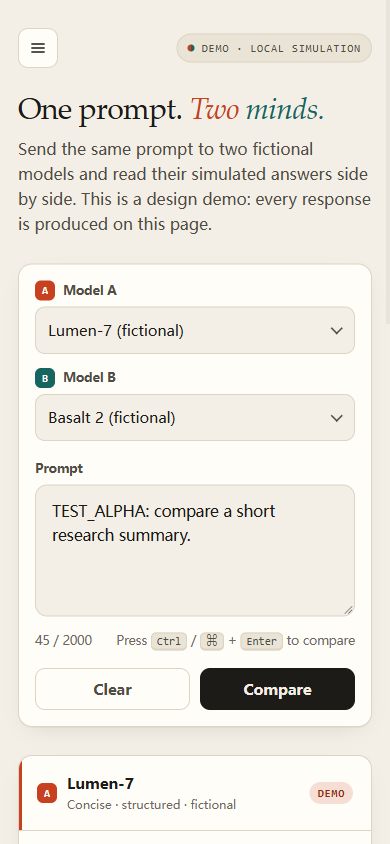
À quoi ressemblaient réellement les pages rendues
Exemple Fable 5.2
Un titre serif plus lourd, une emphase rouge en italique et une barre latérale à fort contraste donnent à cette page une identité éditoriale plus forte. Son contrôle de changement de modèle est un supplément utile, mais il occupe une ligne entière sur mobile et repousse la requête et les résultats plus bas.
Exemple Opus 5.5
Le titre plus léger et la zone de sélection de modèle plus simple semblent plus sobres. Sur le même viewport mobile, le bouton Comparer se termine à environ 710 pixels du haut, contre 826 pixels dans l'exemple Fable, laissant de la place pour que la première carte de résultat apparaisse plus tôt.
Les deux ont choisi des tons de papier chauds, des barres latérales sombres et des titres serif. La différence ici réside dans la hiérarchie et la densité, pas dans un langage de conception complètement différent.Pour cet espace de travail particulier, nous préférons la mise en page compacte de l'exemple Opus.Si la priorité est un titre éditorial plus visible, l'exemple Fable a cet attrait. Il s'agit d'une préférence subjective entre ces artefacts renvoyés, et non d'un classement esthétique général des modèles sous-jacents.
Vérifications du navigateur : apparence et comportement séparément
| Vérifier | Exemple Fable | Exemple Opus |
|---|---|---|
| Validation d'entrée vide | Réussi | Réussi |
| Les comparaisons répétées conservent l'invite soumise | Réussi | Réussi |
| Retour de chargement visible | Réussi | Réussi |
| Effacer l'entrée | Réussi | Réussi |
| Débordement de page à une largeur de 390 pixels | Aucun mesuré | Aucun mesuré |
| L'échec de la copie signale une erreur honnêtement | Réussi | Réussi |
| Copie réussie dans le presse-papiers | Non vérifié | Non vérifié |
Nous avons ouvert les sorties non éditées dans Chrome et utilisé les contrôles DOM pour exécuter les vérifications. Les captures d'écran de bureau utilisent 1440 × 1000 ; les captures d'écran mobiles utilisent 390 × 844. Les quatre montrent la même invite soumise après la comparaison et avant la vérification de copie. Aucune exception d'exécution n'a été capturée au cours de ces étapes. Les écritures dans le presse-papiers n'ont pas réussi dans la session automatisée, et une traversée complète au clavier uniquement n'a pas été testée.
L'utilisation de la paire de conception finale donne un proxy au tarif standard de $0.8826 pour Fable et $0.2918 pour Opus. Cela utilise les tarifs des fournisseurs et les jetons signalés par la passerelle, exclut les tentatives antérieures et ne constitue pas la facture réelle de la passerelle.
Tentatives antérieures et limites des preuves
Créateur de contenu : copie précise en deux formats
Même invite · Test du créateur de contenu
You are a content creator. Based ONLY on these FICTIONAL product facts, write a180-word plain-English explainer and a45-second video script with timestamps, then a five-item fact-check checklist. Facts: Lumen is a fictional AI workspace; it lets users compare two AI text drafts side by side, save prompts locally in their browser, and manually copy a chosen result. It does not publish content automatically, browse the web, or verify facts. No prices, launch dates, speed metrics, supported model names, or privacy guarantees are provided. Audience: freelancers who struggle to choose a usable first draft. Explain a practical example, avoid hype and invented claims, and distinguish local prompt saving from an unproven no-training guarantee.
Le brief du créateur fournissait un espace de travail fictif avec seulement trois fonctionnalités : comparaison de brouillons côte à côte, sauvegarde locale des invites et copie manuelle. Il demandait un texte explicatif de 180 mots, un script de 45 secondes et une liste de contrôle de vérification des faits en cinq points.
Les deux textes explicatifs respectaient l'exigence de 180 motsselon notre règle de comptage des mots, qui conserve les apostrophes et les traits d'union internes dans un mot. Les deux ont préservé les limites des fonctionnalités et ont correctement évité de considérer le stockage local comme une garantie de non-entraînement.
Fable 5.2
A commencé par la difficulté du freelance à choisir un brouillon, puis a expliqué les trois fonctionnalités en phrases courtes. Sa voix off vidéo contenait 101 mots : environ 135 mots par minute si elle est délivrée en 45 secondes.
Opus 5.5
A utilisé un exemple de rédacteur plus détaillé, contrastant une ouverture plus forte avec des explications de fonctionnalités plus claires. Sa voix off contenait 109 mots : environ 145 mots par minute sur la même durée.
Ces estimations de rythme proviennent de la voix off écrite, pas d'un enregistrement chronométré. Fable laisse plus de place aux pauses ; Opus utilise davantage le créneau pour expliquer l'exemple.
Pour les articles plus longs, notre guide utiliser Claude pour la rédaction de textes longs explique comment séparer la rédaction de la vérification et de l'édition.
Analyste de données : remboursements, attribution manquante et ROAS
Même invite · Test d'analyste de données
You are a data analyst. Use only this synthetic data. Orders CSV(order_id,updated,status,channel,amount): o1,1,paid,Search,100; o2,1,paid,Social,80; o2,2,refunded,Social,80; o3,1,paid,Search,120; o4,1,pending,Email,60; o5,1,paid,,50; o6,1,paid,Partner,90; o7,1,paid,Email,70; o8,1,paid,Social,60; o9,1,paid,Partner,110. Channel spend/clicks: Search200/100; Social100/80; Email50/40; Partner0/20. Deduplicate by order_id keeping greatest updated. Paid orders count and revenue use latest paid only; refunded/pending contribute zero. Blank channel must remain Unknown and cannot inherit spend/clicks. Calculate overall paid count, revenue, each channel paid count/revenue/conversion rate per click/ROAS, and measurable ROAS ranking; zero or missing denominator is N/A. Show arithmetic and propose a cautious next-budget decision without inferring causality. Return table and explanation under600 words.
La tâche d'analyste a été conçue pour détecter les erreurs qu'un tableau soigné peut masquer : des identifiants de commande en double, un remboursement ultérieur, une commande en attente, un canal inconnu et un canal partenaire sans dépenses.
Les deux modèles correspondaient à la clé de réponse préparée : 7 commandes payées et 600 de revenus après avoir conservé le dernier statut de commande. Ils ont exclu les enregistrements remboursés et en attente, conservé l'attribution manquante sous Inconnu et marqué les ratios indéfinis comme N/A.
| Canal | Commandes payées | Revenus | Conversion / clic | ROAS |
|---|---|---|---|---|
| Recherche | 2 | 220 | 2.00% | 1.10 |
| Social | 1 | 60 | 1.25% | 0.60 |
| 1 | 70 | 2.50% | 1.40 | |
| Partenaire | 2 | 200 | 10.00% | N/A : aucune dépense |
| Inconnu | 1 | 50 | N/A | N/A |
Fable a montré l'arithmétique des revenus dans le tableau des canaux et a suggéré de vérifier les remboursements, les commandes en attente, les balises manquantes et les coûts partenaires non enregistrés avant de modifier grand-chose. Opus a ajouté un tableau de déduplication enregistrement par enregistrement et a calculé que les revenus non attribués représentaient 8,3 % du total.
Les deux ont recommandé un test à budget limité plutôt que de traiter le ROAS observé comme une preuve causale. La remarque d'Opus selon laquelle une vente sociale supplémentaire doublerait à peu près le ROAS suppose un montant de commande similaire ; ce n'était pas un fait nouveau dans les données d'entrée.
Chef de produit : le préjudice avant les votes de fonctionnalités
Même invite · Test de chef de produit
You are a product manager for a FICTIONAL AI subscription workspace. Feedback: 2 users report duplicate charges after retrying checkout; billing logs confirm one duplicate captured charge. 30 users request dark mode. 8 report one model unavailable and no warning before using a prompt; outage reproduced. 1 requests account/data deletion; request pending for20 days, governing deadline unknown. 12 request reusable saved prompts. 4 want team seats; no revenue commitment. Two engineers available for one week; effort estimates unknown. Produce a one-week priority plan with rationale, explicit unknowns, scope boundaries, owner roles, acceptance criteria, instrumentation and rollback/containment steps. Do not fabricate legal deadlines, revenue, effort or certainty. Distinguish immediate containment from permanent fixes; do not rank purely by vote count. Under700 words.
Le brief produit associait un double débit confirmé à une demande de suppression en retard pour l'utilisateur, une panne de modèle reproduite et d'autres demandes de fonctionnalités populaires. Le piège était de donner la priorité à 30 votes pour le mode sombre plutôt qu'à un préjudice démontré.
Les deux modèles ont placé la facturation, le suivi de la suppression et l'endiguement des pannes avant la construction de fonctionnalités. Aucun des deux n'a inventé de délai légal pour la suppression. Tous deux ont attribué des rôles de propriétaire, séparé l'endiguement immédiat des correctifs permanents et proposé des contrôles d'acceptation et une surveillance.
Fable 5.2
A spécifié le rapprochement des remboursements, un correctif empêchant les frais répétés et l'endiguement manuel des pannes. Il a explicitement traité la perte de quota possible comme quelque chose à confirmer et a signalé la suppression comme irréversible.
Opus 5.5
Ajout d'un avertissement avant soumission, de la conservation des invites et d'une règle explicite contre le changement silencieux de modèle. Son tableau de priorisation était rapide à parcourir.
Cependant, il indiquait que les utilisateurs « perdaient silencieusement leur travail et leurs invites ». Les retours fournis établissaient une panne et une absence d'avertissement, pas une perte avérée d'invites.
Tarification de Fable 5.2 et Opus 5.5
Pour les requêtes API standard, Fable 5.2 coûte deux fois plus cher par jeton qu'Opus 5.5. Cela fait d'Opus le point de départ le moins cher lorsque les deux modèles offrent un résultat acceptable avec une consommation de jetons similaire.
Entrée / sortie
Entrée / sortie
Il s'agit des tarifs standard d'entrée/sortie d'Anthropic, vérifiés le 11 novembre 2026, à partir de laspécification Fable.
La spécification Opus indique le tarif standard correspondant. Le mode rapide, la mise en cache, les remises par lot, les abonnements grand public et la facturation par des tiers ont des conditions différentes.
Pour une requête illustrative avec 10 000 jetons d'entrée et 5 000 jetons de sortie, le calcul au tarif standard est de 0,28 $ pour Fable et de 0,14 $ pour Opus. Il s'agit d'un exemple concret, pas d'une facture issue de nos tests.
Un tarif de jeton plus élevé n'implique pas un coût plus élevé par tâche réussie. Une réponse plus courte, moins de cycles de révision ou moins de raisonnement peuvent modifier le total. Nos tests en un seul tour ne peuvent pas établir d'économies à long terme.
Si vous intégrez l'un ou l'autre modèle dans une application, guide de configuration de l'API Claude couvre les questions de configuration séparément de la comparaison des tarifs de jetons ici.
En multipliant l'utilisation signalée par la passerelle par les tarifs standard d'Anthropic, on obtient une approximation basée sur les tarifs de 0,4291 $ pour Fable contre 0,1799 $ pour Opus sur ces quatre tâches. La formule est jetons d'entrée × tarif d'entrée + jetons de sortie × tarif de sortie, divisé par un million. Cela exclut toutes les demandes de conception et les appels échoués.proxy basé sur les tarifs de 0,4291 $ pour Fable contre 0,1799 $ pour Opus sur ces quatre tâches. La formule est jetons d'entrée × tarif d'entrée + jetons de sortie × tarif de sortie, divisé par un million. Cela exclut toutes les demandes de conception et les appels échoués.
Ce proxy est pas les frais réels de la passerelle. Nous n'avons pas vérifié sa facture, l'équivalence de la comptabilité des jetons ou la majoration. Il ne mesure pas non plus le coût d'une édition humaine ultérieure ou de tentatives supplémentaires.
Ce que les benchmarks officiels établissent
L'évaluation de lancement d'Anthropic donne à Fable un avantage sur plusieurs tâches difficiles. Le tableau ci-dessous reproduit trois scores rapportés ; il s'agit d'évaluations du fournisseur, distinctes de nos propres tests basés sur les rôles.
| Évaluation | Fable 5.2 | Opus 5.5 |
|---|---|---|
| FrontierCode 2.0 | 49.1% | 45.5% |
| FrontierSWE v2 | 69.9% | 62.3% |
| Terminal-Bench-Science 0.1 | 74.6% | 58.7% |
Le rapport de lancement utilise l'effort disponible le plus élevé de chaque modèle, sauf indication contraire. Ces scores incitent à essayer Fable pour des travaux techniques exigeants ; ils n'établissent pas un avantage universel en matière d'écriture, de jugement de produit ou de goût visuel.
Les deux modèles indiquent une fenêtre de contexte d'un million de jetons et une limite de sortie de 128 000 jetons. Ces limites n'ont pas été testées sous contrainte ici.
Questions fréquemment posées
Fable 5.2 est-il meilleur qu'Opus 5.5 pour le codage ?
Anthropic rapporte des scores Fable plus élevés sur plusieurs évaluations de codage difficiles. Notre exercice de codage est un espace de travail IA à fichier unique, pas un benchmark de dépôt, il ne peut donc pas établir un gagnant général en codage.
Fable 5.2 coûte-t-il plus cher ?
Ses tarifs standard d'entrée et de sortie API sont le double de ceux d'Opus 5.5 : 8 $/40 $ contre 4 $/20 $ par million de jetons. Le coût réel des tâches dépend également de l'utilisation, du raisonnement, des nouvelles tentatives, de la mise en cache et du service qui vous facture.
Ces tests ont-ils été exécutés dans GlobalGPT ?
Non. Ils ont utilisé les modèles nommés via une passerelle API tierce. Ils n'établissent pas la disponibilité des modèles, la facturation ou les fonctionnalités natives dans GlobalGPT ou les applications propres de Claude.
Peut-on faire confiance à l'un ou l'autre modèle pour résumer une recherche sans vérifier ?
Les deux réponses de recherche ont calculé correctement le résultat principal, mais chacune a introduit au moins une inférence qui a nécessité une modification. Vérifiez chaque détail de la conception de l'étude et séparez les estimations des affirmations de signification.
Une page générée plus esthétique prouve-t-elle une meilleure capacité de codage ?
Non. La conception visuelle, les interactions fonctionnelles, l'accessibilité et la maintenabilité sont des dimensions distinctes. Une seule page attrayante ne peut pas établir la fiabilité du codage au niveau du référentiel.
Les modèles ont-ils bénéficié d'un effort de raisonnement égal ?
Nous avons utilisé des entrées et des plafonds de sortie identiques, avec les paramètres de raisonnement laissés par défaut sur la plateforme. Le mappage de la passerelle n'a pas été vérifié de manière indépendante, il ne s'agit donc pas d'un benchmark à effort égal.
Dois-je basculer tout mon travail vers Fable 5.2 ?
Utilisez d'abord un test d'acceptation spécifique à la tâche. Commencez par le modèle le moins cher qui le satisfait, puis passez à Fable lorsque vous pouvez identifier une amélioration intéressante.
Verdict final : quel modèle devriez-vous utiliser ?
Commencez par Opus 5.5 lorsqu'un premier brouillon acceptable est l'objectif. Son tarif de jetons standard inférieur en fait la référence pratique pour l'écriture courante, le nettoyage des données et la planification. Pour plus de contexte, consultez notre test de Claude Opus 5.5.
Essayez Fable 5.2 lorsqu'une tâche difficile spécifique ne satisfait toujours pas vos critères d'acceptation. Conservez les mêmes entrées et vérifiez s'il corrige l'échec réel. Les conseils de sélection de modèle recommande également de commencer par le dernier Opus et d'augmenter l'effort lorsque l'Opus à effort élevé est insuffisant.
Si aucun des deux modèles premium n'est nécessaire, Sonnet 5.5 vs Opus 5.5 est la comparaison de coûts la plus pertinente.
Pour un plus large éventail de fournisseurs, voir nos tests de générateur de texte IA.
Pour le travail sur dépôt, la démo à fichier unique de cet examen n'est qu'un point de départ. Elle ne teste pas l'accès shell, les modifications multi-fichiers, l'utilisation d'outils de longue durée ni le comportement de récupération d'un agent de codage. Pour les détails de configuration, consultez notre guide choisir un modèle dans Claude Code avant de considérer une complétion de chat comme un substitut à un environnement de développement complet.



