Comparaison des modèles Claude : Haiku, Sonnet et Opus, et la place de Fable dans cette gamme
Ariette Wynn
Dernière mise à jour le 09/09/2026
Un guide pratique pour 2026 : comment choisir en fonction de la vitesse, du coût de l'API, du contexte, de la complexité de la tâche et du coût d'une mauvaise réponse.
Pour la plupart des tâches quotidiennes de rédaction, d’analyse, de programmation et d’utilisation d’outils, commencez par Claude Sonnet 5. Optez pour Haiku 4.5 lorsque la faible latence et le volume élevé priment sur la gestion des cas limites complexes. Optez pour Opus 5 lorsque la tâche est complexe, difficile à vérifier ou que les erreurs peuvent coûter cher. Fable 5.1 se situe au-dessus d’Opus en tant que solution spécialisée de secours, et non comme option par défaut.
Ces recommandations s’appliquent à des charges de travail mixtes générales. Selon les conseils de production de Anthropic, la plupart des charges de travail devraient commencer par Opus 5, tandis que sa propre matrice des tâches positionne séparément Sonnet pour les tâches quotidiennes exigeant vitesse et performances. Le point de départ approprié dépend donc de votre tolérance au risque et de votre processus d’évaluation, et pas uniquement du nom du modèle.
GlobalGPT permet d'élargir le flux de travail Pratique grâce à un seul abonnement abordable : Claude, GPT-5.6 Sol, Gemini 3 Pro, Kimi K3 et de nombreuses fonctions d’IA partagent un même tableau de bord pour la recherche, la rédaction, l’analyse, le codage et le peaufinage. Son interface en ligne de commande (CLI) permet également d’intégrer l’accès à ces modèles dans votre terminal, votre workflow de développement et vos outils de production existants. La comparaison des résultats est un aspect utile du workflow ; pour un choix plus large au niveau de la famille de modèles, consultez notre Comparaison entre les modèles ChatGPT, Claude et Gemini. La suite de ce guide porte sur le choix parmi les modèles Claude.
Les quatre niveaux actuels apportent des réponses à différents problèmes économiques. L'appel le moins cher n'est pas toujours la tâche la moins coûteuse à réaliser, et le modèle le plus performant ne constitue pas automatiquement la meilleure utilisation d'un budget.
Guide de décision pour le modèle Claude
Choisissez en fonction de la charge de travail et du coût des pannes
Utilisez Sonnet pour un travail quotidien équilibré, optez pour une configuration moins puissante lorsque l'efficacité prime, et passez à une configuration plus puissante lorsque la vérification s'avère difficile ou que les erreurs ont un coût élevé.
Haiku 4.5
L'efficacité avant tout
Commencez par là pour les tâches à fort volume, sensibles à la latence et clairement délimitées, dont les erreurs sont peu coûteuses à détecter et à corriger.
Passez à la vitesse supérieure lorsqueLes cas marginaux ou le temps nécessaire aux relecteurs pour apporter des corrections annulent l'avantage lié au prix des jetons.
Sonnet n° 5
L'équilibre au quotidien
À utiliser pour les travaux combinant rédaction, analyse, programmation, compréhension visuelle et utilisation d'outils, qui font néanmoins l'objet d'une évaluation normale.
Passez à la vitesse supérieure lorsqueLe raisonnement à long terme, la vérification ou le coût d'un échec deviennent alors le facteur limitant.
Opus 5
La capacité avant tout
Commencez par ici pour les cas complexes impliquant des agents, les projets d'entreprise, les diagnostics difficiles ou les décisions dont une erreur peut avoir des conséquences coûteuses.
Descendre lorsqueUn modèle moins cher réussit à plusieurs reprises les mêmes contrôles de réception.
Fable 5.1
Chemin d'exception
N'effectuez une escalade que dans le cas d'un raisonnement complexe ou d'une tâche d'agent de longue durée, lorsque même Opus, qui nécessite davantage de ressources, ne parvient pas à satisfaire à votre évaluation.
Ne faites pas de suppositionsUn niveau supérieur revient automatiquement moins cher une fois pris en compte la qualité, le délai de révision et les nouvelles tentatives.
La règle pratique
Sélectionnez une tâche représentative et ses critères d'acceptation. Choisissez le modèle le moins coûteux qui donne des résultats fiables, puis évaluez le temps nécessaire à la correction et à la vérification avant de le considérer comme l'option la moins chère.
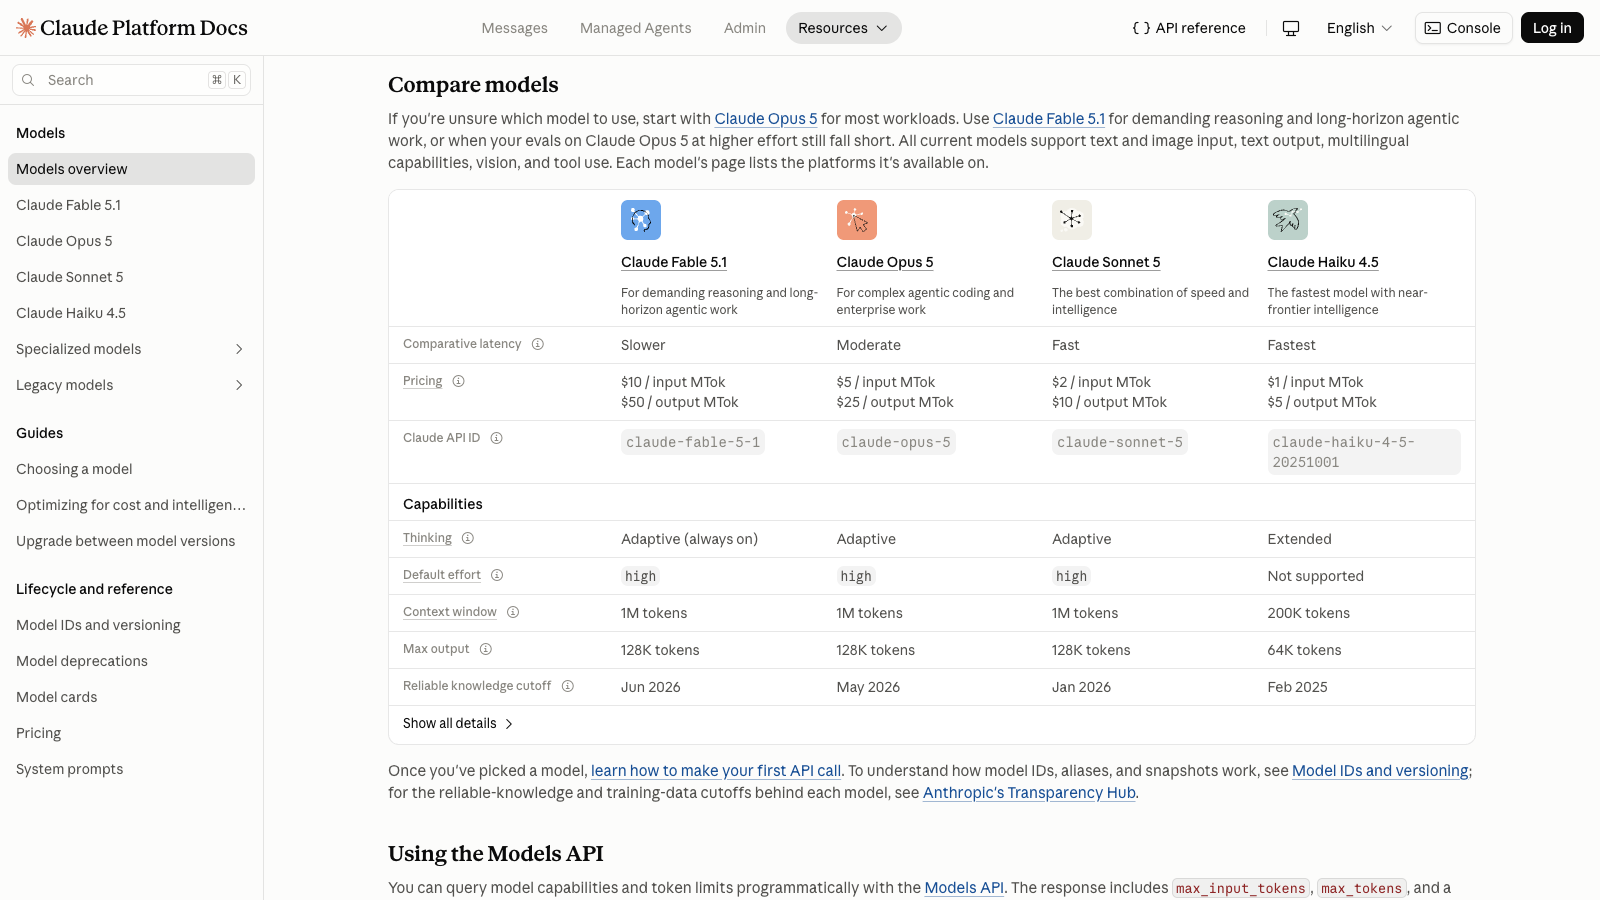
La gamme actuelle de modèles Claude
Au 8 septembre 2026, la gamme active de Anthropic comprend les modèles Claude Haiku 4.5, Claude Sonnet 5, Claude Opus 5 et Claude Fable 5.1. Haiku, Sonnet et Opus sont des noms de familles qui perdurent, mais la version associée à chaque famille évolue au fil du temps. Enregistrez l’identifiant exact du modèle que vous avez évalué en production, plutôt que de partir du principe qu’un nom de famille correspondra toujours au même instantané.
Modèle actuel
Étiquette officielle indiquant la vitesse
Contexte de l'API
Puissance maximale
Entrée / sortie de l'API de base
Haiku 4.5
Le plus rapide
200 000
64 Ko
$1 / $5 par MTok
Sonnet n° 5
Rapide
1M
128 Ko
$2 / $10 par MTok
Opus 5
Modéré
1M
128 Ko
$5 / $25 par MTok
Fable 5.1
Plus lent
1M
128 Ko
$10 / $50 par MTok
La présentation des modèles de la gamme Anthropic répertorie Haiku 4.5, Sonnet 5, Opus 5 et Fable 5.1 comme la gamme actuelle au 8 septembre 2026.
L'accès à Claude.ai ne correspond pas aux spécifications de l'API
Le tableau des forfaits Claude.ai décrit les conditions d’accès pour les particuliers et indique actuellement une fenêtre de contexte de 200 000 pour les forfaits individuels. La documentation de l’API répertorie les limites de contexte et de sortie spécifiques à chaque modèle, notamment une fenêtre de contexte de 1 million pour les modèles Sonnet 5, Opus 5 et Fable 5.1. N’utilisez pas le tableau de l’API pour déduire ce que comprend un plan Claude.ai particulier, ni le tableau des plans grand public pour déduire les limites d’un modèle API. Consultez le Guide des tarifs et des forfaits Claude pour la distinction au niveau du plan.
Claude Haiku, Sonnet et Opus : principales différences
Le principal compromis ne se résume pas à un simple classement par qualité. Choisir un modèle plus haut dans la gamme offre davantage de capacités pour les tâches complexes, mais cela augmente également le coût de base en jetons et réduit généralement la vitesse. Les limites de contexte et les contrôles de raisonnement varient également.
Les compromis concrets
Des étiquettes officielles et des spécifications API de base, associées à des points de départ pratiques pour les charges de travail courantes.
Dimension
Haiku 4.5
Sonnet n° 5
Opus 5
Le meilleur point de départ
Travail rapide, répété et limité
Travail intellectuel quotidien de nature variée
Travail complexe aux enjeux importants
Étiquette officielle indiquant la vitesse
Le plus rapide
Rapide
Modéré
Contexte / sortie de l'API
200 K / 64 K
1 Mo / 128 Ko
1 Mo / 128 Ko
Contrôle du raisonnement
Réflexion approfondie sur le manuel
Esprit d'adaptation et engagement
Esprit d'adaptation et engagement
Prix de base de l'API
Entrée $1 / Sortie $5
Entrée $2 / Sortie $10
$5 entrée / $25 sortie
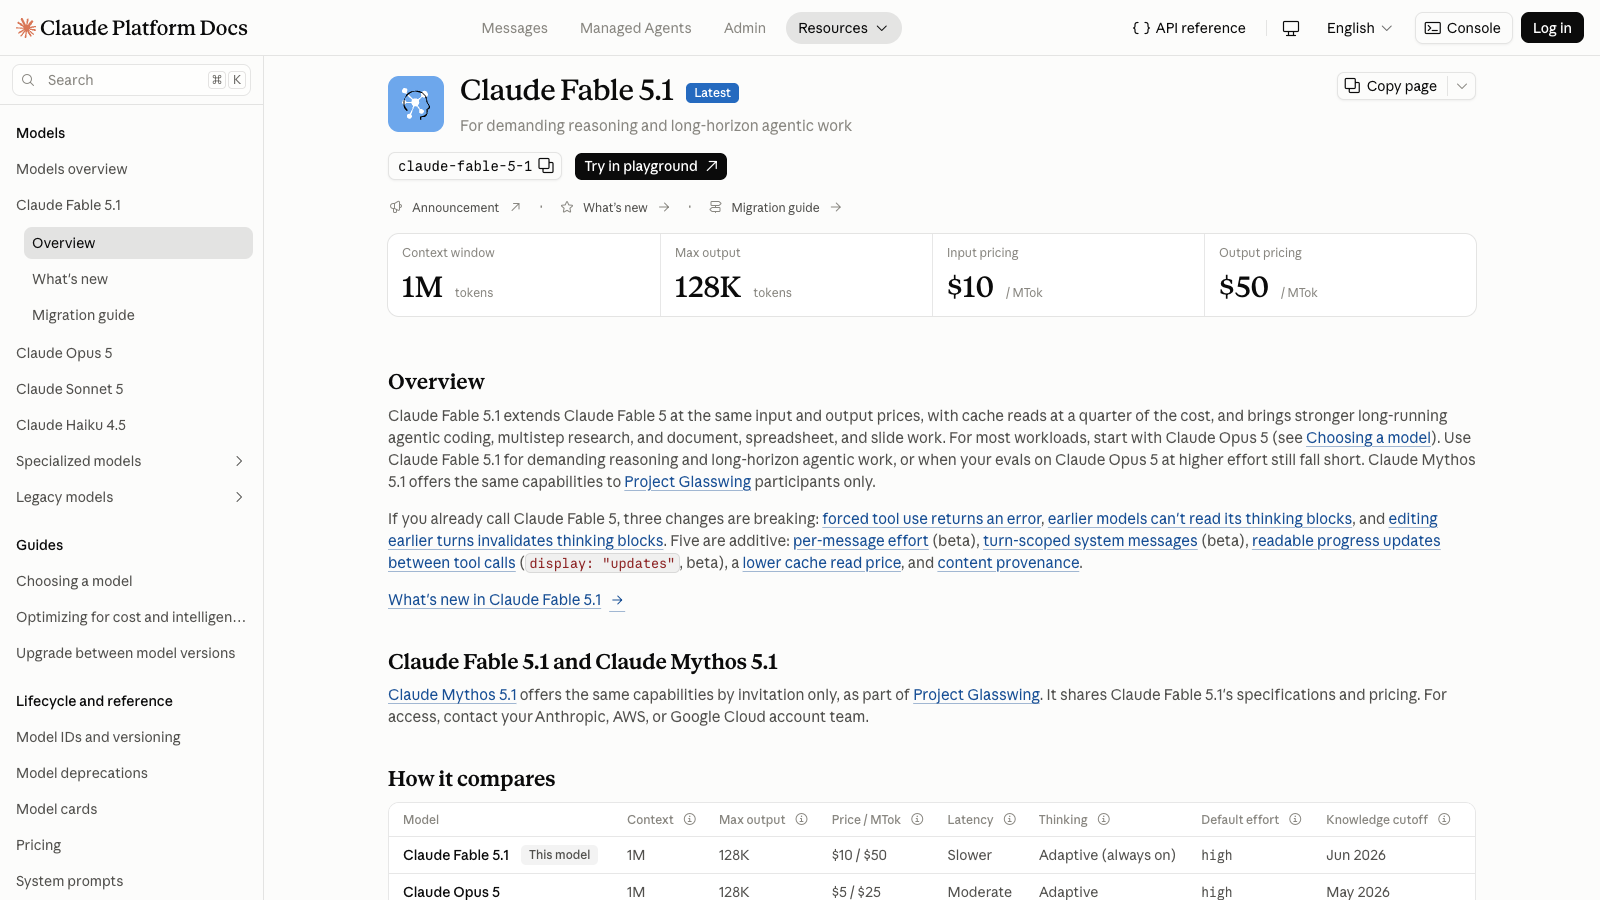
À quel genre appartient Fable ? Le modèle Fable 5.1 est officiellement classé dans la catégorie « Slower » (plus lent), avec un contexte de 1 million, un débit maximal de 128 000 et des tarifs d'entrée/sortie de base de $10 / $50 par million de jetons. Considérez-le comme un niveau supérieur à envisager lorsque le modèle Opus, même avec un effort accru, ne répond toujours pas à vos critères d'évaluation.
Vitesse et latence
Les étiquettes Anthropic désignent Haiku 4.5 comme “ le plus rapide ”, Sonnet 5 comme “ rapide ”, Opus 5 comme “ modéré ” et Fable 5.1 comme “ plus lent ”. Il s’agit de désignations qualitatives des produits, et non de mesures en millisecondes ou en tokens par seconde. La latence réelle dépend de la taille de la requête, des paramètres de raisonnement, des outils utilisés, de la charge et du mode de service.
Commandes de contexte, de sortie et de raisonnement
Le contexte API réduit de Haiku (200 Ko) et sa sortie maximale de 64 Ko restent suffisants pour de nombreuses tâches limitées. Sonnet et Opus étendent ces deux limites respectivement à 1 M et 128 K. Haiku 4.5 utilise une réflexion étendue manuelle, tandis que Sonnet 5 et Opus 5 prennent en charge la réflexion adaptative et le contrôle de l’effort. Cette différence explique en partie pourquoi un seul et même paramètre de raisonnement ne permet pas de créer des tests parfaitement équivalents pour tous les modèles.
Quel modèle Claude choisir pour chaque tâche ?
Charge de travail
Commencer par
Pourquoi
Mise à niveau lorsque
Classification, extraction, acheminement, triage de l'assistance
Haiku 4.5
Une faible latence et un faible coût de base des jetons conviennent particulièrement aux tâches claires et reproductibles.
Les cas marginaux ou le temps nécessaire à la correction annulent les économies réalisées.
Rédaction, analyse, compréhension visuelle, programmation au quotidien
Sonnet n° 5
Un équilibre entre vitesse, performances, contexte et coût pour les tâches mixtes.
Le raisonnement ou la vérification à long terme devient le goulot d'étranglement.
La capacité est plus importante que le prix unitaire le plus bas.
Même après avoir consacré davantage d'efforts à Opus, celui-ci échoue toujours à une évaluation représentative exigeante.
Travaux exceptionnels, de longue haleine ou faisant largement appel au raisonnement
Fable 5.1
Il s'agit de la trajectoire d'escalade actuelle au-dessus d'Opus.
Ne l'utiliser que lorsque les avantages mesurés justifient son coût plus élevé.
Ce ne sont que des points de départ, et non des solutions universelles. Par exemple, une modification de code courte mais à fort enjeu peut justifier l'utilisation d'Opus, tandis qu'une tâche d'extraction longue mais très structurée peut tout à fait convenir à Haiku. Pour des exemples concrets de workflows, consultez notre guide sur en utilisant le code Claude.
Lorsque votre liste de sélection dépasse Claude, GlobalGPT vous permet d'exécuter la même instruction représentative sur Claude, GPT-5.6 Sol, Gemini 3 Pro et Kimi K3 au sein d'un même espace de travail. Maintenez un critère de validation constant : la vitesse est importante pour les tâches répétitives, tandis que la qualité des réponses et le temps de correction déterminent si un résultat à moindre coût est réellement plus économique.
Choisissez en fonction du coût d'un échec, et pas uniquement du type de tâche
Les étiquettes des tâches masquent la variable la plus importante : que se passe-t-il lorsque la réponse est incorrecte ? Le cadre présenté ci-dessous est un outil d'aide à la décision éditoriale qui s'appuie sur les principes de Anthropic, à savoir « l'efficacité avant tout » et « les capacités avant tout ». Il ne s'agit pas d'un référentiel Anthropic.
Échelle des coûts liés aux défaillances
Commencez par un niveau bas lorsque la détection des erreurs est peu coûteuse ; commencez par un niveau élevé lorsque la vérification est incomplète ou coûteuse.
À bas prix
Exemples Étiquetage, routage, nettoyage des ébauches, résumés réversibles
Démarrer Haiku 4.5
Transmettre à un niveau supérieur Lorsque le temps consacré aux corrections annule le gain d'efficacité
Matériau
Exemples Ébauches destinées aux clients, analyses validées, code de production testé
Démarrer Sonnet n° 5
Transmettre à un niveau supérieur Lorsque la révision ne permet pas de détecter de manière fiable des défaillances importantes
Coûteux
Exemples Changements impliquant une grande autonomie, diagnostic difficile, décisions lourdes de conséquences
Démarrer Opus 5
Transmettre à un niveau supérieur Passer à « Fable » uniquement après qu’un « Opus » nécessitant un effort plus important ait échoué à une évaluation « gelée »
Quand mettre à niveau ou revenir à une version antérieure de votre modèle Claude
Ne passez à l'étape suivante que lorsqu'une limite mesurée apparaît
Du haïku au sonnet
Passez à la version supérieure lorsque les cas limites, les instructions manquantes ou le temps consacré aux corrections par les relecteurs dépassent les économies réalisées.
Sonnet à Opus
Passez à une version supérieure lorsque l'exécution à long terme, la complexité du raisonnement, la vérification ou le coût d'un échec constituent une contrainte.
Opus à un niveau d'effort plus élevé
Testez la charge de travail exigeante à l'aide de contrôles d'acceptation figés avant de passer au niveau supérieur.
D'Opus à Fable
Ne passez à l'étape suivante que si l'Opus, malgré des efforts accrus, échoue toujours à l'évaluation représentative et que le bénéfice justifie le coût.
Règle de déclassement : Revenez à un modèle inférieur lorsqu'un modèle moins cher réussit à plusieurs reprises les mêmes tests de validation avec la latence et la fiabilité requises.
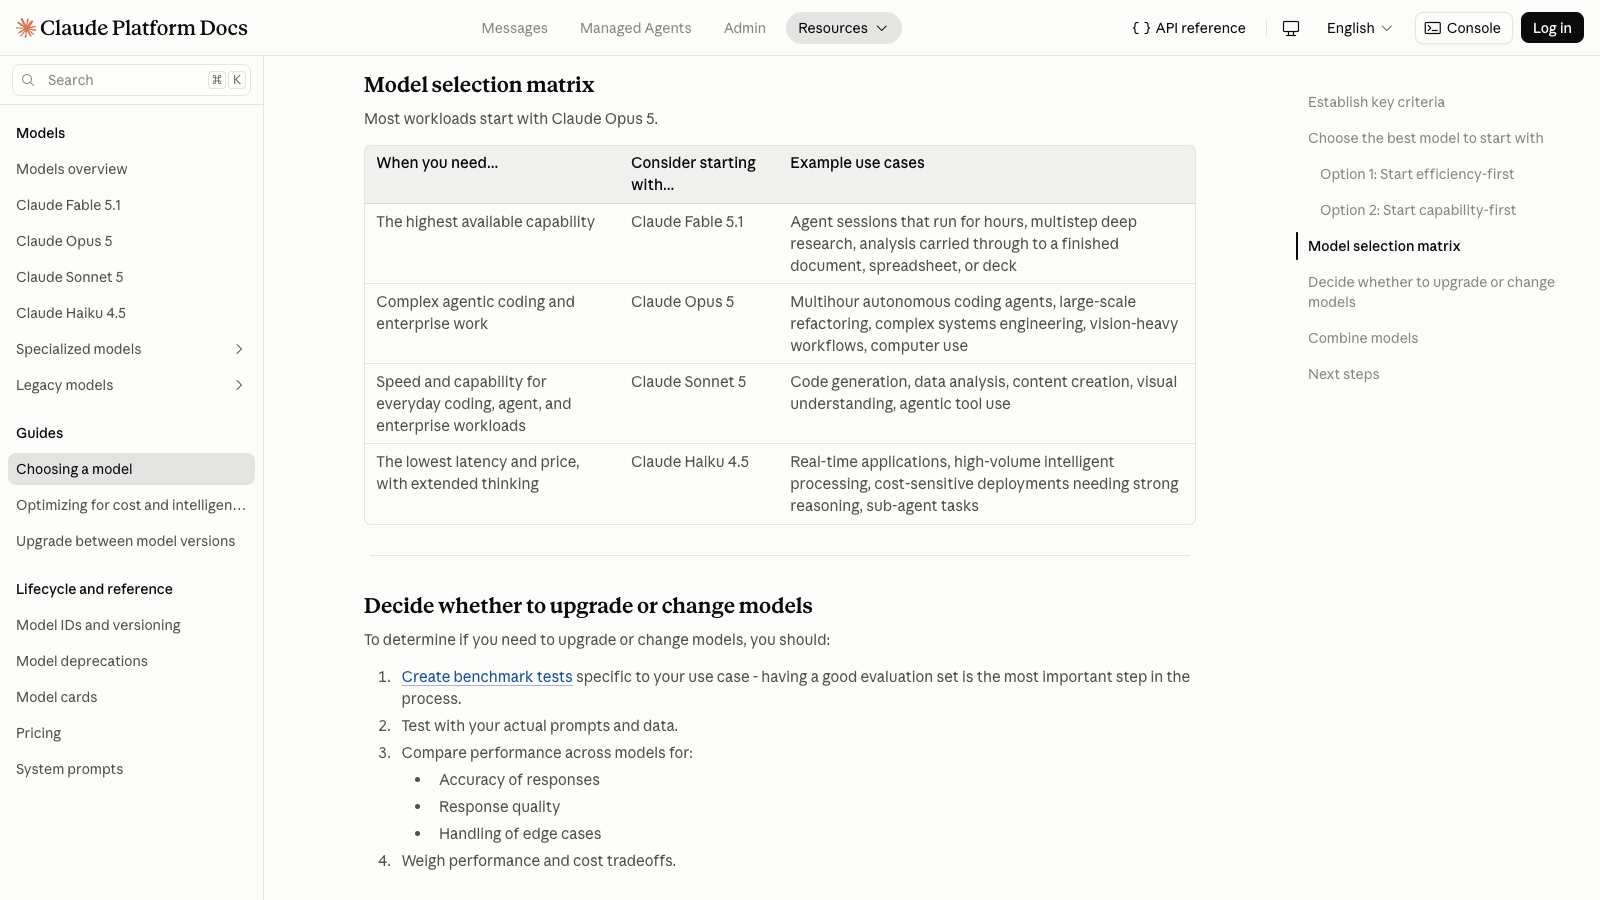
La matrice de Anthropic met en correspondance quatre modèles Claude actuels avec différents besoins en termes de capacités, de vitesse et de charge de travail.
Exemple de coût fixe pour l'API Claude
Pour une charge de travail globale fixe de 1 million de jetons d'entrée et 100 000 jetons de sortie répartis sur plusieurs requêtes API standard, le coût de base des jetons varie entre $1,50 avec Haiku 4.5 et $15,00 avec Fable 5.1. Il ne s'agit pas d'une seule requête, et cela ne remplace pas les limites de sortie par requête.
Une charge de travail, quatre modèles Claude
Le volume de jetons reste le même, mais son coût est multiplié par 2, 5 ou 10 par rapport au total en Haiku à mesure que l'on passe aux niveaux supérieurs.
Charge de travail 1,0 M en entrée + 0,1 M en sortie sur plusieurs requêtes
Haiku 4.5
$1.50
Sonnet n° 5
$3.00
Opus 5
$7.50
Fable 5.1
$15.00
Modèle
Calcul des données d'entrée
Calcul du rendement
Total
Haiku 4.5
1,0 x $1
0,1 x $5
$1.50
Sonnet n° 5
1,0 x $2
0,1 x $10
$3.00
Opus 5
1,0 x $5
0,1 x $25
$7.50
Fable 5.1
1,0 x $10
0,1 × $50
$15.00
Comprend : Taux de référence standard des jetons d'entrée et de sortie, issus d'un instantané de prix Anthropic.
Sont exclus : Mise en cache des requêtes, API par lots, mode rapide, géographie, frais d'utilisation des outils, taxes, remises et crédits GlobalGPT.
Le barème des tarifs indique le coût des jetons, et non celui d'un résultat finalisé. Une formule moins chère peut s'avérer plus coûteuse si les nouvelles tentatives, les corrections et les vérifications mobilisent davantage de temps de travail que ce que permettent d'économiser les jetons.
Test pratique du modèle Claude : mêmes instructions, modes de défaillance différents
Le 9 septembre 2026, nous avons transmis les trois mêmes requêtes via l'API Anywhere aux modèles Claude Haiku 4.5, Sonnet 5, Opus 5 et Fable 5.1. Les tâches portaient sur le triage structuré des demandes d'assistance, la rédaction fondée sur des preuves et le débogage JavaScript vérifiable. Nous avons conservé la première réponse valide de chaque modèle et l'avons évaluée à l'aune de règles fixées avant l'examen des réponses.
Le résultat n'était pas un simple classement. Sonnet, Opus et Fable ont tous trois obtenu un score de 26,5 sur 30, mais leurs points forts et leurs faiblesses différaient considérablement. Haiku a renvoyé un code HTTP 503 lors des deux tentatives autorisées pour chaque tâche ; la qualité de ses résultats reste donc inconnue dans le cadre de ce test.
Configuration des essais et résultat global
Trois prompts figés, les mêmes limites de tokens par tâche, aucune utilisation d'outils ni de recherche, et la première réponse valide conservée pour chaque modèle.
LieuAPI Anywhere
Date9 septembre 2026
TâchesTriage structuré, note de lancement, débogage JavaScript
Règle de nouvelle tentativeErreur de transport, 429/5xx, contenu vide ou réponse non valide
Modèle
Tâches terminées
Note globale de qualité
Signal le plus utile
Claude Haïku 4.5
0/3
Non noté
Les six requêtes autorisées ont toutes renvoyé un code 503 ; disponibilité de l'itinéraire uniquement.
Claude Sonnet 5
3/3
26.5/30
Le seul modèle à répondre à toutes les exigences mentionnées dans la note de lancement.
Claude Opus 5
3/3
26.5/30
Débogage approfondi ; une contrainte relative à la longueur d'écriture a été omise.
Claude Fable 5.1
3/3
26.5/30
Sorties structurées et propres ; la note de lancement a été tronquée après une réponse vide.
Sortie structurée
Test n° 1 : Tri des tickets d'assistance
Résultat de l'exercice : Fable 5.1, 10/10
Fable a été le seul modèle à renvoyer un fichier JSON directement analysable, avec les six libellés et actions corrects. Opus et Sonnet ont correctement identifié les libellés, mais ont ajouté des balises Markdown ; tous deux ont également renforcé une échéance fournie, et Sonnet a promis prématurément une correction ou un remboursement.
Modèle
Statut
Score
Latence partout
Jetons signalés
Que s'est-il passé ?
Claude Haïku 4.5
Itinéraire indisponible
Non noté
Non disponible
Non disponible
Deux réponses 503 ; aucun score de qualité.
Claude Sonnet 5
Sortie conservée
7.5/10
10,39 s
1005
Les libellés sont corrects, mais le JSON est « clôturé » et le résultat concernant le remboursement ou la correction est inventé.
Claude Opus 5
Sortie conservée
8.5/10
11,87 s
1051
Des étiquettes correctes et des mesures énergiques, mais un JSON « clôturé » et un délai plus strict.
Claude Fable 5.1
Sortie conservée
10/10
8,55 s
680
JSON directement analysable ; toutes les vérifications « frozen » ont été validées.
Données d'entrée complètes pour le test
Vous gérez une boîte de réception dédiée à l'assistance d'un service SaaS. Classez chaque ticket ci-dessous. Renvoyez un JSON comportant uniquement un champ de niveau supérieur nommé « tickets ». Le champ « tickets » doit être un tableau respectant l’ordre d’origine, et chaque élément doit contenir exactement les champs suivants : ticket_id, category, urgency et action. Le champ « category » doit prendre l’une des valeurs suivantes : billing, access, bug ou feature. Le champ « urgency » doit prendre l’une des valeurs suivantes : low, medium ou high. Utilisez uniquement le texte du ticket ; n’inventez pas de résultats liés à la politique ni de faits concernant le client.

#481 : On nous a facturé deux fois le même renouvellement annuel. La clôture de la paie a lieu vendredi et j’ai besoin que cela soit examiné avant cette date.
#482 : La réinitialisation du mot de passe indique que l’e-mail a été envoyé, mais je n’ai rien reçu. J’ai vérifié le dossier spam et j’ai réessayé une fois.
#483 : Les exportations CSV arrondissent tous les montants en devises au dollar entier, alors que le tableau de bord affiche toujours les centimes.
#484 : Veuillez ajouter un mode sombre au tableau de bord d’analyse.
#485 : Depuis le changement de domaine de notre entreprise ce matin, tous les employés reçoivent un message d’accès SSO refusé.
#486 : Pourriez-vous m’envoyer une copie de la facture du mois dernier ?
Claude Haiku 4.5 : résultat opérationnel complet
Aucun résultat de modèle n'a été généré. Les deux tentatives autorisées via l'API Anywhere ont renvoyé un code HTTP 503 ; cette route a donc été marquée comme indisponible et exclue de l'évaluation de la qualité.
Claude Sonnet 5 : sortie maximale
```json
{
  "tickets": [
    {
 "ticket_id": "#481",
      "category": "facturation",
 "urgency": "élevée",
 "action": "Enquêter sur la double facturation des frais de renouvellement annuel et procéder à une correction/un remboursement avant la clôture de la paie du client vendredi."
    },
    {
 "ticket_id": "#482",
      "category": "access",
 "urgency": "medium",
 "action": "Vérifier l'adresse e-mail du compte et la délivrabilité des e-mails, puis déclencher manuellement ou renvoyer l'e-mail de réinitialisation du mot de passe."
    },
    {
 "ticket_id" : "#483",
      "category": "bug",
 "urgency": "medium",
 "action": "Transmettre le problème au service d’ingénierie afin de corriger l’arrondi lors de l’exportation au format CSV, de sorte que les valeurs monétaires correspondent à la précision au centime près affichée sur le tableau de bord."
    },
    {
 " ticket_id " : " #484 ",
 " category " : " feature ",
 " urgency " : " low ",
 " action " : "Enregistrer la demande de mode sombre pour le tableau de bord analytique et l’ajouter au backlog des fonctionnalités du produit."
    },
    {
 "ticket_id": "#485",
      "category": "access",
 "urgency": "high",
 "action": "Examiner immédiatement la configuration de l’authentification unique (SSO) liée au changement de domaine de l’entreprise et rétablir l’accès pour tous les employés concernés."
    },
    {
      "ticket_id": "#486",
 "category": "facturation",
 "urgency": "faible",
 "action": "Retrouver la facture du mois dernier et en envoyer une copie au client."
    }
  ]
}
```
Claude Opus 5 : puissance maximale
```json
{
  "tickets": [
    {
 "ticket_id": "481",
 "category": "facturation",
 "urgency": "élevée",
 "action": "Transmettre le ticket au service de facturation afin de vérifier le double prélèvement des frais de renouvellement annuel et de confirmer la résolution du problème avant la clôture de la paie du client vendredi."
    },
    {
 "ticket_id": "482",
      "category": "accès",
 "urgency": "moyenne",
 "action": "Vérifier les journaux d'envoi des e-mails pour le message de réinitialisation envoyé à cette adresse et, s'il n'a pas été remis, déclencher une procédure de réinitialisation vérifiée pour l'utilisateur."
    },
    {
 "ticket_id": "483",
      "category": "bug",
 "urgency": "medium",
 "action": "Signaler un bug concernant l’arrondi des devises lors de l’exportation CSV, en précisant la divergence avec les valeurs du tableau de bord, et demander les étapes de reproduction ou un exemple d’exportation."
    },
    {
 "ticket_id": "484",
 "category": "feature",
 "urgency": "low",
 "action": " Enregistrer comme demande de fonctionnalité pour le mode sombre du tableau de bord analytique et accuser réception sans s’engager sur un délai. "
    },
    {
 " ticket_id " : " 485 ",
      "category": "access",
 "urgency": "high",
 "action": "Transmettre le ticket comme une panne du SSO à l’échelle de l’organisation liée au changement de domaine ; demander au service Identité/Authentification de vérifier immédiatement la configuration du domaine SSO."
    },
    {
      "ticket_id": "486",
 "category": "facturation",
 "urgency": "faible",
 "action": "Envoyer la copie de la facture du mois précédent demandée au contact vérifié du compte."
    }
  ]
}
```
Claude Fable 5.1 : puissance maximale
{"tickets":[{"ticket_id":"481","category":"facturation","urgency":"élevée","action":"Enquêter sur le signalement d'un double prélèvement pour le renouvellement annuel et répondre avant la date limite de paie du client, fixée au vendredi."},{"ticket_id":"482","category":"accès","urgency":"moyenne","action":"Vérifier les journaux d'envoi des e-mails de réinitialisation de mot de passe pour l'adresse de l'utilisateur et renvoyer l'e-mail ou proposer une autre méthode de réinitialisation."},{"ticket_id":"483","category":"bug","urgency":"medium","action":"Reproduire le problème d'arrondi des montants en devises à des dollars entiers lors de l'exportation au format CSV et transmettre le problème à l'équipe d'ingénierie pour qu'elle y remédie."},{"ticket_id":"484","category":"feature","urgence" : "faible", "action" : "Enregistrer la demande de mode sombre pour le tableau de bord analytique auprès de l'équipe produit et accuser réception."},{"ticket_id" : "485", "catégorie" : "accès", "urgency":"high","action":"Transmettre les erreurs d’accès SSO refusé à l’échelle de l’entreprise suite au changement de domaine et vérifier la configuration du domaine SSO."},{"ticket_id":"486","category":"billing","urgency":"low","action":"Retrouver et envoyer au client une copie de la facture du mois dernier."}]}
Politique de la « première sortie valide ». La latence correspond au temps réel via Anywhere, et non à la latence native Anthropic. Les nombres de jetons sont communiqués par le fournisseur ; aucun coût direct lié à l'API n'est déduit de cet itinéraire.
Respect des contraintes
Test n° 2 : note de lancement fondée sur des données factuelles
Résultat de l'exercice : Sonnet 5, 10/10
Sonnet était le seul modèle à répondre à toutes les exigences fixées. Opus a généré une note pertinente, mais a dépassé la limite de caractères et a laissé entendre que tous ceux qui n’avaient pas répondu étaient des étudiants inscrits. La première réponse de Fable était vide ; sa nouvelle tentative autorisée a renvoyé une note visiblement tronquée, dépourvue de recommandation ou de mise en garde.
Modèle
Statut
Score
Latence partout
Jetons signalés
Que s'est-il passé ?
Claude Haïku 4.5
Itinéraire indisponible
Non noté
Non disponible
Non disponible
Deux réponses 503 ; aucun score de qualité.
Claude Sonnet 5
Sortie conservée
10/10
9,94 s
796
Les critères relatifs aux termes « champ d'application », « structure », « éléments probants », « recommandation » et « mise en garde » ont été respectés.
Claude Opus 5
Sortie conservée
8/10
9,49 s
826
Une analyse solide, mais 223 mots de moins que le seuil fixé selon la méthode du « nombre figé » et une déduction non étayée.
Claude Fable 5.1
Sortie conservée
6.5/10
19,27 s
1685
Première réponse vide ; la nouvelle tentative enregistrée a été tronquée avant la recommandation et la mise en garde.
Données d'entrée complètes pour le test
Rédigez une note interne de lancement de 180 à 220 mots destinée à un chef de produit en vous appuyant uniquement sur les faits ci-dessous. Veillez à inclure : un objet, un court paragraphe d’introduction, exactement trois puces, une recommandation et une mise en garde clairement identifiée. N’inventez pas de décision budgétaire, de pourcentages, de signification statistique ni d’effets de causalité.

Faits :
- Le projet pilote a recruté 120 étudiants.
- À la date de référence du 31 mars, 96 étudiants avaient assisté à au moins trois sessions.
- La note moyenne obtenue dans l'enquête était de 4,3 sur 5, sur la base de 71 répondants.
- La fiche opérationnelle du programme indique un budget de $18 000.
- La note d’approbation financière indique $20 000. Elle ne précise pas si la différence résulte d’une révision ou d’une erreur d’enregistrement.
- Les participants n’ont pas été répartis de manière aléatoire et aucun score de référence n’a été recueilli.
- La décision porte sur le lancement d’un deuxième projet pilote, et non sur sa mise en œuvre définitive.
Claude Haiku 4.5 : résultat opérationnel complet
Aucun résultat de modèle n'a été généré. Les deux tentatives autorisées via l'API Anywhere ont renvoyé un code HTTP 503 ; cette route a donc été marquée comme indisponible et exclue de l'évaluation de la qualité.
Claude Sonnet 5 : sortie maximale
**Objet : Résultats du programme pilote — Recommandation de lancer un deuxième programme pilote**

Le programme pilote initial a achevé sa première période d’évaluation, et les premiers indicateurs d’engagement et de satisfaction sont encourageants. Avant de s’engager dans un deuxième programme pilote, l’équipe doit examiner ensemble certains éléments de données et points en suspens.

- Sur les 120 étudiants inscrits, 96 avaient assisté à au moins trois sessions à la date de l'évaluation du 31 mars.
- Une enquête réalisée après les sessions, à laquelle 71 personnes ont répondu, a donné une note moyenne de 4,3 sur 5.
- Les chiffres budgétaires ne concordent pas d’un document à l’autre : la fiche opérationnelle du programme indique $18 000, tandis que la note d’approbation financière mentionne $20 000 ; il est difficile de déterminer s’il s’agit d’une révision ou d’une erreur d’enregistrement.

**Recommandation :** Compte tenu des résultats d’assiduité et de l’enquête, nous recommandons de lancer un deuxième projet pilote afin de recueillir des données plus structurées — idéalement avec un groupe de comparaison défini et une mesure de référence — avant d’envisager toute décision de déploiement à plus grande échelle. Ce deuxième projet pilote devrait également servir d’occasion de régulariser l’écart budgétaire avec le service financier avant que les fonds ne soient définitivement alloués.

**Mise en garde :** Ces résultats doivent être interprétés avec prudence. Les participants n’ont pas été sélectionnés de manière aléatoire et aucun score de référence n’a été recueilli ; nous ne pouvons donc pas attribuer les résultats de l’enquête ou les tendances de participation au programme lui-même. Il s’agit d’une décision visant à définir le périmètre d’un deuxième projet pilote, et non d’une décision concernant une mise en œuvre définitive.
Claude Opus 5 : puissance maximale
**Objet : Résultats du projet pilote et recommandation concernant une deuxième cohorte pilote**

Le premier projet pilote a franchi son étape intermédiaire du 31 mars, et nous disposons désormais de suffisamment d’informations pour décider s’il convient de lancer un deuxième projet pilote. La présente note résume nos observations, nos recommandations ainsi que la principale limite à prendre en compte dans l’interprétation des résultats. Aucune décision définitive concernant le déploiement à grande échelle n'est à l'ordre du jour à ce stade.

- **Inscription et participation :** 120 étudiants se sont inscrits. À la date butoir du 31 mars, 96 d'entre eux avaient assisté à au moins trois sessions.
- **Retour des participants :** L’enquête de satisfaction post-participation a donné une note moyenne de 4,3 sur 5, sur la base de 71 répondants. Les autres étudiants inscrits n’ont pas répondu ; la note ne reflète donc que ce sous-ensemble.
- **Écart budgétaire :** la fiche opérationnelle du programme indique un budget de $18 000, tandis que la note d’approbation financière mentionne $20 000. La note financière ne précise pas si cette différence résulte d’une révision ou d’une erreur d’enregistrement, et nous n’avons pas déterminé quel chiffre fait foi.

**Recommandation :** Poursuivre la planification d’un deuxième projet pilote, à condition que les services financiers et les opérations du programme harmonisent les deux chiffres budgétaires et confirment un seul chiffre faisant foi avant que nous ne nous engagions à engager des dépenses. Un deuxième projet pilote devrait également recueillir des scores de référence lors de l’admission.

**AVERTISSEMENT :** Les participants n’ont pas été répartis de manière aléatoire et aucun score de référence n’a été recueilli. Les chiffres relatifs à l’engagement et aux enquêtes décrivent donc ce que ce groupe a fait et rapporté ; ils ne permettent pas de déterminer les effets du programme ni ses performances auprès d’une population différente.
Claude Fable 5.1 : puissance maximale
**Objet :** Résumé du bilan intermédiaire du projet pilote et recommandation concernant un deuxième projet pilote

Bonjour [Directeur],

Vous trouverez ci-dessous un résumé de l'état d'avancement du projet pilote à la date de référence du 31 mars, ainsi qu'une recommandation quant à l'opportunité de passer à un deuxième projet pilote. La présente note porte uniquement sur la décision relative à un deuxième projet pilote et non sur le déploiement définitif.

- **Inscriptions et assiduité :** 120 étudiants inscrits. À la date de bilan du 31 mars, 96 d’entre eux avaient assisté à au moins trois sessions.
- **Avis des participants :** une enquête a révélé une note moyenne de 4,3 sur 5 auprès de 71 répondants.
- **Données budgétaires :** la fiche opérationnelle du programme fait état d’un budget de $18 000, tandis que la note d’approbation financière indique $20 000. La note financière ne précise pas si cette différence résulte d’une révision ou d’une erreur d’enregistrement.

**
Politique de la « première sortie valide ». La latence correspond au temps réel via Anywhere, et non à la latence native Anthropic. Les nombres de jetons sont communiqués par le fournisseur ; aucun coût direct lié à l'API n'est déduit de cet itinéraire.
Exactitude du code
Test n° 3 : Débogage JavaScript vérifiable
Résultat de l'exercice : ex æquo entre Opus 5 et Fable 5.1, 10/10
Les trois modèles disponibles ont tous détecté des défauts et généré des versions de remplacement qui ont satisfait aux huit cas de test. Opus et Fable ont renvoyé du JSON valide et ont terminé ex æquo avec un score de 10/10. Le code de Sonnet a également satisfait aux tests, mais la balise Markdown qui l’encadrait n’a pas respecté l’exigence de JSON pur.
Modèle
Statut
Score
Latence partout
Jetons signalés
Que s'est-il passé ?
Claude Haïku 4.5
Itinéraire indisponible
Non noté
Non disponible
Non disponible
Deux réponses 503 ; aucun score de qualité.
Claude Sonnet 5
Sortie conservée
9/10
13,17 s
1471
La solution de remplacement a réussi les 8 cas testés ; la sortie « fenced » n'a pas respecté la consigne relative au format JSON.
Claude Opus 5
Sortie conservée
10/10
20,17 s
1826
JSON valide, les deux défauts ont été identifiés et les 8 cas d'exécution ont tous été validés.
Claude Fable 5.1
Sortie conservée
10/10
15,89 s
1409
JSON valide, diagnostic concis et 8 cas d'exécution sur 8 réussis.
Données d'entrée complètes pour le test
Diagnostiquez et corrigez cette fonction JavaScript. Renvoyez un objet JSON comportant exactement quatre champs : root_cause (chaîne de caractères), replacement (chaîne de caractères contenant la fonction de remplacement complète), tests (tableau de chaînes de caractères représentant des cas de test) et remaining_risk (chaîne de caractères). N’indiquez pas que vous avez exécuté les tests. Effectuez la correction la plus simple et la plus claire possible qui respecte le contrat.

Contrat :
- `tasks` est un tableau de fonctions sans argument qui renvoient des promesses.
- Renvoie la première valeur résolue dans l'ordre d'entrée, même si cette valeur est 0, `false` ou une chaîne vide.
- Ignore les tâches rejetées.
- Renvoie `null` lorsque toutes les tâches sont rejetées ou que le tableau est vide.

Code actuel :
async function firstSuccessful(tasks) {
  const results = await Promise.all(tasks.map((task) => task()));
  return results.find(Boolean) || null;
}
Claude Haiku 4.5 : résultat opérationnel complet
Aucun résultat de modèle n'a été généré. Les deux tentatives autorisées via l'API Anywhere ont renvoyé un code HTTP 503 ; cette route a donc été marquée comme indisponible et exclue de l'évaluation de la qualité.
Claude Sonnet 5 : sortie maximale
```json
{
  "root_cause": "Two bugs: (1) Promise.all rejects immediately if any task rejects, instead of ignoring rejected tasks; (2) results.find(Boolean) incorrectly treats falsy fulfilled values (0, false, '') as failures, causing them to be skipped in favor of null.",
  "replacement": "async function firstSuccessful(tasks) {\n  const settled = await Promise.allSettled(tasks.map((task) => task()));\n  const firstFulfilled = settled.find((r) => r.status === 'fulfilled');\n  return firstFulfilled ? firstFulfilled.value : null;\n}",
  "tests": [
    "test('returns null for empty array', async () => { expect(await firstSuccessful([])).toBeNull(); });",
    "test('returns null when all tasks reject', async () => { const tasks = [() => Promise.reject('err1'), () => Promise.reject('err2')]; expect(await firstSuccessful(tasks)).toBeNull(); });",
    "test('returns first fulfilled value even if falsy (0)', async () => { const tasks = [() => Promise.resolve(0), () => Promise.resolve(42)]; expect(await firstSuccessful(tasks)).toBe(0); });",
    "test('returns first fulfilled value even if false', async () => { const tasks = [() => Promise.resolve(false), () => Promise.resolve(true)]; expect(await firstSuccessful(tasks)).toBe(false); });",
    "test('returns first fulfilled value even if empty string', async () => { const tasks = [() => Promise.resolve(''), () => Promise.resolve('nonempty')]; expect(await firstSuccessful(tasks)).toBe(''); });",
    "test('ignores leading rejected tasks and returns first fulfilled in order', async () => { const tasks = [() => Promise.reject('err'), () => Promise.resolve('second'), () => Promise.resolve('third')]; expect(await firstSuccessful(tasks)).toBe('second'); });",
    "test('preserves input order even if later task resolves faster', async () => { const tasks = [() => new Promise((res) => setTimeout(() => res('slow-first'), 50)), () => new Promise((res) => setTimeout(() => res('fast-second'), 5))]; expect(await firstSuccessful(tasks)).toBe('slow-first'); });"
  ],
  "remaining_risk": "The fix assumes 'first fulfilled value in input order' means the first task by array index that fulfills, regardless of timing, which matches the contract wording but await Promise.allSettled waits for all tasks to complete (including slow ones) before returning, which may not be desired if early-exit performance is needed; also unhandled promise rejection warnings are avoided by allSettled, but if tasks throw synchronously instead of returning rejected promises, this is not explicitly tested here beyond the reject cases."
}
```
Claude Opus 5 : puissance maximale
{
  "root_cause": "Two defects. (1) `Promise.all` rejects as soon as any task rejects, so a single rejected task makes the whole function reject instead of ignoring it and returning a later fulfilled value. (2) `results.find(Boolean) || null` selects by truthiness rather than by fulfillment, so legitimate fulfilled values such as 0, false, '', NaN, null, or undefined are skipped and/or coerced to null. Using `Promise.allSettled` plus a status check on the settled records fixes both, and returning `record.value` directly preserves falsy results.",
  "replacement": "async function firstSuccessful(tasks) {\n  const results = await Promise.allSettled(tasks.map((task) => task()));\n  const firstFulfilled = results.find((result) => result.status === 'fulfilled');\n  return firstFulfilled ? firstFulfilled.value : null;\n}",
  "tests": [
    "firstSuccessful([]) resolves to null (empty input).",
    "firstSuccessful([() => Promise.resolve('a'), () => Promise.resolve('b')]) resolves to 'a' (input order, not completion order).",
    "firstSuccessful([() => new Promise((res) => setTimeout(() => res('slow-first'), 50)), () => Promise.resolve('fast-second')]) resolves to 'slow-first' (order is by index, not by who settles first).",
    "firstSuccessful([() => Promise.reject(new Error('boom')), () => Promise.resolve('second')]) resolves to 'second' (rejection ignored, does not propagate).",
    "firstSuccessful([() => Promise.reject(new Error('a')), () => Promise.reject(new Error('b'))]) resolves to null (all reject).",
    "firstSuccessful([() => Promise.resolve(0)]) resolves to 0, not null (falsy number preserved).",
    "firstSuccessful([() => Promise.resolve(false)]) resolves to false (falsy boolean preserved).",
    "firstSuccessful([() => Promise.resolve('')]) resolves to '' (empty string preserved).",
    "firstSuccessful([() => Promise.resolve(undefined), () => Promise.resolve('later')]) resolves to undefined (first fulfilled wins even if its value is undefined).",
    "firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve(null), () => Promise.resolve('third')]) resolves to null because index 1 fulfilled with null — verifying null-as-value is not confused with the all-rejected sentinel by inspecting status.",
    "firstSuccessful([() => Promise.resolve(NaN)]) resolves to NaN (Number.isNaN on the result is true)."
  ],
  "remaining_risk": "The function still starts every task and awaits all of them, so there is no short-circuiting: a slow or never-settling later task delays or blocks the result, and side effects of later tasks always occur. A task that throws synchronously (rather than returning a rejected promise) will throw inside `tasks.map`, causing the returned promise to reject instead of being ignored; wrap the invocation in `Promise.resolve().then(task)` if that must also be tolerated. `null` is still returned both for all-rejected/empty input and when a task genuinely fulfills with `null`, so callers cannot distinguish those cases. Non-array or non-function inputs are not validated, and rejection reasons are discarded rather than aggregated (no AggregateError), which can hide diagnostics."
}
Claude Fable 5.1 : puissance maximale
{"root_cause":"Two defects: (1) Promise.all rejects as soon as any task rejects, so rejected tasks are not ignored and the function throws instead of skipping them; (2) results.find(Boolean) skips legitimate falsy fulfilled values (0, false, '') and the trailing '|| null' also converts such values to null, violating the requirement to return the first fulfilled value even when it is falsy.","replacement":"async function firstSuccessful(tasks) {\n const results = await Promise.allSettled(tasks.map((task) => task()));\n const first = results.find((result) => result.status === 'fulfilled');\n return first ? first.value : null;\n}","tests":["firstSuccessful([]) resolves to null","firstSuccessful([() => Promise.resolve('a'), () => Promise.resolve('b')]) resolves to 'a'","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve('b')]) resolves to 'b' and does not throw","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.reject(new Error('y'))]) resolves to null","firstSuccessful([() => Promise.resolve(0), () => Promise.resolve(5)]) resolves to 0","firstSuccessful([() => Promise.resolve(false), () => Promise.resolve(true)]) resolves to false","firstSuccessful([() => Promise.resolve(''), () => Promise.resolve('z')]) resolves to ''","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve(null)]) resolves to null (fulfilled null is returned as-is)","firstSuccessful([() => new Promise(r => setTimeout(() => r('slow'), 50)), () => Promise.resolve('fast')]) resolves to 'slow' (input order wins over settlement order)"],"remaining_risk":"All tasks are started concurrently and the function waits for every task to settle before returning, so a slow task delays the result even when an earlier task has already fulfilled; a sequential or early-exit strategy would be needed if latency matters. A task that throws synchronously (rather than returning a rejected promise) will still cause the function to reject, since the contract assumes tasks return promises. Promise.allSettled requires ES2020 or a polyfill."}
Politique de la « première sortie valide ». La latence correspond au temps réel via Anywhere, et non à la latence native Anthropic. Les nombres de jetons sont communiqués par le fournisseur ; aucun coût direct lié à l'API n'est déduit de cet itinéraire.
Ces résultats d'Anywhere montrent pourquoi le choix du modèle doit dépendre de la tâche à accomplir plutôt que d'un classement unique. Dans GlobalGPT, vous pouvez appliquer la même méthode de comparaison à votre propre prompt sur Claude et d'autres modèles de référence, puis choisir la sortie qui correspond le mieux à vos critères de qualité, à vos besoins en matière de rapidité et à votre charge de travail de révision.
Comment réaliser une comparaison équitable
Figer une tâche représentative. Utilisez les mêmes critères de vérification concernant l’intention, les sources, l’accès aux outils et l’acceptation des objectifs.
Enregistrez la première sortie valide. Ne donnez pas discrètement à un modèle des tentatives supplémentaires lors de la comparaison principale.
Il faut distinguer la qualité de la disponibilité. Les problèmes d'authentification, de capacité et d'acheminement doivent figurer dans une note de disponibilité, et non dans le score de qualité.
Évaluez l'ensemble du processus. Prendre en compte le temps écoulé, le temps consacré par les relecteurs, le temps de correction et le temps nécessaire à la résolution des tâches ayant échoué.
Choisissez le modèle de transmission le moins cher. Effectuez un nouveau test lorsque les consignes, les outils, les versions des modèles ou les coûts liés aux défaillances changent.
Le rôle de GlobalGPT
Le Anthropic remplace le Fable 5.1 pour les tâches exigeantes lorsque les évaluations Opus 5, pourtant plus poussées, s'avèrent encore insuffisantes.
Quels sont les modèles Claude actuellement disponibles ?
Au 8 septembre 2026, la gamme active de Anthropic comprend les modèles Claude Haiku 4.5, Claude Sonnet 5, Claude Opus 5 et Claude Fable 5.1. Les versions exactes et les identifiants de modèle pouvant varier, veuillez vérifier à nouveau la liste officielle des modèles avant le déploiement.
Quelle est la différence entre Claude Haiku, Sonnet et Opus ?
Haiku privilégie la vitesse et un faible coût de base en jetons, Sonnet offre un bon équilibre entre vitesse et performances pour les tâches quotidiennes, tandis qu’Opus privilégie les performances pour les tâches complexes ou à fort enjeu. Le choix approprié dépend de votre charge de travail et du coût de vérification, et non d’un classement absolu.
Quel modèle Claude dois-je utiliser pour la plupart des tâches ?
Commencez par Sonnet 5 pour la plupart des tâches quotidiennes : rédaction, analyse, programmation, compréhension visuelle et utilisation d'outils. Optez plutôt pour Opus 5 lorsque les erreurs ont un coût élevé ou lorsque le travail nécessite un raisonnement plus approfondi et une vérification plus rigoureuse.
Quel modèle Claude est le mieux adapté à la programmation ?
Sonnet 5 constitue un point de départ pratique pour le codage quotidien, avec des révisions et des tests réguliers. Utilisez Opus 5 pour les diagnostics difficiles, le codage agentique complexe, l'exécution à long terme ou les modifications dont les erreurs peuvent coûter cher.
Quel modèle Claude est le mieux adapté à l'écriture ?
Sonnet 5 constitue le point de départ équilibré pour la plupart des travaux de rédaction et de révision. Haiku 4.5 est adapté aux textes volumineux et très structurés, tandis qu’Opus 5 peut valoir la peine d’être testé pour les synthèses complexes ou les contenus à fort enjeu difficiles à vérifier.
Le format Claude Sonnet est-il meilleur que l'Opus ?
Ce n'est pas toujours le cas. Le modèle Sonnet 5 est plus rapide et moins cher aux tarifs de base de l'API, tandis que le modèle Anthropic permet à Opus 5 de traiter des tâches plus complexes. Le meilleur modèle est celui qui, parmi les options les moins chères, satisfait de manière fiable à vos propres critères d'acceptation.
Est-ce que Claude Fable va remplacer Opus ?
Le niveau Anthropic positionne le Fable 5.1 comme un niveau d’escalade destiné aux cas nécessitant un raisonnement complexe ou un travail de longue haleine de la part des agents, lorsque l’Opus 5, qui requiert davantage d’efforts, s’avère encore insuffisant, et non comme un substitut universel à l’Opus.
Est-ce que Claude.ai et l'API Claude partagent la même fenêtre de contexte ?
Les limites du forfait n° Claude.ai et les spécifications du modèle API sont distinctes. Le tableau des forfaits individuels du Anthropic indique actuellement une fenêtre de contexte de 200 000, tandis que la documentation de l'API mentionne une fenêtre de contexte de 1 million pour les forfaits Sonnet 5, Opus 5 et Fable 5.1.
Quand dois-je passer de Haiku à Sonnet ou à Opus ?
Passez à un modèle supérieur lorsque les échecs aux contrôles d'acceptation, les cas limites complexes, le temps de correction, l'effort de vérification ou le coût d'une erreur l'emportent sur les avantages du modèle inférieur en termes de vitesse et de coût par jeton. Revenez au modèle inférieur lorsqu'un modèle moins coûteux réussit de manière répétée les mêmes contrôles figés.
Combien coûtent les services Claude Haiku, Sonnet et Opus via l'API ?
Aux taux de base de Anthropic vérifiés le 8 septembre 2026, Haiku 4.5 coûte $1 en entrée et $5 en sortie, Sonnet 5 coûte $2 et $10, et Opus 5 coûte 1 TP41T5 et 1 TP41T25 par million de jetons. Voir les tarifs de Anthropic page officielle des tarifs pour connaître les tarifs en vigueur et les autres modes de tarification.
Verdict final : commencez par le modèle le moins cher qui répond aux critères
Pour une utilisation mixte générale, le Sonnet 5 reste le modèle par défaut le plus pratique ; c’est d’ailleurs le seul à avoir satisfait à toutes les contraintes de « launch-note » lors de notre test. Les modèles Opus 5 et Fable 5.1 ont égalé le score total de 26,5/30 obtenu par Sonnet grâce à des atouts différents, tandis que Haiku 4.5 n’a pas pu être noté car l’itinéraire « Anywhere » renvoyait une erreur 503 à chaque tentative autorisée. Considérez ces résultats comme des indications relatives à la charge de travail, et non comme un classement universel définitif.
La prochaine étape est simple : retenez une tâche concrète, définissez ce que constitue un résultat satisfaisant, testez chaque candidat sérieux dans des conditions comparables, et intégrez le temps de correction dans le coût final. Le modèle gagnant est celui qui, parmi ceux qui réussissent de manière fiable, est le moins coûteux, et non celui qui présente le taux de tokens le plus bas ou le nom de niveau le plus prestigieux.
GlobalGPT intègre cette méthode dans un flux de travail d'IA plus large et abordable. Utilisez Claude, GPT-5.6 Sol, Gemini 3 Pro, Kimi K3 et d’autres modèles de pointe dotés de multiples fonctions d’IA dans un tableau de bord unique, puis transférez le travail vers votre terminal, votre workflow de développement et vos outils de production existants via l’interface CLI de GlobalGPT. Les tests comparatifs vous aident à faire votre choix ; l'avantage principal réside dans le fait de maintenir l'intégralité du flux de travail connecté.
Nano Banana 2.1 vs Pro : comparez les publications, les graphiques, les images de produits et les modifications générés à partir d'une même consigne avec les tarifs officiels de l'API. Consultez les résultats avant de choisir un modèle.
GPT-6.1 Sol vs GPT-6 Astra : comparez les tarifs, le codage, le contexte, les outils et des exemples concrets de coûts afin de choisir le modèle OpenAI le mieux adapté à votre charge de travail.
Découvrez ce que signifie le mot-clé GPT « AI Motion Designer for After Effects » et comment GLBGPT utilise Yukie, le logiciel de montage vidéo, les prompts, les effets, les légendes, l'audio et les clips générés.
Découvrez comment créer des images pour votre blog à l'aide de l'IA, en vous appuyant sur des ressources actuelles, des tests pratiques, des limites clairement définies et un parcours plus sûr, de la première tentative à la mise en production.