
Réponse rapide : GPT-6 Luna est le modèle de OpenAI dédié aux tâches à haut volume. L'API officielle indique un coût de $0,10 par million de tokens d'entrée et de $0,50 par million de tokens de sortie aux tarifs Standard, avec une fenêtre de contexte de 1,05 million de tokens et une sortie maximale de 128 000 tokens. La question la plus importante à se poser avant l’achat est de savoir si ses réponses répondent aux exigences de votre tâche à un coût total acceptable.
OpenAI présente GPT-6 Luna comme son modèle le plus efficace pour les tâches ciblées et à haut volume. Cette affirmation relève du positionnement commercial du fournisseur et ne constitue pas un score de qualité mesuré. Cette analyse traduit les spécifications publiées en décisions d'achat et d'architecture, puis rend compte des réactions du public en citant leurs sources. Nous avons également exécuté trois petites tâches en conservant l’identifiant du modèle, le chemin d’accès, l’ensemble de prompts, la sortie brute et les informations d’utilisation. Les résultats de ces tâches sont présentés ci-dessous à titre d’exemple d’exécution observée, et non comme un benchmark officiel.
Avis rapide
Luna est l’option pragmatique et économique proposée dans la grille tarifaire officielle : elle conserve le même contexte général et les mêmes plafonds de sortie que Sol, tout en facturant une fraction des tarifs des jetons. Cela la rend particulièrement intéressante pour les appels ciblés et répétés, mais son faible prix ne garantit pas une latence moindre ni une qualité inférieure sans un test contrôlé.
La distinction la plus utile ne réside pas simplement dans l’opposition entre “ intelligent ” et “ rapide ”, mais dans la nature de la charge de travail. Le GPT-6 Luna présente les mêmes limites maximales en termes de contexte et de sortie que son homologue, mais son positionnement et son prix justifient un point de fonctionnement différent. Comparez la gamme plus large Guide de sélection des modèles d'IA et le Le meilleur modèle d'IA pour le codage guide à suivre lorsque la tâche implique plusieurs prestataires.
GPT-6 Luna en bref
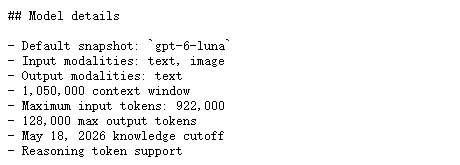
Le tableau ci-dessous reprend les données actuelles Page officielle du modèle GPT-6 Luna. La capacité contextuelle ne correspond pas à la taille recommandée pour la prompt, et la longueur maximale de l'entrée est indépendante de la fenêtre contextuelle de la rubrique.
gpt-6-lunaLes deux modèles apparentés prennent en charge les sorties structurées, l'appel de fonctions, le traitement en continu, la mise en cache des invites, l'entrée d'images, la recherche de fichiers et la recherche sur le Web, comme indiqué dans la liste des fonctionnalités documentées. Le comportement exact de l'outil dépend toujours de la configuration du point de terminaison, du compte et de la requête ; ne concluez pas qu'une exécution de l'outil a réussi simplement parce qu'une case à cocher indique que cette fonctionnalité est disponible.
En ce qui concerne le contexte familial, le Test de l'Astra GPT-6 montre comment un article connexe sur GPT-6 distingue la documentation du prestataire, les parcours sur la plateforme et les réactions attribuées.
Tarification de GPT-6 Luna et la règle des 272 000
Aux tarifs standard, le Page des tarifs OpenAI indique $0,10 d'entrée, $0,01 d'entrée mise en cache, $0,125 d'écritures dans le cache et $0,50 de sortie par million de tokens. Les écritures dans le cache représentent 1,25 fois le volume d'entrée non mise en cache. Les modes Batch et Flex sont facturés à 501 TP40T en mode Standard, le mode Fast est facturé au double du tarif applicable, et le traitement régional ajoute 101 TP40T lorsqu'il est disponible.
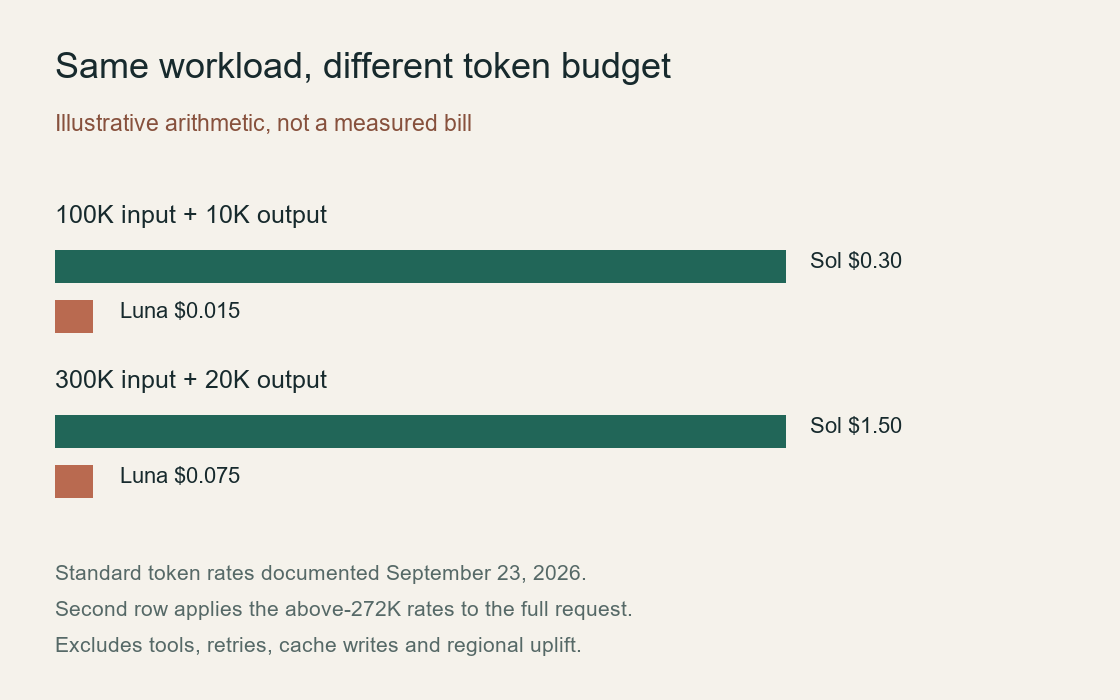
La colonne « Contexte long » est calculée selon la règle de OpenAI : au-delà de 272 000 entrées, les taux d’entrée et de cache doublent et la sortie est multipliée par 1,5 pour la requête complète. Il ne s’agit pas d’une facturation à taux mixte. À titre de référence pratique pour l’établissement d’un budget, 100 000 entrées plus 10 000 sorties coûtent environ $0.015 avant prise en compte des outils ou du relèvement régional ; un exemple avec 300 000 en entrée et 20 000 en sortie coûte environ $0.075 aux taux applicables aux contrats à long terme.
Une grande fenêtre de contexte peut s'avérer utile, même si elle n'est pas facile à remplir. La récupération, la sélection de blocs, la réutilisation du cache et les limites de sortie ont plus d'importance que le chiffre de 1,05 million annoncé. Voir le Détail des tarifs du GPT-6 Astra pour une explication complémentaire sur les seuils de contexte et le fonctionnement du cache.
GPT-6 Luna : adaptation à l'API, outils et limites
OpenAI recommande l'API Responses pour les outils intégrés et l'appel de fonctions. La fonctionnalité « Chat Completions » ne prend en charge l'appel de fonctions que lorsque effort_de_raisonnement est défini sur aucun. Il s'agit là d'un détail d'implémentation qu'il convient de prendre en compte avant la migration : une requête peut être syntaxiquement valide tout en ne correspondant pas au comportement de l'outil auquel s'attend votre intégration actuelle.
Le tableau actuel des limites de débit répertorie les niveaux standard suivants. RPM signifie « requêtes par minute », TPM signifie « jetons par minute » et la valeur « file d'attente » correspond à la limite de jetons par lot.
Avant le déploiement en production, vérifiez bien le niveau, le point de terminaison, le mode de diffusion et le contrat d'outil dans votre propre compte. Le Guide des limites d'utilisation du Codex Cela permet de mieux comprendre pourquoi le plafond publié d'un modèle ne correspond pas à la limite d'utilisation effective d'un compte.
Ce que laissent entrevoir les caractéristiques techniques du GPT-6 Luna
Il s'agit d'une carte d'adéquation, et non d'une référence. Utilisez le Guide du flux de travail des modèles d'IA tout-en-un lorsque votre véritable choix consiste à déterminer comment passer d’un modèle à l’autre au sein d’un même processus reproductible, plutôt que de choisir le modèle qui semble le plus convaincant.
Nos tests : GPT-6 Luna face à trois tâches concrètes
Le 23 septembre 2026, nous avons testé une petite correction JavaScript, une note de décision en trois points et l'extraction de données JSON. Les résultats présentés ci-dessous correspondent aux réponses complètes pour l'ID de modèle gpt-6-luna. Les tentatives précédentes ayant rencontré des erreurs temporaires de surcharge, ces résultats ne doivent pas être considérés comme des mesures de fiabilité issues d'une première tentative. Nous examinons ce que contiennent les réponses, ce qu'un lecteur peut réutiliser et ce qui n'a pas encore été testé.
Correction de code : conserver la valeur zéro sans réécrire la fonction
L'exercice de programmation consistait à diagnostiquer un bug, à proposer un correctif minimal et à réaliser deux tests de régression. Le résultat présenté correspond à la nouvelle tentative ; le libellé exact de la consigne n'est pas disponible.
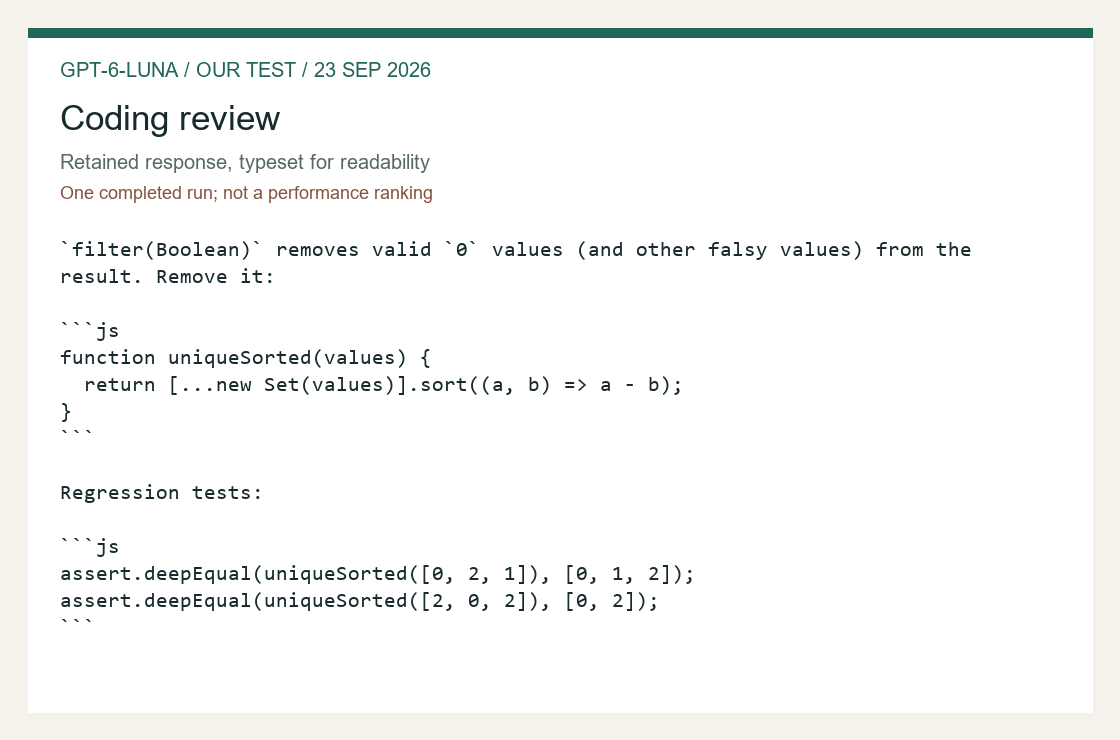
La fonction `filter(Boolean)` supprime les valeurs `0` valides (et les autres valeurs considérées comme fausses) du résultat. Supprimez-la :

```js
function uniqueSorted(values) {
  return [...new Set(values)].sort((a, b) => a - b);
}
```

Tests de régression :

```js
assert.deepEqual(uniqueSorted([0, 2, 1]), [0, 1, 2]);
assert.deepEqual(uniqueSorted([2, 0, 2]), [0, 2]);
```
Utilisation signalée pour cette réponse terminée : 61 jetons d'entrée, 317 jetons de complétion, 378 jetons au total. L'utilisation de la fonction de complétion peut inclure des jetons de raisonnement ; il ne s'agit pas simplement de la longueur de la réponse visible.
La réponse complète de Luna a correctement identifié que filtre(booléen) supprime les valeurs zéro valides et a supprimé cette opération finale. La réponse a conservé la déduplication basée sur les ensembles et le comparateur numérique existants. Pour un ticket de maintenance à portée restreinte, ce format de réponse est utile : une brève explication suivie de la fonction exacte. Il n'y a eu aucune refonte inutile de l'API, aucune nouvelle dépendance de bibliothèque, ni aucune modification de mise en forme sans rapport avec le sujet qui aurait pu masquer la correction.
Le problème d'intégration se situe au niveau des tests. Luna a utilisé assert.deepEqual deux fois, mais sans inclure d’importation d’assertion. Si l’on collait ces instructions dans un nouveau fichier Node.js, l’exécution échouerait avant même que l’une ou l’autre des assertions ne soit exécutée. Les assertions elles-mêmes ciblent des combinaisons pertinentes de zéro, de tri et de doublons, mais l’exemple n’est pas autonome. Ajoutez une importation d’assertion stricte ou adaptez les instructions à votre outil de test existant. Il s’agit d’une petite correction, mais elle illustre bien pourquoi une réponse codée plausible et un artefact prêt à l’exécution constituent des critères d’acceptation différents.
La réponse de codage conservée correspond à une nouvelle tentative. Une tentative précédente avait atteint sa limite de sortie de 900 tokens ; la nouvelle tentative, qui a abouti, a utilisé une consigne plus courte et une limite de 1 200 tokens. La formulation exacte de la nouvelle tentative n’ayant pas été conservée, nous ne présentons pas la consigne de codage d’origine comme si elle avait produit cette réponse. Cela empêche une comparaison directe et claire en termes de qualité ou de latence avec Sol. Cela fournit également une leçon pratique en matière de déploiement : enregistrez la version de la consigne et la raison de l’achèvement, et ne traitez jamais une réponse tronquée comme un correctif de code réussi.
Synthèse à trois notes : maintenir la décision conditionnelle
Synthétisez les trois notes suivantes en une note de décision concise comprenant : la décision, les éléments justificatifs, les risques et la prochaine étape. Note A : Une fenêtre de contexte de 1,05 million de tokens peut contenir de grands ensembles de données source, mais ne rend pas chaque requête peu coûteuse. Remarque B : au-delà de 272 000 tokens d’entrée, les taux d’entrée/de mise en cache documentés augmentent et le volume de sortie est multiplié pour la requête complète. Remarque C : la récupération et la réutilisation du cache peuvent réduire le coût des invites répétées, mais les critères d’acceptation doivent encore être testés.
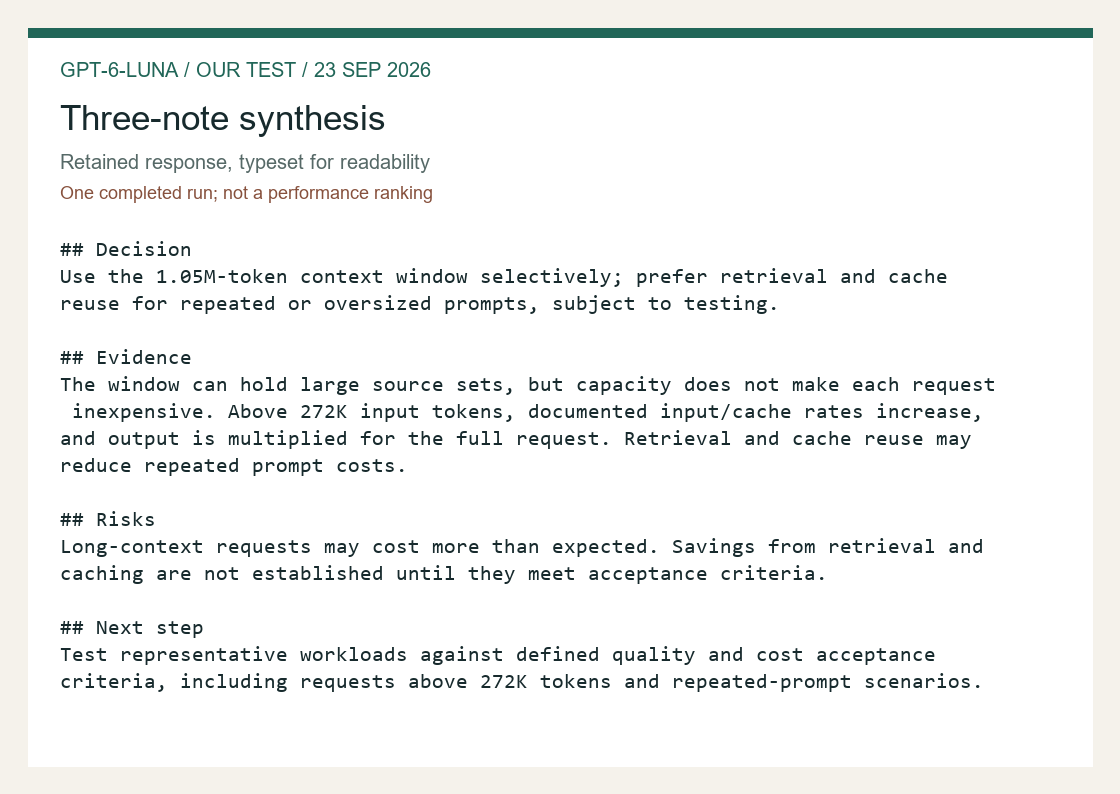
## Décision
Utiliser la fenêtre de contexte de 1,05 million de tokens de manière sélective ; privilégier la récupération et la réutilisation du cache pour les invites répétées ou trop volumineuses, sous réserve de tests.

## Justification
La fenêtre peut contenir de grands ensembles de données source, mais sa capacité ne rend pas chaque requête peu coûteuse. Au-delà de 272 000 tokens d’entrée, les taux d’entrée et de mise en cache documentés augmentent, et le volume de sortie est multiplié pour l’intégralité de la requête. La récupération et la réutilisation du cache peuvent réduire les coûts liés aux invites répétées.

## Risques
Les requêtes à contexte long peuvent coûter plus cher que prévu. Les économies réalisées grâce à la récupération et à la mise en cache ne sont confirmées qu’une fois les critères d’acceptation remplis.

## Prochaine étape
Tester des charges de travail représentatives par rapport à des critères d’acceptation définis en matière de qualité et de coût, y compris les requêtes supérieures à 272 000 tokens et les scénarios de prompts répétés.
Utilisation signalée pour cette réponse terminée : 99 jetons d'entrée, 223 jetons de complétion, 322 jetons au total. L'utilisation de la fonction de complétion peut inclure des jetons de raisonnement ; il ne s'agit pas simplement de la longueur de la réponse visible.
Luna a conservé les quatre sections demandées dans la note de synthèse et a subordonné sa recommandation à la réalisation de tests. Elle a maintenu la distinction entre la gestion d’un vaste ensemble de sources et son traitement à moindre coût. Elle a également précisé que les économies réalisées en matière de recherche et de mise en cache ne sont avérées que lorsqu’elles répondent aux critères d’acceptation. Cette prudence est utile pour les synthèses internes récurrentes, où une recommandation séduisante risque sinon de se transformer en une promesse non étayée après plusieurs cycles de réécriture.
La tâche comprenait trois courtes notes et seulement 99 tokens de prompt signalés. Qualifier cela de test de référence à long contexte reviendrait à exagérer la portée de ce qui s’est passé. La réponse montre que Luna est capable d'organiser un tout petit ensemble de données fournies lors de ce test ; elle ne démontre toutefois pas de capacité de rappel, de couverture des documents, de résistance aux instructions contradictoires, ni d'exactitude à proximité de la taille maximale d'entrée. Avant de l'utiliser pour des résumés récurrents, incluez des cas comportant des dates contradictoires et des propriétaires manquants, puis vérifiez si l'incertitude persiste dans la formulation finale.
Extraction JSON : garder les éléments inconnus explicites
Extrayez les champs suivants de ce brief et renvoyez uniquement un JSON valide contenant les clés « customer », « priority », « deadline » et « unknowns ». Brief : Client : Northwind Labs. Priorité : élevée. Date limite : 04/10/2026. Le responsable n'est pas nommé et le budget n'est pas confirmé.
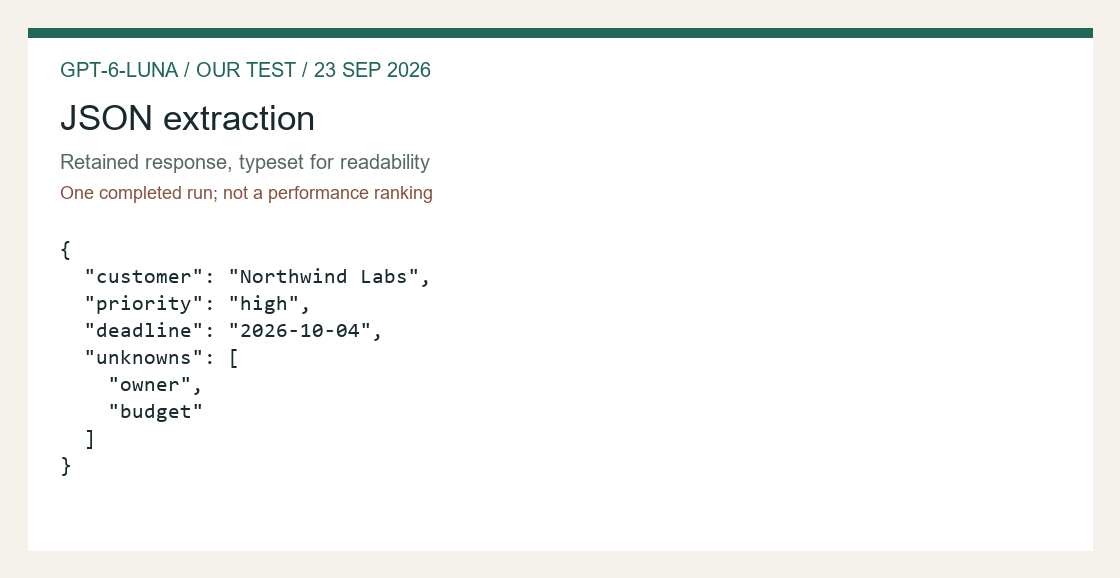
{"client" : "Northwind Labs", "priorité" : "élevée", "date limite" : "04/10/2026", "inconnues" : ["responsable", "budget"]}Utilisation signalée pour cette réponse terminée : 64 jetons d'entrée, 63 jetons de complétion, 127 jetons au total. L'utilisation de la fonction de complétion peut inclure des jetons de raisonnement ; il ne s'agit pas simplement de la longueur de la réponse visible.
Le résultat de l’extraction constitue, dans ce petit échantillon, l’argument concret le plus solide en faveur de l’utilisation de Luna pour des tâches ciblées et reproductibles. Le modèle a renvoyé un JSON valide contenant les clés demandées, a correctement copié « Northwind Labs » et la date limite au format ISO, et a conservé les champs « propriétaire » et « budget » sous forme de valeurs inconnues. Il n’y avait aucun préfixe conversationnel à supprimer. Sol a généré un JSON identique à partir de la même instruction d’extraction ; les données disponibles ne montrent donc pas d’avantage du modèle plus coûteux sur cet enregistrement.
La validité syntaxique n’est qu’une première étape. Un analyseur JSON acceptera sans problème un propriétaire fictif, un client erroné ou une date qui semble valide mais qui est incorrecte. Un schéma peut imposer des contraintes sur les champs et les types ; il ne peut pas prouver que le contenu est conforme à la source. Pour cela, la vérification des trois valeurs connues par rapport au cahier des charges et la confirmation que les deux champs manquants restent inconnus constituent le filtre sémantique. À grande échelle, il vaut mieux acheminer les conflits et les dates incertaines vers la révision plutôt que de les corriger en devinant.
Une validation qui va au-delà du JSON analysable
Ce qui suit est un exemple de validation éditoriale, et non une réponse supplémentaire du modèle. Il s'exécute localement sous Node.js et n'effectue aucune requête auprès du modèle. Il vérifie le test spécifique évoqué plus haut ; il ne s'agit pas d'une évaluation générale du modèle.
const assert = require('node:assert/strict');
const response = '{"customer":"Northwind Labs","priority":"high","deadline":"2026-10-04","unknowns":["owner","budget"]}';
const value = JSON.parse(response);
assert.deepStrictEqual(Object.keys(value).sort(), ['customer','deadline','priority','unknowns']);
assert.equal(value.customer, 'Northwind Labs');
assert.equal(value.priority, 'high');
assert.equal(value.deadline, '2026-10-04');
assert.deepStrictEqual(value.unknowns, ['owner', 'budget']);
console.log('Ce test correspond au cahier des charges. Les nouvelles entrées doivent avoir leurs propres valeurs attendues.');
Le validateur vérifie délibérément les données attendues ainsi que l’ensemble des clés. Il rejettera une réponse qui ajouterait un champ « owner » avec un niveau de confiance ou modifierait la date tout en restant un JSON valide. Ces valeurs précises appartiennent à ce test ; un validateur de production doit obtenir les attentes à partir du contrat d’entrée, et non pas coder en dur « Northwind Labs » pour chaque client. La validation du calendrier et l’autorisation de mettre à jour un enregistrement sont des vérifications distinctes. Réussir cet exemple signifie que la réponse obtenue correspond à ce cas de figure, et non que toutes les extractions futures seront correctes.
Comment GPT-6 Luna transforme un véritable flux de travail
Les caractéristiques techniques ne sont pertinentes que lorsqu’elles modifient le mode de fonctionnement d’une équipe. GPT-6 Luna est conçu pour des tâches ciblées et à haut volume ; la première question à se poser est donc de savoir si votre charge de travail tire parti de ce profil. Si chaque requête comporte une entrée courte, un contrat de sortie précis et un test d’acceptation clair, le modèle peut s’intégrer dans un pipeline reproductible. Si la tâche est ambiguë, nécessite l’utilisation de nombreux outils ou est susceptible de requérir plusieurs cycles de correction, l’orchestration globale est tout aussi importante que le nom du modèle.
Pour GPT-6 Luna, une méthode de production efficace consiste à suivre un processus en deux étapes : demander d’abord une réponse concise indiquant explicitement les incertitudes, puis ne transmettre que la partie contestée ou incomplète lors de la deuxième étape. Cela limite le gaspillage de tokens de sortie et rend les échecs visibles. Cela vous offre également un meilleur point de comparaison avec GPT-6 Sol : la question n’est pas de savoir quel nom semble le plus percutant, mais quelle méthode permet d’atteindre les critères d’acceptation avec le moins de tentatives possibles.
Un modèle de calcul des coûts simple avant l'expédition
Le barème officiel des tarifs doit être converti en unités réellement utilisées par votre équipe : requêtes par jour, nombre moyen de jetons d'entrée, part de préfixes mis en cache, jetons de sortie et pourcentage d'appels dépassant 272 000 jetons d'entrée. Un tableur qui ne prend en compte que le prix d'entrée affiché masque le multiplicateur lié au contexte à long terme et le coût des nouvelles tentatives.
Ce calcul est particulièrement pertinent lorsqu'on compare GPT-6 Luna à GPT-6 Sol. Une requête moins coûteuse peut s'avérer onéreuse si elle nécessite plusieurs cycles de correction ; à l'inverse, une requête plus performante peut s'avérer inutile lorsque la tâche consiste en une extraction déterministe. La référence appropriée est un petit échantillon de votre propre trafic, utilisant les mêmes prompts, le même schéma et la même règle de validation.
Modes de défaillance à vérifier avant la mise en service
Une page de modèle peut vous indiquer quels points de terminaison et quelles modalités sont documentés, mais elle ne peut pas garantir que votre application existante se comportera de la même manière après la migration. Vérifiez si les événements de streaming sont analysés correctement, si les appels aux outils conservent l'état d'une tentative à l'autre, si la sortie structurée rejette les champs mal formés et si votre pipeline de journalisation enregistre l'identifiant du modèle et le paramètre de raisonnement pour chaque requête.
Ces mêmes critères permettent de tirer parti des observations pratiques présentées dans cette analyse sans pour autant en faire un classement. Nos trois tests montrent comment la solution a géré un petit défaut de code, une note de décision et une extraction JSON rigoureuse. Ils ne permettent pas d’évaluer la latence, la fiabilité à grande échelle ni d’établir un classement universel en termes de qualité.
Un cadre décisionnel pour les équipes réelles
L'évaluation d'un modèle s'avère utile lorsqu'elle aide quelqu'un à prendre une décision dans un cadre de contraintes. Pour GPT-6 Luna, les contraintes les plus pertinentes sont la structure de la requête, le coût de l'évaluation, la taille du contexte, le format de sortie et les conséquences d'une réponse erronée. La description fournie par le fournisseur met l’accent sur des tâches ciblées et à haut volume, mais une équipe doit tout de même traduire cette description en un processus qu’elle peut suivre. Commencez par formuler la tâche en une seule phrase, en précisant les données d’entrée que le modèle recevra, la sortie attendue par un autre système, ainsi que le point de contrôle humain qui permet d’éviter une erreur silencieuse.
La première erreur consiste à choisir un modèle à partir d’une invite de démonstration. Une démonstration privilégie la fluidité et masque les détails opérationnels tels que les tentatives répétées, la gestion des jetons, les autorisations des outils et les échecs de schéma. Une meilleure comparaison repose sur trois tâches représentatives : une requête ordinaire, une requête difficile et une requête qui devrait être rejetée ou transmise à un niveau supérieur. Le résultat n’est pas un simple score. Il s’agit d’une petite carte indiquant où le modèle permet de gagner du temps, où il nécessite une supervision et où un autre modèle — souvent GPT-6 Sol — constitue la solution la plus économique ou la plus sûre.
Commencez par le test d'acceptation
Rédigez le test d'acceptation avant de rédiger la consigne. Pour le code, le test peut consister en un test unitaire réussi ou en un correctif qui ne modifie pas l'API publique. Pour l'extraction, il peut s'agir d'un fichier JSON valide contenant toutes les clés requises et préservant explicitement les valeurs inconnues. Pour une note de décision, il peut s'agir d'une structure fixe comprenant les éléments suivants : justifications, risques, responsable et prochaine étape. Le modèle ne peut être évalué que par rapport à une cible visible. Sans cette cible, un paragraphe soigné peut sembler abouti alors qu’il omet discrètement le seul champ dont le processus en aval a besoin.
Un bon test d’acceptation est suffisamment précis pour être exécuté automatiquement et suffisamment pertinent pour protéger l’utilisateur. Il doit également permettre de mettre en évidence les divergences. Si deux résultats diffèrent, l’équipe doit pouvoir identifier un fait manquant, une hypothèse non étayée, un champ mal formé ou un calcul erroné. Cela est plus concret que de dire qu’une réponse “ semblait plus pertinente ”. C’est également ce qui distingue une révision qui aide le service des achats d’une révision qui se contente de reprendre le discours de lancement.
Utilisez le nom du modèle pour choisir une hypothèse de départ. Utilisez votre test d'acceptation pour déterminer si cette hypothèse résiste à la mise en production.
Conception de messages qui correspondent au profil du modèle
La même consigne ne doit pas être copiée telle quelle d’un modèle à l’autre. Le contrat de tâche peut rester stable, mais la quantité de contexte, les instructions de raisonnement et les contraintes de sortie doivent correspondre à l’itinéraire. Pour GPT-6 Luna, veillez à ce que l’instruction système soit suffisamment concise pour ne pas faire concurrence au contenu source. Précisez le rôle, la règle de décision, le format de sortie requis et les conditions nécessitant une inconnue explicite ou une escalade.
Pour les documents volumineux, séparez l’extraction du jugement. Identifiez d’abord les passages qui répondent à la question ; demandez ensuite la conclusion en utilisant uniquement ces passages et les critères énoncés. Cela réduit le risque qu’une phrase affirmée soit construite à partir d’un détail éloigné et non pertinent. Cela permet également de faire de la fenêtre de contexte de 1,05 million de tokens un outil plutôt qu’une valeur par défaut. Un contexte étendu est utile lorsque la relation entre des éléments de preuve éloignés est importante. Il constitue un gaspillage lorsque la tâche peut être résolue à l’aide d’un petit ensemble bien sélectionné.
Pour les workflows utilisant des outils, décrivez la frontière entre le modèle et l’outil. Le modèle doit déterminer si un outil est nécessaire, fournir des arguments selon un schéma strict et expliquer ce qu’il fera de la valeur renvoyée. L'application doit appliquer les autorisations, valider les arguments, enregistrer l'appel et déterminer si un appel d'outil ayant échoué peut être réessayé. Considérer le modèle comme l'application dans son ensemble complique le débogage et augmente l'ampleur des répercussions d'une hypothèse erronée.
Une consigne réutilisable en quatre parties
Contexte : Ne fournissez que les faits et les documents nécessaires à la réalisation de la tâche. Objectif : Formulez la décision ou la transformation en une seule phrase. Contraintes : préciser le format, les exclusions, la gestion des incertitudes et les limites de l'outil. Vérifier : Demandez au modèle de répertorier les données manquantes ou les contradictions avant qu'il ne finalise sa réponse. Cette structure est suffisamment concise pour permettre des appels répétés et suffisamment explicite pour permettre une comparaison entre différents modèles.
Quand une grande fenêtre contextuelle s'avère utile
La limite de 1,05 million de tokens est facile à retenir, mais aussi à mal utiliser. Une fenêtre contextuelle vous indique la quantité de données pouvant tenir dans une requête ; elle ne vous indique pas la quantité de données à envoyer, dans quelle mesure le modèle exploitera chaque passage, ni le coût de la requête. Une requête volumineuse peut également ralentir la révision, car l'équipe a davantage de données à examiner et le risque de conflits subtils entre les instructions est accru.
Utilisez la fenêtre complète lorsque la tâche dépend réellement de références éloignées : un contrat dont les définitions sont séparées des exceptions, un référentiel où les interfaces et les implémentations sont très éloignées les unes des autres, ou une longue archive de recherche où la réponse nécessite de retracer une séquence. Utilisez la recherche rapide lorsque la question est locale, lorsque l'ensemble des sources change fréquemment, ou lorsque vous souhaitez disposer d'une piste de citation concise. Utilisez la mise en cache lorsqu’un préfixe stable est réutilisé dans de nombreuses requêtes et que la plateforme fournit suffisamment de détails d’utilisation pour prouver que le cache fonctionne.
Le seuil de 272 000 devrait figurer dans le schéma d’architecture, et non dans une note de bas de page du paragraphe consacré à la tarification. Une requête qui ne pose aucun problème en dessous de ce seuil peut devenir nettement plus coûteuse au-delà. Les équipes doivent consigner dans un journal les jetons d’entrée, les jetons mis en cache, les jetons de sortie, l’ID du modèle, les paramètres de raisonnement, ainsi que le fait que la requête ait ou non dépassé le seuil. Ce journal permet d’établir un modèle de coûts réel et de détecter toute inflation accidentelle du contexte avant qu’elle ne se traduise par une mauvaise surprise en fin de mois.
Questions relatives à la migration d'API qui justifient un test en environnement de préproduction
Avant de migrer une intégration existante vers GPT-6 Luna, créez un environnement de test permettant de reproduire un petit échantillon anonymisé. Comparez le texte final, les champs structurés, les appels d’outils, les raisons d’arrêt et l’utilisation des tokens. Ne vous contentez pas de comparer uniquement le premier écran de la réponse. Un modèle peut conserver la conclusion visible tout en modifiant le nom d’un champ, en omettant une condition d’erreur ou en renvoyant un argument d’outil que l’application ne peut pas exécuter en toute sécurité.
Les « réponses » et les « finalisations de chat » ne sont pas des libellés interchangeables dans un plan d’intégration. La prise en charge des points de terminaison, les paramètres de raisonnement, le comportement des outils, les événements en flux continu et les objets d’erreur ont tous une incidence sur l’adaptateur. Fixez l’identifiant du modèle dans la configuration, mais veillez à ce qu’il reste visible dans les journaux et les rapports de test. Lorsqu’une requête échoue, l’enregistrement doit indiquer le point de terminaison, le modèle, l’effort de raisonnement, la version de l’invite, la taille de la requête et la décision de réessayer. Ces informations permettent à un ingénieur de reproduire une défaillance au lieu de se demander si le modèle passait simplement une mauvaise journée.
Le traitement par lots modifie la rentabilité et le rythme opérationnel. Il peut convenir au classement nocturne, à la préparation de documents ou à une file d'attente de transformations peu urgentes. En revanche, il est peu adapté à une action interactive nécessitant une réponse destinée à l'utilisateur. Les modes « rapide » et « régional » modifient également le calcul des prix. Considérez-les comme des choix de configuration explicites et faites-en état dans la feuille de calcul du budget plutôt que de les dissimuler dans un paramètre par défaut.
Reproduisez les entrées représentatives, validez les résultats structurés, enregistrez les arguments de l'outil, comparez les raisons d'arrêt, mesurez l'utilisation des jetons et testez un scénario d'échec avant de modifier la valeur par défaut en production.
Qualité, sécurité et coût des contrôles
Un prix unitaire plus bas ne signifie pas automatiquement un coût total plus faible, et un modèle plus coûteux ne garantit pas automatiquement de meilleurs résultats commerciaux. Le coût total inclut les nouvelles tentatives, la vérification humaine, la gestion des incidents et le travail nécessaire pour corriger les données en aval. L’indicateur pertinent est le coût par résultat accepté, ventilé par famille de tâches. Une approche légèrement plus coûteuse par requête peut tout de même s’avérer avantageuse si elle réduit le travail de correction sur les tâches à fort impact ; une approche très économique peut s’imposer de manière décisive pour une extraction déterministe accompagnée d’une validation rigoureuse.
Le risque doit être classé en fonction de l'action, et non en fonction de la marque du modèle. La lecture d’un document public et la rédaction d’un résumé diffèrent de la modification d’un dossier client, de la validation d’un paiement, de la suppression de données ou de la publication d’une déclaration juridique. Les actions irréversibles doivent être soumises à un contrôle humain ou à une deuxième étape de validation indépendante. Demandez au modèle d’identifier les incertitudes, mais ne considérez jamais une phrase qui semble affirmer une certitude comme un système d’autorisation.
Les questions relatives à la confidentialité et à la durée de conservation doivent être abordées lors de l'examen du déploiement. Vérifiez quelles données sont transmises, pendant combien de temps les journaux sont conservés, qui peut consulter les invites, et si la requête contient des informations confidentielles ou à caractère personnel. Masquez les informations lorsque cela est possible, réduisez au minimum le contexte et conservez une trace claire des champs qui ont été supprimés. Ces mesures de contrôle s’appliquent que le modèle soit utilisé via une API officielle ou par un autre moyen compatible.
Comment comparer GPT-6 Luna et GPT-6 Sol
Une comparaison équitable consiste à maintenir constants la tâche et la règle d’acceptation, tout en permettant à chaque modèle d’exploiter ses atouts documentés. Exécutez le même paquet d’entrée, mais notez si un modèle nécessite un paramètre de raisonnement différent ou un point de terminaison différent. Exposez clairement les différences : l’un peut produire un correctif plus complet, un autre peut s’avérer moins coûteux pour des extractions répétées, et un troisième peut être plus facile à intégrer car son contrat d’outil correspond à votre adaptateur actuel.
Ne transformez pas une tâche réussie en classement général. Trois petites tâches sont utiles pour mettre en évidence des problèmes liés au flux de travail, et non pour désigner un gagnant universel. Répétez la tâche avec plusieurs données d'entrée réalistes, incluez au moins un cas contradictoire ou incomplet, et définissez à l'avance ce qui constitue un résultat satisfaisant. Si l'échantillon est trop petit pour étayer une conclusion, indiquez-le clairement. Cette limite renforce la confiance plutôt que d'affaiblir l'évaluation.
Un déploiement progressif qui permet de revenir sur la décision
Commencez par du trafic fictif ou une file d’attente non critique. Laissez le nouvel itinéraire générer une réponse tandis que l’itinéraire existant reste la référence. Comparez le taux d’acceptation, le coût en jetons, le temps de traitement et les catégories d’échec sur une période donnée. Passez ensuite à une famille de tâches à la fois, en conservant un commutateur de retour en arrière et une balise de version claire. Un déploiement par étapes transforme le choix d’un modèle en un changement technique observable, plutôt qu’en un remplacement effectué en une seule journée.
Lors du déploiement, soyez attentifs aux changements qui ne se reflètent pas dans un simple taux de réussite : des résultats plus longs, davantage d’appels d’outils, davantage d’escalades ou davantage de requêtes dépassant le seuil de contexte long. Un modèle peut sembler précis tout en consommant davantage de budget ou en alourdissant la charge de travail des opérateurs. Mettez en place des alertes pour ces critères et examinez-les avec les personnes qui gèrent concrètement les exceptions.
À quoi ressemble la réussite ?
La réussite, c'est un parcours stable dont le coût est connu, dont les causes d'échec sont identifiables et qui s'accompagne d'un processus de révision que chacun peut suivre. Il ne s’agit pas de prétendre que le modèle est parfait. Il s’agit de savoir quelles tâches il gère bien, quelles tâches nécessitent une autre approche, et comment l’arrêter ou le corriger lorsque les données d’entrée sont incomplètes. Telle est la norme pratique qui sous-tend les observations et la documentation rassemblées dans cette analyse.
Ce que les réactions du public peuvent et ne peuvent pas vous révéler
Les sources suivantes sont présentées à titre de réactions du public, et non comme des documents officiels ou des données de référence validées. Leurs titres indiquent ce que chaque auteur a choisi de tester ou d’expliquer ; ils ne constituent pas un résultat représentatif de l’ensemble du marché.
- Chase AI : Les GPT 6 Sol et Luna sont enfin là (et le 50% est moins cher !). Considérez le cadre et toute démonstration comme l'expérience de ce créateur, et non comme une vérité universelle.
- Rob, le spécialiste de l'IA : ChatGPT a lancé GPT-6 Sol et GPT-6 Luna (nouveaux modèles et agents ChatGPT). Considérez le cadre et toute démonstration comme l'expérience de ce créateur, et non comme une vérité universelle.
- L'IA avec Surya : GPT-6 Soul, Luna ou Claude Opus 5.5 : lequel choisir ?. Considérez le cadre et toute démonstration comme l'expérience de ce créateur, et non comme une vérité universelle.
Une autre question relative à la dénomination se pose ici : plusieurs vidéos publiques utilisent indifféremment les termes “ GPT-6 ” et “ GPT-5.6 ” dans leurs titres. Veillez à indiquer clairement l'identifiant exact du modèle lorsque vous reprenez une affirmation. Le Comparaison entre le GPT-6 Astra et le GPT-5.6 Sol C'est un exemple utile qui illustre pourquoi l'identité du fournisseur, le nom de la plateforme et l'itinéraire doivent être enregistrés séparément.
Comment accéder à GPT-6 Luna
Ouvrir le Espace de travail GPT-6 Luna Commencez par une tâche que vous pouvez évaluer : un petit exemple de code, un petit paquet de code source ou un cahier des charges d'extraction structuré. Gardez à l'œil le résultat attendu et les critères d'acceptation lorsque vous comparez les différentes versions. Les tarifs officiels des jetons indiqués ci-dessus concernent l'utilisation directe de l'API et ne constituent en aucun cas une promesse concernant les crédits d'espace de travail ou les quotas d'abonnement.
Pour en savoir plus sur la nomenclature actuelle des plateformes et le contexte des crédits distincts, consultez le Guide des tarifs GPT-5.6 et le Comparaison des modèles GPT-5.6. Ces pages fournissent des informations sur la plateforme et le contexte éditorial ; elles ne prévalent pas sur le tableau des tarifs de l'API de OpenAI.
Choisissez une tâche représentative et comparez le résultat à vos propres critères d'acceptation.
Ouvrir l'espace de travail GPT-6 LunaÀ qui s'adresse le GPT-6 Luna ?
Si votre sélection comprend des alternatives moins onéreuses, comparez les catalogue de modèles plus complet plutôt que de partir du principe que le modèle le plus récent est automatiquement le plus intéressant. Si vous évaluez des tâches impliquant un volume important de données, le Guide sur les modèles d'analyse de données propose une approche distincte axée sur les flux de travail.
Foire aux questions
Qu'est-ce que GPT-6 Luna ?
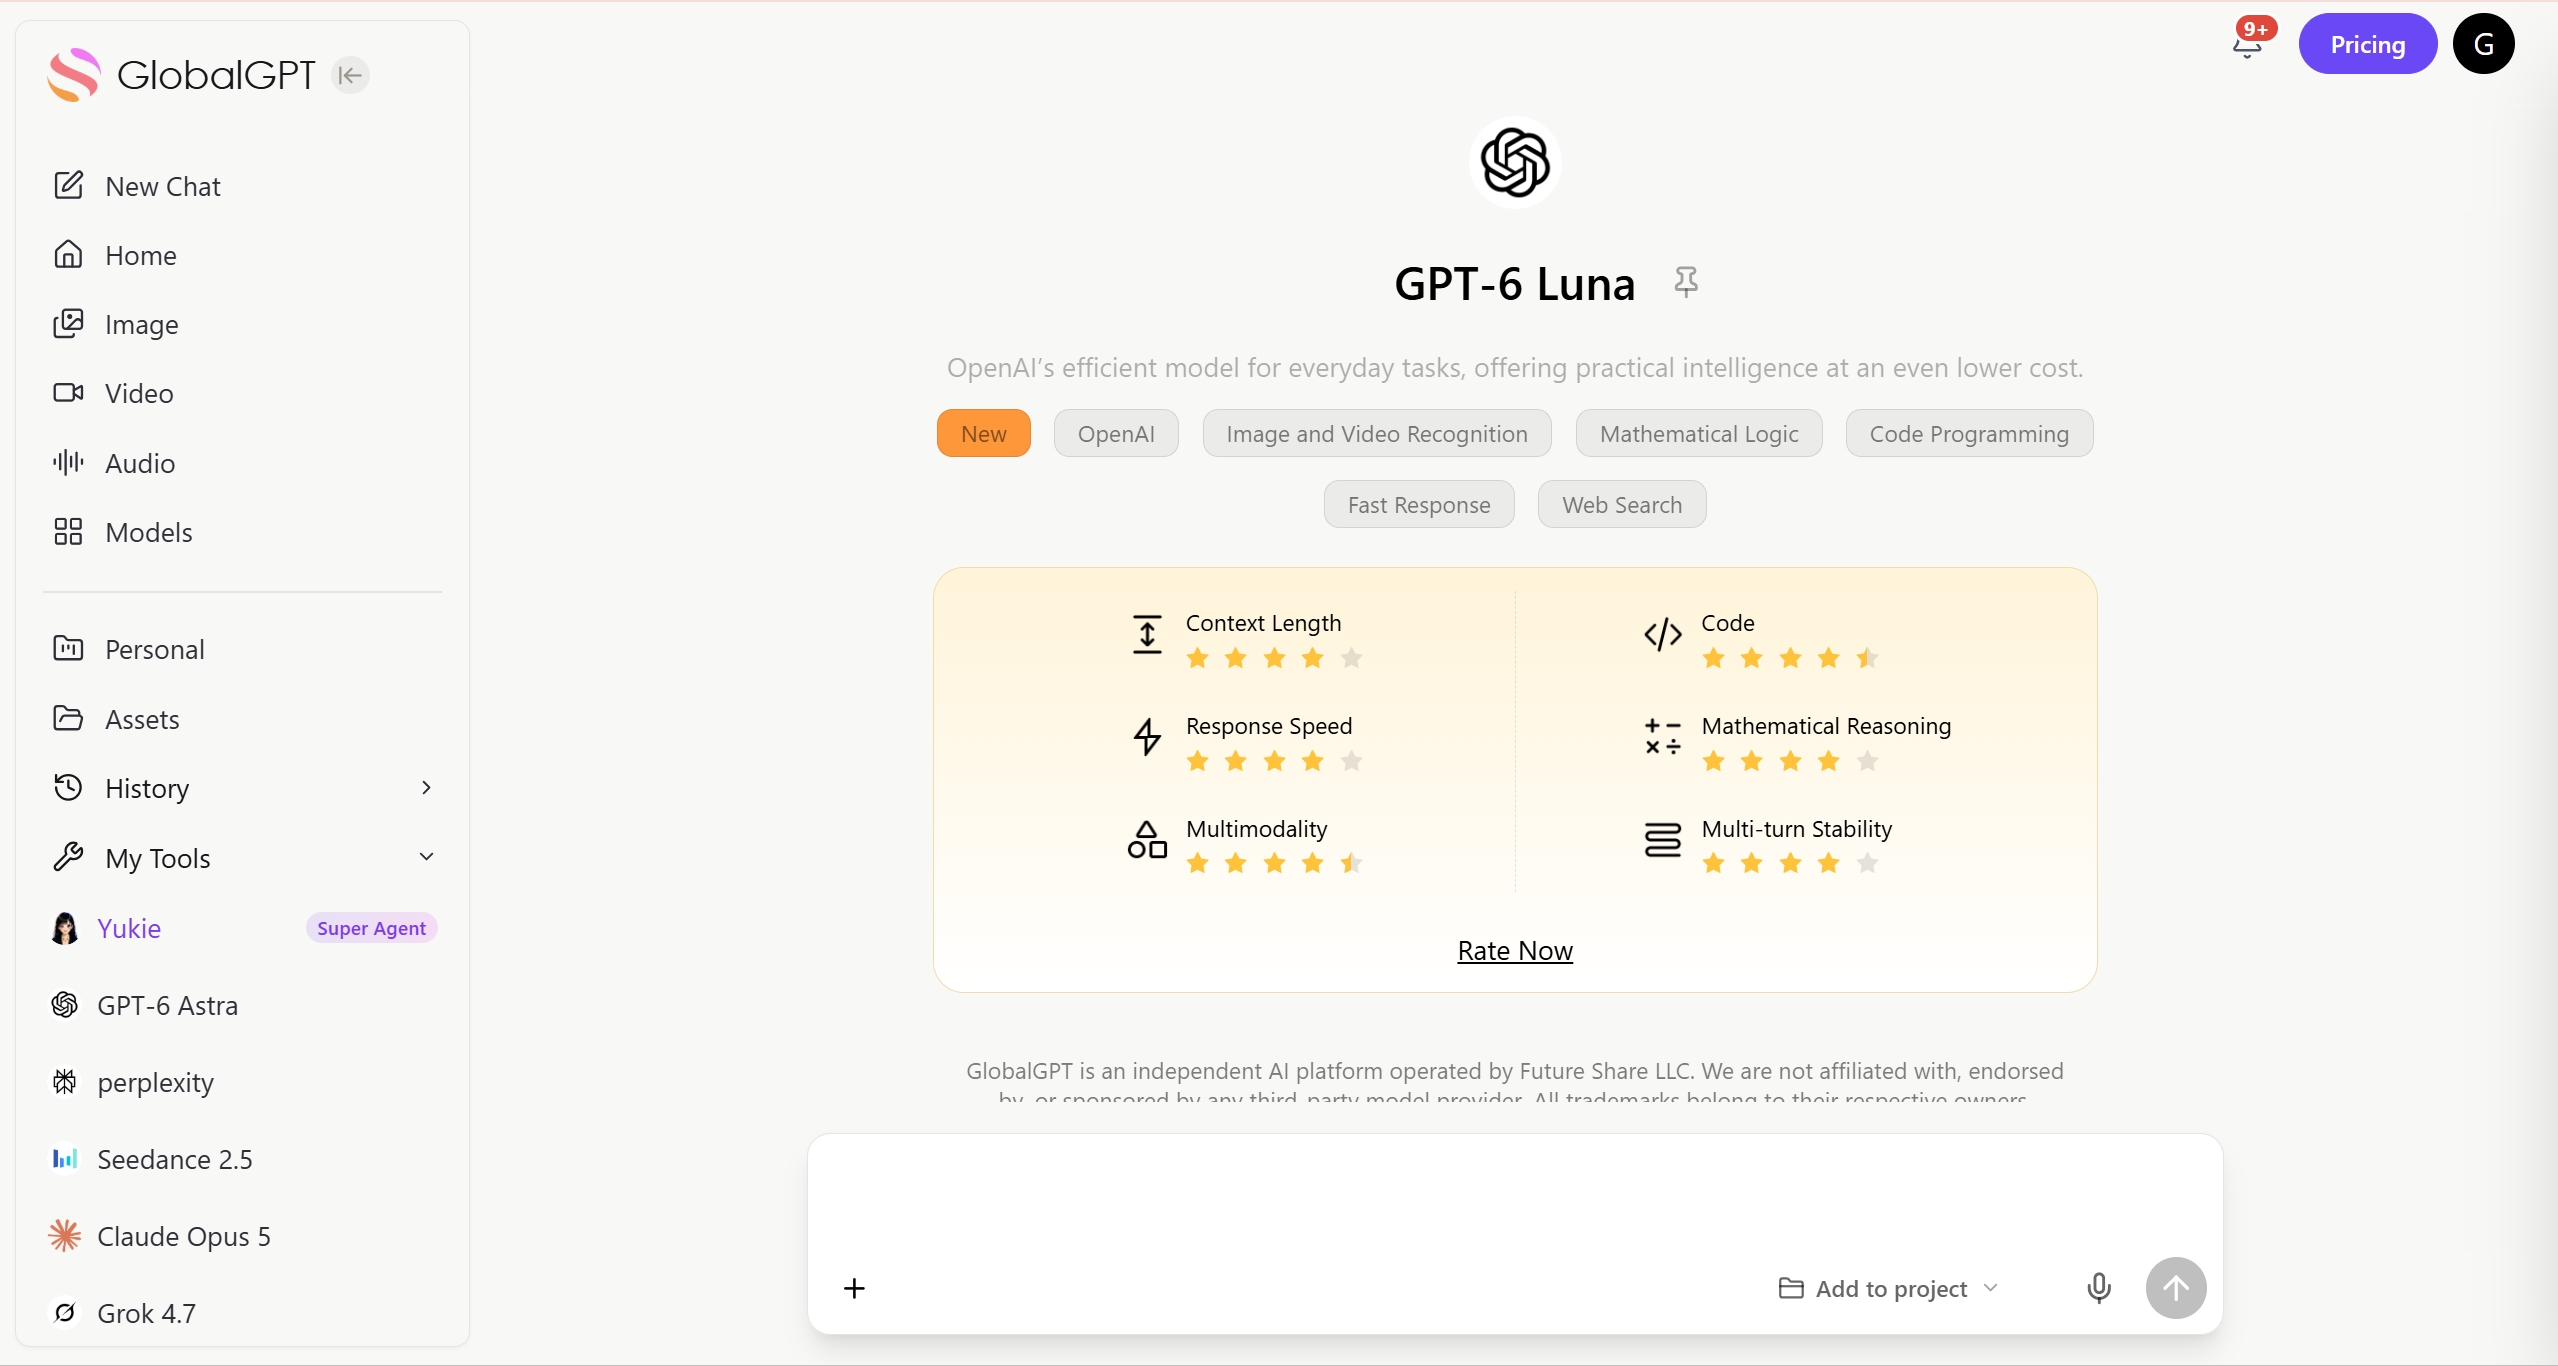
GPT-6 Luna est le modèle de OpenAI dédié aux tâches ciblées à grand volume. Son identifiant officiel de modèle API est gpt-6-luna.
Combien coûte le GPT-6 Luna ?
OpenAI indique que GPT-6 Luna coûte $0,10 par million de tokens d'entrée, $0,01 par million de tokens d'entrée mis en cache, $0,125 par million d'écritures dans le cache, et $0,50 par million de jetons de sortie, aux tarifs Standard.
Que se passe-t-il lorsque le nombre de jetons d'entrée dépasse 272 000 ?
Lorsqu'une requête dépasse 272 Ko de tokens d'entrée, OpenAI applique des taux d'entrée et de mise en cache multipliés par 2, ainsi que des taux de sortie multipliés par 1,5, à l'ensemble de la requête.
Quelles sont les limites de contexte et de sortie ?
GPT-6 Luna présente une fenêtre de contexte de 1 050 000 tokens, une entrée maximale de 922 000 tokens et une sortie maximale de 128 000 tokens.
Quel est le seuil de connaissances requis ?
La page actuelle du modèle OpenAI indique que la date limite de mise à jour des connaissances pour GPT-6 Luna est le 18 mai 2026.
Quels sont les paramètres de raisonnement disponibles ?
L'API documente les niveaux d'effort de raisonnement suivants : « none », « low », « medium », « high », « xhigh » et « max », la valeur par défaut étant « medium ».
Quels sont les points de terminaison API pris en charge ?
GPT-6 Luna prend en charge les fonctionnalités « Chat Completions », « Responses » et « Batch ». La page du modèle ne mentionne pas parmi les fonctionnalités prises en charge : le temps réel, les assistants, l'audio, la vidéo, la génération d'images, les embeddings, le fine-tuning, la modération ni les anciennes versions de « Completions ».
GPT-6 Luna peut-il accepter des images ?
Oui. La page du modèle mentionne une entrée sous forme de texte et d'image, avec une sortie sous forme de texte. Cela ne signifie pas pour autant qu'il s'agisse d'un modèle de génération d'images.
Le modèle GPT-6 Luna est-il disponible dans la version GlobalGPT ?
Utilisez la page dédiée au modèle GPT-6 Luna dont le lien figure ci-dessus. Les crédits Workspace et les quotas des forfaits sont distincts des tarifs directs liés aux jetons API décrits dans cette analyse.
Cet article contient-il un test de performance ?
Il s'agit de trois observations portant sur des tâches de petite envergure, et non d'un test comparatif contrôlé. Luna a eu besoin d'une consigne de programmation révisée lors de la nouvelle tentative. Ces résultats ne permettent pas de désigner un gagnant incontestable ni d'évaluer les performances à grande échelle.
Verdict final
Luna est l’option pragmatique axée sur les coûts figurant dans la grille tarifaire officielle : elle conserve le même contexte général et les mêmes plafonds de débit que Sol, tout en facturant une fraction des tarifs des jetons. Cela la rend particulièrement intéressante pour les appels ciblés et répétés, mais son faible prix ne garantit pas une latence plus faible ni une qualité inférieure sans un test contrôlé. Faites votre choix en fonction des rendements acceptables et du coût total d'exploitation, puis réévaluez-le lorsque votre charge de travail évoluera.
Vérifié le 23 septembre 2026. Informations officielles : OpenAI Developers. Dénomination officielle de l'itinéraire : GlobalGPT. Réaction du public : liens vers les créateurs et les publications, avec mention de la source uniquement.









