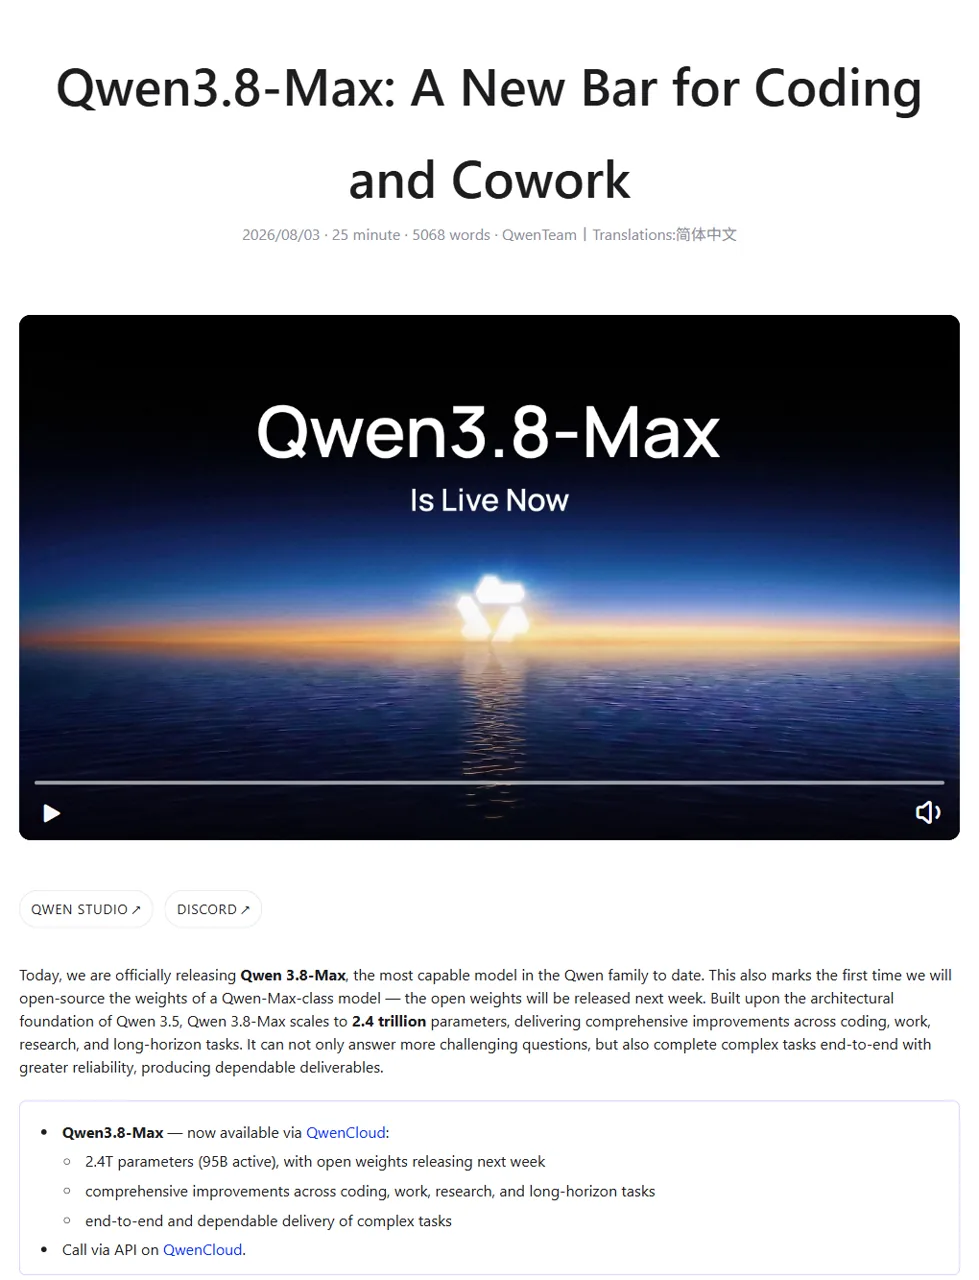
El Qwen 3.8 Max es el nuevo modelo insignia de Alibaba Qwen para programación, trabajo profesional, agentes de ejecución prolongada y tareas multimodales. Su nombre oficial es Qwen3.8-Max, se anunció el 3 de agosto de 2026 que contaba con un total de 2,4 billones de parámetros, 95 000 millones de parámetros activos y una ventana de contexto de 1 millón de tokens.
Este lanzamiento va más allá de una simple actualización rutinaria de los parámetros de referencia. Qwen posiciona el modelo como un agente capaz de planificar, utilizar herramientas, analizar la información visual y seguir trabajando a lo largo de largas cadenas de tareas, y no solo como un chatbot que responde a una pregunta cada vez. Esto lo sitúa en el mismo segmento de mercado que el los mejores modelos de IA para el trabajo real, pero conviene analizar con más detenimiento su precio de la API, su plan de peso abierto y sus requisitos de implementación antes de cambiar.
¿Qué es Qwen3.8-Max?
Qwen3.8-Max es un modelo de «mezcla de expertos» a gran escala desarrollado por el equipo Qwen de Alibaba. Cuenta con un total de 2,4 billones de parámetros, pero activa 95 000 millones de parámetros por cada token. El modelo combina texto, código, comprensión visual, uso de herramientas y planificación a largo plazo en un único sistema diseñado para llevar a cabo tareas complejas de principio a fin.
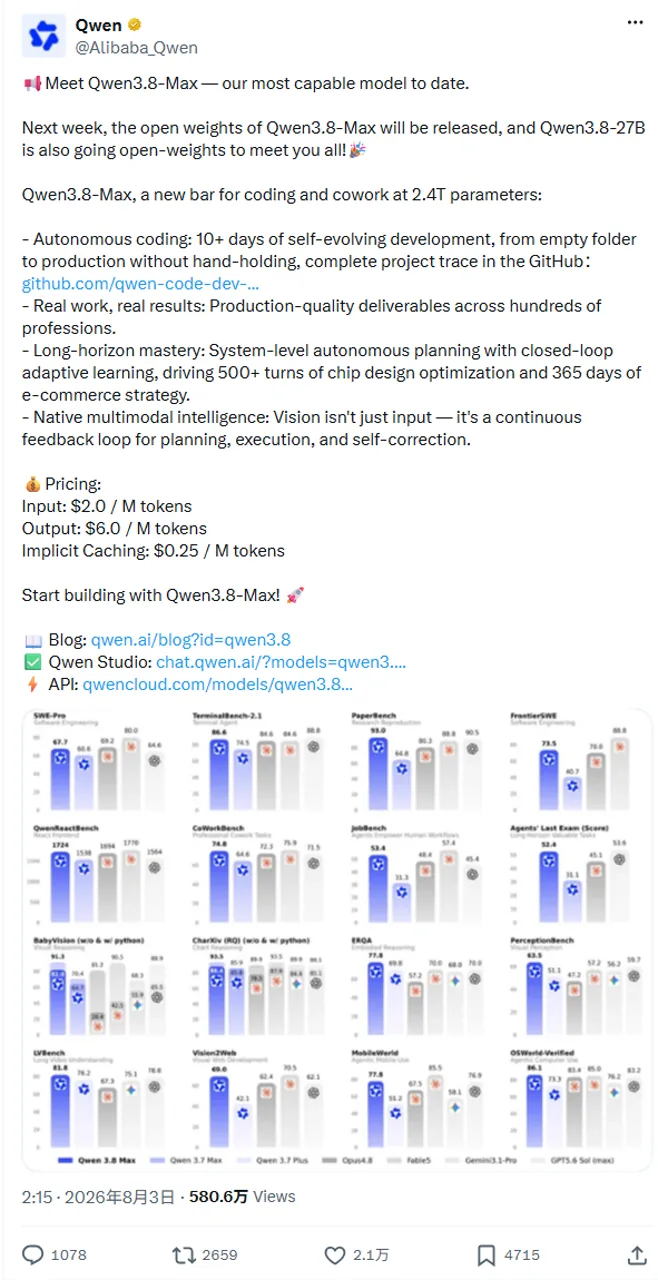
En Lanzamiento oficial de Qwen describe cuatro objetivos fundamentales: una codificación autónoma más sólida, resultados profesionales con calidad de producción, tareas de ciclo cerrado más prolongadas y agentes multimodales nativos. En la práctica, Qwen pretende que el modelo pase de “responder a esta pregunta” a “tomar este objetivo, elaborar un plan, utilizar las herramientas disponibles, comprobar el resultado y continuar hasta que el trabajo esté terminado”.”
Qwen 3.8: Especificaciones máximas
El recuento de parámetros debe interpretarse en su contexto. Un modelo de 2,4 billones de parámetros es enorme, pero Qwen3.8-Max no utiliza todos los parámetros para cada token. Su diseño de «mezcla de expertos» dirige cada token a través de una parte activa más reducida de la red. Por lo tanto, la cifra de 95 000 millones de parámetros activos resulta más útil para comprender el comportamiento de la inferencia que el recuento total por sí solo, aunque ninguna de estas cifras indica por sí misma la latencia real ni los requisitos de hardware.
La ventana de contexto de un millón de tokens resulta más útil de forma inmediata. Permite almacenar repositorios de gran tamaño, conjuntos de documentos extensos, historiales detallados de agentes o meses de registros operativos en una sola solicitud. Aunque esto no garantiza una recuperación perfecta de todos y cada uno de los tokens, ofrece a los desarrolladores mucho más margen para conservar instrucciones, resultados de herramientas, código y decisiones intermedias sin necesidad de realizar recortes drásticos.
¿Qué puede hacer el Qwen3.8-Max?
Codificación autónoma
Los materiales de presentación de Qwen hacen hincapié en proyectos que van mucho más allá de una simple solicitud de generación de código. La empresa describe un desarrollo autónomo que dura más de 10 días, pasando de una carpeta vacía a un proyecto en producción, al tiempo que se adapta a los errores y a los nuevos requisitos. Esa es la dirección correcta para los agentes a escala de repositorio, aunque los compradores deben seguir validando el modelo con sus propios lenguajes, conjuntos de pruebas, normas de seguridad y entorno de implementación.
En el día a día de la ingeniería, las cuestiones prácticas son más sencillas: ¿Es capaz el modelo de procesar varios archivos a la vez? ¿Conserva las interfaces durante la refactorización? ¿Escribirá pruebas, analizará los errores y corregirá su propio parche? Esos criterios son más importantes que una puntuación en una clasificación a la hora de elegir el mejor modelo de IA para codificación.
Tareas profesionales de “cowork”
El término “cowork” hace referencia a los resultados del trabajo, más que a una charla informal. Qwen destaca informes, investigaciones, presentaciones, análisis, documentos y otros productos finales de cientos de profesiones. Un buen modelo de «cowork» debe seguir unas instrucciones concisas, organizar las pruebas, utilizar el formato adecuado y ofrecer un resultado que la persona pueda editar o presentar, no solo un párrafo verosímil.
Agentes con horizonte temporal amplio
Qwen también informa de tareas a nivel de sistema que se prolongan durante cientos de turnos. Entre sus ejemplos se incluyen más de 500 turnos de optimización del diseño de chips y una simulación de estrategia de comercio electrónico de un año de duración. Se trata de demostraciones de los proveedores, no de una promesa de que todos los agentes funcionarán sin supervisión durante días. Sin embargo, sí muestran cuál es el objetivo del producto: planificación persistente, evaluación en bucle cerrado y mejora continua, en lugar de respuestas aisladas.
Planificación multimodal y retroalimentación visual
Qwen3.8-Max trata las imágenes y las pantallas como parte del ciclo del agente. Un agente visual puede examinar una página, elegir una acción, observar qué ha cambiado y revisar su plan. Esto facilita tareas relacionadas con el uso del ordenador, la comprensión de documentos, las pruebas de interfaces, la programación visual, los gráficos y el razonamiento espacial. Lo difícil no es simplemente reconocer una imagen, sino mantener las observaciones visuales vinculadas al objetivo del agente a lo largo de numerosos pasos.
Pruebas prácticas: resultados útiles, respuestas lentas y una ejecución sin datos
He ejecutado tres solicitudes independientes en el qwen3.8-max ID del modelo a través de la API compatible con Anywhere OpenAI el 4 de agosto de 2026. Se trata de pequeñas comprobaciones prácticas, no de una evaluación comparativa independiente ni de una afirmación sobre todas las implementaciones de Qwen. Son útiles porque muestran tanto la calidad de la respuesta visible como el comportamiento de la ruta de la pasarela sometida a prueba.
Depuración de Retry-helper
La primera tarea utilizaba una función de reintento defectuosa procedente de un escenario de webhook de pago. La indicación limitaba al modelo a tres intentos, dos retrasos de retroceso exactos, una salida inmediata en caso de éxito y la reactivación de la tercera excepción tras un fallo total.
La respuesta identificó tres defectos distintos: un «sleep» incondicional tras cada intento, un resultado tras las excepciones, y una comprobación de «veracidad» que retrasaba o gestionaba incorrectamente el éxito. La línea esperada era "paid" con los argumentos [0,1; 0,2] de sleep_fn.
Entonces ejecuté el código localmente, en lugar de fiarme de la explicación. Superó tres casos: dos fallos seguidos de un éxito, un valor de éxito «falsy» en la primera llamada de 0, y tres fallos en los que el resultado final RuntimeError("failure-3") Hubo que volver a enviarla. Fue una buena solución desde el punto de vista de la ingeniería. La contrapartida fue la latencia: la respuesta visible tardó 51,577 segundos en llegar a través de la pasarela sometida a prueba.
Síntesis de pruebas contradictorias
La segunda tarea consistía en comprobar si el modelo era capaz de distinguir los datos oficiales actuales de las notas antiguas, las afirmaciones de los proveedores, un comentario de la comunidad y una ruta de la plataforma no verificada.
El modelo gestionó correctamente el conflicto simulado. No repitió el contexto de 256K ni el precio de entrada de $1.20 como actual, no convirtió un comentario sobre cuatro GPU en un requisito de hardware y no afirmó que GlobalGPT ya contara con una ruta dedicada Qwen3.8-Max. Además, etiquetó la tabla oficial de pruebas de rendimiento como «facilitada por el proveedor». La respuesta tardó 94,973 segundos, por lo que se trató de otro resultado en el que primó la calidad frente a la rapidez de la extracción.
¿Qué falló en la prueba de planificación?
Una tercera solicitud pedía un plan de migración al CMS de dos horas, a cargo de dos ingenieros, con puntos de control explícitos de «seguir adelante» o «no seguir adelante» y de reversión. La primera solicitud finalizó tras 133,682 segundos, cuando se cerró la conexión de origen. Un conjunto de reintentos más corto max_completion_tokens a 1.200, pero la API indicaba motivo_finalización: "longitud", agotó todo el presupuesto de razonamiento y no devolvió ninguna respuesta visible tras 32,899 segundos.
Se trata de una advertencia operativa útil, pero no es una prueba de que Qwen3.8-Max no pueda planificar migraciones. No había ningún plan disponible para evaluar. A través de esta pasarela, la planificación compleja requiere un margen de finalización mayor, el procesamiento por flujos o una indicación por etapas, de modo que el razonamiento interno no agote todo el presupuesto de respuesta antes de que se emita el texto visible.
Qwen: 3,8. Resultados máximos en pruebas de rendimiento
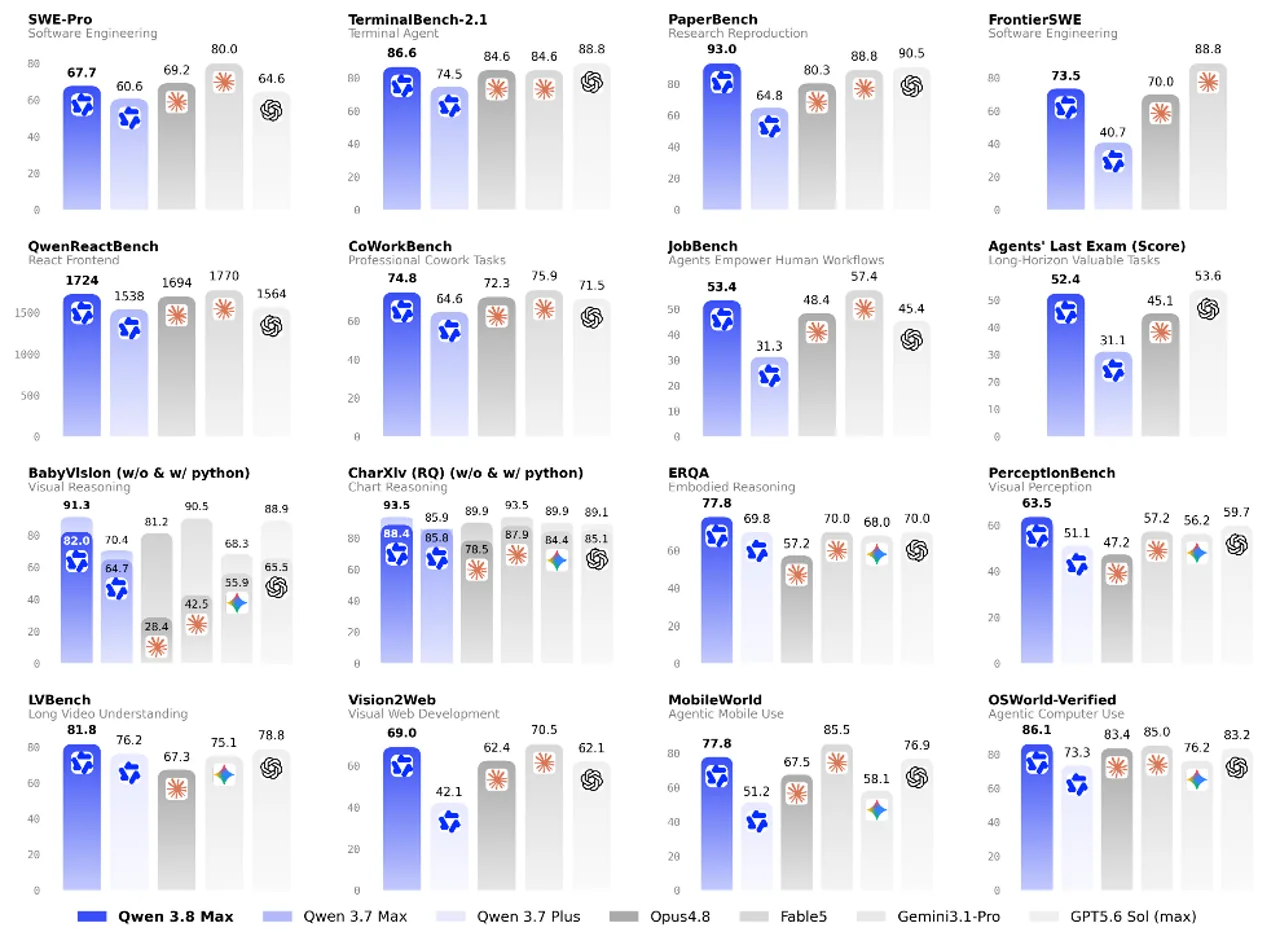
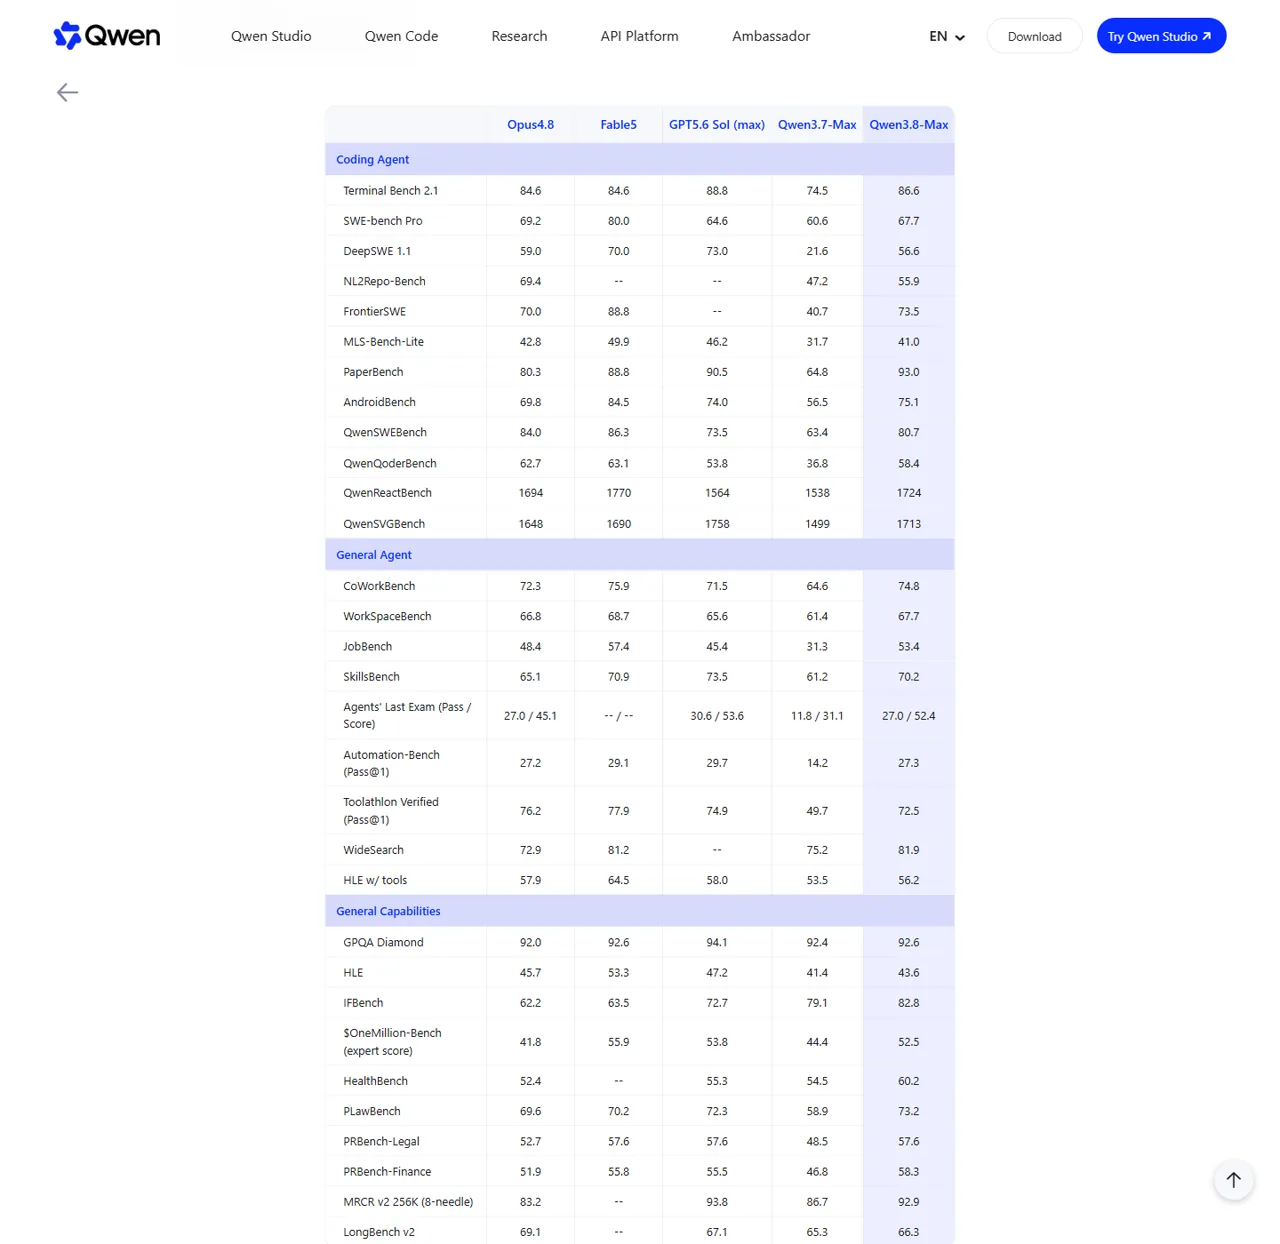
El paquete de pruebas de referencia oficial de Qwen presenta a Qwen3.8-Max como un agente multimodal y de codificación potente, pero los resultados son dispares, en lugar de ser un triunfo rotundo. Lidera los modelos incluidos en algunas pruebas, se sitúa cerca del líder en otras y queda por detrás de GPT-5.6 Sol o Fable 5 en varias categorías. Se trata de una interpretación más equilibrada que la de reducir docenas de pruebas a una única etiqueta de “mejor modelo”.
Resultados seleccionados de la clasificación oficial de la Qwen
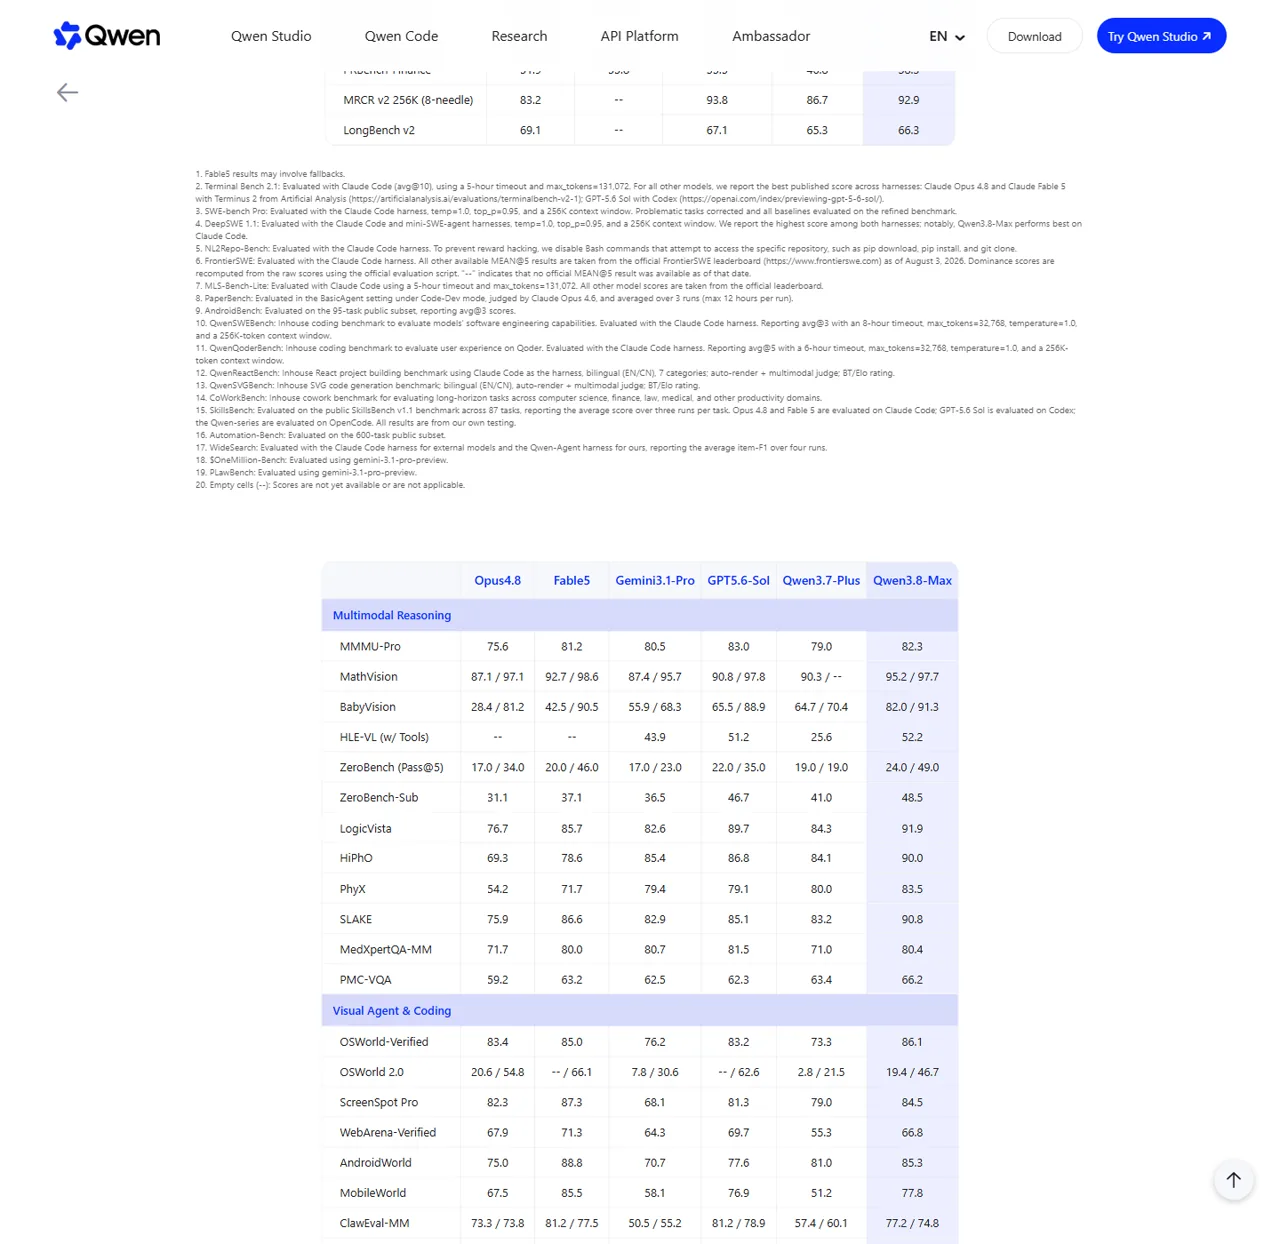
Estas cifras proceden de los propios materiales de presentación de Qwen. Las notas a pie de página indican que la tabla combina informes oficiales de los modelos, fichas del sistema, clasificaciones públicas y evaluaciones internas de Qwen. Los arneses y los ajustes también varían entre algunos modelos. Utiliza la tabla para identificar los puntos fuertes más prometedores y, a continuación, comprueba la lista de candidatos preseleccionados por tu cuenta antes de tomar una decisión que implique un coste elevado.
Qué significan los resultados de la codificación
La ventaja más evidente es el equilibrio. Qwen3.8-Max se sitúa a la cabeza en tareas de terminal, ingeniería de software, implementación de documentos, tareas de colaboración, búsquedas en la web y seguimiento de instrucciones. No es necesario que gane en todas las categorías para resultar útil; un agente que mantenga un buen rendimiento de forma constante en planificación, programación, herramientas y comprobaciones visuales puede resultar más fiable que un modelo optimizado para una prueba concreta.
La tabla oficial también muestra por qué son importantes las pruebas comparativas. GPT-5.6 Sol lidera varias filas relacionadas con el razonamiento o orientadas a terminales, mientras que Fable 5 sigue siendo especialmente competitivo en tareas de colaboración, interfaz y visuales. Una tabla aparte Comparación entre GPT-5.6 y Fable 5 puede ayudarte a trasladar esas familias de modelos a situaciones de uso cotidiano antes de incluir el modelo Qwen3.8-Max en la lista de candidatos.
Qué significan los resultados multimodales
Qwen3.8-Max obtiene excelentes resultados oficiales en razonamiento multimodal, anclaje visual, uso del ordenador, trabajo con documentos y comprensión espacial. Su puntuación de 86,1 en OSWorld-Verified resulta especialmente relevante para los agentes que operan en pantalla, ya que mide la capacidad de completar tareas en entornos de escritorio, y no se limita a describir una imagen.
Comparativa del Qwen3.8-Max
No hay una respuesta responsable de una sola línea a la pregunta: “¿Es Qwen3.8-Max mejor que GPT, Claude o Gemini?”. Los propios datos de Qwen muestran que los líderes de la categoría cambian de una fila a otra. La idoneidad del producto también depende de la fiabilidad de la herramienta, la calidad de los resultados, la latencia, la disponibilidad regional, los controles de privacidad y la interfaz que rodea al modelo.
Qwen3.8-Max resulta la opción más atractiva cuando se busca un único modelo que cubra la programación, la gestión de documentos, la investigación, las tareas prolongadas y los agentes visuales. GPT-5.6 Sol puede seguir siendo la mejor opción para aquellas cargas de trabajo en las que su gran capacidad de razonamiento y sus resultados finales se adapten a tu entorno. Merece la pena analizar más detenidamente el Fable 5 para tareas de colaboración y aquellas que requieren un uso intensivo de la interfaz de usuario; el Comparación entre Fable 5 y Opus 4.8 ofrece más información sobre esa parte de la resolución.
Los pesos abiertos previstos para el modelo podrían convertirse en su mayor ventaja estructural. Hoy en día, el rendimiento exclusivo de la API es lo que importa, pero los pesos descargables ofrecen opciones para el ajuste fino, la infraestructura privada, la investigación y el despliegue regional. El valor final dependerá de la licencia que se publique, los formatos de los pesos, la compatibilidad con la cuantificación y el hardware necesario para ejecutar el modelo a una velocidad útil.
Precios de la API Qwen3.8-Max
Qwen indicó los siguientes precios de lanzamiento en su comunicado oficial:
Una estimación sencilla es:
coste estimado = entrada no almacenada en caché × $2/M + entrada almacenada en caché × $0,25/M + salida × $6/M
Por ejemplo, una ejecución que utilice 10 millones de tokens de entrada no almacenados en caché y 2 millones de tokens de salida costaría aproximadamente $32 según las tarifas de lanzamiento, antes de aplicar los cargos de cualquier otra plataforma: $20 por la entrada más $12 por la salida. Un agente que vuelva a leer un repositorio de gran tamaño en cada turno puede gastar mucho más, lo que hace que el almacenamiento en caché y la gestión del contexto sean tan importantes como el precio de entrada anunciado.
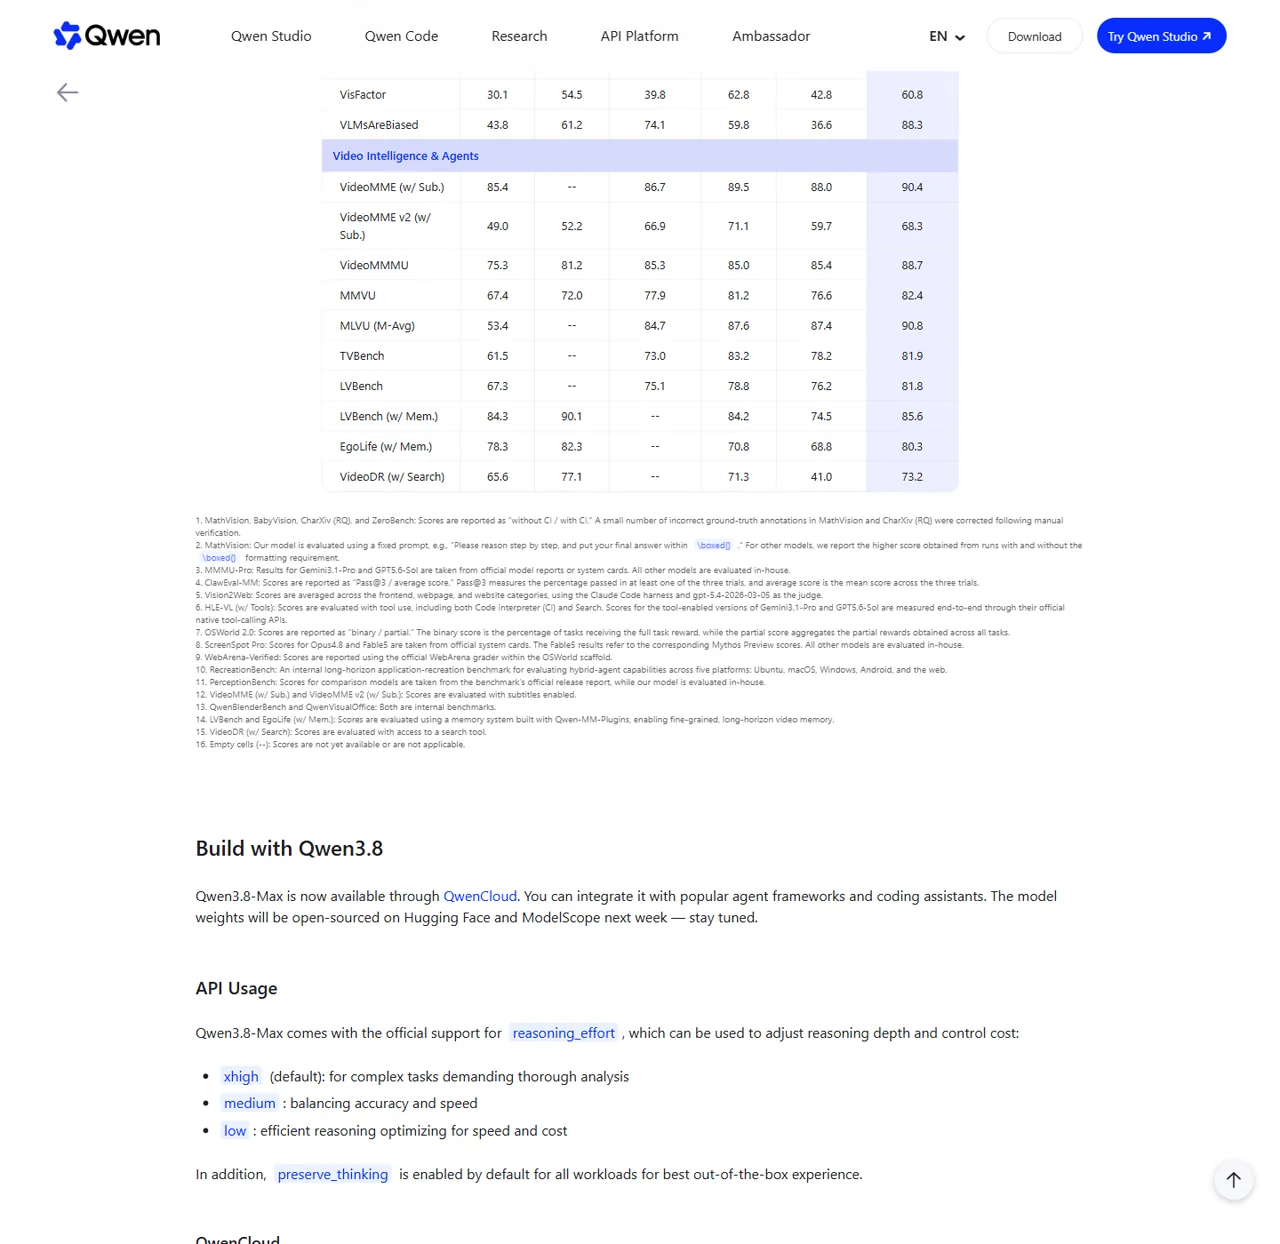
Qwen3.8-Max también es compatible con esfuerzo_de_razonamiento controles. En la sección oficial de la API se enumeran xalto como valor por defecto para el análisis complejo, medio para lograr un equilibrio entre precisión y rapidez, y bajo para trabajar de forma más rápida y eficiente. preserve_thinking está activado por defecto. Estos controles pueden reducir los costes, pero deben evaluarse en función de la calidad de las tareas, en lugar de considerarse modos intercambiables.
La fijación de precios entre distintos proveedores requiere la misma precaución. Un modelo con una tarifa por token más baja puede acabar resultando más caro si requiere indicaciones más largas, más reintentos o llamadas adicionales a herramientas. El Guía de precios de la API Gemini 3.1 Pro es un ejemplo ilustrativo de por qué la longitud del contexto y los niveles de uso son importantes, además de la tasa base.
Cómo acceder a Qwen3.8-Max
1. Utiliza Qwen Studio para realizar una evaluación directa
La forma más rápida de echar un primer vistazo es Estudio Qwen. Empieza con una tarea real en lugar de una pregunta trivial: proporciona un resumen desordenado, un problema de programación con varios archivos, un conjunto de documentos o un flujo de trabajo basado en imágenes. Comprueba si el resultado es preciso, editable y lo suficientemente completo como para ahorrar tiempo.
2. Utilizar la API QwenCloud para aplicaciones
Qwen3.8-Max está disponible a través de QwenCloud. Según la página de lanzamiento, su API es compatible con los protocolos estándar del sector para la finalización de mensajes y las respuestas, conformes con la especificación OpenAI, además de ofrecer una interfaz compatible con Anthropic. Esto facilita la migración, pero es recomendable revisar los nombres de los modelos, los parámetros, el comportamiento de la transmisión, los esquemas de las herramientas y la gestión de errores en la documentación oficial.
3. Conéctalo a herramientas de programación y de agentes
La página de lanzamiento de Qwen incluye integraciones con Qwen Code, Claude Code, Codex y OpenClaw. Por lo tanto, el modelo puede encajar en un flujo de trabajo ya existente de un terminal o agente sin necesidad de crear una nueva interfaz. La compatibilidad con la integración no elimina el coste de la herramienta asociada, por lo que conviene comparar la factura del modelo con la de Estructura de precios de Codex antes de estandarizar el flujo de trabajo de un equipo.
Los usuarios del código Claude también deben separar el coste del producto de codificación de la API del modelo externo. Los planes disponibles y las modalidades de facturación se resumen en el Guía de precios del código Claude.
Los usuarios de OpenClaw se plantean una pregunta adicional: ¿qué modelo ofrece la mejor combinación de uso de herramientas, velocidad y precio para un agente concreto? El Comparación de modelos OpenClaw ofrece un marco práctico para tomar esa decisión, en lugar de recurrir por defecto al modelo más grande.
4. Mantener la integridad del flujo de trabajo multimodelo
En el momento de su lanzamiento, QwenCloud es la ruta de producción verificada para Qwen3.8-Max. Si además se comparan las alternativas GPT, Claude, Gemini o Fable, la Espacio de trabajo multimodelo GlobalGPT puede reducir la necesidad de cambiar de pestaña entre los modelos compatibles. Utiliza la ruta oficial Qwen para el modelo Qwen3.8-Max hasta que se haya verificado la existencia de una página dedicada al modelo GlobalGPT; no des por sentado que existe una nueva URL para el modelo solo porque se haya anunciado su lanzamiento.
Qwen3.8: Pesos máximos en posición abierta
Qwen anunció que los pesos Qwen3.8-Max saldrían a la venta la semana siguiente al lanzamiento del 3 de agosto. Lo mismo publicación oficial en X También se ha anunciado que el modelo Qwen3.8-27B pasará a ser de peso libre. Es una buena noticia para su implantación e investigación a nivel local, pero el simple anuncio no basta para planificar un clúster de producción.
Antes de descargar o presupuestar el hardware, comprueba los cinco elementos que figuran en la ficha del modelo definitivo:
- Las condiciones exactas de la licencia y del uso comercial.
- URL oficiales de los repositorios de Hugging Face o ModelScope.
- Formatos de precisión y cuantificación disponibles.
- Requisitos mínimos y recomendados de CPU, GPU, RAM y almacenamiento.
- Si el modelo publicado se ajusta al comportamiento de la API alojada y a la longitud del contexto.
“Open weight” y “código abierto” no siempre son lo mismo. Los «peso abierto» indican que los parámetros del modelo se pueden descargar; la licencia determina qué se puede modificar, redistribuir o utilizar con fines comerciales. Hasta que los repositorios y la licencia estén disponibles, las páginas que prometen una descarga de Qwen3.8-Max, una compilación GGUF o requisitos precisos de hardware local se están adelantando a los hechos.
El anuncio del modelo 27B debería tratarse de la misma manera. Puede que se convierta en la opción más realista para los usuarios locales, pero su arquitectura, la longitud del contexto, las necesidades de memoria y los resultados de las pruebas de rendimiento deberían proceder de su propia ficha técnica oficial, y no copiarse del modelo Max.
Qwen3.8: Límites máximos y mejor ajuste
Limitaciones que hay que tener en cuenta
- La mayor parte de la información sobre el lanzamiento procede de Qwen. Las evaluaciones independientes pueden utilizar diferentes indicaciones, herramientas o criterios de puntuación.
- El contexto amplio no equivale a una memoria perfecta. Un modelo puede procesar un millón de tokens y, aun así, pasar por alto un detalle o seguir una instrucción poco clara.
- Los agentes que generan muchos datos pueden resultar costosos. La tasa de salida de $6 por millón es importante cuando un flujo de trabajo genera código extenso, informes o trazas de razonamiento repetidas.
- Los detalles de la implementación local no estarán completos hasta que lleguen los pesos y la ficha del modelo. Un sistema de 2,4 T con todos los parámetros no funcionará igual que un modelo de sobremesa pequeño.
- El uso de herramientas añade otra capa de fallo. El estado del navegador, los permisos, los errores de red y los esquemas de herramientas mal definidos pueden hacer que un modelo, que de otro modo sería eficaz, deje de funcionar.
- La información sobre los lanzamientos cambia rápidamente. Antes de la publicación o la adquisición, conviene volver a comprobar los precios, los repositorios, las integraciones y la disponibilidad.
¿Quién debería probarlo ahora?
La cuestión es, sencillamente, que Qwen3.8-Max merece una prueba exhaustiva, pero no una migración a ciegas. Utiliza una tarea exigente con una condición de éxito clara, registra el número total de tokens y reintentos, y compara el resultado final, no solo la primera respuesta.
Preguntas frecuentes
¿Cuándo salió al mercado la versión Qwen 3.8 Max?
Qwen3.8-Max se presentó oficialmente el 3 de agosto de 2026. El modelo alojado estuvo disponible a través de Qwen Studio y QwenCloud desde su lanzamiento. Qwen indicó que los pesos abiertos se publicarían la semana siguiente, por lo que la disponibilidad de la API y la de los pesos descargables deben considerarse hitos independientes.
¿Es Qwen3.8-Max de código abierto?
Qwen ha anunciado los pesos abiertos para Qwen3.8-Max, pero el repositorio definitivo y la licencia determinan lo que los usuarios pueden ejecutar, modificar, redistribuir o utilizar con fines comerciales. Hasta que esos archivos estén disponibles y se hayan verificado, decir que “se ha anunciado el lanzamiento de los pesos abiertos” es más preciso que dar por sentado que ya están disponibles todos los permisos de código abierto o formatos locales.
¿Cuántos parámetros tiene el modelo Qwen3.8-Max?
Qwen3.8-Max cuenta con un total de 2,4 billones de parámetros y activa 95 000 millones de parámetros por token. Utiliza una arquitectura de «mezcla de expertos», por lo que el número total de parámetros y el número de parámetros activos describen partes diferentes del sistema. Ninguna de estas cifras por sí sola permite predecir la velocidad real ni los requisitos de hardware.
¿Qué es la ventana de contexto Qwen3.8-Max?
La versión oficial indica una ventana de contexto de 1 millón de tokens. Es lo suficientemente amplia para código extenso, documentos, resultados de herramientas e historial de agentes, pero el contexto máximo no garantiza una recuperación perfecta. Prueba el modelo con la posición, el formato y la densidad de la información que utilices en tu flujo de trabajo real.
¿Cuánto cuesta la API Qwen3.8-Max?
En el momento del lanzamiento, Qwen fijó los siguientes precios: $2 por cada millón de tokens de entrada, $6 por cada millón de tokens de salida y $0,25 por cada millón de tokens almacenados implícitamente en caché. Considéralos como precios de lanzamiento y compruébalos antes de elaborar tu presupuesto. Los costes de los agentes también dependen de la reutilización del contexto, el esfuerzo de razonamiento, los reintentos y la longitud de las salidas generadas.
¿Es el Qwen3.8-Max mejor que el GPT-5.6 Sol o el Fable 5?
No en todas las pruebas. La tabla oficial de Qwen muestra que el modelo Qwen3.8-Max lidera algunas pruebas de referencia relacionadas con la programación, la búsqueda, el seguimiento de instrucciones y el uso del ordenador, mientras que los modelos GPT-5.6 Sol o Fable 5 lideran otras. El modelo más adecuado depende de la tarea, el entorno de herramientas, la latencia, el precio y la calidad del resultado final.
¿Puedo ejecutar Qwen3.8-Max de forma local?
Qwen ha anunciado que los pesos se podrán descargar la semana posterior al lanzamiento, pero la viabilidad a nivel local dependerá de los archivos definitivos, la precisión, la compatibilidad con la cuantificación, la licencia y las recomendaciones de hardware. Es recomendable esperar a la ficha técnica oficial del modelo antes de dar por buenas las estimaciones exactas de RAM, VRAM o almacenamiento. Las variantes más pequeñas, como la Qwen3.8, podrían resultar más prácticas una vez que se haya publicado la documentación oficial.
¿Qué es el Qwen3.8-27B?
La publicación sobre el lanzamiento de Qwen indica que Qwen3.8-27B también se lanzará con pesos abiertos. El artículo sobre el lanzamiento de Max no ofrece detalles suficientes para reutilizar las especificaciones del modelo Max en la versión 27B. Consulta la ficha del modelo para conocer su arquitectura, ventana de contexto, pruebas de rendimiento, licencia e instrucciones de descarga.
¿Puedo utilizar el modelo Qwen3.8-Max en el GlobalGPT?
En el momento de la publicación, no se había verificado una ruta GlobalGPT específica para Qwen3.8-Max. Utiliza Qwen Studio o QwenCloud para acceder directamente. GlobalGPT sigue siendo útil para comparar otros modelos disponibles de GPT, Claude, Gemini y Fable sin tener que cambiar de plataforma.
Veredicto final
Utiliza Qwen Studio o QwenCloud para evaluar directamente el modelo Qwen3.8-Max. Utiliza GlobalGPT para comparar otros modelos verificados sin dar a entender que ya exista una ruta específica para el modelo Qwen3.8-Max.
Compara los modelos disponiblesQwen 3.8 Max es uno de los lanzamientos de modelos más ambiciosos de 2026: 2,4 billones de parámetros en total, 95 000 millones de parámetros activos, una ventana de contexto de 1 millón de tokens, sólidos resultados oficiales en programación y agentes multimodales, y una trayectoria anunciada de peso abierto. El precio de su API de lanzamiento es lo suficientemente competitivo como para probarlo, especialmente cuando el almacenamiento en caché reduce los costes de contexto repetidos.
La razón más importante para interesarse por ello no es una simple victoria en una prueba comparativa. Se trata del intento de combinar la programación, los resultados profesionales, la planificación a largo plazo, la retroalimentación visual y el uso de herramientas en un único modelo. Empieza con Qwen Studio o con una evaluación controlada de QwenCloud, mide la calidad de las tareas completadas y el coste total, y espera a que se publiquen las ponderaciones oficiales y la licencia antes de comprometerte a una implementación local.
Fuentes primarias consultadas el 4 de agosto de 2026: Lanzamiento oficial de Qwen3.8-Max y Publicación oficial de lanzamiento de @Alibaba_Qwen.