
Grok 4: Precios de la API: costes, límites y cómo empezar

¿Estás desarrollando una aplicación o elaborando el presupuesto para un agente? Empieza por el modelo que realmente vas a poner en marcha. El Aviso de migración del 15 de mayo de 2026 Afirma que el ID original «Grok 4» ahora se resuelve como «Grok 4.3» con un esfuerzo de razonamiento mínimo. Una llamada satisfactoria a un ID antiguo ya no demuestra que el modelo original lo gestionara.

El uso de la API se contabiliza por separado de las suscripciones de los usuarios de Grok. Precios de suscripción y acceso a Grok incluye los planes de chat; esas cuotas mensuales no son créditos simbólicos para una integración directa con xAI.

¿Quieres probar una pregunta antes de integrarla en una aplicación? Prueba con Grok 4.6 en GlobalGPT para un flujo de trabajo basado en chat. Utiliza una clave API de xAI para tu propia integración y facturación directa con xAI. Este artículo ha sido publicado por GlobalGPT; los enlaces a productos incluyen seguimiento de referencias.
Grok 4 Precios de la API: tarifas actuales y la original, ya retirada

La tabla que aparece a continuación utiliza Precios de catálogo de xAI consultados el 8 de septiembre de 2026. Cada importe se expresa en dólares estadounidenses por cada millón de tokens. La entrada, la entrada almacenada en caché y la salida son categorías facturables independientes, por lo que un único “precio por millón” combinado oculta el coste real de la carga de trabajo.

USD por cada millón de tokens · tramitación estándar

grok-4.3

Destino de redirección original Grok 4

Contexto: 1.000.000 de fichas

Texto de entrada < 200 000

Entrada
$1.25
Entrada almacenada en caché
$0.20
Resultado / razonamiento
$2.50

Respuesta >= 200 000

Entrada
$2.50
Entrada almacenada en caché
$0.40
Resultado / razonamiento
$5.00

grok-4.6

Buque insignia actual

Contexto: 500 000 fichas

Texto de entrada < 200 000

Entrada
$2.00
Entrada almacenada en caché
$0.50
Resultado / razonamiento
$6.00

Respuesta >= 200 000

Entrada
$4.00
Entrada almacenada en caché
$1.00
Resultado / razonamiento
$12.00

grok-4.5

Opción anterior de la generación actual

Contexto: 500 000 fichas

Texto de entrada < 200 000

Entrada
$2.00
Entrada almacenada en caché
$0.30
Resultado / razonamiento
$6.00

Respuesta >= 200 000

Entrada
$4.00
Entrada almacenada en caché
$0.60
Resultado / razonamiento
$12.00

Una vez que la solicitud alcanza los 200 000 tokens, se aplican las tarifas de contexto largo a todos los tokens de dicha solicitud, incluida la salida.

Los demás identificadores de la familia 4 de Grok que figuran en la lista son grok-4.20-0309-razonamiento, grok-4.20-0309-sin-razonamiento y grok-4.20-multi-agent-0309. Cada uno tiene una ventana de contexto de 1 millón de tokens y las mismas tasas de tokens cortos y largos indicadas que Grok 4.3. El precio unitario equivalente no implica que el consumo total de tokens sea el mismo, especialmente en el caso de trabajos con varios agentes.

Si buscas una alternativa específica para la programación, grok-build-0.1 cuenta con una ventana de contexto de 256K y unas tasas de entrada/caché/salida en contexto corto de $1,00/$0,20/$2,00, que aumentan hasta $2,00/$0,40/$4,00 en el umbral de 200K de la solicitud. Para conocer más detalles sobre el comportamiento y los casos de uso, consulte nuestra Reseña del Grok 4.6.
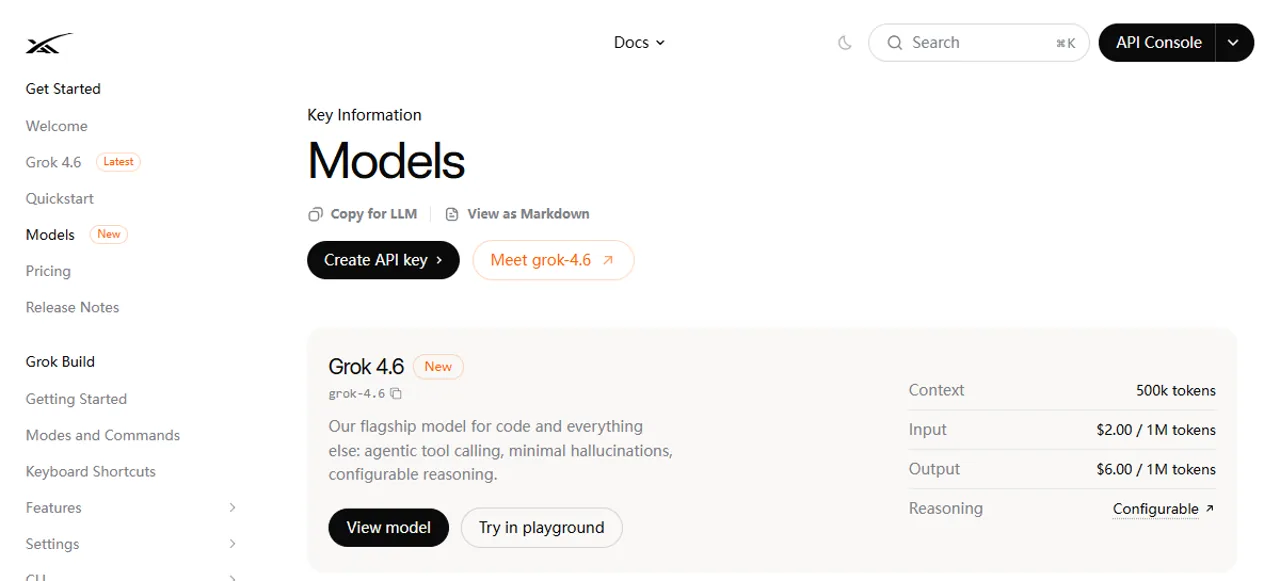
Documentación oficial de xAI en la que se menciona Grok 4.6, su ID de modelo, un contexto de 500 000 y un razonamiento configurable.
Catálogo oficial de modelos de xAI, registrado el 7 de septiembre y revisado de nuevo el 8 de septiembre de 2026. El título $2/$6 corresponde a Grok 4,6: precios de entrada/salida en contexto corto; las tarifas de caché y de contexto largo se indican más arriba.

¿Qué ha pasado con el precio original del $3 / $15?

Referencias anteriores, entre ellas nuestra Guía de integración de API Grok 4, cotización de $3 por cada millón de tokens de entrada y $15 por cada millón de tokens de salida para el Grok original 4. Considéralo como una cotización histórica, no como la factura actual de un ID retirado. La antigua URL oficial del modelo redirige ahora al catálogo general de modelos, por lo que no se trata de una hoja de precios de archivo recién verificada.

En Anuncio original Grok 4 describe una ventana de contexto de 256 000 tokens. Esa capacidad histórica, así como los precios o umbrales anteriores del modelo Fast, no deben incluirse en el presupuesto para la sustitución. La regla concreta para grok-4-0709 Ahora es Grok 4.3 con un esfuerzo de razonamiento reducido, y se factura según las tarifas de Grok 4.3.
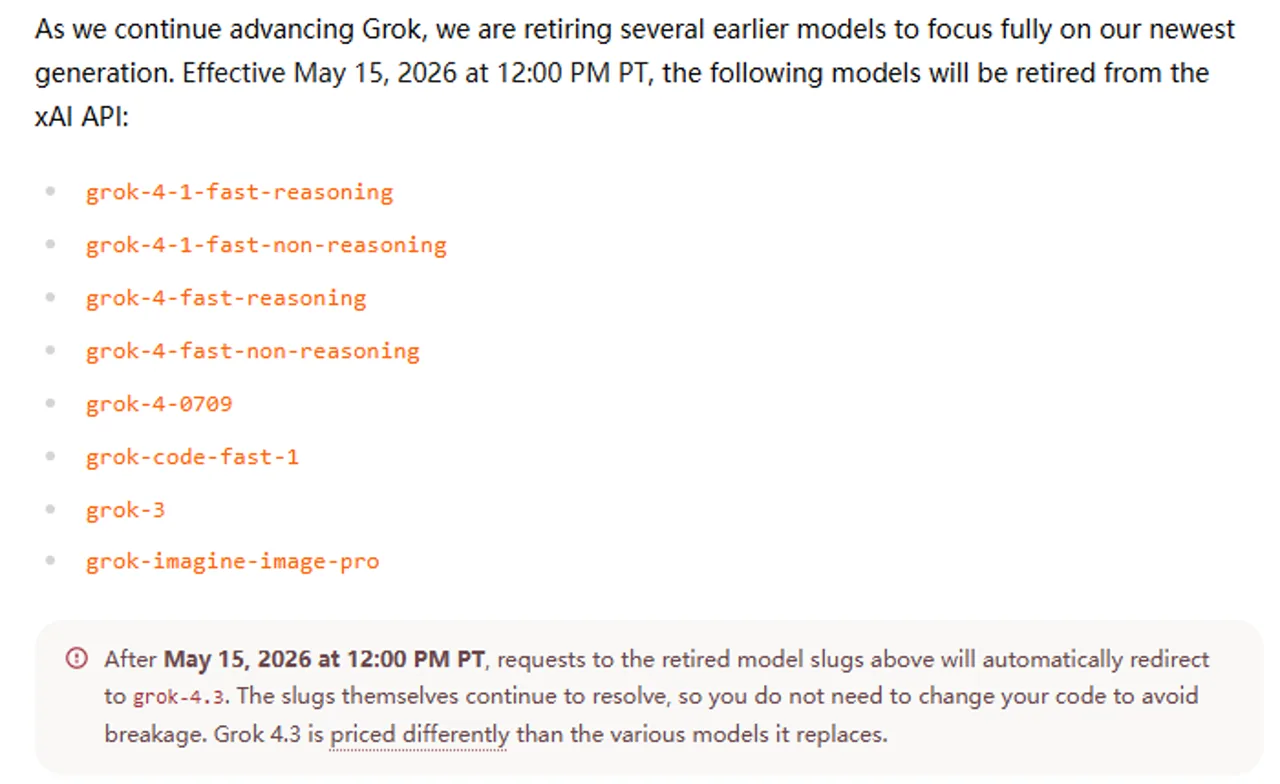
Aviso oficial de retirada en el que se menciona grok-4-0709 y su redirección a grok-4.3
Aviso de retirada de xAI, capturado el 7 de septiembre de 2026; texto revisado de nuevo el 8 de septiembre. La redirección original Grok 4 ID que aparece en la lista remite a Grok 4.3. El aviso completo identifica por separado las excepciones relativas a los modelos de codificación y de imagen.

Grok 4 es una generación de modelos, mientras que Grok es también el nombre de un producto de consumo. Nuestro explicación de qué es Grok 4 proporciona esa información sobre el producto. En el caso de los nuevos códigos, selecciona explícitamente un modelo compatible en lugar de confiar en una redirección por retirada del mercado o dar por sentado que el alias de un proveedor se mantendrá fijo.

Cómo influyen los datos de entrada, los datos de entrada almacenados en caché y el razonamiento en el proyecto de ley

Una solicitud, tres cargos simbólicos

Entrada sin almacenar en caché

(I – C) × caudal de entrada

I = todos los tokens de prompt; C = tokens de prompt almacenados en caché.

Entrada almacenada en caché

C × tasa de caché

Los tokens almacenados en caché forman parte de la entrada, no son una entrada adicional.

Volumen facturable

O × tasa de producción

O incluye el razonamiento cuando el punto final lo indica en la salida.

Estimación del valor del token en USD = [(I – C) × tasa de entrada + C × tasa de entrada almacenada en caché + O × tasa de salida] / 1 000 000. A continuación, añade los gastos correspondientes por herramientas, almacenamiento u otros conceptos. Selecciona las tarifas de contexto largo utilizando el mensaje de total, incluidos los tokens almacenados en caché, antes de realizar el cálculo.

Los datos de entrada incluyen los mensajes, las instrucciones y el historial de conversación enviados al modelo. El almacenamiento en caché reutiliza un prefijo inicial idéntico en todas las solicitudes; es un proceso automático, y xAI recomienda utilizar un identificador de conversación para mejorar la reutilización. Una solicitud con un aspecto similar no garantiza que se produzca una coincidencia en la caché. El Documentación sobre el almacenamiento en caché de las indicaciones explica el comportamiento de la coincidencia.

En «Autocompletado de chat», lee prompt_tokens_details.cached_tokens; en «Respuestas», léase input_tokens_details.cached_tokens. El Referencia sobre el uso de la caché y los precios factura los tokens de razonamiento a la tasa de finalización completa. Si el total de la producción ya incluye el razonamiento, al añadir tokens_de_razonamiento de nuevo lo contaría por duplicado.

Grok 4.6 admite los niveles de esfuerzo de razonamiento bajo, medio, alto y «xalto»; su valor predeterminado documentado es «alto», y el razonamiento no se puede desactivar. Grok 4.3 admite los niveles «ninguno», bajo, medio y alto. Esto hace que merezca la pena evaluar la versión Grok 4.3 con el nivel «ninguno» para tareas de extracción estrictas, mientras que la versión Grok 4.6 puede consumir más tokens incluso cuando su respuesta visible es breve. Véase el configuración del razonamiento y la entrada del modelo Grok 4.3 anterior.

Llamadas de herramientas, trabajo por lotes y solicitudes prioritarias

Según el tabla oficial de precios de herramientas, «Web Search», «X Search» y «Code Execution» cuestan cada una $5 por cada 1.000 llamadas, o $0,005 por llamada, más el consumo de tokens. Una solicitud puede invocar herramientas más de una vez. Diez llamadas de búsqueda suman $0,05 antes de los tokens del modelo; habilitar una herramienta no indica cuántas veces se utilizará.

La búsqueda de archivos adjuntos cuesta $10 por cada 1.000 llamadas; la búsqueda en colecciones cuesta $2,50 por cada 1.000. Los archivos almacenados y las colecciones también conllevan tarifas diarias de almacenamiento y descarga. Las imágenes y los vídeos tienen sus propias unidades de precio, por lo que no deben incluirse en un cálculo de tokens basado únicamente en texto. Nuestro Tutorial sobre el flujo de trabajo de imagen y vídeo en Grok cubiertas que separan esa ruta de generación.

En API por lotes Ofrece un descuento de 20% en tokens para la versión Grok 4.3 y las tres variantes de la versión Grok 4.20 que figuran en la lista. El descuento se aplica a los tokens de entrada, de entrada en caché, de salida y de razonamiento. En la página del modelo Grok 4.6 se indica que la API por lotes no es compatible. No apliques un descuento general de 50% ni des por sentado que todos los modelos de la lista admiten el procesamiento por lotes.

Tratamiento prioritario cuesta el doble de las tarifas estándar por token, incluidos los tokens de caché y de razonamiento, cuando el resultado nivel_de_servicio confirma prioridad. Si se recurre al nivel predeterminado, se aplican las tarifas estándar. La prioridad se aplica a las «conclusiones de chat» y a las «respuestas», pero no a la API por lotes.

Tres ejemplos de costes de API transparentes

Se trata de estimaciones de precios de catálogo, no de facturas reales. Todas las solicitudes que figuran a continuación se procesan de forma estándar: solo texto, sin herramientas, sin almacenamiento, sin reintentos y sin impuestos. El “resultado” incluye cualquier razonamiento facturable. Las dos primeras cargas de trabajo se basan en solicitudes de menos de 200 000 tokens.

Coste por solicitud y por cada 10 000 solicitudes

Grok 4,3 · sin caché

$0.005 / solicitud

2.000 entradas × $1,25 + 1.000 salidas × $2,50, dividido por 1M. 10.000 solicitudes = $50.

Grok 4,6 · sin caché

$0.010 / solicitud

2.000 entradas × $2 + 1.000 salidas × $6, dividido por 1M. 10.000 solicitudes = $100.

Grok 4,6 · 90% entrada almacenada en caché

$0.0073 / solicitud

200 sin caché × $2 + 1.800 con caché × $0,50 + 1.000 de salida × $6, dividido entre 1M. 10.000 solicitudes = $73.

Una alta tasa de aciertos en la caché resulta más útil cuando las entradas predominan en la carga de trabajo. En ese ejemplo de Grok 4,6, el almacenamiento en caché ahorra $0,0027 por llamada, o 27% del total, aunque se almacenen en caché 90% de tokens de entrada. La carga de salida se mantiene en $0,006. Evalúa el ahorro en relación con la solicitud completa, no solo con la parte almacenada en caché.

El límite de 200 000 caracteres de la instrucción puede modificar toda la solicitud.

Otro token de entrada supera el umbral de precio

199 999 fichas de respuesta rápida

$0.459998

Grok 4.6: (199 999 × $2 + 10 000 de salida × $6) / 1M. Sin caché.

200 000 fichas de respuesta rápida

$0.920000

Grok 4.6: (200.000 × $4 + 10.000 de salida × $12) / 1M. Sin caché.

Lo principal La tabla de precios utiliza explícitamente la expresión “Contexto largo >= 200 000 tokens”.” y afirma que todos los tokens se facturan a la tarifa más alta una vez que el prompt alcanza el umbral. En la descripción del modelo se indica que se “superan” los 200 000. Para calcular un presupuesto exacto de 200 000, utiliza el límite explícito de la tabla de precios; no des por hecho que sigue aplicándose la tarifa más barata.

Para realizar una previsión mensual, calcula el volumen de solicitudes por separado para cada carga de trabajo, banda de contexto, patrón de aciertos en la caché y configuración de razonamiento. Añade los reintentos previstos y las invocaciones de herramientas. A continuación, compara esa estimación con los datos de costes obtenidos tras realizar una pequeña prueba piloto. La cifra de céntimos por llamada solo resulta útil cuando sus supuestos se ajustan a las condiciones de producción.

El contexto, los resultados, los límites de frecuencia y los límites de gasto son diferentes

Cuatro límites que hay que comprobar antes de escalar

Ventana de contexto

A petición

Grok 4.3: 1 millón de tokens. Grok 4.6: 500 000. No se trata de una asignación mensual.

Presupuesto de gastos

Por respuesta

Establece un límite de salida compatible. La capacidad contextual no garantiza que la salida sea tan visible.

RPS / TPM

Rendimiento

Solicitudes por segundo y tokens por minuto. Ambos deben mantenerse dentro del límite del nivel del equipo.

Controles de gasto

Dinero

El saldo de prepago, la recarga automática y los límites de facturación controlan de forma independiente el comportamiento de la recarga.

El público tabla de limitación de velocidad En el Nivel 0 se indican 37 solicitudes por segundo y 10 millones de tokens por minuto para Grok 4.3; para Grok 4.6 se indican 150 solicitudes por segundo y 50 millones de tokens por minuto. Se trata de entradas de nivel publicadas con fecha, no de una promesa de que todas las claves tengan la misma capacidad útil. La Consola de tu equipo es la fuente de referencia para el acceso y los límites de su modelo actual.

Los niveles se basan en el gasto acumulado en la API desde el 1 de enero de 2026: $0, $50, $250, $1.000 y $5.000 para los niveles del 0 al 4. Las solicitudes se limitan por segundo utilizando el presupuesto de solicitudes por minuto dividido entre 60, por lo que no se puede agotar la asignación de un minuto completo de una sola vez. Las entradas, las salidas, el razonamiento y los tokens almacenados en caché cuentan para el TPM, incluso cuando algunos tienen un coste menor.

Las páginas de los modelos Grok 4.3 y 4.6, que se han revisado, indican los tamaños de contexto sin una cifra máxima de salida específica. La actual Referencia del punto final de respuestas define max_output_tokens como el presupuesto combinado de salida y razonamiento: su valor por defecto es 128 000 cuando no se especifica, y admite un valor mayor para generaciones más largas. Ese valor por defecto no garantiza 128 000 tokens de respuesta visibles ni un contexto ilimitado. Establece un presupuesto explícito y revisa las respuestas incompletas.

Documentación sobre facturación de xAI distingue entre los créditos de prepago y la facturación mensual, que está desactivada por defecto. La recarga automática permite reponer los créditos de prepago y cuenta con sus propios umbrales y límite mensual. El límite de facturación controla el consumo de pospago; no es lo mismo que un límite único global que abarque las compras, recargas y solicitudes de prepago.

Para tu primera integración, empieza con un saldo prepago limitado y revisa con atención cualquier configuración de recarga automática. Para acceder al chat diario sin tener que programar una integración, la opción independiente Guía de uso del Grok abarca el flujo de trabajo del producto. La suscripción al chat y el equipo de la API cuentan con controles diferentes.

Dos tareas reales del modelo Grok 4.6: lo que revelan los registros de uso

Hemos reutilizado dos pruebas ya realizadas el 7 de septiembre de 2026 a través de la API de agregación de Broly en https://anywhere.broly.ai/v1, utilizando la función «Completar chat». Tanto los solicitados como los devueltos grok-4.6; la identidad del modelo anterior no se ha verificado de forma independiente. Se trata de resultados de la pasarela Grok 4.6, no de pruebas originales de Grok 4 ni de una comparación entre modelos.

Cada tarea se ejecutó una vez con temperatura=0, max_tokens=2048 y stream=false. No se enviaron herramientas ni indicaciones explícitas sobre el esfuerzo de razonamiento. Se utilizó la misma instrucción del sistema para ambas solicitudes:


Instrucciones sobre el sistema compartido

Extracción de gastos

La tarea convirtió cinco notas de gastos sintéticas en un formato JSON ordenado con céntimos en número entero, incluyendo un reembolso negativo. La respuesta conservó todos los campos solicitados y generó el total neto correcto de $209,00.

Texto exacto de la solicitud: Extracción de gastos

Resultado completo de la consulta: Extracción de gastos

{
  "moneda": "USD",
  "artículos": [
    {
 "etiqueta": "tren",
 "importe_centavos": 4680
    },
    {
 "label": "hotel",
 "amount_cents": 12800
    },
    {
      "label": "cena",
 "amount_cents": 2745
    },
    {
 "label": "reembolso",
 "amount_cents": -1250
    },
    {
 "label": "taxi",
 "amount_cents": 1925
    }
  ],
  "net_total_cents": 20900
}

Uso declarado · Extracción de gastos

Entrada / almacenada en caché

364 / 192

Los tokens almacenados en caché se incluyen en el recuento de entradas.

Finalización / razonamiento

991 / 857

La justificación se indica en los detalles de finalización.

Hora del reloj de pared

22,753 segundos

Incluye los gastos generales de red y de puerta de enlace; una ejecución.

Programación con restricciones

La tarea consistía en seleccionar trabajos indivisibles dentro de un presupuesto de ocho horas con ciertos requisitos previos. La respuesta elegida fue A, B, C y E, lo que sumaba un total de ocho horas y un valor de 24. Enumeramos de forma independiente los 64 subconjuntos: 17 eran viables, y este era el único conjunto óptimo.

Texto exacto de la pregunta: Programación con restricciones

Resultado completo: Programación con restricciones

{
  "selected": ["A", "B", "C", "E"],
  "order": ["A", "B", "C", "E"],
  "total_hours": 8,
  "total_value": 24
}

Uso declarado · Planificación con restricciones

Entrada / almacenada en caché

428 / 192

Los tokens almacenados en caché se incluyen en el recuento de entradas.

Finalización / razonamiento

4267 / 4217

La justificación se indica en los detalles de finalización.

Hora del reloj de pared

61,980 segundos

Incluye los gastos generales de red y de puerta de enlace; una ejecución.

La respuesta de programación es más corta que el JSON de gastos, pero su total de finalización registrado es de 4.267 tokens, incluidos 4.217 tokens de razonamiento. Esa es la lección que hay que extraer para la elaboración de presupuestos: la longitud visible de la respuesta es un indicador poco fiable del consumo del modelo de razonamiento. Estas dos tareas son ejemplos útiles del patrón de uso, no una prueba de rendimiento en cuanto a latencia ni una clasificación general de calidad.

Extracto sobre el uso de la pasarela: programación restringida

{
  "prompt_tokens": 428,
  "completion_tokens": 4267,
  "total_tokens": 4695,
  "detalles_de_los_tokens_de_la_pregunta": {
    "tokens_almacenados_en_la_caché": 192
  },
  "detalles_de_los_tokens_de_completación": {
    "tokens_de_razonamiento": 4217
  }
}

La pasarela también devolvió un valor nulo tokens_de_entrada y tokens_de_salida campos, a pesar de que los contadores de «Chat Completions» no eran cero. Para estos registros, utilizamos prompt_tokens y tokens_de_finalización. No hemos considerado los alias con valor cero como una solicitud gratuita ni hemos deducido el número de tokens visibles a partir de otros campos con valor cero.

Aplicar las tarifas oficiales sin denominarlo «factura»

Si estos recuentos de pasarelas se facturaran según los precios de catálogo actuales de xAI para contextos cortos de Grok 4.6, la tarea de extracción costaría [(364 – 192) × $2 + 192 × $0,50 + 991 × $6] / 1M = $0,006386. La programación sería [(428 – 192) × $2 + 192 × $0,50 + 4.267 × $6] / 1M = $0,026170. Se trata de estimaciones hipotéticas de la tasa de xAI, no de cargos observados en Broly.

La respuesta de programación indicó 4.267 tokens de finalización, aunque la solicitud envió max_tokens=2048. No se ha verificado la semántica del límite máximo de la pasarela. Esta discrepancia no permite determinar cómo funciona el límite máximo de salida propio de xAI, y el límite solicitado no puede considerarse un techo de gasto demostrado para esta pasarela.

Las respuestas directas de xAI ofrecen una señal de facturación más útil: coste_en_USD_ticks. La documentación oficial define un USD como 10 000 000 000 de ticks e indica que el campo incluye los cargos por token, los descuentos y las llamadas a herramientas del lado del servidor de dicha solicitud. Las respuestas reutilizadas de la pasarela no contienen ese campo. Para una conversación, suma los valores de ticks por solicitud en lugar de dar por hecho que cada respuesta contiene el total de la sesión.

Lo que observaron los usuarios independientes de la API

El 21 de agosto de 2026, un usuario de Hacker News mediaman Señalaron que la tasa de entradas almacenadas en caché de Grok 4.6, de $0,50 por millón, equivale a 25% de su tasa de entradas no almacenadas en caché de $2. Su preocupación se centraba en las lecturas repetidas de la caché en el trabajo agéntico. Las dos tasas de Grok coinciden con la tabla oficial actual; las comparaciones más amplias y las especulaciones del comentarista son valoraciones personales.

mediaman en Hacker News hablando sobre los precios de la caché de la API de Grok
mediaman sobre los precios de la caché del Grok 4.6, 21 de agosto de 2026. Evaluación personal de los costes; las comparaciones y especulaciones son del autor del comentario. Capturado el 8 de septiembre de 2026.

Anteriormente, el 9 de noviembre de 2025, XCSme Se describía el uso de Grok 4 Fast a través de la API para el análisis y la extracción de datos, calificándolo de económico y rápido. Se trata de un informe histórico sobre un modelo Fast ya descatalogado. No establece el precio, la velocidad ni la calidad actuales del Grok 4.3 ni del Grok 4.6.

XCSme en Hacker News hablando sobre la extracción de datos de la API Grok
XCSme sobre el uso del Grok 4 Fast para la extracción, 9 de noviembre de 2025. Experiencia personal pasada con un modelo ya descatalogado. Capturado el 8 de septiembre de 2026.

Estas dos experiencias concretas plantean algunas preguntas piloto útiles: ¿qué parte de tu código proviene del contexto almacenado en caché y qué parte del razonamiento y los reintentos? No establecen un consenso entre los desarrolladores. Si además estás comparando el trabajo resultante, nuestro Comparación entre Grok y ChatGPT: trabajo, búsqueda y codificación aborda esa decisión por separado.

Cómo empezar a utilizar la API oficial de xAI

En Guía oficial de inicio rápido de xAI utiliza la API de respuestas en https://api.x.ai/v1/responses. Se trata de un punto final y una cuenta distintos de los utilizados en las pruebas que realizamos el 7 de septiembre.

  1. Crea una cuenta en xAI Console o inicia sesión en ella y selecciona el equipo adecuado.
  2. Añade créditos de API y revisa la configuración de gastos. Confirma que el modelo seleccionado esté disponible para tu equipo.
  3. Crea una clave API y facilítala al proceso de tu servidor como XAI_API_KEY. No la incluyas en el código del navegador, el control de versiones, las capturas de pantalla ni los registros.
  4. Envía una solicitud breve utilizando un identificador de modelo actual explícito y, a continuación, registra el modelo devuelto, el uso, el nivel de servicio y el identificador de la solicitud.

El ejemplo que se muestra a continuación utiliza Node.js 18 o una versión posterior y su función «fetch» integrada, por lo que no es necesario instalar ningún SDK. Configura la variable XAI_API_KEY en el entorno de tu proceso antes de ejecutarlo. Utiliza el formato oficial actual de solicitud «Responses» y un nivel bajo de esfuerzo de razonamiento; el código se ha comprobado localmente sin enviar ninguna otra solicitud de API de pago.

Primera solicitud oficial · Node.js

Comprueba que el estado sea «completado» e inspecciona el objeto de uso antes de ampliar la escala. En este ejemplo se asignan 2.048 tokens de salida y razonamiento a través del campo oficial «Responses». Un tiempo de espera es un plazo límite del lado del cliente, no una prueba de que el trabajo del lado del servidor se haya cancelado o no se haya facturado. El ejemplo no vuelve a intentarlo automáticamente; el límite de tokens no es un límite monetario global para una aplicación que también envía entradas o invoca herramientas.

Para un SDK compatible con OpenAI, la URL base es https://api.x.ai/v1 y la credencial sigue siendo la tuya xAI Clave de API. La API de respuestas utiliza entrada y razonamiento: { esfuerzo: "bajo" }; «Chat Completions» utiliza mensajes y sus propios nombres de parámetros. Copiar una solicitud de pasarela sin modificaciones en un punto final diferente puede dar lugar a un error, incluso cuando ambos acepten JSON.

Errores habituales en la integración y control de costes

  • 401 No autorizado: comprueba el encabezado «Bearer», la clave y el entorno de ejecución. Un código de error 403 puede indicar problemas con los permisos del equipo o restricciones de acceso. Repetir la misma solicitud no válida no soluciona el problema.
  • 404 No encontrado: comprueba el punto final y el ID del modelo exactos. Distingue entre un ID no válido y un ID retirado y documentado que aún se resuelve mediante una redirección.
  • 400 o 422: comprueba el esquema de la solicitud y los parámetros admitidos. Por ejemplo, la documentación actual sobre razonamiento rechaza las penalizaciones por presencia o frecuencia y los parámetros de detención para los modelos de razonamiento.
  • 429 Demasiadas solicitudes: pon las tareas en cola, suaviza los picos de tráfico y utiliza un retroceso exponencial acotado con fluctuación. Realiza un seguimiento tanto de las RPS como de las TPM, e incluye los reintentos en el presupuesto de la carga de trabajo.
  • Resultado inesperado o estado incompleto: comprueba la respuesta, la configuración del razonamiento y el límite de salida aplicable. Valida la salida legible por máquina antes de utilizarla; una respuesta HTTP correcta no garantiza la calidad de la tarea.

Para controlar los costes, elige el modelo y la configuración de razonamiento más económicos que superen tus propias comprobaciones de tareas; mantén instrucciones estables al inicio para reutilizar la caché; elimina el historial irrelevante; supervisa el límite de 200 000 indicaciones y limita los bucles de las herramientas del agente. Utiliza el procesamiento por lotes solo cuando el modelo lo admita y el trabajo pueda esperar. Considera la prioridad como una opción de compra independiente.

Conserva las estimaciones de tokens para la planificación y los valores de coste devueltos para la conciliación. Al agregar muchas solicitudes, guarda los valores enteros y compara los totales de las solicitudes con el uso de la Consola y las facturas. Un campo de coste que falte significa “desconocido”, no cero; una respuesta breve y visible no garantiza que la factura sea baja.

Para conocer los precios actuales de la API Grok 4, elabora tu presupuesto basándote en el modelo que realmente atiende la solicitud, el rango de precios de la indicación y el volumen total facturable. Empieza con una pequeña solicitud oficial, analiza su uso y el campo de coste y, a continuación, adapta la carga de trabajo que supere tus propios controles. Para explorar indicaciones en un espacio de trabajo de chat, abrir Grok 4,6 en GlobalGPT.

Grok 4: Preguntas frecuentes sobre los precios de la API

¿Cuánto cuesta ahora el Grok 4 API?

A partir del 8 de septiembre de 2026, el ID «grok-4-0709», ya en desuso, redirige a «Grok 4.3». Por debajo de los 200 000 tokens de prompt, sus tarifas en dólares por millón son $1,25 para la entrada, $0,20 para la entrada en caché y $2,50 para la salida. Las tarifas para contextos largos se duplican.

¿Sigue estando disponible el Grok 4 API original?

El modelo original grok-4-0709 se retiró de la API de xAI el 15 de mayo de 2026. Su ID sigue siendo válido, pero las solicitudes se gestionan mediante el modelo Grok 4.3, con un bajo nivel de razonamiento, y se facturan según las tarifas del modelo sustitutivo.

¿Cuánto cuesta el Grok 4.6 API?

Grok 4,6 supone un coste de $2 de entrada, $0,50 de entrada en caché y $6 de salida por cada millón de tokens por debajo de los 200 000 tokens de la solicitud. A partir de 200 000, las tarifas son de $4, $1 y $12. Las llamadas a herramientas y otros cargos aplicables se facturan por separado.

¿Hay que pagar por las fichas de razonamiento?

Sí. xAI factura los tokens de razonamiento según la tasa de finalización. Cuando el razonamiento ya esté incluido en el resultado comunicado o en el total de finalización, no lo añadas por segunda vez en tu estimación.

¿Se tiene en cuenta la entrada almacenada en caché a la hora de calcular el límite de 200 000?

Sí. Hay que contar la solicitud completa, incluidos los tokens almacenados en caché. Según la tabla de precios oficial, una solicitud de 200 000 tokens o más se incluye en la franja de contexto largo, y las tarifas más elevadas se aplican a todos los tokens de dicha solicitud.

¿Hay un límite gratuito de API Grok con la suscripción al chat?

No des por sentado que una suscripción al chat incluye créditos para la API de xAI. La guía oficial de inicio rápido de la API utiliza una cuenta de la Consola y créditos independientes. Cualquier promoción debe verificarse para ese equipo de la API; el acceso gratuito para usuarios particulares es una oferta diferente.

¿Cuáles son los límites de velocidad de la API Grok?

Los límites dependen del modelo y del nivel del equipo. En la tabla del Nivel 0 que se ha consultado figuran el Grok 4.3 con 37 RPS y 10 M TPM, y el Grok 4.6 con 150 RPS y 50 M TPM. Utiliza la consola de tu equipo para confirmar los límites que se aplican a tu clave.

¿Puedo utilizar el Grok 4.6 en el GlobalGPT?

Sí. GlobalGPT cuenta con una entrada de chat Grok 4.6 verificada. Se trata de un flujo de trabajo independiente de la plataforma; no sustituye a una clave API de xAI, a la facturación directa de la API ni a los controles de tu consola de xAI.

¿Cómo puedo consultar el coste real de una solicitud de xAI?

Lee el valor de «usage.cost_in_usd_ticks» de la respuesta oficial y divídelo entre 10 000 000 000 para obtener el importe en USD. Este campo abarca esa solicitud, incluidos los descuentos por token y las herramientas del lado del servidor. Suma las solicitudes para realizar un seguimiento de una conversación.

Comparte el post:

Entradas relacionadas