 Chloe Murphy
Hidrógeno
Tiempo observado55,21 sTokens de entrada4,273Tokens de salida8,243
Evaluación de salida
Correcto: A+C+D, coste 16, valor 31. También se identificó A+C+E como la única otra cartera factible con valor de al menos 30.
Comparamos los benchmarks publicados por Google y los precios de la API, y luego probamos los tres modelos en tareas idénticas con resultados verificados, prompts, tiempo y uso de tokens.

Hydrogen tiene el precio oficial de tokens más bajo; Carbon apunta al razonamiento más profundo; Argon equilibra el razonamiento de vanguardia y la eficiencia. Los tres pasaron nuestras cuatro tareas completadas. La prueba de código más difícil expuso diferencias de formato y explicación en lugar de un ganador en corrección.
Google ahora tiene tres modelos Gemini 4 con nombres que dicen muy poco sobre cuál elegir. ¿Deberías empezar con Hydrogen, usar Argon para trabajos exigentes o pagar por el razonamiento más profundo de Carbon?
La comparación útil es la capacidad por tarea: qué puede resolver cada modelo, cuánto razonamiento utiliza y cuánto cuesta una respuesta completa. Las puntuaciones oficiales de los benchmarks nos dan un punto de partida; se necesitan tareas difíciles con el mismo prompt para ver dónde importan esas diferencias.
Probamos los tres modelos en las mismas tareas a través de GlobalGPT. Si quieres comparar tu propia carga de trabajo, empieza con GlobalGPT y revisa las opciones de modelo y los términos de uso actuales de tu cuenta.
Diseñado para codificación diaria rápida y ejecución agéntica.
Puede ejecutarse de forma independiente o encargarse de la ejecución junto con modelos de razonamiento más profundo.
Índice reportado por Google: 51 en pensamiento alto, 54 en xhigh.
Fuente: El anuncio de Hydrogen de Google.
El modelo de razonamiento Gemini 4 de mayor capacidad.
Destinado a depuración difícil, investigación científica y verificación extendida.
Puede usar más tokens de razonamiento que Argon a pesar de tarifas por token iguales.
Fuente: El anuncio de disponibilidad de Carbon de Google.
Razonamiento de frontera eficiente para codificación, matemáticas y ciencia exigentes.
Google lo posiciona como más rápido y menos intensivo en tokens que Carbon.
Su papel es un equilibrio entre profundidad de razonamiento y costo de la tarea.
Fuente: La documentación de modelos y precios de Google.
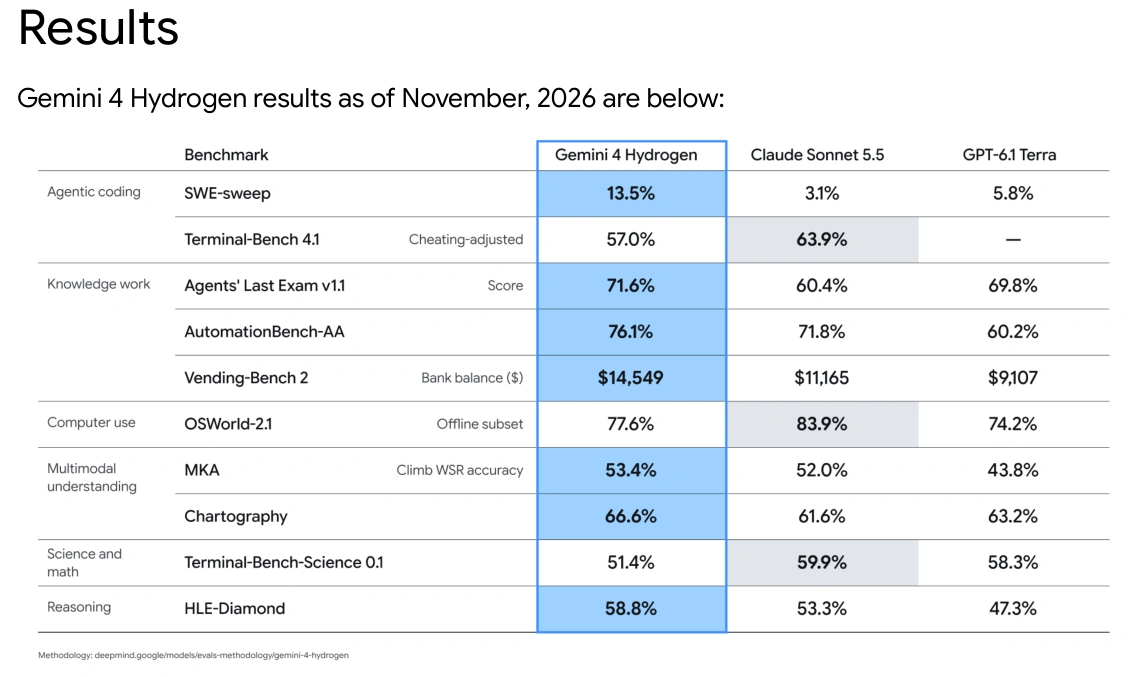
BENCHMARK PUBLICADO · MÁS ALTO ES MEJOR
Una vista rápida de las puntuaciones reportadas por Google.
Estos son resultados publicados reportados por Google, verificados el 15 de noviembre de 2026. No son puntuaciones de nuestras propias pruebas. La cifra de Carbon proviene de su anuncio; las cifras de Hydrogen y Argon provienen del anuncio de Hydrogen anterior. Esta es una comparación de fuentes entre anuncios, en lugar de una nueva ejecución de clasificación de tres modelos con configuraciones idénticas verificadas de forma independiente.
No coloque las cifras de Terminal-Bench 4.0 y 4.1 en una misma columna clasificada. Una versión de evaluación modificada puede cambiar la dificultad de las tareas, por lo que los porcentajes no respaldarían una comparación directa justa.
Precios estándar de la API de Gemini en USD por un millón de tokens, verificados el 15 de noviembre de 2026:
API GEMINI ESTÁNDAR · USD POR 1 MILLÓN DE TOKENS
Entrada
SALIDA · INCLUIDO PENSAMIENTO
Entrada
SALIDA · INCLUIDO PENSAMIENTO
Entrada
SALIDA · INCLUIDO PENSAMIENTO
*Las tarifas publicadas actuales de Hydrogen no especifican ningún aumento en diciembre; esto no es una garantía contra cambios futuros. La facturación de salida incluye tokens de pensamiento. Los cargos por búsqueda y otras herramientas son independientes. Estas son las tarifas de la API de Google, no los precios de suscripción ni las conversiones de créditos de GlobalGPT.
Con recuentos de tokens fijos, Hydrogen cuesta25% menos que Carbon o Argon a sus tarifas introductorias. Frente a las tarifas anunciadas de diciembre, esa diferencia se convierte en 62,5%. El costo real de la tarea también depende de los tokens de razonamiento, los reintentos y el uso de herramientas.
Por ejemplo, 100.000 tokens de entrada y 20.000 tokens de salida facturables cuestan $0,30 en Hydrogen, $0,40 en Carbon o Argon hasta el 30 de noviembre, y $0,80 en Carbon o Argon a partir del 1 de diciembre. Este cálculo excluye herramientas, almacenamiento en caché, descuentos por lotes y reintentos; no predice cuántos tokens necesita cada modelo.
Hydrogen tiene un nivel de API gratuito con límite de velocidad. Carbon y Argon no lo tienen. Las suscripciones de consumidores son una compra separada con sus propias reglas de acceso.
Fuente: Precios de la API de Google.
Probamos Hydrogen, Carbon y Argon en cuatro tareas idénticas. Las tres primeras comprobaron la precisión básica; la tarea final requería un programa completo de búsqueda exacta que ejecutamos y verificamos con una respuesta calculada de forma independiente.
Misma entrada e instrucción del sistema para cada tarea.
Solicitudes nuevas, contexto del proyecto desactivado y sin uso de herramientas del modelo.
Corrección, formato de salida, tiempo y uso de tokens evaluados por separado.
PRUEBA 1 · LÍNEA BASE DE PRECISIÓN
Seleccione la cartera óptima e identifique cada alternativa que cumpla los requisitos.
Solve exactly, showing verifiable arithmetic and a proof of optimality. Six indivisible projects have (cost, value): A(7,13), B(6,12), C(5,10), D(4,8), E(3,7), F(2,4). Budget=16. C requires A. D and E cannot both be selected. B requires at least one of D or F. Select projects maximizing total value; break ties by lower cost then alphabetically sorted project-list. Give chosen list, cost, value and enumerate all feasible candidates with value at least 30. No external tools or web.
Correcto: A+C+D, coste 16, valor 31. También se identificó A+C+E como la única otra cartera factible con valor de al menos 30.
Correcto: A+C+D, coste 16, valor 31. También se identificó A+C+E como la única otra cartera factible con valor de al menos 30.
Correcto: A+C+D, coste 16, valor 31. También se identificó A+C+E como la única otra cartera factible con un valor de al menos 30.
Veredicto de la tarea: Los tres pasaron las comprobaciones de respuesta principal.
PRUEBA 2 · LÍNEA BASE DE PRECISIÓN
Separe la conversión agregada de los efectos a nivel de dispositivo y el incremento estandarizado.
Analyze a randomized experiment using only these counts. Variant A: mobile 90 purchases/900 visitors; desktop 80/100. Variant B: mobile 20/100; desktop 630/900. Show overall and device-specific conversion rates, absolute lifts B-A, and a standardized B-A lift using 50% mobile/50% desktop. Explain the reversal, distinguish observational aggregate from randomized causal interpretation, and state exactly what randomization details are missing. May we claim B wins overall and in both devices? Do not invent significance or revenue. No external tools or web.
Correcto: B lidera por 48 puntos porcentuales en general, pero pierde 10 puntos en escritorio. Una mezcla de dispositivos común 50/50 da incremento nulo. Se rechazó una victoria en ambos segmentos.
Correcto: B lidera por 48 puntos porcentuales en general, pero pierde 10 puntos en escritorio. Una mezcla de dispositivos común 50/50 da incremento nulo. Rechazó una victoria en ambos segmentos.
Correcto: B lidera por 48 puntos porcentuales en general, pero pierde 10 puntos en escritorio. Una mezcla común de dispositivos 50/50 da cero incremento. Rechazó una victoria en ambos segmentos.
Veredicto de la tarea: Los tres pasaron las comprobaciones de respuesta central.
PRUEBA 3 · LÍNEA BASE DE PRECISIÓN
Aplique revisiones, anulaciones y reembolsos correctamente y luego devuelva JSON estricto.
Return valid JSON only, no Markdown. Reconcile event ledger by event_id: retain highest revision, then exclude void=true. Amounts are integer cents; refund amounts subtract from captured revenue even when received before capture; group by order_id; ignore pending. Ledger: [e1,r1,o1,capture,1000,false];[e1,r2,o1,capture,1200,false];[e2,r1,o1,refund,200,false];[e3,r1,o2,refund,300,false];[e4,r1,o2,capture,2000,false];[e5,r1,o3,capture,500,false];[e5,r2,o3,capture,500,true];[e6,r1,o3,pending,900,false];[e7,r1,o4,capture,700,false];[e8,r1,o4,refund,800,false];[e8,r2,o4,refund,600,false];[e9,r1,o2,refund,100,false]. Output keys orders (array sorted by order_id with order_id,net_cents,retained_event_ids sorted lexically), total_net_cents, excluded_event_ids (superseded event versions written as event_id:rN plus void and pending versions). Include o3 with zero net. No external tools or web.
Correcto: totales de pedido de 1.000, 1.600, 0 y 100 centavos; total 2.700 centavos. Salida sin procesar analizada como JSON sin limpieza.
Correcto: totales de pedido de 1.000, 1.600, 0 y 100 centavos; total 2.700 centavos. Salida sin procesar analizada como JSON sin limpieza.
Correcto: totales de pedido de 1.000, 1.600, 0 y 100 centavos; total 2.700 centavos. Salida bruta analizada como JSON sin limpieza.
Veredicto de la tarea: Los tres pasaron las comprobaciones de respuesta central.
PRUEBA 4 · TAREA DE CODIFICACIÓN DURA
Genere Python ejecutable para una búsqueda restringida; ejecutamos cada programa contra una referencia exhaustiva independiente.
Find the EXACT top 5 feasible portfolios, ranked by highest total value, then lowest total cost, then lexicographic sorted ID string. Items (ID,cost,value): [('A', 9, 19), ('B', 7, 16), ('C', 11, 25), ('D', 6, 13), ('E', 8, 18), ('F', 5, 12), ('G', 10, 23), ('H', 4, 9), ('I', 12, 29), ('J', 3, 8), ('K', 7, 17), ('L', 6, 15), ('M', 9, 22), ('N', 5, 11), ('O', 8, 20), ('P', 4, 10), ('Q', 11, 27), ('R', 2, 5)]. Budget 55; choose between 6 and 9 items inclusive. Dependencies: C requires A; G requires B and D; I requires E; M requires F and H; Q requires J and K. Mutually exclusive pairs: (A,B),(E,F),(L,N),(O,Q). At least 2 of C,G,I,M,Q. Exactly 2 of D,H,L,P. At least one of B,F,J,N,R. If O is selected then P is selected and K is absent. If R is selected then exactly one of A,E is selected. Return ONLY executable Python 3 code, at most 120 lines. Implement an exact exhaustive search, print JSON with keys feasible_count and top5 (each row [sorted_ID_string,cost,value]). Do NOT manually calculate or hardcode the answer. State complexity in a code comment. Use only itertools and json; no filesystem, network, subprocess or other imports. The code will be executed and checked against an independent exhaustive reference.Aprobado: el código ejecutable devolvió 121 carteras factibles y los los cinco primeros correctos. Incluía el recuento correcto de combinaciones y una explicación más completa de la complejidad.
Aprobado: se devolvió código ejecutable 121 carteras factibles y los los cinco primeros correctos. El recuento de combinaciones fue correcto; la nota de complejidad omitió el término de ordenación final.
Aprobado tras eliminar una valla Markdown: se devolvió código 121 carteras factibles y los los cinco primeros correctos. El comentario afirmaba 115.379 combinaciones en lugar de 142.766 y omitía la ordenación en su nota de complejidad.
Veredicto de la tarea: Corrección funcional empatada. Hydrogen ofreció la combinación más limpia de formato ejecutable y explicación en esta ejecución.
Los tiempos son observaciones de ejecuciones de extremo a extremo de una sola pasada, incluido el tiempo de red y de cola, con solicitudes ejecutadas simultáneamente. Los tokens informan el uso de entrada/salida y pueden incluir tokens de razonamiento o de envoltura de solicitud; no son cargos en dólares. Un intento separado de respuesta directa alcanzó los límites de velocidad o un tiempo de espera local y fue excluido de la puntuación de calidad. La tarea de codificación anterior utilizó un nuevo prompt emparejado.
Comience con Hydrogen cuando sus tarifas oficiales de tokens más bajas se ajusten a su carga de trabajo. Mantenga Argon en su comparación si valora el razonamiento de frontera eficiente: resolvió correctamente nuestra tarea de codificación de búsqueda exacta después de la limpieza de formato. Evalúe Carbon en trabajos que requieran una exploración más profunda; este conjunto de pruebas no demostró una ventaja de corrección que justificara elegirlo por defecto. Verifique el cargo de plataforma mostrado por separado de las tarifas de la API de Google.
Hydrogen tiene las tarifas de API estándar listadas más bajas: $1.50 por millón de tokens de entrada y $7.50 por millón de tokens de salida, verificadas el 15 de noviembre de 2026.
Sus tarifas de tokens estándar listadas son iguales. Carbon aún puede costar más por tarea si utiliza más tokens de razonamiento o pasos de verificación.
No. Comprueba la versión del benchmark y la configuración de pensamiento, y luego prueba el modelo en tareas representativas con respuestas verificables de forma independiente.
Ejecutamos cada solucionador de Python generado y comparamos su recuento factible y las cinco carteras principales con una referencia independiente de búsqueda exhaustiva.
Nuestra guía de acceso a Argon explica las diferencias entre el acceso a la plataforma, las suscripciones de Google, AI Studio y la facturación de la API.
Para obtener detalles de acceso, lea cómo usar Gemini 4 Argon. Para comparar modelos en una misma cuenta, comience con GlobalGPT y compruebe el modelo seleccionado y las condiciones de uso mostradas.