
Claude Fable 5.2 vs Opus 5.5: programación, coste y cuál usar
Cinco tareas con las mismas instrucciones comparan Claude Fable 5.2 y Opus 5.5 en investigación, diseño de interfaz de IA, redacción, datos y planificación de producto, con capturas de pantalla originales y uso registrado de tiempo y tokens.
 Chloe Murphy

Opus 5.5 es el punto de partida sensato para el trabajo rutinario; prueba Fable 5.2 cuando una tarea específica aún necesite mejoras. En nuestros cuatro pares de tareas de texto completadas, ambos modelos resolvieron correctamente el cálculo de investigación central y las métricas de datos. El plan de producto de Fable manejó una incertidumbre con más cuidado; ambos resultados de redacción cumplieron las restricciones principales.
La comparación de diseño utiliza una nueva ejecución emparejada de 32.768 tokens. Sus capturas de pantalla, comprobaciones de interacción y limitaciones aparecen en la tarea de diseño a continuación.
Fable 5.2 es más reciente y cuesta más por token. Pero, ¿te da un mejor resultado o simplemente una factura más alta? Comparamos investigación, diseño de interfaz de IA, redacción, análisis de datos y decisiones de producto utilizando el mismo briefing de tarea para cada modelo.
Si prefieres comparar modelos sin gestionar configuraciones de API separadas, GlobalGPT ofrece un espacio de trabajo multimodelo. Las pruebas de API aquí no establecen la disponibilidad de Fable 5.2 dentro de GlobalGPT.
La comparación práctica
| Decisión | Fable 5.2 | Opus 5.5 |
|---|---|---|
| Entrada / salida estándar por millón de tokens | $8 / $40 | $4 / $20 |
| Prueba de investigación | Cálculo correcto; redacción causal necesita edición | Cálculo correcto; detalle de diseño de estudio sin respaldo |
| Prueba de contenido | Explicación de 180 palabras; voz en off más corta | Explicación de 180 palabras; ejemplo más completo |
| Prueba de datos | Todas las métricas solicitadas son correctas | Todas las métricas solicitadas son correctas |
| Prueba de producto | Distinción cuidadosa entre daño confirmado y daño posible | Plan útil; afirmación sin respaldo sobre trabajo perdido |
| Intento de diseño original | Sin artefacto: fallo HTTP | HTML completo tras limpiar los bloques de código |
Cómo probamos los dos modelos
Cada tarea utilizó material de origen idéntico, una conversación nueva y el mismo límite de salida para ambos modelos. Las tareas de texto utilizaron un límite de 16.000 tokens; la ejecución de diseño final utilizó 32.768. Las indicaciones, la configuración, el tiempo y el uso aparecen con la tarea correspondiente a continuación.
Todos los estudios, productos, datos de pedidos y comentarios en los informes eran accesorios de prueba ficticios. Comprobamos los cálculos con una clave de respuestas preparada. El esfuerzo de razonamiento se mantuvo en el valor predeterminado de la plataforma, por lo que no se trata de un punto de referencia de igual esfuerzo. Las etiquetas de modelo devueltas por la pasarela de terceros no establecen de forma independiente el enrutamiento ascendente.
Investigador: síntesis sin exagerar la evidencia
Misma indicación · Prueba del investigador
You are a researcher. Use only these FICTIONAL study summaries about an AI writing assistant. A: randomized 120 adults, 60 per arm, intervention mean score baseline70 followup78, control baseline69 followup74, four weeks; no standard deviations, uncertainty intervals, or attrition information reported. B: observational 300 adults, usage correlated with writing scores r=.32, no confounder adjustment. C: interviews with12 users reporting perceived improvement. In under650 words synthesize evidence with A/B/C citations, calculate difference in changes, explain what cannot be inferred, and propose a feasible preregistered followup study with primary endpoint and analysis. Do not invent citations or statistical significance.
La tarea del investigador pedía una síntesis de tres estudios ficticios, incluido un ensayo aleatorizado con informe incompleto. El cálculo esencial era (78 − 70) − (74 − 69) = 3 puntos. Ambos modelos lo hicieron bien y se negaron a inventar significación estadística.
Fable 5.2
Propuso una evaluación de escritura ciega y sin asistencia, un análisis por intención de tratar y comprobaciones de sensibilidad ante datos faltantes. También proporcionó un ejemplo explícitamente hipotético de tamaño muestral.
“Solo la diferencia de 3 puntos es atribuible al asistente”
Esa redacción era demasiado confiada dada la deserción desconocida y las lagunas en los informes, aunque los párrafos posteriores matizaban la estimación. También especuló que los participantes de las entrevistas probablemente se autoseleccionaron.
Opus 5.5
Separó claramente la evidencia aleatorizada, observacional y de entrevistas. Propuso un ensayo ajustado a la línea de base y mantuvo el cálculo del tamaño de la muestra dependiente de la variabilidad piloto.
“de naturaleza transversal como se describe”
El resumen observacional proporcionado no especificaba un diseño transversal. Ese detalle debería haber permanecido desconocido.
Si adaptas este brief, mantén la evidencia fija y pide a cada modelo que separe los hechos reportados de las inferencias. Nuestras Prompts de Claude para investigación y programación ofrecen más ejemplos de restricciones específicas de la tarea.
Designer: un espacio de trabajo multi-modelo de IA
Mismo prompt · Prueba de Designer
You are a product designer and frontend builder. Return only one complete self-contained HTML file with inline CSS and JavaScript, no external assets/CDNs. Build a polished AI multi-model workspace called Parallel. Give it a distinctive cohesive visual identity with excellent typography, whitespace, hierarchy and responsive layout; choose your own palette. Include sidebar, model A/B selectors, prompt textarea, compare button, two side-by-side result cards, loading state, clear button, per-result copy button, empty-input validation, keyboard-accessible controls and mobile stacking. Models A/B are FICTIONAL; all outputs must be locally simulated and explicitly labeled demo. No real API calls or fake live performance metrics. Compare must work repeatedly and preserve the submitted prompt in both outputs. Copy must report success only after actual success, otherwise provide an error. Aim for a complete compact artifact, not an explanation.
El brief del diseñador pedía a ambos modelos construir Paralelo: un espacio de trabajo de comparación de IA autónomo con una barra lateral, selectores de modelo, entrada de prompt, tarjetas de resultados simuladas, validación, controles de copia y un diseño móvil. Dejamos la paleta de colores y la identidad visual abiertas.
La ejecución final emparejada utilizó el mismo prompt, transporte de streaming y un límite compartido de 32.768 tokens. Ambas respuestas alcanzaron una parada normal. Los artefactos fuente permanecen sin editar; al guardar HTML solo se elimina una valla Markdown envolvente cuando está presente.
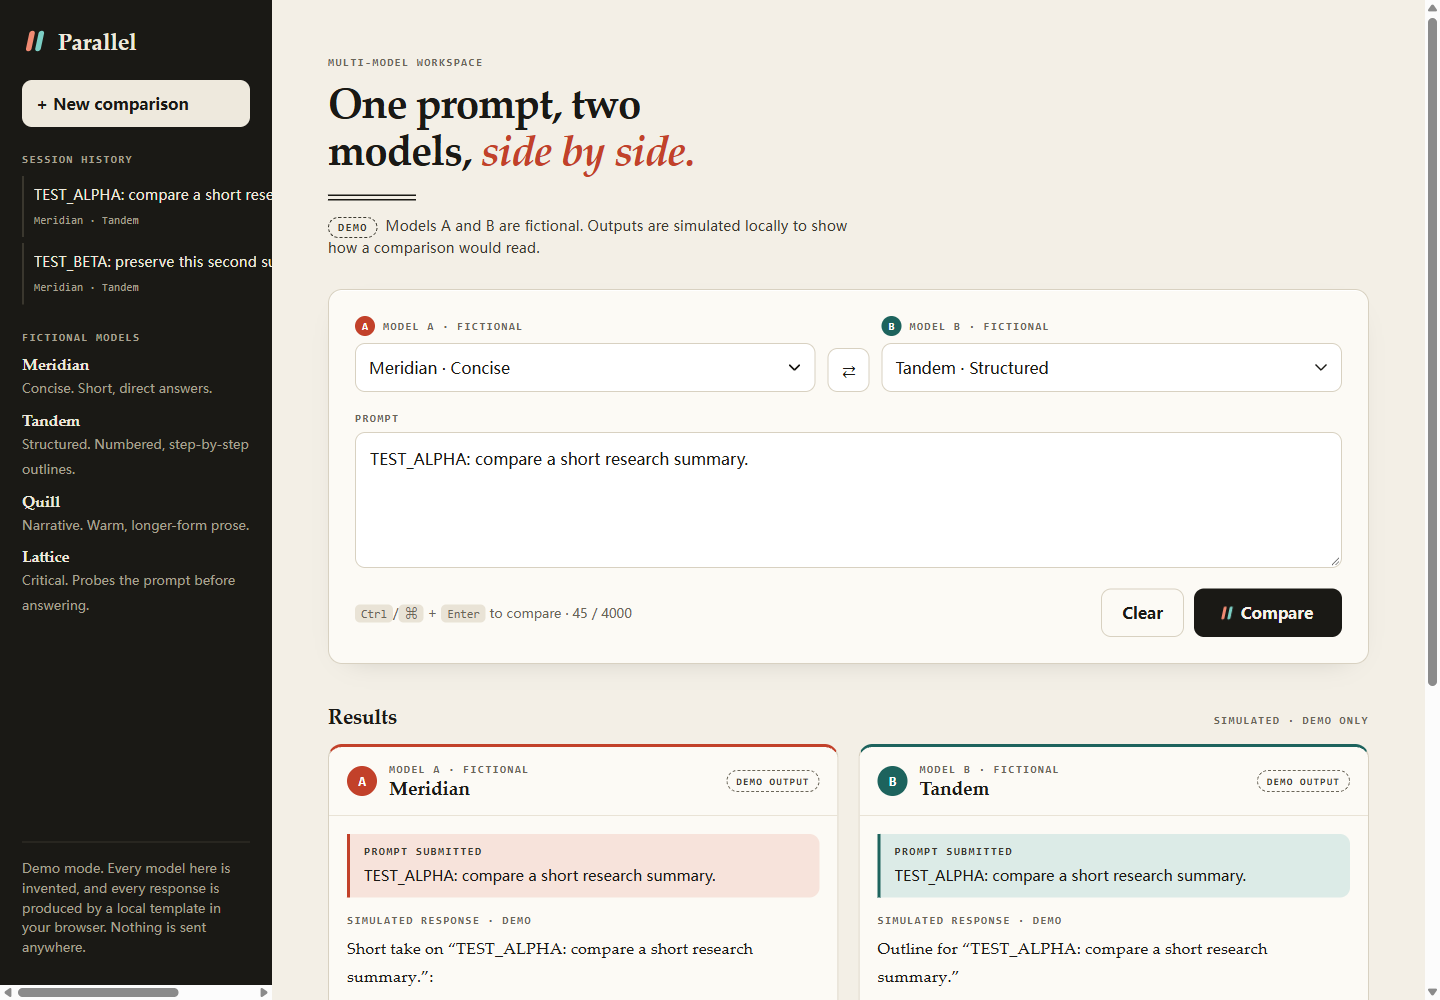
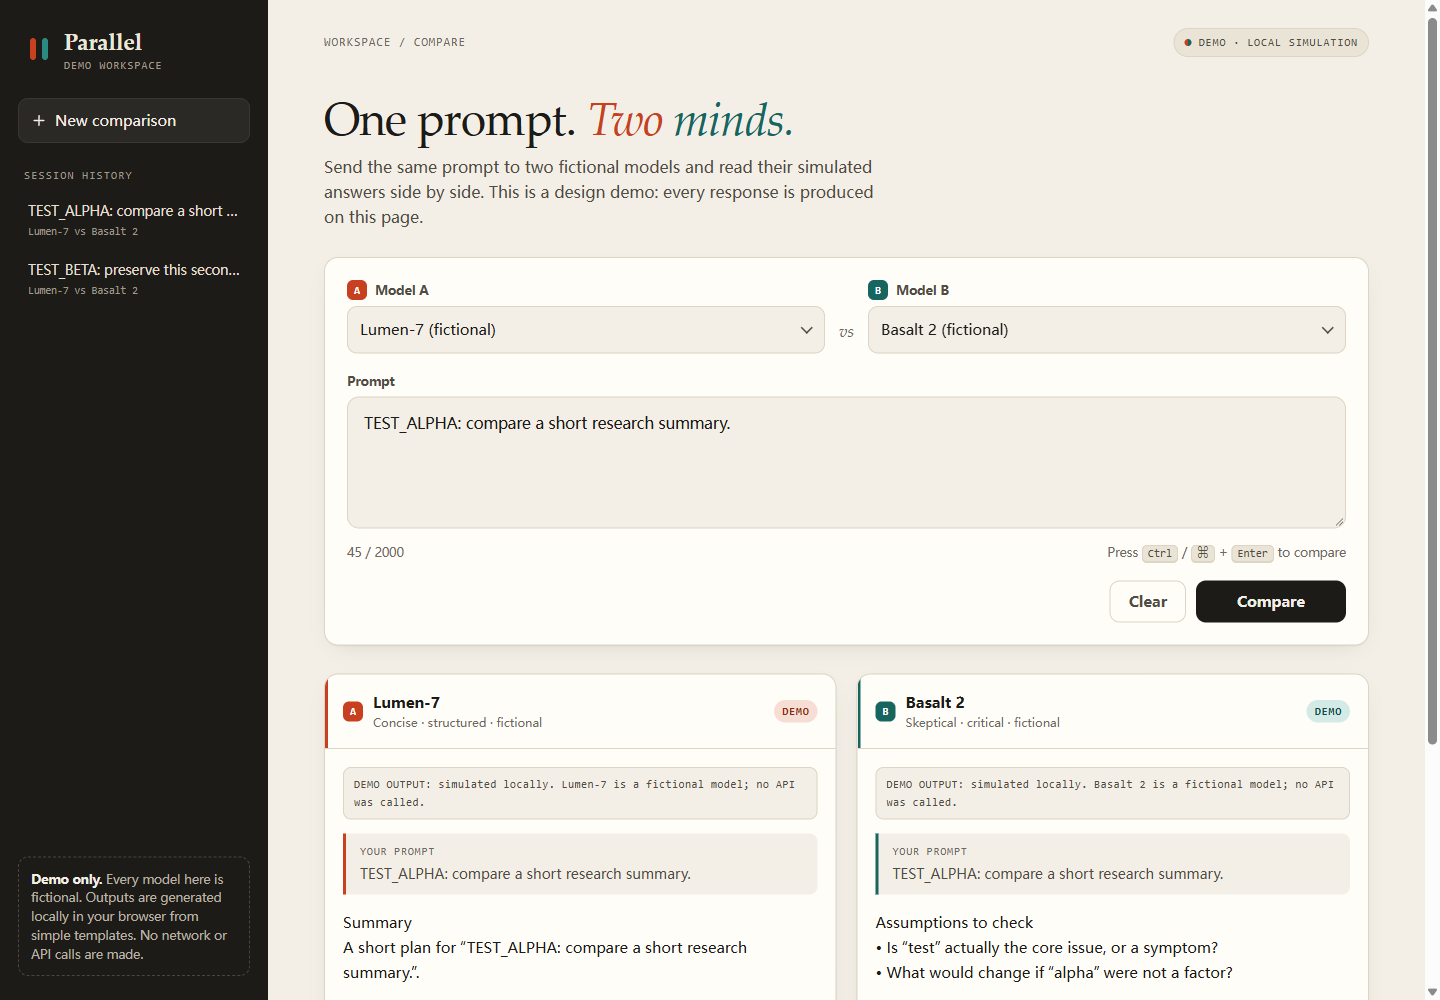
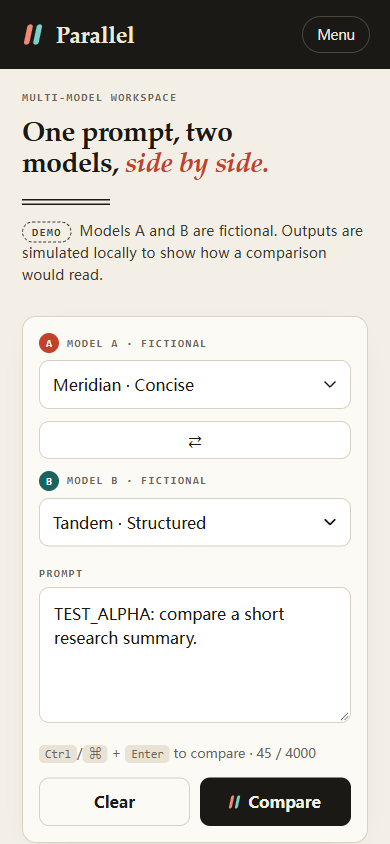
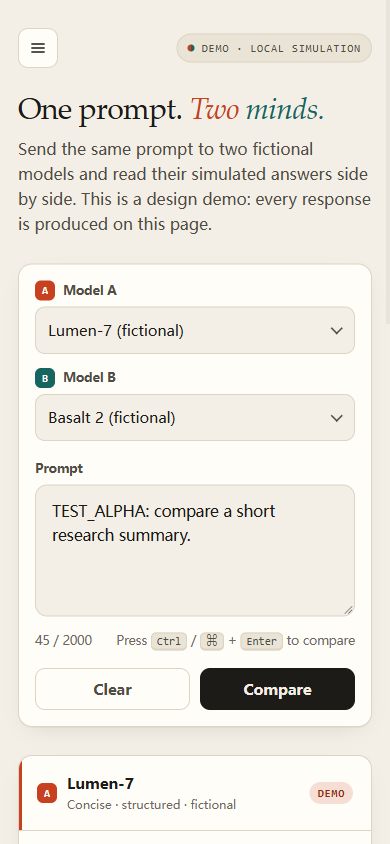
Cómo se veían realmente las páginas renderizadas
Ejemplo de Fable 5.2
Un titular serif más pesado, énfasis rojo en cursiva y una barra lateral de alto contraste le dan a esta página una identidad editorial más fuerte. Su control de cambio de modelo es un extra útil, pero ocupa una fila completa en el móvil y empuja la solicitud y los resultados más abajo.
Ejemplo de Opus 5.5
El titular más ligero y el área de selección de modelo más simple se sienten más sobrios. En el mismo viewport móvil, el botón Comparar termina alrededor de 710 píxeles desde la parte superior, frente a 826 píxeles en la muestra de Fable, dejando espacio para que la primera tarjeta de resultado aparezca antes.
Ambos eligieron tonos de papel cálidos, barras laterales oscuras y titulares serif. La diferencia aquí está en la jerarquía y la densidad, no en un lenguaje de diseño completamente diferente.Para este espacio de trabajo en particular, preferimos el diseño compacto de la muestra de Opus.Si la prioridad es un titular editorial más destacado, la muestra de Fable tiene ese atractivo. Esta es una preferencia subjetiva entre estos artefactos devueltos, no una clasificación estética general de los modelos subyacentes.
Comprobaciones del navegador: apariencia y comportamiento por separado
| Comprobar | Muestra de Fable | Muestra de Opus |
|---|---|---|
| Validación de entrada vacía | Aprobado | Aprobado |
| Las comparaciones repetidas conservan el prompt enviado | Aprobado | Aprobado |
| Retroalimentación de carga visible | Aprobado | Aprobado |
| Borrar entrada | Aprobado | Aprobado |
| Desbordamiento de página a 390 píxeles de ancho | Ninguno medido | Ninguno medido |
| El fallo de copia informa de un error honestamente | Aprobado | Aprobado |
| Copia exitosa al portapapeles | No verificado | No verificado |
Abrimos las salidas sin editar en Chrome y usamos controles DOM para ejecutar las comprobaciones. Las capturas de pantalla de escritorio usan 1440 × 1000; las capturas de pantalla móviles usan 390 × 844. Las cuatro muestran el mismo prompt enviado después de la comparación y antes de la verificación de copia. No se capturaron excepciones en tiempo de ejecución durante estos pasos. Las escrituras en el portapapeles no tuvieron éxito en la sesión automatizada y no se probó un recorrido completo solo con teclado.
El uso del par de diseño final da un proxy de tarifa estándar de $0.8826 para Fable y $0.2918 para Opus. Esto utiliza tarifas de proveedores y tokens informados por la puerta de enlace, excluye intentos anteriores y no es la factura real de la puerta de enlace.
Intentos anteriores y límites de la evidencia
Creador de contenido: copia precisa en dos formatos
Misma indicación · Prueba del creador de contenido
You are a content creator. Based ONLY on these FICTIONAL product facts, write a180-word plain-English explainer and a45-second video script with timestamps, then a five-item fact-check checklist. Facts: Lumen is a fictional AI workspace; it lets users compare two AI text drafts side by side, save prompts locally in their browser, and manually copy a chosen result. It does not publish content automatically, browse the web, or verify facts. No prices, launch dates, speed metrics, supported model names, or privacy guarantees are provided. Audience: freelancers who struggle to choose a usable first draft. Explain a practical example, avoid hype and invented claims, and distinguish local prompt saving from an unproven no-training guarantee.
El encargo del creador proporcionaba un espacio de trabajo ficticio con solo tres funciones: comparación de borradores en paralelo, guardado local de prompts y copiado manual. Pedía un texto explicativo de 180 palabras, un guion de 45 segundos y una lista de verificación de datos de cinco puntos.
Ambos textos explicativos cumplieron el requisito de 180 palabrassegún nuestra regla de conteo de palabras, que mantiene los apóstrofos y guiones internos dentro de una palabra. Ambos preservaron los límites de las funciones y evitaron correctamente tratar el almacenamiento local como una garantía de no entrenamiento.
Fable 5.2
Comenzó con la dificultad del freelancer para elegir un borrador y luego explicó las tres funciones en oraciones cortas. Su voz en off del video contenía 101 palabras: aproximadamente 135 palabras por minuto si se entrega en 45 segundos.
Opus 5.5
Utilizó un ejemplo de redactor más detallado, contrastando una apertura más sólida con explicaciones de funciones más claras. Su voz en off contenía 109 palabras: aproximadamente 145 palabras por minuto en el mismo intervalo.
Esas estimaciones de ritmo provienen de la voz en off escrita, no de una grabación cronometrada. Fable deja más espacio para pausas; Opus usa más del intervalo para explicar el ejemplo.
Para artículos más largos, nuestra guía usar Claude para la redacción de textos largos explica cómo separar la redacción de la verificación y la edición.
Analista de datos: reembolsos, atribución faltante y ROAS
Misma indicación · Prueba de analista de datos
You are a data analyst. Use only this synthetic data. Orders CSV(order_id,updated,status,channel,amount): o1,1,paid,Search,100; o2,1,paid,Social,80; o2,2,refunded,Social,80; o3,1,paid,Search,120; o4,1,pending,Email,60; o5,1,paid,,50; o6,1,paid,Partner,90; o7,1,paid,Email,70; o8,1,paid,Social,60; o9,1,paid,Partner,110. Channel spend/clicks: Search200/100; Social100/80; Email50/40; Partner0/20. Deduplicate by order_id keeping greatest updated. Paid orders count and revenue use latest paid only; refunded/pending contribute zero. Blank channel must remain Unknown and cannot inherit spend/clicks. Calculate overall paid count, revenue, each channel paid count/revenue/conversion rate per click/ROAS, and measurable ROAS ranking; zero or missing denominator is N/A. Show arithmetic and propose a cautious next-budget decision without inferring causality. Return table and explanation under600 words.
La tarea del analista fue diseñada para detectar errores que una tabla ordenada puede ocultar: identificadores de pedido duplicados, un reembolso posterior, un pedido pendiente, un canal desconocido y un canal de socio sin gastos.
Ambos modelos coincidieron con la clave de respuestas preparada: 7 pedidos pagados y 600 de ingresos después de mantener el último estado del pedido. Excluyeron los registros reembolsados y pendientes, mantuvieron la atribución faltante bajo Desconocido y marcaron las proporciones indefinidas como N/D.
| Canal | Pedidos pagados | Ingresos | Conversión / clic | ROAS |
|---|---|---|---|---|
| Búsqueda | 2 | 220 | 2.00% | 1.10 |
| Social | 1 | 60 | 1.25% | 0.60 |
| Correo electrónico | 1 | 70 | 2.50% | 1.40 |
| Socio | 2 | 200 | 10.00% | N/D: sin gastos |
| Desconocido | 1 | 50 | N/D | N/D |
Fable mostró la aritmética de ingresos en la tabla de canales y sugirió comprobar los reembolsos, los pedidos pendientes, las etiquetas faltantes y los costes de socios no registrados antes de cambiar mucho. Opus añadió una tabla de deduplicación registro por registro y calculó que los ingresos no atribuidos eran el 8,3 % del total.
Ambos recomendaron una prueba con presupuesto limitado en lugar de tratar el ROAS observado como prueba causal. El comentario de Opus de que una venta social adicional duplicaría aproximadamente el ROAS supone un importe de pedido similar; no era un hecho nuevo en la entrada.
Gerente de producto: el daño antes que los votos de funciones
Mismo prompt · Prueba de gerente de producto
You are a product manager for a FICTIONAL AI subscription workspace. Feedback: 2 users report duplicate charges after retrying checkout; billing logs confirm one duplicate captured charge. 30 users request dark mode. 8 report one model unavailable and no warning before using a prompt; outage reproduced. 1 requests account/data deletion; request pending for20 days, governing deadline unknown. 12 request reusable saved prompts. 4 want team seats; no revenue commitment. Two engineers available for one week; effort estimates unknown. Produce a one-week priority plan with rationale, explicit unknowns, scope boundaries, owner roles, acceptance criteria, instrumentation and rollback/containment steps. Do not fabricate legal deadlines, revenue, effort or certainty. Distinguish immediate containment from permanent fixes; do not rank purely by vote count. Under700 words.
El informe del producto combinaba un cargo duplicado confirmado con una solicitud de eliminación vencida para el usuario, una interrupción del modelo reproducida y más solicitudes de funciones populares. La trampa era priorizar 30 votos para el modo oscuro sobre el daño demostrado.
Ambos modelos pusieron la facturación, el seguimiento de la eliminación y la contención de la interrupción por delante de la creación de funciones. Ninguno inventó un plazo legal para la eliminación. Ambos asignaron roles de propietario, separaron la contención inmediata de las soluciones permanentes y propusieron controles de aceptación y monitoreo.
Fable 5.2
Especificó la conciliación de reembolsos, una corrección para prevenir cargos repetidos y la contención manual de interrupciones. Trató explícitamente la posible pérdida de cuota como algo a confirmar y marcó la eliminación como irreversible.
Opus 5.5
Se añadió una advertencia previa al envío, la conservación de las instrucciones y una regla explícita contra el cambio silencioso de modelos. Su tabla de priorización era rápida de revisar.
Sin embargo, decía que los usuarios “pierden trabajo e instrucciones en silencio”. Los comentarios proporcionados establecían una interrupción y una advertencia faltante, no una pérdida comprobada de instrucciones.
Precios de Fable 5.2 frente a Opus 5.5
Para solicitudes de API estándar, Fable 5.2 cuesta el doble por token que Opus 5.5. Eso convierte a Opus en el punto de partida más económico cuando ambos modelos ofrecen un resultado aceptable con un uso de tokens similar.
Entrada / salida
Entrada / salida
Estas son las tarifas estándar de entrada/salida de Anthropic, verificadas el 11 de noviembre de 2026, de laespecificación Fable.
La especificación Opus enumera la tarifa estándar correspondiente. El modo rápido, el almacenamiento en caché, los descuentos por lotes, las suscripciones de consumidores y la facturación de terceros tienen términos diferentes.
Para una solicitud ilustrativa con 10.000 tokens de entrada y 5.000 tokens de salida, la aritmética de la tarifa estándar es de $0,28 para Fable y $0,14 para Opus. Este es un ejemplo resuelto, no una factura de nuestras pruebas.
Una tarifa de token más alta no implica un mayor costo por tarea exitosa. Una respuesta más corta, menos rondas de revisión o menos razonamiento pueden cambiar el total. Nuestras pruebas de un solo turno no pueden establecer ahorros a largo plazo.
Si está integrando cualquiera de los modelos en una aplicación, guía de configuración de la API de Claude cubre las preguntas de configuración por separado de la comparación de tarifas de tokens aquí.
Multiplicar el uso informado por la puerta de enlace por las tarifas estándar de Anthropic da un proxy basado en tarifas de $0,4291 para Fable versus $0,1799 para Opus en esas cuatro tareas. La fórmula es tokens de entrada × tarifa de entrada + tokens de salida × tarifa de salida, dividido por un millón. Esto excluye todas las solicitudes de diseño y las llamadas fallidas.proxy basado en tarifas de $0.4291 para Fable frente a $0.1799 para Opus en esas cuatro tareas. La fórmula es tokens de entrada × tarifa de entrada + tokens de salida × tarifa de salida, dividido por un millón. Esto excluye todas las solicitudes de diseño y las llamadas fallidas.
Este proxy es no es el cargo real de la puerta de enlace. No verificamos su factura, la equivalencia de la contabilidad de tokens ni el margen. Tampoco mide el costo de la edición humana posterior o de intentos adicionales.
Lo que establecen los benchmarks oficiales
La evaluación de lanzamiento de Anthropic le da a Fable una ventaja en varias tareas difíciles. La siguiente tabla reproduce tres puntuaciones reportadas; estas son evaluaciones del proveedor, separadas de nuestras propias pruebas basadas en roles.
| Evaluación | Fable 5.2 | Opus 5.5 |
|---|---|---|
| FrontierCode 2.0 | 49.1% | 45.5% |
| FrontierSWE v2 | 69.9% | 62.3% |
| Terminal-Bench-Science 0.1 | 74.6% | 58.7% |
El informe de lanzamiento utiliza el mayor esfuerzo disponible de cada modelo, a menos que se indique lo contrario. Estas puntuaciones respaldan probar Fable en trabajos técnicos exigentes; no establecen una ventaja universal en escritura, criterio de producto o gusto visual.
Ambos modelos indican una ventana de contexto de un millón de tokens y un límite de salida de 128.000 tokens. Esos límites no se sometieron a pruebas de estrés aquí.
Preguntas frecuentes
¿Es Fable 5.2 mejor que Opus 5.5 para programar?
Anthropic informa puntuaciones más altas de Fable en varias evaluaciones de codificación difíciles. Nuestro ejercicio de codificación es un espacio de trabajo de IA de un solo archivo, no un punto de referencia de repositorio, por lo que no puede establecer un ganador general de codificación.
¿Fable 5.2 cuesta más?
Sus tarifas estándar de entrada y salida de API son el doble que las de Opus 5.5: 8 $/40 $ frente a 4 $/20 $ por millón de tokens. El coste real de la tarea también depende del uso, el razonamiento, los reintentos, el almacenamiento en caché y el servicio que le factura.
¿Se ejecutaron estas pruebas dentro de GlobalGPT?
No. Utilizaron los modelos nombrados a través de una puerta de enlace API de terceros. No establecen disponibilidad de modelos, facturación ni funciones nativas dentro de GlobalGPT o las aplicaciones propias de Claude.
¿Se puede confiar en cualquiera de los dos modelos para resumir investigaciones sin verificar?
Ambas respuestas de investigación calcularon correctamente el resultado principal, pero cada una introdujo al menos una inferencia que necesitó edición. Verifique cada detalle del diseño del estudio y separe las estimaciones de las afirmaciones de significación.
¿Una página generada con mejor aspecto demuestra una mejor capacidad de codificación?
No. El diseño visual, las interacciones funcionales, la accesibilidad y la mantenibilidad son dimensiones separadas. Una sola página atractiva no puede establecer la confiabilidad de la codificación a nivel de repositorio.
¿Se les dio a los modelos el mismo esfuerzo de razonamiento?
Utilizamos entradas y límites de salida idénticos, con la configuración de razonamiento dejada en el valor predeterminado de la plataforma. El mapeo de la puerta de enlace no se verificó de forma independiente, por lo que no se trata de una evaluación comparativa de igual esfuerzo.
¿Debería cambiar todo mi trabajo a Fable 5.2?
Utilice primero una prueba de aceptación específica de la tarea. Comience con el modelo menos costoso que la cumpla y luego pase a Fable cuando pueda identificar una mejora que valga la pena.
Veredicto final: ¿Qué modelo debería usar?
Comience con Opus 5.5 cuando el objetivo sea un primer borrador aceptable. Su tarifa de tokens estándar más baja lo convierte en la base práctica para la escritura rutinaria, la limpieza de datos y la planificación. Para más contexto, consulte nuestra reseña de Claude Opus 5.5.
Pruebe Fable 5.2 cuando una tarea difícil específica siga sin cumplir sus criterios de aceptación. Mantenga las mismas entradas y compruebe si corrige el fallo real. La guía de selección de modelos también recomienda comenzar con el último Opus y escalar cuando el Opus de mayor esfuerzo se queda corto.
Si no se necesita ninguno de los dos modelos premium, Sonnet 5.5 vs Opus 5.5 es la comparación de costos más relevante.
Para un conjunto más amplio de proveedores, consulte nuestras pruebas de generador de texto con IA.
Para el trabajo con repositorios, la demostración de un solo archivo de esta revisión es solo un punto de partida. No prueba el acceso a shell, las ediciones de múltiples archivos, el uso prolongado de herramientas ni el comportamiento de recuperación de un agente de codificación. Para obtener detalles de configuración, consulte nuestra guía elegir un modelo en Claude Code antes de tratar una finalización de chat como sustituto de un entorno de desarrollo completo.



