Comparativa de los modelos Claude: Haiku, Sonnet y Opus, y el lugar que ocupa Fable
Ariette Wynn
Última actualización: 9 de septiembre de 2026
Una guía práctica para 2026 sobre cómo elegir en función de la velocidad, el coste de la API, el contexto, la complejidad de la tarea y el coste de una respuesta errónea.
Para la mayoría de las tareas cotidianas de redacción, análisis, programación y uso de herramientas, empieza con Claude Sonnet 5. Elige Haiku 4.5 cuando la baja latencia y el alto volumen sean más importantes que la gestión de casos extremos difíciles. Elige Opus 5 cuando la tarea sea compleja, difícil de verificar o cuando un error resulte muy costoso. Fable 5.1 se sitúa por encima de Opus como una vía de escalación especializada, no como opción predeterminada.
Esas recomendaciones se refieren a cargas de trabajo mixtas generales. Las directrices de producción del Anthropic indican que la mayoría de las cargas de trabajo deberían comenzar con Opus 5, mientras que su propia matriz de tareas sitúa por separado a Sonnet para tareas cotidianas que requieren velocidad y capacidad. Por lo tanto, el punto de partida adecuado depende de tu tolerancia al riesgo y de tu proceso de evaluación, y no solo del nombre del modelo.
GlobalGPT amplía el flujo de trabajo Práctico con una única suscripción asequible: Claude, GPT-5.6 Sol, Gemini 3 Pro, Kimi K3 y múltiples funciones de IA comparten un único panel de control para la investigación, la redacción, el análisis, la programación y el perfeccionamiento. Su interfaz de línea de comandos (CLI) también permite integrar el acceso a esos modelos en tu terminal, en tu flujo de trabajo de desarrollo y en tus herramientas de producción actuales. Comparar los resultados es una parte útil del flujo de trabajo; para conocer la gama más amplia de opciones a nivel de familia, consulta nuestro Comparación entre ChatGPT, Claude y Gemini. El resto de esta guía se centra en la elección dentro de la gama Claude.
Los cuatro niveles actuales resuelven diferentes problemas económicos. La llamada más barata no siempre es la tarea completada más económica, y el modelo más potente no supone automáticamente el mejor uso del presupuesto.
Guía de elección del modelo Claude
Elige en función de la carga de trabajo y el coste de las averías
Utiliza Sonnet para el trabajo diario habitual; opta por una configuración más sencilla cuando se busque la eficiencia, y elige una configuración más compleja cuando la verificación resulte complicada o los errores tengan un coste elevado.
Haiku 4,5
La eficiencia ante todo
Empieza por aquí si se trata de tareas de gran volumen, sensibles a la latencia y con límites bien definidos, cuyos errores sean fáciles y económicos de detectar y corregir.
Sube de nivel cuandoLos casos extremos o el tiempo de corrección de los revisores anulan la ventaja en el precio de los tokens.
Soneto 5
Equilibrio diario
Utilízalo para trabajos que combinen redacción, análisis, programación, comprensión visual y el uso de herramientas, y que sigan siendo objeto de una revisión habitual.
Sube de nivel cuandoEl razonamiento a largo plazo, la verificación o el coste de los fallos se convierten en el factor limitante.
Obra n.º 5
La capacidad es lo primero
Empieza por aquí si se trata de una codificación compleja con agentes, trabajos empresariales, diagnósticos difíciles o decisiones en las que un error puede salir muy caro.
Desplázate hacia abajo cuandoUn modelo más económico supera una y otra vez las mismas pruebas de aceptación.
Fable 5.1
Ruta de excepción
Recurre a este nivel solo en casos de razonamientos complejos o tareas de agente de larga duración, cuando Opus, que requiere un mayor esfuerzo, siga sin cumplir con tus criterios de evaluación.
No des nada por sentadoUn nivel superior resulta automáticamente más económico una vez que se tienen en cuenta la calidad, el tiempo de revisión y los intentos de repetición.
La regla práctica
Selecciona una tarea representativa y sus comprobaciones de aceptación. Elige el modelo más económico que supere las pruebas de forma fiable y, a continuación, calcula el tiempo necesario para la corrección y la verificación antes de considerarlo la opción más económica.
La gama actual de modelos Claude
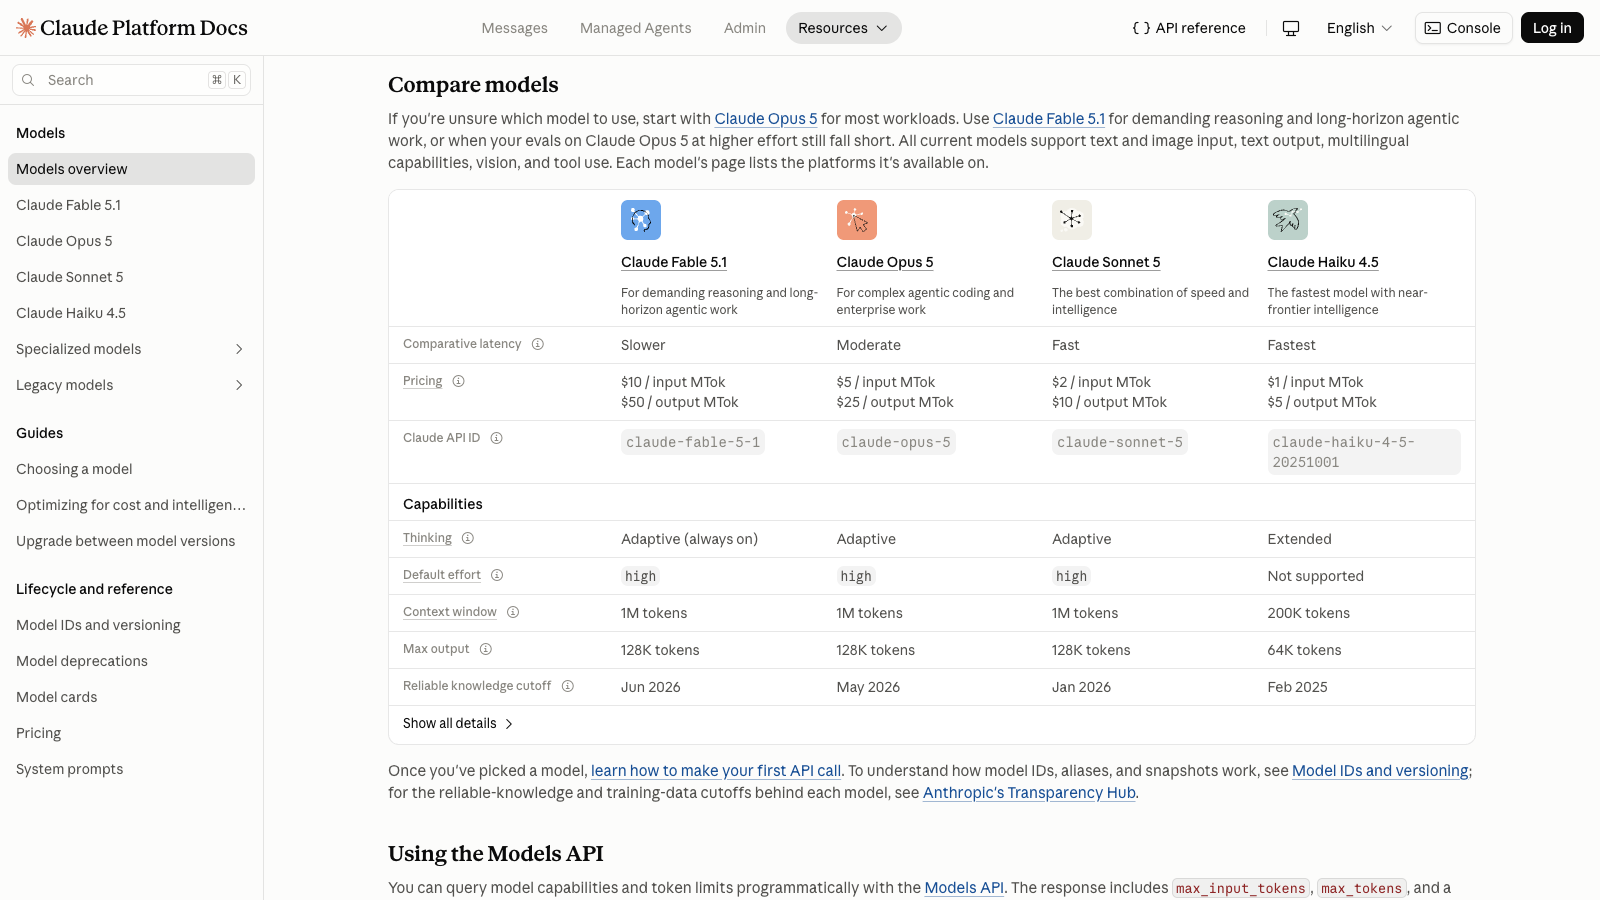
A fecha de 8 de septiembre de 2026, la gama activa de Anthropic incluye Claude Haiku 4.5, Claude Sonnet 5, Claude Opus 5 y Claude Fable 5.1. Haiku, Sonnet y Opus son nombres de familia duraderos, pero la versión asociada a cada familia cambia con el tiempo. Anota el ID exacto del modelo que has evaluado en producción, en lugar de dar por sentado que una etiqueta de familia siempre corresponderá a la misma instantánea.
Modelo actual
Etiqueta oficial de velocidad
Contexto de la API
Potencia máxima
Entrada y salida de la API base
Haiku 4,5
Más rápido
200 000
64K
$1 / $5 por MTok
Soneto 5
Rápido
1M
128K
$2 / $10 por MTok
Obra n.º 5
Moderado
1M
128K
$5 / $25 por MTok
Fable 5.1
Más lento
1M
128K
$10 / $50 por MTok
En la descripción general de modelos de Anthropic figuran Haiku 4.5, Sonnet 5, Opus 5 y Fable 5.1 como la gama actual a fecha de 8 de septiembre de 2026.
El acceso a Claude.ai no es lo mismo que las especificaciones de la API
La tabla de planes de Claude.ai describe el acceso de los usuarios y, actualmente, indica una ventana de contexto de 200 000 para los planes individuales. La documentación de la API detalla los límites de contexto y de salida específicos de cada modelo, incluyendo una ventana de contexto de 1 millón para Sonnet 5, Opus 5 y Fable 5.1. No utilices la tabla de la API para deducir qué incluye un plan Claude.ai concreto, ni utilices la tabla de planes para consumidores para deducir los límites de un modelo de la API. Consulta el Guía de precios y planes de Claude para la distinción a nivel de plan.
Claude Haiku, Sonnet y Opus: diferencias clave
La principal disyuntiva no es una simple clasificación por calidad. A medida que se asciende en la lista, se obtiene mayor capacidad para realizar tareas complejas, pero también aumenta el coste básico en tokens y, por lo general, se reduce la velocidad. Los límites de contexto y los controles de razonamiento también varían.
Las compensaciones prácticas
Etiquetas oficiales y especificaciones básicas de la API, junto con puntos de partida prácticos para cargas de trabajo habituales.
Dimensión
Haiku 4,5
Soneto 5
Obra n.º 5
El mejor punto de partida
Trabajo rápido, repetitivo y limitado
Trabajo intelectual cotidiano de carácter mixto
Trabajo complejo y de gran repercusión
Etiqueta oficial de velocidad
Más rápido
Rápido
Moderado
Contexto y salida de la API
200 K / 64 K
1 M / 128 K
1 M / 128 K
Control del razonamiento
Pensamiento manual ampliado
Pensamiento adaptativo y esfuerzo
Pensamiento adaptativo y esfuerzo
Precio base de la API
Entrada $1 / Salida $5
Entrada $2 / Salida $10
$5 entrada / $25 salida
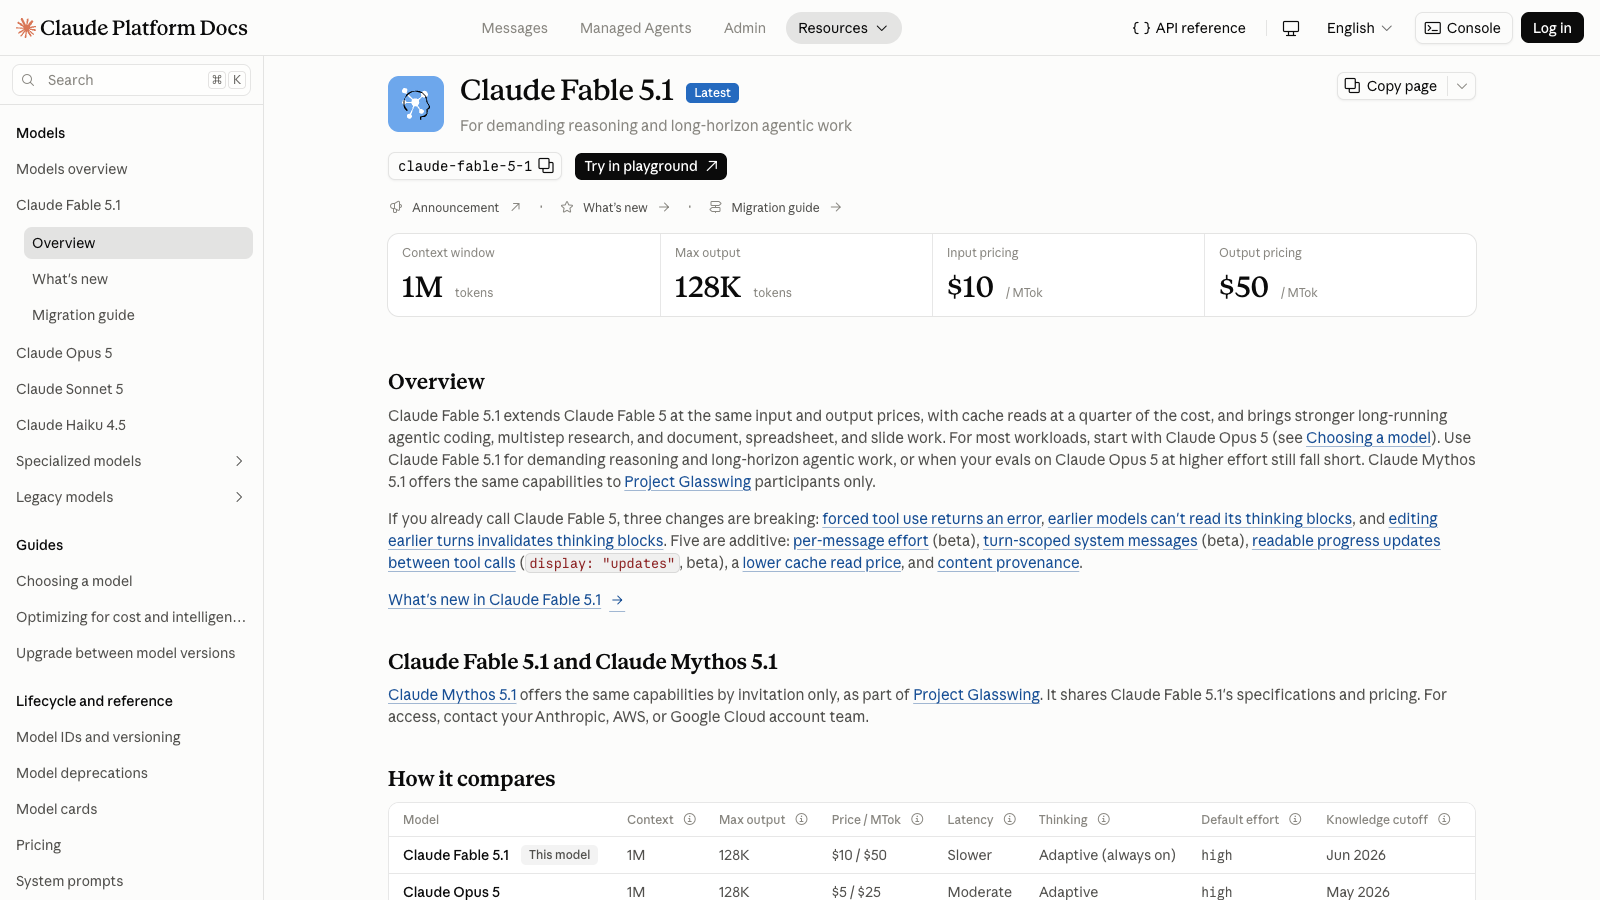
Dónde encaja Fable: Fable 5.1 se denomina oficialmente «Slower», con un contexto de 1 millón, una salida máxima de 128 K y un precio base de entrada/salida de $10 / $50 por millón de tokens. Considéralo un nivel superior cuando Opus, incluso con un mayor esfuerzo, siga sin cumplir tus criterios de evaluación.
Velocidad y latencia
Las etiquetas Anthropic, Haiku 4.5 “Más rápido”, Sonnet 5 “Rápido”, Opus 5 “Moderado” y Fable 5.1 “Más lento”. Se trata de etiquetas cualitativas de los productos, no de milisegundos medidos ni de tokens por segundo. La latencia real depende del tamaño de la solicitud, la configuración del razonamiento, las herramientas, la carga y el modo de servicio.
Controles de contexto, salida y razonamiento
El contexto de la API de Haiku, más reducido (200K), y su salida máxima de 64K siguen siendo más que suficientes para muchos trabajos con límites definidos. Sonnet y Opus amplían ambos límites a 1M y 128K. Haiku 4.5 utiliza el razonamiento extendido manual, mientras que Sonnet 5 y Opus 5 admiten el razonamiento adaptativo y el control del esfuerzo. Esa diferencia es una de las razones por las que una única configuración de razonamiento idéntica no puede crear pruebas perfectamente equivalentes en todos los modelos.
¿Qué modelo Claude debes utilizar para cada tarea?
Carga de trabajo
Comience con
Por qué
Actualizar cuando
Clasificación, extracción, derivación, triaje de asistencia
Haiku 4,5
La baja latencia y el bajo coste básico de los tokens se adaptan a tareas claras y repetibles.
Los casos extremos o el tiempo de corrección anulan el ahorro.
La capacidad es más importante que el precio por token más bajo.
Opus, a pesar de haber requerido un mayor esfuerzo, sigue sin superar una exigente evaluación representativa.
Obras excepcionales de larga duración o que requieren un gran esfuerzo de razonamiento
Fable 5.1
Es la ruta de escalada actual situada por encima de Opus.
Utilízalo únicamente cuando el beneficio obtenido justifique su mayor coste.
Se trata de puntos de partida, no de soluciones universales. Por ejemplo, un cambio de código breve pero de gran importancia puede justificar el uso de Opus, mientras que una tarea de extracción larga pero muy estructurada puede seguir siendo adecuada para Haiku. Para ver ejemplos prácticos de flujos de trabajo, consulta nuestra guía sobre utilizando Claude para la codificación.
Cuando tu lista de candidatos se amplíe más allá de Claude, GlobalGPT te permite ejecutar la misma indicación representativa en Claude, GPT-5.6 Sol, Gemini 3 Pro y Kimi K3 en un único espacio de trabajo. Mantén constante el control de aceptación: la velocidad es importante para el trabajo repetitivo, mientras que la calidad de las respuestas y el tiempo de corrección determinan si un resultado de menor coste es realmente más económico.
Elige en función del coste del fracaso, no solo del tipo de tarea
Las etiquetas de las tareas ocultan la variable más importante: ¿qué ocurre cuando la respuesta es incorrecta? El marco que se muestra a continuación es una herramienta de toma de decisiones editoriales basada en las directrices de Anthropic, que dan prioridad a la eficiencia y a la capacidad. No se trata de un punto de referencia de Anthropic.
Escala de costes de fallo
Empieza por un nivel más bajo cuando detectar los errores resulte barato; empieza por un nivel más alto cuando la verificación sea incompleta o costosa.
Bajo coste
Ejemplos Etiquetado, enrutamiento, limpieza de borradores, resúmenes reversibles
Inicio Haiku 4,5
Elevar el asunto Cuando el tiempo dedicado a las correcciones anula la mejora en la eficiencia
Material
Ejemplos Borradores destinados a los clientes, análisis revisados, código de producción probado
Inicio Soneto 5
Elevar el asunto Cuando la revisión no permite detectar de forma fiable fallos importantes
Caro
Ejemplos Cambios que requieren un alto grado de autonomía, diagnósticos complejos, decisiones de gran trascendencia
Inicio Obra n.º 5
Elevar el asunto A «Fable» solo después de que «Opus», que requiere un mayor esfuerzo, falle una evaluación congelada
Cuándo actualizar o volver a una versión anterior de tu modelo Claude
Avanza solo cuando aparezca un límite medido
Del haiku al soneto
Actualiza cuando los casos extremos, los errores en las instrucciones o el tiempo dedicado a las correcciones de los revisores superen el ahorro obtenido.
Soneto a Opus
Actualiza el sistema cuando la ejecución a largo plazo, el razonamiento complejo, la verificación o el coste de los fallos se conviertan en una limitación.
Opus con mayor esfuerzo
Prueba la carga de trabajo exigente con comprobaciones de aceptación congeladas antes de pasar al nivel superior.
De «Opus» a «Fable»
Recurre a un nivel superior solo cuando el Opus, que requiere un mayor esfuerzo, siga sin superar la evaluación representativa y la ventaja justifique el coste.
Regla de rebaja de calificación: Vuelve a bajar de categoría cuando un modelo más barato supere repetidamente las mismas pruebas de aceptación con la latencia y la fiabilidad requeridas.
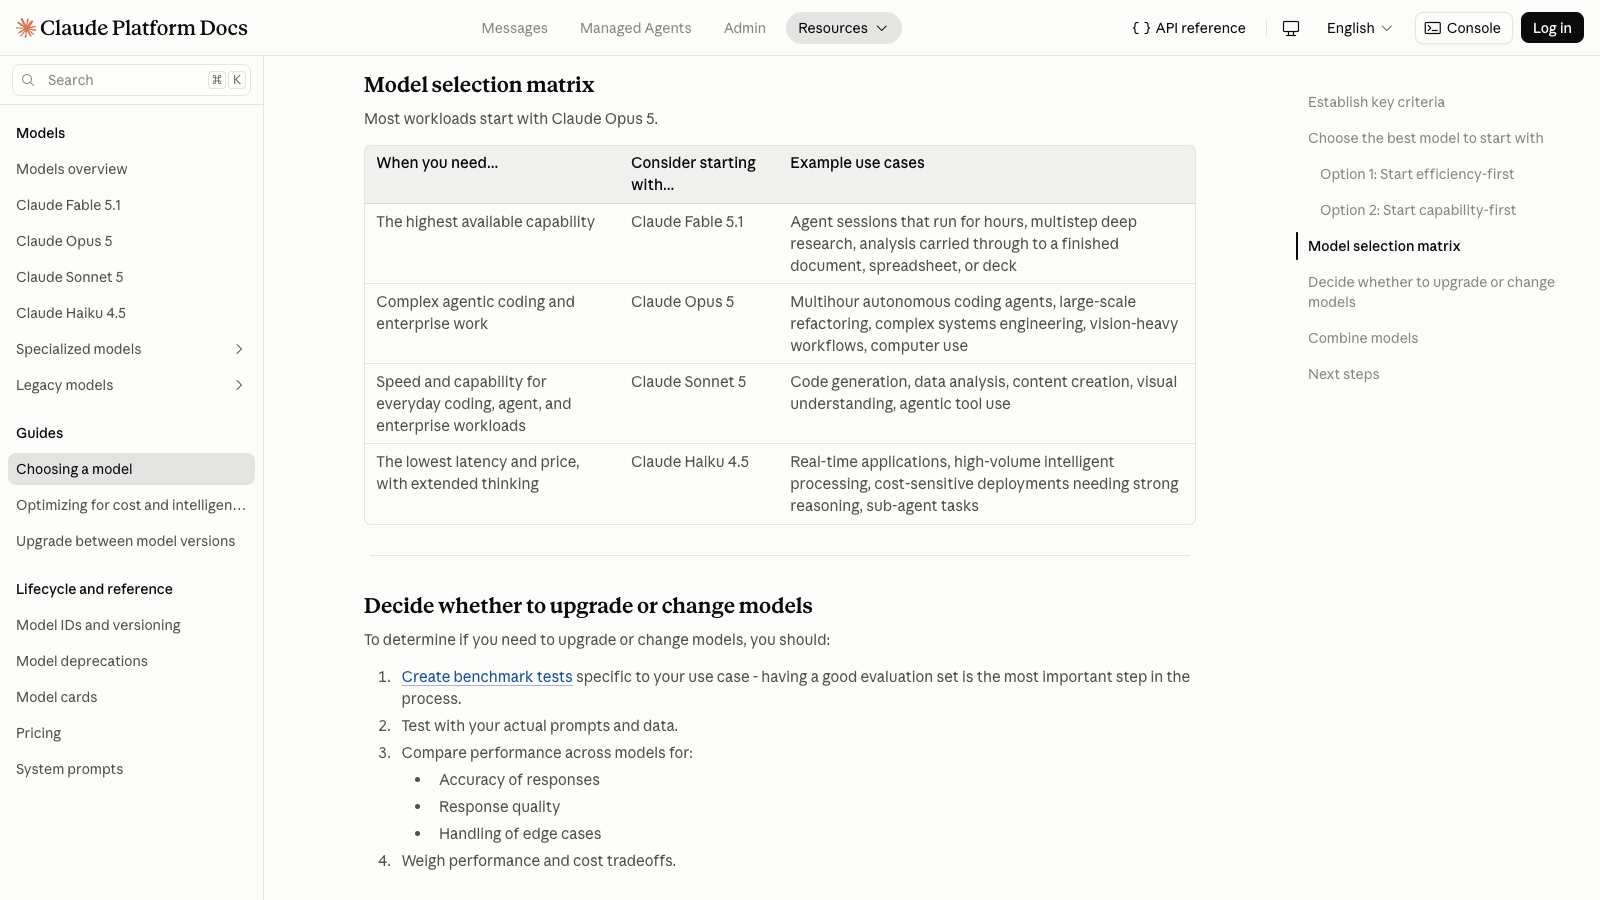
La matriz de Anthropic clasifica los cuatro modelos actuales de Claude según diferentes necesidades de capacidad, velocidad y carga de trabajo.
Ejemplo de coste fijo de la API Claude
Para una carga de trabajo agregada fija de 1 millón de tokens de entrada más 100 000 tokens de salida repartidos entre varias solicitudes de API estándar, el coste base por token oscila entre $1,50 con Haiku 4.5 y $15,00 con Fable 5.1. No se trata de una sola solicitud y no anula los límites de salida por solicitud.
Una carga de trabajo, cuatro modelos Claude
El mismo volumen de tokens cuesta 2, 5 o 10 veces el total de Haiku a medida que se asciende en los niveles actuales.
Carga de trabajo 1,0 M de entrada + 0,1 M de salida en varias solicitudes
Haiku 4,5
$1.50
Soneto 5
$3.00
Obra n.º 5
$7.50
Fable 5.1
$15.00
Modelo
Cálculo de los datos de entrada
Cálculo de la producción
Total
Haiku 4,5
1,0 × $1
0,1 x $5
$1.50
Soneto 5
1,0 × $2
0,1 x $10
$3.00
Obra n.º 5
1,0 x $5
0,1 x $25
$7.50
Fable 5.1
1,0 x $10
0,1 x $50
$15.00
Incluye: Tipos de referencia estándar de los tokens de entrada y salida a partir de una instantánea de precios Anthropic.
Quedan excluidos: Almacenamiento en caché de solicitudes, API por lotes, modo rápido, ubicación geográfica, comisiones por uso de herramientas, impuestos, descuentos y créditos GlobalGPT.
La tabla de precios indica el coste de las fichas, no el coste de un resultado final. Un modelo más barato puede acabar resultando más caro si los reintentos, las correcciones y la verificación consumen más tiempo del personal que el ahorro que suponen las fichas.
Prueba práctica del modelo Claude: mismas indicaciones, diferentes modos de fallo
El 9 de septiembre de 2026, enviamos las mismas tres indicaciones a través de la API de Anywhere a Claude Haiku 4.5, Sonnet 5, Opus 5 y Fable 5.1. Las tareas abarcaban la clasificación estructurada de casos de asistencia, la redacción basada en pruebas y la depuración de código JavaScript auditable. Conservamos la primera respuesta válida de cada modelo y la evaluamos según unas reglas fijadas antes de que se revisaran las respuestas.
El resultado no fue una simple clasificación. Sonnet, Opus y Fable obtuvieron cada uno una puntuación de 26,5 sobre 30, aunque sus puntos fuertes y débiles diferían notablemente. Haiku devolvió un código HTTP 503 en los dos intentos permitidos para cada tarea, por lo que se desconoce la calidad de sus resultados en esta prueba.
Configuración de la prueba y resultado general
Tres indicaciones fijas, los mismos límites de tokens por tarea, sin herramientas ni búsquedas, y se conserva la primera salida válida de cada modelo.
Lugar de celebraciónAPI de Anywhere
Fecha9 de septiembre de 2026
TareasTriaje estructurado, nota de lanzamiento, depuración de JavaScript
Regla de reintentoError de transporte, 429/5xx, contenido vacío o respuesta mal formada
Modelo
Tareas completadas
Puntuación total de calidad
La señal más útil
Claude Haiku 4.5
0/3
Sin puntuación
Las seis solicitudes autorizadas devolvieron un código 503; solo disponibilidad de ruta.
Claude Soneto 5
3/3
26.5/30
El único modelo que cumple todos los requisitos indicados en las notas de lanzamiento.
Claude Opus 5
3/3
26.5/30
Gran profundidad de depuración; se pasó por alto una restricción de longitud de escritura.
Claude Fable 5.1
3/3
26.5/30
Resultados estructurados y limpios; la nota de inicio se truncó tras una respuesta vacía.
Salida estructurada
Prueba 1: Clasificación de tickets de asistencia técnica
Resultado de la tarea: Fable 5.1, 10/10
Fable fue el único modelo que devolvió un JSON directamente analizable con las seis etiquetas y acciones correctas. Opus y Sonnet acertaron con las etiquetas, pero añadieron delimitadores de Markdown; además, ambos reforzaron un plazo proporcionado, y Sonnet prometió prematuramente una corrección o un reembolso.
Modelo
Estado
Puntuación
Latencia en cualquier lugar
Tokens denunciados
¿Qué pasó?
Claude Haiku 4.5
Ruta no disponible
Sin puntuación
No disponible
No disponible
Dos respuestas 503; sin puntuación de calidad.
Claude Soneto 5
Salida conservada
7.5/10
10,39 s
1005
Las etiquetas son correctas, pero el JSON está entre comillas y el resultado de la devolución o corrección es inventado.
Claude Opus 5
Salida conservada
8.5/10
11,87 s
1051
Etiquetas correctas y medidas contundentes, pero con JSON «enjaulado» y un plazo más estricto.
Claude Fable 5.1
Salida conservada
10/10
8,55 s
680
JSON directamente analizable; se han superado todas las comprobaciones de «frozen».
Entrada completa de la prueba
Gestionas un buzón de asistencia técnica de un servicio SaaS. Clasifica cada ticket que aparece a continuación. Devuelve JSON solo con un campo de nivel superior denominado «tickets». «tickets» debe ser una matriz en el orden original, y cada elemento debe contener exactamente «ticket_id», «category», «urgency» y «action». «category» debe ser uno de los siguientes: «billing», «access», «bug» o «feature». «urgency» debe ser uno de los siguientes: «low», «medium» o «high». Utiliza únicamente el texto del ticket; no inventes resultados de políticas ni datos sobre los clientes.

#481: Nos han cobrado dos veces por la misma renovación anual. El cierre de nóminas es el viernes y necesito que se investigue antes de esa fecha.
#482: El restablecimiento de contraseña indica que se ha enviado el correo electrónico, pero no llega nada. He comprobado la carpeta de spam y lo he vuelto a intentar una vez.
#483: Las exportaciones en CSV redondean todos los importes en moneda a dólares enteros, mientras que el panel de control sigue mostrando céntimos.
#484: Por favor, añadid un modo oscuro al panel de análisis.
#485: Tras el cambio del dominio de nuestra empresa esta mañana, todos los empleados reciben un mensaje de acceso denegado al SSO.
#486: ¿Podríais enviarme una copia de la factura del mes pasado?
Claude Haiku 4.5: resultado operativo completo
No se generó ningún resultado del modelo. Los dos intentos permitidos con la API de Anywhere devolvieron un código de estado HTTP 503, por lo que esta ruta se marcó como no disponible y se excluyó de la puntuación de calidad.
Claude Sonnet 5: potencia máxima
```json
{
  "tickets": [
    {
 "ticket_id": "#481",
      "category": "facturación",
 "urgency": "alta",
 "action": "Investigar el cargo duplicado por la renovación anual y emitir una corrección o un reembolso antes de que se cierre la nómina del cliente el viernes."
    },
    {
 "ticket_id": "#482",
      "category": "acceso",
 "urgency": "media",
 "action": "Verificar la dirección de correo electrónico de la cuenta y la capacidad de entrega del correo, y a continuación activar manualmente o reenviar el correo electrónico de restablecimiento de contraseña."
    },
    {
 "ticket_id": "#483",
      "category": "error",
 "urgency": "media",
 "action": "Derivar a ingeniería para que corrija el redondeo en la exportación CSV, de modo que los valores monetarios coincidan con la precisión al céntimo que se muestra en el panel de control."
    },
    {
 "ticket_id": "#484",
 "category": "feature",
 "urgency": "low",
 "action": "Registrar la solicitud del modo oscuro para el panel de análisis e incluirla en la lista de características pendientes del producto."
    },
    {
 "ticket_id": "#485",
      "category": "access",
 "urgency": "high",
 "action": "Investigar de inmediato la configuración de SSO vinculada al cambio de dominio de la empresa y restablecer el acceso para todos los empleados afectados."
    },
    {
      "ticket_id": "#486",
 "category": "facturación",
 "urgency": "baja",
 "action": "Localizar la factura del mes pasado y enviar una copia al cliente."
    }
  ]
}
```
Claude Opus 5: potencia máxima
```json
{
  "tickets": [
    {
 "ticket_id": "481",
 "category": "facturación",
 "urgency": "alta",
 "action": "Derivar a facturación para verificar el cargo duplicado por la renovación anual y confirmar la resolución antes del cierre de nóminas del cliente el viernes."
    },
    {
 "ticket_id": "482",
      "category": "acceso",
 "urgency": "media",
 "action": "Comprobar los registros de entrega de correo electrónico para ver si se ha enviado el mensaje de restablecimiento a esa dirección y, si no se ha entregado, activar una ruta de restablecimiento verificada para el usuario."
    },
    {
 "ticket_id": "483",
      "categoría": "error",
 "urgencia": "media",
 "acción": "Registrar un error relacionado con el redondeo de divisas en la exportación CSV, indicando la discrepancia con los valores del panel de control, y solicitar los pasos para reproducir el error o una exportación de muestra."
    },
    {
 "ticket_id": "484",
 "category": "feature",
 "urgency": "low",
 "action": "Registrarlo como una solicitud de función de modo oscuro para el panel de análisis y acusar recibo sin comprometerse a un plazo."
    },
    {
 "ticket_id": "485",
      "category": "acceso",
 "urgency": "alta",
 "action": "Elevar el incidente como una interrupción del SSO en toda la organización relacionada con el cambio de dominio; solicitar al equipo de identidad y autenticación que revise inmediatamente la configuración del dominio del SSO."
    },
    {
      "ticket_id": "486",
 "category": "facturación",
 "urgency": "baja",
 "action": "Enviar la copia de la factura del mes anterior solicitada a la persona de contacto verificada de la cuenta."
    }
  ]
}
```
Claude Fable 5.1: potencia máxima
{"tickets":[{"ticket_id":"481","category":"facturación","urgency":"alta","action":"Investigar el cargo por renovación anual duplicado que se ha notificado y responder antes de la fecha límite de pago de nóminas del cliente, fijada para el viernes."},{"ticket_id":"482","category":"acceso","urgency":"media","action":"Comprobar los registros de envío de correos electrónicos de restablecimiento de contraseña para la dirección del usuario y reenviarlos o proporcionar una vía alternativa para restablecer la contraseña."},{"ticket_id":"483","categoría":"error","urgencia":"media","acción":"Reproduce el redondeo de los importes en moneda a dólares enteros en la exportación CSV y remítelo al equipo de ingeniería para que lo solucione."},{"ticket_id":"484","categoría":"funcionalidad","urgencia":"baja","acción":"Registrar la solicitud del modo oscuro para el panel de análisis con el equipo de producto y acusar recibo."},{"id_ticket":"485","categoría":"acceso","urgencia":"alta","acción":"Escalar los errores de acceso denegado al SSO en toda la empresa tras el cambio de dominio y revisar la configuración del dominio del SSO."},{"ticket_id":"486","categoría":"facturación","urgencia":"baja","acción":"Localizar y enviar al cliente una copia de la factura del mes pasado."}]}
Política de «primera salida válida». La latencia corresponde al tiempo real a través de Anywhere, no a la latencia nativa de Anthropic. Los recuentos de tokens los facilitan los proveedores; de esta ruta no se deduce ningún coste directo de la API.
Cumplimiento de restricciones
Prueba 2: Nota de lanzamiento basada en datos empíricos
Resultado de la tarea: Sonnet 5, 10/10
Sonnet fue el único modelo que cumplió todos los requisitos establecidos. Opus generó una nota convincente, pero superó el límite de palabras y dio a entender que todos los que no habían respondido eran estudiantes matriculados. La primera respuesta de Fable estuvo vacía; en su segundo intento, devolvió una nota visiblemente truncada, sin la recomendación ni la advertencia.
Modelo
Estado
Puntuación
Latencia en cualquier lugar
Tokens denunciados
¿Qué pasó?
Claude Haiku 4.5
Ruta no disponible
Sin puntuación
No disponible
No disponible
Dos respuestas 503; sin puntuación de calidad.
Claude Soneto 5
Salida conservada
10/10
9,94 s
796
Se han cumplido los requisitos relativos a los términos «alcance», «estructura», «pruebas», «recomendación» y «advertencia».
Claude Opus 5
Salida conservada
8/10
9,49 s
826
Un análisis sólido, pero con 223 palabras por debajo del límite establecido según el método de recuento fijo y una inferencia sin fundamento.
Claude Fable 5.1
Salida conservada
6.5/10
19,27 s
1685
La primera respuesta está vacía; el reintento guardado se truncó antes de la recomendación y la advertencia.
Entrada completa de la prueba
Redacta una nota interna de lanzamiento de entre 180 y 220 palabras dirigida a un director de producto utilizando únicamente los datos que se indican a continuación. Incluye: un asunto, un breve párrafo introductorio, exactamente tres puntos clave, una recomendación y una advertencia claramente señalada. No inventes cifras presupuestarias, porcentajes, significación estadística ni efectos causales.

Datos:
- En el programa piloto se inscribieron 120 estudiantes.
- En el punto de control del 31 de marzo, 96 estudiantes habían asistido al menos a tres sesiones.
- La puntuación media de la encuesta fue de 4,3 sobre 5, según 71 encuestados.
- La hoja de operaciones del programa indica un presupuesto de $18 000.
- La nota de aprobación financiera indica $20 000. No se especifica si la diferencia se debe a una revisión o a un error de registro.
- Los participantes no fueron asignados aleatoriamente y no se recopiló ninguna puntuación de referencia.
- La decisión consiste en si se pone en marcha un segundo programa piloto, no en si se implanta de forma permanente.
Claude Haiku 4.5: resultado operativo completo
No se generó ningún resultado del modelo. Los dos intentos permitidos con la API de Anywhere devolvieron un código de estado HTTP 503, por lo que esta ruta se marcó como no disponible y se excluyó de la puntuación de calidad.
Claude Sonnet 5: potencia máxima
**Asunto: Resultados del programa piloto — Recomendación para continuar con un segundo programa piloto**

El programa piloto inicial ha concluido su primer periodo de evaluación, y los primeros indicadores de participación y satisfacción son alentadores. Antes de comprometernos con un segundo programa piloto, hay algunos datos y cuestiones pendientes que el equipo debería revisar conjuntamente.

- De los 120 estudiantes matriculados, 96 habían asistido al menos a tres sesiones a fecha del 31 de marzo.
- Una encuesta realizada tras las sesiones, en la que participaron 71 personas, arrojó una puntuación media de 4,3 sobre 5.
- Las cifras presupuestarias no coinciden entre los distintos documentos: la hoja de operaciones del programa indica $18 000, mientras que la nota de aprobación financiera indica $20 000; no está claro si esto se debe a una revisión o a un error de registro.

**Recomendación:** Teniendo en cuenta los resultados de asistencia y de la encuesta, recomendamos seguir adelante con una segunda fase piloto para recopilar datos más estructurados —a ser posible, con un grupo de comparación definido y una medición de referencia— antes de plantearse cualquier decisión sobre una implantación más amplia. Esta segunda fase piloto también debería servir como oportunidad para conciliar la discrepancia presupuestaria con el departamento financiero antes de que se aprueben definitivamente los fondos.

**Advertencia:** Estos resultados deben interpretarse con cautela. Los participantes no fueron asignados aleatoriamente y no se recopiló ninguna puntuación de referencia, por lo que no podemos atribuir los resultados de la encuesta ni los patrones de asistencia al programa en sí. Se trata de una decisión sobre el alcance de una segunda prueba piloto, no de una decisión sobre su implantación permanente.
Claude Opus 5: potencia máxima
**Asunto: Resultados del proyecto piloto y recomendación sobre una segunda cohorte piloto**

El primer proyecto piloto ha completado su punto de control del 31 de marzo y ahora disponemos de información suficiente para decidir si se lleva a cabo un segundo proyecto piloto. Esta nota resume lo que hemos observado, nuestras recomendaciones y la principal limitación a la hora de interpretar los resultados. En esta fase no se ha tomado ninguna decisión definitiva sobre su implantación.

- **Inscripción y participación:** se inscribieron 120 estudiantes. A fecha del punto de control del 31 de marzo, 96 de ellos habían asistido al menos a tres sesiones.
- **Opiniones de los participantes:** La encuesta posterior a la participación obtuvo una puntuación media de 4,3 sobre 5, basada en 71 encuestados. El resto de estudiantes inscritos no respondió, por lo que la puntuación refleja únicamente ese subconjunto.
- **Discrepancia presupuestaria:** La hoja de operaciones del programa indica un presupuesto de $18 000, mientras que la nota de aprobación financiera indica $20 000. La nota de Finanzas no especifica si la diferencia se debe a una revisión o a un error de registro, y no hemos determinado qué cifra es la válida.

**Recomendación:** Seguir adelante con la planificación de una segunda fase piloto, siempre y cuando los departamentos de Finanzas y Operaciones del Programa concilien las dos cifras presupuestarias y confirmen una única cifra válida antes de que comprometamos el gasto. Un segundo proyecto piloto también debería recopilar puntuaciones de referencia en el momento de la admisión.

**ADVERTENCIA:** Los participantes no fueron asignados aleatoriamente y no se recopiló ninguna puntuación de referencia. Por lo tanto, las cifras de participación y de la encuesta describen lo que este grupo hizo y comunicó; no pueden indicarnos qué efectos tuvo el programa ni cómo funcionaría con una población diferente.
Claude Fable 5.1: potencia máxima
**Asunto:** Resumen del punto de control del proyecto piloto y recomendación sobre una segunda fase piloto

Hola, [Director],

A continuación se incluye un resumen del estado del proyecto piloto en el punto de control del 31 de marzo, junto con una recomendación sobre si se debe pasar a una segunda fase piloto. Esta nota se refiere únicamente a la decisión sobre la segunda fase piloto, no a su implantación definitiva.

- **Inscripción y asistencia:** 120 estudiantes inscritos. En la evaluación del 31 de marzo, 96 habían asistido al menos a tres sesiones.
- **Opiniones de los participantes:** Una encuesta arrojó una puntuación media de 4,3 sobre 5 entre los 71 encuestados.
- **Registros presupuestarios:** La hoja de operaciones del programa indica un presupuesto de $18 000, mientras que la nota de aprobación financiera indica $20 000. La nota financiera no indica si la diferencia se debe a una revisión o a un error de registro.

**
Política de «primera salida válida». La latencia corresponde al tiempo real a través de Anywhere, no a la latencia nativa de Anthropic. Los recuentos de tokens los facilitan los proveedores; de esta ruta no se deduce ningún coste directo de la API.
Corrección del código
Prueba 3: Depuración de JavaScript auditable
Resultado de la tarea: Opus 5 y Fable 5.1 empatados, 10/10
Los tres modelos disponibles detectaron errores y generaron sustituciones que superaron las ocho pruebas ejecutables. Opus y Fable devolvieron un JSON válido y empataron con 10/10. El código de Sonnet también superó la prueba, pero el marcador Markdown que lo rodeaba incumplía el requisito de JSON directo.
Modelo
Estado
Puntuación
Latencia en cualquier lugar
Tokens denunciados
¿Qué pasó?
Claude Haiku 4.5
Ruta no disponible
Sin puntuación
No disponible
No disponible
Dos respuestas 503; sin puntuación de calidad.
Claude Soneto 5
Salida conservada
9/10
13,17 s
1471
La versión de sustitución superó los 8 de los 8 casos; la salida «fenced» no cumplió con el requisito del formato JSON.
Claude Opus 5
Salida conservada
10/10
20,17 s
1826
JSON válido, se han identificado ambos defectos y se han superado los 8 de los 8 casos ejecutables.
Claude Fable 5.1
Salida conservada
10/10
15,89 s
1409
JSON válido, diagnóstico conciso y 8 de 8 casos ejecutables superados.
Entrada completa de la prueba
Diagnostica y repara esta función de JavaScript. Devuelve un objeto JSON que contenga exactamente cuatro campos: root_cause (cadena de caracteres), replacement (cadena de caracteres que contenga la función de sustitución completa), tests (matriz de cadenas de caracteres con casos de prueba) y remaining_risk (cadena de caracteres). No afirmes que has ejecutado las pruebas. Realiza la reparación más sencilla y clara que cumpla con el contrato.

Contrato:
- tasks es una matriz de funciones sin argumentos que devuelven promesas.
- Devuelve el primer valor cumplido en el orden de entrada, incluso cuando ese valor sea 0, false o una cadena vacía.
- Ignora las tareas rechazadas.
- Devuelve null cuando todas las tareas se rechazan o la matriz está vacía.

Código actual:
async function firstSuccessful(tasks) {
  const results = await Promise.all(tasks.map((task) => task()));
  return results.find(Boolean) || null;
}
Claude Haiku 4.5: resultado operativo completo
No se generó ningún resultado del modelo. Los dos intentos permitidos con la API de Anywhere devolvieron un código de estado HTTP 503, por lo que esta ruta se marcó como no disponible y se excluyó de la puntuación de calidad.
Claude Sonnet 5: potencia máxima
```json
{
  "root_cause": "Two bugs: (1) Promise.all rejects immediately if any task rejects, instead of ignoring rejected tasks; (2) results.find(Boolean) incorrectly treats falsy fulfilled values (0, false, '') as failures, causing them to be skipped in favor of null.",
  "replacement": "async function firstSuccessful(tasks) {\n  const settled = await Promise.allSettled(tasks.map((task) => task()));\n  const firstFulfilled = settled.find((r) => r.status === 'fulfilled');\n  return firstFulfilled ? firstFulfilled.value : null;\n}",
  "tests": [
    "test('returns null for empty array', async () => { expect(await firstSuccessful([])).toBeNull(); });",
    "test('returns null when all tasks reject', async () => { const tasks = [() => Promise.reject('err1'), () => Promise.reject('err2')]; expect(await firstSuccessful(tasks)).toBeNull(); });",
    "test('returns first fulfilled value even if falsy (0)', async () => { const tasks = [() => Promise.resolve(0), () => Promise.resolve(42)]; expect(await firstSuccessful(tasks)).toBe(0); });",
    "test('returns first fulfilled value even if false', async () => { const tasks = [() => Promise.resolve(false), () => Promise.resolve(true)]; expect(await firstSuccessful(tasks)).toBe(false); });",
    "test('returns first fulfilled value even if empty string', async () => { const tasks = [() => Promise.resolve(''), () => Promise.resolve('nonempty')]; expect(await firstSuccessful(tasks)).toBe(''); });",
    "test('ignores leading rejected tasks and returns first fulfilled in order', async () => { const tasks = [() => Promise.reject('err'), () => Promise.resolve('second'), () => Promise.resolve('third')]; expect(await firstSuccessful(tasks)).toBe('second'); });",
    "test('preserves input order even if later task resolves faster', async () => { const tasks = [() => new Promise((res) => setTimeout(() => res('slow-first'), 50)), () => new Promise((res) => setTimeout(() => res('fast-second'), 5))]; expect(await firstSuccessful(tasks)).toBe('slow-first'); });"
  ],
  "remaining_risk": "The fix assumes 'first fulfilled value in input order' means the first task by array index that fulfills, regardless of timing, which matches the contract wording but await Promise.allSettled waits for all tasks to complete (including slow ones) before returning, which may not be desired if early-exit performance is needed; also unhandled promise rejection warnings are avoided by allSettled, but if tasks throw synchronously instead of returning rejected promises, this is not explicitly tested here beyond the reject cases."
}
```
Claude Opus 5: potencia máxima
{
  "root_cause": "Two defects. (1) `Promise.all` rejects as soon as any task rejects, so a single rejected task makes the whole function reject instead of ignoring it and returning a later fulfilled value. (2) `results.find(Boolean) || null` selects by truthiness rather than by fulfillment, so legitimate fulfilled values such as 0, false, '', NaN, null, or undefined are skipped and/or coerced to null. Using `Promise.allSettled` plus a status check on the settled records fixes both, and returning `record.value` directly preserves falsy results.",
  "replacement": "async function firstSuccessful(tasks) {\n  const results = await Promise.allSettled(tasks.map((task) => task()));\n  const firstFulfilled = results.find((result) => result.status === 'fulfilled');\n  return firstFulfilled ? firstFulfilled.value : null;\n}",
  "tests": [
    "firstSuccessful([]) resolves to null (empty input).",
    "firstSuccessful([() => Promise.resolve('a'), () => Promise.resolve('b')]) resolves to 'a' (input order, not completion order).",
    "firstSuccessful([() => new Promise((res) => setTimeout(() => res('slow-first'), 50)), () => Promise.resolve('fast-second')]) resolves to 'slow-first' (order is by index, not by who settles first).",
    "firstSuccessful([() => Promise.reject(new Error('boom')), () => Promise.resolve('second')]) resolves to 'second' (rejection ignored, does not propagate).",
    "firstSuccessful([() => Promise.reject(new Error('a')), () => Promise.reject(new Error('b'))]) resolves to null (all reject).",
    "firstSuccessful([() => Promise.resolve(0)]) resolves to 0, not null (falsy number preserved).",
    "firstSuccessful([() => Promise.resolve(false)]) resolves to false (falsy boolean preserved).",
    "firstSuccessful([() => Promise.resolve('')]) resolves to '' (empty string preserved).",
    "firstSuccessful([() => Promise.resolve(undefined), () => Promise.resolve('later')]) resolves to undefined (first fulfilled wins even if its value is undefined).",
    "firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve(null), () => Promise.resolve('third')]) resolves to null because index 1 fulfilled with null — verifying null-as-value is not confused with the all-rejected sentinel by inspecting status.",
    "firstSuccessful([() => Promise.resolve(NaN)]) resolves to NaN (Number.isNaN on the result is true)."
  ],
  "remaining_risk": "The function still starts every task and awaits all of them, so there is no short-circuiting: a slow or never-settling later task delays or blocks the result, and side effects of later tasks always occur. A task that throws synchronously (rather than returning a rejected promise) will throw inside `tasks.map`, causing the returned promise to reject instead of being ignored; wrap the invocation in `Promise.resolve().then(task)` if that must also be tolerated. `null` is still returned both for all-rejected/empty input and when a task genuinely fulfills with `null`, so callers cannot distinguish those cases. Non-array or non-function inputs are not validated, and rejection reasons are discarded rather than aggregated (no AggregateError), which can hide diagnostics."
}
Claude Fable 5.1: potencia máxima
{"root_cause":"Two defects: (1) Promise.all rejects as soon as any task rejects, so rejected tasks are not ignored and the function throws instead of skipping them; (2) results.find(Boolean) skips legitimate falsy fulfilled values (0, false, '') and the trailing '|| null' also converts such values to null, violating the requirement to return the first fulfilled value even when it is falsy.","replacement":"async function firstSuccessful(tasks) {\n const results = await Promise.allSettled(tasks.map((task) => task()));\n const first = results.find((result) => result.status === 'fulfilled');\n return first ? first.value : null;\n}","tests":["firstSuccessful([]) resolves to null","firstSuccessful([() => Promise.resolve('a'), () => Promise.resolve('b')]) resolves to 'a'","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve('b')]) resolves to 'b' and does not throw","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.reject(new Error('y'))]) resolves to null","firstSuccessful([() => Promise.resolve(0), () => Promise.resolve(5)]) resolves to 0","firstSuccessful([() => Promise.resolve(false), () => Promise.resolve(true)]) resolves to false","firstSuccessful([() => Promise.resolve(''), () => Promise.resolve('z')]) resolves to ''","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve(null)]) resolves to null (fulfilled null is returned as-is)","firstSuccessful([() => new Promise(r => setTimeout(() => r('slow'), 50)), () => Promise.resolve('fast')]) resolves to 'slow' (input order wins over settlement order)"],"remaining_risk":"All tasks are started concurrently and the function waits for every task to settle before returning, so a slow task delays the result even when an earlier task has already fulfilled; a sequential or early-exit strategy would be needed if latency matters. A task that throws synchronously (rather than returning a rejected promise) will still cause the function to reject, since the contract assumes tasks return promises. Promise.allSettled requires ES2020 or a polyfill."}
Política de «primera salida válida». La latencia corresponde al tiempo real a través de Anywhere, no a la latencia nativa de Anthropic. Los recuentos de tokens los facilitan los proveedores; de esta ruta no se deduce ningún coste directo de la API.
Estos resultados de Anywhere demuestran por qué la elección del modelo debe basarse en la tarea en cuestión y no en una única clasificación. En GlobalGPT, puedes aplicar el mismo método de comparación a tu propia indicación en Claude y otros modelos líderes, y luego elegir el resultado que mejor se adapte a tus criterios de calidad, tus necesidades de velocidad y tu carga de trabajo de revisión.
Cómo realizar la comparación de forma imparcial
Congela una tarea representativa. Utiliza la misma intención, el mismo material de origen, el mismo acceso a las herramientas y las mismas comprobaciones de aceptación de objetivos.
Anota el primer resultado válido. No concedas en silencio a un modelo más intentos de reintento en la comparación principal.
Hay que diferenciar entre calidad y disponibilidad. Los fallos de autenticación, capacidad y ruta deben incluirse en una nota sobre disponibilidad, no en la puntuación de calidad.
Evalúa todo el proceso de trabajo. Calcula el tiempo transcurrido, el esfuerzo de los revisores, el tiempo de corrección y la recuperación de tareas fallidas.
Elige el modelo de paso más barato. Vuelve a realizar las pruebas cuando cambien las indicaciones, las herramientas, las versiones de los modelos o los costes de los fallos.
Dónde encaja GlobalGPT
El Anthropic se posiciona como el Fable 5.1 para trabajos exigentes cuando las evaluaciones del Opus 5, que requieren un mayor esfuerzo, siguen sin dar la talla.
A fecha de 8 de septiembre de 2026, la gama activa de Anthropic incluye los modelos Claude Haiku 4.5, Claude Sonnet 5, Claude Opus 5 y Claude Fable 5.1. Las versiones exactas y los identificadores de modelo pueden variar, por lo que se recomienda volver a consultar la descripción general oficial de los modelos antes de la implementación.
¿Cuál es la diferencia entre Claude Haiku, Sonnet y Opus?
Haiku da prioridad a la velocidad y a un bajo coste básico de tokens; Sonnet equilibra la velocidad y la capacidad para el trabajo diario; y Opus da prioridad a la capacidad para tareas complejas o de gran importancia. La elección adecuada depende de tu carga de trabajo y del coste de verificación, no de una clasificación absoluta.
¿Qué modelo Claude debería utilizar para la mayoría de las tareas?
Empieza con Sonnet 5 para la mayoría de las tareas cotidianas de redacción, análisis, programación, comprensión visual y uso de herramientas. En cambio, empieza con Opus 5 cuando el fracaso tenga un coste elevado o el trabajo requiera un razonamiento más profundo y una verificación más rigurosa.
¿Qué modelo Claude es el más adecuado para la programación?
Sonnet 5 es un punto de partida práctico para la codificación cotidiana, con revisiones y pruebas habituales. Utiliza Opus 5 para diagnósticos difíciles, codificación agencial compleja, ejecución a largo plazo o cambios en los que un error puede salir muy caro.
¿Qué modelo Claude es el mejor para escribir?
Sonnet 5 es el punto de partida más equilibrado para la mayoría de las tareas de redacción y edición. Haiku 4.5 es adecuado para textos de gran volumen y estructura rigurosa, mientras que puede merecer la pena probar Opus 5 para síntesis complejas o material de gran importancia que resulte difícil de verificar.
¿Es Claude Sonnet mejor que Opus?
No en todos los casos. Sonnet 5 es más rápido y más barato según las tarifas básicas de la API, mientras que Anthropic permite a Opus 5 abordar trabajos más complejos. El mejor modelo es la opción más económica que supere de forma fiable tus propios criterios de aceptación.
¿Va a sustituir Claude Fable a Opus?
El n.º Anthropic posiciona el Fable 5.1 como un nivel de escalación para tareas que requieren un razonamiento complejo o un trabajo prolongado por parte del agente, cuando el Opus 5, que supone un mayor esfuerzo, sigue sin ser suficiente, y no como un sustituto universal de Opus.
¿Tienen Claude.ai y la API de Claude la misma ventana de contexto?
Los límites del plan n.º Claude.ai y las especificaciones del modelo de la API son independientes. La tabla de planes individuales de Anthropic indica actualmente una ventana de contexto de 200K, mientras que la documentación de la API indica un contexto de 1M para Sonnet 5, Opus 5 y Fable 5.1.
¿Cuándo debería actualizar de Haiku a Sonnet u Opus?
Actualiza el modelo cuando los fallos en los controles de aceptación, los casos extremos complicados, el tiempo de corrección, el esfuerzo de verificación o el coste de un error superen la ventaja que ofrece el modelo inferior en cuanto a velocidad y precio por token. Vuelve al modelo anterior cuando un modelo más económico supere repetidamente los mismos controles fijos.
¿Cuánto cuestan Claude Haiku, Sonnet y Opus a través de la API?
Según las tarifas base de Anthropic verificadas el 8 de septiembre de 2026, Haiku 4.5 cuesta $1 de entrada y $5 de salida; Sonnet 5 cuesta $2 y $10, y Opus 5 cuesta $5 y $25 por cada millón de tokens. Véase Anthropic’s página oficial de precios para consultar las tarifas actuales y otras modalidades de pago.
Veredicto final: Empieza por el modelo más barato que cumpla los requisitos
Para trabajos mixtos generales, el Sonnet 5 sigue siendo la opción predeterminada más práctica, y fue el único modelo que superó todas las restricciones de las notas de lanzamiento en nuestra prueba. Opus 5 y Fable 5.1 igualaron la puntuación total de Sonnet (26,5/30) gracias a diferentes puntos fuertes, mientras que Haiku 4.5 no pudo puntuarse porque la ruta «Anywhere» devolvía un error 503 en cada intento permitido. Considera estos resultados como una muestra de la carga de trabajo, no como una clasificación universal definitiva.
El siguiente paso es sencillo: elige una tarea real, define en qué consiste un resultado satisfactorio, evalúa cada candidato serio en condiciones comparables e incluye el tiempo de corrección en el coste final. El modelo ganador es el más económico que supere la prueba de forma fiable, no el que tenga la tarifa por token más baja ni el nombre de nivel más alto.
GlobalGPT integra ese método en un flujo de trabajo de IA más amplio y asequible. Utiliza Claude, GPT-5.6 Sol, Gemini 3 Pro, Kimi K3 y otros modelos líderes con múltiples funciones de IA en un único panel de control, y luego traslada el trabajo a tu terminal, flujo de trabajo de desarrollo y herramientas de producción existentes a través de la CLI de GlobalGPT. Las pruebas comparativas te ayudan a elegir; la mayor ventaja es mantener conectado el flujo de trabajo completo.
Descubre qué significa la palabra clave «AI Motion Designer for After Effects GPT» y cómo GLBGPT utiliza a Yukie, el editor de vídeo, las indicaciones, los efectos, los subtítulos, el audio y los clips generados.
Aprende a crear imágenes para blogs con IA utilizando fuentes actuales, pruebas prácticas, límites claros y un proceso más seguro desde el primer intento hasta la producción.
Descubre los planes anuales ilimitados de vídeo con IA, con fuentes actuales, pruebas prácticas, límites claros y un camino más seguro desde la primera prueba hasta la producción.
Descubre las alternativas a GPT Live 1 con fuentes actualizadas, pruebas prácticas, límites claros y un camino más seguro desde la primera prueba hasta la puesta en producción.