Kurze Antwort: Kosten für GPT-6 Astra $10 pro 1 Mio. Eingabetoken, $1 pro 1 Mio. zwischengespeicherte Eingabetoken, $12,50 pro 1 Mio. Cache-Schreib-Token, und $50 pro 1M ausgegebener Token zu Standardtarifen, solange die Anzahl der Eingabetoken bei maximal 272.000 liegt. Oberhalb von 272.000 wird die gesamte Anfrage auf die Preisgestaltung für lange Kontexte umgestellt: $20 Eingabe, $2 zwischengespeicherte Eingabe, $25 Cache-Schreibvorgänge und $75 Ausgabe pro 1 Mio. Token. OpenAI dokumentiert ein Kontextfenster von 1,05 Mio. Token und eine maximale Ausgabe von 128.000.
Diese Zahlen machen Astra zwar leistungsstark, aber auch so kostspielig, dass eine sorgfältige Planung erforderlich ist. Eine wiederholte Abfrage kann deutlich günstiger werden, wenn das Caching funktioniert, während eine Anfrage, die die Grenze von 272.000 Eingabetoken nur knapp überschreitet, erheblich teurer werden kann. In diesem Leitfaden werden die offiziellen Preise von den berechneten Beispielen und unseren praktischen API-Beobachtungen vom 5. September 2026 getrennt dargestellt.

Preise für die GPT-6 Astra-API
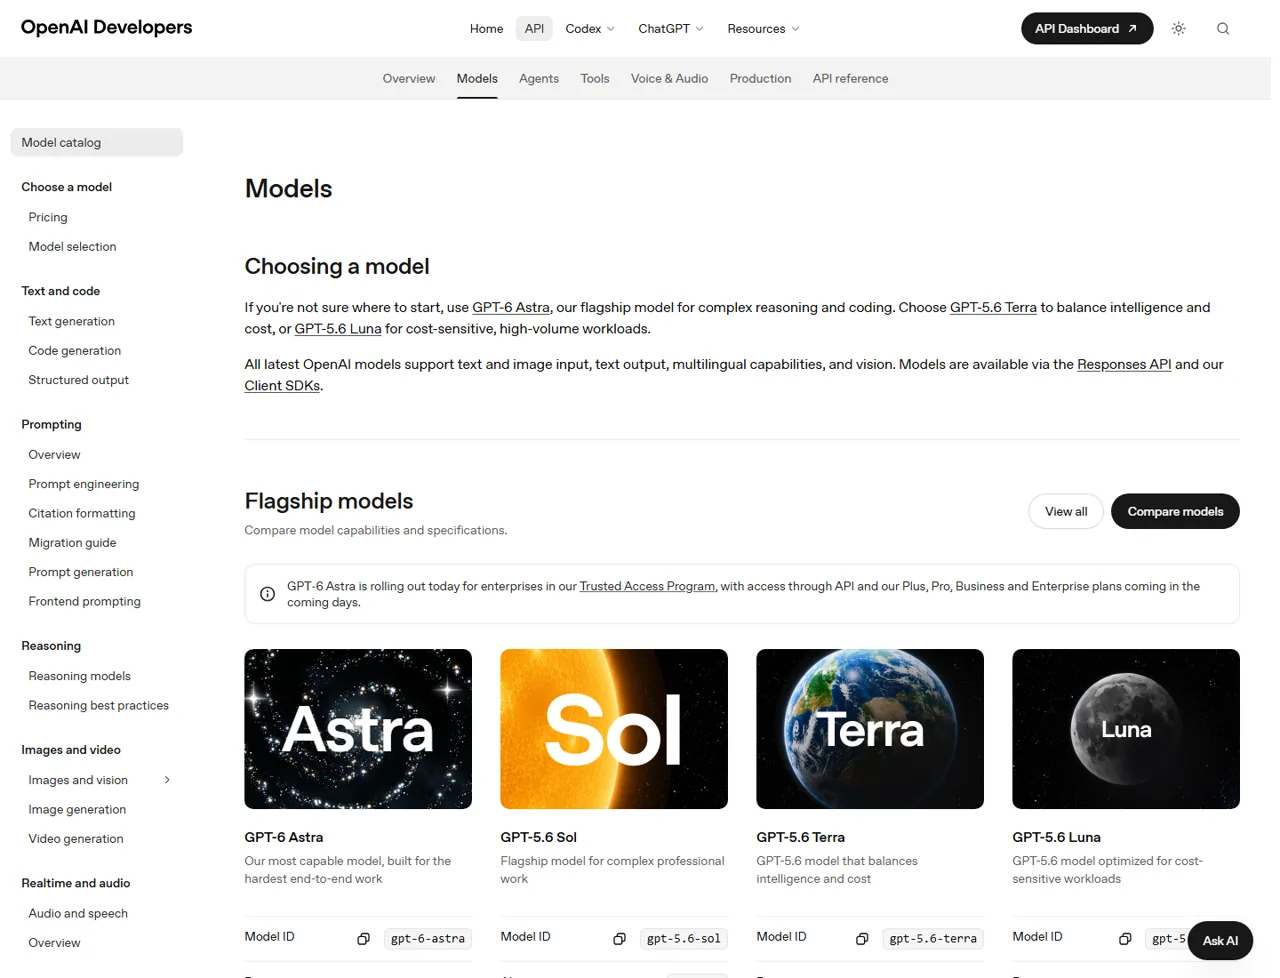
OpenAI unterteilt die Standardpreisgestaltung in einen kurzen und einen langen Kontext. Der Schwellenwert basiert auf Eingabe-Token, nicht die Summe aus Eingabe und Ausgabe. Der kurze Kontext umfasst Eingaben mit bis zu 272.000 Token; der lange Kontext gilt ab diesem Wert.
Kosten pro 1 Mio. Token
Die höhere Preisstufe gilt für die gesamte Anfrage. Die angegebenen Preise gelten pro 1 Mio. Token.
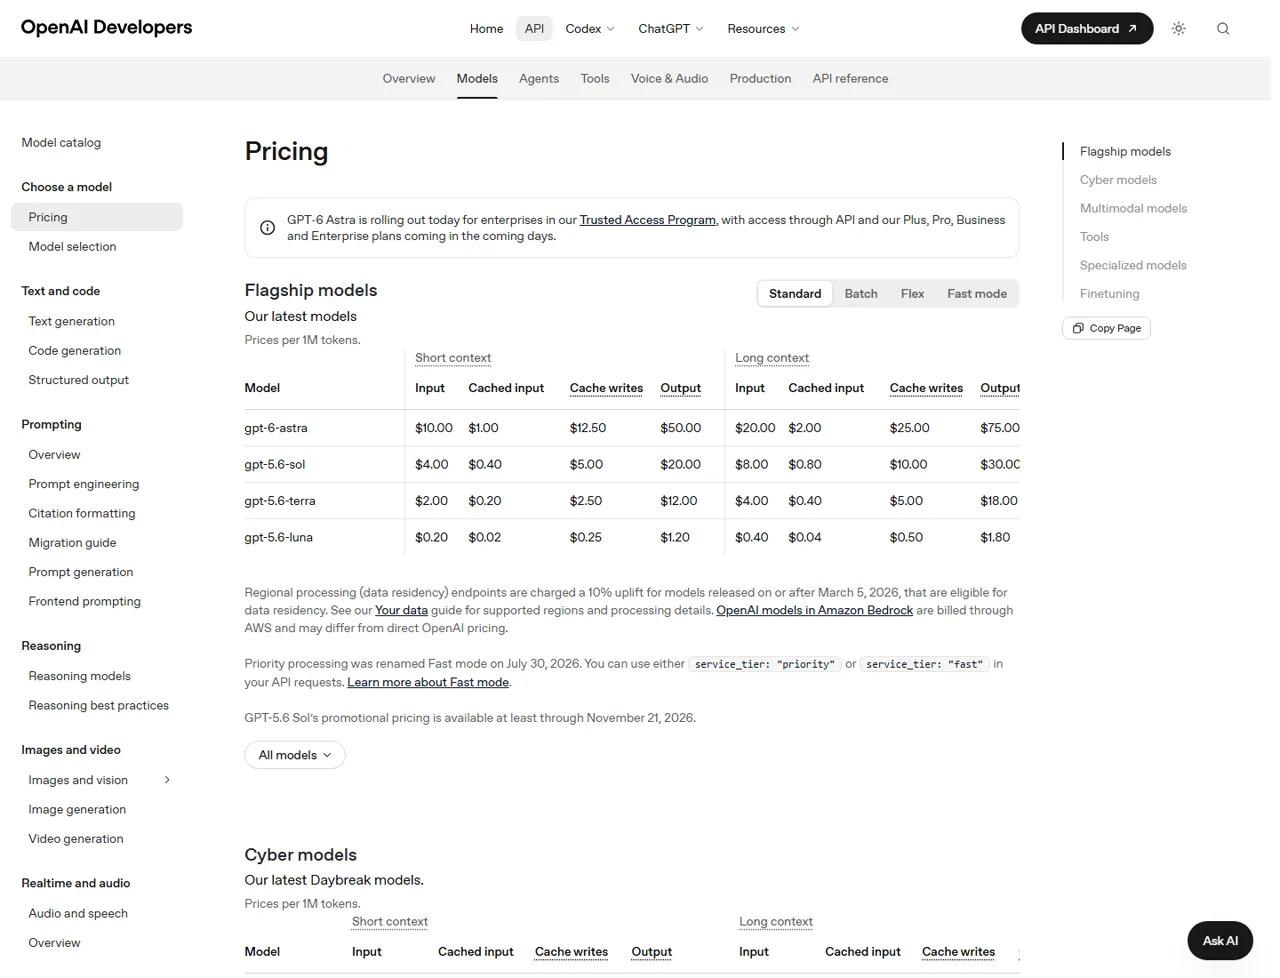
Das Wichtigste dabei ist, dass beim Überschreiten der 272K-Grenze keine Rechnung mit gemischten Tarifen entsteht. Laut API-Preisdokumentation von OpenAI, gelten die höheren Preise für die gesamte Anfrage, sobald die Eingabemenge den Schwellenwert überschreitet. Teams, die Astra mit einem früheren Flaggschiff-Produkt vergleichen, sollten daher über den reinen Eingabepreis hinausblicken; unser GPT-5.6-Preisliste bietet nützliche Hintergrundinformationen für diese Haushaltsdebatte.
Das Zwischenspeichern von Eingaben kann den Aufwand für wiederholte Eingaben erheblich reduzieren, doch die Erstellung des Caches ist nicht kostenlos. Ein Cache-Schreibvorgang kostet das 1,25-Fache des geltenden Tarifs für nicht zwischengespeicherte Eingaben. Die Verarbeitung im Batch- und Flex-Modus kostet 50% im Standard-Tarif, während der Fast-Modus das Doppelte des geltenden Tarifs kostet. Die berechtigte regionale Verarbeitung kostet zusätzlich 10%, und der Fast-Modus ist für Astra mit Datenaufbewahrung in der EU nicht verfügbar.
Wie viel kostet ein GPT-6-Astra-API-Aufruf?
Bei einer Standardanfrage berechnen Sie jede abgerechnete Token-Kategorie separat und addieren Sie anschließend die Ergebnisse:
Gesamtkosten = Kosten für nicht zwischengespeicherte Eingaben + Kosten für zwischengespeicherte Eingaben + Kosten für das Schreiben in den Cache + Kosten für Ausgaben.
(0,0125 × $10) + (0,002 × $50)$0.225(0,1 × $10) + (0,005 × $50)$1.25(0,1 × $1) + (0,005 × $50)$0.35(0,3 × $20) + (0,01 × $75)$6.75Die Schätzungen zum Standardtarif beinhalten keine Werkzeuge, regionale Aufschläge und sonstige separat in Rechnung gestellte Leistungen.
Die 100.000 Beispiele zeigen, warum wiederverwendbare Präfixe wichtig sind: Die Schätzung für „Model-Token“ sinkt von $1,25 auf $0,35, wenn alle Eingaben als zwischengespeichert gelten. Dies dient lediglich zur Veranschaulichung der Preisgestaltung und ist kein Versprechen, dass jede wiederholte Eingabe zu einem Cache-Treffer führt. Für eine umfassendere Budgetierung mit mehreren Modellen vergleichen Sie bitte die Workflow-Annahmen in unserem Leitfaden zu All-in-One-KI-Modellen.
GPT-6: Astra-Token, Kontextfenster und Ausgabebeschränkungen
Die Offizielle GPT-6-Astra-Modellseite dokumentiert a 1.050.000-Token-Kontextfenster und eine Maximale Ausgabe von 128.000 Token. Der Wissensstand endet am 30. April 2026. Es akzeptiert Text- und Bildeingaben, gibt Text zurück und unterstützt die Einstellungen für den Aufwandsgrad der Schlussfolgerungen niedrig, mittel, hoch, xhoch, und max.
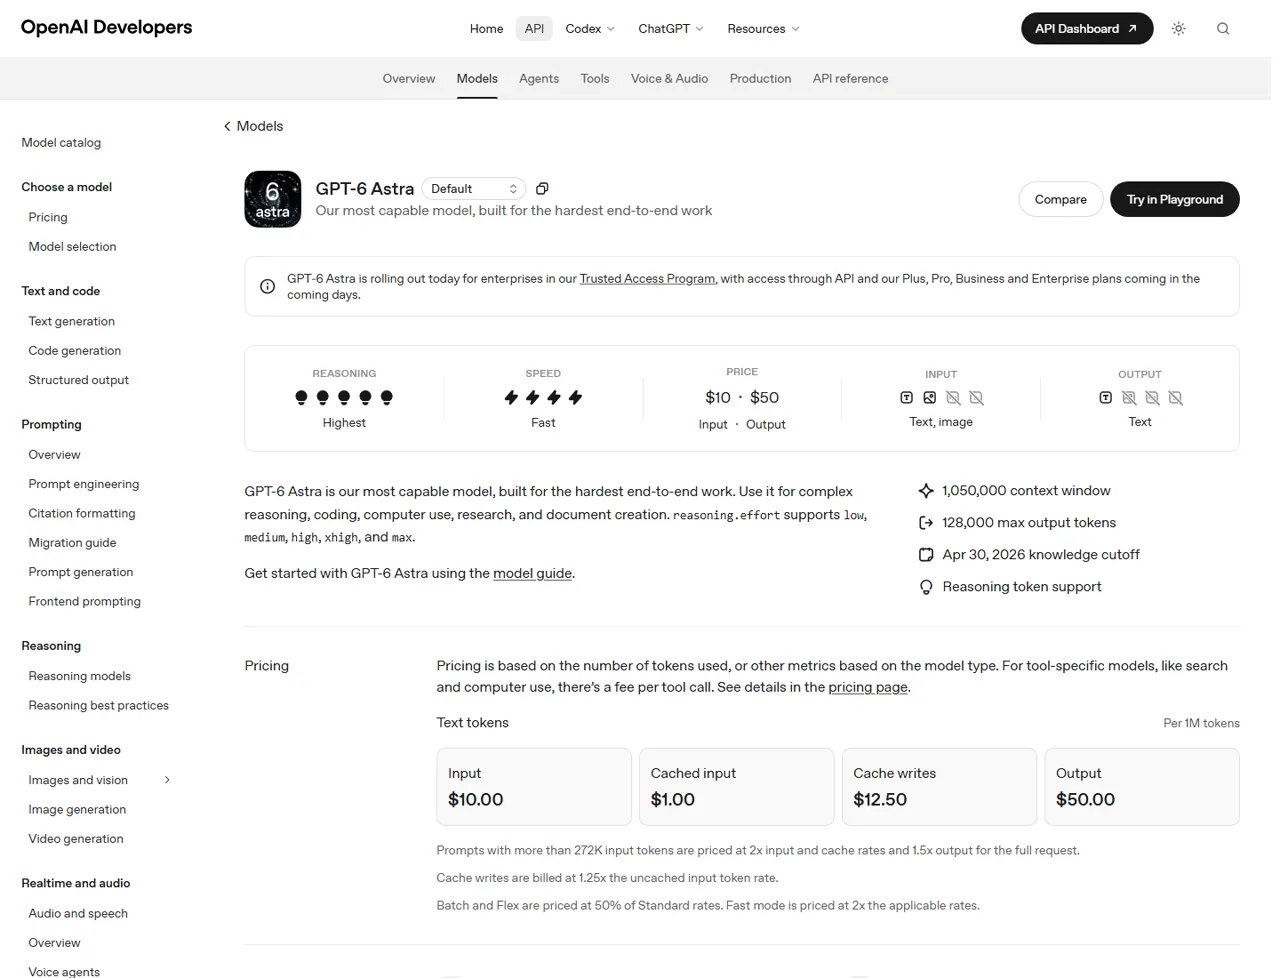
Ein großes Kontextfenster ist eine Kapazität und keine Empfehlung, jede Anfrage zu erfüllen. Durch Abruf, Dokumentenauswahl, Zusammenfassung und die Struktur der Eingabeaufforderung lässt sich die Eingabe unter der Kostengrenze von 272K halten. Auch die Wahl des Modells spielt eine Rolle: Entwickler, die sich auf die Programmierung konzentrieren, können die Vor- und Nachteile in unserem bestes AI-Modell für die Codierung Analyse, anstatt davon auszugehen, dass das Modell mit dem größten Fenster automatisch die beste Anpassung darstellt.
Sechs praktische Testaufgaben für die GPT-6 Astra-API
Teststatus: GPT-6 Astra wurde am 5. September 2026 über die Broly Anywhere-Kompatibilitäts-API verfügbar. Wir haben die sechs unten aufgeführten Aufgaben ausgeführt. Bei fünf davon wurden verwertbare HTTP-200-Antworten erhalten; die Anfrage mit dem Grenzwert von 272K endete mit einem Transportfehler und bleibt weiterhin unbestätigt.
Eingabeaufforderungen und beobachtete Ergebnisse
Modell-ID gpt-6-astra. Jedes Ergebnis entspricht einem beobachteten Durchlauf und stellt keinen offiziellen Benchmark dar. Die tatsächliche Laufzeit umfasst die Gateway- und Upstream-Verzögerung.
Grundlagen der Token-Abrechnung
Das Modell lieferte das erwartete theoretische Ergebnis. Die tatsächliche API-Nutzung belief sich auf 54 Eingabe- und 26 Ausgabe-Token.
Prompt-Caching
Beide Abfragen waren korrekt, doch das wiederholte Präfix ergab in beiden Antworten null zwischengespeicherte und null Cache-Schreib-Token.
272K-Preisgrenze
Die umfangreiche synthetische Anfrage wurde beendet, bevor eine HTTP-Antwort eintraf. Da kein Nutzungsobjekt zurückgegeben wurde, bleiben das Ratenband und das Abrechnungsverhalten ungemessen.
Argumentation „niedrig“ vs. „maximal“
Bei beiden Durchläufen ergab sich das Ergebnis $265,20. Max benötigte länger und lieferte 88 Argumentationstoken; bei dieser einzelnen Rechenaufgabe zeigte sich keine Verbesserung der Antwortqualität.
128K-Ausgangsparameter
Der Kompatibilitäts-Endpunkt gab „OK“ zurück, anstatt ein Token abzulehnen, das über dem offiziellen Höchstwert lag. Dies ist ein Verhalten des Gateways und kein Hinweis auf ein größeres unterstütztes Ausgabefenster.
Tarifüberschriften und Leistungsstufen
Normale Antworten enthielten keine „remaining-request“- oder „remaining-token“-Header. Sowohl die Flex- als auch die Priority-Probes waren erfolgreich, gaben jedoch „service_tier: default“ zurück.
GPT-6 Astra API-Ratenbeschränkungen
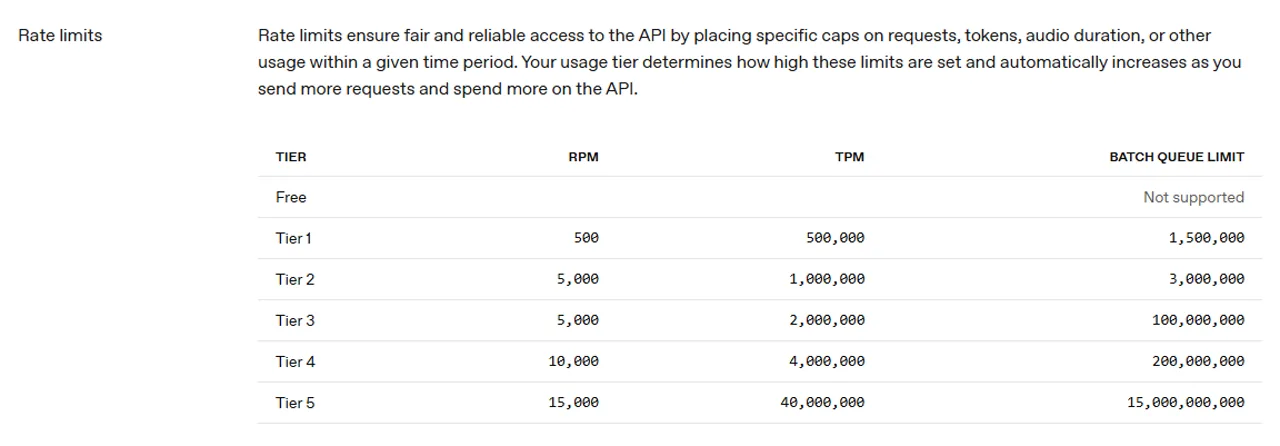
GPT-6 Astra wird in der kostenlosen Stufe nicht unterstützt. Die veröffentlichten Limits steigen je nach Nutzungsstufe an, doch die Header der Live-Projekte bleiben die praktische Quelle für Informationen zur verbleibenden Kapazität und zum Zeitpunkt der Zurücksetzung.
Die Kapazität steigt bei Tier 5 stark an
Die Balkenhöhe dient nur zur Veranschaulichung. Maßgeblich sind die oben angegebenen Werte für RPM, TPM und die Batch-Warteschlange.
Mit „Batch“ oder „Flex“ lassen sich die Modell-Token-Sätze halbieren, wenn keine sofortigen Antworten erforderlich sind. „Fast“ eignet sich zwar für latenzkritische Aufgaben, verdoppelt jedoch den anfallenden Preis und ist für Astra nicht mit Datenaufbewahrung in der EU verfügbar. Bevor Sie eine Produktions-Workload festlegen, vergleichen Sie die Modellkosten mit den damit verbundenen Plattformkosten; unsere Codex-Preisübersicht veranschaulicht, warum Produktabonnements und API-Abrechnung nicht miteinander vermischt werden sollten.
Was erste Rezensionen zeigen
Der unabhängige Entwickler Matt Wolfe hat ein Video veröffentlicht, das einen ersten Einblick in die Programmierung, den Umgang mit Computern sowie Demonstrationen zu Blender und der Unreal Engine bietet. Diese Beispiele sind hilfreich, um zu verstehen, welche Arbeitsabläufe die Tester derzeit untersuchen, stellen jedoch keine kontrollierten Benchmark-Ergebnisse dar und ersetzen nicht die oben genannten API-Tests. Umfassendere Vergleiche wie beispielsweise ChatGPT vs. Claude vs. Gemini sollte ebenfalls als arbeitsspezifische Orientierungshilfe verstanden werden und nicht als allgemeingültige Rangliste.
Für wen ist GPT-6 Astra geeignet?
Astra eignet sich gut für anspruchsvolle Programmieraufgaben, agentenbasierte Arbeitsabläufe, die Analyse umfangreicher Dokumente und multimodale Aufgaben, bei denen eine stärkere Schlussfolgerungsfähigkeit oder ein sehr großes Kontextfenster die höheren Token-Kosten ausgleichen können. Teams sollten das Tool zunächst im Rahmen einer eng gefassten, messbaren Aufgabe testen und die Qualität pro Dollar vergleichen, nicht nur die Qualität der Ergebnisse. Unsere Übersicht über die besten KI-Modelle bietet einen breiteren Auswahlrahmen.
- Verwenden Sie Astra, wenn: Die Aufgabe ist komplex, Fehler sind kostspielig, ein langer Kontext ist erforderlich oder das Modell kann mehrere schwächere Durchläufe ersetzen.
- Verwenden Sie ein günstigeres Modell, wenn: Bei der Arbeit handelt es sich um routinemäßige Klassifizierung, Extraktion, Überarbeitung oder die Erstellung großer Datenmengen mit einfachen Qualitätsanforderungen.
- Optimieren Sie zunächst, wenn: Die Anzahl der Eingabeaufforderungen überschreitet wiederholt 272.000, große statische Präfixe können zwischengespeichert werden oder die Latenz erfordert keine Standard- oder Fast-Verarbeitung.
Für Leser, die benachbarte Premium-Optionen vergleichen, ist die Vergleich zwischen GPT-5.6, Fable 5 und GPT-5.5 bietet eine weitere Perspektive hinsichtlich Kosten, Leistungsfähigkeit und Arbeitsaufwand. GlobalGPT verfügt über eine dedizierte GPT-6 Astra-Landingpage. Unsere API-Beobachtungen wurden separat über den Broly Anywhere-Kompatibilitäts-Endpunkt erfasst.
Häufig gestellte Fragen
Wie hoch ist der Preis für die GPT-6 Astra-API?
Die Standardpreise für kurze Kontexte betragen $10/M für Eingaben, $1/M für zwischengespeicherte Eingaben, $12,50/M für Cache-Schreibvorgänge und $50/M für Ausgaben. Ab 272.000 Eingabetoken verbraucht die vollständige Anfrage $20/M Eingabe, $2/M zwischengespeicherte Eingabe, $25/M Cache-Schreibvorgänge und $75/M Ausgabe.
Was passiert, wenn eine Eingabe 272K Eingabetoken überschreitet?
OpenAI verschiebt die gesamte Anfrage in das Long-Context-Band. Es handelt sich nicht um eine gemischte Abrechnung, bei der nur Tokens über 272K mehr kosten.
Was ist das Kontextfenster von GPT-6 Astra?
OpenAI sieht ein Kontextfenster von 1.050.000 Token, eine maximale Eingabe von 922.000 Token und eine maximale Ausgabe von 128.000 Token vor. Token für die Schlussfolgerung belegen ebenfalls Kontextplatz und werden als Ausgabe abgerechnet.
Unterstützt GPT-6 Astra die Eingabe von Bildern?
Ja. In der Modelldokumentation sind Text- und Bildeingaben mit Textausgabe aufgeführt. Audio und Video sind nicht als Eingabemodalitäten für dieses Modell aufgeführt.
Sind diese Kostenbeispiele offizielle Rechnungen?
Nein. Es handelt sich um Rechenbeispiele unter Verwendung der dokumentierten Tarife. Ihre Rechnung kann außerdem die Abrechnung von zwischengespeicherten Tokens, den Verarbeitungsmodus, die regionale Verarbeitung und andere separat abgerechnete Leistungen enthalten.
Welche Verarbeitungsmodi stehen zur Verfügung?
Für die Tarife „Standard“, „Batch“, „Flex“, „Fast“ und „Ultrafast“ liegen dokumentierte Astra-Preise vor. „Batch“ und „Flex“ kosten die Hälfte des „Standard“-Tarifs, „Fast“ kostet das Doppelte des „Standard“-Tarifs und „Ultrafast“ kostet das Sechsfache des „Standard“-Tarifs im gleichen Kontextband. Für berechtigte regionale Verarbeitung fallen zusätzliche Kosten in Höhe von 10% an; die Verfügbarkeit hängt vom Modus und vom Endpunkt ab.
Wie wird GPT-6 Astra über GlobalGPT abgerechnet?
Die API von GlobalGPT sieht für GPT-6 Astra 23 Credits pro 1.000 Eingabe-Token und 117 Credits pro 1.000 Ausgabe-Token vor. Reasoning-Token werden als Ausgabe abgerechnet. Dies sind die Credit-Sätze von GlobalGPT; für die Nutzung der OpenAI-API gelten eigene Preise in US-Dollar.
Endgültiges Urteil
GPT-6 Astra kombiniert ein Kontextfenster von 1,05 Millionen Token und eine maximale Ausgabe von 128.000 mit einer Premium-Preisgestaltung. Der Standardtarif für kurze Kontexte beginnt bei $10 pro 1 Mio. Eingabetoken und $50 pro 1 Mio. Ausgabetoken, doch die 272.000-Grenze, Reasoning-Token, Cache-Schreibvorgänge, der Verarbeitungsmodus und regionale Aufschläge können die Rechnung erheblich beeinflussen. Schätzen Sie die Tokenanzahl vor dem Senden umfangreicher Prompts, überprüfen Sie die Cache-Nutzung anhand der Nutzungsdaten und beurteilen Sie Astra anhand des Nutzens der erledigten Aufgabe und nicht allein anhand des Listenpreises.