
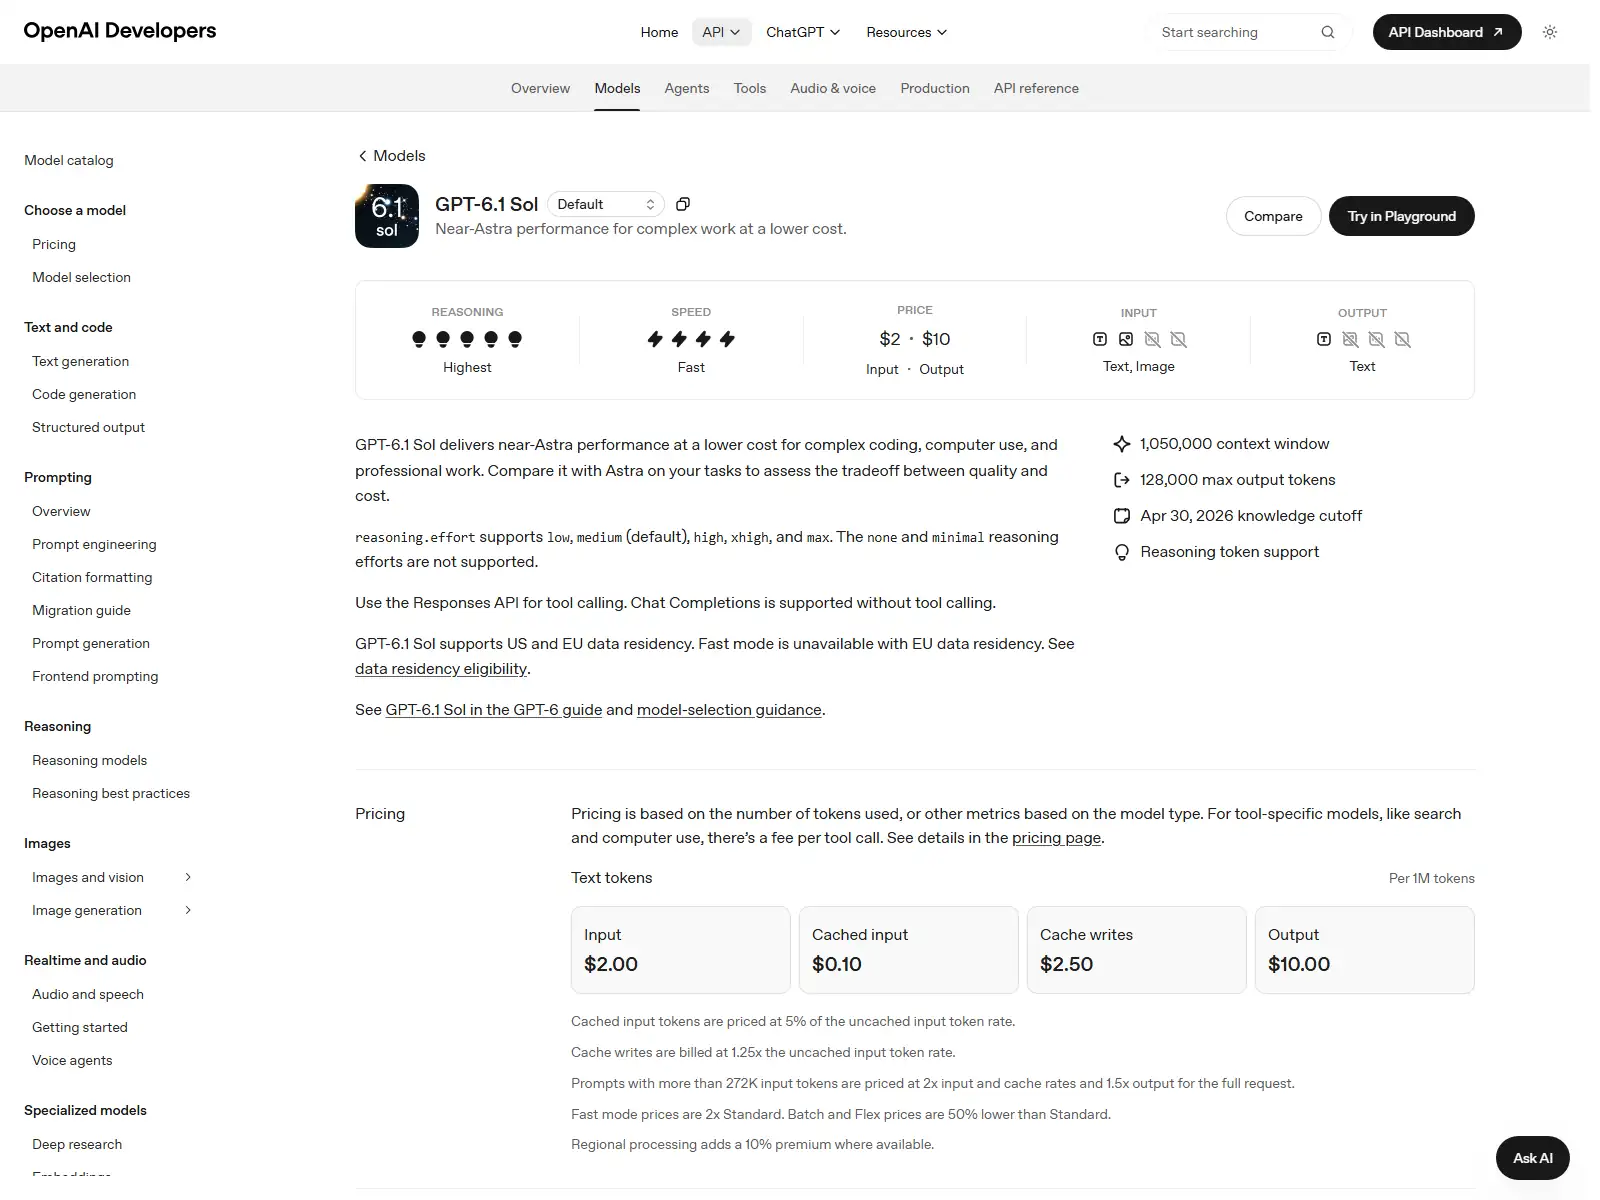
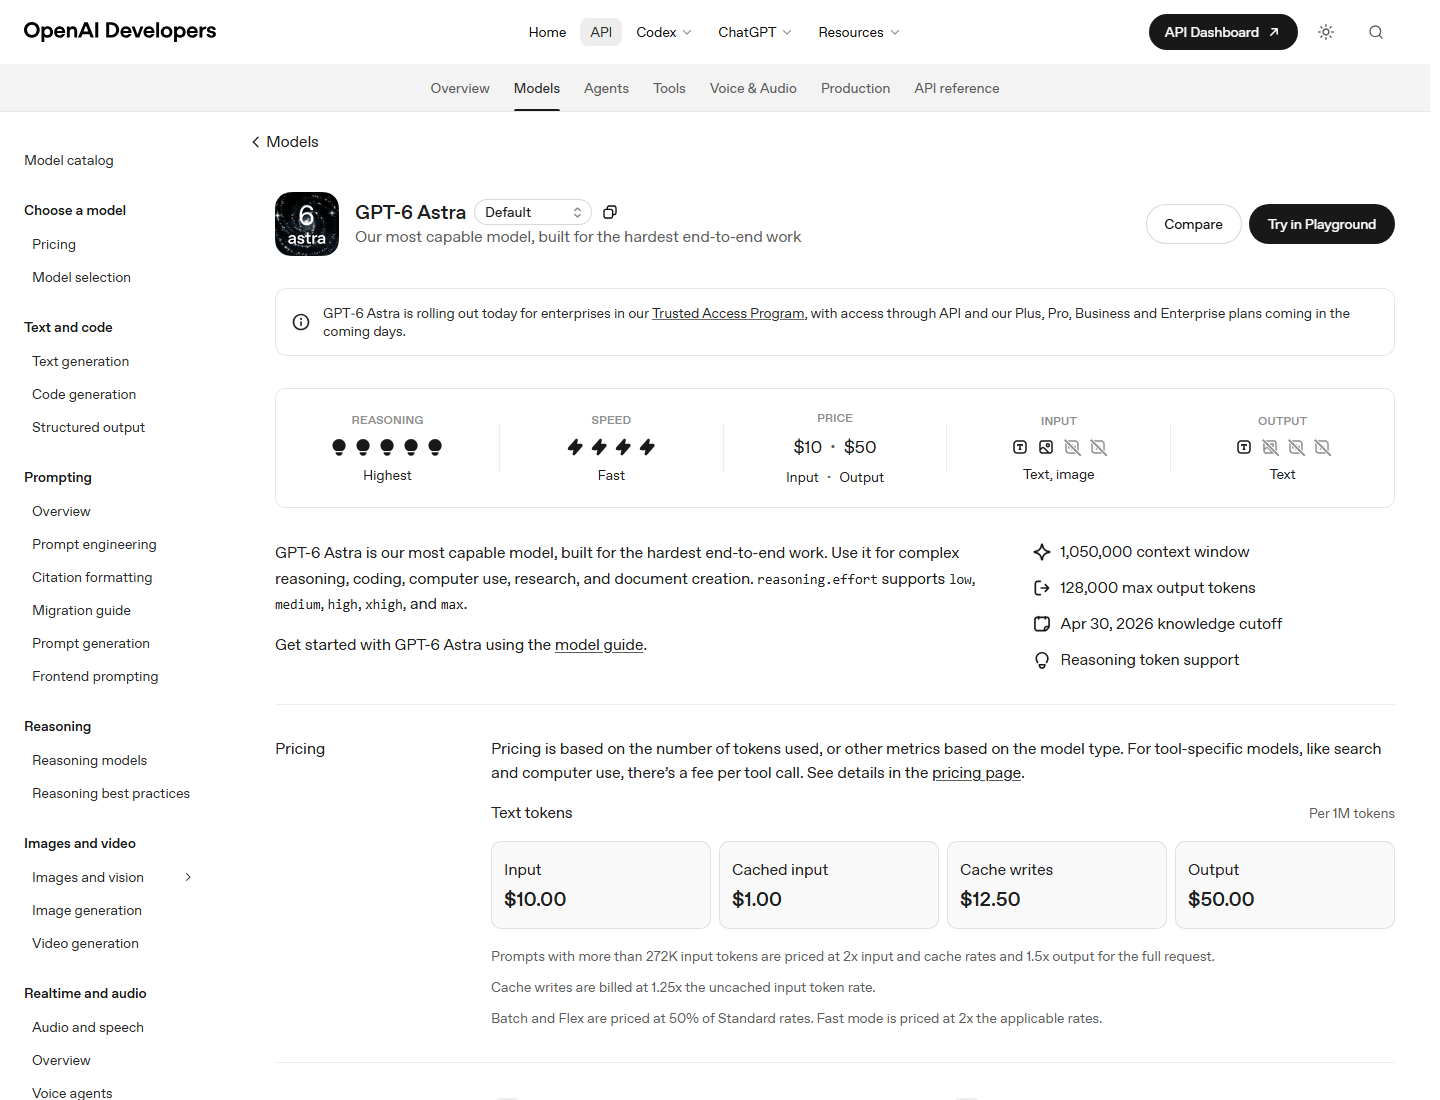
GPT-6.1 Sol ist der Standardwert; GPT-6 Astra ist die Qualitätsobergrenze. Beide bieten dasselbe Kontextfenster von 1.050.000 Token, eine Ausgabebegrenzung von 128.000 Token, multimodale Eingaben und ein umfangreiches Toolset. Der entscheidende Unterschied liegt in der Positionierung und im Preis: Sol kostet $2 pro Million Eingabetoken und $10 pro Million Ausgabetoken, während Astra $10 und $50 kostet. Mit anderen Worten: Astra muss genügend Mehrwert schaffen, um die fünfmal höheren Standard-Token-Kosten zu rechtfertigen.
Das macht Sol jedoch nicht zu “dem gleichen Modell zum günstigeren Preis”. OpenAI bezeichnet Astra als sein leistungsstärkstes Modell für anspruchsvollste End-to-End-Aufgaben und beschreibt Sol als eine Lösung, die bei komplexen Aufgaben eine Leistung nahe der von Astra bietet – und das zu geringeren Kosten. Die richtige Entscheidung ist daher eine Frage der Bewertung und keine Frage der Markenrangliste. Dieser Vergleich stützt sich auf aktuelle GPT-6.1 Sol-Dokumentation, die Seite zum GPT-6-Astra-Modell, sowie identische Kostenszenarien, die am 9. Oktober 2026 überprüft wurden.
GPT-6.1 Sol vs. GPT-6 Astra: Ein kurzer Vergleich
Die Tabelle erleichtert die erste Entscheidung: Wenn Sie noch keine aufgabenspezifischen Erkenntnisse haben, ist Sol die erste Wahl, da es die wichtigsten Schnittstellen- und Kapazitätsmerkmale beibehält und gleichzeitig die Token-Kosten deutlich senkt. Astra wird zur rationalen Wahl, wenn die Aufgabe ungewöhnlich schwierig ist, die Nachteile einer falschen Antwort groß sind oder das bessere Ergebnis mehrere Runden menschlicher oder modellbasierter Überarbeitungen erspart.
Dies unterscheidet sich vom Vergleich von Sol mit einem kleinen, schnellen Modell. Nach den aktuellen Herstellerangaben der OpenAI-Reihe liegt Sol im oberen Bereich und nicht am unteren Ende der Preisklasse. Leser, die sich für ein Modell aus der gesamten Produktpalette entscheiden möchten, können auch unseren Leitfaden zu den besten KI-Modellen und die Testbericht zum GPT-6 Luna um zu sehen, wann ein leichteres Modell ausreicht.
Was GPT-6.1 Sol und GPT-6 Astra gemeinsam haben
Auf den beiden offiziellen Modellseiten sind dasselbe Kontextfenster, die maximale Eingabe, die maximale Ausgabe und der Wissensgrenzwert aufgeführt. Beide akzeptieren Text und Bilder und geben Text aus. Keines der beiden Modelle listet Audio oder Video als native Modell-Eingabe oder -Ausgabe auf. Außerdem weisen sie die gleichen Stufen für den Rechenaufwand auf: „low“, „medium“, „high“, „xhigh“ und „max“, wobei „medium“ als Standardwert gilt. Diese Symmetrie vereinfacht A/B-Tests, da eine Anwendung die meisten Anfrageparameter konstant halten und lediglich die Modell-ID wechseln kann.
Beide Modelle unterstützen strukturierte Ausgaben, Funktionsaufrufe, Websuche, Dateisuche, Bildgenerierung, Code-Interpreter, gehostete Shell, Patch-Anwendung, Computernutzung, MCP, Fähigkeiten und Toolsuche. OpenAI listet den Aufruf von Tools über die Responses-API auf; „Chat Completions“ ist verfügbar, wenn keine Tools beteiligt sind. Eine Feinabstimmung wird auf keiner der beiden Modellseiten unterstützt. Es handelt sich hierbei um Funktionsangaben und nicht um Zusicherungen, dass die beiden Modelle Tools mit identischer Genauigkeit auswählen werden.
Ein Kontextfenster von einer Million Token ist eine Kapazitätsgrenze, kein Freifahrtschein, um das Retrieval-Design zu ignorieren. Sehr lange Anfragen sind aufwendiger, schwieriger zu debuggen und unterliegen der Preisstufe ab 272.000 Eingabetoken. Chunking, Retrieval, Zusammenfassungen und das Zwischenspeichern von Prompts bleiben weiterhin wichtig. Die gleiche Warnung gilt für die Obergrenze von 128.000 Ausgabetoken: Kleinere, überprüfbare Artefakte sind in der Regel sicherer als eine einzige umfangreiche Antwort.
Preisgestaltung: Die fünffache Preisdifferenz
Zu Standardtarifen kostet GPT-6.1 Sol $2 pro Million nicht zwischengespeicherter Eingabetoken, $0,10 für zwischengespeicherte Eingaben, $2,50 für Schreibvorgänge in den Cache und $10 für die Ausgabe. GPT-6 Astra kostet $10, $1, $12,50 bzw. $50. Sol ist bei nicht zwischengespeicherten Eingaben, Cache-Schreibvorgängen und Ausgaben fünfmal günstiger; zwischengespeicherte Eingaben sind zehnmal günstiger. Die aktuellen Zahlen stammen direkt aus den Modellseiten von OpenAI und Dokumentation zur Preisgestaltung der API.
Die in der Überschrift genannte Rate ist nicht der gesamte Preis. Sobald eine Anfrage 272.000 Eingabetoken überschreitet, wendet OpenAI die doppelte normale Eingabe- und Cache-Rate sowie die 1,5-fache normale Ausgaberate auf die gesamte Anfrage an. Die Preise für „Batch“ und „Flex“ liegen bei 50% des Standardtarifs, während „Fast“ das Doppelte des geltenden Tarifs kostet. Astra bietet außerdem eine „Ultrafast“-Stufe an. Vergleichen Sie Gleiches mit Gleichem: Eine Sol-Batch-Anfrage und eine Astra-Fast-Anfrage geben keinen Aufschluss über das zugrunde liegende Modell-Preis-Verhältnis.
Eine ausführlichere Aufschlüsselung der Flaggschiff-Kategorie finden Sie in unserem GPT-6 Astra – Preisübersicht. Die frühere Preisanalyse für GPT-6 Sol Dies ist hilfreich bei der Planung einer Migration von der vorherigen Sol-Generation, jedoch sollten bei Produktionsschätzungen die genaue aktuelle Modell-ID und die aktuellen Tarife verwendet werden.
Langfristige Planung: Gleiche Kapazität, unterschiedliche Wirtschaftlichkeit
Das identische Kontextfenster mit 1.050.000 Token lässt Sol und Astra bei dokumentenintensiven Aufgaben zwar austauschbar erscheinen, doch die Kapazität ist nur die erste Einschränkung. Eine Anfrage, die nahe an der Grenze liegt, muss dennoch die richtigen Belege finden, Anweisungen von zitiertem Material unterscheiden, Beziehungen über viele Dateien hinweg bewahren und ein Ergebnis liefern, das eine Person oder ein Programm überprüfen kann. Das Modell mit dem größeren Namen macht eine Informationsarchitektur nicht überflüssig. Organisieren Sie Quellen, kennzeichnen Sie Grenzen und verlangen Sie Verweise auf stabile Dokumentkennungen.
Die niedrigeren Kosten von Sol machen Experimente mit langem Kontext wirtschaftlich sinnvoll. Ein Team kann mehrere Chunking-Strategien, Abrufschwellen und Zusammenfassungsformate zum Preis eines einzigen Astra-Durchlaufs testen. Diese umfassendere Suche kann das System verbessern, selbst wenn Astra bei einer einzelnen Eingabe den Sieg davonträgt. Astra wird attraktiver, sobald der Arbeitsablauf stabil ist und die noch ungelösten Fehler tatsächlich modellbedingt sind. In der frühen Entwicklungsphase kann die Verwendung des gesamten Budgets für einige wenige Vorzeige-Anfragen weniger Lerneffekte bringen als die Durchführung einer disziplinierten Sol-Auswertung über viele repräsentative Fälle hinweg.
Der Schwellenwert von 272K sollte ausdrücklich überwacht werden. Eine Anfrage mit 271K Eingabetoken und eine mit 273K sind von der Größe her ähnlich, doch durch die zweite Anfrage fällt die gesamte Anfrage in die höhere Bandbreite. Erstellen Sie im Rahmen eines Preflight eine Token-Schätzung und protokollieren Sie, welche Preisklasse jeder Auftrag genutzt hat. Liegt eine Eingabe knapp über der Grenze, kann das Entfernen von doppelten Standardtexten, veralteten Konversationsverläufen oder wenig aussagekräftigen Passagen die Kosten erheblich senken, ohne die Qualität zu beeinträchtigen. Diese Optimierung gilt für beide Modelle, wobei Fehler aufgrund der höheren Grundtarife von Astra teurer zu Buche schlagen.
Das Caching von Eingaben ist besonders nützlich, wenn ein großer Präfix über mehrere Aufrufe hinweg stabil bleibt. Beispiele hierfür sind Richtlinienhandbücher, Codierungsstandards, ein Produktkatalog oder ein Tool-Schema, das von vielen Aufgaben gemeinsam genutzt wird. Stellen Sie stabile Inhalte an den Anfang und variable Anweisungen an den Schluss, sofern das Caching-Verhalten der API diese Anordnung unterstützt. Messen Sie anschließend die Cache-Treffer, anstatt sie nur anzunehmen. Der Vorteil von „Cached Input“ bei Sol ist besonders groß, kann jedoch durch ein sich ständig änderndes Präfix zunichte gemacht werden. Das Cache-Design gehört ebenso wie Genauigkeit und Latenz in den Benchmark-Bericht.
Verwenden Sie für die Recherche und Dokumentenanalyse einen stufenweisen Arbeitsablauf: Sammeln Sie relevante Belege, lassen Sie sich vom Modell eine strukturierte Belegübersicht erstellen, überprüfen Sie die Quellenangaben und fordern Sie erst dann eine Synthese an. Setzen Sie Astra ein, wenn die Synthese auch nach einer soliden Evidenzpipeline noch schwach ausfällt oder wenn die Quellenbasis ungewöhnlich subtile Widersprüche enthält. Dadurch werden Fehler bei der Evidenzgewinnung von Fehlern in der Schlussfolgerung getrennt. Ohne diese Trennung zahlen Teams oft für ein leistungsfähigeres Modell, um ein vermeidbares Problem bei der Kontextkonstruktion auszugleichen.
Programmierung und Einsatz von Werkzeugen
Beim Programmieren lautet die relevante Frage nicht: “Welches Modell kann Code schreiben?” Beide können das. Die Frage ist vielmehr, wo die zusätzlichen Fähigkeiten von Astra das Ergebnis verändern. Sol eignet sich besonders für gängige Repository-Aufgaben: die Implementierung von Funktionen mit begrenztem Umfang, die Diagnose reproduzierbarer Fehler, die Überprüfung von Pull-Anfragen, das Schreiben von Tests, die Transformation von Daten und das Ausführen iterativer Tool-Schleifen. Dank des niedrigeren Preises sind bei gleichem Budget mehr Versuche, mehr Überprüfungen und größere Auswertungssätze möglich.
Astra eignet sich am besten für Aufgaben, bei denen Unklarheiten und Koordination im Vordergrund stehen: eine ungewohnte Monorepo-Migration, eine sicherheitsrelevante Architekturüberprüfung, die Nutzung von Computern mit langfristiger Perspektive, eine schwierige sprachübergreifende Portierung oder ein Produktionsvorfall mit unvollständigen Beweisen. Das leistungsfähigste Modell kann seinen höheren Preis wert sein, wenn ein einziger richtiger Plan stundenlange Nacharbeit verhindert. Unser Das beste KI-Modell zum Vergleich von Programmiercodes erklärt, warum Repository-Tests wichtiger sind als allgemeine Eindrücke zur Programmierung.
- Umfangsbezogene Funktionen mit klaren Abnahmetests
- Regelmäßiges Debugging und Code-Review
- Schleifen mit hohem Datenvolumen
- Entwürfe für Migrationen und Refactorings
- Testgenerierung und Dokumentation
- Schwerwiegende Fehler nach einem Sol-Versuch
- Sicherheits- oder Datenänderungen mit hohem Risiko
- Mehrdeutige systemübergreifende Architektur
- Längere, eigenständige Aufgaben am Computer
- Abschließende Überprüfung, wenn Fehler teuer zu stehen kommen
Beurteilen Sie keines der beiden Modelle anhand von Code, der lediglich plausibel erscheint. Stellen Sie beiden Modellen denselben Repository-Snapshot, dieselben Anweisungen, dieselben Tools, denselben Zeitrahmen und dieselben Tests zur Verfügung. Erfassen Sie die Erfolgsquote, manuelle Korrekturen, Fehlschläge bei Tool-Aufrufen, Tokens, Latenzzeiten und Kosten. Ein Modell, das fünfmal so viel kostet, aber die Anzahl der Fehlversuche halbiert, kann gerechtfertigt sein; ein Modell, das den Stil verbessert, ohne die Akzeptanz zu steigern, hingegen nicht.
Leistungsnachweise: Was wir daraus schließen können und was nicht
Die Positionierung von OpenAI liefert die stichhaltigste Zusammenfassung: Astra ist das leistungsfähigste Modell für die anspruchsvollsten End-to-End-Aufgaben, während GPT-6.1 Sol darauf abzielt, bei komplexen Aufgaben eine Leistung nahe der von Astra zu geringeren Kosten zu erzielen. Diese Aussagen stützen eine Auswahlhypothese, nicht jedoch eine allgemeingültige prozentuale Leistungslücke. Kein einzelner öffentlicher Benchmark kann die Leistung in Bezug auf Ihre firmeneigenen Dokumente, Tools, Richtlinien oder Ihren Code vorhersagen.
Einführungsvideos sind hilfreich, um zu verstehen, wie ein Unternehmen ein Produkt präsentiert, stellen jedoch keine unabhängigen Bewertungen dar. Ebenso zeigen Rezensionen von Content-Erstellern reale Benutzeroberflächen und nützliche Beispiele, doch jede Rezension spiegelt eine bestimmte Aufgabenstellung, Tool-Konfiguration und Veröffentlichungsfrist wider. Betrachten Sie ein positives Vorschaubild oder ein „First-Look“-Urteil als Anhaltspunkt für Ihren eigenen Testplan, nicht als Beweis dafür, dass Astra oder Sol in jeder Kategorie gewinnt.
Das offizielle OpenAI-Video oben dokumentiert die Berichterstattung über den Start von „Astra“. Die unabhängige Seite von Matt Wolfe unten zeigt, dass sich die Aufmerksamkeit Dritter schnell auf das Ausmaß der Veröffentlichung konzentrierte. Keiner der beiden Screenshots wird hier als numerischer Maßstab herangezogen. Der Artikel verzichtet bewusst darauf, Begeisterung, Aufrufe oder den Titel eines Urhebers in eine unbegründete Leistungsbewertung umzuwandeln.
Ein aussagekräftiger Vergleich basiert auf einem privaten Bewertungsdatensatz, der der Produktionsumgebung ähnelt. Beziehen Sie einfache Aufgaben, typische Aufgaben und aufwendige Fehlerfälle ein. Blenden Sie die Ergebnisse aus, wenn menschliche Präferenzen eine Rolle spielen. Testen Sie bei Agenten eher die Aufgabenerledigung und die Wiederherstellung als die erste Reaktion. OpenAI’s Leitfaden zur Modellauswahl empfiehlt ebenfalls, Modelle anhand identischer Aufgaben zu vergleichen und das leichteste Modell sowie den geringsten Rechenaufwand zu wählen, die die Qualitätsanforderungen erfüllen.
So führen Sie einen fairen Vergleich zwischen Sol und Astra durch
Beginnen Sie damit, die Entscheidung zu definieren, die die Bewertung treffen soll. “Welches Modell ist intelligenter?” ist zu vage. Eine sinnvolle Frage lautet: “Welches Modell sollte die Pull-Request-Prüfungen für dieses Repository bei mittlerem Denkaufwand übernehmen?” oder “Sollte die endgültige Vertragssynthese von Sol auf Astra eskaliert werden?” Legen Sie die Aufgabenfamilie, die Service-Stufe, den Denk-Aufwand, die Werkzeuge, das Zeitlimit und die Akzeptanzkriterien fest, bevor Sie Ergebnisse generieren. Andernfalls lässt sich ein positives Ergebnis eher durch die Konfiguration als durch das Modell erklären.
Stellen Sie einen Datensatz zusammen, der groß genug ist, um sowohl gewöhnliche Fälle als auch aussagekräftige Randfälle abzudecken. Zwanzig sorgfältig ausgewählte Beispiele können zwar offensichtliche Fehler aufdecken, doch eine Routing-Richtlinie für den Produktiveinsatz benötigt in der Regel mehr. Wählen Sie Beispiele aus aktuellen realen Projekten aus, nachdem Sie sensible Daten entfernt haben, und kennzeichnen Sie jeden Fall nach Schwierigkeitsgrad und Risiko. Bewahren Sie einen gesperrten Testdatensatz auf, damit die sofortige Feinabstimmung nicht nach und nach zu einer Überanpassung an die Beispiele führt, die bereits jeder gesehen hat. Verwalten Sie den Datensatz und den Evaluator in Versionen, genau wie Sie den Anwendungscode in Versionen verwalten.
Bevorzugen Sie deterministische Prüfungen, wann immer es die Aufgabe zulässt. Kompilieren Sie Code, führen Sie Tests durch, validieren Sie JSON anhand eines Schemas, vergleichen Sie extrahierte Felder mit Bezeichnungen und überprüfen Sie zitierte Passagen. Menschliche Bewerter sollten sich auf Eigenschaften konzentrieren, die durch Automatisierung nicht gut erfasst werden können, wie beispielsweise Klarheit, Urteilsvermögen und die Frage, ob eine Empfehlung den geschäftlichen Kontext berücksichtigt. Die Identität des Modells sollte verborgen und die Reihenfolge der Ergebnisse zufällig angeordnet werden. Wenn die Bewerter wissen, welche Antwort von Astra stammt, können Preis und Ruf die Bewertung beeinflussen, ohne dass jemand absichtlich voreingenommen ist.
Erfassen Sie den Schweregrad, nicht nur Durchschnittswerte. Zehn geringfügige stilistische Vorteile sollten eine kritische Empfehlung zum Datenverlust nicht aufwiegen. Definieren Sie harte Ausschlusskriterien wie erfundene Zitate, unsichere Befehle, fehlende Pflichtfelder oder die Nichteinhaltung einer rechtlichen Vorgabe. Berichten Sie die Verteilung nach Schwierigkeitsgrad und Risikokategorie. Sol könnte bei normalen Aufgaben mit Astra gleichziehen und nur bei den schwierigsten fünf Prozent zurückfallen; dieses Ergebnis spricht stark für einen Router anstelle einer „Alles-oder-Nichts“-Migration.
Berechnen Sie abschließend die Unsicherheit und führen Sie instabile Fälle erneut durch. Da Modellausgaben variieren können, überbewertet ein einmaliger Vergleich den Zufallsfaktor. Wiederholen Sie eine Teilmenge, untersuchen Sie Abweichungen zwischen den Bewertern und bewahren Sie die Rohdaten für eine spätere Überprüfung auf. Die abschließende Empfehlung sollte das Testdatum, die Modell-IDs, die Einstellungen, die Datensatzversion, die verwendeten Preise und bekannte Lücken enthalten. Überprüfen Sie diese nach einer Modellaktualisierung, einer Änderung der Prompts oder einer wesentlichen Veränderung der Arbeitslast erneut. Die Wahl eines Modells ist eine fortlaufende Produktionsentscheidung und kein dauerhaftes Errungenschaft.
Lassen Sie nicht zu, dass der Bewerter zum versteckten Entscheidungsmodell wird. Wenn ein automatisierter Bewerter eine bestimmte Ausgabe deutlich bevorzugt, wählen Sie diese Entscheidungen für eine Expertenprüfung aus und vergleichen Sie den Bewerter mit den tatsächlichen Akzeptanzergebnissen. Trennen Sie die Qualität der Darstellung von der Richtigkeit der Aufgabe: Eine ausgefeilte Erklärung kann eine nicht erfüllte Anforderung verschleiern, während eine knappe Antwort möglicherweise jeden Test besteht. Berichten Sie außerdem über Enthaltungen und Unentschieden, anstatt einen Gewinner zu erzwingen. Diese Details machen das Ergebnis zwar weniger dramatisch, aber für die Budgetierung und Weiterleitung weitaus nützlicher. Das Ziel ist eine wiederholbare Betriebsregel, die ein anderes Teammitglied überprüfen und reproduzieren kann. Zeichnen Sie auch abgelehnte Ergebnisse auf; Fehlerbeispiele verdeutlichen die Weiterleitungsgrenze oft besser als eine Tabelle mit Durchschnittswerten.
Beispiele für tatsächliche Kosten
Betrachten wir einen Durchlauf eines Codierungsagenten mit 200.000 nicht zwischengespeicherten Eingabetoken und 20.000 Ausgabetoken. Sol kostet etwa $0,60: $0,40 für die Eingabe und $0,20 für die Ausgabe. Astra kostet etwa $3,00: $2,00 plus $1,00. Über 10.000 Durchläufe hinweg beträgt die Differenz etwa $24.000 vor Tool-Gebühren, Caching, regionalen Aufschlägen oder Anpassungen der Servicestufe.
Betrachten wir nun eine Anfrage mit langem Kontext, die 300.000 Eingabetoken und 30.000 Ausgabetoken umfasst. Da die Eingabe 272.000 überschreitet, gelten für die gesamte Anfrage die höheren Raten. Sols effektive Eingaberate beträgt nun $4 pro Million und die Ausgaberate $15, was insgesamt etwa $1,65 ergibt. Bei Astra beträgt die Eingaberate $20 und die Ausgaberate $75, was insgesamt etwa $8,25 ergibt. Das Verhältnis von 1:5 bleibt bestehen, aber die absolute Differenz nimmt zu.
Durch das Caching kann sich die Berechnung weiter in Richtung Sol verlagern, da dessen Cache-Eingangsrate nur ein Zehntel derjenigen von Astra beträgt. Dies ist relevant für stabile Systembefehle, umfangreiche wiederholte Referenzen und das Agent-Scaffolding. Allerdings sind Cache-Schreibvorgänge nach wie vor mit Kosten verbunden, und eine Änderung des Präfixes kann die Wiederverwendbarkeit verringern. Nehmen Sie Ihre Schätzungen anhand tatsächlicher Nutzungsprotokolle vor, anstatt davon auszugehen, dass jedes Token die Cache-Rate erhält.
So vergleichen Sie die Modelle in der API
Verwenden Sie die Responses-API für Anwendungen, die diese API nutzen, und halten Sie die Vergleichskonfiguration identisch. Der einfachste sinnvolle Testaufbau besteht darin, denselben Input an beide Modell-IDs zu senden, die Metadaten der Antworten aufzuzeichnen und denselben Evaluator auszuführen. Geben Sie API-Schlüssel nicht im Quellcode preis; verwenden Sie stattdessen eine Umgebungsvariable und Ihren üblichen Secret-Manager.
Die Stichprobe ist bewusst klein gehalten. Ein Produktions-Harness sollte Anfrage-IDs, Evaluator-Versionen, Repository-Commits, Tool-Traces, Wiederholungsanzahlen und Akzeptanzergebnisse speichern. Außerdem sollte er den Preis anhand der tatsächlich genutzten Servicestufe und des tatsächlich genutzten Long-Context-Bands berechnen. Vermeiden Sie es, dass ein Modell Feedback sieht, das das andere nicht erhalten hat, es sei denn, Sie testen ausdrücklich eine Routing-Sequenz.
Eine praktische Strategie für die Routenführung von Sol nach Astra
Ein zweistufiger Router erfasst das stärkste wirtschaftliche Argument für Sol, ohne so zu tun, als seien alle Eingabeaufforderungen gleichwertig. Leiten Sie normalen Datenverkehr mit mittlerer Bewertungsgewichtung an Sol weiter. Eskalieren Sie, wenn deterministische Tests fehlschlagen, das Modell eine geringe Konfidenz meldet, die Aufgabe einer Kategorie mit hohem Risiko zugeordnet ist oder ein Mensch ausdrücklich eine Flaggschiff-Überprüfung anfordert. Halten Sie die Eskalationsregeln transparent, damit die Kosten nicht unbemerkt in die Höhe treiben.
Verwenden Sie dieselbe Eingabeaufforderung, dieselben Tools und dieselben Abnahmetests.
Tests, Konfidenz, Risikoklasse und manuelle Überprüfung.
Leiten Sie fehlerhafte oder risikoreiche Arbeiten an Astra weiter.
Verfolgen Sie die Abnahme, Nacharbeiten, Verzögerungen und Gesamtkosten.
Das Routing bietet Teams zudem eine kontrollierte Möglichkeit, Standardwerte anzupassen. Wenn sich die Akzeptanzrate von Sol bei einer Aufgabengruppe verbessert, sollte deren Anteil erhöht werden. Wenn Astra wiederholt kostspielige Fehler verhindert, sollte diese Kategorie direkt weitergeleitet werden. Der Vergleich wird so zu einer datengestützten Betriebsrichtlinie statt zu einer einmaligen Modelldiskussion. Als Referenz für eine frühere Generation siehe GPT-6 Astra vs. GPT-5.6 Sol.
Latenz und Zuverlässigkeit gehören in dieselbe Routing-Richtlinie. Ein Modell kann zwar eine aussagekräftigere Antwort liefern, dennoch aber die falsche Standardwahl sein, wenn seine Antwortzeit einen interaktiven Arbeitsablauf unterbricht oder seine längere Überlegungszeit zu Zeitüberschreitungen bei den Aufträgen führt. Messen Sie die Latenz bis zum ersten Token, die Gesamtdauer, die Wiederherstellung nach einem Tool-Aufruf und den erfolgreichen Abschluss unter realistischen Parallelitätsbedingungen. Definieren Sie anschließend für jede Aufgabenklasse ein Serviceziel. Sol kann den zeitkritischen Produktionsverkehr übernehmen, während Astra die asynchrone Überprüfung übernimmt – oder umgekehrt, was gerechtfertigt sein kann, wenn eine schwierige Aufgabe regelmäßig vor der Eskalation fehlschlägt. Die Modellentscheidung ist operativer Natur und nicht bloß redaktioneller Art.
Wer sollte sich für Sol entscheiden, und wer für Astra?
Entscheiden Sie sich für GPT-6.1 Sol für eine kostenbewusste Produktion
Sol eignet sich für Produktteams, Agenturen, Forscher und Entwickler, die umfangreiche Mengen anspruchsvoller Arbeit bewältigen, aber dennoch über messbare Akzeptanzkriterien verfügen. Besonders überzeugend ist es, wenn Iterationen Teil des Prozesses sind: „Code-Test-Fix“-Schleifen, Dokumentenüberarbeitungen, Extraktion mit Validierung, Forschungszusammenfassungen und mehrstufige interne Agenten. Durch den niedrigeren Preis stehen mehr Testumfänge und ein größeres Budget für Wiederholungsversuche zur Verfügung.
Entscheiden Sie sich für GPT-6 Astra – für die anspruchsvollsten und qualitätskritischsten Aufgaben
Astra eignet sich für Teams, bei denen die schwierigsten Aufgaben mit hohen Fehlerkosten oder unzureichenden automatisierten Prüfungen verbunden sind. Eine schwierige Architekturentscheidung, eine abschließende Sicherheitsüberprüfung, eine neuartige wissenschaftliche Denk Aufgabe oder eine lange Abfolge von Rechenvorgängen können die Anschaffung des Flaggschiff-Modells rechtfertigen. Es ist zudem die sinnvollere Standardwahl in der frühen Erkundungsphase, wenn das Team noch nicht weiß, was ein kleineres Modell übersieht, und die Kosten keine unmittelbare Einschränkung darstellen.
Verwenden Sie beide, wenn der Schwierigkeitsgrad der Aufgaben variiert
Die meisten ausgereiften Systeme sollten nicht bei jeder Anfrage ein einziges Modell vorschreiben. Verwenden Sie „Sol“ für den breiten Mittelbereich und „Astra“ als Eskalationsschicht. Fügen Sie „Luna“ oder ein anderes kleineres Modell für vorhersehbare Klassifizierung und Transformation hinzu. Dieses mehrstufige Design spiegelt die tatsächliche Vielfalt der Arbeitslasten wider und ist in der Regel wirtschaftlicher, als über einen einzigen dauerhaften „Gewinner“ zu debattieren. Unser Methodik zur Modellprüfung bietet einen nützlichen Rahmen, um wiederholbare Erkenntnisse von Eindrücken zu unterscheiden.
So verwenden Sie GPT-6.1 Sol und GPT-6 Astra auf GlobalGPT
GlobalGPT bietet Live-Produktpfade für beide Modelle innerhalb eines multimodellen Arbeitsbereichs. Öffnen Sie den Arbeitsbereich, starten Sie eine neue Konversation und wählen Sie im aktuellen Modellauswahlfeld entweder „GPT-6.1 Sol“ oder „GPT-6 Astra“ aus. Die Zusammenführung beider Modelle in einer einzigen Oberfläche ist nützlich für vergleichende Erkundungsarbeiten, während die API-Auswertung nach wie vor der bessere Weg für automatisierte Bewertungen, die genaue Erfassung der Nutzung und die Steuerung der Bereitstellung ist.
Beginnen Sie beim ersten Durchgang mit Sol, führen Sie dann die schwierigste Eingabe mit Astra erneut aus und vergleichen Sie, was sich wesentlich geändert hat.
Geöffnet GlobalGPTWeitere modellspezifische Hintergrundinformationen finden Sie in unserem Anleitung zu GPT-6.1 Sol erklärt und Testbericht zum GPT-6 Astra. Auf diesen Seiten werden die einzelnen Modelle jeweils separat behandelt; auf dieser Seite geht es um die Kauf- und Routing-Entscheidung zwischen ihnen.
Häufig gestellte Fragen
Ist GPT-6.1 Sol besser als GPT-6 Astra?
Nicht unbedingt. OpenAI positioniert GPT-6 Astra als sein leistungsstärkstes Modell und GPT-6.1 Sol als kostengünstigeres Modell, das bei komplexen Aufgaben eine Leistung nahe der von Astra bietet. Sol bietet das bessere Preis-Leistungs-Verhältnis, wenn es Ihre Qualitätsanforderungen erfüllt; Astra ist die sicherere, qualitätsorientierte Wahl für die anspruchsvollsten Aufgaben.
Um wie viel günstiger ist GPT-6.1 Sol als GPT-6 Astra?
Zu Standardtarifen kostet Sol $2 pro Million Eingabetoken und $10 pro Million Ausgabetoken, während Astra $10 bzw. $50 kostet. Sol ist daher bei nicht zwischengespeicherten Eingabe- und Ausgabetoken fünfmal günstiger. Sein Preis von $0,10 für zwischengespeicherte Eingabetoken beträgt ein Zehntel des Preises von Astra in Höhe von $1.
Haben GPT-6.1 Sol und GPT-6 Astra dasselbe Kontextfenster?
Ja. In OpenAI sind für beide Modelle ein Kontextfenster von 1.050.000 Token, eine maximale Eingabe von 922.000 und eine maximale Ausgabe von 128.000 angegeben. Bei Anfragen mit mehr als 272.000 Eingabetoken wird die gesamte Anfrage auf Tarife mit längerem Kontext umgeleitet.
Welches Modell eignet sich besser zum Programmieren?
Astra ist die erste Wahl in Sachen Qualität für ungewöhnlich schwierige, mehrdeutige oder risikoreiche Repository-Arbeiten. Sol ist die praktische Standardlösung für routinemäßige Feature-Entwicklung, Fehlerbehebung, Reviews und Agent-Loops, da seine geringeren Kosten mehr Iterationen ermöglichen. Führen Sie beide vor einer Standardisierung an denselben Repository-Tests aus.
Unterstützen beide Modelle Werkzeuge und die Eingabe von Bildern?
Ja. Auf den offiziellen Modellseiten werden folgende Funktionen aufgeführt: Text- und Bildeingabe, Textausgabe, strukturierte Ausgaben, Funktionsaufrufe, Websuche, Dateisuche, Code-Interpreter, gehostete Shell, Patches anwenden, Computernutzung, MCP, Fähigkeiten und Toolsuche. Für den Aufruf von Tools sollte die Responses-API verwendet werden.
Wann muss ich für GPT-6 Astra bezahlen?
Setzen Sie Astra ein, wenn ein Fehler hohe Kosten verursacht, es sich um eine wirklich bahnbrechende Aufgabe handelt oder eine vergleichende Bewertung zeigt, dass die zusätzliche Qualität den Nacharbeitsaufwand so weit reduziert, dass sich das Fünffache des Token-Preises rechtfertigt. Beispiele hierfür sind kritische Migrationen, der Einsatz komplexer autonomer Computersysteme und die abschließende Überprüfung von Ergebnissen mit hoher Tragweite.
Für welche Argumentationsmethode soll ich mich entscheiden?
Beginnen Sie mit der Einstellung „mittel“, der dokumentierten Standardeinstellung für beide Modelle. Verringern Sie den Wert für einfache Transformationen und erhöhen Sie ihn nur, wenn der Schwierigkeitsgrad der Aufgabe oder die Fehlerkosten dies erfordern. Die effiziente Einstellung ist diejenige, bei der Ihre Abnahmetests durchweg bestanden werden, ohne dass dafür ein übermäßiger Aufwand erforderlich ist.
Kann ich GPT-6.1 Sol und GPT-6 Astra auf GlobalGPT verwenden?
GlobalGPT verfügt in seinem Multi-Modell-Arbeitsbereich über Live-Routen sowohl für GPT-6.1 Sol als auch für GPT-6 Astra. Die Verfügbarkeit kann je nach Konto und Schnittstelle variieren. Öffnen Sie daher den Arbeitsbereich und überprüfen Sie den aktuellen Modell-Picker, bevor Sie einen Produktions-Workflow starten.
Sollte ich jede Eingabe an ein einziges Modell weiterleiten?
In der Regel nicht. Ein einfacher Router kann normale Aufgaben an Sol weiterleiten und Fälle mit geringer Zuverlässigkeit, fehlgeschlagenen Tests oder hohem Risiko an Astra eskalieren. Auf diese Weise wird der größte Teil des Kostenvorteils von Sol genutzt, während Astra für Aufgaben reserviert bleibt, bei denen die zusätzliche Leistungsfähigkeit einen messbaren Mehrwert bietet.
Endgültiges Urteil
GPT-6.1 Sol sollte das erste Modell sein, das kostenbewusste Teams in Betracht ziehen; GPT-6 Astra sollte weiterhin das Ziel für die anspruchsvollsten Aufgaben bleiben. Ihr gemeinsamer Kontext, ihre Ausgabebeschränkung, ihre Modalitäten, ihre Steuerungsmöglichkeiten für die Schlussfolgerungen und ihr Werkzeugkatalog machen den Vergleich ungewöhnlich übersichtlich. Sol bietet den wirtschaftlichen Vorteil. Astra hat den offiziellen Leistungsvorteil.
Die entscheidende Kennzahl ist nicht allein der Token-Preis oder das Ansehen des Modells. Messen Sie die Kosten pro akzeptiertem Ergebnis unter realen betrieblichen Einschränkungen und Budgets. Wenn Sol eine ähnliche Erfolgsquote aufweist, lassen sich seine um das Fünffache niedrigeren Eingabe- und Ausgaberaten ohne Zwischenspeicherung kaum ignorieren. Wenn Astra Fehler verhindert, die Überprüfung durch Experten reduziert oder Aufgaben löst, die Sol nicht bewältigen kann, kann der Aufpreis gerechtfertigt sein. Beginnen Sie mit identischen Aufgaben, führen Sie die Bewertung nach Möglichkeit blind durch und fördern Sie nur das Modell und die Argumentationsleistung, die sich ihren Platz verdient haben.









