 Chloe Murphy
Wasserstoff
Beobachtete Zeit55,21 sEingabe-Tokens4,273Ausgabe-Tokens8,243
Ausgabebewertung
Korrekt: A+C+D, Kosten 16, Wert 31. Außerdem wurde A+C+E als einziges weiteres zulässiges Portfolio mit einem Wert von mindestens 30 identifiziert.
Wir vergleichen die von Google veröffentlichten Benchmarks und API-Preise und testen dann alle drei Modelle mit identischen Aufgaben, mit verifizierten Ergebnissen, Prompts, Zeit- und Token-Verbrauch.

Hydrogen hat den niedrigsten offiziellen Token-Preis; Carbon zielt auf das tiefste Denken; Argon balanciert modernste Denkfähigkeit und Effizienz. Alle drei haben unsere vier abgeschlossenen Aufgaben bestanden. Der schwierigste Codetest zeigte Unterschiede in Formatierung und Erklärung, aber keinen Gewinner bei der Korrektheit.
Google hat jetzt drei Gemini-4-Modelle, deren Namen kaum verraten, welches man wählen sollte. Sollten Sie mit Hydrogen beginnen, Argon für anspruchsvolle Arbeiten verwenden oder für Carbons tiefergehende Schlussfolgerungen bezahlen?
Der nützliche Vergleich ist die Fähigkeit pro Aufgabe: was jedes Modell lösen kann, wie viel Schlussfolgerung es verwendet und was eine fertige Antwort kostet. Offizielle Benchmark-Ergebnisse geben uns einen Ausgangspunkt; schwierige Aufgaben mit gleichem Prompt sind nötig, um zu sehen, wo diese Unterschiede wichtig sind.
Wir haben alle drei Modelle über GlobalGPT mit denselben Aufgaben getestet. Wenn Sie Ihre eigene Arbeitslast vergleichen möchten, beginnen Sie mit GlobalGPT und prüfen Sie die aktuellen Modelloptionen und Nutzungsbedingungen Ihres Kontos.
Entwickelt für schnelles alltägliches Codieren und agentenbasierte Ausführung.
Kann eigenständig ausgeführt werden oder die Ausführung neben Modellen mit tieferem Denken übernehmen.
Von Google gemeldeter Index: 51 bei hohem Denken, 54 bei xhigh.
Quelle: Googles Hydrogen-Ankündigung.
Googles leistungsfähigste Gemini 4 Reasoning-Modell.
Gedacht für schwieriges Debugging, wissenschaftliche Forschung und erweiterte Verifikation.
Kann trotz gleicher Token-Raten mehr Reasoning-Tokens als Argon verbrauchen.
Quelle: Googles Carbon-Verfügbarkeitsankündigung.
Effizientes Frontier-Reasoning für anspruchsvolles Programmieren, Mathematik und Wissenschaft.
Google positioniert es als schneller und weniger token-intensiv als Carbon.
Seine Rolle ist ein Gleichgewicht zwischen Reasoning-Tiefe und Aufgabenkosten.
Quelle: Googles Modell- und Preisdokumentation.
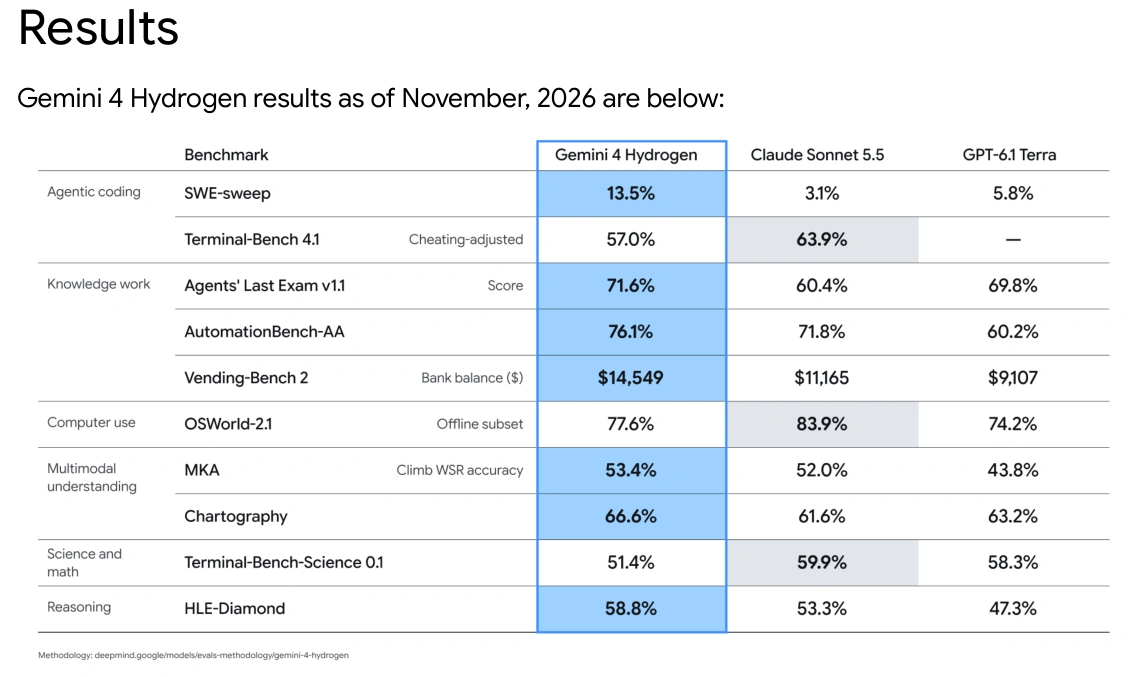
VERÖFFENTLICHTER BENCHMARK · HÖHER IST BESSER
Ein schneller Überblick über die von Google gemeldeten Werte.
Dies sind von Google gemeldete veröffentlichte Ergebnisse, geprüft am 15. November 2026. Es handelt sich nicht um Ergebnisse unserer eigenen Tests. Die Zahl von Carbon stammt aus seiner Ankündigung; die Zahlen für Hydrogen und Argon stammen aus der Hydrogen-Ankündigung oben. Dies ist ein Quellenvergleich über Ankündigungen hinweg und kein neuer Drei-Modell-Leaderboard-Lauf mit unabhängig verifizierten identischen Einstellungen.
Stellen Sie die Zahlen von Terminal-Bench 4.0 und 4.1 nicht in eine gemeinsame Rangliste. Eine geänderte Evaluierungsversion kann die Aufgabenschwierigkeit verändern, sodass die Prozentsätze keinen fairen direkten Vergleich zulassen.
Standard-Gemini-API-Preise in USD pro eine Million Tokens, geprüft am 15. November 2026:
STANDARD GEMINI API · USD PRO 1 MIO. TOKENS
Eingabe
AUSGABE · EINSCHLIESSLICH DENKEN
Eingabe
AUSGABE · EINSCHLIESSLICH DENKEN
Eingabe
AUSGABE · EINSCHLIESSLICH DENKEN
*Die aktuell veröffentlichten Preise von Hydrogen sehen keine Erhöhung im Dezember vor; dies ist keine Garantie gegen zukünftige Änderungen. Die Ausgabeabrechnung umfasst Thinking-Tokens. Such- und andere Tool-Gebühren sind separat. Dies sind die API-Preise von Google, nicht die Abonnementpreise oder Guthabenumrechnungen von GlobalGPT.
Bei festen Token-Anzahlen kostet Hydrogen25 % weniger als Carbon oder Argon zu ihren Einführungspreisen. Gegenüber den angekündigten Dezemberpreisen beträgt der Unterschied 62,5 %. Die tatsächlichen Aufgabenkosten hängen auch von Reasoning-Tokens, Wiederholungen und Tool-Nutzung ab.
Zum Beispiel kosten 100.000 Eingabetokens und 20.000 abrechenbare Ausgabetokens 0,30 $ bei Hydrogen, 0,40 $ bei Carbon oder Argon bis zum 30. November und 0,80 $ bei Carbon oder Argon ab dem 1. Dezember. Diese Berechnung schließt Tools, Caching, Mengenrabatte und Wiederholungen aus; sie sagt nicht voraus, wie viele Tokens jedes Modell benötigt.
Hydrogen hat eine ratenbegrenzte kostenlose API-Stufe. Carbon und Argon haben keine. Verbraucherabonnements sind ein separater Kauf mit eigenen Zugriffsregeln.
Quelle: Google API-Preise.
Wir haben Hydrogen, Carbon und Argon bei vier identischen Aufgaben getestet. Die ersten drei prüften die Kernkorrektheit; die letzte Aufgabe erforderte ein vollständiges Exaktsuchprogramm, das wir ausführten und mit einer unabhängig berechneten Antwort verglichen.
Gleiche Eingabe und Systemanweisung für jede Aufgabe.
Neue Anfragen, Projektkontext deaktiviert und keine Modell-Tool-Nutzung.
Korrektheit, Ausgabeformat, Zeit- und Token-Verbrauch werden separat bewertet.
TEST 1 · GENAUIGKEITS-BASISWERT
Wählen Sie das optimale Portfolio und identifizieren Sie jede qualifizierende Alternative.
Solve exactly, showing verifiable arithmetic and a proof of optimality. Six indivisible projects have (cost, value): A(7,13), B(6,12), C(5,10), D(4,8), E(3,7), F(2,4). Budget=16. C requires A. D and E cannot both be selected. B requires at least one of D or F. Select projects maximizing total value; break ties by lower cost then alphabetically sorted project-list. Give chosen list, cost, value and enumerate all feasible candidates with value at least 30. No external tools or web.
Korrekt: A+C+D, Kosten 16, Wert 31. Außerdem wurde A+C+E als einziges weiteres zulässiges Portfolio mit einem Wert von mindestens 30 identifiziert.
Korrekt: A+C+D, Kosten 16, Wert 31. Außerdem wurde A+C+E als einziges weiteres zulässiges Portfolio mit einem Wert von mindestens 30 identifiziert.
Korrekt: A+C+D, Kosten 16, Wert 31. Außerdem wurde A+C+E als einziges weiteres zulässiges Portfolio mit einem Wert von mindestens 30 identifiziert.
Aufgabenurteil: Alle drei haben die Kernantwortprüfungen bestanden.
TEST 2 · GENAUIGKEITSBASIS
Trennen Sie die Gesamtkonversion von gerätespezifischen Effekten und standardisiertem Lift.
Analyze a randomized experiment using only these counts. Variant A: mobile 90 purchases/900 visitors; desktop 80/100. Variant B: mobile 20/100; desktop 630/900. Show overall and device-specific conversion rates, absolute lifts B-A, and a standardized B-A lift using 50% mobile/50% desktop. Explain the reversal, distinguish observational aggregate from randomized causal interpretation, and state exactly what randomization details are missing. May we claim B wins overall and in both devices? Do not invent significance or revenue. No external tools or web.
Korrekt: B führt insgesamt um 48 Prozentpunkte, verliert aber auf dem Desktop 10 Punkte. Eine übliche 50/50-Gerätemischung ergibt Null-Lift. Ein Sieg in beiden Segmenten wurde abgelehnt.
Korrekt: B führt insgesamt um 48 Prozentpunkte, verliert aber auf dem Desktop 10 Punkte. Eine übliche 50/50-Gerätemischung ergibt Null-Lift. In beiden Segmenten einen Sieg abgelehnt.
Richtig: B führt insgesamt um 48 Prozentpunkte, verliert aber 10 Punkte auf dem Desktop. Eine übliche 50/50-Gerätemischung ergibt null Steigerung. In beiden Segmenten einen Sieg abgelehnt.
Aufgabenurteil: Alle drei bestanden die Kernantwortprüfungen.
TEST 3 · GENAUIGKEITSBASIS
Wenden Sie Revisionen, Stornierungen und Rückerstattungen korrekt an und geben Sie dann striktes JSON zurück.
Return valid JSON only, no Markdown. Reconcile event ledger by event_id: retain highest revision, then exclude void=true. Amounts are integer cents; refund amounts subtract from captured revenue even when received before capture; group by order_id; ignore pending. Ledger: [e1,r1,o1,capture,1000,false];[e1,r2,o1,capture,1200,false];[e2,r1,o1,refund,200,false];[e3,r1,o2,refund,300,false];[e4,r1,o2,capture,2000,false];[e5,r1,o3,capture,500,false];[e5,r2,o3,capture,500,true];[e6,r1,o3,pending,900,false];[e7,r1,o4,capture,700,false];[e8,r1,o4,refund,800,false];[e8,r2,o4,refund,600,false];[e9,r1,o2,refund,100,false]. Output keys orders (array sorted by order_id with order_id,net_cents,retained_event_ids sorted lexically), total_net_cents, excluded_event_ids (superseded event versions written as event_id:rN plus void and pending versions). Include o3 with zero net. No external tools or web.
Richtig: Bestellsummen von 1.000, 1.600, 0 und 100 Cent; insgesamt 2.700 Cent. Rohausgabe als JSON ohne Bereinigung geparst.
Richtig: Bestellsummen von 1.000, 1.600, 0 und 100 Cent; insgesamt 2.700 Cent. Rohausgabe als JSON ohne Bereinigung geparst.
Korrekt: Bestellsummen von 1.000, 1.600, 0 und 100 Cent; Gesamtsumme 2.700 Cent. Rohausgabe ohne Bereinigung als JSON geparst.
Aufgabenurteil: Alle drei bestanden die Kernantwortprüfungen.
TEST 4 · HARD CODING TASK
Generieren Sie ausführbares Python für eine eingeschränkte Suche; wir haben jedes Programm gegen eine unabhängige erschöpfende Referenz ausgeführt.
Find the EXACT top 5 feasible portfolios, ranked by highest total value, then lowest total cost, then lexicographic sorted ID string. Items (ID,cost,value): [('A', 9, 19), ('B', 7, 16), ('C', 11, 25), ('D', 6, 13), ('E', 8, 18), ('F', 5, 12), ('G', 10, 23), ('H', 4, 9), ('I', 12, 29), ('J', 3, 8), ('K', 7, 17), ('L', 6, 15), ('M', 9, 22), ('N', 5, 11), ('O', 8, 20), ('P', 4, 10), ('Q', 11, 27), ('R', 2, 5)]. Budget 55; choose between 6 and 9 items inclusive. Dependencies: C requires A; G requires B and D; I requires E; M requires F and H; Q requires J and K. Mutually exclusive pairs: (A,B),(E,F),(L,N),(O,Q). At least 2 of C,G,I,M,Q. Exactly 2 of D,H,L,P. At least one of B,F,J,N,R. If O is selected then P is selected and K is absent. If R is selected then exactly one of A,E is selected. Return ONLY executable Python 3 code, at most 120 lines. Implement an exact exhaustive search, print JSON with keys feasible_count and top5 (each row [sorted_ID_string,cost,value]). Do NOT manually calculate or hardcode the answer. State complexity in a code comment. Use only itertools and json; no filesystem, network, subprocess or other imports. The code will be executed and checked against an independent exhaustive reference.Bestanden: Ausführbarer Code gab zurück 121 zulässige Portfolios und die korrekten Top fünf. Enthielt die korrekte Kombinationsanzahl und eine ausführlichere Komplexitätserklärung.
Bestanden: ausführbarer Code zurückgegeben 121 zulässige Portfolios und die korrekte Top Fünf. Die Kombinationsanzahl war korrekt; die Komplexitätsnotiz ließ den letzten Sortierterm aus.
Bestanden nach Entfernen eines Markdown-Zauns: Code zurückgegeben 121 zulässige Portfolios und die korrekte Top Fünf. Der Kommentar behauptete 115.379 Kombinationen statt 142.766 und ließ die Sortierung in seiner Komplexitätsnotiz aus.
Aufgabenurteil: Funktionale Korrektheit gleichauf. Hydrogen lieferte in diesem Lauf die sauberste Kombination aus ausführbarer Formatierung und Erklärung.
Die Zeiten sind Beobachtungen aus einzelnen End-to-End-Läufen einschließlich Netzwerk- und Wartezeit, wobei die Anfragen gleichzeitig ausgeführt wurden. Tokens geben die Input-/Output-Nutzung an und können Reasoning- oder Request-Wrapper-Tokens enthalten; sie sind keine Dollargebühren. Ein separater Direktantwort-Versuch stieß auf Ratenlimits oder einen lokalen Timeout und wurde von der Qualitätsbewertung ausgeschlossen. Die obige Codierungsaufgabe verwendete einen neuen abgestimmten Prompt.
Beginnen Sie mit Hydrogen, wenn die niedrigeren offiziellen Token-Raten zu Ihrer Arbeitslast passen. Behalten Sie Argon im Vergleich, wenn Sie Wert auf effizientes Frontier-Reasoning legen: Es hat unsere Exact-Search-Codierungsaufgabe nach Formatierungsbereinigung korrekt gelöst. Bewerten Sie Carbon bei Arbeiten, die tiefere Exploration erfordern; dieser Testsatz zeigte keinen Korrektheitsvorteil, der eine Standardwahl rechtfertigen würde. Prüfen Sie die angezeigte Plattformgebühr getrennt von den Google-API-Raten.
Hydrogen hat die niedrigsten gelisteten Standard-API-Raten: 1,50 $ pro Million Eingabetokens und 7,50 $ pro Million Ausgabetokens, geprüft am 15. November 2026.
Ihre gelisteten Standard-Token-Raten sind gleich. Carbon kann pro Aufgabe dennoch mehr kosten, wenn es mehr Reasoning-Tokens oder Verifikationsschritte verwendet.
Nein. Überprüfen Sie die Benchmark-Version und die Denkeinstellung und testen Sie das Modell dann an repräsentativen Aufgaben mit unabhängig überprüfbaren Antworten.
Wir haben jeden generierten Python-Solver ausgeführt und seine zulässige Anzahl und die fünf besten Portfolios mit einer unabhängigen Referenz durch vollständige Suche verglichen.
Unser Argon-Zugriffsleitfaden erklärt die Unterschiede zwischen Plattformzugriff, Google-Abonnements, AI Studio und API-Abrechnung.
Einzelheiten zum Zugriff finden Sie unter wie man Gemini 4 Argon verwendet. Um Modelle in einem Konto zu vergleichen, beginnen Sie mit GlobalGPT und überprüfen Sie das ausgewählte Modell und die angezeigten Nutzungsbedingungen.