
Claude Fable 5.2 vs. Opus 5.5: Programmierung, Kosten und Auswahl
Fünf Aufgaben mit identischen Prompts vergleichen Claude Fable 5.2 und Opus 5.5 in Recherche, KI-Interface-Design, Schreiben, Daten und Produktplanung, mit Original-Screenshots und aufgezeichneter Zeit- und Token-Nutzung.
 Chloe Murphy

Opus 5.5 ist der sinnvolle Ausgangspunkt für Routinearbeit; testen Sie Fable 5.2, wenn eine bestimmte Aufgabe noch verbessert werden muss. In unseren vier abgeschlossenen Textaufgaben-Paaren haben beide Modelle die zentrale Forschungsberechnung und die Datenkennzahlen korrekt gelöst. Fables Produktplan ging mit einer Unsicherheit sorgfältiger um; beide Schreibergebnisse erfüllten die wichtigsten Vorgaben.
Der Designvergleich verwendet einen neuen, abgestimmten Lauf mit 32.768 Token. Screenshots, Interaktionsprüfungen und Einschränkungen finden sich in der Designaufgabe unten.
Fable 5.2 ist neuer und kostet mehr pro Token. Aber liefert es ein besseres Ergebnis – oder einfach nur eine höhere Rechnung? Wir haben Recherche, KI-Interface-Design, Schreiben, Datenanalyse und Produktentscheidungen mit demselben Aufgabenbriefing für jedes Modell verglichen.
Wenn Sie Modelle lieber vergleichen möchten, ohne separate API-Setups zu verwalten, bietet GlobalGPT einen Multi-Modell-Arbeitsbereich. Die API-Tests hier belegen nicht, dass Fable 5.2 in GlobalGPT verfügbar ist.
Der praktische Vergleich
| Entscheidung | Fable 5.2 | Opus 5.5 |
|---|---|---|
| Standard-Eingabe / -Ausgabe pro Million Token | $8 / $40 | $4 / $20 |
| Forschungstest | Korrekte Berechnung; kausale Formulierung muss überarbeitet werden | Korrekte Berechnung; nicht belegtes Detail des Studiendesigns |
| Inhaltstest | 180-Wörter-Erklärung; kürzerer Voiceover | 180-Wörter-Erklärung; ausführlicheres Beispiel |
| Datentest | Alle angeforderten Metriken korrekt | Alle angeforderten Metriken korrekt |
| Produkttest | Sorgfältige Unterscheidung zwischen bestätigtem und möglichem Schaden | Nützlicher Plan; unbelegte Behauptung über verlorene Arbeit |
| Ursprünglicher Designversuch | Kein Artefakt: HTTP-Fehler | Vollständiges HTML nach Bereinigung der Codeblöcke |
Wie wir die beiden Modelle getestet haben
Jede Aufgabe verwendete identisches Quellmaterial, eine neue Konversation und dasselbe Ausgabelimit für beide Modelle. Die Textaufgaben verwendeten ein Limit von 16.000 Token; der finale Designlauf verwendete 32.768. Prompts, Einstellungen, Zeit und Nutzung erscheinen bei der entsprechenden Aufgabe unten.
Alle Studien, Produkte, Bestelldaten und Rückmeldungen in den Briefings waren fiktive Test-Fixtures. Wir haben die Berechnungen anhand eines vorbereiteten Lösungsschlüssels überprüft. Die Reasoning-Anstrengung blieb auf dem Plattformstandard, daher ist dies kein Benchmark mit gleichem Aufwand. Die vom Drittanbieter-Gateway zurückgegebenen Modellbezeichnungen belegen nicht unabhängig das Upstream-Routing.
Forscher: Synthese ohne Überbewertung der Evidenz
Gleicher Prompt · Forscher-Test
You are a researcher. Use only these FICTIONAL study summaries about an AI writing assistant. A: randomized 120 adults, 60 per arm, intervention mean score baseline70 followup78, control baseline69 followup74, four weeks; no standard deviations, uncertainty intervals, or attrition information reported. B: observational 300 adults, usage correlated with writing scores r=.32, no confounder adjustment. C: interviews with12 users reporting perceived improvement. In under650 words synthesize evidence with A/B/C citations, calculate difference in changes, explain what cannot be inferred, and propose a feasible preregistered followup study with primary endpoint and analysis. Do not invent citations or statistical significance.
Die Forscheraufgabe verlangte eine Synthese von drei fiktiven Studien, einschließlich einer randomisierten Studie mit unvollständiger Berichterstattung. Die wesentliche Berechnung war (78 − 70) − (74 − 69) = 3 Punkte. Beide Modelle haben es richtig gemacht und sich geweigert, statistische Signifikanz zu erfinden.
Fable 5.2
Schlug eine verblindete, unassistierte Schreibbewertung, eine Intention-to-treat-Analyse und Sensitivitätsprüfungen für fehlende Daten vor. Außerdem lieferte es ein ausdrücklich hypothetisches Beispiel für die Stichprobengröße.
„Nur der 3-Punkte-Unterschied ist auf den Assistenten zurückzuführen“
Diese Formulierung war angesichts unbekannter Abbrecherquoten und Berichtslücken zu zuversichtlich, auch wenn spätere Absätze die Schätzung einschränkten. Es spekulierte auch, dass die Interviewteilnehmer wahrscheinlich selbstselektiert waren.
Opus 5.5
Trennte randomisierte, beobachtende und Interview-Evidenz klar. Es schlug eine baseline-adjustierte Studie vor und ließ die Stichprobengrößenberechnung von der Pilotvariabilität abhängen.
„wie beschrieben querschnittlicher Natur“
Die gelieferte Beobachtungszusammenfassung spezifizierte kein Querschnittsdesign. Dieses Detail hätte unbekannt bleiben sollen.
Wenn Sie dieses Briefing anpassen, halten Sie die Evidenz fest und bitten Sie jedes Modell, berichtete Fakten von Schlussfolgerungen zu trennen. Unsere Claude-Prompts für Forschung und Programmierung bieten weitere Beispiele für aufgabenspezifische Einschränkungen.
Designer: ein KI-Multimodell-Arbeitsbereich
Gleicher Prompt · Designer-Test
You are a product designer and frontend builder. Return only one complete self-contained HTML file with inline CSS and JavaScript, no external assets/CDNs. Build a polished AI multi-model workspace called Parallel. Give it a distinctive cohesive visual identity with excellent typography, whitespace, hierarchy and responsive layout; choose your own palette. Include sidebar, model A/B selectors, prompt textarea, compare button, two side-by-side result cards, loading state, clear button, per-result copy button, empty-input validation, keyboard-accessible controls and mobile stacking. Models A/B are FICTIONAL; all outputs must be locally simulated and explicitly labeled demo. No real API calls or fake live performance metrics. Compare must work repeatedly and preserve the submitted prompt in both outputs. Copy must report success only after actual success, otherwise provide an error. Aim for a complete compact artifact, not an explanation.
Das Designer-Briefing forderte beide Modelle auf, Parallel: ein eigenständiger KI-Vergleichsarbeitsbereich mit Seitenleiste, Modellauswahl, Prompt-Eingabe, simulierten Ergebniskarten, Validierung, Kopiersteuerungen und einem mobilen Layout. Wir haben die Farbpalette und visuelle Identität offen gelassen.
Der endgültige übereinstimmende Lauf verwendete denselben Prompt, Streaming-Transport und eine gemeinsame Obergrenze von 32.768 Token. Beide Antworten erreichten einen normalen Stopp. Die Quellartefakte bleiben unbearbeitet; beim Speichern von HTML wird nur ein umschließender Markdown-Zaun entfernt, falls vorhanden.
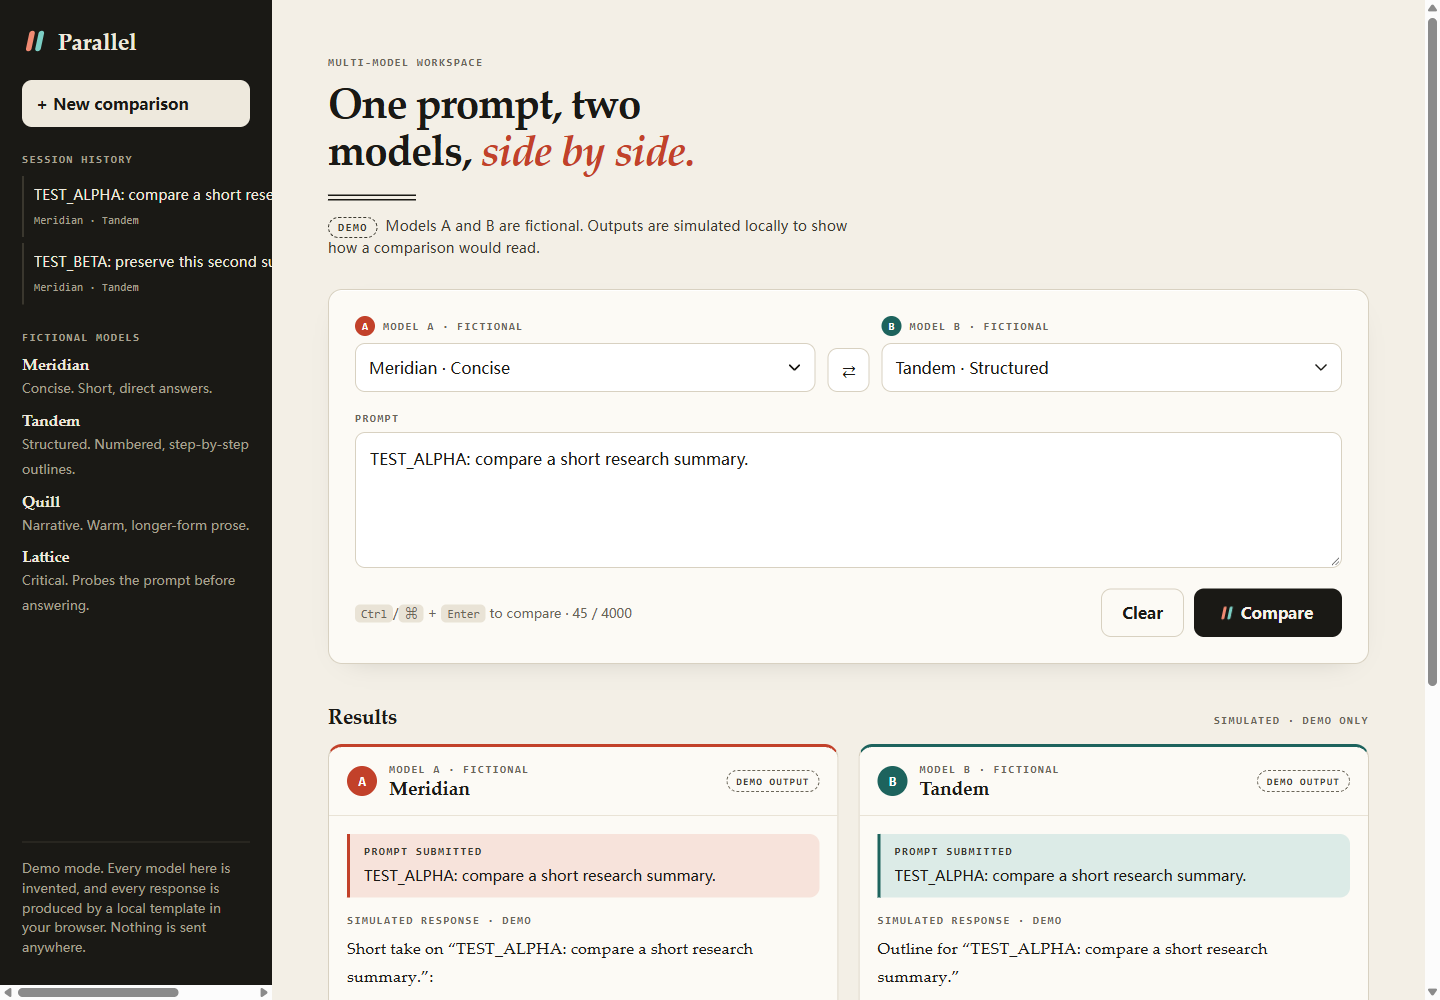
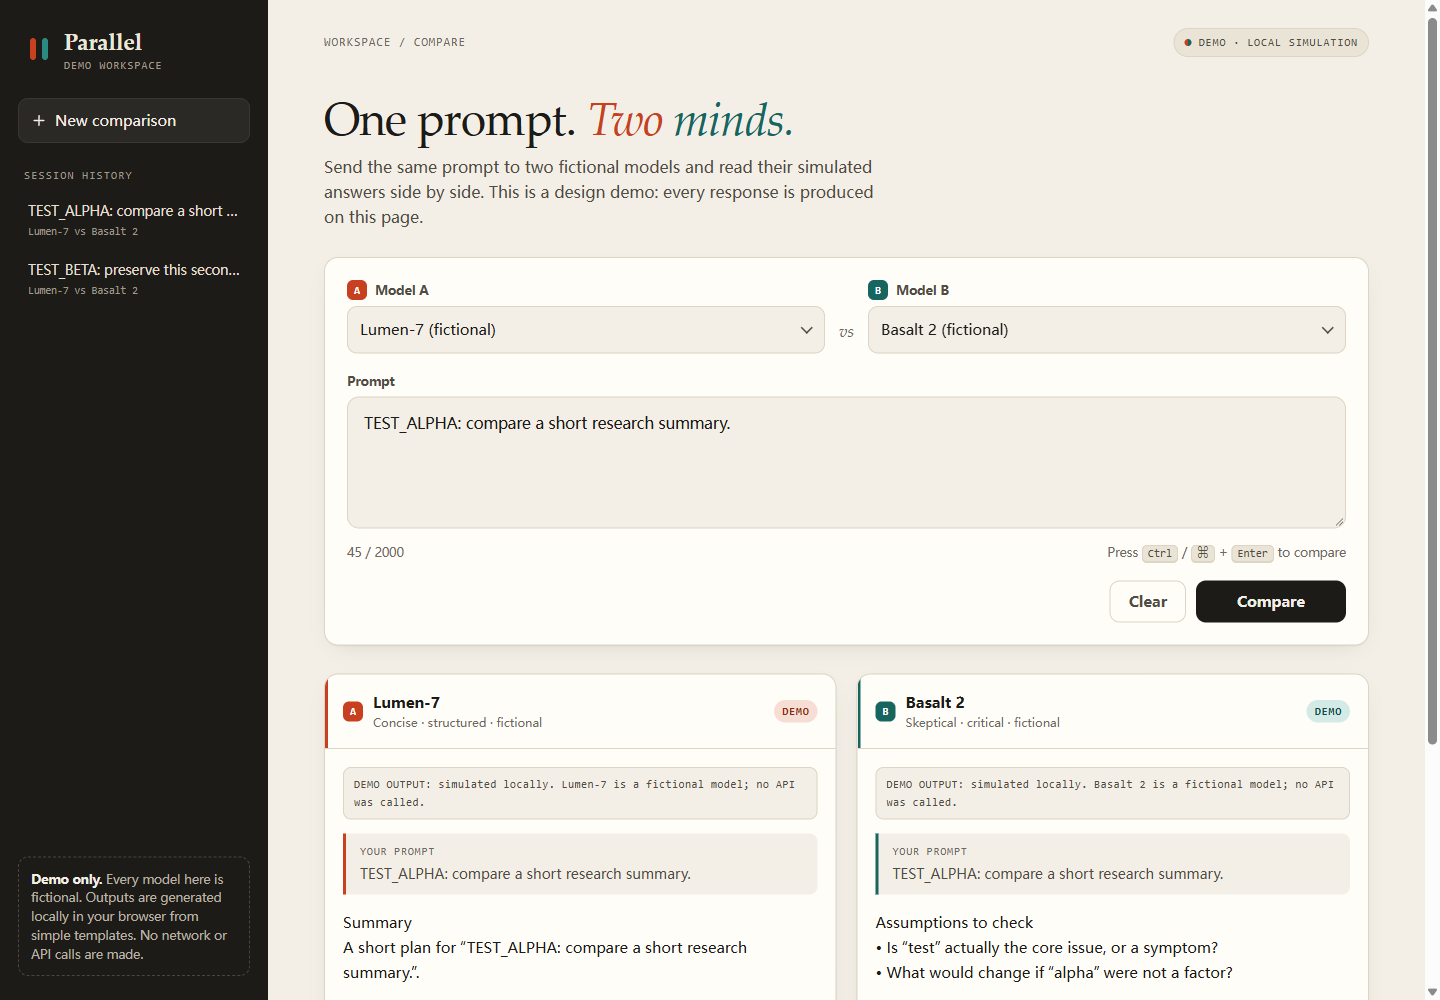
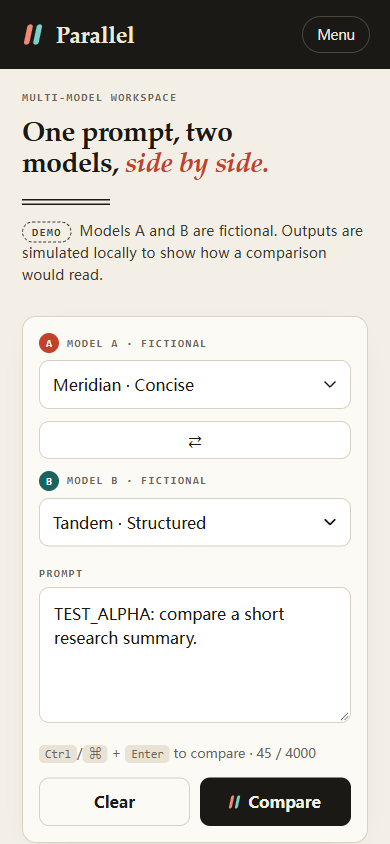
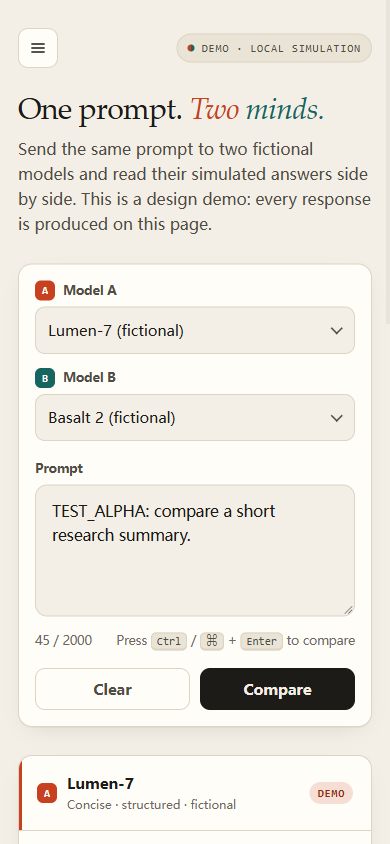
Wie die gerenderten Seiten tatsächlich aussahen
Fable 5.2 Beispiel
Eine schwerere Serifen-Überschrift, kursive rote Hervorhebung und eine kontrastreiche Seitenleiste verleihen dieser Seite eine stärkere redaktionelle Identität. Das Modellwechsel-Steuerelement ist eine nützliche Ergänzung, nimmt aber auf Mobilgeräten eine ganze Zeile ein und schiebt Eingabeaufforderung und Ergebnisse weiter nach unten.
Opus 5.5 Beispiel
Die leichtere Überschrift und der einfachere Modellauswahlbereich wirken zurückhaltender. Bei gleichem mobilen Viewport endet die Schaltfläche „Vergleichen“ etwa 710 Pixel von oben, gegenüber 826 Pixeln im Fable-Beispiel, sodass Platz bleibt, damit die erste Ergebniskarte früher erscheint.
Beide wählten warme Papiertöne, dunkle Seitenleisten und Serifen-Überschriften. Der Unterschied liegt hier in Hierarchie und Dichte, nicht in einer völlig anderen Designsprache.Für diesen speziellen Arbeitsbereich bevorzugen wir das kompakte Layout des Opus-Beispiels.Wenn die Priorität auf einer markanteren redaktionellen Überschrift liegt, hat das Fable-Beispiel diesen Reiz. Dies ist eine subjektive Präferenz zwischen diesen zurückgegebenen Artefakten, kein allgemeines ästhetisches Ranking der zugrunde liegenden Modelle.
Browser-Prüfungen: Aussehen und Verhalten getrennt
| Prüfen | Fable-Beispiel | Opus-Beispiel |
|---|---|---|
| Validierung bei leerer Eingabe | Bestanden | Bestanden |
| Wiederholte Vergleiche behalten die eingegebene Eingabeaufforderung bei | Bestanden | Bestanden |
| Sichtbares Ladefeedback | Bestanden | Bestanden |
| Eingabe löschen | Bestanden | Bestanden |
| Seitenüberlauf bei 390 Pixel Breite | Keine gemessen | Keine gemessen |
| Kopierfehler meldet einen Fehler ehrlich | Bestanden | Bestanden |
| Erfolgreiches Kopieren in die Zwischenablage | Nicht verifiziert | Nicht verifiziert |
Wir öffneten die unbearbeiteten Ausgaben in Chrome und verwendeten DOM-Steuerelemente, um die Prüfungen durchzuführen. Desktop-Screenshots verwenden 1440 × 1000; mobile Screenshots verwenden 390 × 844. Alle vier zeigen denselben eingereichten Prompt nach dem Vergleich und vor der Kopierprüfung. Während dieser Schritte wurden keine Laufzeitausnahmen erfasst. Schreibvorgänge in die Zwischenablage waren in der automatisierten Sitzung nicht erfolgreich, und eine vollständige reine Tastaturnavigation wurde nicht getestet.
Die Nutzung des endgültigen Designpaars ergibt einen Proxy zum Standardtarif von $0.8826 für Fable und $0.2918 für Opus. Dies verwendet Anbieterraten und vom Gateway gemeldete Token, schließt frühere Versuche aus und ist nicht die tatsächliche Rechnung des Gateways.
Frühere Versuche und Beleggrenzen
Content-Ersteller: präziser Text in zwei Formaten
Gleicher Prompt · Content-Ersteller-Test
You are a content creator. Based ONLY on these FICTIONAL product facts, write a180-word plain-English explainer and a45-second video script with timestamps, then a five-item fact-check checklist. Facts: Lumen is a fictional AI workspace; it lets users compare two AI text drafts side by side, save prompts locally in their browser, and manually copy a chosen result. It does not publish content automatically, browse the web, or verify facts. No prices, launch dates, speed metrics, supported model names, or privacy guarantees are provided. Audience: freelancers who struggle to choose a usable first draft. Explain a practical example, avoid hype and invented claims, and distinguish local prompt saving from an unproven no-training guarantee.
Das Kreativ-Briefing lieferte einen fiktiven Arbeitsbereich mit nur drei Funktionen: nebeneinanderliegender Entwurfsvergleich, lokales Speichern von Prompts und manuelles Kopieren. Es verlangte einen 180-Wörter-Erklärtext, ein 45-Sekunden-Skript und eine Checkliste zur Faktenprüfung mit fünf Punkten.
Beide Erklärtexte erfüllten die 180-Wörter-Anforderunggemäß unserer Wortzählregel, die interne Apostrophe und Bindestriche innerhalb eines Wortes beibehält. Beide behielten die Funktionsbeschränkungen bei und vermieden korrekt, lokale Speicherung als Garantie für kein Training zu behandeln.
Fable 5.2
Begann mit der Schwierigkeit des Freiberuflers, einen Entwurf auszuwählen, und erklärte dann die drei Funktionen in kurzen Sätzen. Der Voiceover des Videos enthielt 101 Wörter: etwa 135 Wörter pro Minute, wenn in 45 Sekunden geliefert.
Opus 5.5
Verwendete ein detaillierteres Texter-Beispiel, das einen stärkeren Einstieg mit klareren Funktionserklärungen kontrastiert. Sein Voiceover enthielt 109 Wörter: etwa 145 Wörter pro Minute über denselben Zeitraum.
Diese Temposchätzungen stammen aus dem geschriebenen Voiceover, nicht aus einer zeitgesteuerten Aufnahme. Fable lässt mehr Raum für Pausen; Opus nutzt mehr von der Zeit, um das Beispiel zu erklären.
Für längere Artikel finden Sie in unserem Leitfaden Verwendung von Claude für das Schreiben langer Texte erfahren Sie, wie Sie das Entwerfen von der Überprüfung und Bearbeitung trennen.
Datenanalyst: Rückerstattungen, fehlende Zuordnung und ROAS
Gleicher Prompt · Datenanalyst-Test
You are a data analyst. Use only this synthetic data. Orders CSV(order_id,updated,status,channel,amount): o1,1,paid,Search,100; o2,1,paid,Social,80; o2,2,refunded,Social,80; o3,1,paid,Search,120; o4,1,pending,Email,60; o5,1,paid,,50; o6,1,paid,Partner,90; o7,1,paid,Email,70; o8,1,paid,Social,60; o9,1,paid,Partner,110. Channel spend/clicks: Search200/100; Social100/80; Email50/40; Partner0/20. Deduplicate by order_id keeping greatest updated. Paid orders count and revenue use latest paid only; refunded/pending contribute zero. Blank channel must remain Unknown and cannot inherit spend/clicks. Calculate overall paid count, revenue, each channel paid count/revenue/conversion rate per click/ROAS, and measurable ROAS ranking; zero or missing denominator is N/A. Show arithmetic and propose a cautious next-budget decision without inferring causality. Return table and explanation under600 words.
Die Analystenaufgabe wurde entwickelt, um Fehler zu erkennen, die eine ordentliche Tabelle verbergen kann: doppelte Bestell-IDs, eine spätere Rückerstattung, eine ausstehende Bestellung, einen unbekannten Kanal und einen Partnerkanal ohne Ausgaben.
Beide Modelle stimmten mit dem vorbereiteten Lösungsschlüssel überein: 7 bezahlte Bestellungen und 600 Umsatz nach Beibehaltung des neuesten Bestellstatus. Sie schlossen die erstatteten und ausstehenden Datensätze aus, behielten fehlende Zuordnung unter Unbekannt bei und markierten undefinierte Verhältnisse als N/A.
| Kanal | Bezahlte Bestellungen | Umsatz | Conversion / Klick | ROAS |
|---|---|---|---|---|
| Suche | 2 | 220 | 2.00% | 1.10 |
| Social | 1 | 60 | 1.25% | 0.60 |
| 1 | 70 | 2.50% | 1.40 | |
| Partner | 2 | 200 | 10.00% | N/A: keine Ausgaben |
| Unbekannt | 1 | 50 | N/A | N/A |
Fable zeigte die Umsatzarithmetik in der Kanaltabelle und schlug vor, vor größeren Änderungen die Rückerstattungen, ausstehenden Bestellungen, fehlenden Tags und nicht erfassten Partnerkosten zu prüfen. Opus fügte eine deduplizierte Tabelle auf Datensatzebene hinzu und berechnete, dass nicht zugeordneter Umsatz 8,3 % des Gesamtumsatzes ausmachte.
Beide empfahlen einen Test mit begrenztem Budget, anstatt den beobachteten ROAS als kausalen Beweis zu behandeln. Opus' Nebenbemerkung, dass ein zusätzlicher Social-Verkauf den ROAS ungefähr verdoppeln würde, setzt einen ähnlichen Bestellwert voraus; es handelte sich nicht um eine neue Tatsache in der Eingabe.
Produktmanager: Schaden vor Feature-Stimmen
Gleicher Prompt · Produktmanager-Test
You are a product manager for a FICTIONAL AI subscription workspace. Feedback: 2 users report duplicate charges after retrying checkout; billing logs confirm one duplicate captured charge. 30 users request dark mode. 8 report one model unavailable and no warning before using a prompt; outage reproduced. 1 requests account/data deletion; request pending for20 days, governing deadline unknown. 12 request reusable saved prompts. 4 want team seats; no revenue commitment. Two engineers available for one week; effort estimates unknown. Produce a one-week priority plan with rationale, explicit unknowns, scope boundaries, owner roles, acceptance criteria, instrumentation and rollback/containment steps. Do not fabricate legal deadlines, revenue, effort or certainty. Distinguish immediate containment from permanent fixes; do not rank purely by vote count. Under700 words.
Das Produktbriefing verband eine bestätigte doppelte Abbuchung mit einer überfälligen Löschanfrage des Nutzers, einem reproduzierten Modellausfall und weiteren beliebten Funktionsanfragen. Die Falle bestand darin, 30 Dark-Mode-Stimmen Vorrang vor nachgewiesenem Schaden zu geben.
Beide Modelle stellten Abrechnung, Lösch-Follow-up und Ausfall-Eindämmung vor den Funktionsaufbau. Keines von beiden erfand eine gesetzliche Frist für die Löschung. Beide wiesen Eigentümerrollen zu, trennten die sofortige Eindämmung von dauerhaften Korrekturen und schlugen Abnahmeprüfungen und Überwachung vor.
Fable 5.2
Spezifizierte Rückerstattungsabgleich, eine Korrektur zur Verhinderung wiederholter Abbuchungen und manuelle Ausfall-Eindämmung. Es behandelte möglichen Quotenverlust ausdrücklich als zu bestätigenden Punkt und kennzeichnete die Löschung als unumkehrbar.
Opus 5.5
Es wurde eine Warnung vor dem Absenden, die Beibehaltung von Eingabeaufforderungen und eine ausdrückliche Regel gegen das stillschweigende Wechseln von Modellen hinzugefügt. Die Priorisierungstabelle ließ sich schnell überfliegen.
Es hieß jedoch, dass Benutzer „Arbeit und Eingabeaufforderungen stillschweigend verlieren“. Das bereitgestellte Feedback belegte einen Ausfall und eine fehlende Warnung, nicht aber einen nachgewiesenen Verlust von Eingabeaufforderungen.
Preise für Fable 5.2 und Opus 5.5
Bei Standard-API-Anfragen kostet Fable 5.2 doppelt so viel pro Token wie Opus 5.5. Damit ist Opus der günstigere Einstiegspunkt, wenn beide Modelle bei ähnlichem Token-Verbrauch ein akzeptables Ergebnis liefern.
Eingabe / Ausgabe
Eingabe / Ausgabe
Dies sind die Standard-Eingabe-/Ausgaberaten von Anthropic, geprüft am 11. November 2026, aus derFable-Spezifikation.
Die Opus-Spezifikation listet den entsprechenden Standardtarif auf. Schnellmodus, Caching, Mengenrabatte, Verbraucherabonnements und Abrechnung durch Dritte haben unterschiedliche Bedingungen.
Für eine illustrative Anfrage mit 10.000 Eingabetokens und 5.000 Ausgabetokens beträgt die Standardtarifrechnung 0,28 $ für Fable und 0,14 $ für Opus. Dies ist ein Rechenbeispiel, keine Rechnung aus unseren Tests.
Ein höherer Token-Tarif bedeutet nicht höhere Kosten pro erfolgreicher Aufgabe. Eine kürzere Antwort, weniger Überarbeitungsrunden oder weniger Denkarbeit können die Gesamtkosten verändern. Unsere Ein-Runden-Tests können keine langfristigen Einsparungen belegen.
Wenn Sie eines der Modelle in eine App integrieren, Claude API-Einrichtungsleitfaden behandelt die Einrichtungsfragen getrennt vom Token-Tarifvergleich hier.
Die Multiplikation der vom Gateway gemeldeten Nutzung mit den Standardtarifen von Anthropic ergibt einen tarifbasierten Näherungswert von 0,4291 $ für Fable gegenüber 0,1799 $ für Opus über diese vier Aufgaben. Die Formel lautet Eingabetokens × Eingabetarif + Ausgabetokens × Ausgabetarif, geteilt durch eine Million. Dies schließt alle Designanfragen und fehlgeschlagenen Aufrufe aus.ratenbasierter Proxy von $0,4291 für Fable gegenüber $0,1799 für Opus über diese vier Aufgaben. Die Formel lautet Eingabetokens × Eingaberate + Ausgabetokens × Ausgaberate, geteilt durch eine Million. Dies schließt alle Designanfragen und fehlgeschlagenen Aufrufe aus.
Dieser Proxy ist nicht die tatsächliche Gebühr des Gateways. Wir haben seine Rechnung, die Äquivalenz der Token-Abrechnung oder den Aufschlag nicht überprüft. Es misst auch nicht die Kosten späterer menschlicher Bearbeitung oder zusätzlicher Versuche.
Was die offiziellen Benchmarks feststellen
Die Launch-Evaluierung von Anthropic gibt Fable bei mehreren schwierigen Aufgaben einen Vorteil. Die folgende Tabelle gibt drei gemeldete Punktzahlen wieder; dies sind Anbieterbewertungen, getrennt von unseren eigenen rollenbasierten Tests.
| Evaluierung | Fable 5.2 | Opus 5.5 |
|---|---|---|
| FrontierCode 2.0 | 49.1% | 45.5% |
| FrontierSWE v2 | 69.9% | 62.3% |
| Terminal-Bench-Science 0.1 | 74.6% | 58.7% |
Der Startbericht verwendet die höchste verfügbare Anstrengung jedes Modells, sofern nicht anders angegeben. Diese Ergebnisse sprechen dafür, Fable bei anspruchsvollen technischen Arbeiten auszuprobieren; sie begründen keinen allgemeinen Vorteil beim Schreiben, bei der Produktbeurteilung oder beim visuellen Geschmack.
Beide Modelle geben ein Kontextfenster von einer Million Token und ein Ausgabelimit von 128.000 Token an. Diese Grenzwerte wurden hier keinem Stresstest unterzogen.
Häufig gestellte Fragen
Ist Fable 5.2 besser als Opus 5.5 beim Programmieren?
Anthropic meldet höhere Fable-Ergebnisse bei mehreren schwierigen Programmierbewertungen. Unsere Programmierübung ist ein Einzeldatei-KI-Arbeitsbereich und kein Repository-Benchmark, daher kann sie keinen allgemeinen Gewinner beim Programmieren feststellen.
Kostet Fable 5.2 mehr?
Die Standard-API-Eingabe- und Ausgaberaten sind doppelt so hoch wie bei Opus 5.5: 8 $/40 $ gegenüber 4 $/20 $ pro Million Token. Die tatsächlichen Aufgabenkosten hängen auch von Nutzung, Reasoning, Wiederholungen, Caching und dem Dienst ab, der Ihnen die Rechnung stellt.
Wurden diese Tests innerhalb von GlobalGPT durchgeführt?
Nein. Sie verwendeten die benannten Modelle über ein API-Gateway eines Drittanbieters. Sie etablieren keine Modellverfügbarkeit, Abrechnung oder native Funktionen in GlobalGPT oder Claudes eigenen Apps.
Kann man einem der Modelle vertrauen, Forschungsergebnisse ohne Überprüfung zusammenzufassen?
Beide Forschungsantworten berechneten das Hauptergebnis korrekt, aber jede führte mindestens eine Schlussfolgerung ein, die bearbeitet werden musste. Überprüfen Sie jedes Detail des Studiendesigns und trennen Sie Schätzungen von Signifikanzbehauptungen.
Beweist eine besser aussehende generierte Seite eine bessere Programmierfähigkeit?
Nein. Visuelles Design, funktionierende Interaktionen, Barrierefreiheit und Wartbarkeit sind getrennte Dimensionen. Eine einzelne attraktive Seite kann keine Zuverlässigkeit der Codierung auf Repository-Ebene begründen.
Wurde den Modellen gleicher Denkaufwand eingeräumt?
Wir haben identische Eingaben und Ausgabelimits verwendet, wobei die Reasoning-Einstellungen auf dem Plattformstandard belassen wurden. Das Mapping des Gateways wurde nicht unabhängig verifiziert, daher handelt es sich hier nicht um einen Benchmark mit gleichem Aufwand.
Sollte ich meine gesamte Arbeit auf Fable 5.2 umstellen?
Verwenden Sie zuerst einen aufgabenspezifischen Abnahmetest. Beginnen Sie mit dem günstigeren Modell, das diesen erfüllt, und wechseln Sie dann zu Fable, wenn Sie eine lohnende Verbesserung feststellen können.
Endgültiges Urteil: Welches Modell sollten Sie verwenden?
Beginnen Sie mit Opus 5.5, wenn ein akzeptabler erster Entwurf das Ziel ist. Seine niedrigere Standard-Token-Rate macht es zur praktischen Grundlage für routinemäßiges Schreiben, Datenbereinigung und Planung. Weitere Informationen finden Sie in unseren Claude Opus 5.5 Testbericht.
Probieren Sie Fable 5.2, wenn eine bestimmte schwierige Aufgabe Ihre Abnahmekriterien immer noch nicht erfüllt. Behalten Sie dieselben Eingaben bei und prüfen Sie, ob der tatsächliche Fehler behoben wird. Die Anleitung zur Modellauswahl empfiehlt ebenfalls, mit dem neuesten Opus zu beginnen und zu eskalieren, wenn Opus mit höherem Aufwand nicht ausreicht.
Wenn keines der beiden Premium-Modelle erforderlich ist, Sonnet 5.5 vs Opus 5.5 ist der relevantere Kostenvergleich.
Für eine größere Auswahl an Anbietern siehe unsere KI-Textgenerator-Tests.
Für Repository-Arbeit ist die Ein-Datei-Demo dieser Überprüfung nur ein Ausgangspunkt. Sie testet keinen Shell-Zugriff, keine Bearbeitung mehrerer Dateien, keine lang laufende Tool-Nutzung und kein Wiederherstellungsverhalten eines Coding-Agenten. Einzelheiten zur Konfiguration finden Sie in unserem Leitfaden Auswahl eines Modells in Claude Code bevor Sie eine Chat-Vervollständigung als Ersatz für eine vollständige Entwicklungsumgebung behandeln.



