Claude-Modelle im Vergleich: Haiku vs. Sonnet vs. Opus – und wo Fable ins Bild passt
Ariette Wynn
Zuletzt aktualisiert am 09.09.2026
Ein praktischer Leitfaden für das Jahr 2026 zur Auswahl anhand von Geschwindigkeit, API-Kosten, Kontext, Komplexität der Aufgabe und den Kosten einer falschen Antwort.
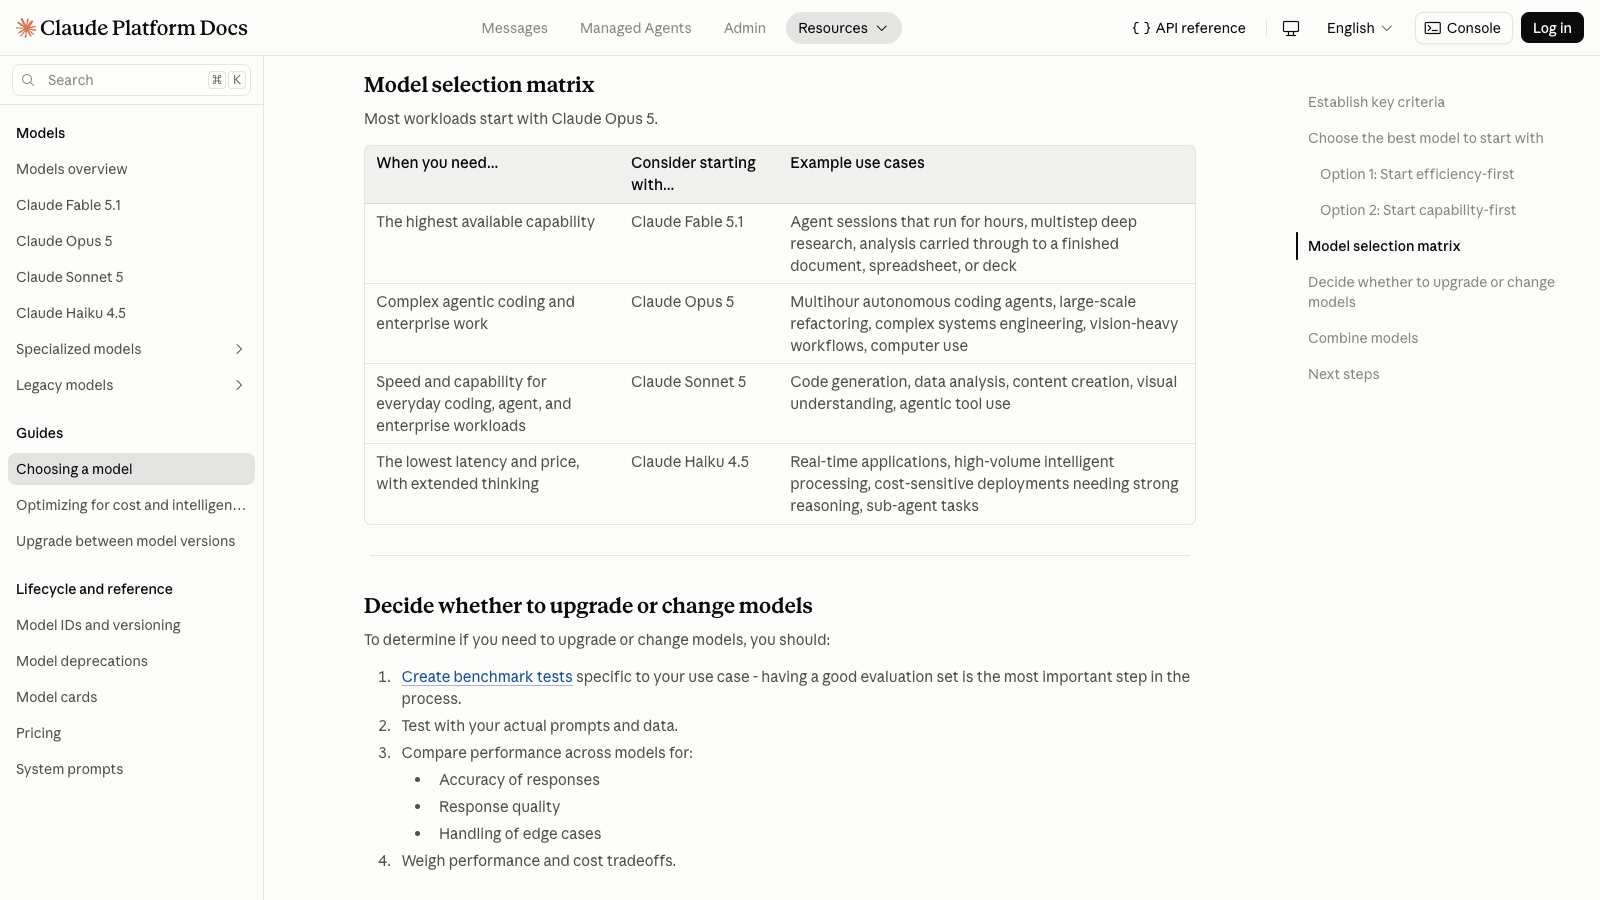
Für die meisten alltäglichen Aufgaben wie Schreiben, Analysieren, Programmieren und den Einsatz von Tools sollten Sie mit Claude Sonnet 5 beginnen. Wählen Sie Haiku 4.5, wenn geringe Latenz und hohes Durchsatzvolumen wichtiger sind als die Bewältigung schwieriger Randfälle. Entscheiden Sie sich für Opus 5, wenn die Aufgabe komplex, schwer zu überprüfen oder mit hohen Kosten bei Fehlern verbunden ist. Fable 5.1 steht über Opus als spezialisierter Eskalationspfad, nicht als Standard.
Diese Empfehlungen gelten für allgemeine gemischte Workloads. Laut den Produktionsrichtlinien von Anthropic sollten die meisten Workloads mit Opus 5 beginnen, während in der firmeneigenen Aufgabenmatrix Sonnet separat für alltägliche Aufgaben, bei denen es auf Geschwindigkeit und Leistungsfähigkeit ankommt, vorgesehen ist. Der richtige Ausgangspunkt hängt daher von Ihrer Risikobereitschaft und Ihrem Bewertungsprozess ab und nicht nur vom Modellnamen.
GlobalGPT sorgt für einen umfassenderen Arbeitsablauf Praktisch mit einem einzigen, erschwinglichen Abonnement: Claude, GPT-5.6 Sol, Gemini 3 Pro, Kimi K3 und zahlreiche KI-Funktionen nutzen ein gemeinsames Dashboard für Recherche, Texterstellung, Analyse, Programmierung und Optimierung. Über die Befehlszeilenschnittstelle (CLI) können Sie diesen Modellzugriff auch in Ihr Terminal, Ihren Entwicklungs-Workflow und Ihre bestehenden Produktionswerkzeuge integrieren. Der Vergleich von Ergebnissen ist ein nützlicher Bestandteil des Workflows; für eine umfassendere Auswahl auf Familienebene siehe unsere Vergleich zwischen ChatGPT, Claude und Gemini. Der Rest dieses Leitfadens konzentriert sich auf die Auswahl innerhalb von Claude.
Die vier derzeitigen Stufen lösen unterschiedliche wirtschaftliche Probleme. Der günstigste Anruf ist nicht immer die kostengünstigste erledigte Aufgabe, und das leistungsstärkste Modell ist nicht automatisch die beste Nutzung eines Budgets.
Entscheidungshilfe für das Modell Claude
Auswahl nach Arbeitsaufwand und Ausfallkosten
Nutzen Sie Sonnet für ausgewogene Alltagsaufgaben, wechseln Sie zu einer niedrigeren Stufe, wenn es auf Effizienz ankommt, und steigen Sie auf eine höhere Stufe um, wenn die Überprüfung schwierig ist oder Fehler hohe Kosten verursachen.
Haiku 4.5
Effizienz steht an erster Stelle
Beginnen Sie hier mit Aufgaben, die ein hohes Volumen aufweisen, latenzempfindlich sind, klar abgegrenzt sind und bei denen die Erkennung und Korrektur von Fehlern kostengünstig ist.
Weitergehen, wennRandfälle oder die Zeit, die Prüfer für Korrekturen benötigen, machen den Preisvorteil der Token zunichte.
Sonett 5
Ausgeglichenheit im Alltag
Verwendung für gemischte Schreibaufgaben, Analysen, Programmierung, visuelles Verständnis und den Einsatz von Werkzeugen, wobei die Arbeiten weiterhin wie gewohnt bewertet werden.
Weitergehen, wennDas Denken in langfristigen Perspektiven, die Verifizierung oder die Ausfallkosten werden zum begrenzenden Faktor.
Opus 5
Kompetenz steht an erster Stelle
Beginnen Sie hier, wenn es um komplexe agentische Programmierung, Unternehmensprojekte, schwierige Diagnosen oder Entscheidungen geht, deren Fehlentscheidungen hohe Kosten verursachen können.
Nach unten scrollen, wennEin kostengünstigeres Modell besteht wiederholt dieselben Abnahmeprüfungen.
Fable 5.1
Ausnahmepfad
Eskalieren Sie nur bei anspruchsvollen Schlussfolgerungen oder lang andauernden Agentenvorgängen, wenn selbst der aufwendigere Opus-Ansatz Ihre Bewertung nicht besteht.
Gehen Sie nicht davon aus, dassEine höhere Stufe ist automatisch günstiger, nachdem Qualität, Bearbeitungszeit und Wiederholungsversuche berücksichtigt wurden.
Die Faustregel
Legen Sie eine repräsentative Aufgabe und die zugehörigen Abnahmetests fest. Wählen Sie das kostengünstigste Modell aus, das die Tests zuverlässig besteht, und berechnen Sie dann den Zeitaufwand für Korrektur und Verifizierung, bevor Sie es als die günstigste Option bezeichnen.
Die aktuelle Claude-Modellreihe
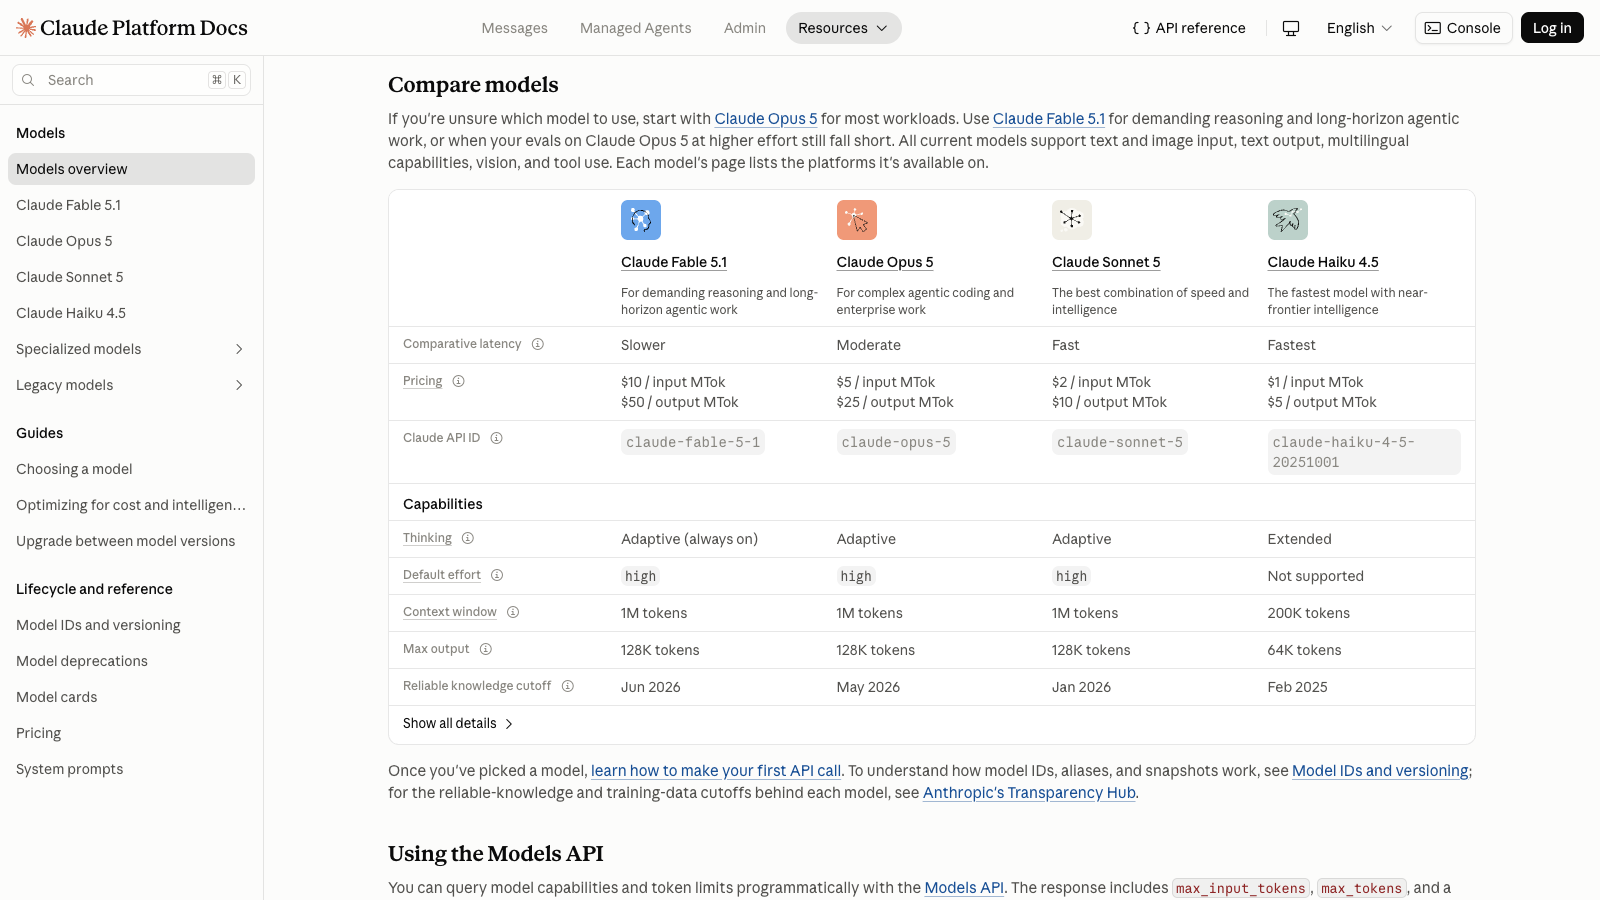
Stand 8. September 2026 umfasst die aktive Produktpalette von Anthropic die Modelle Claude Haiku 4.5, Claude Sonnet 5, Claude Opus 5 und Claude Fable 5.1. Haiku, Sonnet und Opus sind beständige Produktfamilienbezeichnungen, doch die jeweils zugehörige Version ändert sich im Laufe der Zeit. Verweisen Sie auf die genaue Modell-ID, die Sie in der Produktion evaluiert haben, anstatt davon auszugehen, dass eine Produktfamilienbezeichnung immer auf denselben Snapshot verweist.
Aktuelles Modell
Offizielle Geschwindigkeitsangabe
API-Kontext
Maximale Leistung
Basis-API-Eingabe/Ausgabe
Haiku 4.5
Schnellste
200.000
64K
$1 / $5 pro MTok
Sonett 5
Schnell
1M
128 KB
$2 / $10 pro MTok
Opus 5
Mäßig
1M
128 KB
$5 / $25 pro MTok
Fable 5.1
Langsamer
1M
128 KB
$10 / $50 pro MTok
In der Modellübersicht von Anthropic sind Haiku 4.5, Sonnet 5, Opus 5 und Fable 5.1 als aktuelle Produktpalette zum 8. September 2026 aufgeführt.
Der Zugriff auf Claude.ai ist nicht mit den API-Spezifikationen identisch.
Die Claude.ai-Tariftabelle beschreibt den Zugang für Privatkunden und listet derzeit ein Kontextfenster von 200.000 für einzelne Tarife auf. Die API-Dokumentation enthält modellspezifische Kontext- und Ausgabebeschränkungen, darunter ein Kontext von 1 Million für Sonnet 5, Opus 5 und Fable 5.1. Verwenden Sie die API-Tabelle nicht, um Rückschlüsse darauf zu ziehen, was ein bestimmter Claude.ai-Plan beinhaltet, und verwenden Sie die Verbrauchertabelle nicht, um Rückschlüsse auf die Grenzen eines API-Modells zu ziehen. Siehe die Claude – Preis- und Tarifübersicht für die Unterscheidung auf Planungsebene.
Claude Haiku vs. Sonnet vs. Opus: Die wichtigsten Unterschiede
Der wichtigste Kompromiss lässt sich nicht einfach anhand einer Qualitätsrangliste darstellen. Je höher man in der Liste aufsteigt, desto mehr Funktionen stehen für komplexe Aufgaben zur Verfügung, allerdings steigen dadurch auch die Grundkosten in Token und die Geschwindigkeit nimmt in der Regel ab. Auch die Kontextbeschränkungen und die Steuerungsmöglichkeiten für das logische Schlussfolgern unterscheiden sich.
Die praktischen Abwägungen
Offizielle Bezeichnungen und grundlegende API-Spezifikationen, ergänzt durch praktische Anhaltspunkte für gängige Workloads.
Dimension
Haiku 4.5
Sonett 5
Opus 5
Der beste Ausgangspunkt
Schnelle, wiederholte, begrenzte Arbeit
Vielfältige Wissensarbeit im Alltag
Komplexe Arbeit mit weitreichenden Folgen
Offizielle Geschwindigkeitsangabe
Schnellste
Schnell
Mäßig
API-Kontext / Ausgabe
200K / 64K
1 Mio. / 128 K
1 Mio. / 128 K
Kontrolle der Schlussfolgerungen
Manuelles erweitertes Denken
Flexibles Denken und Engagement
Flexibles Denken und Engagement
Grundpreis der API
$1-Eingang / $5-Ausgang
$2 Eingang / $10 Ausgang
$5 Eingang / $25 Ausgang
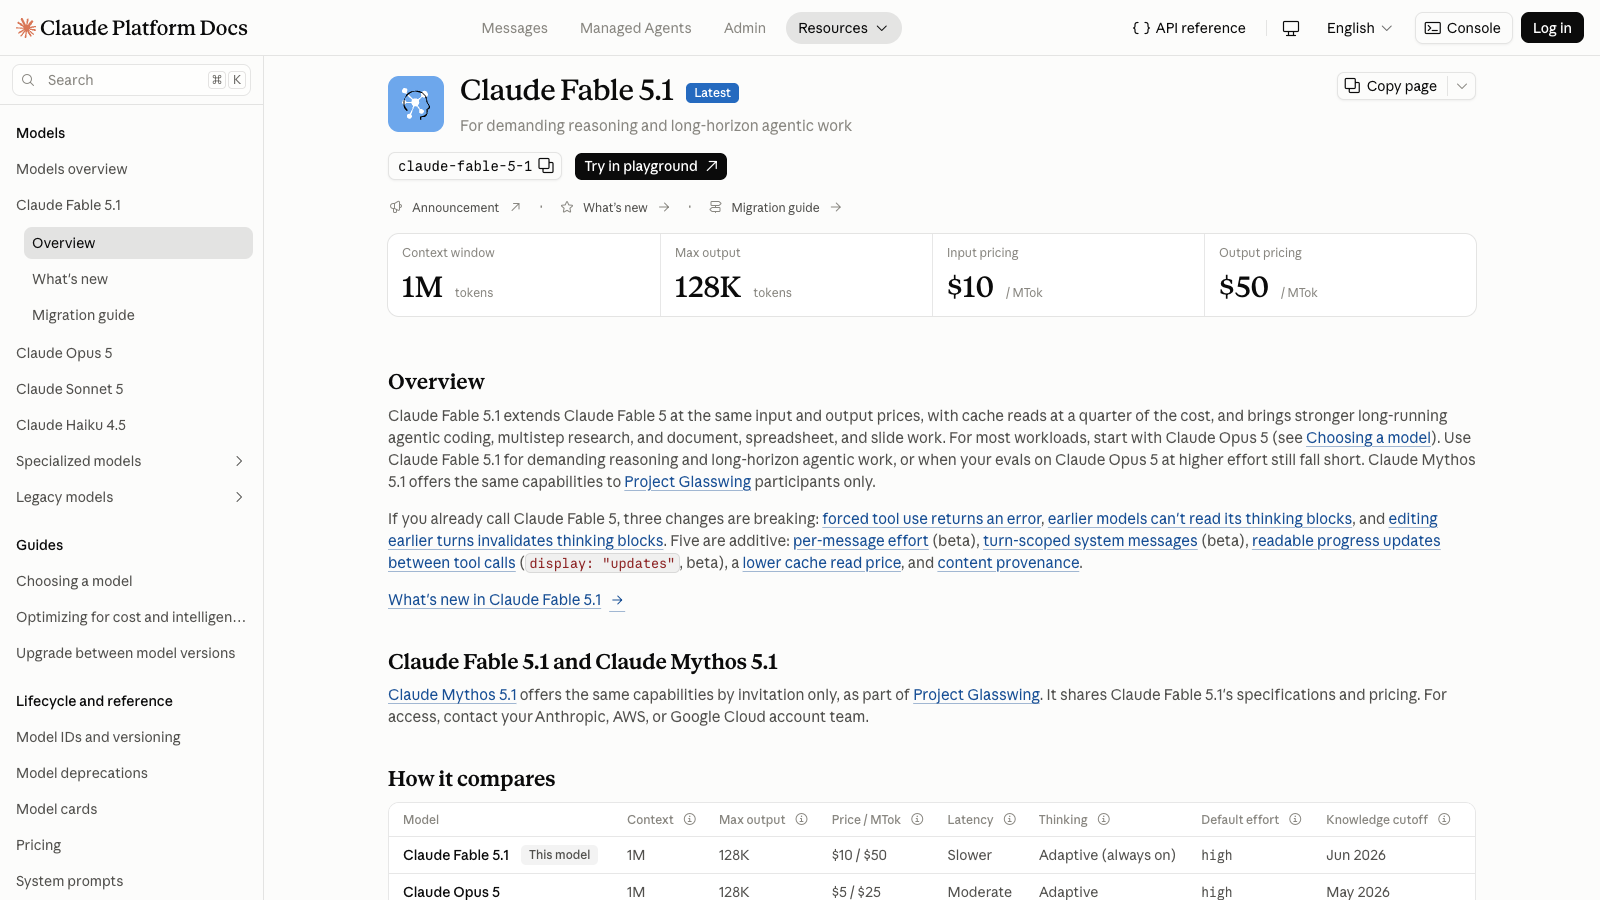
Wo „Fable“ hineinpasst: Fable 5.1 wird offiziell als „Slower“ bezeichnet, mit einem Kontext von 1 Mio., einer maximalen Ausgabe von 128K und Basispreisen für Ein- und Ausgabe gemäß $10 / $50 pro Million Token. Betrachten Sie diese Option als nächste Stufe, wenn Opus trotz höherem Aufwand Ihre Anforderungen nicht erfüllt.
Geschwindigkeit und Latenzzeit
Anthropic wird als “am schnellsten”, Sonnet 5 als “schnell”, Opus 5 als “mittel” und Fable 5.1 als “langsamer” eingestuft. Hierbei handelt es sich um qualitative Produktbezeichnungen, nicht um gemessene Millisekunden oder Tokens pro Sekunde. Die tatsächliche Latenz hängt von der Anfragegröße, den Einstellungen für die Schlussfolgerungen, den verwendeten Tools, der Auslastung und dem Auslieferungsmodus ab.
Steuerelemente für Kontext, Ausgabe und Argumentation
Der kleinere API-Kontext von Haiku (200K) und die maximale Ausgabe von 64K sind für viele begrenzte Aufgaben immer noch beträchtlich. Sonnet und Opus erweitern beide Grenzwerte auf 1 Mio. und 128 KB. Haiku 4.5 nutzt manuelles erweitertes Denken, während Sonnet 5 und Opus 5 adaptives Denken und Aufwandssteuerung unterstützen. Dieser Unterschied ist ein Grund dafür, dass eine einzige identische Einstellung für das Schlussfolgern keine vollkommen gleichwertigen Tests für alle Modelle erzeugen kann.
Welches Claude-Modell sollten Sie für die jeweilige Aufgabe verwenden?
Arbeitsbelastung
Beginnen Sie mit
Warum
Upgrade wenn
Klassifizierung, Entnahme, Weiterleitung, Triage
Haiku 4.5
Eine geringe Latenz und niedrige Grundkosten für Token eignen sich für klare, wiederholbare Aufgaben.
Ausnahmesituationen oder Korrekturzeiten machen die Einsparungen zunichte.
Schreiben, Analyse, visuelles Verständnis, Programmieren im Alltag
Sonett 5
Ausgewogenes Verhältnis von Geschwindigkeit, Leistungsfähigkeit, Kontext und Kosten für gemischte Arbeitsformen.
Das Denken oder die Überprüfung mit langfristigem Horizont wird zum Engpass.
Die Leistungsfähigkeit ist wichtiger als der niedrigste Preis pro Token.
Das aufwendigere Opus scheitert weiterhin an einer anspruchsvollen repräsentativen Bewertung.
Außergewöhnlich langwierige oder kognitiv anspruchsvolle Arbeit
Fable 5.1
Es handelt sich um den aktuellen Eskalationspfad oberhalb von Opus.
Nur dann einsetzen, wenn der gemessene Nutzen die höheren Kosten rechtfertigt.
Dies sind Ausgangspunkte, keine allgemeingültigen Lösungen. So kann beispielsweise eine kurze, aber wichtige Codeänderung den Einsatz von Opus rechtfertigen, während ein langer, aber stark strukturierter Extraktionsauftrag möglicherweise dennoch besser zu Haiku passt. Praktische Beispiele für Arbeitsabläufe finden Sie in unserem Leitfaden zu unter Verwendung von Claude zur Codierung.
Wenn Ihre Auswahlliste über Claude hinausgeht, können Sie mit GlobalGPT dieselbe repräsentative Eingabe in einem Arbeitsbereich für Claude, GPT-5.6 Sol, Gemini 3 Pro und Kimi K3 ausführen. Halten Sie die Akzeptanzprüfung konstant: Bei wiederholten Aufgaben kommt es auf die Geschwindigkeit an, während die Antwortqualität und die Korrekturzeit darüber entscheiden, ob ein kostengünstigeres Ergebnis tatsächlich billiger ist.
Entscheiden Sie sich anhand der Ausfallkosten, nicht nur anhand der Art der Aufgabe
Aufgabenbezeichnungen verschleiern die wichtigste Variable: Was passiert, wenn die Antwort falsch ist? Das untenstehende Rahmenwerk ist ein Instrument zur redaktionellen Entscheidungsfindung, das auf den Leitlinien von Anthropic basiert, bei denen Effizienz und Kompetenz an erster Stelle stehen. Es handelt sich dabei nicht um einen Anthropic-Benchmark.
Ausfallkosten-Leiter
Beginnen Sie mit einem niedrigeren Wert, wenn Fehler kostengünstig behoben werden können; beginnen Sie mit einem höheren Wert, wenn die Überprüfung unvollständig oder kostspielig ist.
Günstig
Beispiele Kennzeichnung, Weiterleitung, Bereinigung von Entwürfen, reversible Zusammenfassungen
Start Haiku 4.5
Eskalieren Wenn durch Korrekturen der Effizienzgewinn zunichte gemacht wird
Material
Beispiele Entwürfe für Kunden, geprüfte Analysen, getesteter Produktionscode
Start Sonett 5
Eskalieren Wenn durch eine Überprüfung wichtige Fehler nicht zuverlässig erkannt werden können
Teuer
Beispiele Veränderungen mit hoher Autonomie, schwierige Diagnosen, weitreichende Entscheidungen
Start Opus 5
Eskalieren Erst dann zu „Fable“, wenn „Opus“ nach einem höheren Aufwand eine „Frozen“-Bewertung verfehlt
Wann Sie Ihr Claude-Modell aufrüsten oder herunterstufen sollten
Erst dann weitergehen, wenn ein festgelegter Grenzwert erreicht ist
Vom Haiku zum Sonett
Führen Sie ein Upgrade durch, wenn Sonderfälle, Befehlsausfälle oder der Zeitaufwand für Korrekturen durch Prüfer die Einsparungen übersteigen.
Sonett an Opus
Führen Sie ein Upgrade durch, wenn die Ausführung über einen langen Zeitraum, komplexe Schlussfolgerungen, Verifizierung oder Ausfallkosten zur Einschränkung werden.
Opus bei höherem Kraftaufwand
Testen Sie die anspruchsvolle Arbeitslast mit „Frozen Acceptance Checks“, bevor Sie zur obersten Ebene übergehen.
Opus zu Fable
Eskalieren Sie erst dann, wenn Opus trotz des höheren Aufwands die repräsentative Bewertung immer noch nicht besteht und der Nutzen die Kosten rechtfertigt.
Regel zur Herabstufung: Wechseln Sie wieder zu einem günstigeren Modell, wenn dieses wiederholt dieselben Abnahmetests mit der erforderlichen Latenz und Zuverlässigkeit besteht.
Die Matrix von Anthropic ordnet vier aktuelle Claude-Modelle unterschiedlichen Anforderungen hinsichtlich Leistungsfähigkeit, Geschwindigkeit und Arbeitslast zu.
Ein Beispiel für feste Claude-API-Kosten
Bei einer festen Gesamtlast von 1 Million Eingabe-Tokens plus 100.000 Ausgabe-Tokens über mehrere Standard-API-Anfragen hinweg liegen die Basis-Token-Kosten zwischen $1,50 bei Haiku 4.5 und $15,00 bei Fable 5.1. Es handelt sich hierbei nicht um eine einzelne Anfrage, und die Ausgabebegrenzungen pro Anfrage werden dadurch nicht außer Kraft gesetzt.
Eine Arbeitslast, vier Claude-Modelle
Das gleiche Token-Volumen kostet das 2-Fache, 5-Fache oder 10-Fache des Haiku-Gesamtbetrags, je nachdem, wie man in den aktuellen Stufen aufsteigt.
Arbeitsbelastung 1,0 Mio. Eingänge + 0,1 Mio. Ausgänge über mehrere Anfragen hinweg
Haiku 4.5
$1.50
Sonett 5
$3.00
Opus 5
$7.50
Fable 5.1
$15.00
Modell
Berechnung der Eingabewerte
Leistungsberechnung
Insgesamt
Haiku 4.5
1,0 × $1
0,1 × $5
$1.50
Sonett 5
1,0 x $2
0,1 × $10
$3.00
Opus 5
1,0 × $5
0,1 × $25
$7.50
Fable 5.1
1,0 × $10
0,1 × $50
$15.00
Im Lieferumfang enthalten: Standard-Eingangs- und Ausgangs-Token-Kurse aus einer Anthropic-Preis Momentaufnahme.
Die Preistabelle gibt Auskunft über die Kosten für die Token, nicht über die Kosten für ein fertiges Ergebnis. Ein günstigeres Modell kann unter Umständen teurer werden, wenn Wiederholungsversuche, Korrekturen und Überprüfungen mehr Personalzeit in Anspruch nehmen als die durch die Token erzielten Einsparungen.
Praxistest mit dem Modell Claude: Gleiche Eingabeaufforderungen, unterschiedliche Fehlermodi
Am 9. September 2026 haben wir dieselben drei Eingabeaufforderungen über die Anywhere-API an Claude Haiku 4.5, Sonnet 5, Opus 5 und Fable 5.1 gesendet. Die Aufgaben umfassten die strukturierte Support-Triage, evidenzbasiertes Schreiben und überprüfbares JavaScript-Debugging. Wir haben jeweils die erste gültige Ausgabe jedes Modells beibehalten und diese anhand von Regeln bewertet, die vor der Überprüfung der Antworten festgelegt worden waren.
Das Ergebnis war keine einfache Rangliste. Sonnet, Opus und Fable erreichten jeweils 26,5 von 30 Punkten, wobei sich ihre Stärken und Schwächen deutlich voneinander unterschieden. Haiku gab bei beiden zulässigen Versuchen für jede Aufgabe einen HTTP-503-Fehler zurück, sodass die Qualität seiner Ausgabe in diesem Test unbekannt bleibt.
Versuchsaufbau und Gesamtergebnis
Drei festgelegte Eingabeaufforderungen, dieselben Token-Beschränkungen auf Aufgabenebene, keine Hilfsmittel und keine Suchfunktion sowie die Beibehaltung der ersten gültigen Ausgabe für jedes Modell.
Regel für erneuten VersuchEinmal beim Transport, 429/5xx, leerer Inhalt oder fehlerhafte Antwort
Modell
Erledigte Aufgaben
Gesamtqualitätsbewertung
Das nützlichste Signal
Claude Haiku 4.5
0/3
Nicht gewertet
Alle sechs zulässigen Anfragen lieferten den Status 503; nur Routenverfügbarkeit.
Claude Sonett 5
3/3
26.5/30
Das einzige Modell, das alle Anforderungen der Einführungsnotiz erfüllt.
Claude Opus 5
3/3
26.5/30
Umfassende Debugging-Tiefe; eine Beschränkung hinsichtlich der Schreiblänge wurde übersehen.
Claude Fable 5.1
3/3
26.5/30
Saubere, strukturierte Ausgaben; die Startmeldung wurde nach einer leeren Antwort abgeschnitten.
Strukturierte Ausgabe
Test 1: Triage von Support-Tickets
Aufgabenergebnis: Fable 5.1, 10/10
„Fable“ war das einzige Modell, das direkt auswertbares JSON mit allen sechs korrekten Bezeichnungen und Aktionen zurückgab. „Opus“ und „Sonnet“ gaben die Bezeichnungen zwar korrekt wieder, fügten jedoch Markdown-Fences hinzu; beide verlängerten zudem eine vorgegebene Frist, und „Sonnet“ versprach voreilig eine Korrektur oder Rückerstattung.
Modell
Status
Punktzahl
Latenz an jedem Ort
Gemeldete Token
Was ist passiert?
Claude Haiku 4.5
Route nicht verfügbar
Nicht gewertet
Nicht verfügbar
Nicht verfügbar
Zwei 503-Antworten; kein Qualitätsfaktor.
Claude Sonett 5
Ausgabe beibehalten
7.5/10
10,39 s
1005
Die Bezeichnungen sind korrekt, aber das JSON ist „eingeschränkt“ und das Ergebnis bezüglich Rückerstattung/Korrektur ist frei erfunden.
Claude Opus 5
Ausgabe beibehalten
8.5/10
11,87 s
1051
Korrekte Bezeichnungen und entschlossene Maßnahmen, aber eingeschränkter JSON-Umfang und eine verkürzte Frist.
Claude Fable 5.1
Ausgabe beibehalten
10/10
8,55 s
680
Direkt auswertbares JSON; alle „frozen“-Prüfungen bestanden.
Vollständige Testdaten
Sie verwalten einen SaaS-Support-Posteingang. Klassifizieren Sie jedes der unten aufgeführten Tickets. Geben Sie JSON nur mit einem Feld der obersten Ebene namens „tickets“ zurück. „tickets“ muss ein Array in der ursprünglichen Reihenfolge sein, und jeder Eintrag muss genau die Felder „ticket_id“, „category“, „urgency“ und „action“ enthalten. „category“ muss einer der Werte „billing“, „access“, „bug“ oder „feature“ sein. „urgency“ muss einer der Werte „low“, „medium“ oder „high“ sein. Verwenden Sie ausschließlich den Tickettext; erfinden Sie keine Richtlinienergebnisse oder Kundenangaben.

#481: Uns wurde dieselbe jährliche Verlängerung zweimal in Rechnung gestellt. Die Gehaltsabrechnung wird am Freitag abgeschlossen, und ich benötige bis dahin eine Klärung dieser Angelegenheit.
#482: Bei der Passwortzurücksetzung wird angezeigt, dass die E-Mail versendet wurde, aber es ist nichts angekommen. Ich habe den Spam-Ordner überprüft und es einmal erneut versucht.
#483: Bei CSV-Exporten werden alle Währungsbeträge auf ganze Dollar gerundet, während im Dashboard weiterhin Centbeträge angezeigt werden.
#484: Bitte fügen Sie dem Analyse-Dashboard einen Dunkelmodus hinzu.
#485: Nachdem sich unsere Unternehmensdomain heute Morgen geändert hat, erhält jeder Mitarbeiter die Meldung „SSO-Zugriff verweigert“.
#486: Könnten Sie mir bitte eine Kopie der Rechnung vom letzten Monat zusenden?
Claude Haiku 4.5: Gesamtergebnis aus der laufenden Geschäftstätigkeit
Es wurden keine Modellausgaben generiert. Beide zulässigen Anywhere-API-Versuche lieferten den HTTP-Status 503, sodass diese Route als nicht verfügbar markiert und aus der Qualitätsbewertung ausgeschlossen wurde.
Claude Sonnet 5: volle Leistung
```json
{
  "tickets": [
    {
 "ticket_id": "#481",
      "category": "Abrechnung",
 "urgency": "hoch",
 "action": "Die doppelte Gebühr für die jährliche Verlängerung prüfen und eine Korrektur/Rückerstattung vornehmen, bevor die Gehaltsabrechnung des Kunden am Freitag abgeschlossen wird."
    },
    {
 "ticket_id": "#482",
      "category": "access",
 "urgency": "medium",
 "action": "Die E-Mail-Adresse des Kontos und die Zustellbarkeit von E-Mails überprüfen und anschließend die E-Mail zum Zurücksetzen des Passworts manuell auslösen oder erneut versenden."
    },
    {
 "ticket_id": "#483",
      "category": "bug",
 "urgency": "medium",
 "action": "An die Technik eskalieren, um die Rundung beim CSV-Export zu beheben, damit die Währungswerte mit der auf dem Dashboard angezeigten Genauigkeit auf Cent-Ebene übereinstimmen."
    },
    {
 "ticket_id": "#484",
 "category": "feature",
 "urgency": "low",
 "action": "Die Anfrage zum Dunkelmodus für das Analyse-Dashboard protokollieren und in den Produkt-Feature-Backlog aufnehmen."
    },
    {
 "ticket_id": "#485",
      "category": "access",
 "urgency": "high",
 "action": "Die SSO-Konfiguration im Zusammenhang mit der geänderten Unternehmensdomain unverzüglich untersuchen und den Zugriff für alle betroffenen Mitarbeiter wiederherstellen."
    },
    {
      "ticket_id": "#486",
 "category": "Abrechnung",
 "urgency": "niedrig",
 "action": "Die Rechnung des letzten Monats ausfindig machen und eine Kopie an den Kunden senden."
    }
  ]
}
```
Claude Opus 5: volle Leistung
```json
{
  "tickets": [
    {
 "ticket_id": "481",
 "category": "Abrechnung",
 "urgency": "hoch",
 "action": "An die Abrechnungsabteilung eskalieren, um die doppelte jährliche Verlängerungsgebühr zu überprüfen und die Lösung vor dem Abschluss der Gehaltsabrechnung des Kunden am Freitag zu bestätigen."
    },
    {
 "ticket_id": "482",
      "category": "access",
 "urgency": "medium",
 "action": "Die E-Mail-Zustellungsprotokolle auf die Rücksetznachricht an diese Adresse überprüfen und, falls diese nicht zugestellt wurde, einen verifizierten Rücksetzvorgang für den Benutzer auslösen."
    },
    {
 "ticket_id": "483",
      "category": "bug",
 "urgency": "medium",
 "action": "Einen Fehlerbericht zur Währungsrundung beim CSV-Export erstellen, dabei auf die Abweichung von den Dashboard-Werten hinweisen und Schritte zur Reproduktion oder einen Beispiel-Export anfordern."
    },
    {
 "ticket_id": "484",
 "category": "feature",
 "urgency": "low",
 "action": "Als Feature-Anfrage für den Dark-Mode im Analyse-Dashboard protokollieren und den Eingang bestätigen, ohne einen Zeitplan zuzusagen."
    },
    {
 "ticket_id": "485",
      "category": "access",
 "urgency": "high",
 "action": "Als organisationsweiten SSO-Ausfall im Zusammenhang mit der Domain-Änderung eskalieren; die SSO-Domain-Konfiguration unverzüglich von der Identitäts-/Authentifizierungsabteilung überprüfen lassen."
    },
    {
      "ticket_id": "486",
 "category": "Abrechnung",
 "urgency": "niedrig",
 "action": "Die angeforderte Kopie der Rechnung des Vormonats an den verifizierten Ansprechpartner des Kontos senden."
    }
  ]
}
```
Claude Fable 5.1: volle Leistung
{"tickets":[{"ticket_id":"481","category":"Abrechnung","urgency":"hoch","action":"Die gemeldete doppelte jährliche Verlängerungsgebühr untersuchen und vor Ablauf der Gehaltsabrechnungsfrist des Kunden am Freitag antworten."},{"ticket_id":"482","category":"access","urgency":"medium","action":"Überprüfe die Zustellungsprotokolle für E-Mails zur Passwortzurücksetzung für die Adresse des Benutzers und sende die E-Mail erneut oder biete einen alternativen Weg zur Passwortzurücksetzung an."},{"ticket_id":"483","category":"Fehler","urgency":"mittel","action":"Die Rundung von Währungsbeträgen auf ganze Dollar beim CSV-Export reproduzieren und zur Behebung an die Entwicklung eskalieren."},{"ticket_id":"484","category":"Funktion","Dringlichkeit":"niedrig","Maßnahme":"Die Anfrage zum Dunkelmodus für das Analyse-Dashboard beim Produktteam protokollieren und den Eingang bestätigen."},{"ticket_id":"485","Kategorie":"Zugriff","Dringlichkeit":"hoch","Maßnahme":"Die unternehmensweiten SSO-Zugriffsverweigerungsfehler nach der Domain-Änderung eskalieren und die SSO-Domain-Konfiguration überprüfen."},{"ticket_id":"486","Kategorie":"Abrechnung","Dringlichkeit":"niedrig","Maßnahme":"Eine Kopie der Rechnung des letzten Monats ausfindig machen und an den Kunden senden."}]}
„First-Valid-Output“-Richtlinie. Die Latenz entspricht der Echtzeit-Dauer über Anywhere, nicht der nativen Anthropic-Latenz. Die Token-Zahlen werden vom Anbieter gemeldet; aus dieser Route lassen sich keine direkten API-Kosten ableiten.
Einhaltung von Einschränkungen
Test 2: Evidenzbasierte Einführungsnotiz
Aufgabenergebnis: Sonnet 5, 10/10
Sonnet war das einzige Modell, das alle festgelegten Anforderungen erfüllte. Opus lieferte eine aussagekräftige Rückmeldung, überschritt jedoch die Zeichenbegrenzung und ging davon aus, dass alle Nicht-Antwortenden eingeschriebene Studierende seien. Die erste Antwort von Fable war leer; bei dem zulässigen Wiederholungsversuch wurde eine sichtbar gekürzte Rückmeldung ohne Empfehlung oder Vorbehalt ausgegeben.
Modell
Status
Punktzahl
Latenz an jedem Ort
Gemeldete Token
Was ist passiert?
Claude Haiku 4.5
Route nicht verfügbar
Nicht gewertet
Nicht verfügbar
Nicht verfügbar
Zwei 503-Antworten; kein Qualitätsfaktor.
Claude Sonett 5
Ausgabe beibehalten
10/10
9,94 s
796
Die Anforderungen hinsichtlich Wortumfang, Struktur, Belegung, Empfehlung und Vorbehalt wurden erfüllt.
Claude Opus 5
Ausgabe beibehalten
8/10
9,49 s
826
Eine fundierte Analyse, allerdings 223 Wörter zu wenig nach der „Frozen-Count“-Methode und eine unbegründete Schlussfolgerung.
Claude Fable 5.1
Ausgabe beibehalten
6.5/10
19,27 s
1685
Erste Antwort leer; der gespeicherte Wiederholungsversuch wurde vor der Empfehlung und dem Hinweis abgeschnitten.
Vollständige Testdaten
Verfassen Sie eine interne Einführungsnotiz mit einer Länge von 180 bis 220 Wörtern für einen Produktleiter, wobei Sie ausschließlich die unten aufgeführten Fakten verwenden. Die Notiz muss Folgendes enthalten: eine Betreffzeile, einen kurzen einleitenden Absatz, genau drei Aufzählungspunkte, eine Empfehlung und einen klar gekennzeichneten Vorbehalt. Erfinden Sie keine Budgetbeschlüsse, Prozentsätze, statistische Signifikanz oder kausale Zusammenhänge.

Fakten:
- An dem Pilotprojekt nahmen 120 Schüler teil.
- Zum Stichtag am 31. März hatten 96 Schüler mindestens drei Sitzungen besucht.
- Die Umfrage ergab bei 71 Befragten einen Durchschnittswert von 4,3 von 5 Punkten.
- Im Programmablaufblatt ist ein Budget von $18.000 aufgeführt.
- In der Genehmigungsnotiz der Finanzabteilung ist $20.000 angegeben. Es wird nicht erwähnt, ob es sich bei der Differenz um eine Korrektur oder einen Erfassungsfehler handelt.
- Die Teilnehmer wurden nicht nach dem Zufallsprinzip zugewiesen, und es wurden keine Ausgangswerte erhoben.
- Es geht um die Entscheidung, ob ein zweites Pilotprojekt gestartet werden soll, nicht darum, ob das Programm dauerhaft eingeführt werden soll.
Claude Haiku 4.5: Gesamtergebnis aus der laufenden Geschäftstätigkeit
Es wurden keine Modellausgaben generiert. Beide zulässigen Anywhere-API-Versuche lieferten den HTTP-Status 503, sodass diese Route als nicht verfügbar markiert und aus der Qualitätsbewertung ausgeschlossen wurde.
Claude Sonnet 5: volle Leistung
**Betreff: Ergebnisse des Pilotprogramms – Empfehlung zur Durchführung eines zweiten Pilotprojekts**

Das erste Pilotprojekt hat seine erste Kontrollphase abgeschlossen, und die ersten Indikatoren zur Beteiligung und Zufriedenheit sind vielversprechend. Bevor wir uns auf ein zweites Pilotprojekt festlegen, gibt es einige Datenpunkte und offene Punkte, die das Team gemeinsam prüfen sollte.

- Von den 120 eingeschriebenen Studierenden hatten bis zum Zwischenstand am 31. März 96 mindestens drei Sitzungen besucht.
- Eine von 71 Befragten ausgefüllte Umfrage nach den Sitzungen ergab eine durchschnittliche Bewertung von 4,3 von 5 Punkten.
- Die Budgetzahlen weichen in den verschiedenen Dokumenten voneinander ab: Im Programmablaufblatt ist $18.000 angegeben, während in der Genehmigungsnotiz der Finanzabteilung $20.000 steht; es ist unklar, ob es sich hierbei um eine Korrektur oder einen Erfassungsfehler handelt.

**Empfehlung:** Angesichts der Anwesenheits- und Umfrageergebnisse empfehlen wir, ein zweites Pilotprojekt durchzuführen, um strukturiertere Daten zu erheben – idealerweise mit einer definierten Vergleichsgruppe und einer Basismessung –, bevor eine Entscheidung über eine breitere Einführung getroffen wird. Dieses zweite Pilotprojekt sollte auch als Gelegenheit dienen, die Budgetabweichung mit der Finanzabteilung abzustimmen, bevor die Mittel endgültig bewilligt werden.

**Einschränkung:** Diese Ergebnisse sollten mit Vorsicht interpretiert werden. Die Teilnehmer wurden nicht nach dem Zufallsprinzip ausgewählt, und es wurden keine Ausgangswerte erhoben, sodass wir die Umfrageergebnisse oder Teilnahmemuster nicht dem Programm selbst zuschreiben können. Es handelt sich hierbei um eine Entscheidung zum Umfang eines zweiten Pilotprojekts, nicht um eine Entscheidung über eine dauerhafte Umsetzung.
Claude Opus 5: volle Leistung
**Betreff: Ergebnisse des Pilotprojekts und Empfehlung zur Durchführung einer zweiten Pilotkohorte**

Das erste Pilotprojekt hat seinen Zwischenstand zum 31. März erreicht, und wir verfügen nun über genügend Informationen, um zu entscheiden, ob ein zweites Pilotprojekt durchgeführt werden soll. Diese Mitteilung fasst zusammen, was wir beobachtet haben, was wir empfehlen und welche wesentlichen Einschränkungen bei der Interpretation zu beachten sind. Eine Entscheidung über eine dauerhafte Einführung steht zum jetzigen Zeitpunkt noch nicht zur Debatte.

- **Teilnahme und Engagement:** 120 Studierende haben sich angemeldet. Zum Stichtag 31. März hatten 96 von ihnen an mindestens drei Sitzungen teilgenommen.
- **Feedback der Teilnehmer:** Die Umfrage nach der Teilnahme ergab bei 71 Befragten eine durchschnittliche Bewertung von 4,3 von 5 Punkten. Die übrigen angemeldeten Studierenden haben nicht geantwortet, sodass die Bewertung nur diese Untergruppe widerspiegelt.
- **Budgetabweichung:** Im Programmablaufblatt ist ein Budget von $18.000 aufgeführt, während in der Genehmigungsnotiz der Finanzabteilung $20.000 angegeben ist. In der Finanzgenehmigungsnotiz wird nicht angegeben, ob die Differenz auf eine Korrektur oder einen Erfassungsfehler zurückzuführen ist, und wir haben noch nicht geklärt, welcher Betrag maßgeblich ist.

**Empfehlung:** Die Planung eines zweiten Pilotprojekts sollte fortgesetzt werden, unter der Voraussetzung, dass die Finanzabteilung und die Programmverwaltung die beiden Budgetzahlen abgleichen und einen einzigen maßgeblichen Betrag bestätigen, bevor wir Mittel bereitstellen. Bei einem zweiten Pilotprojekt sollten zudem Ausgangswerte bei der Aufnahme erhoben werden.

**EINSCHRÄNKUNG:** Die Teilnehmer wurden nicht nach dem Zufallsprinzip zugewiesen, und es wurden keine Ausgangswerte erhoben. Die Zahlen zur Beteiligung und aus den Umfragen beschreiben daher lediglich, was diese Gruppe getan und berichtet hat; sie geben keinen Aufschluss darüber, welche Auswirkungen das Programm hatte oder wie es bei einer anderen Zielgruppe funktionieren würde.
Claude Fable 5.1: volle Leistung
**Betreff:** Zusammenfassung des Zwischenberichts zum Pilotprojekt und Empfehlung zur Durchführung eines zweiten Pilotprojekts

Hallo [Direktor],

im Folgenden finden Sie eine Zusammenfassung des aktuellen Stands des Pilotprojekts zum Stichtag 31. März sowie eine Empfehlung dazu, ob ein zweites Pilotprojekt durchgeführt werden soll. Diese Mitteilung bezieht sich ausschließlich auf die Entscheidung über ein zweites Pilotprojekt, nicht auf die dauerhafte Einführung.

- **Anmeldung und Teilnahme:** 120 Studierende haben sich angemeldet. Zum Stichtag 31. März hatten 96 von ihnen an mindestens drei Sitzungen teilgenommen.
- **Feedback der Teilnehmer:** Eine Umfrage ergab bei 71 Befragten eine Durchschnittsbewertung von 4,3 von 5 Punkten.
- **Budgetunterlagen:** Im Programmablaufblatt ist ein Budget von $18.000 aufgeführt, während in der Finanzgenehmigungsnotiz $20.000 angegeben ist. Aus der Finanznotiz geht nicht hervor, ob es sich bei der Differenz um eine Korrektur oder einen Erfassungsfehler handelt.

**
„First-Valid-Output“-Richtlinie. Die Latenz entspricht der Echtzeit-Dauer über Anywhere, nicht der nativen Anthropic-Latenz. Die Token-Zahlen werden vom Anbieter gemeldet; aus dieser Route lassen sich keine direkten API-Kosten ableiten.
Korrektheit des Codes
Test 3: Nachvollziehbares JavaScript-Debugging
Aufgabenergebnis: Opus 5 und Fable 5.1 haben gleichauf gelegen, 10/10
Alle drei verfügbaren Modelle haben sowohl Fehler gefunden als auch Ersatzlösungen generiert, die acht ausführbare Testfälle bestanden haben. Opus und Fable lieferten gültiges JSON und lagen mit 10/10 gleichauf. Der Code von Sonnet bestand den Test ebenfalls, doch die umgebenden Markdown-Begrenzungszeichen verstießen gegen die Anforderung, dass das JSON direkt im Code enthalten sein muss.
Modell
Status
Punktzahl
Latenz an jedem Ort
Gemeldete Token
Was ist passiert?
Claude Haiku 4.5
Route nicht verfügbar
Nicht gewertet
Nicht verfügbar
Nicht verfügbar
Zwei 503-Antworten; kein Qualitätsfaktor.
Claude Sonett 5
Ausgabe beibehalten
9/10
13,17 s
1471
Der Ersatz hat 8 von 8 Fällen bestanden; bei der „fenced“-Ausgabe ging der Punkt für das JSON-Format verloren.
Claude Opus 5
Ausgabe beibehalten
10/10
20,17 s
1826
Gültiges JSON, beide Fehler wurden identifiziert, und alle 8 ausführbaren Testfälle wurden bestanden.
Claude Fable 5.1
Ausgabe beibehalten
10/10
15,89 s
1409
Gültiges JSON, prägnante Diagnose und 8 von 8 Testfällen bestanden.
Vollständige Testdaten
Diagnostizieren und reparieren Sie diese JavaScript-Funktion. Geben Sie JSON mit genau vier Feldern zurück: root_cause (Zeichenkette), replacement (Zeichenkette, die die vollständige Ersatzfunktion enthält), tests (Array aus Testfall-Zeichenketten) und remaining_risk (Zeichenkette). Geben Sie nicht an, dass Sie Tests durchgeführt haben. Führen Sie die kleinste eindeutige Korrektur durch, die den Vertrag erfüllt.

Spezifikation:
- `tasks` ist ein Array aus Funktionen ohne Argumente, die Promises zurückgeben.
- Gib den ersten erfüllten Wert in der Reihenfolge der Eingabe zurück, auch wenn dieser Wert 0, `false` oder eine leere Zeichenkette ist.
- Ignoriere abgelehnte Aufgaben.
- Gib `null` zurück, wenn jede Aufgabe abgelehnt wird oder das Array leer ist.

Aktueller Code:
async function firstSuccessful(tasks) {
  const results = await Promise.all(tasks.map((task) => task()));
  return results.find(Boolean) || null;
}
Claude Haiku 4.5: Gesamtergebnis aus der laufenden Geschäftstätigkeit
Es wurden keine Modellausgaben generiert. Beide zulässigen Anywhere-API-Versuche lieferten den HTTP-Status 503, sodass diese Route als nicht verfügbar markiert und aus der Qualitätsbewertung ausgeschlossen wurde.
Claude Sonnet 5: volle Leistung
```json
{
  "root_cause": "Two bugs: (1) Promise.all rejects immediately if any task rejects, instead of ignoring rejected tasks; (2) results.find(Boolean) incorrectly treats falsy fulfilled values (0, false, '') as failures, causing them to be skipped in favor of null.",
  "replacement": "async function firstSuccessful(tasks) {\n  const settled = await Promise.allSettled(tasks.map((task) => task()));\n  const firstFulfilled = settled.find((r) => r.status === 'fulfilled');\n  return firstFulfilled ? firstFulfilled.value : null;\n}",
  "tests": [
    "test('returns null for empty array', async () => { expect(await firstSuccessful([])).toBeNull(); });",
    "test('returns null when all tasks reject', async () => { const tasks = [() => Promise.reject('err1'), () => Promise.reject('err2')]; expect(await firstSuccessful(tasks)).toBeNull(); });",
    "test('returns first fulfilled value even if falsy (0)', async () => { const tasks = [() => Promise.resolve(0), () => Promise.resolve(42)]; expect(await firstSuccessful(tasks)).toBe(0); });",
    "test('returns first fulfilled value even if false', async () => { const tasks = [() => Promise.resolve(false), () => Promise.resolve(true)]; expect(await firstSuccessful(tasks)).toBe(false); });",
    "test('returns first fulfilled value even if empty string', async () => { const tasks = [() => Promise.resolve(''), () => Promise.resolve('nonempty')]; expect(await firstSuccessful(tasks)).toBe(''); });",
    "test('ignores leading rejected tasks and returns first fulfilled in order', async () => { const tasks = [() => Promise.reject('err'), () => Promise.resolve('second'), () => Promise.resolve('third')]; expect(await firstSuccessful(tasks)).toBe('second'); });",
    "test('preserves input order even if later task resolves faster', async () => { const tasks = [() => new Promise((res) => setTimeout(() => res('slow-first'), 50)), () => new Promise((res) => setTimeout(() => res('fast-second'), 5))]; expect(await firstSuccessful(tasks)).toBe('slow-first'); });"
  ],
  "remaining_risk": "The fix assumes 'first fulfilled value in input order' means the first task by array index that fulfills, regardless of timing, which matches the contract wording but await Promise.allSettled waits for all tasks to complete (including slow ones) before returning, which may not be desired if early-exit performance is needed; also unhandled promise rejection warnings are avoided by allSettled, but if tasks throw synchronously instead of returning rejected promises, this is not explicitly tested here beyond the reject cases."
}
```
Claude Opus 5: volle Leistung
{
  "root_cause": "Two defects. (1) `Promise.all` rejects as soon as any task rejects, so a single rejected task makes the whole function reject instead of ignoring it and returning a later fulfilled value. (2) `results.find(Boolean) || null` selects by truthiness rather than by fulfillment, so legitimate fulfilled values such as 0, false, '', NaN, null, or undefined are skipped and/or coerced to null. Using `Promise.allSettled` plus a status check on the settled records fixes both, and returning `record.value` directly preserves falsy results.",
  "replacement": "async function firstSuccessful(tasks) {\n  const results = await Promise.allSettled(tasks.map((task) => task()));\n  const firstFulfilled = results.find((result) => result.status === 'fulfilled');\n  return firstFulfilled ? firstFulfilled.value : null;\n}",
  "tests": [
    "firstSuccessful([]) resolves to null (empty input).",
    "firstSuccessful([() => Promise.resolve('a'), () => Promise.resolve('b')]) resolves to 'a' (input order, not completion order).",
    "firstSuccessful([() => new Promise((res) => setTimeout(() => res('slow-first'), 50)), () => Promise.resolve('fast-second')]) resolves to 'slow-first' (order is by index, not by who settles first).",
    "firstSuccessful([() => Promise.reject(new Error('boom')), () => Promise.resolve('second')]) resolves to 'second' (rejection ignored, does not propagate).",
    "firstSuccessful([() => Promise.reject(new Error('a')), () => Promise.reject(new Error('b'))]) resolves to null (all reject).",
    "firstSuccessful([() => Promise.resolve(0)]) resolves to 0, not null (falsy number preserved).",
    "firstSuccessful([() => Promise.resolve(false)]) resolves to false (falsy boolean preserved).",
    "firstSuccessful([() => Promise.resolve('')]) resolves to '' (empty string preserved).",
    "firstSuccessful([() => Promise.resolve(undefined), () => Promise.resolve('later')]) resolves to undefined (first fulfilled wins even if its value is undefined).",
    "firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve(null), () => Promise.resolve('third')]) resolves to null because index 1 fulfilled with null — verifying null-as-value is not confused with the all-rejected sentinel by inspecting status.",
    "firstSuccessful([() => Promise.resolve(NaN)]) resolves to NaN (Number.isNaN on the result is true)."
  ],
  "remaining_risk": "The function still starts every task and awaits all of them, so there is no short-circuiting: a slow or never-settling later task delays or blocks the result, and side effects of later tasks always occur. A task that throws synchronously (rather than returning a rejected promise) will throw inside `tasks.map`, causing the returned promise to reject instead of being ignored; wrap the invocation in `Promise.resolve().then(task)` if that must also be tolerated. `null` is still returned both for all-rejected/empty input and when a task genuinely fulfills with `null`, so callers cannot distinguish those cases. Non-array or non-function inputs are not validated, and rejection reasons are discarded rather than aggregated (no AggregateError), which can hide diagnostics."
}
Claude Fable 5.1: volle Leistung
{"root_cause":"Two defects: (1) Promise.all rejects as soon as any task rejects, so rejected tasks are not ignored and the function throws instead of skipping them; (2) results.find(Boolean) skips legitimate falsy fulfilled values (0, false, '') and the trailing '|| null' also converts such values to null, violating the requirement to return the first fulfilled value even when it is falsy.","replacement":"async function firstSuccessful(tasks) {\n const results = await Promise.allSettled(tasks.map((task) => task()));\n const first = results.find((result) => result.status === 'fulfilled');\n return first ? first.value : null;\n}","tests":["firstSuccessful([]) resolves to null","firstSuccessful([() => Promise.resolve('a'), () => Promise.resolve('b')]) resolves to 'a'","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve('b')]) resolves to 'b' and does not throw","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.reject(new Error('y'))]) resolves to null","firstSuccessful([() => Promise.resolve(0), () => Promise.resolve(5)]) resolves to 0","firstSuccessful([() => Promise.resolve(false), () => Promise.resolve(true)]) resolves to false","firstSuccessful([() => Promise.resolve(''), () => Promise.resolve('z')]) resolves to ''","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve(null)]) resolves to null (fulfilled null is returned as-is)","firstSuccessful([() => new Promise(r => setTimeout(() => r('slow'), 50)), () => Promise.resolve('fast')]) resolves to 'slow' (input order wins over settlement order)"],"remaining_risk":"All tasks are started concurrently and the function waits for every task to settle before returning, so a slow task delays the result even when an earlier task has already fulfilled; a sequential or early-exit strategy would be needed if latency matters. A task that throws synchronously (rather than returning a rejected promise) will still cause the function to reject, since the contract assumes tasks return promises. Promise.allSettled requires ES2020 or a polyfill."}
„First-Valid-Output“-Richtlinie. Die Latenz entspricht der Echtzeit-Dauer über Anywhere, nicht der nativen Anthropic-Latenz. Die Token-Zahlen werden vom Anbieter gemeldet; aus dieser Route lassen sich keine direkten API-Kosten ableiten.
Diese „Anywhere“-Ergebnisse zeigen, warum die Modellauswahl sich an der jeweiligen Aufgabe orientieren sollte und nicht an einer einzelnen Rangliste. In GlobalGPT können Sie dieselbe Vergleichsmethode auf Ihre eigene Eingabeanweisung anwenden und diese mit Claude sowie anderen führenden Modellen vergleichen, um dann die Ausgabe auszuwählen, die Ihren Qualitätsansprüchen, Geschwindigkeitsanforderungen und Ihrem Überprüfungsaufwand am besten entspricht.
Wie lässt sich der Vergleich fair darstellen?
Eine repräsentative Aufgabe einfrieren. Verwenden Sie dieselben Absichts-, Quellmaterial-, Werkzeugzugriffs- und Zielakzeptanzprüfungen.
Zeichne die erste gültige Ausgabe auf. Gewähren Sie einem Modell im primären Vergleich nicht stillschweigend zusätzliche Wiederholungsversuche.
Trenne Qualität von Verfügbarkeit. Fehler bei der Authentifizierung, der Kapazität und der Route gehören in einen Verfügbarkeitshinweis und nicht in den Qualitätswert.
Messen Sie den gesamten Arbeitsablauf. Erfassen Sie die verstrichene Zeit, den Aufwand der Prüfer, die Korrekturzeit und die Zeit für die Behebung fehlgeschlagener Aufgaben.
Wählen Sie das kostengünstigste Passmodell aus. Führen Sie den Test erneut durch, wenn sich Anweisungen, Werkzeuge, Modellversionen oder Ausfallkosten ändern.
Wo GlobalGPT zum Einsatz kommt
Anthropic setzt Fable 5.1 für anspruchsvolle Aufgaben ein, wenn selbst die leistungsstärkeren Opus-5-Auswertungen noch nicht ausreichen.
Stand 8. September 2026 umfasst das aktuelle Produktangebot von Anthropic die Modelle Claude Haiku 4.5, Claude Sonnet 5, Claude Opus 5 und Claude Fable 5.1. Da sich die genauen Versionen und Modell-IDs ändern können, überprüfen Sie bitte vor der Bereitstellung noch einmal die offizielle Modellübersicht.
Was ist der Unterschied zwischen Claude Haiku, Sonnet und Opus?
Haiku legt den Schwerpunkt auf Geschwindigkeit und niedrige Basis-Token-Kosten, Sonnet bietet ein ausgewogenes Verhältnis zwischen Geschwindigkeit und Leistungsfähigkeit für alltägliche Aufgaben, und Opus konzentriert sich auf die Leistungsfähigkeit bei komplexen oder folgenreichen Aufgaben. Die richtige Wahl hängt von Ihrer Arbeitslast und den Verifikationskosten ab, nicht von einer absoluten Rangliste.
Welches Claude-Modell sollte ich für die meisten Aufgaben verwenden?
Beginnen Sie mit Sonnet 5 für die meisten alltäglichen Aufgaben wie Schreiben, Analysieren, Programmieren, visuelles Verständnis und den Umgang mit Werkzeugen. Greifen Sie stattdessen auf Opus 5 zurück, wenn Fehler kostspielig sind oder die Arbeit tiefgreifenderes logisches Denken und eine gründlichere Überprüfung erfordert.
Welches Claude-Modell eignet sich am besten zum Programmieren?
Sonnet 5 ist ein praktischer Ausgangspunkt für die alltägliche Codierung mit regulären Überprüfungen und Tests. Verwenden Sie Opus 5 für schwierige Diagnosen, komplexe agentenbasierte Codierung, Ausführung mit langem Zeithorizont oder Änderungen, deren Fehler hohe Kosten verursachen würden.
Welches Claude-Modell eignet sich am besten zum Schreiben?
Sonnet 5 ist der ausgewogene Ausgangspunkt für die meisten Entwurfs- und Bearbeitungsaufgaben. Haiku 4.5 eignet sich für umfangreiche, streng strukturierte Texte, während Opus 5 bei komplexen Zusammenfassungen oder wichtigen Texten, die schwer zu überprüfen sind, einen Versuch wert sein kann.
Ist Claude Sonnet besser als Opus?
Nicht in jedem Fall. Sonnet 5 ist bei den Basis-API-Tarifen schneller und günstiger, während Anthropic Opus 5 für komplexere Aufgaben prädestiniert. Das bessere Modell ist die kostengünstigste Option, die Ihre eigenen Abnahmetests zuverlässig besteht.
Ersetzt Claude Fable Opus?
Nr. Anthropic positioniert Fable 5.1 als Eskalationsstufe für anspruchsvolle Schlussfolgerungen oder lang andauernde Agentenarbeiten, wenn das aufwendigere Opus 5 noch nicht ausreicht – nicht als universeller Ersatz für Opus.
Haben Claude.ai und die Claude-API dasselbe Kontextfenster?
Die Planbeschränkungen und API-Modellspezifikationen für Claude.ai sind getrennt. In der individuellen Plantabelle für Anthropic ist derzeit ein Kontextfenster von 200.000 angegeben, während in der API-Dokumentation für Sonnet 5, Opus 5 und Fable 5.1 ein Kontext von 1 Mio. angegeben ist.
Wann sollte ich von Haiku auf Sonnet oder Opus umsteigen?
Führen Sie ein Upgrade durch, wenn fehlgeschlagene Akzeptanzprüfungen, schwierige Randfälle, der Korrekturaufwand, der Verifizierungsaufwand oder die Kosten eines Fehlers die Vorteile des langsameren Modells hinsichtlich Geschwindigkeit und Token-Preis überwiegen. Wechseln Sie wieder zu einem günstigeren Modell zurück, wenn dieses wiederholt dieselben festgelegten Prüfungen besteht.
Wie viel kosten Claude Haiku, Sonnet und Opus über die API?
Zu den am 8. September 2026 bestätigten Basissätzen von Anthropic kostet Haiku 4.5 $1 als Eingabe und $5 als Ausgabe, Sonnet 5 kostet $2 und $10, und „Opus 5“ kostet $5 und $25 pro Million Token. Siehe Anthropic’s offizielle Preisseite für aktuelle Tarife und weitere Preismodelle.
Fazit: Beginnen Sie mit dem günstigsten Modell, das die Anforderungen erfüllt
Für allgemeine gemischte Anwendungen bleibt Sonnet 5 die praktischste Standardwahl, und es war das einzige Modell, das in unserem Test alle Vorgaben hinsichtlich der Startnotizen erfüllte. Opus 5 und Fable 5.1 erreichten durch unterschiedliche Stärken die Gesamtpunktzahl von Sonnet (26,5/30), während Haiku 4.5 nicht bewertet werden konnte, da die „Anywhere“-Route bei jedem zulässigen Versuch den Fehlercode 503 zurückgab. Betrachten Sie diese Ergebnisse als Hinweise auf die Arbeitslast und nicht als endgültige, allgemeingültige Rangliste.
Ihr nächster Schritt ist ganz einfach: Legen Sie eine konkrete Aufgabe fest, definieren Sie, wie ein erfolgreiches Ergebnis aussieht, testen Sie jeden ernstzunehmenden Kandidaten unter vergleichbaren Bedingungen und beziehen Sie die Korrekturzeit in die Gesamtkosten ein. Das siegreiche Modell ist das kostengünstigste, das zuverlässig erfolgreich ist – nicht das mit der niedrigsten Token-Rate oder dem hochkarätigsten Namen.
GlobalGPT integriert diese Methode in einen umfassenderen, kostengünstigen KI-Workflow. Nutzen Sie Claude, GPT-5.6 Sol, Gemini 3 Pro, Kimi K3 und andere führende Modelle mit zahlreichen KI-Funktionen in einem einzigen Dashboard und übertragen Sie die Arbeit anschließend über die GlobalGPT-CLI auf Ihr Terminal, in Ihren Entwicklungs-Workflow und in Ihre bestehenden Produktionswerkzeuge. Side-by-Side-Tests helfen Ihnen bei der Auswahl; der größere Vorteil besteht darin, den gesamten Workflow miteinander zu verknüpfen.
Erfahren Sie, was das GPT-Schlüsselwort „AI Motion Designer for After Effects“ bedeutet und wie GLBGPT Yukie, den Video-Editor, Prompts, Effekte, Untertitel, Audio und generierte Clips nutzt.
Erfahren Sie, wie Sie KI-Blogbilder erstellen – mit aktuellen Quellen, praktischen Tests, klaren Grenzen und einem sichereren Weg vom ersten Versuch bis zur Produktion.
Erfahren Sie mehr über die jährlichen AI-Video-Flatrates mit aktuellen Quellen, praktischen Tests, klaren Grenzen und einem sichereren Weg vom ersten Versuch bis zur Produktion.
Erfahren Sie mehr über Alternativen zu GPT-Live 1 – mit aktuellen Quellen, praktischen Tests, klaren Grenzen und einem sichereren Weg vom ersten Test bis zur Produktion.