يجمع «Muse Spark 1.2» بين أسعار الرموز المنخفضة بشكل غير معتاد ونافذة سياق تضم مليون رمز، وقد نجح في اجتياز المهام الثلاث الخاصة ببرمجة النماذج الأساسية ضمن مجموعة اختبارات واجهة برمجة التطبيقات (API) الخاصة بنا في المحاولة الأولى. أطلقت «ميتا» النموذج في 5 أغسطس 2026, ، مع نافذة سياق تضم مليون توكن، ومستويين لتسعير واجهة برمجة التطبيقات (API)، ووكيل طرفي منفصل يُدعى «Muse Code». وتبدو نتائج الاختبارات المعيارية التي أجرتها «ميتا» واعدة؛ إلا أن قوائم التصنيف العامة المستقلة في مجال البرمجة لم تتحقق بعد من نفس تركيبات النماذج والوكلاء.
يفصل هذا الاستعراض بين النموذج والوكيل، وبين التقييمات الرسمية والأدلة المستقلة، وبين التسعير القياسي والمقايضة بين استخدام البيانات ومستوى «المساهم». في اختباراتنا، أنجز النموذج إصلاحًا لخاصية الإيدمبوتنس في لغة Python، وإعادة هيكلة لـ TypeScript مع الحفاظ على التوافق، وميزة JSONL على نطاق المستودع دون الحاجة إلى إعادة المحاولة. لم يتم اختبار تنفيذ وكيل Muse Code، كما لم يتم اختبار موثوقية استدعاء الأدوات. إذا كنت تقارن المجال الأوسع نطاقًا أولاً، فإن دليلنا إلى أفضل نماذج الذكاء الاصطناعي للبرمجة يقدم السياق التنافسي الأوسع نطاقاً.
مراجعة Muse Spark 1.2: إجابة سريعة
النسخة المختصرة: Muse Spark 1.2 هو نموذج Meta يركز على البرمجة، ويتميز بنافذة تبلغ 1 مليون توكن، ووصول إلى واجهة برمجة تطبيقات (API) متوافقة مع SDK OpenAI، ومستوى «المساهم» (Contributor) الذي يجذب الانتباه. أبرز ما يميزه هو القيمة: مدخلات بقيمة $0.10 ومخرجات بقيمة $0.20 لكل مليون توكن في نموذج «المساهم». ويمكن استخدام هذه الفئة لتحسين منتجات Meta، في حين لا يُستخدم النموذج القياسي الأكثر تكلفة لهذا الغرض.
تحتاج نتائج الأداء إلى مزيد من التحفظ. أعلنت شركة «ميتا» عن تحقيق 82.9% في اختبار «Terminal-Bench 2.1» لنظام «Muse Spark 1.2» المزود بـ«Muse Code»، و59.3% في اختبار «DeepSWE». وهذه النتائج تم الحصول عليها من خلال اختبارات أجرتها شركة «ميتا». ولم تكن لوحات Terminal-Bench وDeepSWE العامة قد أدرجت Muse Spark 1.2 حتى عند التحقق منها في 26 أغسطس 2026. التحليل الاصطناعي ويوفر ذلك مصدرًا مستقلًا للتحقق: حيث يظل «مؤشر الذكاء» الخاص به عند 57، وهو أعلى من متوسط النماذج المماثلة البالغ 35.
- أفضل سبب لتجربته الآن: أسعار منخفضة للمساهمين، وسياق واسع، وواجهة برمجة تطبيقات (API) تتبع نمط العميل المألوف OpenAI.
- أفضل سبب يدعو إلى توخي الحذر: لا تثبت المهام الثلاث الخاضعة للرقابة على النموذج الأساسي موثوقية وكيل «Muse Code»، أو جودة استدعاء الأدوات، أو الأداء عبر مستودع إنتاج كبير.
- خيار مهم يتعلق بالخصوصية: استخدم النموذج القياسي للرموز أو المطالبات التي لا ترغب في استخدامها لتحسين منتجات ميتا.
نظرة عامة على Muse Spark 1.2
المواصفات المؤكدة
تصف شركة «ميتا» نموذج «Muse Spark 1.2» بأنه يتمتع بدقة أعلى في البرمجة من المحاولة الأولى، وبموثوقية أكبر في استدعاء الأدوات مقارنةً بنموذج «Muse Spark 1.1». وهذه ادعاءات من جانب المزود الواردة في الصفحة الرسمية لطراز «Muse Spark», ، وليست استنتاجات مستمدة من جلسة البرمجة التي أجريناها.
Muse Spark 1.2 مقابل Muse Code
Muse Spark 1.2 هو النموذج. أما Muse Code فهو وكيل طرفي تجريبي منفصل يعمل باستخدام هذا النموذج. هذا التمييز مهم لأن الوكيل يمكنه إضافة وظائف التخطيط، وتنسيق الأدوات، والتنقل في المستودع، وعزل شجرة العمل، وتسجيل الأحداث، وسلوك إعادة المحاولة حول النموذج الأساسي.
احرص على فصل الطبقات عن بعضها
Muse Spark 1.2
السياق، والاستدلال، وسلوك واجهة برمجة التطبيقات (API)، والفوترة بالرموز، والمخرجات، وقرارات استدعاء الأدوات.
معرّفات النماذج1م سياق 1Mتسعير واجهة برمجة التطبيقات (API)
كود ميوز
تجربة المستخدم في Terminal، والوكلاء الفرعيون، وأشجار عمل Git، وسجل الأحداث، واستئناف سير العمل، والمهارات المجمعة، والتنسيق.
سير عمل الوكيلنتائج نظام «ميتا-ران»
إن الصفحة الرسمية لـ «Muse Code» تصف المنتج بأنه «عامل ترميز بيتا». وهذا يجعل المقارنات مع منتجات مثل «Claude Code» و«Codex» أكثر فائدة من التظاهر بأن كل اختلاف ملحوظ في سير العمل ينبع من استدعاء نموذج بسيط. إن مقارنة بين كودكس ورمز Claude ويوضح ذلك لماذا يمكن للبيئة المحيطة أن تغير تجربة المطور بنفس القدر الذي يغيره النموذج.
اختبارات أداء Muse Spark 1.2: ما الذي تكشفه النتائج حقًّا
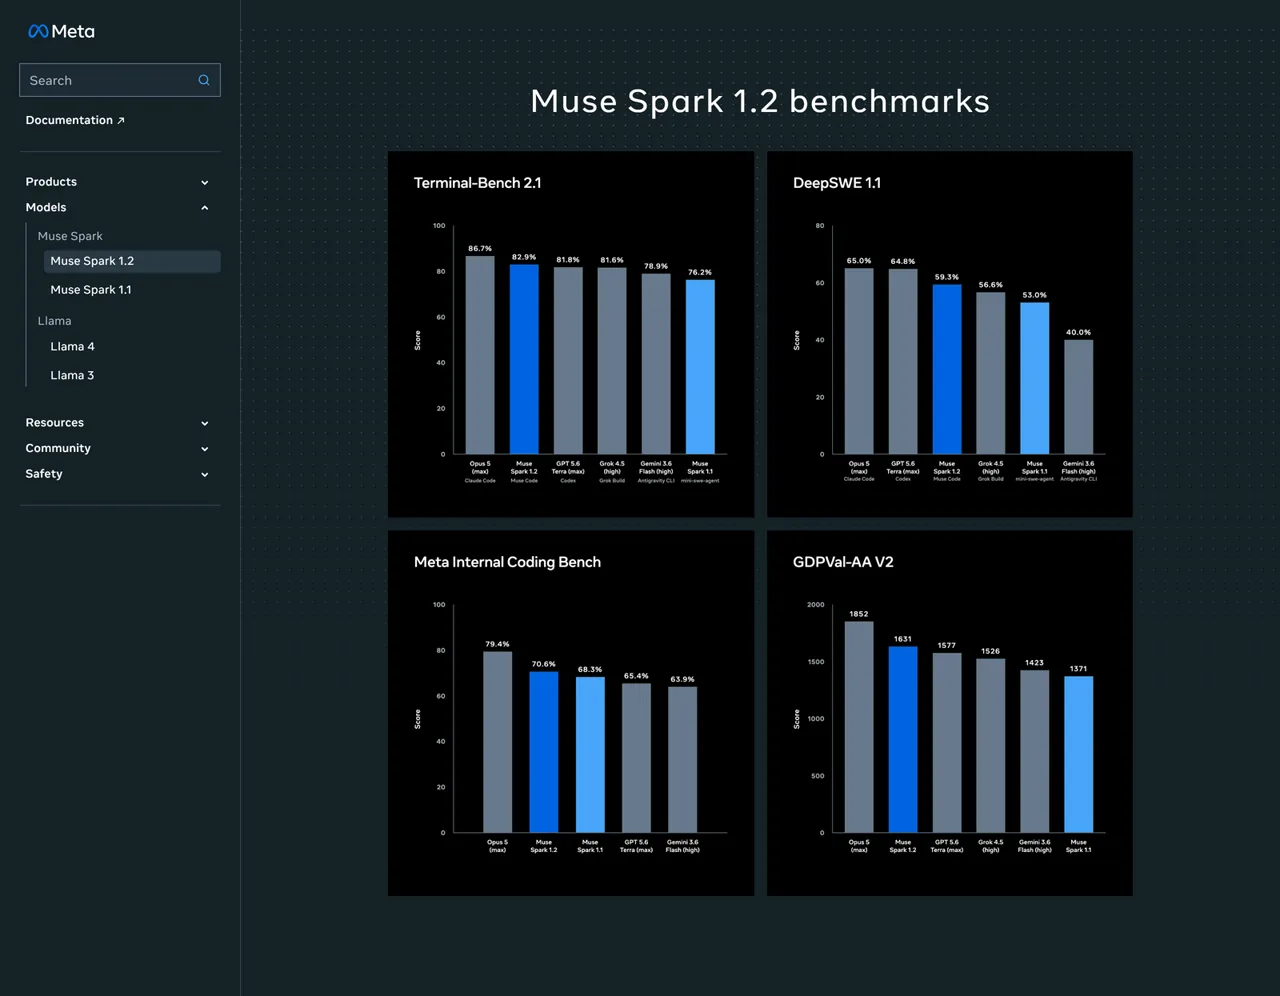
يُظهر مخطط ميتا المعياري أن «Muse Spark 1.2» يحتل مرتبة متقدمة في العديد من تقييمات البرمجة. وتستحق هذه الأرقام الدراسة، لكنها لا تشكل تصنيفًا واحدًا واضحًا لجودة النموذج في حد ذاته. فالنموذج، والوكيل، ونظام الاختبار، وقوة الاستدلال، وبروتوكول المهمة، كلها عوامل يمكن أن تتغير معًا.
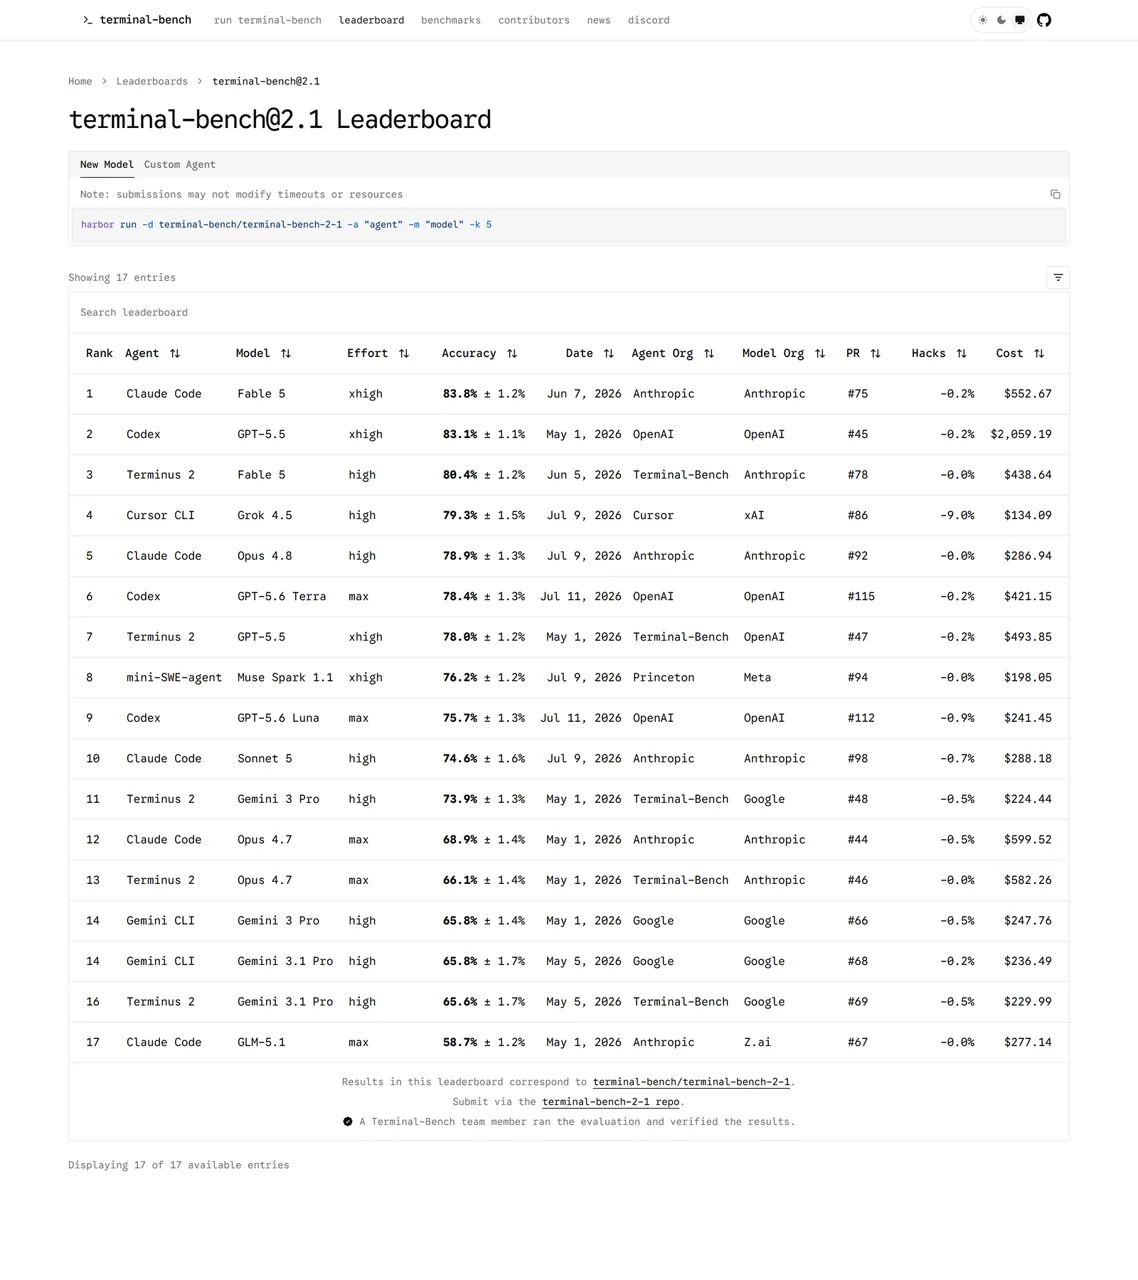
الإصدار 2.1 من Terminal-Bench المُبلغ عنه عبر Meta
لوحة معايير الأداء التلوية
المنضدة الطرفية 2.1
جميع المهام البالغ عددها 89 مهمة · اجتياز المهمة الأولى (pass@1) بعد خمس محاولات · مجموعات مختارة من النماذج والوكلاء
الرقم 82.9% هو نتيجة تشغيل كود Muse في وضع Meta-run. . لوحة المتصدرين العامة لـ Terminal-Bench 2.1 لم يُدرج برنامج Muse Spark 1.2 في 26 أغسطس 2026، لذا فهو ليس إدخالاً مُثبتاً في لوحة المتصدرين العامة. وقد أدرجت اللوحة العامة جهاز «Muse Spark 1.1» المزود بوكيل mini-SWE عند 76.2% ±1.2%.
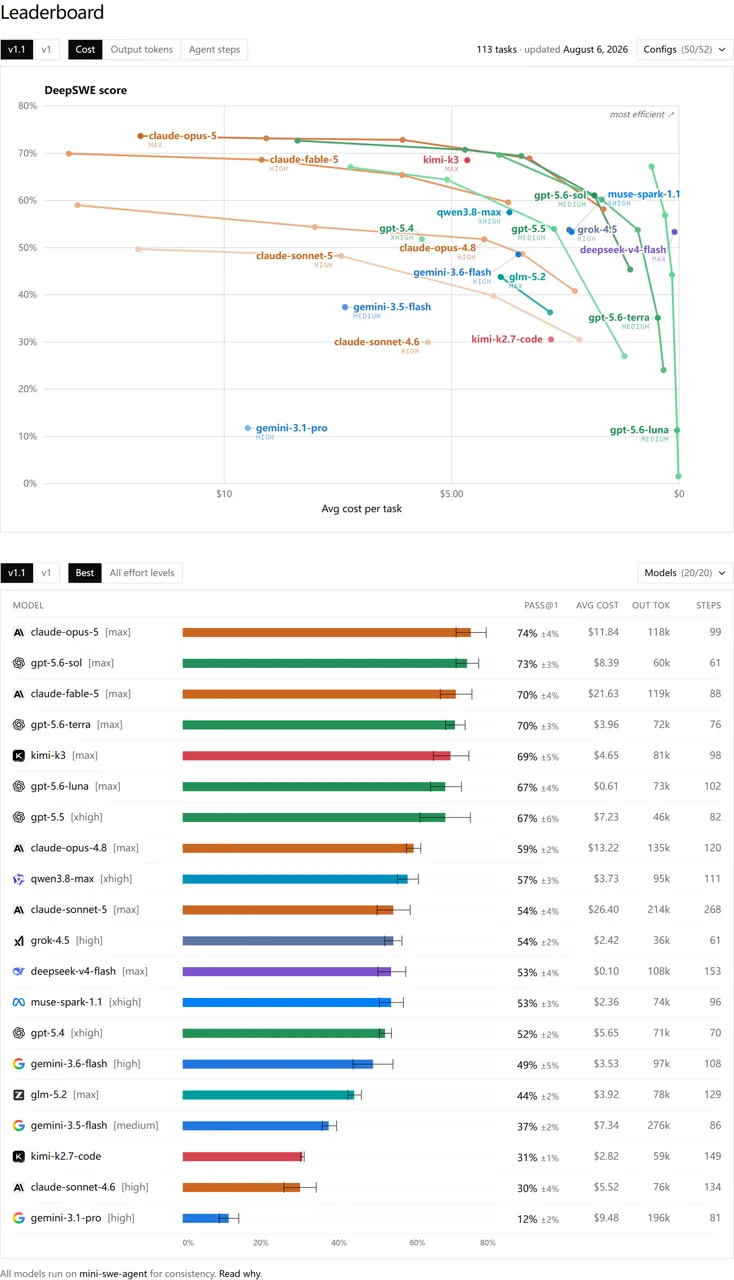
تقرير تلوي عن DeepSWE 1.1
لوحة معايير الأداء التلوية
DeepSWE 1.1
113 مهمة · 91 مستودع · خمس لغات · اجتياز الاختبار في المحاولة الأولى بعد خمس محاولات
إن لوحة المتصدرين العامة لـ DeepSWE الإصدار 1.1 تستخدم الشركة «mini-swe-agent» في جميع الطرز المدرجة لديها حرصًا على الاتساق. ولم تكن قد أضافت «Muse Spark 1.2» عند التحقق؛ حيث كان «Muse Spark 1.1» مدرجًا برقم 53%. أما نتيجة «Meta» البالغة 59.3% فتستخدم «Muse Code»، لذا فإن الرقمين ليسا متطابقين من حيث نظام الاختبار.
تقييمات «ميتا» الداخلية وتقييمات الوكلاء العامين
مقياسان مختلفان للتقييم
منصة الترميز الداخلية لشركة ميتا
440 مهمة داخلية · محاولتان لكل مهمة
| نموذج | النتيجة |
|---|---|
| العمل رقم 5 | 79.4% |
| Muse Spark 1.2 | 70.6% |
| GPT-5.6 تيرا | 65.4% |
| Gemini 3.6 فلاش | 63.9% |
| Grok 4.5 | غير معروض |
GDPVal-AA الإصدار 2
التقييم العام للمهام الوكالية · القيم على غرار نظام «إيلو»
| نموذج | النتيجة |
|---|---|
| العمل رقم 5 | 1852 |
| Muse Spark 1.2 | 1631 |
| GPT-5.6 تيرا | 1577 |
| Grok 4.5 | 1526 |
| Gemini 3.6 فلاش | 1423 |
شركة ميتا منهجية التقييم تشير النتائج إلى أن «Terminal-Bench» يستخدم جميع المهام البالغ عددها 89 مهمة، وحقق معدل نجاح «pass@1» على مدى خمس محاولات. أما «DeepSWE» فيغطي 113 مهمة موزعة على 91 مستودعًا وخمس لغات، وحقق أيضًا معدل نجاح «pass@1» على مدى خمس محاولات. تشير Meta أيضًا إلى أن إعداداتها قد لا تكون مضبوطة بشكل مثالي لنماذج الجهات الخارجية. للاطلاع على مقارنة حالية مع المنافسين تستند إلى قرارات منتجات حقيقية، انظر Claude Opus 5 مقابل GPT-5.6.
المنهجية تغير المعنى
الطراز + الوكيل المختار
89 مهمة، وخمس محاولات، واختلافات في إعدادات الاستدلال القصوى، وقد لا يكون نظام «Meta» مُعدَّلاً بشكل متساوٍ لتوافق مع أنظمة الجهات الخارجية.
المدخلات التي تم التحقق منها
لم يتم العثور على Muse Spark 1.2 عند التحقق. يجب الاطلاع على تكوينات اللوحة وحالة التحقق منها بشكل منفصل من جدول Meta.
وكيل «ميني-سوي» الشائع
113 مهمة موزعة على 91 مستودعًا وخمس لغات. لم يُدرج إصدار Muse Spark 1.2؛ أما إصدار Muse Spark 1.1 فقد أُدرج تحت الرمز 53%.
التحليل الاصطناعي: سياق مستقل مفيد
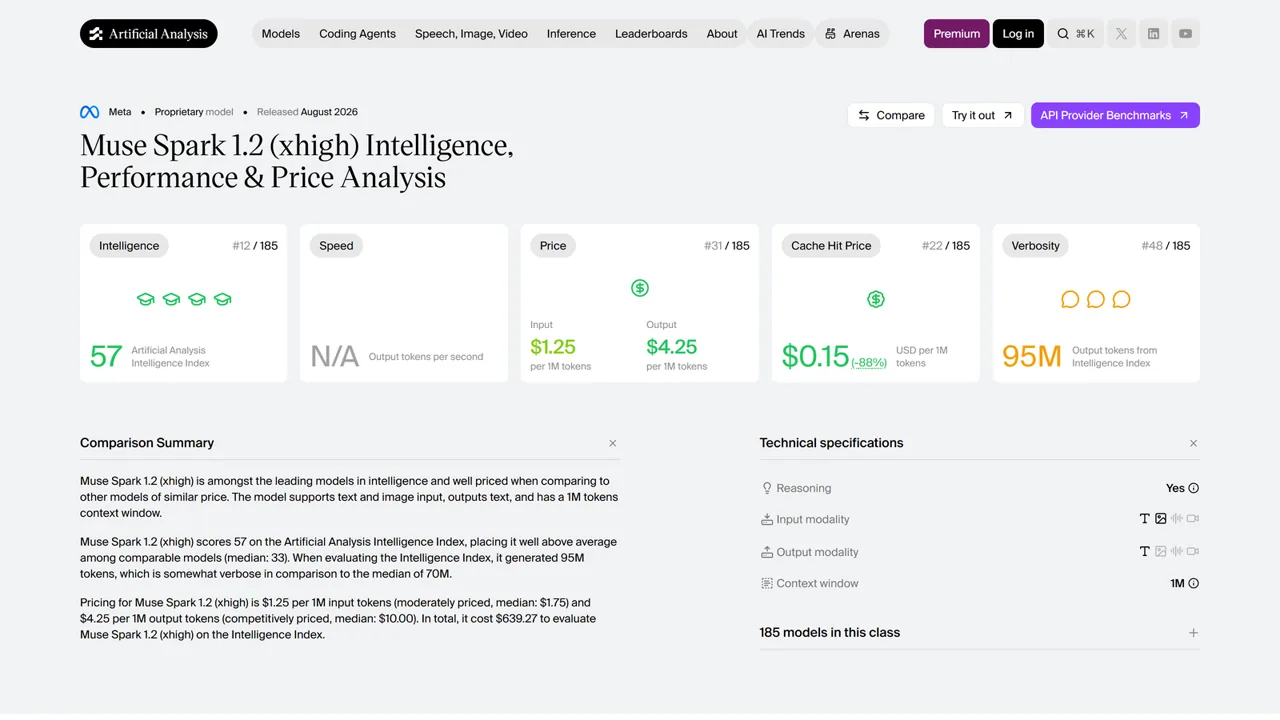
إن صفحة نموذج التحليل الاصطناعي يمنح برنامج «Muse Spark 1.2» مؤشر ذكاء يبلغ 57, ، وهو أعلى من الوسيط الخاص بالطرازات المماثلة البالغ 35 عند التحقق في 26 أغسطس 2026. ويسجل نظام الاختبار الخاص بها 80% على Terminal-Bench v2.1، و57% بعد التعيير على GDPVal-AA v2، و56% على SciCode، و83% في تقييم السياق الطويل AA-LCR.
انحراف إصدار التحليل الاصطناعي
الدرس العملي بسيط: يبدو نموذج «Muse Spark 1.2» قادراً على المنافسة، لكن لا توجد نتيجة واحدة يمكنها أن تُقيّم النموذج بمفردها. تعامل مع الرسم البياني الذي قدمته «Meta» كدليل على نظام «Muse Code»، ومع قوائم المتصدرين العامة كأداة تحقق إضافية، ومع «Artificial Analysis» كتقييم مستقل ولكنه مُعدّ بطريقة مختلفة.
المفاضلة بين السعر والخصوصية في Muse Spark 1.2
تقدم «ميتا» معرّفين لنموذج واجهة برمجة التطبيقات (API) بأسعار تختلف بشكل كبير. والخيار الأرخص ليس مجرد خصم: بل إنه يغير الطريقة التي يمكن بها استخدام البيانات المرسلة.
الدولار الأمريكي لكل مليون توكن · سياق 1M
لا تُستخدم لتحسين المنتج
لا تُستخدم لتحسين منتجات Meta
أرخص، مع مقايضة في استخدام البيانات
البيانات يمكن استخدامها لتحسين منتجات Meta
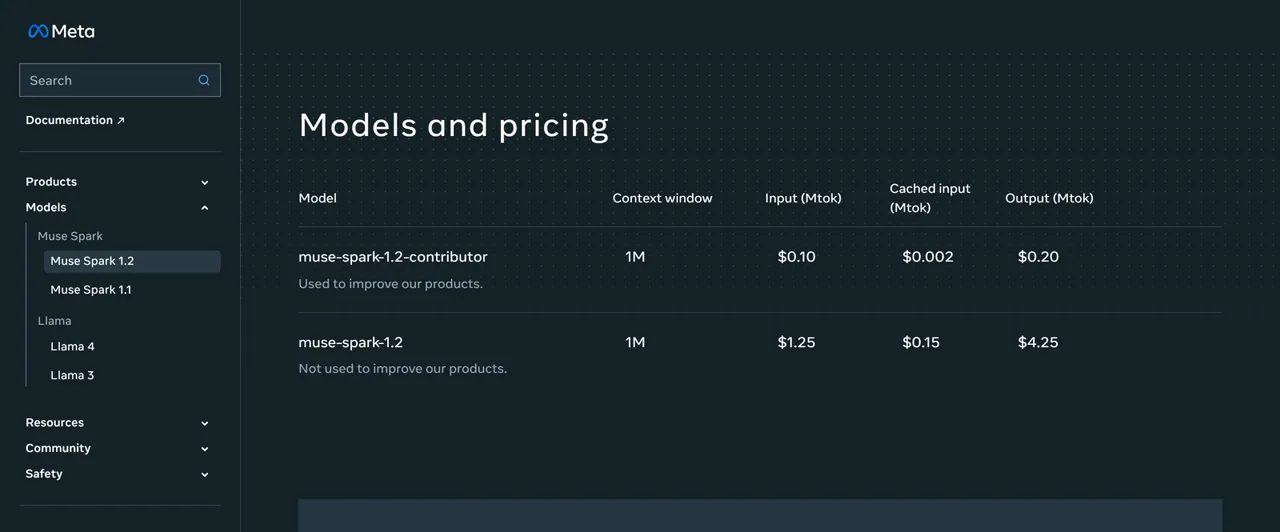
أسعار فئة «المساهمين» أرخص بـ 12.5 ضعفًا بالنسبة للمدخلات، وأرخص بـ 75 ضعفًا بالنسبة للمدخلات المخزنة في ذاكرة التخزين المؤقت، وأرخص بـ 21.25 ضعفًا بالنسبة للمخرجات مقارنةً بالفئة القياسية. ولا توجد نسبة خصم واحدة دقيقة تصف جميع أنواع الرموز.
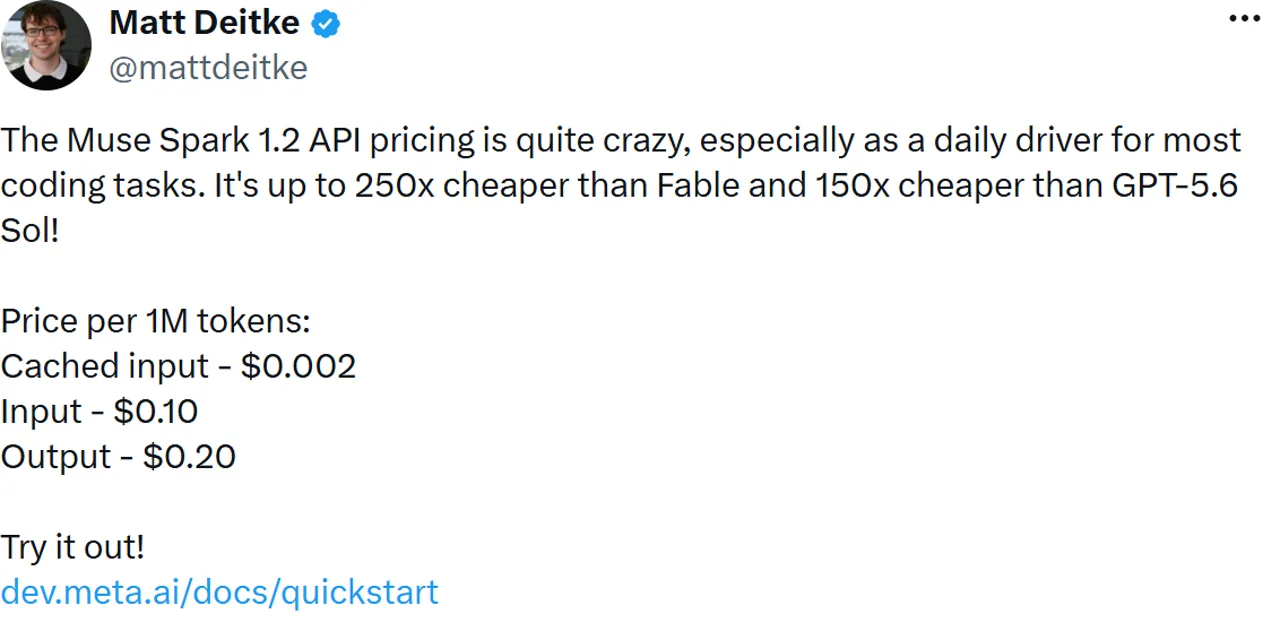
أشاد أحد الباحثين في شركة “ميتا” بفئة “المساهم” (Contributor) ووصفها بأنها «أرخص بما يصل إلى 250 ضعفًا» من «فابل» (Fable) و«أرخص بـ 150 ضعفًا» من «GPT-5.6 Sol». ذلك المقارنة الاجتماعية يستخدم أسعار «المساهمين»، وليس النموذج القياسي، ويجب أن يتضمن دائمًا تحفظًا بشأن استخدام البيانات. يمكن للقراء الذين يقارنون التكاليف الحالية للمنافسين الاستعانة بـ دليل أسعار GPT-5.6 و تفصيل أسعار الرمز Claude.
بالنسبة للمستودعات العامة، أو المهام الاصطناعية، أو أدوات التقييم التي يمكن التخلص منها، قد تكون فئة «المساهم» خيارًا جذابًا. أما بالنسبة للكود الخاص، أو بيانات العملاء، أو بيانات الاعتماد، أو البنية الخاصة، فإن الفئة القياسية هي الإعداد الافتراضي الأكثر أمانًا. وتقول Meta أيضًا إنها بدأت في قبول طلبات عدم الاحتفاظ بالبيانات من خلال قسم المبيعات، وهو مسار وصول منفصل بدلاً من الإعداد الافتراضي للخدمة الذاتية.
الوصول إلى واجهة برمجة التطبيقات (API) لـ Muse Spark 1.2 وأمثلة عليها
ثلاثة مسارات وصول رسمية
العنوان الأساسي الرسمي لموقع كتاب الطبخ: https://api.meta.ai/v1 · 1.2 الطلب الوارد في هذا الاستعراض: لم يتم تنفيذه
إن واجهة برمجة تطبيقات النموذج التلوي يدعم سير عمل متوافق مع SDK OpenAI. يستخدم دليل الاستخدام الرسمي لشركة Meta عنوان URL الأساسي https://api.meta.ai/v1 ويقرأ المفتاح من MODEL_API_KEY. كما تتناول صفحة المنتج موضوع «تأسيس البحث»، في حين يغطي دليل الاستخدام ميزات إكمال النصوص في الدردشة، والبث المباشر، واستدعاء الأدوات، والإخراج المنظم، وتخزين المطالبات مؤقتًا، وعناصر التحكم في الاستدلال، والرؤية، والسياق الطويل، وإعادة المحاولة، ووصفات البحث.
مثال على كتاب الطبخ الرسمي — النسخة الملتقطة: إن كتاب الوصفات الرسمي لـ GitHub لا يزال يستخدم muse-spark-1.1. وهذا يثبت بنية العميل وعنوان URL الأساسي، ولا يعني أن المثال قد تم تحديثه ليتوافق مع الإصدار 1.2.
import os

from openai import OpenAI

client = OpenAI(
    base_url="https://api.meta.ai/v1",
    api_key=os.environ["MODEL_API_KEY"],
)

response = client.chat.completions.create(
    model="muse-spark-1.1",
    messages=[{"role": "user", "content": "Hello, world!"}],
)

print(response.choices[0].message.content)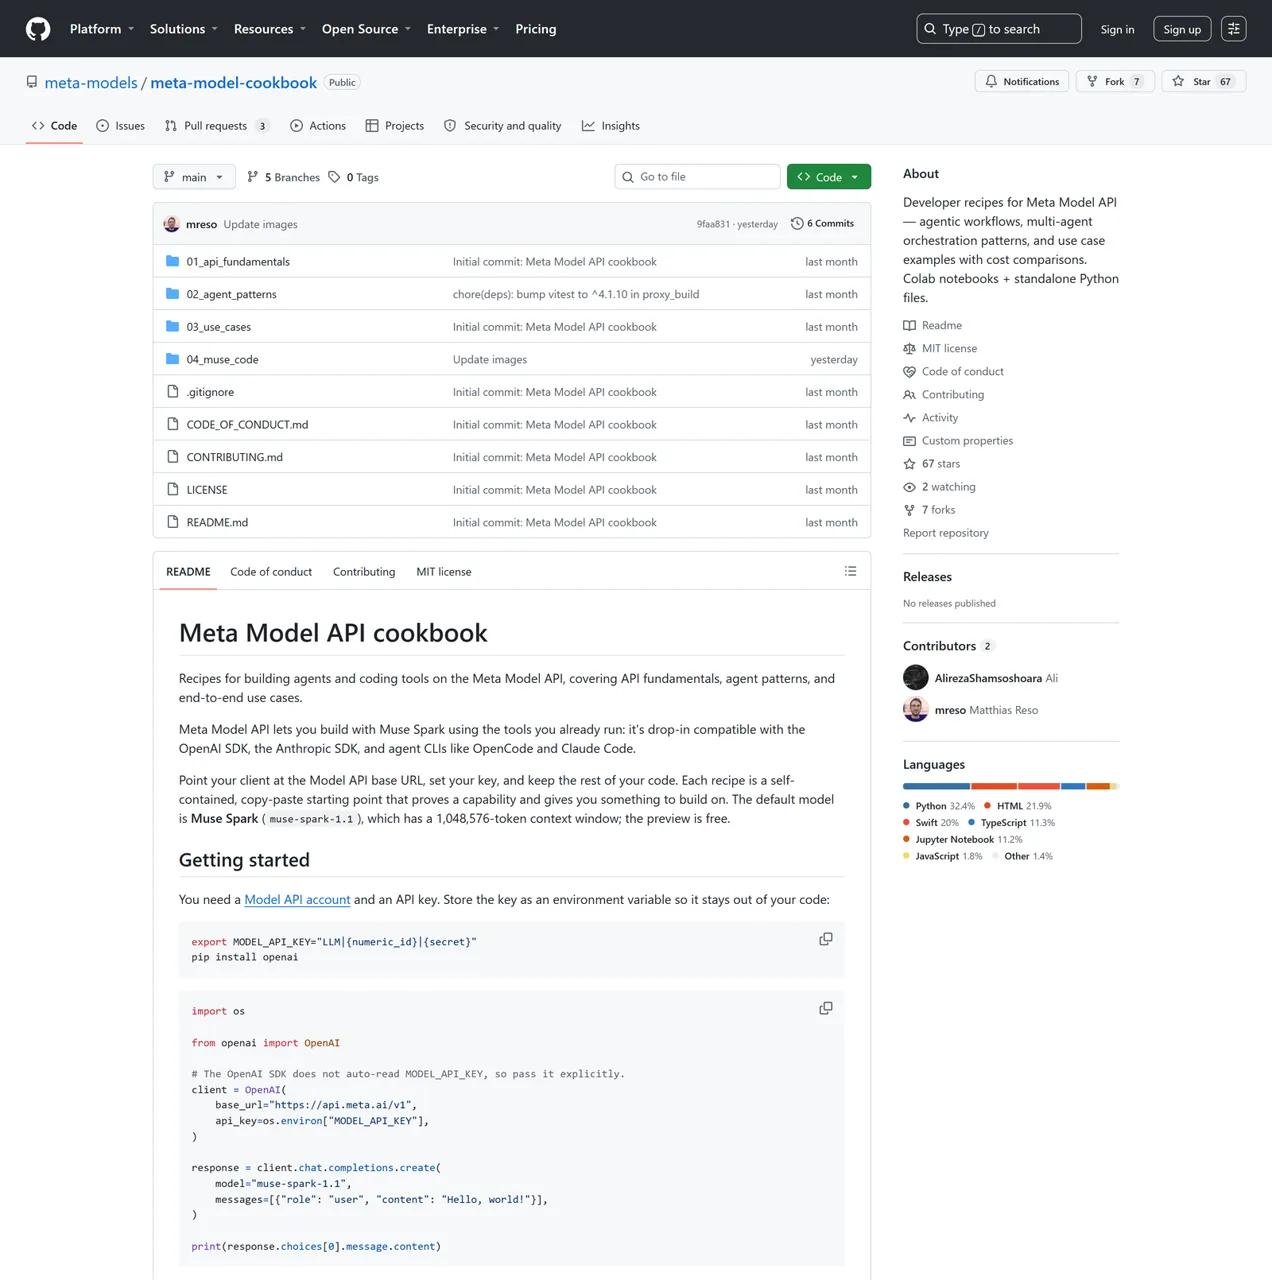
التعديل الموثق — لم يتم تنفيذه: تدرج «ميتا» بشكل منفصل muse-spark-1.2 باعتباره رقم تعريف الطراز القياسي 1.2. يجمع الاستبدال البسيط الوارد أدناه بين حقيقتين رسميتين، لكن لم يتم إرسال أي طلب مدفوع خلال عملية المراجعة هذه.
response = client.chat.completions.create(
    model="muse-spark-1.2",
    messages=[{"role": "user", "content": "Hello, world!"}],
)
Muse Spark هو نموذج استدلال، و يتم احتساب رموز الاستدلال كإخراج. وهذا يجعل معدل الإخراج القياسي $4.25 أكثر أهمية مما يبدو عليه للوهلة الأولى: فالإجابة التي تبدو قصيرة قد تنطوي مع ذلك على استخدامات منطقية جوهرية خفية. ولا تزال عوامل مثل زمن الاستجابة الفعلي، والوقت المستغرق حتى ظهور الرمز الأول، ومعدل إعادة المحاولة، والتكلفة لكل مهمة غير مقاسة هنا.
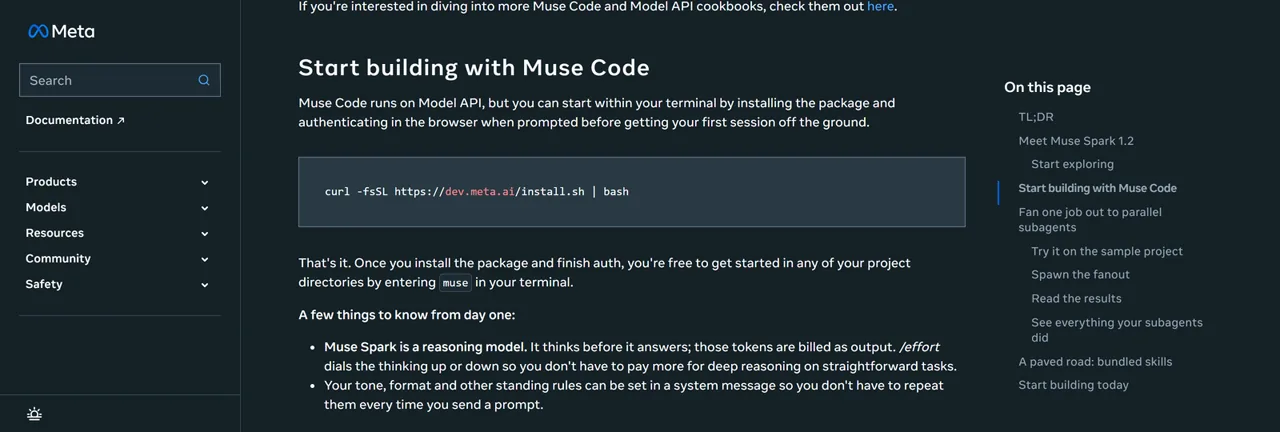
/الجهد المبذول يُغير هذا الأمر عمق الاستدلال. المصدر: دليل مطوري Meta.ما يضيفه «Muse Code»
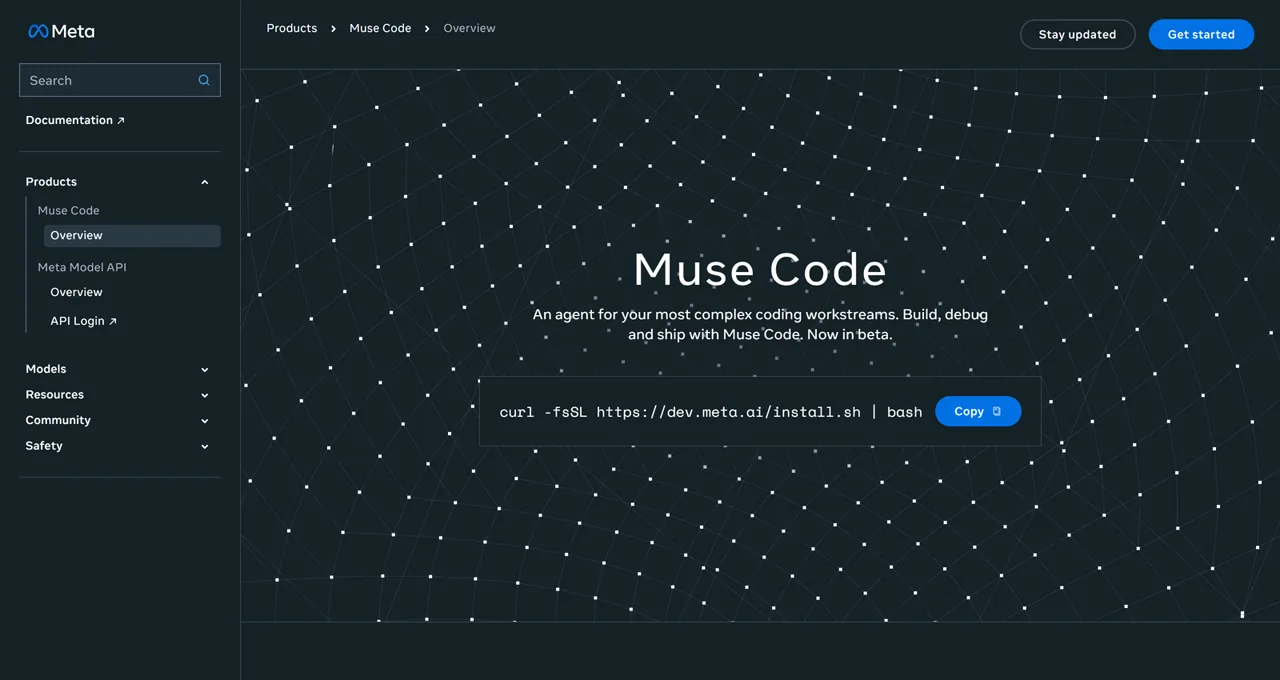
يتم تثبيت «Muse Code» من خلال «الترمينال»، وهو يدمج «Muse Spark 1.2» في سير عمل الوكيل. «Meta’s» تعمق في عالم المطورين يصف عدة أنماط سلوكية لا تندرج ضمن نطاق استدعاء واجهة برمجة التطبيقات (API) البسيط:
- الوكلاء المتوازيون: يمكن تشغيل المهام في أشجار عمل Git معزولة.
- سجل الأحداث الذي يُسمح بالإضافة إليه فقط: يتم تسجيل الجلسات والإجراءات في ملف JSONL محلي لأغراض التدقيق وإعادة التشغيل.
- استئناف سير العمل:
السيرة الذاتية لموسىيمكن متابعة الجلسات التي تم مقاطعتها. - التحكم في الاستدلال: ال
/الجهد المبذوليُعدّل هذا الأمر قوة الاستدلال. - المهارات الصريحة: أسماء ميتا
/المذاق,/الشواء,/شواية-مع-الوثائق, و/الخطة.
ميزات منتج الوكيل
الوكلاء الفرعيون
يمكن أن تتفرع المهام المستقلة.
أشجار العمل
تظل الفروع منفصلة أثناء العمل المتوازي.
سجل JSONL
تدعم الأحداث المحلية التي تُضاف إليها البيانات فقط ميزة إعادة التشغيل.
السيرة الذاتية
السيرة الذاتية لموسى يواصل عقد الجلسات المتقطعة.
المهارات
/المذاق, /الشواء, /شواية-مع-الوثائق, /الخطة.
تجعل هذه المجموعة من الميزات برنامج «Muse Code» مناسبًا لسوق برامج البرمجة الأوسع نطاقًا، حيث تُعدّ عوامل التخطيط والعزل وإعادة التشغيل والالتزام بالأدوات أمورًا مهمة إلى جانب ذكاء النموذج. إن دليل المقارنة بين OpenClaw وClaude وOpenCode وهو سياق مفيد لفهم تلك الاختلافات على مستوى المنتج.
الادعاءات المتعلقة بالإطلاق والإشارات المبكرة من المجتمع
رد الفعل لا يعني الموافقة
التدريب + الأفق البعيد
المزيد من عمليات البرمجة الحسابية، وتنوع البيئات، والتدريب المشترك، واختبار التحمل الذي شمل استدعاء أكثر من 1,000 أداة.
السعر و OpenCode
أشاد أحد مستخدمي موقع «ريديت» بتجربته المبكرة في مجال البرمجة وبالقيمة التي اكتسبها منها.
الخصوصية + الموثوقية
وأعرب مستخدمون آخرون عن مخاوف تتعلق باستهلاك البيانات، والسعر القياسي، وتوافر الجهاز، وموثوقيته في المراحل المبكرة.
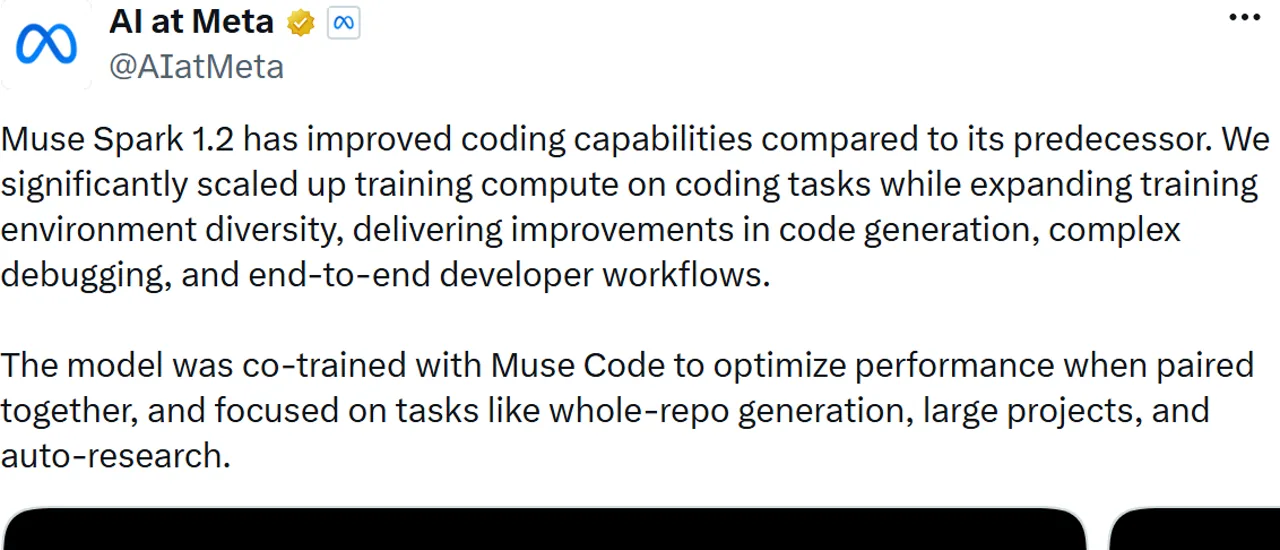
أفادت وحدة الذكاء الاصطناعي في «ميتا» أن «Muse Spark 1.2» حصلت على موارد حاسوبية أكبر للتدريب على البرمجة، وبيئات أكثر تنوعًا، وتركيزًا أكبر على إنشاء مستودعات كاملة وتصحيح الأخطاء فيها، بالإضافة إلى التدريب المشترك مع «Muse Code». وفي تقرير منفصل، موضوع الإطلاق يصف اختبار التحمل الذي يستمر لمدة تصل إلى 24 ساعة ويتضمن أكثر من 1,000 استدعاء للأدوات على وحدات معالجة الرسومات (GPU) من طراز NVIDIA Hopper.
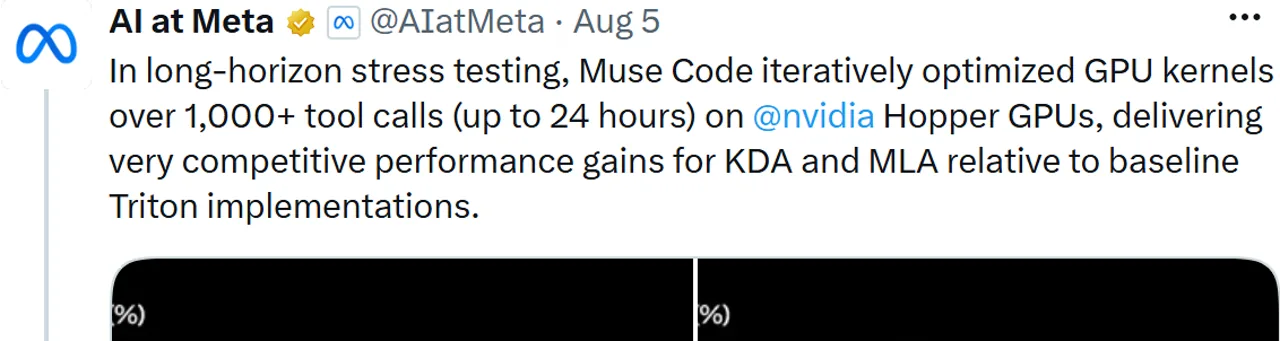
هذا عرض مثير للإعجاب، لكنه لا يمثل معدل نجاح عام تم قياسه. فهو لا يوضح لنا عدد المرات التي اختار فيها الوكيل الأداة الصحيحة، أو تعافى من الأخطاء، أو تجنب تكرار المكالمات، أو أنجز مهمة عادية في المستودع دون الحاجة إلى توجيه.
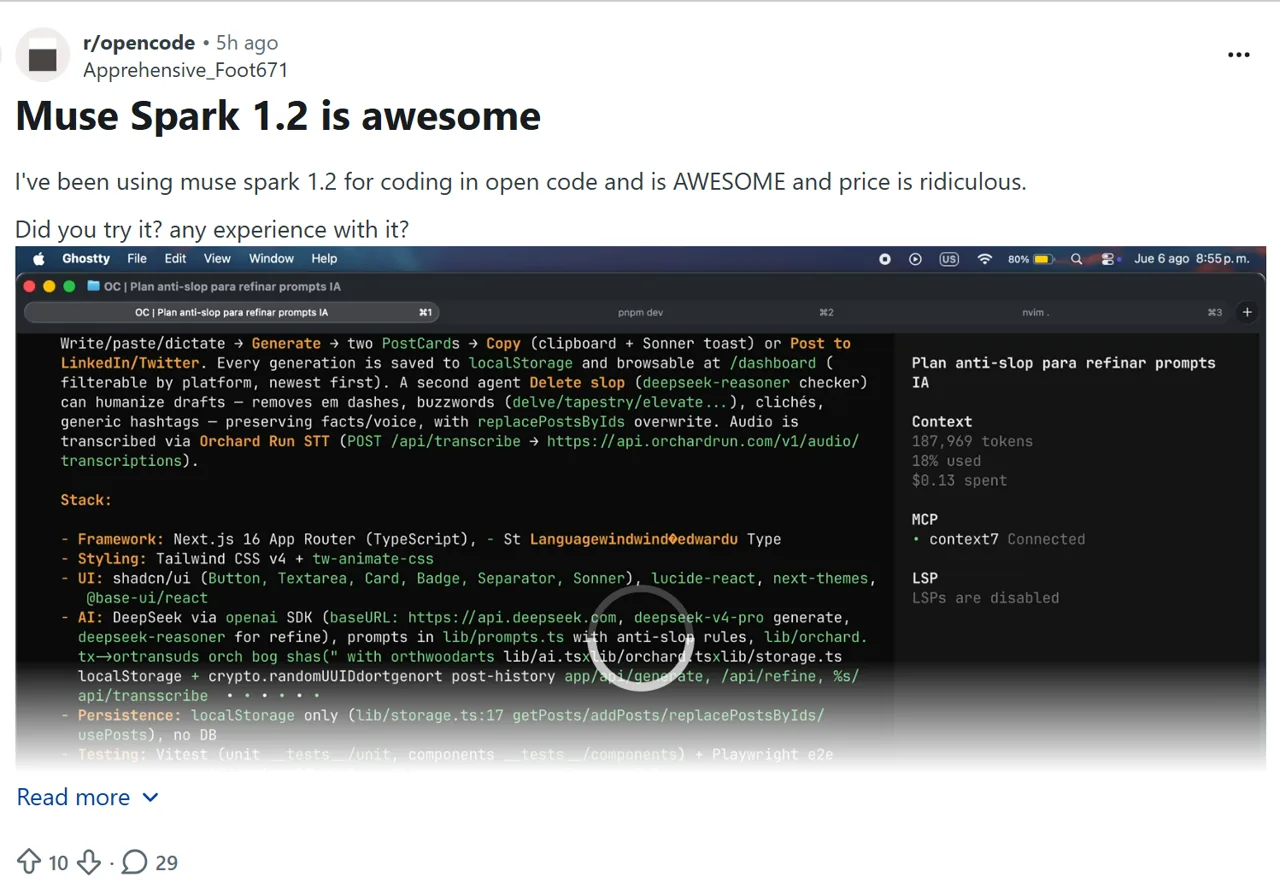
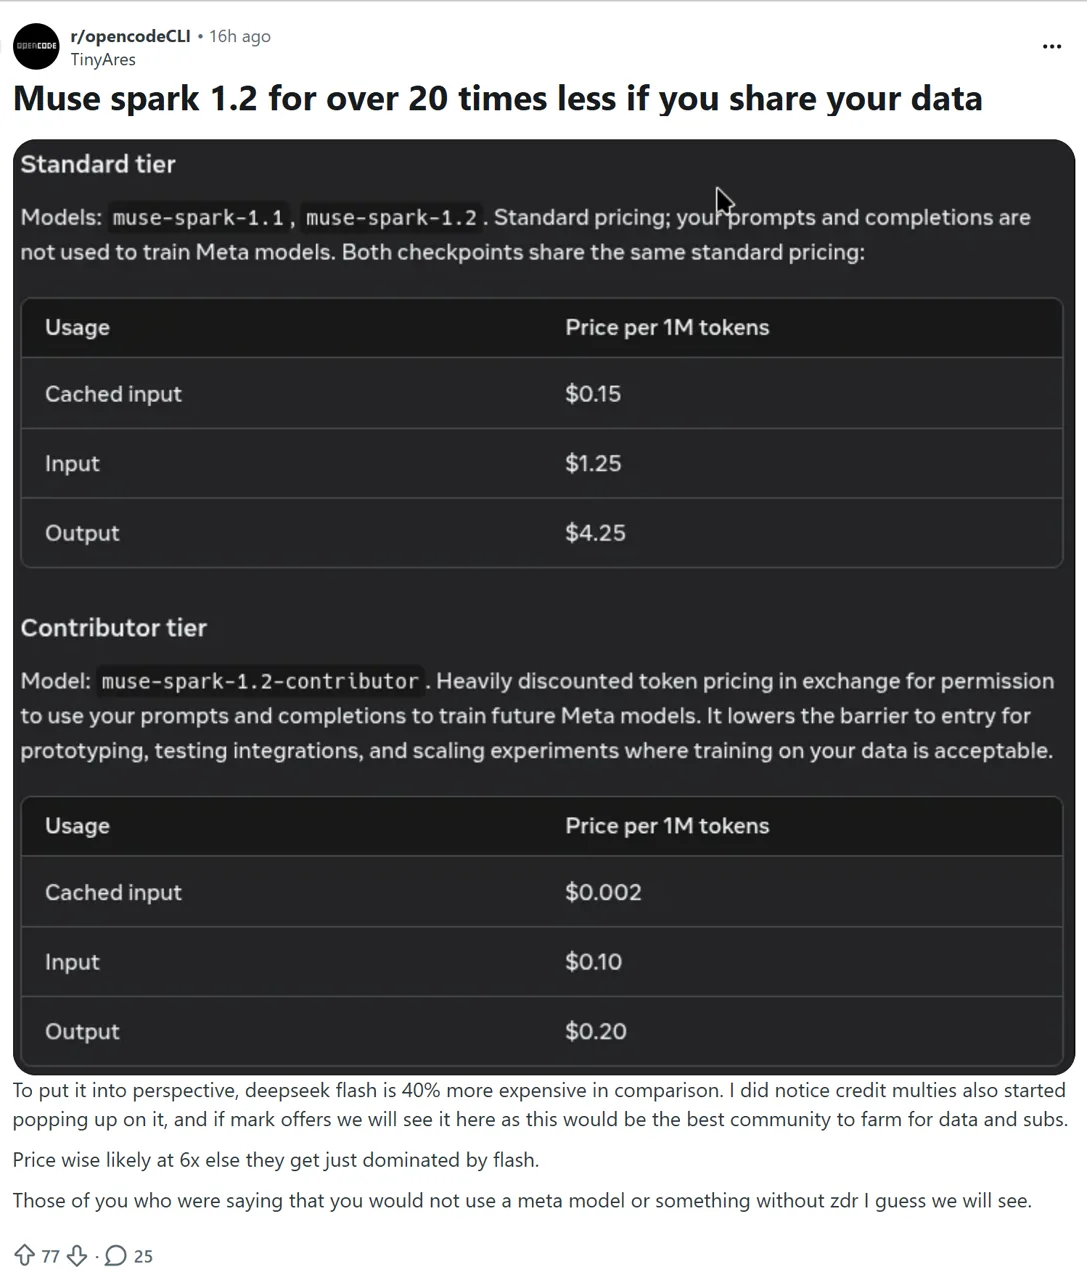
كما أن المنشورات المبكرة على موقع «ريديت» تتسم هي الأخرى بتباين الآراء. أحدها أبلغ أحد مستخدمي r/opencode عن تجربة إيجابية مع OpenCode وأشاد بالسعر. وفي مقال منفصل مناقشة حول تسعير المساهمين أثارت تساؤلات حول استخدام البيانات، وتكلفة الفئة القياسية، وتوافر الخدمة، وموثوقيتها. وهذه ردود فعل فردية، وليست إجماعاً من المجتمع.
اختبارات البرمجة في Muse Spark 1.2: اجتياز 3 مهام من أصل 3
في الاختبارات التي أجريناها، أنجز الطراز الأساسي «Muse Spark 1.2» ثلاث مهام برمجة خاضعة للرقابة من خلال واجهة برمجة تطبيقات (API) لإكمال النصوص في الدردشة متوافقة مع معيار OpenAI. أُتيحت لكل مهمة محاولة واحدة، دون أي محاولات إعادة ودون تدخل بشري. قمنا بتقييم الملفات التي تم إرجاعها في مستودعات قابلة للإزالة مقارنةً باختبارات التحقق العامة والمخفية. لم يتم اختبار تنفيذ وكيل Muse Code، كما لم يتم اختبار موثوقية استدعاء الأدوات، لذا لا ينبغي اعتبار هذه النتائج بمثابة معيار قياسي للوكيل.
نتيجة المحاولة الواحدة
استخدمت الإجابات 6,618 وحدة استدلال. وكانت الأسباب الثلاثة التي أدت إلى الوصول إلى النتيجة هي: توقف, ، وقد أُشير في حقل «المزود» إلى «Meta».
الاختبار 1: إصلاح خطأ «القدرة على التكرار» في لغة بايثون — ناجح
أوقف عمليات التحويل المكررة دون تغيير واجهة برمجة التطبيقات العامة (API)
قام النموذج بتحديد الحارس المفقود لمعرف الطلب، وأضاف أصغر إصلاح آمن، وقدم اختبار تراجع مع الحفاظ على تحديثات التوازن الذري.
كان المُقيِّم المخفي الأصلي يتطلب، بشكل خاطئ، استدعاءً مكررًا لـ return خطأ, ، على الرغم من أن المهمة كانت تتطلب فقط عدم تحصيل الرسوم من المرسل مرتين. وبعد تصحيح ذلك الشرط المختلق المتعلق بقيمة الإرجاع، نجح الرد الأول — الذي لم يُعدَّل — في اجتياز جميع الاختبارات الستة. ولم نقم بإعادة المحاولة أو تعديل ناتج النموذج.
الاختبار 2: إعادة هيكلة ملفات متعددة في TypeScript — ناجح
الفصل بين عمليات التحقق من الصحة، والتخزين الدائم، وتسجيل عمليات التدقيق
حافظت الملفات التي تم إرجاعها على عقد المسار العام، واتباع قواعد TypeScript الصارمة، والمعاملة الواحدة التي تغطي عمليات الكتابة المتعلقة بالأوامر والتدقيق على حد سواء. كما أضافت اختبارات تحقق مركزة دون الاعتماد على بيئة التشغيل.
قارن المُقيِّم الأول الأشياء مع الخام JSON.stringify, ، لذا بدت الكائنات المتكافئة التي تختلف في ترتيب إدراج مفاتيحها غير متكافئة؛ في نظام التشغيل Windows npx كما فشل التشغيل قبل مرحلة التحقق من أنواع البيانات. وباستخدام مُقارن لا يراعي ترتيب القيم واستدعاء للأوامر متوافق مع نظام ويندوز، اجتازت الاستجابة الأصلية جميع عمليات الفحص. ومرة أخرى، لم تتم إعادة المحاولة وفقًا للنموذج.
الاختبار 3: ميزة مستودع JSONL — ناجح
اتباع التعليمات على مستوى المستودع بأكمله
أضف JSONL دون الإخلال بملف CSV
يتميز هذا النموذج بخاصية الكشف عن التوسعات، وأخطاء الأسطر المشوهة التي تبدأ من الرقم 1، والإخراج الذري، وأمان التشغيل التجريبي، والاختبارات المركزة، ونص المساعدة، ومثال لملف README.
ما تظهره الاختبارات: يمكن لـ Muse Spark 1.2 إرجاع تصحيحات قابلة للاستخدام تتضمن عدة ملفات، ومراعاة قيود التوافق، وإضافة اختبارات، ومعالجة ميزة متواضعة على نطاق المستودع بأكمله في محاولة واحدة. وبلغ متوسط التكلفة المُبلغ عنها حوالي $0.0151 لكل مهمة، لكن هذه الاختبارات كانت صغيرة الحجم ولا ينبغي استخدامها لتقدير التكلفة المتوقعة لقاعدة كود كبيرة.
من ينبغي أن يستخدم Muse Spark 1.2؟
دليل اتخاذ القرار
التقييم الخاضع للرقابة
كود عام أو اصطناعي، ومهام قابلة للقياس، واحتياجات ذات سياق واسع، ونتيجة واعدة للنموذج الأساسي بنسبة 3/3.
يلزم تقديم إثبات الوكيل
يُعد سلوك «Muse Code»، والحدود القصوى المستقرة لمعدلات الاستخدام، والاستدعاءات المتكررة للأدوات، أو اختبارات الأداء الشاملة للمستودعات، عوامل حاسمة في اتخاذ القرار.
كود حساس أو إنتاجية عالية
استخدم المستوى القياسي أو قارن بين البدائل عندما تكون الخصوصية وتكلفة رموز الاستدلال هي العوامل المهيمنة.
استخدم النموذج القياسي للرموز الحساسة ما لم تكن مؤسستك قد وافقت بشكل منفصل على شروط المساهمين. إذا أدى سعر المخرجات القياسي إلى تغيير حساب القيمة، فقم بمقارنته بالقيمة الحالية أسعار كوديكس, ، ورمز Claude، وتكاليف عوامل الترميز الأخرى قبل الالتزام بسير العمل.
الحكم النهائي على مراجعة Muse Spark 1.2
حصل برنامج «Muse Spark 1.2» على مكان في القائمة المختصرة للتقييم، وليس على توصية تلقائية بالإنتاج. إن سياق توكن 1M، وشكل واجهة برمجة التطبيقات (API) المألوف، والأسعار المنخفضة للمساهمين، وإتاحة ثلاث محاولات للبرمجة من المرة الأولى، ونتائج «Muse Code» القوية في اختبارات «Meta-run»، كل ذلك يجعل من الصعب تجاهل هذا المشروع. كما أن «Meta» قد أبلت بلاءً حسناً، مقارنةً بالعديد من عمليات الإطلاق الأخرى، في نشر تفاصيل المنهجية المتبعة.
كما أن المحاذير محددة بنفس القدر. فأسعار المساهمين تنطوي على مقايضة تتعلق باستخدام البيانات. وقد تؤدي الرموز القياسية للإخراج والاستدلال إلى ارتفاع التكلفة الفعلية. لم يتم إعادة إنتاج أرقام البرمجة الأعلى التي سجلتها Meta كمدخلات مطابقة على لوحات Terminal-Bench أو DeepSWE العامة، وتغطي عينتنا العملية ثلاث مهام للنموذج الأساسي بدلاً من تنفيذ وكيل Muse Code.
الخطوة المنطقية هي إجراء تجربة محكومة على كود غير حساس، مع حفظ بيانات الاستخدام الأولية ونتائج التحقق المحلي. تعامل مع التكلفة وزمن الاستجابة المقاسين على أنهما عينة لمهمة صغيرة، ثم اختبر حجم مستودعك الخاص، وقدرتك على التعافي من الأعطال، وسير عمل الوكيل قبل اختيار هذا الحل للاستخدام في بيئة الإنتاج.
الأسئلة الشائعة حول Muse Spark 1.2
ما هو Muse Spark 1.2؟
Muse Spark 1.2 هو نموذج «ميتا» المخصص للبرمجة، والذي تم إطلاقه في 5 أغسطس 2026، ويتميز بنافذة سياق سعة 1 مليون توكن، ويمكن الوصول إليه عبر «Muse Code» وواجهة برمجة تطبيقات «Meta Model» و«OpenRouter».
هل برنامج «Muse Spark 1.2» هو نفسه برنامج «Muse Code»؟
لا. «Muse Spark 1.2» هو الطراز؛ أما «Muse Code» فهو وكيل طرفي تجريبي منفصل يعمل بواسطة هذا الطراز. ويضيف «Muse Code» ميزات للمنتج مثل الوكلاء الفرعيين، وأشجار عمل Git المعزولة، وتسجيل الأحداث، وميزة «الاستئناف»، والمهارات المجمعة.
كم تبلغ تكلفة واجهة برمجة التطبيقات (API) لـ Muse Spark 1.2؟
تبلغ تكلفة النموذج القياسي $1.25 مدخلاً، و$0.15 مدخلاً مخزّنًا في ذاكرة التخزين المؤقت، و$4.25 مخرجًا لكل مليون توكن. تبلغ تكلفة نموذج «المساهم» $0.10 للمدخلات، و$0.002 للمدخلات المخزنة مؤقتًا، و$0.20 للمخرجات.
هل تستخدم «ميتا» بيانات واجهة برمجة تطبيقات «ميوز سبارك» في عملية التدريب؟
تقول «ميتا» إن البيانات من الفئة القياسية لا تُستخدم لتحسين منتجات «ميتا». أما البيانات من فئة المساهمين، فيجوز استخدامها لتحسين منتجات «ميتا»، لذا ينبغي أن تستخدم الأكواد الخاصة أو المسجلة الملكية المسار القياسي ما لم توافق المؤسسة على خلاف ذلك.
هل يظهر برنامج «Muse Spark 1.2» في قوائم التصنيف العامة لـ «Terminal-Bench» أو «DeepSWE»؟
لم تكن مدرجة في أي من اللوحات العامة عند التحقق منها في 7 أغسطس 2026. تُسجل «ميتا» 82.9% على «Terminal-Bench 2.1» باستخدام «Muse Code» و59.3% على «DeepSWE»، لكن هذه النتائج تم الحصول عليها من خلال اختبارات أجرتها «ميتا» نفسها.
هل تم اختبار Muse Spark 1.2 عمليًّا في هذه المراجعة؟
نعم. في ثلاث اختبارات أجريت على النموذج الأساسي بمحاولة واحدة، نجح Muse Spark 1.2 في إصلاح خطأ في Python، وإعادة هيكلة كود TypeScript، وميزة مستودع JSONL. وبلغ متوسط زمن الاستجابة 12.98 ثانية، وبلغت التكلفة الإجمالية المبلغ عنها $0.045362. لم يتم اختبار موثوقية وكيل Muse Code واستدعاء الأدوات.
كيف يمكن للمطورين الوصول إلى Muse Spark 1.2؟
تذكر «ميتا» ثلاثة مسارات: وكيل المحطة الطرفية «Muse Code» في مرحلة التجربة التجريبية، وواجهة برمجة تطبيقات «Meta Model»، و«OpenRouter». ويستخدم دليل الإرشادات الرسمي عميلاً متوافقاً مع حزمة أدوات التطوير (SDK) OpenAI، وعنوان URL الأساسي هو https://api.meta.ai/v1.