يمكن لنموذج واحد أن يبني المشهد الصوتي بأكمله.
يمكن لبرنامج Seed Audio 1.0 دمج الصوت البشري، والمؤثرات الصوتية، والمؤثرات المحيطة، والتوقيت، والموسيقى الآلية. وقد أظهرت اختباراتنا وجود سقف إبداعي مرتفع بشكل غير معتاد — ومشكلة في قابلية التكرار لا ينبغي تجاهلها.
يُعد «Seed Audio 1.0» أحد أوائل النماذج الصوتية التي اختبرتها والتي يبدو أنها صُممت لتناسب مشهدًا كاملاً بدلاً من نوع واحد من المخرجات. فهو قادر على التحدث، والتمثيل، وإضافة المؤثرات الصوتية المحيطة، وإنشاء مؤثرات فولي، ووضع الحوار على خط زمني، وإنتاج موسيقى آلية، كل ذلك استجابةً لموجهة واحدة.
الحكم الموجز: يتميز برنامج Seed Audio 1.0 بقدرات هائلة غير معتادة في مجال إنتاج الصوت المتكامل، لا سيما فيما يتعلق بالحوار المتزامن والمشاهد الصوتية السينمائية. أما نقطة ضعفه فهي قابلية التكرار. قد يبدو التشغيل الجيد متكاملاً بشكل لافت، في حين أن تشغيلًا آخر استنادًا إلى نفس الموجهات قد يضم كلامًا مشوشًا، أو يغفل حدثًا واحدًا، أو يغير الصوت المطلوب.
قمت بإنشاء 23 عينة مصحوبة بموسيقى تصويرية من خلال بيئة الاختبار Anywhere/BrolyAI. وشملت هذه العينات مجتمعةً السرد، والحوار بين شخصيتين، والكلام المُؤرخ زمنياً، والتسلسلات التي تحتوي على مؤثرات صوتية فقط، والمشاهد التي تجمع بين الصوت والموسيقى، والموسيقى المستقلة، والأداء متعدد اللغات، والمونولوجات التي مدتها دقيقتان، واستكمال المقاطع الصوتية المرجعية.
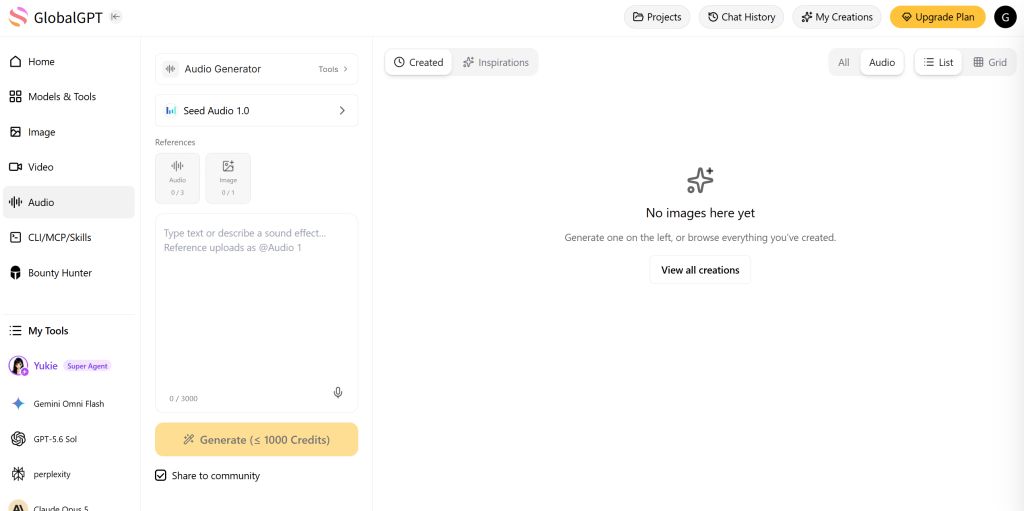
مراجعة برنامج Seed Audio 1.0: الحكم السريع
| الفئة | نتائج الاختبارات التي أجريناها |
|---|---|
| الصوت التعبيري | جودة عالية في أفضل جولة، لكنها غير متسقة عبر الجولات المتكررة |
| حوار متعدد المتحدثين | نصوص دقيقة وفصل قوي بين الأصوات |
| توقيت الحوار | الميزة الأكثر موثوقية في مجموعة الاختبار الخاصة بنا |
| المؤثرات الصوتية | ترتيب واقعي للمساحات والأحداث؛ ضعف في حساب الأعداد الدقيقة للأحداث |
| الصوت + المؤثرات الصوتية + الموسيقى | مشاهد مقنعة تمامًا عندما تتحقق كل الأحداث المطلوبة |
| موسيقى مستقلة | أكثر كفاءة مما كان متوقعًا؛ أنتجت إشارات منظمة مدتها 30 ثانية |
| صوت متعدد اللغات | سيناريو مثالي، لكن إحدى الجولتين تضمنت كلامًا إضافيًا غير موجود في الواقع |
| مقطع صوتي مدته دقيقتان | هوية صوتية قوية وتماسك سردي في كلتا الجولتين |
| الصوت المرجعي | لم تكن موثوقة في موقع الاختبار الخاص بنا؛ وكانت درجة تشابه الصوت ضعيفة |
الأفضل لـ المبدعون الذين يعملون على إنتاج المسرحيات الإذاعية، ومشاهد الألعاب، ومفاهيم البودكاست، والنماذج الأولية السينمائية، واللوحات القصصية التي تعتمد على الصوت في المقام الأول.
أقل ملاءمة لـ: المهام التي تتطلب صياغة حتمية، أو إحصاءات دقيقة للأحداث المتكررة، أو استنساخ صوتي موثوق به من جيل واحد دون تدخل بشري.
ما هو Seed Audio 1.0؟
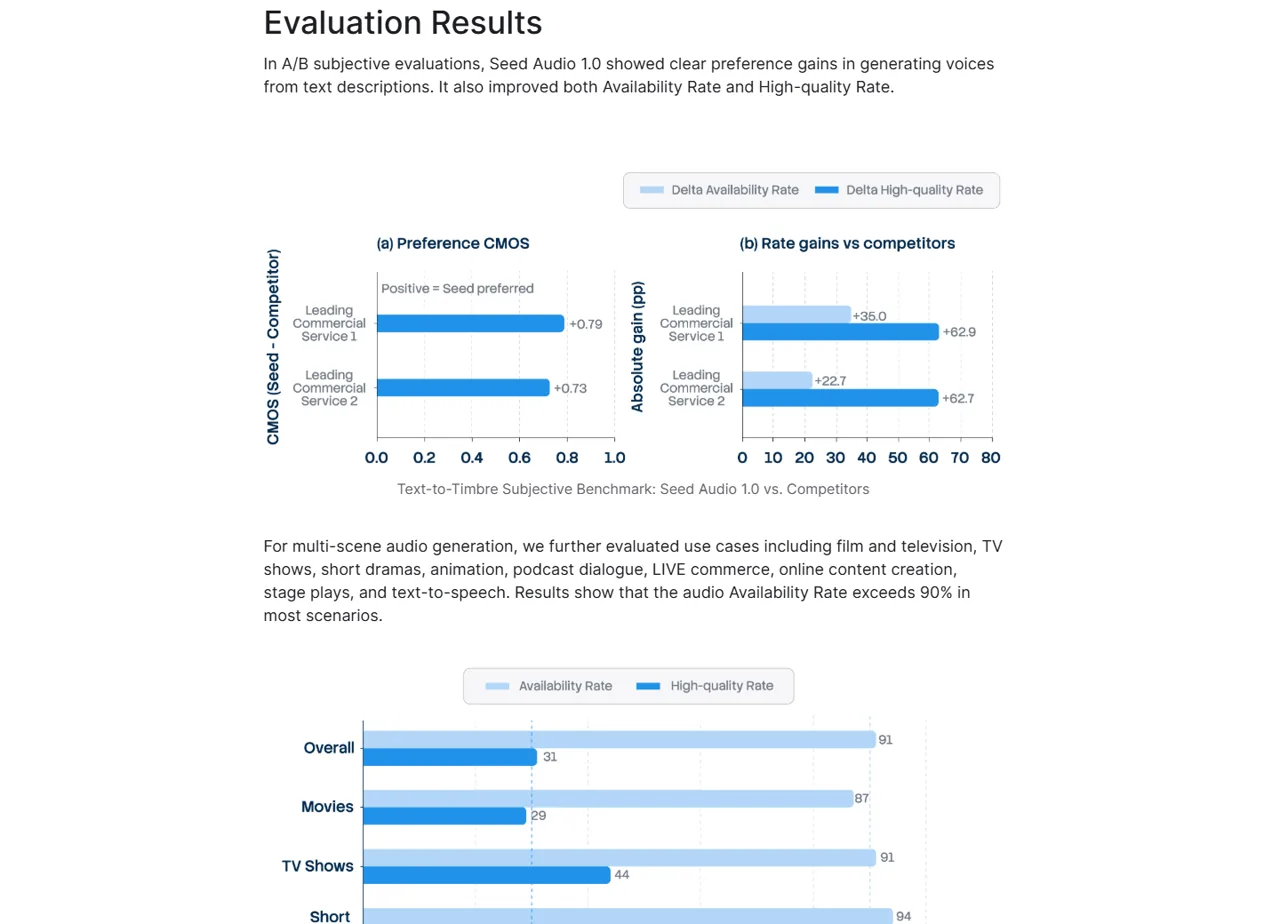
Seed Audio 1.0 هو النموذج الموحد لإنشاء المحتوى الصوتي من النص التابع لشركة ByteDance Seed. وبدلاً من التعامل مع الكلام والمؤثرات الصوتية والموسيقى كعمليات منفصلة، يمكن لهذا النموذج إنتاجها معًا في مشهد صوتي واحد. تشير الصفحة الرسمية للمنتج إلى أنه يدعم توقيت الحوار بفواصل زمنية تبلغ 100 مللي ثانية، ويمكنه إنتاج ما يصل إلى دقيقتين في عملية واحدة.
هذا التصميم الموحد هو عامل الجذب الحقيقي. يمكن أن تصف التوجيهات من يتحدث، وكيف يبدو صوته، وما يحدث في الغرفة، وما هي المؤثرات التي تدخل لاحقًا، ونوع الموسيقى التي تصاحب المشهد. وعندما تسير الأمور على ما يرام، تبدو النتيجة متناغمة وليست مجرد مزيج مركب.
هناك فارق مهم. تشير خارطة الطريق الخاصة بشركة ByteDance إلى أن التوقيت الدقيق يركز حاليًا بشكل أساسي على حوار الشخصيات. أما التحكم الأكثر دقة في المؤثرات الصوتية والأجواء الصوتية والموسيقى، فلا يزال مجالًا يحتاج إلى مزيد من التطوير. وقد أكدت اختباراتنا هذا التمييز: فقد كان توقيت الحوار ممتازًا، في حين كان الدقة في حساب عدد المؤثرات الصوتية أقل موثوقية.
مصادر رسمية تم التحقق منها في 6 أغسطس 2026:
- صفحة منتج Seed Audio 1.0
- تقديم برنامج ByteDance Seed
- وثائق واجهة برمجة التطبيقات (API) لـ BytePlus Audio 1.0
- أسعار BytePlus Audio 1.0
كيف قمنا باختبار Seed Audio 1.0
قمنا بتصميم تسع مهام وأجرينا 23 جولة تقييم. واستخدمت معظم اختبارات الأداء تكرارين أو ثلاثة تكرارات، لأن عينة واحدة مُحسَّنة لا تعطي سوى القليل من المعلومات حول موثوقية الإنتاج.
| اختبار | المهمة | الجولات |
|---|---|---|
| T01 | السرد باللغة الإنجليزية بأسلوب تعبيري | 3 |
| T02 | حوار إذاعي بين شخصيتين | 3 |
| T03 | الحوار عند 0 و4 و9 ثوانٍ | 3 |
| T04 | مشهد في الردهة يعتمد على المؤثرات الصوتية فقط | 2 |
| T05 | الأصوات، والمؤثرات الصوتية المحيطة، والمؤثرات الصوتية الخاصة، والموسيقى | 3 |
| T06 | موسيقى آلية مستقلة | 3 |
| T07 | حرف واحد مشترك بين اللغات الإنجليزية واليابانية والألمانية | 2 |
| T08 | مونولوج في بودكاست مدته 120 ثانية | 2 |
| T09 | استكمال من صوت مرجعي | 2 |
تضمنت النتائج الـ23 المخطط لها حوالي 12.5 دقيقة من الصوت المُنتج، وسُجلت تكلفة إنتاج في المرحلة الأولية بلغت $1.7504 عبر بيئة الاختبار. ولم تُدرج «Seed Audio» بيانات استخدام الرموز النصية. واستندت الفوترة إلى عدد الثواني المُنتجة، لذا تم تسجيل رموز الإنتاج على أنها «غير قابلة للتطبيق».
كانت جميع المخرجات التي تم تقييمها عبارة عن ملفات WAV بتنسيق PCM ستيريو بتردد 40 كيلوهرتز و16 بت. وعندما لم يكن التشغيل الآلي المباشر متاحًا، كان جهاز Gemini 3.6 Flash يستقبل ملفات WAV كمدخلات صوتية ويُرجع نصوصًا منظمة، وفحوصات للأحداث، وتقديرات زمنية، وملاحظات حول التشويشات الصوتية. وتعد هذه الأحكام تقييمات استماع آلية، وليست درجات MOS بشرية.
توليد الصوت: نغمات عالية مذهلة، قابلية تكرار متفاوتة
T01 · السرد التعبيري
تباين كبيركان أحدها عبارة عن خطاب إضافي متخيل، وآخر بدا متكلفًا، أما الثالث فكان طبيعيًا وكاملاً.
الموجه المستخدم
تتلو راوية واحدة بهدوء جملتين متطابقتين، تنتقل خلالهما من القلق إلى الثقة. بدون موسيقى أو مؤثرات صوتية.طلبت تعليمات التسجيل من متحدثة واحدة ذات نبرة هادئة أن تلقي جملتين محددتين، مع الانتقال من القلق المعتدل إلى الثقة المتزايدة، دون أي أصوات في الخلفية.
كانت سلوكيات العمليات الثلاث مختلفة تمامًا:
- الجولة الأولى: ألقى الجملة المطلوبة، ثم تابع بخطاب غير مكتوب ومشوش استمر لعدة ثوانٍ.
- الجولة الثانية: نطق النص بالضبط، لكن نطقه كان بطيئًا ومتقطعًا.
- الجولة الثالثة: أدى النص بالكامل بطريقة طبيعية، مع إتقان الإيقاع واتساق النبرة.
هذا هو النمط الأساسي لهذه المراجعة. يمكن لبرنامج Seed Audio 1.0 تقديم أداء صوتي قوي، لكن التشغيل مرة واحدة لا يكفي للأعمال التي تتطلب دقة في الصياغة. قم بإنشاء بدائل واستمع إلى النص بالكامل قبل النشر.
وقد التزم النموذج بالتعليمات السلبية في جميع الجولات الثلاث للسرد: فلم يتم رصد أي موسيقى أو مؤثرات صوتية أو ضوضاء خلفية غير مرغوب فيها.
الحوار متعدد الشخصيات وفصل المتحدثين
T02 · مسرحية إذاعية من شخصيتين
3/3 نصوص دقيقةكانت النصوص الثلاثة متطابقة تمامًا. أما صوت الغرفة ومدة المقدمة فقد تباينت من لقطة إلى أخرى.
الموجه المستخدم
تهمس مايا، ويجيب إيلي بهدوء، ويصاحب الحوار المكون من ثلاث جمل ثابتة صوت أزيز الثلاجة.تضمنت مشهد متجر البقالة لدينا شخصيتين بالغتين وثلاث جمل ثابتة. كان على مايا أن تهمس بتوتر، بينما حاول إيلي أن يبدو هادئًا. وكان الصوت الخلفي الوحيد المطلوب هو أزيز خفيف صادر عن الثلاجة.
قدمت جميع التجارب الثلاث الحوار بالترتيب الصحيح بصوتين متميزين. أما أفضل تجربة، فقد جمعت بين دقة النصوص، والفصل الواضح بين المتحدثين، والعاطفة المقنعة، بالإضافة إلى أزيز الثلاجة المستمر.
أما المقاطع الأخرى فقد ظهرت فيها مشكلات بسيطة على مستوى المشهد. فقد خصص أحدها ما يقارب النصف الأول من مدته البالغة 30 ثانية للأصوات المحيطة قبل بدء الحوار. أما المقطع الآخر فقد أغفل صوت أزيز الثلاجة المطلوب. لم يؤد أي من هذين الخطأين إلى إفساد المشهد الحواري، لكن كلاهما يقلل من كفاءة عملية المونتاج.
بالنسبة للدراما الصوتية، فإن النتيجة العملية مشجعة: فـ«Seed Audio» تدرك التحولات في شخصيات الشخصيات والتباين الصوتي. وقد تظل بحاجة إلى قص المقدمات الطويلة أو إعادة التوليد للحصول على نغمة الغرفة المناسبة.
كان توقيت الحوار هو النتيجة الأبرز
T03 · توقيت على مستوى المطالبة
الأكثر موثوقيةوقد أسفرت جميع التجارب الثلاث عن وضع الخطوط بالقرب من النقاط المطلوبة ضمن حدود عدم اليقين الزمني للمُقيِّم.
الموجه المستخدم
ضع ثلاثة خطوط راديو عند 0.0 و4.0 و9.0 ثانية مع متحدثين من الذكور/الإناث/الذكور.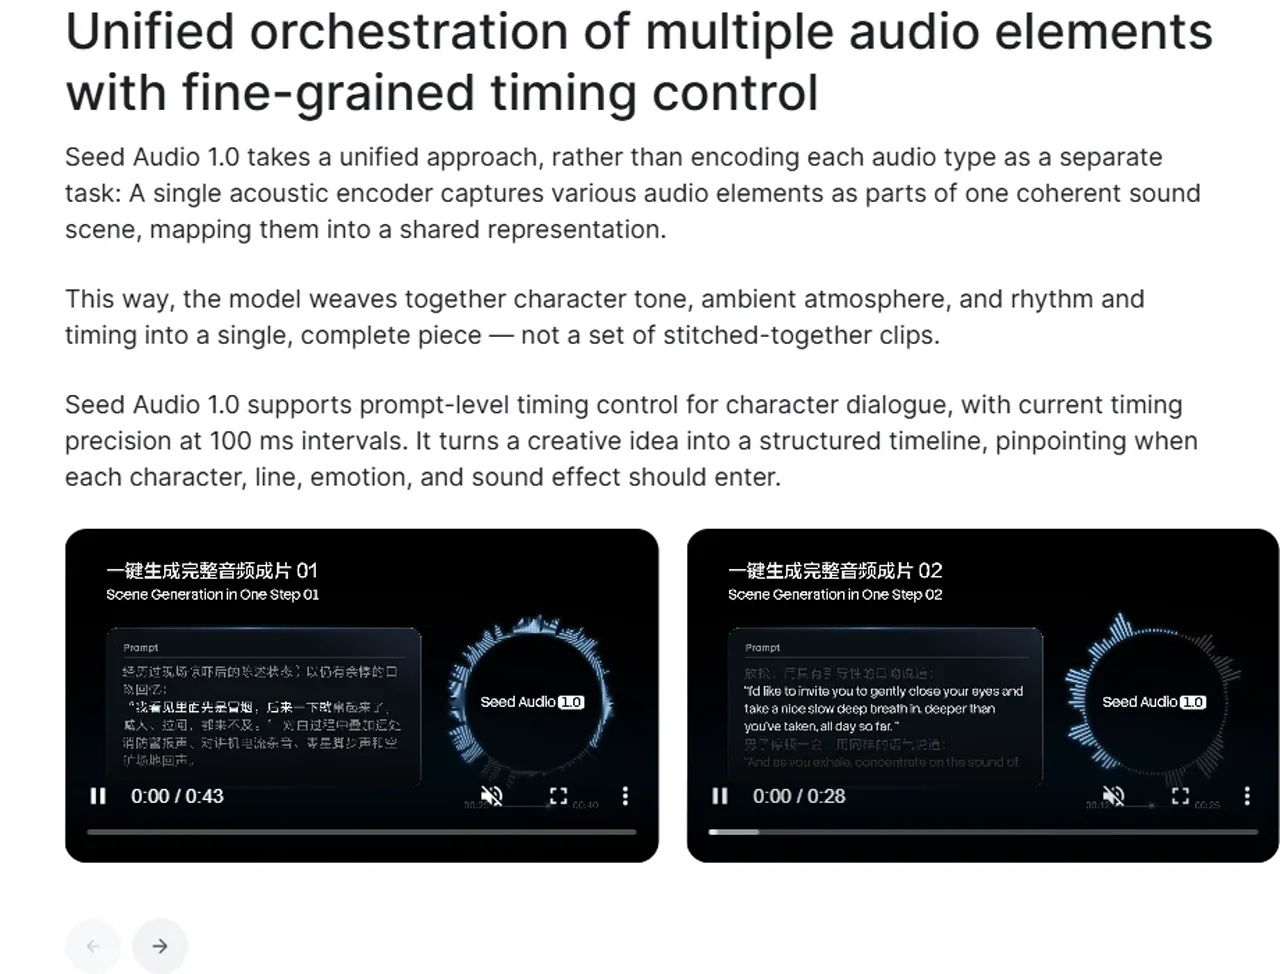
طلب اختبار التوقيت ثلاثة خطوط لاسلكية:
- “الوحدة السابعة، أبلغي عن وضعك.” عند 0.0 ثانية.
- “المدخل الشمالي آمن.” عند 4.0 ثوانٍ.
- “ابقوا في مواقعكم” عند 9.0 ثوانٍ.
في جميع التجارب الثلاث، كانت الخطوط والترتيب ونمط المتحدثين (ذكر-أنثى-ذكر) صحيحة. وقد حددت تقديرات الصوت في Gemini أوقات بدء التجارب المتكررة عند حوالي 0.1 و4.0 و9.0 ثوانٍ. أما الجولة الأولى، فقد قُدرت بـ 0.1 و3.9 و8.9 ثانية تقريبًا.
لا ينبغي تقديم هذه القياسات على أنها دليل بمستوى مختبري يدل على دقة تبلغ 100 مللي ثانية — فقد أشارت أداة التقييم نفسها إلى وجود هامش خطأ يبلغ حوالي 0.1 ثانية. وحتى مع أخذ هذا التحفظ في الاعتبار، كانت هذه هي الميزة الأكثر قابلية للتكرار التي قمنا باختبارها. إذا كنت بحاجة إلى إدخال الحوار في مواضع قريبة من النقاط الزمنية المخطط لها، فإن Seed Audio 1.0 يُعد خيارًا واعدًا بشكل غير عادي.
توليد المؤثرات الصوتية: مشاهد واقعية، عد غير دقيق
T04 · ممر مع مؤثرات صوتية فقط
فشل عملية العدكان المكان والترتيب مقنعين، لكن الجريتين أسفرتا عن أربع خطوات وخطوتين.
الموجه المستخدم
مفاتيح، باب ثقيل، ثلاث خطوات بالضبط، صوت رعد، ثم صوت إغلاق الباب بقوة. لا صوت ولا موسيقى.وصف التوجيه الذي يقتصر على المؤثرات الصوتية فقط ممرًا صغيرًا مبلطًا: مفاتيح بالقرب من الميكروفون، وباب خشبي ثقيل يُفتح، وثلاث خطوات بطيئة تبتعد، ورعد بعيد، وصوت إغلاق باب أخير. وكان الكلام والموسيقى ممنوعين.
وقد نجح كلا المخرجان في خلق مساحة صوتية واقعية، والحفاظ على تسلسل الأحداث، وتجنب تسرب الأصوات أو الموسيقى. ووُصفت التأثيرات بأنها واقعية، مع تناسق جيد في الإحساس بالمسافة وخصائص الغرفة.
لم تتطابق أي من العمليتين مع العدد المحدد بالضبط. فقد أنتجت إحداهما أربع خطوات، بينما أنتجت الأخرى خطوتين. وهذا يجعل «Seed Audio» أداة مفيدة لتوليد مفهوم صوتي مقتنع، لكنها أقل موثوقية عندما يحتاج المحرر إلى ثلاثة أصوات ارتطام أو طرقات أو خطوات أو طلقات نارية بالضبط.
أفضل طريقة للعمل هي استخدام تقنية إنشاء المؤثرات الصوتية (SFX) في مرحلة واحدة لخلق الأجواء ولإنشاء النماذج الأولية بسرعة، ثم استبدال أو تعديل الأحداث التي تتطلب دقة في عدد المرات في برنامج DAW.
الصوت، والمؤثرات الصوتية المحيطة، والمؤثرات الصوتية الخاصة، والموسيقى في مشهد واحد
T05 · المزيج السينمائي الكامل
تم إنجاز 2/3تم إكمال اثنين من أصل ثلاثة مسارات في كل ضربة. وأخفق أحدهما في الضربة المعدنية الأخيرة.
الموجه المستخدم
ممر المطر، حركة المرور، صافرة الإنذار، همسة المحقق، نبض الأوتار، خطوات سريعة، وصوت ارتطام معدني.
كان اختبار المشهد الكامل مزدحماً عن قصد. فقد تضمن زقاقاً ليلياً مبللاً، وقطرات ماء، وحركة مرور، وصفارة شرطة متحركة، وجملة يهمس بها المحقق، وألحان آلات وترية خافتة، وخطوات سريعة، وصوت إغلاق باب معدني.
تضمنت جولتان من أصل ثلاث الجولة تسلسل الأحداث الكامل. ظل الحوار واضحًا فوق أصوات الخلفية والموسيقى، وبدت المشهد متماسكًا من الناحية المكانية، بدلاً من أن يبدو كمقاطع غير مترابطة تم تجميعها معًا. أما في إحدى الجولات، فقد غاب الصوت المعدني النهائي، على الرغم من أنها نجحت في خلق الجو المناسب وإعادة الخطاب المنطوق بدقة.
وهنا يبرز النموذج الموحد بأقوى صورة له. ففيما يتعلق بتصميم القصص المصورة وابتكار الأفكار الإبداعية، فإن إنشاء مشهد مختلط كامل انطلاقًا من موجه واحد يكون أسرع وأكثر تعبيرًا من الحصول على كل مكون على حدة. أما بالنسبة للإنتاج النهائي، فلا تزال الإشارات النهائية المهمة بحاجة إلى التحقق منها.
هل يمكن لبرنامج Seed Audio 1.0 إنتاج موسيقى؟
T06 · موسيقى مستقلة
المؤلفات الموسيقيةوقد ابتكر الثلاثة جميعًا موسيقى منظمة. وكان أحدهم قد جعل من الصعب تمييز صوت البيانو المكتوم.
الموجه المستخدم
مقطوعة موسيقية تشويقية بمعدل 72 نبضة في الدقيقة، تتضمن نغمة متكررة على التشيلو، وبيانو مع كاتم الصوت، ونغمة طنين تناظرية، وتصعيد موسيقي، ونهاية غير حاسمة.
نعم. في الاختبارات التي أجريناها، أنتج برنامج Seed Audio 1.0 موسيقى آلية مستقلة يمكن التعرف عليها، بدلاً من مجرد نسيج صوتي محيطي غامض.
طلبت التعليمات إنتاج مقطع موسيقي تشويقي مدته 30 ثانية بمعدل 72 نبضة في الدقيقة (BPM)، يتضمن نغمة متكررة منخفضة على التشيلو، ونبضات هادئة على البيانو مع كاتم الصوت، ونغمة طنينية تناظرية ناعمة، وتصعيدًا واضحًا، ووترًا نهائيًّا غير مكتمل. وشكلت جميع المقاطع الثلاثة مقطعًا موسيقيًّا متماسكًا يتمتع بالإحساس الإيقاعي المطلوب والنهاية المطلوبة. تضمنت اثنتان من المحاولات جميع العناصر المطلوبة؛ أما في إحدى المحاولات، فقد كان من الصعب تمييز صوت البيانو المكتم.
وهذا لا يعني تلقائيًّا أن برنامج «Seed Audio» يمكن أن يحل محل أداة مخصصة لتوليد الأغاني. فقد كانت مهمتنا هي إنتاج مقطع موسيقي سينمائي قصير بدون كلمات، وليس أغنية تتألف من مقاطع وكورس مع كلمات. ومع ذلك، فإن قدرات البرنامج الموسيقية كبيرة بما يكفي لدعم مشاهد الألعاب، والمقاطع الدعائية، والبودكاست، والتصور المسبق — لا سيما عندما يتعين أن تتفاعل الموسيقى مع الكلام وتصميم الصوت في نفس عملية التوليد.
الأداء متعدد اللغات: ممتاز في أفضل الأحوال، ضعيف في أسوأ الأحوال
T07 · صوت واحد، ثلاث لغات
1/2 نظيفكانت إحدى المرات خالية من الأخطاء؛ أما الأخرى فقد تكرر فيها الكلام وظهرت فيه هذيانات عند التبديل بين اللغتين.
الموجه المستخدم
تتحدث إحدى الشخصيات النسائية الإنجليزية واليابانية والألمانية بنفس الأسلوب وبنفس الهدوء العاطفي.
طلبت المهمة متعددة اللغات من إحدى الشخصيات النسائية أن تؤدي نفس الدور في غرفة التسجيل باللغات الإنجليزية واليابانية والألمانية. وأسفرت التجربتان عن انطباعات متناقضة.
قدمت المحاولة الأفضل العبارات الثلاث بدقة، وحافظت على نفس النبرة، واتبعت نبرة هادئة، واستخدمت فواصل واضحة. أما المحاولة الأضعف، فقد بدأت بشكل صحيح باللغة الإنجليزية، ثم تكرر الكلام و«هذى» عند الجزء الياباني، وأفسدت مقدمة النص الألماني. وانخفضت بشكل حاد درجة اتساق النبرة الملحوظة عبر اللغات.
وهذا يعني أن برنامج Seed Audio 1.0 قادر على تقديم أداء مقنع للشخصيات متعددة اللغات، لكن هذه الميزة تتطلب وجود عدة مرشحين ومراجعة تراعي الخصائص اللغوية. لا تقم بالموافقة على الناتج متعدد اللغات بمجرد التحقق من اللغة الأولى فقط.
إنشاء محتوى في دقيقتين واستقرار الصوت في المحتوى الطويل
T08 · مونولوج مدته 120 ثانية
2/2 مستقربلغت مدة كلا الملفين 120 ثانية بصوت واحد ثابت. أما أحدهما فقد احتوى على تعثر بسيط في النطق.
الموجه المستخدم
يروي مقدم بودكاست واحد قصة منظمة عن محطة أرصاد جوية تتضمن ثلاثة اكتشافات دون أي معلومات أساسية.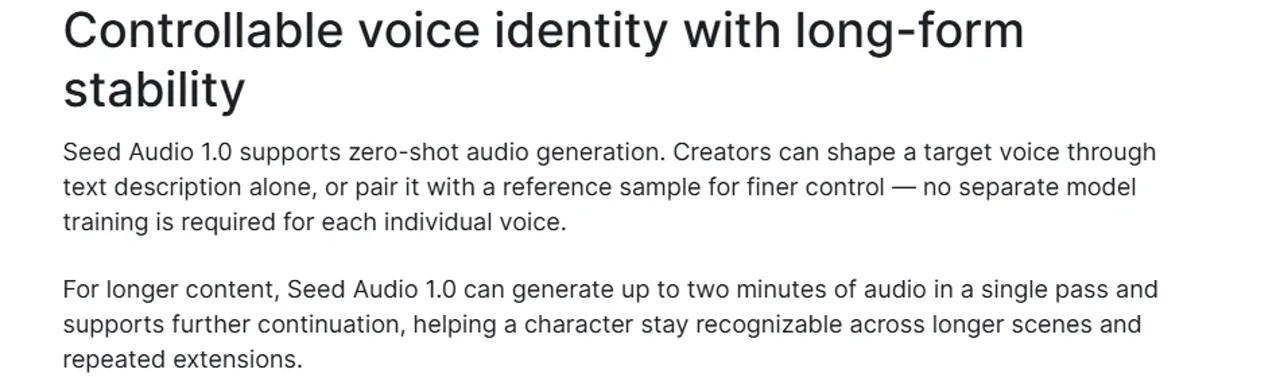
أنتجت كلتا المهمتين الطويلتين ملفات WAV مدتها 120 ثانية بالضبط. واستخدمت كل منهما صوت مقدم بودكاست واحد من الذكور مع صوت استوديو عادي، بدون موسيقى وبدون مؤثرات صوتية.
حافظت النسخة الأولى على صوت واحد وبنية تحقيقية متماسكة طوال النص: مقدمة واضحة، وثلاثة اكتشافات مرتبة ترتيباً زمنياً، وانتقال من الفضول إلى القلق، وسؤال أخير لم يُحل. ولم يُكتشف أي انحراف واضح في الصوت أو أي مقطع مشوش.
كان التسجيل الثاني متماسكًا ومستقرًا بالمثل، مع تعثر لغوي قصير عند حوالي 1:31. وهذه نتيجة قوية بالنسبة لمونولوج مدته دقيقتان تم تسجيله في مرة واحدة. ويشير ذلك إلى أن ادعاء «Seed Audio» بشأن «الشكل الطويل» لا يقتصر على مجرد حد زمني؛ بل إن النموذج قادر على الحفاظ على الهوية والبنية السردية طوال المدة الكاملة.
يتعين توخي الحذر عند التعامل مع استمرارية الصوت المرجعي
T09 · استمرار المرجع
المسار غير مؤكدكان النص دقيقًا، لكن تشابه الصوت كان ضعيفًا؛ فقد تم تغيير أحد المخرجات إلى صوت ذكوري وإضافة مؤثرات صوتية.
الموجه المستخدم
الاستمرار من تسجيل صوتي نسائي معتمد مع الحفاظ على هوية الصوت وأسلوب التسجيل الحميمي.استخدم الاختبار المرجعي أقوى عينة سردية كمدخل معتمد، وطلب استكمالًا بنفس الهوية الأنثوية العامة ونفس أسلوب التسجيل الحميمي.
كان كلا الناتجين يتلقيان النص المطلوب بالضبط، لكن لم يتطابق أي منهما جيدًا مع النموذج المرجعي. فقد تحول الناتج الأول إلى همسة كاملة مصحوبة بصوت تنفسي، وحصل على درجة متحفظة في تشابه الصوت بلغت 2/5. أما الناتج الثاني، فقد تم تقييمه على أنه يستخدم صوتًا ذكوريًّا، وحصل على درجة 1/5 في التشابه، كما أضاف ما يقارب 17 ثانية من المؤثرات الصوتية غير المرغوب فيها قبل بدء الكلام.
هناك قيد مهم يتعلق بالموقع هنا. فقد قبلت نقطة نهاية مهمة «Anywhere» الحقل المرجعي، لكنها لم تُرجع تأكيدًا يوضح كيف استخدم النموذج الأعلى هذا المرجع. وتُثبت هذه النتائج أن استمرارية المرجع لم تكن موثوقة عبر مسار الاختبار الذي اتبعناه؛ وهي لا تثبت أن واجهة برمجة التطبيقات الأصلية لـ BytePlus تتصرف دائمًا بنفس الطريقة.
أسعار وقيود برنامج Seed Audio 1.0
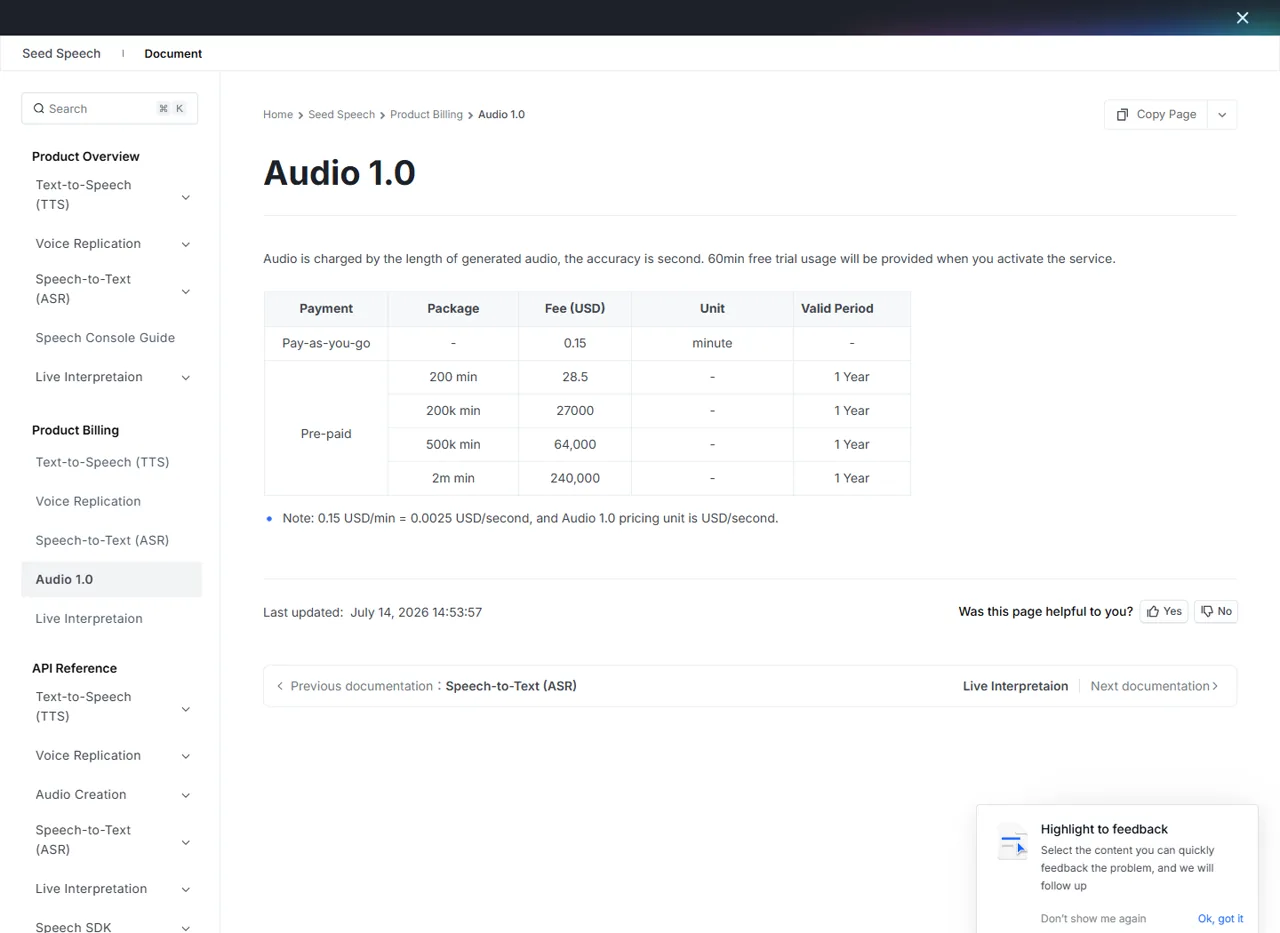
يتم احتساب التكلفة بالثانية، مع 60 دقيقة تجريبية مجانية عند تفعيل الخدمة.
القدرة القصوى
أحرف المطالبة
مراجع صوتية
صورة مرجعية
تُدرج BytePlus السعر الرسمي لنظام الدفع الفوري عند $0.15 لكل دقيقة مُولَّدة, ، تُحسب الفاتورة بالثانية، مع 60 دقيقة تجريبية مجانية عند تفعيل الخدمة. تحدد وثائق واجهة برمجة التطبيقات (API) القدرة القصوى لمدة 120 ثانية, ، يدعم المطالبات حتى 3,000 حرف, ، يسمح بما يصل إلى ثلاثة مقاطع صوتية مرجعية, ، ويقبل صورة مرجعية واحدة.
يمكن أن تصل مدة كل مقطع صوتي مرجعي إلى 30 ثانية وحجمه إلى 10 ميغابايت. أما الحد الأقصى لحجم الصورة المرجعية فهو 10 ميغابايت. هذه هي الحدود المحددة من قبل BytePlus نفسها؛ وقد تعرض المنصات الخارجية نماذج إدخال أصغر حجمًا أو تطبق أسعارًا مختلفة.
أظهر مسار الاختبار الخاص بنا «Anywhere/BrolyAI» تكلفة الإرسال بشكل منفصل، وبلغ متوسطها حوالي $0.14 لكل دقيقة مُولَّدة. ولا ينبغي الخلط بين هذا الحقل الخاص ببيئة الاختبار وأسعار التجزئة لدى BytePlus أو السعر النهائي لأي منصة أخرى.
إيجابيات وسلبيات برنامج Seed Audio 1.0
مواطن تميزه
- الصوت الموحد، والمؤثرات الصوتية، والمؤثرات المحيطة، والموسيقى
- توقيت حوار ممتاز
- هوية قوية ذات طابع موسع
- موسيقى سينمائية مفيدة
المكان الذي ينكسر فيه
- تباين كبير بين القراءات
- تشوش في الكلام من حين لآخر
- العد الدقيق الضعيف لـ SFX
- عدم موثوقية استمرارية المراجع في مسارنا
الإيجابيات
- يُنتج الأصوات، والمؤثرات الصوتية المحيطة، ومؤثرات فولي، والموسيقى في عملية واحدة.
- توقيت الحوار كان ممتازًا في الاختبارات المتكررة التي أجريناها.
- فصل قوي بين مكبري الصوت ومعالجة دقيقة للنص.
- تنتج موسيقى سينمائية مفيدة يمكن استخدامها بشكل مستقل.
- يحافظ على هوية الصوت وتماسك السرد طوال دقيقتين.
- يُخرج ملف WAV ستيريو نقي بتردد 40 كيلوهرتز عبر مسار الاختبار الخاص بنا.
السلبيات
- قد تختلف نتائج التشغيلات المتكررة بشكل كبير من حيث مدى طبيعيتها وموثوقيتها.
- كلام متقطع أو مشوش في بعض الأحيان.
- لا يمكن الاعتماد على الأرقام الدقيقة الخاصة بتأثيرات الصوت.
- تفتقد بعض المشاهد الكاملة الحدث النهائي المطلوب.
- تحتاج العروض متعددة اللغات إلى مراجعة دقيقة.
- كانت استمرارية الصوت المرجعي ضعيفة في بيئة الاختبار الخاصة بنا.
- أدى الإرسال المتوازي المكثف إلى حدوث أخطاء في التزامن في المراحل الأولية، على الرغم من أن المهام التي فشلت لم يتم احتساب تكاليفها.
من ينبغي أن يستخدم Seed Audio 1.0؟
يُعد برنامج Seed Audio 1.0 خيارًا مثاليًّا لمنشئي المحتوى الصوتي الذين يفكرون في «المشاهد» بدلاً من «العناصر المنفصلة». وهو مفيد بشكل خاص في مجال الدراما الإذاعية، وحوارات الألعاب، والنماذج الأولية السينمائية، واللوحات القصصية الصوتية، ومفاهيم البودكاست، والمقاطع الصوتية القصيرة المثيرة للتشويق.
وهو أقل إقناعًا كنظام للتسليم النهائي بنقرة واحدة. فإذا كانت الصياغة الدقيقة، أو هوية الصوت، أو عدد الأحداث أمورًا حاسمة من الناحية القانونية أو الإبداعية، فيجب التخطيط لإجراء عمليات إنتاج متكررة ومراجعة بشرية. يعمل هذا النموذج بشكل أفضل عندما تعامله على أنه «مخرج صوتي سريع» مع عدة لقطات — وليس كأداة عرض حتمية.
الأسئلة الشائعة
هل «Seed Audio 1.0» نموذج لتحويل النص إلى كلام؟
هل يمكن لبرنامج Seed Audio 1.0 إنتاج مؤثرات صوتية بدون كلام؟
هل يمكن لبرنامج Seed Audio 1.0 إنتاج موسيقى؟
إلى متى يمكن لبرنامج Seed Audio 1.0 أن يستمر في إنتاج الصوت؟
هل يدعم برنامج Seed Audio 1.0 الصوت المرجعي؟
كم يبلغ سعر برنامج Seed Audio 1.0؟
الحكم النهائي
يُعد «Seed Audio 1.0» نموذجًا صوتيًا موحدًا مثيرًا للاهتمام حقًّا. فالقدرة على إنتاج كلام مقنع، ومؤثرات صوتية، وأصوات محيطة، وموسيقى من موجه واحد ليست مجرد ادعاء ترويجي: فقد أظهرت اختباراتنا التي شملت مشاهد مختلطة وموسيقى أن هذه العناصر يمكن أن تعمل معًا.
كانت أفضل ميزة فيه هي توقيت الحوار. أما أكبر نقطة ضعف فيه فكانت الاتساق. ففي 23 عينة، أظهر النموذج مرارًا وتكرارًا نتيجة ممتازة في أفضل الأحوال، ونتيجة بديلة أضعف بشكل ملحوظ.
فيما يتعلق بإنشاء النماذج الأولية الإبداعية، من السهل قبول هذه المقايضة. قم بإنشاء عدة نسخ، واحتفظ بأفضلها، وافحص كل نهاية. أما في حالة الإنتاج الحتمي، أو المطابقة الصوتية الدقيقة، أو الأعمال التي تعتمد على عدد الأحداث، فاحرص على تضمين مرحلة المراجعة والتحرير البشري في سير العمل.
الحكم النهائي: يُعد برنامج Seed Audio 1.0 أحد أكثر برامج توليد الصوت على مستوى المشهد كفاءةً التي قمنا باختبارها، لكن من الأفضل استخدامه كأداة إبداعية متعددة اللقطات بدلاً من كونه أداة عرض نهائية تعتمد على لقطة واحدة.