

L'identifiant du modèle API GPT-6.1 Terra est gpt-6.1-terra. Aux tarifs standard, OpenAI correspond à $1 par million de jetons d'entrée, $0,05 pour les entrées mises en cache, $1,25 pour une écriture dans le cache toutes les 30 minutes, $2,50 pour une écriture dans le cache toutes les 12 heures et $5 pour les sorties. Le modèle accepte du texte et des images, renvoie du texte, expose une fenêtre de contexte de 1 050 000 jetons et prend en charge l'appel d'outils via l'API Responses.
La tarification semble simple jusqu’à ce que l’on prenne en compte la mise en cache, les niveaux de service, le traitement régional et la règle relative aux contextes de plus de 272 000. Ce guide transforme les tarifs officiels en formules reproductibles, présente les limites documentées pour les opérations « Build » et « Launch », et distingue la facturation officielle via l’API OpenAI de celle via l’espace de travail GlobalGPT. Les informations ont été vérifiées par rapport au page officielle du modèle GPT-6.1 Terra et Tarification de l'API OpenAI le 27 octobre 2026.
Réponse rapide de l'API GPT-6.1 Terra
Identifiant et points de terminaison du modèle API GPT-6.1 Terra
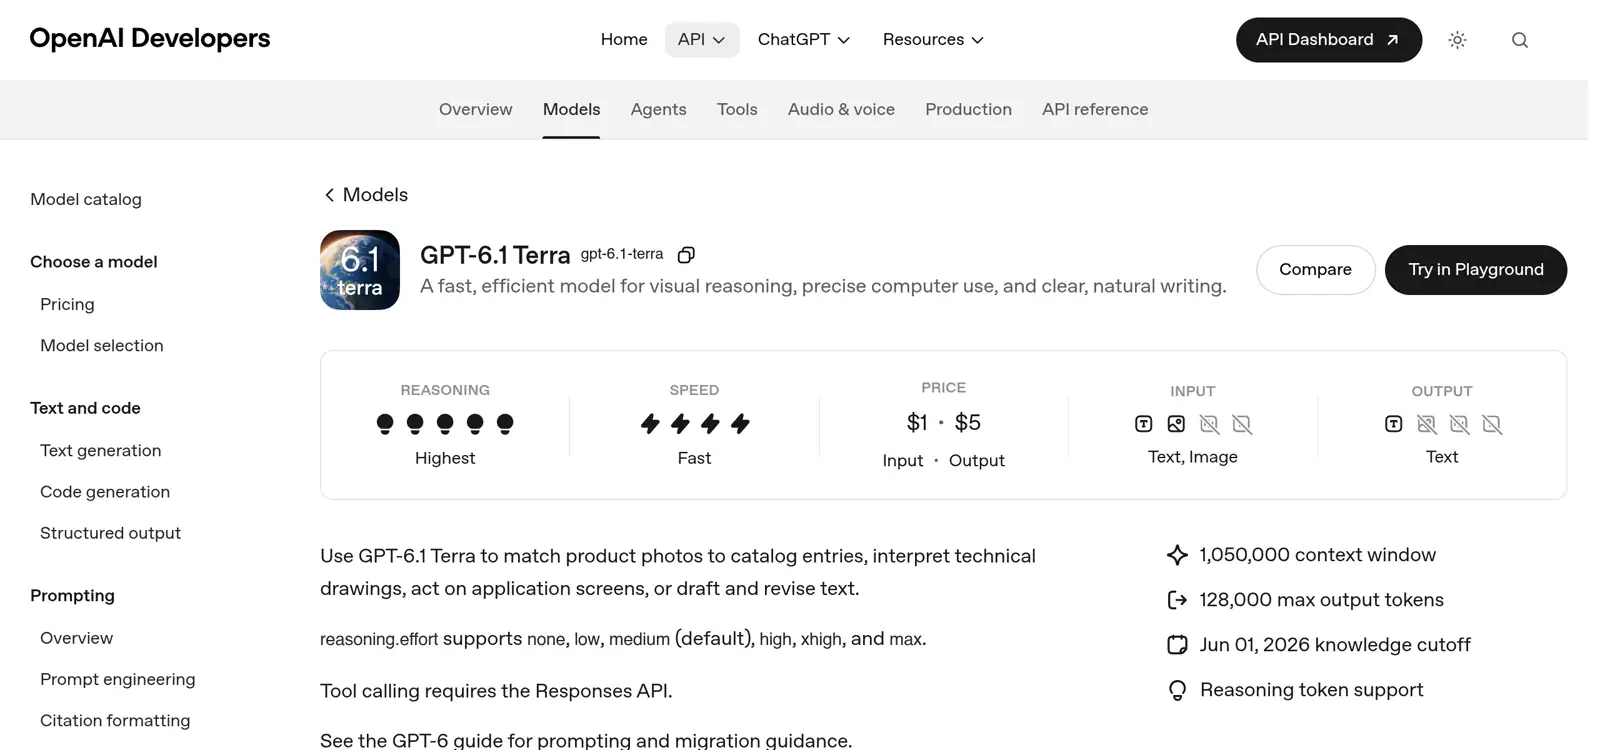
Utilisez la chaîne de modèle exacte dans chaque requête. Les noms de famille similaires ne constituent pas des alias : gpt-6.1-sol est un produit différent, avec un positionnement et des prix différents. Le OpenAI journal des modifications du développeur présente la version de Terra sortie le 26 octobre, tandis que la page de présentation la décrit comme une solution rapide et efficace pour le raisonnement visuel, une utilisation précise de l'ordinateur et une écriture claire et naturelle.
Si une application doit acheminer des requêtes entre Terra et Sol, précisez quelles requêtes nécessitent effectivement L'approche plus approfondie de Sol en matière de raisonnement et de programmation avant la mise en œuvre, plutôt que d'envoyer chaque tâche vers le modèle plus coûteux.
Pour les nouvelles applications utilisant des outils, l’API « Responses » constitue la valeur par défaut la plus pratique. La page officielle du modèle répertorie les « Responses » avec appel d’outils et les « Chat Completions » sans appel d’outils. Cette distinction est importante pour les agents qui appellent des fonctions, recherchent des fichiers, explorent le Web, exécutent du code, utilisent un shell hébergé, appliquent des correctifs, invoquent des compétences ou interagissent avec des outils informatiques. Une tâche de génération de texte brut peut toujours utiliser les « Chat Completions », mais mélanger les deux approches sans consigner le point de terminaison rend les évaluations plus difficiles à reproduire.
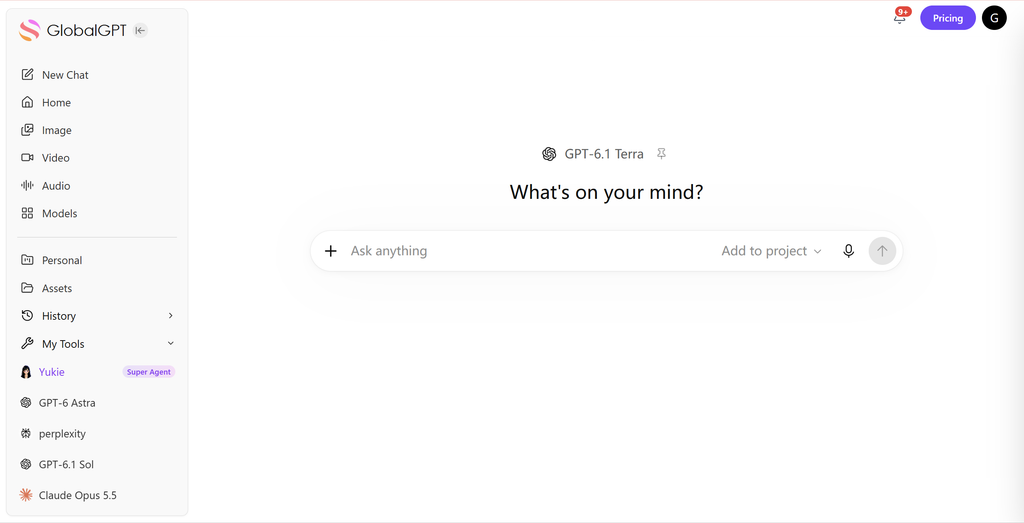
Terra soutient les initiatives en matière de raisonnement menées par aucun à travers max, avec moyen documenté comme valeur par défaut. Ne partez pas du principe qu’une passerelle ou un espace de travail multimodèle a conservé le paramètre que vous avez demandé, à moins que la réponse ou les métadonnées de l’itinéraire ne le prouvent. Dans notre itinéraire de test alternatif GlobalGPT, l’interface a indiqué que la réflexion approfondie était désactivée, mais n’a pas affiché de champ distinct dédié à l’effort de raisonnement ; l’effort exact n’a donc pas pu être vérifié.
Tarifs standard de GPT-6.1 Terra
Chaque compteur est indépendant. Une requête peut inclure simultanément des entrées non mises en cache, des entrées mises en cache, une écriture dans le cache et des sorties. Multipliez le nombre de jetons par son propre tarif par million, puis additionnez les différents éléments. Les frais spécifiques aux outils, au stockage, au réseau et tout abonnement au niveau du produit sont distincts de cette formule de calcul des jetons. Les tarifs officiels correspondent aux prix de l'API et ne constituent en aucun cas une garantie quant au montant débité affiché par un espace de travail tiers.
Les tarifs standard de Terra correspondent à la moitié des prix pratiqués par GPT-6.1 Sol pour les entrées $2 et les sorties $10. Ces informations constituent un contexte utile pour les équipes qui choisissent un modèle par défaut, mais la qualité du modèle continue d'influencer le coût total par résultat accepté. Utilisez les mêmes invites et les mêmes critères d'acceptation pour tester où Terra permet de faire des économies, tandis que Sol tire ses revenus de sa prime au lieu de se baser uniquement sur le prix du jeton.
Mode standard vs modes Batch, Flex et Fast
Les modes « Batch » et « Flex » divisent par deux les tarifs applicables aux jetons ; le mode « Fast » les double. Appliquez systématiquement le multiplicateur de niveau à chaque composant du jeton avant d’ajouter le traitement régional facultatif. Une tâche standard $0.10 devient environ $0.05 en mode Batch ou Flex et $0.20 en mode Fast, en supposant la même composition de jetons et l’absence de contexte long ou d’ajustement régional. L’éligibilité, le comportement de mise en file d’attente et les caractéristiques de latence dépendent toujours de l’itinéraire choisi.
Ne confondez pas les calculs relatifs aux niveaux de service avec les affirmations concernant la qualité des modèles. Un traitement plus rapide ne signifie pas qu’un autre modèle est plus performant, et un prix « Batch » inférieur ne garantit pas que la tâche sera terminée dans un délai interactif. Enregistrez le niveau de service réel renvoyé par l’API. Notre parcours de test GlobalGPT n’en a pas révélé, de sorte que les frais de plateforme indiqués ne peuvent pas être convertis en un débit officiel au tarif Standard.
Avant de transférer toutes les demandes de faible priorité vers Batch, vérifiez si GPT-6 Luna répond déjà aux critères d'acceptation pour des tâches courtes et bien délimitées, pour lesquelles Terra pourrait encore s'avérer plus sophistiqué que nécessaire.
Mise en cache des requêtes : lectures, écritures et durée de conservation
Une entrée mise en cache à $0,05 par million de jetons ne représente que 5% d’entrée ordinaire, mais la création de l’entrée réutilisable coûte plus cher : $1,25 par million de jetons pour 30 minutes ou $2,50 pour 12 heures. Un préfixe stable doit être réutilisé suffisamment de fois pour amortir cette écriture. L'écriture à courte durée de conservation atteint le seuil de rentabilité après environ 1,26 lecture ordinaire évitée ; l'écriture de 12 heures en nécessite environ 2,63. Les requêtes réelles incluent des suffixes et des sorties non mis en cache ; il convient donc de mesurer les appels complets plutôt que de ne citer que le préfixe.
Concevez une invite pouvant être mise en cache en plaçant en premier lieu les éléments volumineux et stables : politiques, schémas, normes de codage, catalogues de produits ou corpus de référence partagé. Placez ensuite les instructions spécifiques à la requête. Veillez à ce que le préfixe reste stable au niveau des octets, enregistrez un hachage et vérifiez l’utilisation des jetons mis en cache renvoyés. Si votre application modifie continuellement le préfixe, un compteur d’écritures en cache peut augmenter plutôt que réduire le coût effectif.
La règle du « contexte long de plus de 272 000 »
La fenêtre de contexte principale de Terra est de 1,05 million de jetons, mais la tarification change avant d’atteindre cette limite. Lorsque l’entrée dépasse 272 000 jetons, OpenAI applique des taux d’entrée et de mise en cache multipliés par 2, ainsi que des taux de sortie multipliés par 1,5 à l’ensemble de la requête. Une requête de 273 000 jetons n’est donc pas facturée au tarif normal pour les 272 000 premiers jetons, et ne fait l’objet d’un supplément que sur les 1 000 derniers. L’appel dans son intégralité passe dans la tranche tarifaire supérieure.
Cette étape permet d'assurer le contrôle financier de la récupération et de la compression. Supprimez les passages standardisés en double, l'historique des conversations obsolètes et les extraits récupérés de faible valeur avant l'envoi. Si une requête se situe à la limite, calculez les deux fourchettes et déterminez si le contexte supplémentaire améliore suffisamment l'acceptabilité pour justifier le passage à la fourchette supérieure. Une large fenêtre contextuelle correspond à la capacité disponible ; il ne s'agit pas d'une recommandation de la remplir.
Pour une tâche à contexte long qui échoue toujours après le nettoyage des données récupérées et l'amélioration des instructions, utilisez l'erreur exacte pour vérifier si GPT-6 Astra comble l'écart de qualité avant de passer à une version définitive du modèle. La question est de savoir si le modèle plus performant corrige l'erreur mesurée, et non s'il occupe une place plus élevée dans la hiérarchie des modèles.
Traitement régional et champ d'application des données
Le code OpenAI correspond à une majoration de traitement régional de 10% lorsque cette option est disponible. Il convient de l'appliquer une fois que les tarifs liés au modèle, au contexte et au niveau de service ont été déterminés. Un travail « Standard » dont le tarif est calculé à $0,20 passe à $0,22 avec la majoration ; un travail « Batch » dont le tarif est calculé à $0,10 passe à $0,11. Le guide officiel sur les contrôles des données C'est ici que vous pouvez vérifier la disponibilité et les conditions d'accès au programme de résidence pour votre organisation.
Le traitement régional ne constitue pas une taxe générale appliquée à chaque requête Terra. Il ne s'applique que lorsque l'itinéraire régional éligible est sélectionné. Veillez à le faire apparaître clairement sur une ligne distincte afin que le service des achats puisse distinguer les exigences relatives à l'emplacement des données du coût du modèle. La même distinction doit être appliquée aux frais d'outils et à l'accès GlobalGPT, qui ne figurent pas dans le tableau officiel des jetons Terra.
Limites de débit de GPT-6.1 Terra
La page du modèle consultée indique également des files d'attente par lots de 3 000 000 de jetons pour « Build » et de 200 000 000 de jetons pour « Launch ». Ces chiffres correspondent aux niveaux de compte documentés, et non à un débit garanti pour chaque organisation. Les limites peuvent s’appliquer à l’échelle des projets ou des organisations, et une requête peut atteindre en premier lieu la limite RPM, la limite TPM ou la capacité de la file d’attente, selon sa nature.
Concevez en tenant compte de ces trois contraintes. De courtes échanges peuvent épuiser le quota de requêtes par minute tout en utilisant peu de capacité de jetons. Les traitements de documents volumineux peuvent épuiser le quota de jetons par minute avec relativement peu d’appels. Les charges de travail par lots peuvent saturer la file d’attente même lorsqu’aucune requête interactive n’est envoyée. Ajoutez un recul exponentiel en cas d’erreurs de débit transitoires, respectez les recommandations du serveur en matière de réessais et limitez le nombre de réessais afin qu’un workflow défaillant ne puisse pas créer une boucle de coûts accidentelle.
Ce qu'a réellement révélé notre test d'utilisation de l'API
Une requête pré-générée compatible avec le format OpenAI a été rejetée avant l'inférence avec un code HTTP 402. Échec de la consommation du quota de jetons. Il indiquait un quota restant de $0,006048 pour une exigence de pré-consommation de $0,012676. L'appel n'ayant jamais été exécuté, cet événement ne correspond pas à un résultat de la fonctionnalité Terra et l'exigence ne constitue pas un débit vérifié de manière indépendante. Nous avons ensuite utilisé une route GlobalGPT authentifiée, configurée pour gpt-6.1-terra afin de préserver les éléments de preuve exploitables issus des essais.
Les trois appels de routage ont été effectués, mais la réponse n'a pas confirmé la présence d'un flux en amont response.model ou niveau de service. L'itinéraire a indiqué un montant total facturé de 0,016076 dans le champ de facturation de sa propre plateforme. Nous ne convertissons pas cette valeur en dollars officiels de l’API. Le résultat exploitable est plus restreint : les données brutes d’utilisation comprenaient les champs « prompt », « completion », « total » et « cached-prompt », et les calculs générés par le modèle correspondaient aux tarifs officiels fournis.
Exemples de coûts liés à GPT-6.1 Terra
L'exemple du document long applique un facteur de 2× à l'ensemble des 300 000 tokens d'entrée et un facteur de 1,5× à l'ensemble des 10 000 tokens de sortie : 300 000 / 1 000 000 × $2 équivaut à $0,60, et 10 000 / 1 000 000 × $7,50 équivaut à $0,075. Les appels d’outils et le traitement régional sont exclus. Si le même travail peut s’exécuter en mode batch, le total des jetons éligibles tombe à environ $0,3375.
Pour un workflow mis en cache, ajoutez le coût d'écriture dans le cache lors de l'appel qui crée l'entrée, puis utilisez le prix de l'entrée mise en cache uniquement pour les jetons que l'API signale effectivement comme étant mis en cache. Les équipes qui migrent depuis d'anciens modèles doivent reconstruire le modèle de coût à partir du Référence GPT-5.6 plutôt que de transférer d'anciens multiplicateurs ou identifiants de modèles dans une estimation Terra.
Lorsque les achats doivent également respecter un plafond budgétaire de référence, évaluez la même charge de travail représentative à Tarifs de l'API GPT-6 Astra. Le fait de se baser sur une seule charge de travail et un seul test de réception rend cette comparaison des tarifs plus pertinente que la simple juxtaposition de prix catalogue sans rapport les uns avec les autres.
Calculateur de coût GPT-6.1 Terra à copier
Ce calculateur considère la règle documentée « plus de 272K » comme un multiplicateur de la requête complète et maintient explicitement la majoration régionale. Il n'inclut pas les frais liés à la recherche sur le Web, au stockage, à l'interpréteur de code ou à d'autres outils. Pour la facturation en production, comparez les estimations avec les données d’utilisation réelles et la facture officielle du compte, plutôt que d’utiliser les calculs générés par le modèle comme registre comptable.
FAQ sur l'API GPT-6.1 Terra
Quel est l'identifiant du modèle API GPT-6.1 Terra ?
Utilisez « gpt-6.1-terra ». Veillez à conserver exactement cette chaîne de caractères dans les requêtes, les journaux, les évaluations et les exportations de facturation afin que les résultats ne soient pas confondus avec ceux de GPT-6.1 Sol ou d'un modèle Terra plus ancien.
Combien coûte le GPT-6.1 Terra ?
Aux taux standard, la valeur d'entrée est $1, l'entrée mise en cache est de $0,05, une écriture en cache toutes les 30 minutes est de $1,25, une écriture en cache toutes les 12 heures est de $2,50, et la sortie est de $5 par million de jetons.
GPT-6.1 Terra prend-il en charge l'API Responses ?
Oui. Le document OpenAI décrit la prise en charge de l'API Responses avec l'appel d'outils. La fonctionnalité « Chat Completions » est également prise en charge, mais sans appel d'outils pour ce modèle.
Qu'est-ce que la fenêtre de contexte de GPT-6.1 Terra ?
OpenAI spécifie une fenêtre de contexte de 1 050 000 tokens et jusqu'à 128 000 tokens en sortie. Aucune valeur maximale distincte pour l'entrée n'a été documentée dans le code source vérifié.
Que se passe-t-il lorsque le nombre de jetons d'entrée dépasse 272 000 ?
Lorsque le volume d'entrée dépasse 272 000 jetons, la requête complète utilise deux fois les débits d'entrée et de mise en cache, et 1,5 fois le débit de sortie. Le multiplicateur ne s'applique pas uniquement aux jetons situés au-delà du seuil.
Quelles sont les limites de débit de GPT-6.1 Terra ?
La page du modèle sélectionné indique une configuration à 5 000 tr/min, 1 000 000 TPM et une file d'attente par lots de 3 000 000 de jetons ; le modèle « Launch » correspond à 10 000 tr/min, 4 000 000 TPM et une file d'attente par lots de 200 000 000 de jetons.
La mise en cache des invites permet-elle toujours de réduire la facture ?
Non. Il faut un préfixe réutilisable et une utilisation effective des jetons mis en cache. Une écriture dans le cache coûte plus cher qu'une entrée ordinaire ; par conséquent, les préfixes de courte durée ou qui changent constamment risquent de ne pas justifier le coût de l'écriture.
Puis-je utiliser GPT-6.1 Terra sur GlobalGPT ?
Une route GlobalGPT active existe pour GPT-6.1 Terra. L'accès GlobalGPT correspond à une route de plateforme distincte et ne doit pas être considéré comme une preuve officielle de facturation ou de limitation de débit via l'API OpenAI.
Le modèle GPT-6.1 Terra est-il performant pour les images ?
Il accepte des entrées sous forme de texte et d'images et renvoie du texte, ce qui convient à l'analyse de captures d'écran, au raisonnement visuel et à la conception d'interfaces. Il ne génère pas nativement de fichiers audio ou vidéo.
Verdict final
GPT-6.1 Terra constitue un choix d'API économique lorsque le raisonnement visuel, la compréhension des interfaces, l'écriture naturelle et le travail assisté par des outils priment sur la profondeur maximale de raisonnement. L'identification exacte du modèle est simple, mais le contrôle des coûts de production repose sur la séparation de cinq compteurs de jetons, la vérification du comportement du cache, l'application de la règle du contexte long pour les requêtes complètes, ainsi que la surveillance indépendante des files d'attente RPM, TPM et par lots.
Commencez par les niveaux de raisonnement « Standard » et « Moyen », évaluez la charge de travail représentative la plus faible, puis n’ajoutez les multiplicateurs liés au niveau de service ou à la région que lorsque l’itinéraire les utilise réellement. Comptez les jetons avant toute requête avoisinant les 272 000. Lorsque la charge de travail nécessite un raisonnement plus approfondi ou un codage plus complexe, comparez la même tâche avec Sol plutôt que de vous fier aux noms des modèles.
Pour les équipes qui comparent OpenAI à d'autres prestataires, exécuter la même tâche sur d'autres grandes familles de modèles plutôt que d'étendre les conclusions tirées de la comparaison entre la Terre et le Soleil à des systèmes sans rapport avec ceux-ci.





