

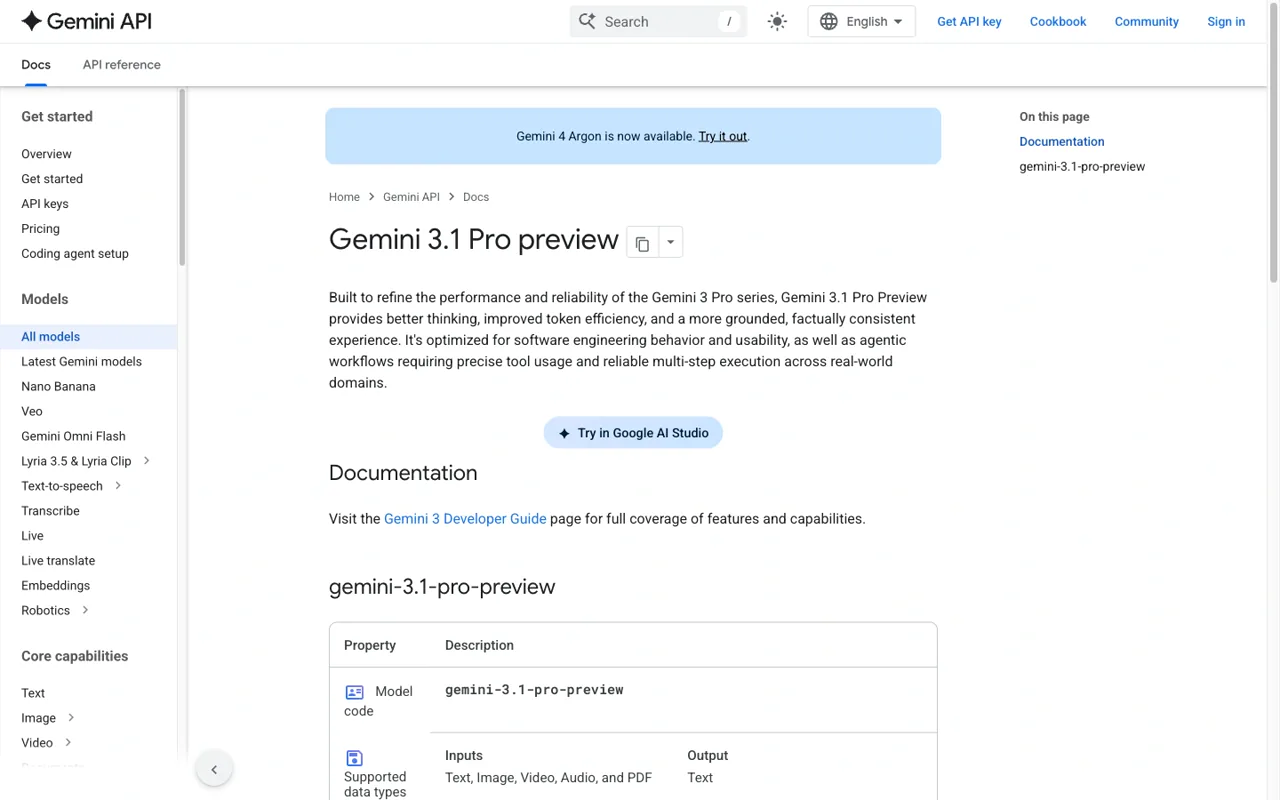
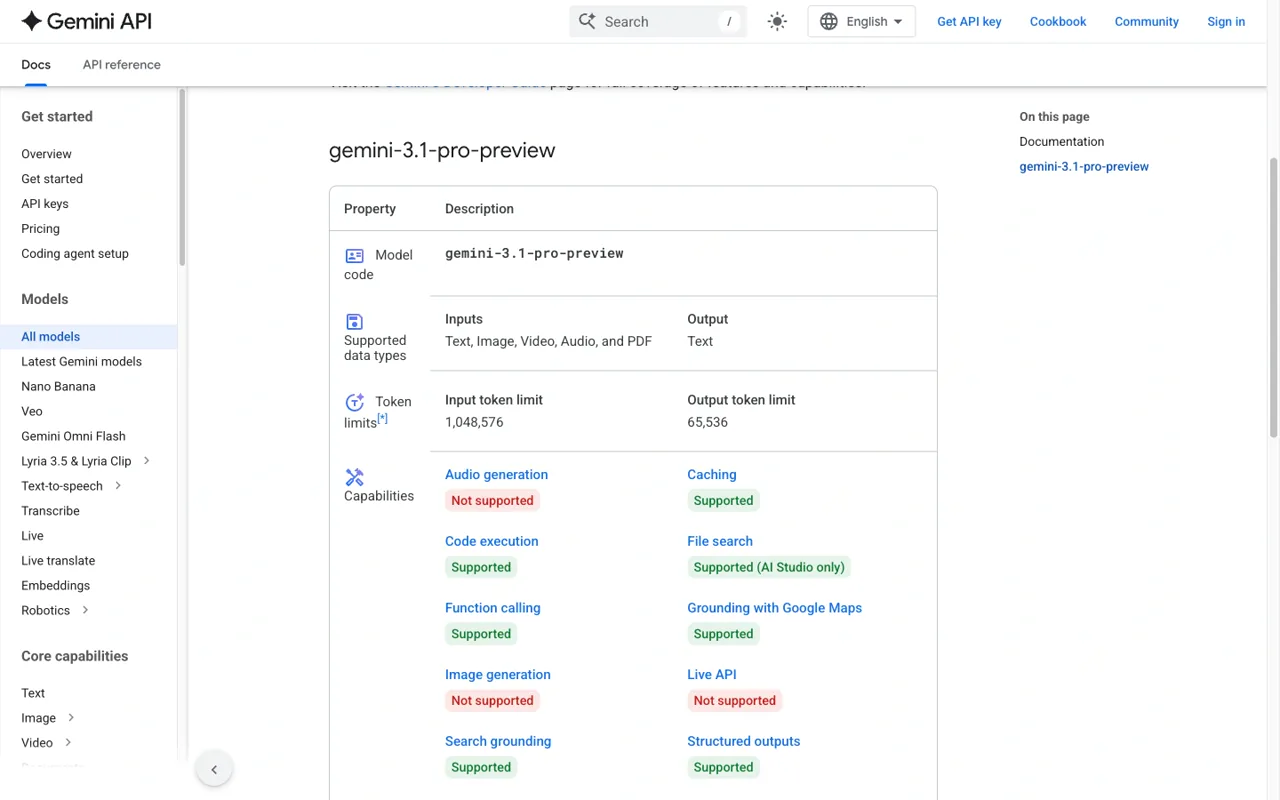
La cifra más clara en este momento es el límite del contexto del modelo: Gemini 3.1 Pro Preview admite hasta 1.048.576 tokens de entrada y devuelve hasta 65.536 tokens de salida. Eso no es lo mismo que una cuenta de API ilimitada. Tu proyecto puede seguir alcanzando un límite de frecuencia, una cuota, una restricción del nivel de facturación o un límite de uso de Google Gemini Apps.
Esta guía distingue entre esas capas y sustituye el antiguo enfoque de “bypass” por soluciones prácticas: identificar el límite, acortar o agrupar la solicitud, volver a intentarlo con retrasos progresivos cuando se trate de un problema de transporte y elegir la ruta adecuada para la tarea.
Si necesitas continuar con un flujo de trabajo prolongado de programación o investigación mientras se limita el ancho de banda de una ruta, GlobalGPT Reúne Gemini 3.1 Pro junto con otros modelos y funciones de IA en un único espacio de trabajo. Sus rutas de API, CLI, MCP y el agente Yukie resultan útiles cuando la tarea requiere un traspaso repetible; además, no agotan la cuota propia de Google.
¿Cuáles son los límites del Gemini 3.1 Pro?
| Capa límite | Datos disponibles actualmente | Qué controla |
|---|---|---|
| Contexto de entrada del modelo | 1 048 576 tokens | La cantidad de texto, archivos multimedia y contexto de la conversación que puede contener una solicitud. |
| Resultados del modelo | 65 536 tokens | La cantidad de texto, incluidas las marcas de reflexión cuando proceda, que puede devolver una respuesta. |
| Límite de precios de la API | 200 000 tokens de entrada | ¿Qué tarifas de entrada y salida se aplican en el nivel de pago estándar?. |
| Cuota del proyecto | Depende de la facturación y las cuotas de Google Cloud / AI Studio | Cuántas solicitudes o tokens puede enviar el proyecto durante un periodo determinado. |
| Uso de las aplicaciones Gemini | Se calcula automáticamente; se actualiza cada 5 horas hasta alcanzar el límite semanal | Acceso a la aplicación para consumidores, funciones y uso específico de cada plan. |
No existe un único límite denominado “Gemini 3.1 Pro”. Una solicitud puede caber dentro de la ventana de contexto y, aun así, recibir un error 429 porque el proyecto está enviando demasiadas solicitudes, la cuenta ha agotado su cuota o el servicio está temporalmente ocupado.
Límites de tokens y de contexto
La página de ejemplo de Google identifica el punto final como gemini-3.1-pro-vista previa. Acepta entradas de texto, imágenes, vídeo, audio y PDF, y devuelve texto. La página enumera las funciones compatibles: razonamiento, almacenamiento en caché, ejecución de código, llamada a funciones, búsqueda en Google y ubicación en Google Maps, contexto de URL, salida estructurada, API por lotes, Flex y opciones de prioridad.


Límites de velocidad y niveles de cuota de la API
Los límites de la API se establecen a nivel de proyecto y de plan de facturación, no solo en función del nombre del modelo. Consulta la página de cuotas del proyecto para conocer el número de solicitudes por minuto, el número de tokens por minuto, los límites diarios y el nivel de facturación activo. Google puede modificar los valores disponibles según la región, la cuenta y el nivel de servicio, por lo que una cifra antigua de un blog no es una referencia fiable de la cuota actual.
- RPM: solicitudes por minuto. Muchas llamadas pequeñas pueden alcanzar este límite antes de que se agote la capacidad de tokens.
- TPM: tokens por minuto. Unas pocas solicitudes con un contexto extenso pueden agotarlo rápidamente.
- Cuota diaria o mensual: una asignación de mayor duración que puede seguir agotada tras un breve nuevo intento.
- Estado de facturación: Es posible que sea necesario activar la facturación en un proyecto para disponer de límites más altos o de acceso a entorno de producción.
- Uso de la herramienta: La búsqueda de referencias, las referencias de mapas, las llamadas a funciones y otras herramientas pueden suponer un aumento del trabajo y de los costes.
El umbral de precio de 200 000 es un límite de facturación, no un límite estricto del contexto. Una solicitud de 250 000 tokens puede caber dentro de la ventana de contexto de 1 millón, aunque se facture a las tarifas estándar más elevadas.
Cómo solucionar el error Gemini 3.1 Pro 429

- Lee los detalles de la respuesta. Anota el ID del modelo, el proyecto, el código de estado, el valor de «retry-after» y el nombre de la cuota, si la API lo devuelve.
- Detén la ráfaga. No envíes la misma solicitud en un bucle muy rápido; eso puede alargar el intervalo de limitación.
- Vuelve a intentarlo con un retraso exponencial. Utiliza un número reducido y limitado de reintentos y respeta el parámetro «Retry-After» cuando esté presente.
- Reduce la solicitud. Acortar el historial, eliminar los archivos duplicados, reducir el presupuesto de producción o dividir el trabajo en fases.
- Comprueba los límites de los proyectos y la facturación. Un nuevo intento no puede restablecer una cuota que ya se ha agotado.
- Realiza la tarea con cuidado. En el caso de un trabajo interactivo con plazos ajustados, continúa con el briefing en otro modelo o espacio de trabajo, en lugar de hacer como si el límite del proveedor hubiera desaparecido.
Estas medidas resuelven los problemas relacionados con el transporte y la carga de trabajo. No eluden los controles de los proveedores y no deben utilizarse para eludir las restricciones de seguridad o de cuenta.
Cómo enviar trabajos de contexto extenso sin malgastar el presupuesto
El contexto extenso funciona mejor cuando la solicitud tiene un objetivo claro. Coloca el material de referencia compartido en un prefijo estable, solicita primero un índice o una extracción y, a continuación, envía solo las secciones pertinentes a la siguiente fase.
- Empieza por elaborar un esquema o resumir los puntos clave, en lugar de pedir que se reescriba todo de inmediato.
- Mantén unas especificaciones del proyecto estables y transmite un resumen conciso del estado entre cada paso.
- Utiliza el almacenamiento en caché cuando se envíe repetidamente el mismo prefijo largo y los datos de facturación del proveedor confirmen que se han producido aciertos en la caché.
- Utiliza «Batch» o «Flex» cuando el trabajo sea asíncrono y tu nivel de servicio lo admita.
- Mantén los límites de salida lo suficientemente altos como para el trabajo, pero lo suficientemente bajos como para evitar respuestas excesivas accidentales.

Cuando lo más adecuado sea una API, una CLI, un MCP o una ruta de espacio de trabajo
Utiliza la API cuando tu aplicación necesite llamadas programables, registros y una factura del proveedor. Utiliza la CLI cuando el modelo deba funcionar junto a un terminal o un repositorio. Utiliza MCP cuando la tarea requiera herramientas autorizadas, como la búsqueda de archivos, el acceso al código o los servicios internos. Utiliza un agente Yukie cuando el trabajo abarque la planificación, las llamadas a herramientas y los traspasos.

GlobalGPT resulta muy útil en este contexto como capa de continuidad: comparar una respuesta, seguir redactando, pasar el briefing al equipo de programación o a las herramientas creativas, y mantener la decisión sobre los costes al margen de la cuota de la API de Google. Para conocer el cálculo actual de los precios, consulta Guía de precios del Gemini 3.1 Pro.
PREGUNTAS FRECUENTES
¿Cuál es la entrada máxima del Gemini 3.1 Pro?
La página de modelos actual de Google recoge 1.048.576 tokens de entrada para gemini-3.1-pro-vista previa.
¿Cuál es la potencia máxima?
En esa misma página figuran 65 536 tokens de producción. Los tokens de producción y de reflexión deben tenerse en cuenta en las conversaciones sobre planificación y facturación.
¿Una ventana de contexto de 1M implica un uso ilimitado?
No. Se refiere al tamaño del contexto de una solicitud. Las cuotas del proyecto, los límites de frecuencia, la facturación y las normas de uso de la aplicación siguen siendo aplicables.
¿Cómo puedo solucionar el error 429 «Demasiadas solicitudes»?
Lee los detalles de la respuesta, respeta el campo «Retry-After», reduce la frecuencia o el tamaño de las solicitudes y comprueba las cuotas del proyecto y la facturación. Un bucle de reintentos no supone un aumento de la cuota.
¿Puede GlobalGPT eliminar las limitaciones de Gemini 3.1 Pro?
No puede modificar los límites de Google. Sin embargo, puede ofrecer otro modelo y una vía alternativa de trabajo cuando sea necesario continuar con la tarea.
Lo primero es diagnosticar la capa: La capacidad del contexto, el presupuesto de salida, la cuota del proyecto, el uso de la aplicación y la limitación temporal requieren soluciones diferentes.





