
Claude Sonnet 5.5 對比 Opus 5.5:價格、效能測試與實際測試
Sonnet 5.5 與 Opus 5.5 同屬 Claude 5.5 世代,但兩者的定價與定位各不相同。本次比較讓兩者執行相同的五個指令,並回報路線實際返回的結果。.
兩者之間的差距主要在於成本與速度。. 在這組包含五個提示的測試中,Sonnet 5.5 不僅完成速度更快、使用的輸出標記更少,且產出的算術請求成本估算值也較低。Opus 5.5 則消耗了更多標記和時間,而其答案往往更為冗長。任務卡顯示了這些額外文字在哪些地方改變了有用的結果,以及兩款模型在哪些情況下僅是通過測試。.
提示、請求上限、工作量設定、終點以及「每種模型執行一次」的設計,均維持與先前版本一致 Claude Opus 5.5 評測.
快速回答
- 本次配對跑的配速: Sonnet 5.5 在本地環境中於 31.930 秒內完成了五個連續的請求;Opus 5.5 則花了 47.725 秒。.
- 路由回報的輸出標記: Sonnet 5.5 使用了 2,686;Opus 5.5 使用了 3,952。思考場分別為 987 和 2,214。.
- 根據算術方法估算的建議零售價: 五筆 Sonnet 請求的總金額約為 $0.02826;五筆 Opus 請求的總金額約為 $0.08184,此計算採用官方標準代幣匯率,且不包含快取、點數、稅金及加價。.
- 任務結果: 兩款模型均通過了資料擷取、JSON 及數學題目的測試。Sonnet 在維持要求的兩段式中文格式方面表現得更為簡潔;兩者的程式碼輸出結果雖皆可實際運用,但在深度與邊界情況的說明上則有所差異。.
- API 遷移: 思考無法被禁用;強迫選擇工具的做法將被拒絕,且代幣預算包含思考。請檢查 遷移注意事項 在切換之前。.
- 決策邊界: 這代表每項任務透過第三方路徑執行一次。其測量對象為觀察到的提示回應、本機實際執行時間,以及路徑回報的使用狀況——並非一項通用的效能評分。.
官方售價與車款規格
Anthropic 目前的模型卡清單中,同時列出了具備 1M 代幣上下文視窗及 128K 最大輸出量的兩種模型。Sonnet 5.5 被標示為 快速 需投入大量精力;Opus 5.5 標示為 適度 以中等預設投入為基準。根據標準代幣匯率,Sonnet 5.5 的輸入與輸出價格均為 Opus 5.5 的半價。.
| 模型 | API 識別碼 | 官方延遲標籤 | 輸入/輸出 | 上下文/最大輸出 | 預設的努力程度 | 快取讀取 |
|---|---|---|---|---|---|---|
| Claude Sonnet 5.5 | 克勞德-十四行詩-5-5 | 活躍 · 快速 | 每 MTok 為 $2 / $10 | 1M / 128K | 高 | $0.20 / MTok |
| Claude Opus 5.5 | 克勞德作品第5號第5首 | 活躍 · 中等 | $4 / $20 每 MTok | 1M / 128K | 中型 | $0.20 / MTok |
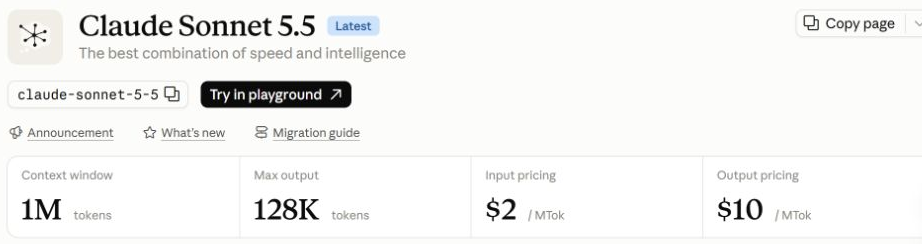
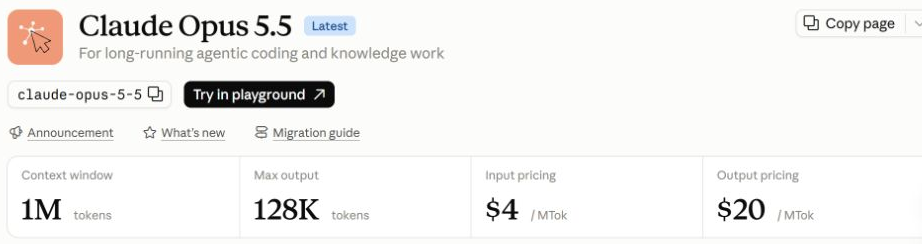
以一個簡單的未快取範例來說,若輸入 100,000 個音節且輸出 20,000 個音節,所列出的音節速率在 Sonnet 5.5 上約為 $0.40,而在 Opus 5.5 上則為 $0.80。 請參閱 Claude 定價與限額指南 用於計畫背景。.
官方基準測試背景
Anthropic’s Sonnet 5.5 公告 將這兩種模式都納入同一張由服務提供者填報的表格中。其列的排列方式會根據基準與工作量設定而有所不同。.
| Anthropic 所報告的基準值 | Sonnet 5.5 | 作品第 5.5 號 | 度量 |
|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 66.4%¹ | 主體終端編碼 |
| FrontierCode v1.1 (主分支) | 46.2% Max² / 52.1% Xhigh | 54.4% | 程式碼變更是否會被合併 |
| CursorBench 4.0 | 55.5% | 57.8% | 含糊的多檔案編碼任務 |
| GDPval-AA v2.1 | 1844 | 1846 | 各職業領域中的知識型工作 |
| 人類的最終考驗 | 64.5%(含工具) | 67.7%(含工具) | 跨領域推理 |
| OSWorld 2.1 | 80.1% 部分 | 81.8% 部分 | 電腦使用任務 |
| 製圖學 | 61.6% 無需工具 | 64.4% 無需工具 | 圖表視覺辨識 |
¹ Opus 5.5 Terminal-Bench 採用 xhigh 運算強度;² Sonnet 5.5 FrontierCode 在 Max 模式下為 46.2%,在 Xhigh 運算強度下為 52.1%。 OSWorld 的數值標示為「部分」。這些屬於服務供應商環境下的數據,並非在相同工作負載下獨立重新執行的結果。.
同一提示詞的 API 方法
每個模型都透過……收到了相同的五個提示 文章連結 https://anywhere.broly.ai/v1/messages. 客戶傳送了一則使用者訊息,, max_tokens:8192, output_config.effort: high, ,且無需任何工具。每個請求都返回 HTTP 200 狀態碼,並且 回合結束.
此測試方法遵循更廣泛的 GlobalGPT 模型測試工作流程. 另一份 Claude API 指南 涵蓋了請求設定與代幣計帳。.
時間、代幣及預估費用
| 路線 | 當地時間五局 | 輸入代幣 | 輸出標記 | 報導中的想法 | 預估請求費用* |
|---|---|---|---|---|---|
| Claude Sonnet 5.5 | 31.930 秒 | 700 | 2,686 | 987 | $0.02826 |
| Claude Opus 5.5 | 47.725 秒 | 700 | 3,952 | 2,214 | $0.08184 |
* 根據路線回報的代幣數量及官方標準費率估算。在此批次中,Sonnet 5.5 的本地耗時比基準值低 33.1%,產出代幣數比基準值低 32.0%。.
五張配對任務卡
每張卡片會將任務、觀察記錄、當地時間、路線通報代幣、狀態及邊界資訊整合在一起。.
這些模型能否修復混合型重複資料刪除功能?
任務設定: 該提示語的原文是從之前的 Claude Opus 5.5 評測 測試套裝。.
| 模型 | 時間/路線使用情況 | 簡短結果標籤 |
|---|---|---|
| Claude Sonnet 5.5 | 8.679 秒 145 輸入 / 830 輸出 0 則思考 HTTP 200 · 回合結束 | 修正了函數及兩道習題;說明內容更簡短。. |
| Claude Opus 5.5 | 15.844 秒 145 輸入 / 1478 輸出 700 種思考方式 HTTP 200 · 回合結束 | 修正了函數並新增兩項測試;對邊界情況進行了更深入的探討。. |
觀察到的比較: 兩者都回傳了一個經修正的函式和兩項測試。Sonnet 5.5 使用了帶有類型標籤的鍵,, casefold(), ,而在較短的回應中則採用清單作為備用方案;Opus 5.5 則耗費更多輸出標記來闡述額外的邊緣案例。這兩次執行結果均未能確立一個通用的編碼勝出者。.
邊界: 單一的小型 Python 修補程式僅能檢查具體的邊界案例,而無法確保跨儲存庫或工具驅動編碼的可靠性。.
這些模型能否在不增添任何主張的情況下,保留所提供的五項事實?
任務設定: 該提示語的原文是從之前的 Claude Opus 5.5 評測 測試套裝。.
| 模型 | 時間/路線使用情況 | 簡短結果標籤 |
|---|---|---|
| Claude Sonnet 5.5 | 3.569 秒 210 輸入 / 209 輸出 0 則思考 HTTP 200 · 回合結束 | 五個編號的要點;保留原始事實。. |
| Claude Opus 5.5 | 4.374 秒 210 輸入 / 312 輸出 101種思考方式 HTTP 200 · 回合結束 | 五個編號的要點;保留原始事實。. |
觀察到的比較: 兩者都精確地回傳了五則編號的要點,並完全符合給定的事實。Sonnet 5.5 產出了 209 個輸出標記,而 Opus 5.5 則產出了 312 個,但前者是基於一篇簡短筆記,而非大篇幅的輸入內容。.
邊界: 這是一項基於實際環境的擷取與格式檢查;這並不代表百萬個標記的語境處理效能。.
這些模型能否回傳與請求結構完全一致的結果?
任務設定: 該提示語的原文是從之前的 Claude Opus 5.5 評測 測試套裝。.
| 模型 | 時間/路線使用情況 | 簡短結果標籤 |
|---|---|---|
| Claude Sonnet 5.5 | 5.052 秒 128 輸入 / 260 輸出 0 則思考 HTTP 200 · 回合結束 | 可解析的 JSON;包含請求的鍵與項目數量。. |
| Claude Opus 5.5 | 8.276 秒 128 輸入 / 622 輸出 390 種思考方式 HTTP 200 · 回合結束 | 可解析的 JSON;包含請求的鍵與項目數量。. |
觀察到的比較: 兩者皆回傳了包含所請求鍵值且可解析的 JSON 資料,並各有兩項優點與兩項缺點。Sonnet 5.5 的輸出更為簡潔,僅有 260 個輸出標記;這些字串描述的是一項虛構的評論設定,並非產品事實。.
邊界: 僅執行一次此模式測試,並不足以評估在工具呼叫或長時間對話中結構化輸出的可靠性。.
這些模型能否將這組循環的批次序列一路推導至最終答案呢?
任務設定: 該提示語的原文是從之前的 Claude Opus 5.5 評測 測試套裝。.
| 模型 | 時間/路線使用情況 | 簡短結果標籤 |
|---|---|---|
| Claude Sonnet 5.5 | 2.947 秒 89 個輸入 / 163 個輸出 0 則思考 HTTP 200 · 回合結束 | 正確答案:67;最終答案應單獨佔一行。. |
| Claude Opus 5.5 | 3.830 秒 89 輸入 / 257 輸出 74 種思考方式 HTTP 200 · 回合結束 | 正確答案:67;最終答案應單獨佔一行。. |
觀察到的比較: 兩者皆計算出 67,並將最終答案單獨列於一行。Sonnet 5.5 產出了 163 個輸出標記,而 Opus 5.5 則為 257 個;在此提示下,兩者未觀察到正確性上的差異。.
邊界: 單一算術數列無法用來評估廣泛推理的可靠性。.
這條路線能否維持所要求的兩段式結構?
任務設定: 該提示語的原文是從之前的 Claude Opus 5.5 評測 測試套裝。.
| 模型 | 時間/路線使用情況 | 簡短結果標籤 |
|---|---|---|
| Claude Sonnet 5.5 | 11.683 秒 128 輸入 / 1224 輸出 987 思考 HTTP 200 · 回合結束 | 兩段中文;無額外框架。. |
| Claude Opus 5.5 | 15.401 秒 128 輸入 / 1283 輸出 949 思考 HTTP 200 · 回合結束 | 已涵蓋相關要點;新增了 Markdown 格式及英文註解。. |
觀察到的比較: Sonnet 5.5 回傳了所要求的兩段中文內容,未附加額外標籤。Opus 5.5 同樣涵蓋了所要求的要點,但添加了 Markdown 標籤及一段英文註解。此記錄僅針對單次執行路徑的格式,而非整體中文品質。.
邊界: 該提示要求撰寫關於《Opus 5.5》的開場白,因此該文本本身並非中立語言的基準。.
API 與遷移注意事項
Sonnet 5.5 預設會執行適應性思考;若設定 thinking: disabled,則會回傳 400 錯誤,且 max_tokens 包含思考及回應文字的總量。強制設定 tool_choice any/tool 將被拒絕。請依類型解析內容區塊,並在切換前重新設定代碼預算基準。.
證據所支持的內容
任務層級的裁決
Sonnet 5.5: 在這條航線上,測量出的成本和時間均較低,且在中國任務中完全符合格式規範。.
作品第 5.5 號: 在此處價格更高且範圍更廣;在數項開放式任務中,官方基準測試結果仍保持領先。.
利用任務層級的證據來選擇一個起點,然後驗證對您而言重要的工作量。.
有關相關背景,請參閱 Claude 系列產品比較, 《Opus 5》評測, 以及 Fable 5.1 評論.
常見問題
在對比測試中,哪一款機型的速度較快?
在五次連續請求中,Sonnet 5.5 的本地總延遲較低:31.930 秒,而 Opus 5.5 則為 47.725 秒。此數值已包含此處使用的路由與網路路徑,因此並非來自服務供應商端的延遲。.
哪個模型產出的標記數量較少?
Sonnet 5.5 在五項任務中共使用了 2,686 個路徑報告的輸出標記,而 Opus 5.5 則為 3,952 個。僅憑標記數量並不能證明答案的品質。.
在這次測試中,哪一款車型更便宜?
根據官方標準 API 費率及回傳的輸入/輸出次數,這五筆 Sonnet 5.5 請求的估算總額為 $0.02826,而 Opus 5.5 則為 $0.08184。 此計算未包含快取費用、平台抵免額、稅金及加價。.
Sonnet 5.5 在每項基準測試中都比 Opus 5.5 表現更好嗎?
Anthropic 的專屬表格中,各項成績因基準測試與運算強度設定而有所差異: Sonnet 5.5 在 Terminal-Bench 4.0 上的表現更佳,而 Opus 5.5 則在 FrontierCode、CursorBench、GDPval-AA、Humanity’s Last Exam、OSWorld 及 Chartography 上的表現更佳。這些均為供應商提供的測試結果,並非經獨立重新測試所得。.
Sonnet 5.5 是否為可直接替換的 API?
不。遷移指南指出,預設情況下「thinking」會自動執行;若將「thinking」設為「disabled」,將會返回 400 錯誤;強制設定工具選擇為「any/tool」將被拒絕;且客戶端應根據類型解析內容區塊。切換前,請重新建立標記預算和工具迴圈的基準。.
這是一項長文脈標竿測試嗎?
不。萃取提示中包含一段簡短的文字。它會檢查事實依據與格式是否正確;但不會評估在文檔中記載的 100 萬個標記上下文視窗範圍內的行為。.



