

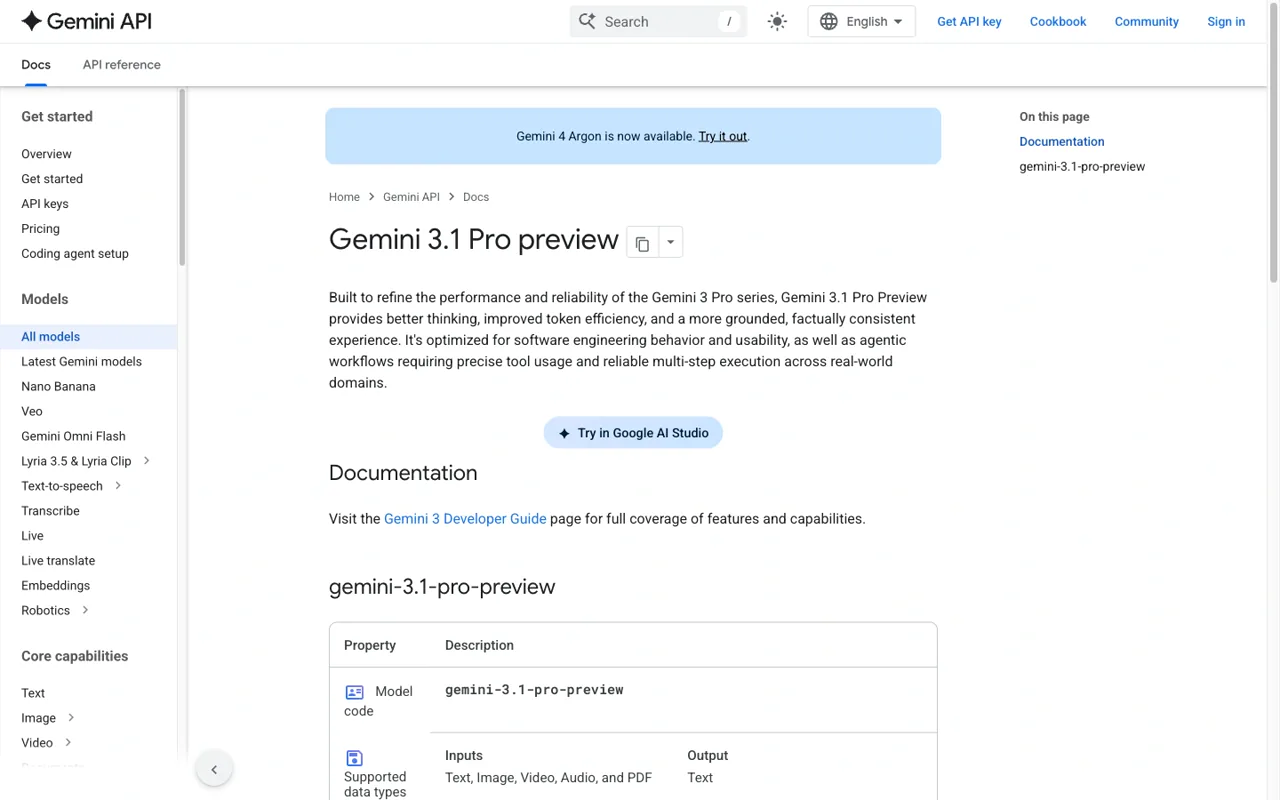
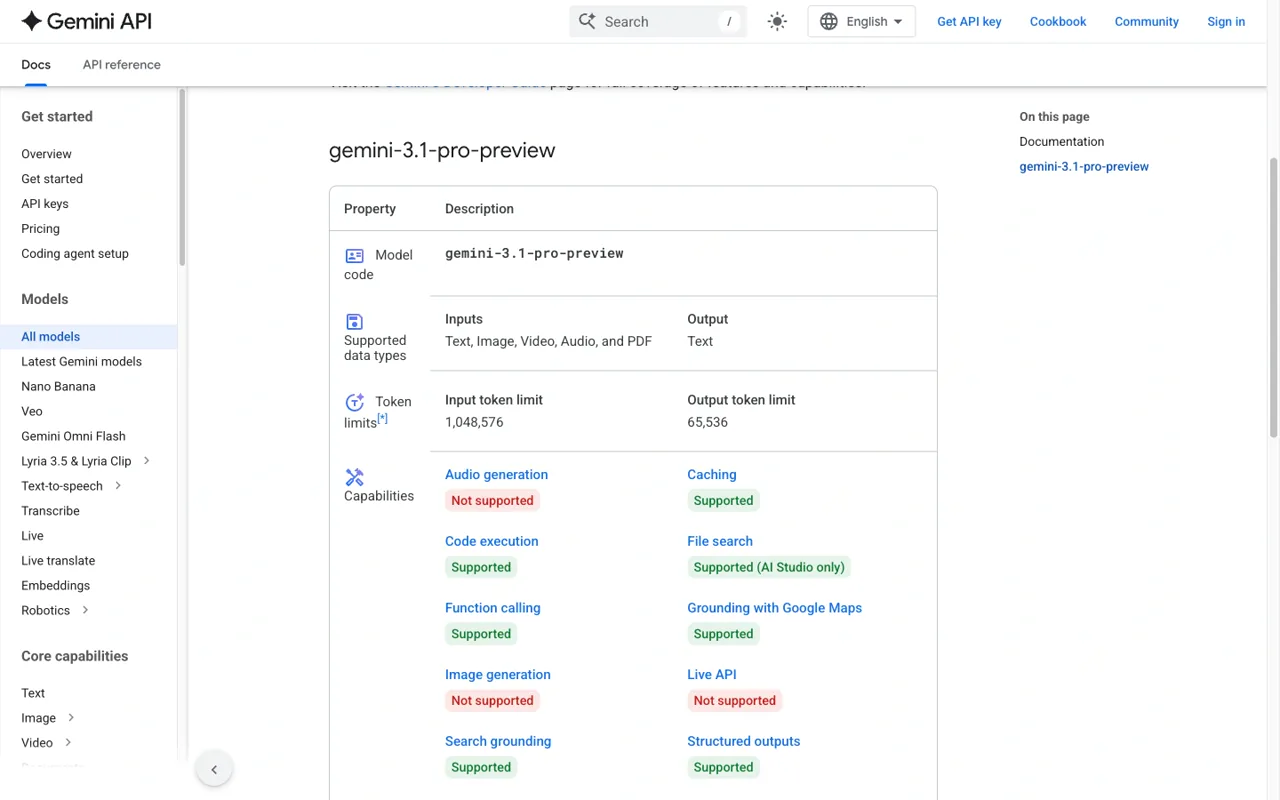
O número mais claro no momento é o limite de contexto do modelo: o Gemini 3.1 Pro Preview aceita até 1.048.576 tokens de entrada e retorna até 65.536 tokens de saída. Isso não é o mesmo que uma conta de API ilimitada. Seu projeto ainda pode atingir um limite de taxa, uma cota, uma restrição de plano de cobrança ou um limite de uso do Google Apps Gemini.
Este guia separa essas camadas e substitui a antiga abordagem de “bypass” por soluções práticas: identificar o limite, encurtar ou agrupar a solicitação, tentar novamente com backoff quando se tratar de um problema de transporte e escolher a rota adequada para a tarefa.
Se você precisar dar continuidade a um longo fluxo de trabalho de programação ou pesquisa enquanto uma rota estiver com o tráfego restrito, GlobalGPT reúne o Gemini 3.1 Pro junto com outros modelos e funções de IA em um único espaço de trabalho. Sua API, CLI, MCP e rotas do agente Yukie são úteis quando a tarefa requer um repasse repetível; elas não esgotam a cota do próprio Google.
Quais são os limites do Gemini 3.1 Pro?
| Camada limite | Evidências atuais | O que ele controla |
|---|---|---|
| Contexto de entrada do modelo | 1.048.576 tokens | Qual a quantidade de texto, mídia e contexto da conversa que uma solicitação pode conter. |
| Resultado do modelo | 65.536 tokens | Qual a quantidade de texto, incluindo marcadores de reflexão, quando aplicável, que uma resposta pode retornar. |
| Limite de preços da API | 200.000 tokens de entrada | Quais taxas de entrada/saída se aplicam ao plano padrão pago?. |
| Cota do projeto | Depende do faturamento e das cotas do Google Cloud / AI Studio | Quantos pedidos ou tokens o projeto pode enviar durante um determinado período. |
| Uso dos aplicativos Gemini | Baseado em computação; é atualizado a cada 5 horas até atingir um limite semanal | Acesso ao aplicativo para consumidores, recursos e uso específico de cada plano. |
Não existe um único limite específico para o “Gemini 3.1 Pro”. Uma solicitação pode caber dentro da janela de contexto e, mesmo assim, receber um código 429 porque o projeto está enviando muitas solicitações, a conta esgotou uma cota ou o serviço está temporariamente ocupado.
Limites de tokens e de contexto
A página de exemplo do Google identifica o endpoint como gemini-3.1-pro-preview. Ela aceita entradas de texto, imagens, vídeo, áudio e PDF e retorna texto. A página lista o suporte a raciocínio, armazenamento em cache, execução de código, chamada de funções, localização no Google Search e no Google Maps, contexto de URL, saída estruturada, API Batch, Flex e opções de prioridade.


Limites de taxa da API e camadas de cota
Os limites da API são definidos no nível do projeto e do plano de cobrança, e não apenas pelo nome do modelo. Verifique a página de cotas do projeto para saber o número de solicitações por minuto, tokens por minuto, limites diários e o plano de cobrança ativo. O Google pode alterar os valores disponíveis por região, conta e nível de serviço; portanto, um número antigo mencionado em um blog não é uma referência confiável para a cota atual.
- RPM: solicitações por minuto. Muitas chamadas pequenas podem atingir esse limite antes que a capacidade de tokens se esgote.
- TPM: tokens por minuto. Algumas solicitações com contexto extenso podem esgotá-lo rapidamente.
- Cota diária ou mensal: uma tolerância de período mais longo que pode permanecer esgotada após uma breve nova tentativa.
- Estado de cobrança: Um projeto pode precisar que o faturamento seja ativado para obter limites mais altos ou acesso à produção.
- Uso da ferramenta: A pesquisa de grounding, o Maps de grounding, as chamadas de função e outras ferramentas podem aumentar o trabalho e os custos.
O limite de preço de 200 mil é um limite de faturamento, não um limite rígido de contexto. Uma solicitação de 250 mil tokens pode caber dentro da janela de contexto de 1 milhão, sendo cobrada pelas tarifas padrão mais altas.
Como corrigir um erro Gemini 3.1 Pro 429

- Leia os detalhes da resposta. Registre o ID do modelo, o projeto, o código de status, o valor de “retry-after” e o nome da cota, caso a API retorne um.
- Interrompa a sequência. Não envie a mesma solicitação em um loop contínuo; isso pode prolongar o período de limitação.
- Tente novamente com recuo exponencial. Utilize um número limitado de tentativas e respeite o parâmetro Retry-After, quando houver.
- Reduzir a solicitação. Resuma o histórico, remova arquivos repetidos, reduza o orçamento de produção ou divida o trabalho em etapas.
- Verifique as cotas do projeto e o faturamento. Uma nova tentativa não pode restaurar uma cota que já tenha sido esgotada.
- Execute a tarefa com cuidado. Para um trabalho interativo com prazo apertado, continue o briefing em outro modelo ou área de trabalho, em vez de fingir que o limite do provedor não existe mais.
Essas etapas resolvem problemas relacionados ao transporte e à carga de trabalho. Elas não contornam os controles do provedor e não devem ser utilizadas para burlar restrições de segurança ou de conta.
Como enviar trabalhos com contexto extenso sem desperdiçar o orçamento
O contexto extenso funciona melhor quando a solicitação tem uma finalidade clara. Coloque o material de referência compartilhado em um prefixo estável, solicite primeiro um índice ou uma extração e, em seguida, envie apenas as seções relevantes para a próxima etapa.
- Comece com um esboço ou com a extração dos pontos-chave, em vez de pedir uma reescrita completa logo de cara.
- Mantenha um briefing de projeto consistente e transmita um resumo conciso do estado do projeto entre as etapas.
- Utilize o cache quando o mesmo prefixo longo for enviado repetidamente e os dados de faturamento do provedor confirmarem os acertos no cache.
- Use o Batch ou o Flex quando o trabalho for assíncrono e sua camada de serviços for compatível com isso.
- Mantenha os limites de saída altos o suficiente para a tarefa, mas baixos o suficiente para evitar respostas gigantescas acidentais.

Quando a API, a CLI, o MCP ou uma rota do espaço de trabalho são adequados
Utilize a API quando seu aplicativo precisar de chamadas programáveis, registros de log e uma fatura do provedor. Utilize a CLI quando o modelo precisar operar junto a um terminal ou repositório. Utilize o MCP quando a tarefa exigir ferramentas aprovadas, como pesquisa de arquivos, acesso a código ou serviços internos. Utilize um agente Yukie quando o trabalho envolver planejamento, chamadas de ferramentas e transferências de tarefas.

GlobalGPT é mais útil aqui como uma camada de continuidade: compare uma resposta, continue elaborando o rascunho, encaminhe o briefing para a equipe de programação ou para as ferramentas criativas e mantenha a decisão sobre custos separada da cota da API do Google. Para a análise atual dos preços, consulte Guia de preços do Gemini 3.1 Pro.
PERGUNTAS FREQUENTES
Qual é a entrada máxima do Gemini 3.1 Pro?
A página de modelo atual do Google lista 1.048.576 tokens de entrada para gemini-3.1-pro-preview.
Qual é a potência máxima?
Essa mesma página lista 65.536 tokens de saída. Os tokens de saída e de reflexão devem ser incluídos nas discussões sobre planejamento e faturamento.
Uma janela de contexto de 1M significa uso ilimitado?
Não. Isso se refere ao tamanho do contexto de uma única solicitação. As cotas do projeto, os limites de taxa, o faturamento e as regras de uso do aplicativo continuam válidos.
Como faço para corrigir o erro 429 (Too Many Requests)?
Leia os detalhes da resposta, respeite o parâmetro Retry-After, aumente o intervalo entre tentativas, reduza o tamanho ou a frequência das solicitações e verifique as cotas do projeto e o faturamento. Um ciclo de tentativas não significa um aumento da cota.
O GlobalGPT consegue remover as restrições do Gemini 3.1 Pro?
Isso não pode alterar os limites do Google. Pode, porém, oferecer outro modelo e uma alternativa de fluxo de trabalho quando for necessário dar continuidade ao trabalho.
Primeiro, faça o diagnóstico da camada: A capacidade do contexto, o orçamento de saída, a cota do projeto, o uso do aplicativo e a limitação temporária exigem soluções diferentes.





