Claude Sonnet 4.5 is een verouderd model met een duidelijke identiteit: Anthropic introduceerde het op 29 september 2025 voor programmeerwerk, agentgebaseerde workflows, computergebruik en langdurige taken met meerdere stappen. Als een bestaande toepassing ervan afhankelijk is, hangt de beslissing af van drie factoren: de sterke punten op het gebied van programmeren, de kosten voor het draaien ervan en de inspanning die nodig is om over te stappen naar een ander model.
Voor ontwikkelaars die afwisselend bezig zijn met onderzoek, schrijven, hulp bij het programmeren en modelspecifieke taken, GlobalGPT biedt één geïntegreerde werkruimte. Eén abonnement biedt toegang tot een uitgebreide modelcatalogus en diverse AI-functies, waardoor het een voordelige manier is om een ontwikkelingsworkflow te ondersteunen. De CLI van GlobalGPT koppelt die workflow aan je terminal en je bestaande ontwikkeltools.
Wat is Claude Sonnet 4.5?
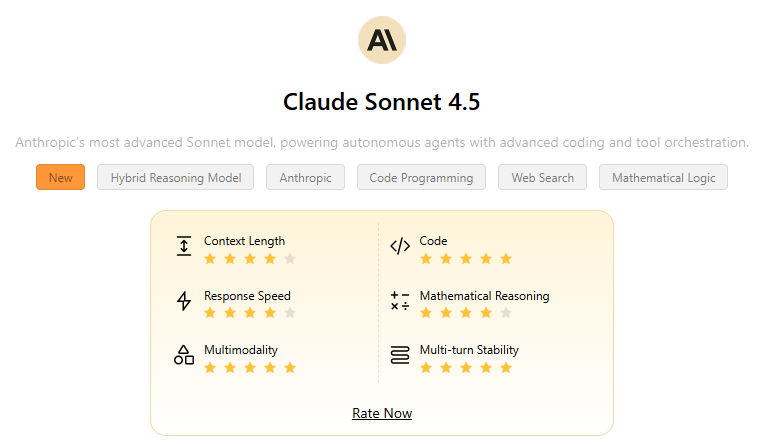
Sonnet 4.5 was bij de lancering het praktische middenklasse-model van Anthropic: krachtiger dan een lichtgewichtmodel voor complexe softwareopdrachten, maar goedkoper dan de Opus-serie. Anthropic’s aankondiging van de lancering de nadruk lag op programmeren, computergebruik, het bouwen van agents, redeneren en wiskunde.
Deze uitspraken hebben betrekking op de release van september 2025. Ze betekenen niet dat Sonnet 4.5 in 2026 de nieuwste Claude-optie wordt, en een benchmark van een leverancier is geen garantie voor elke codebase. De vraag waar het vandaag om gaat, is of je het bekende gedrag van dit model nodig hebt of dat je kunt overstappen op een nieuwere standaardinstelling.
Huidige API-status en overzicht van te beëindigen API’s
claude-sonnet-4-5De tabel met verouderde modellen van Anthropic toonde een verouderd momentopname claude-sonnet-4-5-20250929 als Actief bij controle op 30 september 2026. In dezelfde rij staat Niet eerder dan 29 september 2026. Die formulering is een ondergrens, geen geplande sluitingsdatum. Raadpleeg de live levenscyclus-tabel voordat je een migratie naar de productieomgeving uitvoert.
Wat uit de lanceringsgegevens blijkt
Het relevante bewijsmateriaal is specifiek en gedateerd. Het laat zien waarom Sonnet 4.5 een referentiepunt voor codering werd, terwijl de testomstandigheden uitleggen hoe ver elk getal zich kan verplaatsen.
Resultaten van het computergebruik bij de lancering
Succespercentage van OSWorld, op een schaal van 0–100%. Hoe hoger, hoe beter.
Bron: Aankondiging van de lancering van Anthropic, 29 september 2025; gecontroleerd op 28 september 2026. Een stijging van 19,2 procentpunten in de gerapporteerde beoordeling; dit is geen garantie voor succes bij algemene desktop-taken.
| Bewijs | Resultaat uit de beginperiode | Hoe moet je dit lezen? |
|---|---|---|
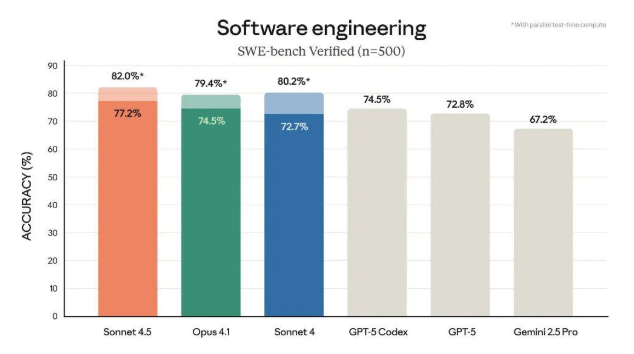
| SWE-bench Geverifieerd | 77.2% voorlopige uitslag | 500 opgaven, gemiddeld over 10 pogingen, geen extra rekentijd tijdens de test, 200K denkbudget |
| SWE-bench-variant met hoge rekenkracht | 82.0% | Parallelle pogingen, filtering op zichtbare regressie en interne selectie van kandidaten |
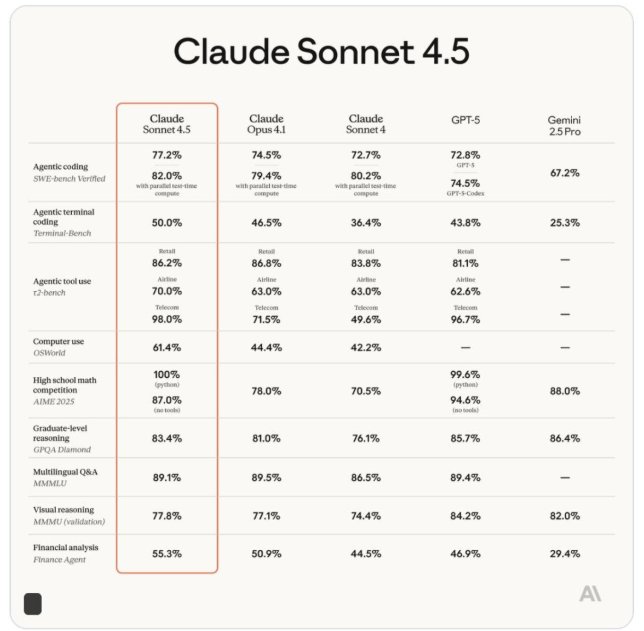
| OSWorld | 61,41 TP40T tegen Sonnet 4 bij 42,21 TP40T | De door Anthropic gepubliceerde benchmarkvergelijking van computergebruik |
Het primaire, door SWE-bench geverifieerde resultaat van Anthropic (77,2%) omvatte alle 500 opgaven, was gebaseerd op een gemiddelde van 10 pogingen, maakte geen gebruik van extra rekentijd tijdens het testen en had een denkbudget van 200K. Het cijfer 82,0% is afkomstig van een afzonderlijke opstelling met hoge rekenkracht, met parallelle pogingen, filtering op zichtbare regressie en interne selectie van kandidaten. Dit zijn andere evaluatieomstandigheden.
Anthropic rapporteerde op OSWorld ook een score van 61,4%, vergeleken met 42,2% voor de Sonnet 4 vier maanden eerder. OSWorld test taken bij computergebruik, dus het resultaat zegt iets over de interactie met softwareomgevingen; het is geen voorspelling voor succes bij elke desktop-workflow.
Anthropic meldde dat Sonnet 4.5 meer dan 30 uur lang zijn aandacht bij complexe, uit meerdere stappen bestaande taken wist vast te houden. Dit is een waarneming van de leverancier, geen belofte dat elke gebruikerstaak 30 uur zal duren of dat ononderbroken autonomie altijd wenselijk is.
Programmering en upgrades van agents bij de lancering
Deze release omvatte zowel model- als toolingwijzigingen. Anthropic bevatte checkpoints voor het opslaan en terugdraaien van voortgang, een vernieuwde terminal, een native VS Code-extensie, contextbewerking en geheugentools, code-uitvoering en het aanmaken van bestanden, en de Claude Agent SDK.
- Checkpoints helpt je tijdens een lange programmeersessie om een misstap te herstellen zonder de hele run kwijt te raken.
- De Claude Agent SDK legt de basis Anthropic uit die wordt gebruikt voor de Claude-code, zodat teams taakspecifieke agents kunnen bouwen.
- Het gelijktijdig gebruik van tools en taken met een langere doorlooptijd maakten deel uit van de introductie; de huidige opdrachten en menu’s moeten worden nagekeken in de actuele documentatie.
- De Claude-code, de API en de webapp zijn afzonderlijke toegangsmogelijkheden. Kies de optie die het beste aansluit bij uw toegangsrechten, facturering en beoordelingsproces.
Raadpleeg voor implementatiedetails de actuele ontwikkelaarsdocumentatie van Anthropic in plaats van een lanceringsinstructie uit 2025 over te nemen. De model-ID vormt een betrouwbaar uitgangspunt; tools en het gedrag van clients moeten worden getoetst aan de hand van de actuele API- en Claude-codedocumentatie.
In de aankondiging van de lancering wordt ook Michael Truell, CEO van Cursor, geciteerd, die spreekt over betere code en het uitvoeren van taken met een langere doorlooptijd. Die klantbeoordeling helpt verklaren waarom deze release zo aantrekkelijk is voor ontwikkelaars, terwijl de hierboven genoemde benchmarkmethoden een nauwkeurigere basis voor vergelijking bieden.
Prijzen en toegang tot de API
De Prijstabel Anthropic Vermeldt voor Sonnet 4.5 $3 per miljoen invoertokens en $15 per miljoen uitvoertokens. In de prijstabel staan ook lagere batchsnelheden en schrijf-/leessnelheden voor de prompt-cache vermeld voor workloads waarbij lange context wordt hergebruikt; de prijspagina is gecontroleerd op 28 september 2026.
| API-route | Invoer | Uitgang | Als het past |
|---|---|---|---|
| Standaard API | $3 / MTok | $15 / MTok | Interactieve verzoeken en reguliere productieverzoeken |
| Batch-API | $1.50 / MTok | $7.50 / MTok | Asynchrone bulkverwerking; Anthropic documenteert een korting op het 50%-token |
| Cache voor invoerprompts | $3.75 / MTok (5 minuten schrijven) of $6 / MTok (1 uur schrijven) | - | Herhaalde lange prompts; cache-leesbewerkingen bedragen $0,30 / MTok |
Dezelfde werklast: Standaard versus Batch
100.000 niet-gecachete invoertokens + 10.000 uitvoertokens. USD; schaalbaarheid vanaf nul tot $0,45.
Berekening op basis van De tarieflijst van Anthropic, gecontroleerd op 28 september 2026. Bij batchverwerking wordt deze tokenvergoeding met 50% verlaagd wanneer asynchrone verwerking mogelijk is. Caching, regionale aanpassingen en andere kosten zijn hierin niet meegerekend; dit is een voorbeeld, geen daadwerkelijk berekende rekening.
Een verzoek met 100.000 niet-gecachete invoertokens en 10.000 uitvoertokens zou volgens de standaardtarieven, vóór cache, dataresidentie of andere aanpassingen, ongeveer $0,45 bedragen. Hetzelfde aantal tokens in Batch zou ongeveer $0,225 bedragen. Dit zijn rekenvoorbeelden, geen facturatieofferte.
Voor de consumentenapp, de Claude-code, GlobalGPT en de API kunnen de toegangs- en factureringsvoorwaarden verschillen. Als u Sonnet 4.5 binnen een werkruimte met meerdere modellen wilt gebruiken, open de huidige pagina over de GlobalGPT Sonnet 4.5. Gebruik voor directe API-aanroepen de console en de API-documentatie van Anthropic.
Hoe je Sonnet 4.5 vandaag de dag kunt gebruiken
Er zijn drie praktische manieren, die elk een andere taak vervullen:
- GlobalGPT-werkruimte: Open Sonnet 4.5 met andere modellen en functies wanneer je chat, onderzoek, schrijven of hulp bij het programmeren wilt combineren zonder dat je meerdere afzonderlijke werkruimten hoeft te beheren.
- Anthropic API: gebruik
claude-sonnet-4-5in de Messages API wanneer je de eigenaar bent van de applicatie, directe facturering nodig hebt of een momentopname wilt vastzetten. - Claude-code of een integratie met een editor: Gebruik het toolpad wanneer repository-werk, shell-toegang en beoordelingsrechten net zo belangrijk zijn als het model.
Veiligheidsgegevens
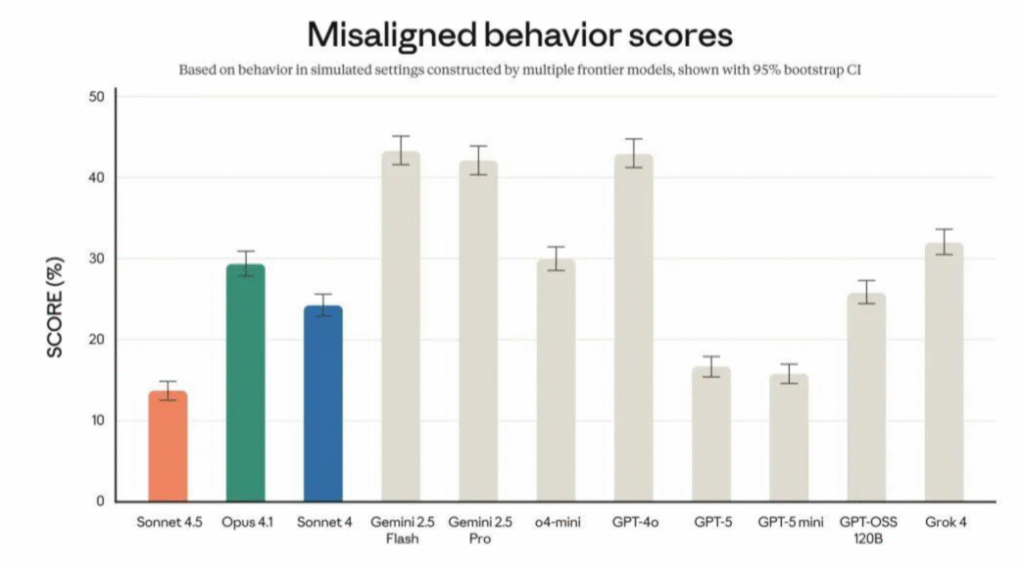
In de aankondiging van de lancering van Anthropic werd Sonnet 4.5 omschreven als het model dat op dat moment het meest in lijn was met de nieuwste ontwikkelingen, en werd melding gemaakt van een afname van gedragingen zoals slijmerigheid, misleiding, machtsstreven en het aanmoedigen van waanvoorstellingen. Ook werd er melding gemaakt van vooruitgang op het gebied van prompt-injectie voor agentische systemen en systemen voor computergebruik.
De bijgevoegde gedrags-auditor-grafiek is beperkter dan een algemene veiligheidsgarantie. De grafiek wordt aangeduid als een gesimuleerde situatie en maakt gebruik van 95% bootstrap-betrouwbaarheidsintervallen; lagere scores zijn beter. Het resultaat levert aanwijzingen op over de geteste opstelling, maar vormt geen bewijs dat elke implementatie veilig is of dat prompt-injectie verdwijnt.
Lees de Claude Sonnet 4.5-systeemkaart Raadpleeg de evaluatiegegevens en beperkingen voordat u het model in een cruciale workflow gaat gebruiken.
Huidige alternatieven en richtlijnen inzake compatibiliteit
Anthropic’s overzicht van de huidige modellen geeft naast de 4.5-snapshot ook nieuwere families weer. De keuze is afhankelijk van de taak:
Bewaar Sonnet 4.5
Kies deze optie wanneer uw integratie, promptset of regressiegeschiedenis afhankelijk is van het gedrag in 2025 en de levenscyclusregel uw implementatie nog steeds ondersteunt.
Overstappen naar een nieuwere Sonnet
Kies de huidige Sonnet-serie als je een ondersteunde standaardinstelling wilt en het je niet uitmaakt dat er een compatibiliteitscontrole nodig is voordat je de model-ID wijzigt.
Kies een andere familie
Kies een model in Opus-stijl voor diepgaandere analyse of een model in Haiku-stijl voor snelheid en lichtere taken; toets dit aan de hand van de taak die je daadwerkelijk uitvoert.
Zie voor een Claude-specifiek vergelijkingspad De gids van GlobalGPT met alternatieven voor Claude Sonnet 4.5. Voor informatie over de API en het abonnement, de huidige prijslijst voor Claude legt uit hoe abonnementen, API-kosten en gebruikslimieten in elkaar zitten.
Is Sonnet 4.5 nog steeds de moeite waard?
Ja, wanneer het gaat om compatibiliteitsgevoelige codering, een bekende Claude Code-workflow of een benchmark- en regressiereferentie. Het lanceringsbewijs is nog steeds bruikbaar, de API-ID is duidelijk en op de levenscycluspagina werd de snapshot bij de laatste geregistreerde controle als ‘Actief’ weergegeven.
Als er geen compatibiliteitsbeperkingen gelden, is het minder aantrekkelijk om dit als nieuwe universele standaard te gebruiken. Een nieuwer, ondersteund model biedt mogelijk betere huidige tools of redeneringen, en gezien de ondergrens voor het uit de roulatie halen op 29 september 2026 is een migratieplan verstandig. Vergelijk je eigen prompts en toolaanroepen en kies vervolgens het model dat voldoet aan de workflow die je nodig hebt.
FAQ
Wat is Claude Sonnet 4.5?
Dit is het programmeer- en agentmodel van Anthropic voor september 2025. De API-model-ID is claude-sonnet-4-5, met de momentopname van die datum claude-sonnet-4-5-20250929.
Is Claude Sonnet 4.5 nog steeds actief?
In de levenscyclus-tabel van Anthropic werd de verouderde momentopname bij controle op 30 september 2026 als “Actief” weergegeven. In de rij staat ook ‘Niet eerder dan 29 september 2026’, wat een ondergrens is en geen vaste uitdienststellingsdatum. Controleer de actuele tabel nogmaals voordat u een implementatie met een lange levensduur uitvoert.
Hoeveel kost de Sonnet 4.5 API?
De standaardprijs bedraagt $3 per miljoen invoertokens en $15 per miljoen uitvoertokens. De batchprijs bedraagt respectievelijk $1,50 en $7,50. Voor het schrijven naar en lezen uit de cache gelden aparte tarieven.
Is Claude Sonnet 4.5 gratis?
Voor direct API-gebruik wordt per token betaald. Bij toegang via Claude of GlobalGPT gelden het abonnement en de gebruikslimieten van de betreffende dienst; controleer de geselecteerde dienst voordat u een grote werklast start.
Was de bewering over de 30 uur een garantie voor de gebruiker?
Nr. Anthropic schreef dat het meer dan 30 uur had gemeten bij complexe taken met meerdere stappen. Dat is een verouderde waarneming van de leverancier, geen garantie voor elke gebruiker of elke werklast.
Is Sonnet 4.5 beter dan ChatGPT 5?
Zonder opdracht, set met aanwijzingen, hulpmiddelen en beoordelingsregels kan er geen enkele winnaar zijn. Vergelijk de modellen op basis van hun werkwijze bij het coderen, redeneren en het gebruik van hulpmiddelen, in plaats van een zoekfragment als maatstaf te nemen.
Om Sonnet 4.5 naast je andere AI-tools te gebruiken, de huidige GlobalGPT-modelpagina openen. Begin met een echte programmeervraag of een debuggingtaak, en pas vervolgens dezelfde projectcontext toe op onderzoek en documentatie.