Vergelijking van Claude-modellen: Haiku vs Sonnet vs Opus, en waar Fable in dit rijtje past
Ariette Wynn
Laatst bijgewerkt op 9 september 2026
Een praktische gids voor 2026 om keuzes te maken op basis van snelheid, API-kosten, context, de complexiteit van de taak en de kosten van een verkeerd antwoord.
Voor de meeste alledaagse taken zoals schrijven, analyseren, programmeren en het gebruik van tools kun je het beste beginnen met Claude Sonnet 5. Kies Haiku 4.5 wanneer een lage latentie en een hoog verwerkingsvolume belangrijker zijn dan het afhandelen van lastige randgevallen. Kies Opus 5 wanneer de taak complex is, moeilijk te controleren of wanneer fouten grote gevolgen hebben. Fable 5.1 staat boven Opus als een gespecialiseerd escalatiepad, niet als standaard.
Deze aanbevelingen gelden voor algemene gemengde workloads. Volgens de productie-richtlijnen van Anthropic zouden de meeste workloads met Opus 5 moeten beginnen, terwijl Sonnet in de eigen taakmatrix apart wordt genoemd voor dagelijkse taken waarbij snelheid en capaciteit centraal staan. Het juiste startpunt hangt daarom af van uw risicotolerantie en evaluatieproces, en niet alleen van de modelnaam.
GlobalGPT zorgt voor een bredere workflow Handig met één betaalbaar abonnement: Claude, GPT-5.6 Sol, Gemini 3 Pro, Kimi K3 en diverse AI-functies delen één dashboard voor onderzoek, schrijven, analyse, coderen en verfijning. De CLI zorgt er bovendien voor dat u vanuit uw terminal, ontwikkelingsworkflow en bestaande productietools toegang krijgt tot die modellen. Het vergelijken van resultaten is een nuttig onderdeel van de workflow; voor een bredere keuze op familieniveau, zie onze Vergelijking tussen ChatGPT, Claude en Gemini. De rest van deze gids gaat over het maken van keuzes binnen Claude.
De vier huidige niveaus bieden een oplossing voor verschillende economische problemen. Het goedkoopste gesprek is niet altijd de goedkoopste voltooide taak, en het krachtigste model betekent niet automatisch dat het budget optimaal wordt benut.
Beslissingsgids voor het Claude-model
Kies op basis van werklast en kosten bij uitval
Gebruik Sonnet voor evenwichtig dagelijks werk, schakel een stapje terug voor efficiëntie en schakel een stapje op wanneer verificatie lastig is of fouten veel kosten.
Haiku 4.5
Efficiëntie staat voorop
Begin hier met taken die grote volumes verwerken, waarbij vertraging een belangrijke rol speelt en die duidelijk afgebakend zijn, en waarbij fouten goedkoop kunnen worden opgespoord en gecorrigeerd.
Ga een stapje hoger wanneerUitzonderingsgevallen of de tijd die beoordelaars nodig hebben om correcties aan te brengen, doen het prijsvoordeel van het token teniet.
Sonnet 5
Dagelijks evenwicht
Gebruik dit voor gemengde schrijfopdrachten, analyses, programmeeropdrachten, visuele begripsopdrachten en opdrachten waarbij gereedschap wordt gebruikt, die nog steeds op de gebruikelijke wijze worden beoordeeld.
Ga een stapje hoger wanneerRedeneren op lange termijn, verificatie of de kosten van mislukking worden de beperkende factor.
Opus 5
Functionaliteit staat voorop
Begin hier als het gaat om complexe agentische codering, bedrijfsmatige projecten, moeilijke diagnoses of beslissingen waarbij fouten hoge kosten met zich meebrengen.
Ga naar beneden wanneerEen goedkoper model doorstaat herhaaldelijk dezelfde acceptatietests.
Fable 5.1
Uitzonderingspad
Escaleer alleen bij veeleisende redeneringen of langdurige agenttaken wanneer Opus, dat meer inspanning vergt, nog steeds niet aan je evaluatiecriteria voldoet.
Ga er niet zomaar vanuitEen hoger niveau is automatisch goedkoper nadat rekening is gehouden met kwaliteit, beoordelingstijd en herhalingspogingen.
De praktische regel
Leg één representatieve taak en de bijbehorende acceptatiecontroles vast. Kies het goedkoopste model dat betrouwbaar slaagt, en bereken vervolgens de tijd die nodig is voor correctie en verificatie voordat je het de goedkoopste optie noemt.
Het huidige Claude-modellenassortiment
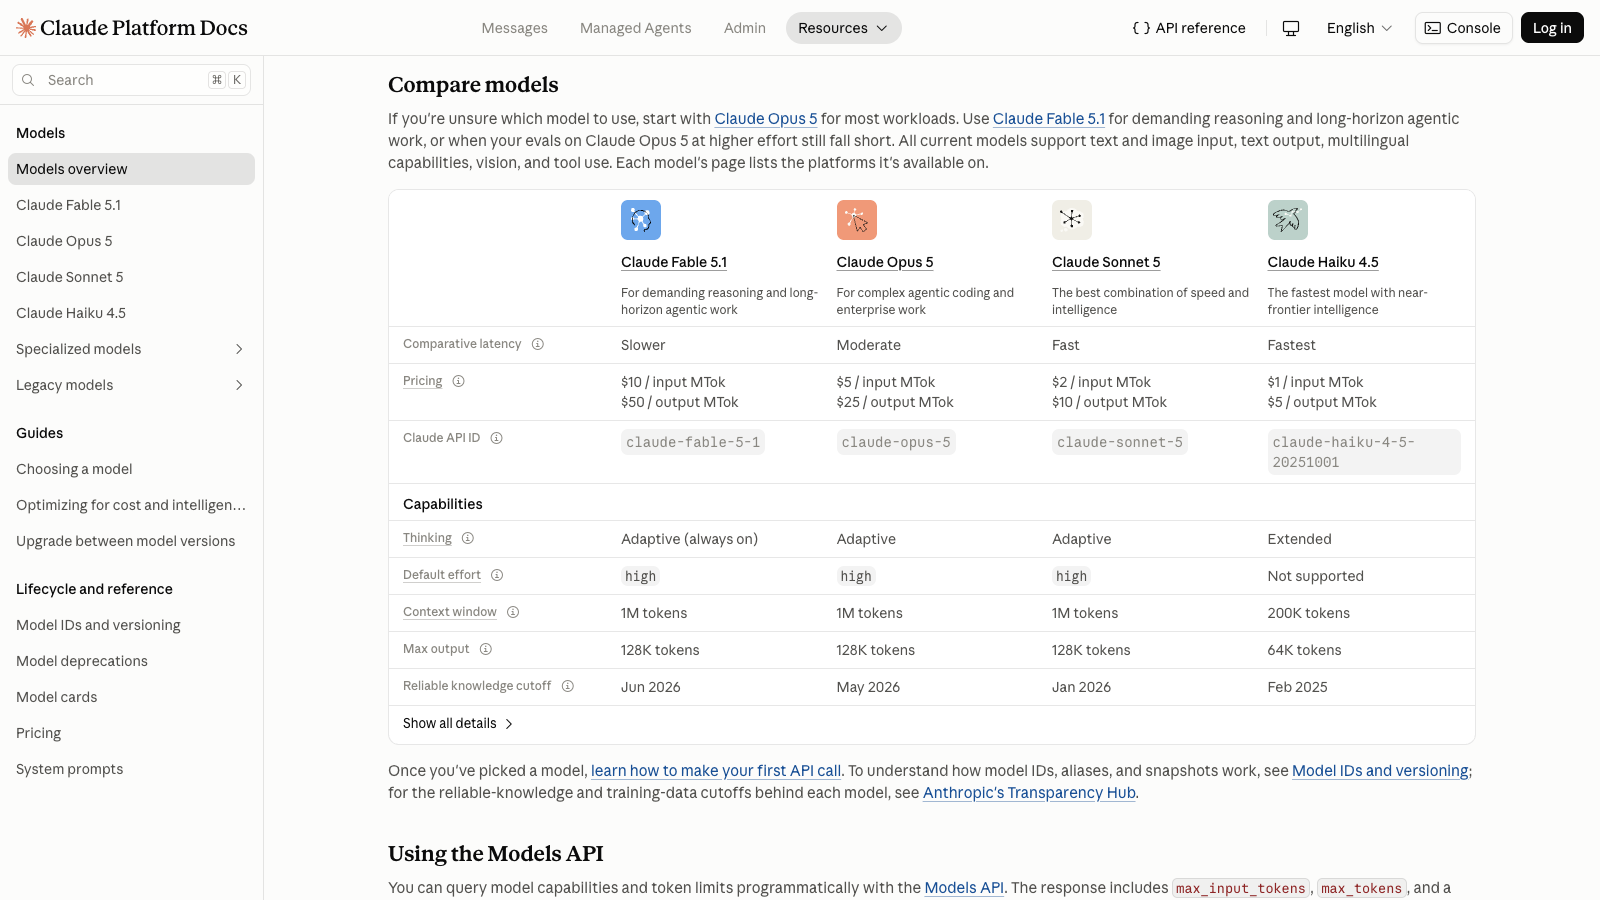
Per 8 september 2026 bestaat het actieve assortiment van Anthropic uit Claude Haiku 4.5, Claude Sonnet 5, Claude Opus 5 en Claude Fable 5.1. Haiku, Sonnet en Opus zijn vaste productnamen, maar de versie die bij elke productlijn hoort, verandert in de loop van de tijd. Noteer de exacte model-ID die u in de productieomgeving hebt getest, in plaats van ervan uit te gaan dat een productnaam altijd naar dezelfde snapshot verwijst.
Huidig model
Officieel snelheidslabel
API-context
Maximaal vermogen
Basis-API-invoer / -uitvoer
Haiku 4.5
Snelste
200K
64K
$1 / $5 per MTok
Sonnet 5
Snel
1M
128K
$2 / $10 per MTok
Opus 5
Matig
1M
128K
$5 / $25 per MTok
Fable 5.1
Langzamer
1M
128K
$10 / $50 per MTok
In het modellenoverzicht van Anthropic worden Haiku 4.5, Sonnet 5, Opus 5 en Fable 5.1 vermeld als het huidige assortiment op 8 september 2026.
Toegang tot Claude.ai is niet hetzelfde als API-specificaties
De tarieftabel voor Claude.ai beschrijft de toegang voor consumenten en vermeldt momenteel een contextvenster van 200K voor individuele abonnementen. De API-documentatie vermeldt modelspecifieke context- en uitvoerlimieten, waaronder een context van 1M voor Sonnet 5, Opus 5 en Fable 5.1. Gebruik de API-tabel niet om af te leiden wat een bepaald Claude.ai-abonnement precies omvat, en gebruik de abonneetabel ook niet om de limieten van een API-model af te leiden. Zie de Prijs- en abonnementengids voor Claude voor het onderscheid op planniveau.
Claude Haiku vs Sonnet vs Opus: de belangrijkste verschillen
De belangrijkste afweging is niet louter een ranglijst op basis van kwaliteit. Door hoger in de reeks te kiezen, krijg je meer mogelijkheden voor complex werk, maar stijgen ook de basiskosten in tokens en neemt de snelheid doorgaans af. Ook de contextbeperkingen en de redeneerregels verschillen.
De praktische afwegingen
Officiële labels en basis-API-specificaties, gecombineerd met praktische uitgangspunten voor veelvoorkomende workloads.
Afmeting
Haiku 4.5
Sonnet 5
Opus 5
Het beste uitgangspunt
Snel, herhaald, begrensd werk
Gemengd dagelijks kenniswerk
Complex werk met verstrekkende gevolgen
Officieel snelheidslabel
Snelste
Snel
Matig
API-context / uitvoer
200K / 64K
1M / 128K
1M / 128K
Controle van de redenering
Handmatig uitgebreid denken
Flexibel denken en inzet
Flexibel denken en inzet
Basisprijs van de API
$1-ingang / $5-uitgang
$2-ingang / $10-uitgang
$5 ingang / $25 uitgang
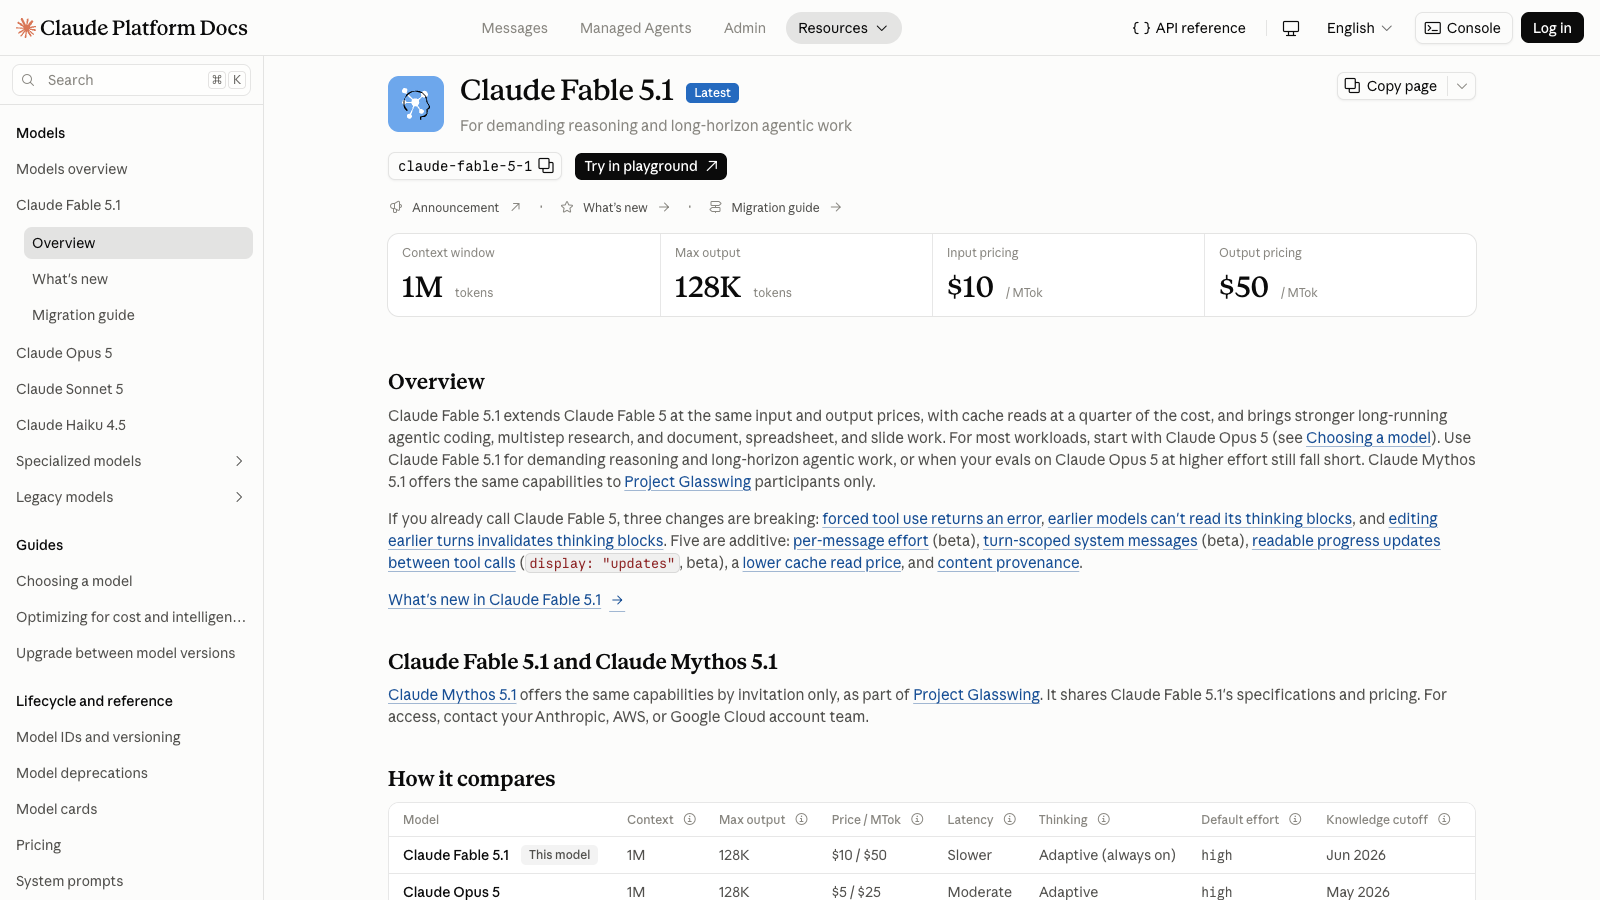
Waar Fable past: Fable 5.1 wordt officieel aangeduid als ‘Slower’, met een context van 1 miljoen, een maximale output van 128K en basisprijzen voor input en output volgens het $10-/$50-tarief per miljoen tokens. Beschouw dit als een escalatieniveau wanneer Opus, zelfs bij een hogere inspanning, nog steeds niet aan uw evaluatie voldoet.
Snelheid en latentie
Anthropic wordt aangeduid als Haiku 4.5 “Snelst”, Sonnet 5 als “Snel”, Opus 5 als “Matig” en Fable 5.1 als “Langzamer”. Dit zijn kwalitatieve productlabels, geen gemeten milliseconden of tokens per seconde. De werkelijke latentie is afhankelijk van de grootte van het verzoek, de instellingen voor redenering, de gebruikte tools, de belasting en de bedieningsmodus.
Instellingen voor context, uitvoer en redenering
De kleinere API-context van 200K en de maximale output van 64K van Haiku zijn voor veel beperkte taken nog steeds ruim voldoende. Sonnet en Opus breiden beide limieten uit tot 1M en 128K. Haiku 4.5 maakt gebruik van handmatig uitgebreid redeneren, terwijl Sonnet 5 en Opus 5 adaptief redeneren en inspanningscontrole ondersteunen. Dat verschil is een van de redenen waarom één enkele identieke redeneringsinstelling niet voor alle modellen perfect gelijkwaardige tests kan opleveren.
Welk Claude-model moet je voor welke taak gebruiken?
Werkdruk
Begin met
Waarom
Upgraden wanneer
Classificatie, gegevensontsluiting, routering, triage van ondersteuning
Haiku 4.5
Een lage latentie en lage basiskosten voor tokens zijn geschikt voor duidelijk, herhaalbaar werk.
In uitzonderlijke gevallen of door correctietijd gaan de besparingen verloren.
De prestaties zijn belangrijker dan de laagste prijs per token.
Opus, dat meer inspanning vergt, voldoet nog steeds niet aan een strenge, representatieve beoordeling.
Werk dat uitzonderlijk lang duurt of veel denkwerk vereist
Fable 5.1
Dit is het huidige escalatiepad boven Opus.
Gebruik dit alleen wanneer het gemeten voordeel de hogere kosten rechtvaardigt.
Dit zijn uitgangspunten, geen universele oplossingen. Zo kan een korte maar risicovolle codewijziging het gebruik van Opus rechtvaardigen, terwijl een lange maar zeer gestructureerde extractietaak wellicht toch beter bij Haiku past. Voor praktische voorbeelden van workflows verwijzen we je naar onze gids over met behulp van Claude voor de codering.
Wanneer je shortlist verder reikt dan Claude, kun je met GlobalGPT dezelfde representatieve prompt in één werkruimte door Claude, GPT-5.6 Sol, Gemini 3 Pro en Kimi K3 laten lopen. Houd de acceptatiecontrole constant: snelheid is belangrijk bij herhaald werk, terwijl de kwaliteit van de antwoorden en de correctietijd bepalen of een goedkoper resultaat ook daadwerkelijk voordeliger is.
Kies op basis van de kosten van mislukking, niet alleen op basis van het soort taak
Taaklabels verhullen de belangrijkste variabele: wat gebeurt er als het antwoord fout is? Het onderstaande raamwerk is een hulpmiddel voor redactionele beslissingen, gebaseerd op de richtlijnen van Anthropic waarin efficiëntie en bekwaamheid voorop staan. Het is geen Anthropic-benchmark.
Ladder van faalkosten
Begin met een lagere drempel wanneer fouten gemakkelijk op te sporen zijn; begin met een hogere drempel wanneer de controle onvolledig of kostbaar is.
Escaleren Wanneer correctietijd de efficiëntiewinst tenietdoet
Materiaal
Voorbeelden Ontwerpen voor klanten, gecontroleerde analyses, geteste productiecode
Start Sonnet 5
Escaleren Wanneer een controle belangrijke fouten niet op betrouwbare wijze kan opsporen
Dure
Voorbeelden Veranderingen die een hoge mate van zelfstandigheid vereisen, moeilijke diagnoses, ingrijpende beslissingen
Start Opus 5
Escaleren Naar Fable pas nadat een Opus met hogere inspanning een bevroren evaluatie mist
Wanneer moet u uw Claude-model upgraden of downgraden?
Ga pas omhoog als er een gemeten grenswaarde verschijnt
Haiku naar sonnet
Voer een upgrade uit wanneer randgevallen, gemiste instructies of de tijd die beoordelaars besteden aan correcties de besparingen overstijgen.
Sonnet aan Opus
Voer een upgrade uit wanneer uitvoering op de lange termijn, complexe redeneringen, verificatie of de kosten van mislukking een beperkende factor worden.
Opus bij een hogere inspanning
Test de veeleisende werklast met bevroren acceptatiecontroles voordat je naar het hoogste niveau overgaat.
Van Opus naar Fable
Escaleer alleen als Opus, ondanks de extra inspanning, nog steeds niet voldoet aan de representatieve evaluatie en de voordelen opwegen tegen de kosten.
Regel voor verlaging van de rating: Ga weer een stap terug wanneer een goedkoper model herhaaldelijk dezelfde acceptatietests doorstaat met de vereiste latentie en betrouwbaarheid.
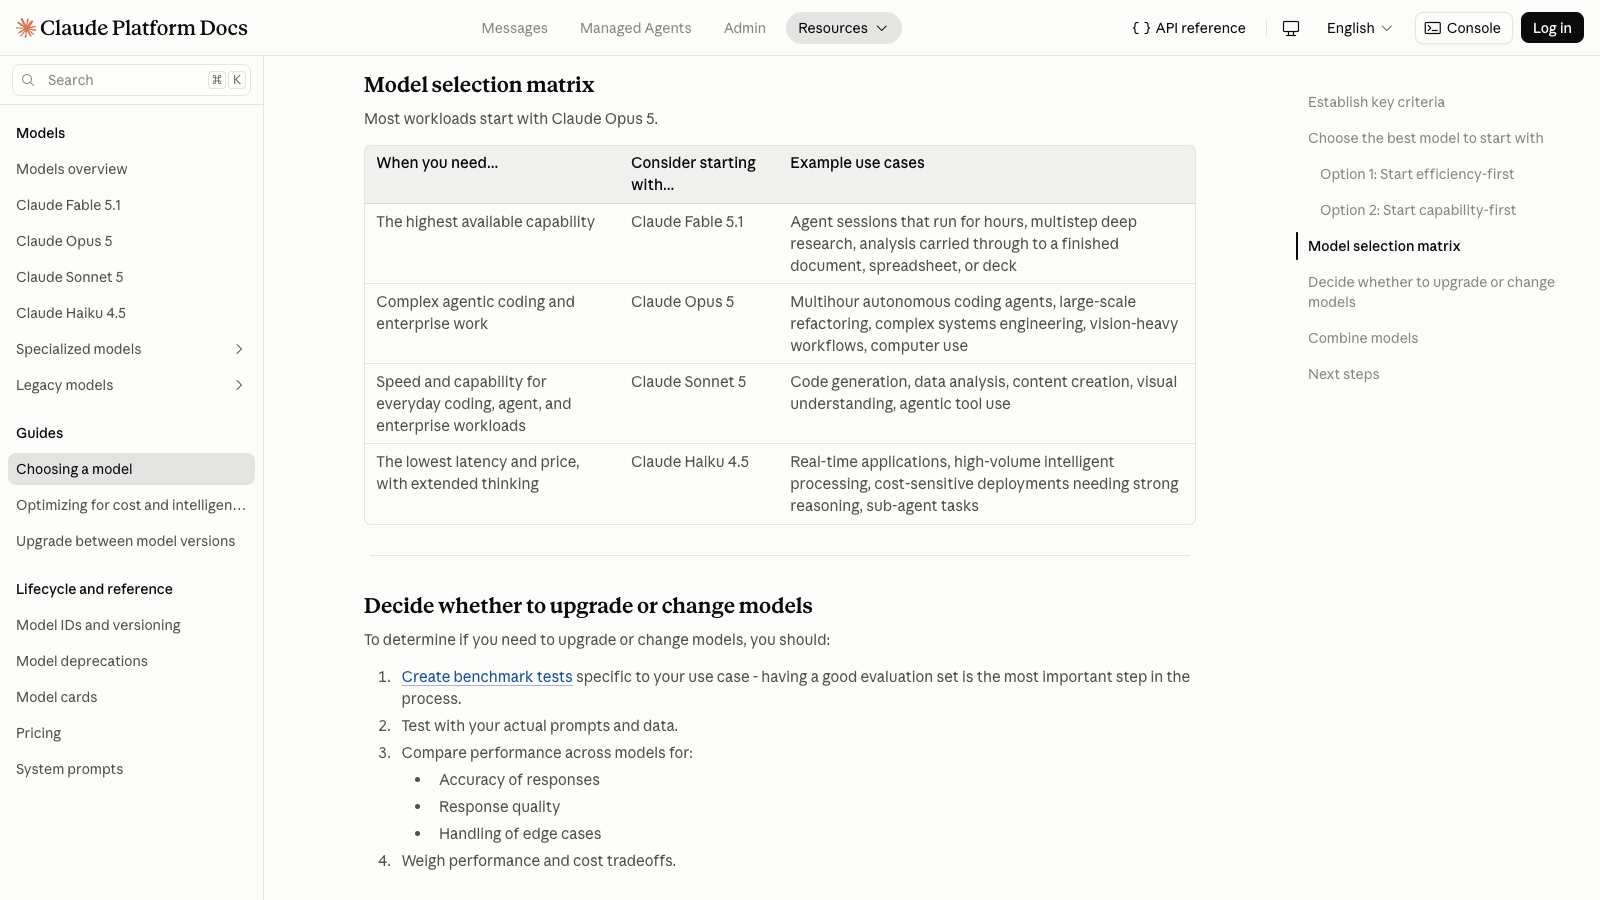
De matrix van Anthropic brengt vier huidige Claude-modellen in kaart op basis van verschillende vereisten op het gebied van capaciteit, snelheid en werklast.
Een voorbeeld van vaste kosten voor de Claude-API
Bij een vaste totale werklast van 1 miljoen invoertokens plus 100.000 uitvoertokens, verdeeld over meerdere standaard API-verzoeken, variëren de basiskosten per token van $1,50 bij Haiku 4.5 tot $15,00 bij Fable 5.1. Dit betreft niet één verzoek en het overschrijft de uitvoerlimieten per verzoek niet.
Eén workload, vier Claude-modellen
Naarmate je naar hogere niveaus stijgt, kost hetzelfde tokenvolume 2x, 5x of 10x het Haiku-totaal.
Werkdruk 1,0 M ingang + 0,1 M uitgang over meerdere verzoeken heen
Haiku 4.5
$1.50
Sonnet 5
$3.00
Opus 5
$7.50
Fable 5.1
$15.00
Model
Berekening van de invoer
Berekening van de output
Totaal
Haiku 4.5
1,0 x $1
0,1 x $5
$1.50
Sonnet 5
1,0 x $2
0,1 x $10
$3.00
Opus 5
1,0 x $5
0,1 x $25
$7.50
Fable 5.1
1,0 x $10
0,1 × $50
$15.00
Inbegrepen: Standaard basiskoersen voor in- en uitstap-tokens op basis van één Anthropic-prijsmomentopname.
Uitgesloten: Caching van prompts, Batch API, snelle modus, geografie, kosten voor tools, belastingen, kortingen en GlobalGPT-tegoed.
De prijstabel geeft de kosten van de tokens weer, niet de kosten van een voltooid resultaat. Een goedkoper model kan uiteindelijk duurder uitvallen als herhalingspogingen, correcties en verificatie meer tijd van het personeel in beslag nemen dan de besparing op de tokens oplevert.
Praktische test met het Claude-model: dezelfde invoer, verschillende storingsmodi
Op 9 september 2026 hebben we dezelfde drie prompts via de Anywhere API naar Claude Haiku 4.5, Sonnet 5, Opus 5 en Fable 5.1 gestuurd. De taken hadden betrekking op gestructureerde ondersteuning bij triage, op bewijs gebaseerd schrijven en controleerbare JavaScript-foutopsporing. We hebben de eerste geldige uitvoer van elk model bewaard en deze beoordeeld aan de hand van regels die waren vastgelegd voordat de antwoorden werden beoordeeld.
Het resultaat was geen eenvoudige ranglijst. Sonnet, Opus en Fable scoorden elk 26,5 van de 30 punten, terwijl hun sterke en zwakke punten sterk van elkaar verschilden. Haiku gaf bij beide toegestane pogingen voor elke taak een HTTP 503-foutmelding, waardoor de kwaliteit van de uitvoer in deze test onbekend blijft.
Testopstelling en totaalresultaat
Drie vaste prompts, dezelfde limieten voor het aantal tokens per taak, geen hulpmiddelen of zoekfunctie, en voor elk model wordt de eerste geldige uitvoer behouden.
Regel voor herhalingEenmaal voor transport, 429/5xx, lege inhoud of onjuist opgebouwd antwoord
Model
Voltooide taken
Totale kwaliteitsscore
Meest nuttige signaal
Claude Haiku 4.5
0/3
Niet gescoord
Alle zes toegestane verzoeken leverden een 503-fout op; alleen routebeschikbaarheid.
Claude Sonnet 5
3/3
26.5/30
Het enige model dat aan alle vereisten uit de lanceringsnotitie voldoet.
Claude Opus 5
3/3
26.5/30
Grote diepgang bij het opsporen van fouten; er is een beperking op de schrijflengte over het hoofd gezien.
Claude Fable 5.1
3/3
26.5/30
Overzichtelijke, gestructureerde uitvoer; de startmelding werd afgebroken na één leeg antwoord.
Gestructureerde uitvoer
Test 1: Triage van supporttickets
Resultaat van de opdracht: Fable 5.1, 10/10
Fable was het enige model dat direct parseerbare JSON teruggaf waarin alle zes labels en acties correct waren. Opus en Sonnet hadden de labels weliswaar goed, maar voegden Markdown-fences toe; beide modellen verstrakten bovendien een opgegeven deadline, en Sonnet beloofde voortijdig een correctie of terugbetaling.
Model
Status
Score
Latentie overal
Gemelde tokens
Wat is er gebeurd?
Claude Haiku 4.5
Route niet beschikbaar
Niet gescoord
Niet beschikbaar
Niet beschikbaar
Twee 503-responsen; geen kwaliteitsscore.
Claude Sonnet 5
Uitvoer behouden
7.5/10
10,39 s
1005
De labels kloppen, maar de JSON is omheind en er is een verzonnen uitkomst voor terugbetaling/correctie.
Claude Opus 5
Uitvoer behouden
8.5/10
11,87 s
1051
Juiste labels en krachtige maatregelen, maar omheinde JSON en een strakkere deadline.
Claude Fable 5.1
Uitvoer behouden
10/10
8,55 s
680
Direct te parseren JSON; alle ‘frozen’-controles zijn geslaagd.
Volledige testinvoer
Je beheert een SaaS-ondersteuningsinbox. Classificeer elk ticket hieronder. Retourneer alleen JSON met één veld op het hoogste niveau met de naam tickets. tickets moet een array zijn in de oorspronkelijke volgorde, en elk item moet precies ticket_id, category, urgency en action bevatten. category moet een van de volgende zijn: billing, access, bug, feature. urgency moet een van de volgende zijn: low, medium, high. Gebruik uitsluitend de tekst van het ticket; verzin geen beleidsuitkomsten of feiten over de klant.

#481: Er is ons tweemaal een bedrag in rekening gebracht voor dezelfde jaarlijkse verlenging. De salarisadministratie sluit vrijdag en ik wil dat dit voor die tijd wordt onderzocht.
#482: Bij het opnieuw instellen van het wachtwoord staat dat de e-mail is verzonden, maar ik ontvang niets. Ik heb de spamfolder gecontroleerd en het nog een keer geprobeerd.
#483: Bij CSV-exporten worden alle valutabedragen afgerond op hele dollars, terwijl het dashboard nog steeds centen weergeeft.
#484: Voeg alstublieft een donkere modus toe aan het analysedashboard.
#485: Nadat ons bedrijfsdomein vanochtend is gewijzigd, krijgt elke medewerker een melding dat SSO-toegang is geweigerd.
#486: Kunt u mij een kopie van de factuur van vorige maand sturen?
Claude Haiku 4.5: volledig bedrijfsresultaat
Er werd geen modeloutput gegenereerd. Beide toegestane pogingen via de Anywhere API leverden een HTTP 503-foutcode op, waardoor deze route als niet beschikbaar werd gemarkeerd en buiten de kwaliteitsbeoordeling werd gehouden.
Claude Sonnet 5: volledig vermogen
```json
{
  "tickets": [
    {
 "ticket_id": "#481",
      "category": "facturering",
 "urgency": "hoog",
 "action": "Onderzoek de dubbele jaarlijkse verlengingskosten en zorg voor een correctie/terugbetaling voordat de salarisafrekening van de klant vrijdag wordt afgesloten."
    },
    {
 "ticket_id": "#482",
      "category": "access",
 "urgency": "medium",
 "action": "Controleer het e-mailadres en de bezorgbaarheid van de e-mail van het account, en activeer vervolgens handmatig de e-mail voor het opnieuw instellen van het wachtwoord of verstuur deze opnieuw."
    },
    {
 "ticket_id": "#483",
      "category": "bug",
 "urgency": "medium",
 "action": "Escaleren naar de technische afdeling om de afronding bij CSV-export te corrigeren, zodat de valutawaarden overeenkomen met de precisie tot op de cent die op het dashboard wordt weergegeven."
    },
    {
 "ticket_id": "#484",
 "category": "feature",
 "urgency": "low",
 "action": "Registreer het verzoek om een donkere modus voor het analysedashboard en voeg dit toe aan de productfeature-backlog."
    },
    {
 "ticket_id": "#485",
      "category": "access",
 "urgency": "high",
 "action": "Onderzoek onmiddellijk de SSO-configuratie die gekoppeld is aan het gewijzigde bedrijfsdomein en herstel de toegang voor alle betrokken medewerkers."
    },
    {
      "ticket_id": "#486",
 "category": "facturering",
 "urgency": "laag",
 "action": "Zoek de factuur van vorige maand op en stuur een kopie naar de klant."
    }
  ]
}
```
Claude Opus 5: volledig vermogen
```json
{
  "tickets": [
    {
 "ticket_id": "481",
 "category": "facturering",
 "urgency": "hoog",
 "action": "Doorsturen naar de factureringsafdeling om de dubbele jaarlijkse verlengingskosten te controleren en de oplossing te bevestigen vóór de afsluiting van de salarisadministratie van de klant op vrijdag."
    },
    {
 "ticket_id": "482",
      "category": "access",
 "urgency": "medium",
 "action": "Controleer de e-mailbezorgingslogboeken op het resetbericht naar dat adres en start, indien niet bezorgd, een geverifieerd resetproces voor de gebruiker."
    },
    {
 "ticket_id": "483",
      "category": "bug",
 "urgency": "medium",
 "action": "Dien een bugrapport in over het afronden van valuta bij CSV-export, waarbij je de afwijking ten opzichte van de waarden op het dashboard vermeldt, en vraag om stappen om het probleem te reproduceren of om een voorbeeldexport."
    },
    {
 "ticket_id": "484",
 "category": "feature",
 "urgency": "low",
 "action": "Registreer dit als een verzoek om een donkere modus voor het analysedashboard en bevestig de ontvangst zonder een tijdschema toe te zeggen."
    },
    {
 "ticket_id": "485",
      "category": "access",
 "urgency": "high",
 "action": "Escaleer dit als een organisatiebrede SSO-storing die verband houdt met de domeinwijziging; laat de afdeling identiteit/authenticatie de SSO-domeinconfiguratie onmiddellijk controleren."
    },
    {
      "ticket_id": "486",
 "category": "facturering",
 "urgency": "laag",
 "action": "Stuur de gevraagde kopie van de factuur van de vorige maand naar de geverifieerde contactpersoon van het account."
    }
  ]
}
```
Claude Fable 5.1: volledig vermogen
{"tickets":[{"ticket_id":"481","category":"facturering","urgency":"hoog","action":"Onderzoek de gemelde dubbele jaarlijkse verlengingskosten en reageer vóór de deadline van de klant op vrijdag voor de salarisuitbetaling."},{"ticket_id":"482","category":"access","urgency":"medium","action":"Controleer de verzendlogboeken van e-mails voor het resetten van wachtwoorden voor het e-mailadres van de gebruiker en verstuur de e-mail opnieuw of bied een alternatieve manier aan om het wachtwoord te resetten."},{"ticket_id":"483","category":"bug","urgency":"medium","action":"Reproduceer de afronding van valutabedragen naar hele dollars bij de CSV-export en escaleer dit naar de technische afdeling voor een oplossing."},{"ticket_id":"484","category":"feature","urgency":"low","action":"Registreer het verzoek om een donkere modus voor het analysedashboard bij het productteam en bevestig de ontvangst."},{"ticket_id":"485","category":"access","urgency":"high","action":"Escaleer de bedrijfsbrede SSO-toegangsfouten na de domeinwijziging en controleer de SSO-domeinconfiguratie."},{"ticket_id":"486","category":"billing","urgency":"low","action":"Zoek de factuur van vorige maand op en stuur de klant een kopie."}]}
Beleid op basis van de eerste geldige output. De latentie is de werkelijke tijd via Anywhere, niet de native Anthropic-latentie. Het aantal tokens wordt door de provider gerapporteerd; uit deze route kunnen geen directe API-kosten worden afgeleid.
Het volgen van beperkingen
Test 2: Op feiten gebaseerde lanceringsnota
Resultaat van de opdracht: Sonnet 5, 10/10
Sonnet was het enige model dat aan alle gestelde eisen voldeed. Opus produceerde een krachtige opmerking, maar overschreed het maximum aantal woorden en suggereerde dat alle niet-reageerders ingeschreven studenten waren. Het eerste antwoord van Fable was leeg; bij de toegestane herpoging leverde het een zichtbaar ingekorte opmerking op, zonder aanbeveling of voorbehoud.
Model
Status
Score
Latentie overal
Gemelde tokens
Wat is er gebeurd?
Claude Haiku 4.5
Route niet beschikbaar
Niet gescoord
Niet beschikbaar
Niet beschikbaar
Twee 503-responsen; geen kwaliteitsscore.
Claude Sonnet 5
Uitvoer behouden
10/10
9,94 s
796
Voldaan aan de vereisten met betrekking tot de termen ‘bereik’, ‘structuur’, ‘bewijs’, ‘aanbeveling’ en ‘voorbehoud’.
Claude Opus 5
Uitvoer behouden
8/10
9,49 s
826
Een sterke analyse, maar 223 woorden te weinig volgens de ‘frozen count’-methode en één ongefundeerde conclusie.
Claude Fable 5.1
Uitvoer behouden
6.5/10
19,27 s
1685
Eerste reactie leeg; de bewaarde herhalingspoging werd afgebroken vóór de aanbeveling en de kanttekening.
Volledige testinvoer
Schrijf een interne lanceringsnota van 180-220 woorden voor een productdirecteur, waarbij je uitsluitend de onderstaande feiten gebruikt. Neem het volgende op: een onderwerpregel, een korte inleidende alinea, precies drie opsommingstekens, een aanbeveling en één duidelijk aangegeven voorbehoud. Verzin geen begrotingsbesluit, percentages, statistische significantie of causale effecten.

Feiten:
- Aan het proefproject namen 120 studenten deel.
- Bij de tussenstand op 31 maart hadden 96 studenten ten minste drie sessies bijgewoond.
- De gemiddelde score in de enquête bedroeg 4,3 op 5, gebaseerd op 71 respondenten.
- Op het programma-overzicht staat een budget van $18.000 vermeld.
- In de goedkeuringsnota van de financiële afdeling staat $20.000 vermeld. Er wordt niet vermeld of het verschil het gevolg is van een herziening of een boekhoudkundige fout.
- De deelnemers werden niet willekeurig ingedeeld en er werd geen uitgangsscore vastgelegd.
- De beslissing betreft het al dan niet starten van een tweede proefproject, niet de vraag of het programma permanent zal worden ingevoerd.
Claude Haiku 4.5: volledig bedrijfsresultaat
Er werd geen modeloutput gegenereerd. Beide toegestane pogingen via de Anywhere API leverden een HTTP 503-foutcode op, waardoor deze route als niet beschikbaar werd gemarkeerd en buiten de kwaliteitsbeoordeling werd gehouden.
Claude Sonnet 5: volledig vermogen
**Onderwerp: Resultaten proefprogramma — Aanbeveling om door te gaan met een tweede proef**

De eerste proef heeft de eerste evaluatiefase afgerond en de eerste indicatoren op het gebied van betrokkenheid en tevredenheid zijn bemoedigend. Alvorens toe te zeggen op een tweede proef, zijn er enkele gegevens en openstaande punten die het team gezamenlijk moet bespreken.

- Van de 120 ingeschreven studenten hadden er 96 op de peildatum van 31 maart ten minste drie sessies bijgewoond.
- Een enquête na afloop van de sessies, ingevuld door 71 respondenten, leverde een gemiddelde score op van 4,3 op een schaal van 5.
- De begrotingscijfers lopen in de verschillende documenten uiteen: op het programma-overzicht staat $18.000 vermeld, terwijl in de goedkeuringsnota van de financiële afdeling $20.000 staat; het is onduidelijk of dit het gevolg is van een herziening of een boekhoudkundige fout.

**Aanbeveling:** Gezien de aanwezigheidscijfers en de enquêteresultaten raden wij aan om door te gaan met een tweede pilot om meer gestructureerde gegevens te verzamelen — idealiter met een duidelijk omschreven vergelijkingsgroep en een nulmeting — alvorens een besluit te nemen over een bredere uitrol. Deze tweede pilot zou ook de gelegenheid moeten bieden om de budgettaire discrepantie met de financiële afdeling op te lossen voordat de financiering definitief wordt vastgesteld.

**Voorbehoud:** Deze resultaten moeten met de nodige voorzichtigheid worden geïnterpreteerd. De deelnemers zijn niet willekeurig ingedeeld en er is geen uitgangsscore vastgelegd, waardoor we de enquêteresultaten of aanwezigheidspatronen niet aan het programma zelf kunnen toeschrijven. Dit is een beslissing om de omvang van een tweede proefproject te bepalen, geen beslissing over definitieve implementatie.
Claude Opus 5: volledig vermogen
**Onderwerp: Resultaten van de pilot en aanbeveling inzake een tweede pilotgroep**

De eerste pilot heeft de tussentijdse evaluatie van 31 maart afgerond en we beschikken nu over voldoende informatie om te beslissen of we een tweede pilot zullen uitvoeren. In deze notitie wordt samengevat wat we hebben waargenomen, wat we aanbevelen en wat de belangrijkste beperking is bij de interpretatie. Er ligt in dit stadium nog geen besluit over een definitieve uitrol op tafel.

- **Inschrijving en betrokkenheid:** 120 studenten hebben zich ingeschreven. Bij de tussentijdse evaluatie op 31 maart hadden 96 van hen ten minste drie sessies bijgewoond.
- **Feedback van deelnemers:** De enquête na afloop van het programma scoorde gemiddeld 4,3 op 5, gebaseerd op 71 respondenten. De overige ingeschreven studenten hebben niet gereageerd, dus de score weerspiegelt alleen die subgroep.
- **Budgetverschil:** Op het programma-overzicht staat een budget van $18.000 vermeld, terwijl in de goedkeuringsnota van de financiële afdeling $20.000 staat vermeld. In de financiële nota wordt niet vermeld of het verschil het gevolg is van een herziening of een boekhoudkundige fout, en we hebben nog niet kunnen vaststellen welk bedrag de juiste is.

**Aanbeveling:** Ga door met de planning van een tweede proefproject, op voorwaarde dat Financiën en Programma-uitvoering de twee begrotingscijfers met elkaar in overeenstemming brengen en één definitief bedrag bevestigen voordat we de uitgaven vastleggen. Bij een tweede proefproject moeten ook uitgangsscores worden verzameld bij aanvang.

**WAARSCHUWING:** Deelnemers werden niet willekeurig toegewezen en er werden geen uitgangsscores verzameld. De cijfers over betrokkenheid en enquêtes geven daarom weer wat deze groep deed en rapporteerde; ze kunnen ons niet vertellen wat het programma teweegbracht of hoe het zou presteren bij een andere doelgroep.
Claude Fable 5.1: volledig vermogen
**Onderwerp:** Samenvatting van de tussentijdse evaluatie van de pilot en aanbeveling voor een tweede pilot

Hallo [directeur],

Hieronder volgt een samenvatting van de stand van zaken van de pilot bij de tussentijdse evaluatie op 31 maart, samen met een aanbeveling over het al dan niet doorgaan met een tweede pilot. Deze notitie heeft uitsluitend betrekking op de beslissing over een tweede pilot, niet op de definitieve invoering.

- **Inschrijvingen en aanwezigheid:** 120 studenten hebben zich ingeschreven. Bij de tussentijdse evaluatie op 31 maart hadden 96 studenten ten minste drie sessies bijgewoond.
- **Feedback van deelnemers:** Uit een enquête onder 71 respondenten kwam een gemiddelde score van 4,3 op een schaal van 5 naar voren.
- **Begrotingsgegevens:** Op het programma-overzicht staat een begroting van $18.000 vermeld, terwijl in de goedkeuringsnota van de financiële afdeling $20.000 staat vermeld. Uit de financiële nota blijkt niet of het verschil het gevolg is van een herziening of een boekhoudkundige fout.

**
Beleid op basis van de eerste geldige output. De latentie is de werkelijke tijd via Anywhere, niet de native Anthropic-latentie. Het aantal tokens wordt door de provider gerapporteerd; uit deze route kunnen geen directe API-kosten worden afgeleid.
Juistheid van de code
Test 3: Controleerbare JavaScript-foutopsporing
Resultaat van de opdracht: Opus 5 en Fable 5.1 staan gelijk, 10/10
Alle drie de beschikbare modellen hebben zowel fouten gevonden als vervangende oplossingen gegenereerd die aan acht uitvoerbare testgevallen voldeden. Opus en Fable leverden geldige JSON op en eindigden ex aequo met 10/10. De code van Sonnet voldeed ook aan de eisen, maar de omringende Markdown-afbakening maakte dat niet aan de vereiste voor directe JSON werd voldaan.
Model
Status
Score
Latentie overal
Gemelde tokens
Wat is er gebeurd?
Claude Haiku 4.5
Route niet beschikbaar
Niet gescoord
Niet beschikbaar
Niet beschikbaar
Twee 503-responsen; geen kwaliteitsscore.
Claude Sonnet 5
Uitvoer behouden
9/10
13,17 s
1471
De vervangende versie slaagde in 8 van de 8 gevallen; de omheinde uitvoer verloor het punt voor het JSON-formaat.
Claude Opus 5
Uitvoer behouden
10/10
20,17 s
1826
Geldige JSON, beide fouten zijn vastgesteld en alle 8 uitvoerbare gevallen zijn geslaagd.
Claude Fable 5.1
Uitvoer behouden
10/10
15,89 s
1409
Geldige JSON, beknopte diagnose en 8 van de 8 uitvoerbare gevallen geslaagd.
Volledige testinvoer
Diagnoseer en herstel deze JavaScript-functie. Retourneer uitsluitend JSON met precies vier velden: root_cause (string), replacement (string met de volledige vervangingsfunctie), tests (array van testcase-strings) en remaining_risk (string). Geef niet aan dat je tests hebt uitgevoerd. Voer de kleinst mogelijke, duidelijke correctie uit die aan het contract voldoet.

Contract:
- `tasks` is een array van functies zonder argumenten die `Promises` retourneren.
- Retourneer de eerste vervulde waarde in de volgorde van invoer, zelfs als die waarde 0, `false` of een lege tekenreeks is.
- Negeer afgewezen taken.
- Retourneer `null` wanneer elke taak wordt afgewezen of de array leeg is.

Huidige code:
async function firstSuccessful(tasks) {
  const results = await Promise.all(tasks.map((task) => task()));
  return results.find(Boolean) || null;
}
Claude Haiku 4.5: volledig bedrijfsresultaat
Er werd geen modeloutput gegenereerd. Beide toegestane pogingen via de Anywhere API leverden een HTTP 503-foutcode op, waardoor deze route als niet beschikbaar werd gemarkeerd en buiten de kwaliteitsbeoordeling werd gehouden.
Claude Sonnet 5: volledig vermogen
```json
{
  "root_cause": "Two bugs: (1) Promise.all rejects immediately if any task rejects, instead of ignoring rejected tasks; (2) results.find(Boolean) incorrectly treats falsy fulfilled values (0, false, '') as failures, causing them to be skipped in favor of null.",
  "replacement": "async function firstSuccessful(tasks) {\n  const settled = await Promise.allSettled(tasks.map((task) => task()));\n  const firstFulfilled = settled.find((r) => r.status === 'fulfilled');\n  return firstFulfilled ? firstFulfilled.value : null;\n}",
  "tests": [
    "test('returns null for empty array', async () => { expect(await firstSuccessful([])).toBeNull(); });",
    "test('returns null when all tasks reject', async () => { const tasks = [() => Promise.reject('err1'), () => Promise.reject('err2')]; expect(await firstSuccessful(tasks)).toBeNull(); });",
    "test('returns first fulfilled value even if falsy (0)', async () => { const tasks = [() => Promise.resolve(0), () => Promise.resolve(42)]; expect(await firstSuccessful(tasks)).toBe(0); });",
    "test('returns first fulfilled value even if false', async () => { const tasks = [() => Promise.resolve(false), () => Promise.resolve(true)]; expect(await firstSuccessful(tasks)).toBe(false); });",
    "test('returns first fulfilled value even if empty string', async () => { const tasks = [() => Promise.resolve(''), () => Promise.resolve('nonempty')]; expect(await firstSuccessful(tasks)).toBe(''); });",
    "test('ignores leading rejected tasks and returns first fulfilled in order', async () => { const tasks = [() => Promise.reject('err'), () => Promise.resolve('second'), () => Promise.resolve('third')]; expect(await firstSuccessful(tasks)).toBe('second'); });",
    "test('preserves input order even if later task resolves faster', async () => { const tasks = [() => new Promise((res) => setTimeout(() => res('slow-first'), 50)), () => new Promise((res) => setTimeout(() => res('fast-second'), 5))]; expect(await firstSuccessful(tasks)).toBe('slow-first'); });"
  ],
  "remaining_risk": "The fix assumes 'first fulfilled value in input order' means the first task by array index that fulfills, regardless of timing, which matches the contract wording but await Promise.allSettled waits for all tasks to complete (including slow ones) before returning, which may not be desired if early-exit performance is needed; also unhandled promise rejection warnings are avoided by allSettled, but if tasks throw synchronously instead of returning rejected promises, this is not explicitly tested here beyond the reject cases."
}
```
Claude Opus 5: volledig vermogen
{
  "root_cause": "Two defects. (1) `Promise.all` rejects as soon as any task rejects, so a single rejected task makes the whole function reject instead of ignoring it and returning a later fulfilled value. (2) `results.find(Boolean) || null` selects by truthiness rather than by fulfillment, so legitimate fulfilled values such as 0, false, '', NaN, null, or undefined are skipped and/or coerced to null. Using `Promise.allSettled` plus a status check on the settled records fixes both, and returning `record.value` directly preserves falsy results.",
  "replacement": "async function firstSuccessful(tasks) {\n  const results = await Promise.allSettled(tasks.map((task) => task()));\n  const firstFulfilled = results.find((result) => result.status === 'fulfilled');\n  return firstFulfilled ? firstFulfilled.value : null;\n}",
  "tests": [
    "firstSuccessful([]) resolves to null (empty input).",
    "firstSuccessful([() => Promise.resolve('a'), () => Promise.resolve('b')]) resolves to 'a' (input order, not completion order).",
    "firstSuccessful([() => new Promise((res) => setTimeout(() => res('slow-first'), 50)), () => Promise.resolve('fast-second')]) resolves to 'slow-first' (order is by index, not by who settles first).",
    "firstSuccessful([() => Promise.reject(new Error('boom')), () => Promise.resolve('second')]) resolves to 'second' (rejection ignored, does not propagate).",
    "firstSuccessful([() => Promise.reject(new Error('a')), () => Promise.reject(new Error('b'))]) resolves to null (all reject).",
    "firstSuccessful([() => Promise.resolve(0)]) resolves to 0, not null (falsy number preserved).",
    "firstSuccessful([() => Promise.resolve(false)]) resolves to false (falsy boolean preserved).",
    "firstSuccessful([() => Promise.resolve('')]) resolves to '' (empty string preserved).",
    "firstSuccessful([() => Promise.resolve(undefined), () => Promise.resolve('later')]) resolves to undefined (first fulfilled wins even if its value is undefined).",
    "firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve(null), () => Promise.resolve('third')]) resolves to null because index 1 fulfilled with null — verifying null-as-value is not confused with the all-rejected sentinel by inspecting status.",
    "firstSuccessful([() => Promise.resolve(NaN)]) resolves to NaN (Number.isNaN on the result is true)."
  ],
  "remaining_risk": "The function still starts every task and awaits all of them, so there is no short-circuiting: a slow or never-settling later task delays or blocks the result, and side effects of later tasks always occur. A task that throws synchronously (rather than returning a rejected promise) will throw inside `tasks.map`, causing the returned promise to reject instead of being ignored; wrap the invocation in `Promise.resolve().then(task)` if that must also be tolerated. `null` is still returned both for all-rejected/empty input and when a task genuinely fulfills with `null`, so callers cannot distinguish those cases. Non-array or non-function inputs are not validated, and rejection reasons are discarded rather than aggregated (no AggregateError), which can hide diagnostics."
}
Claude Fable 5.1: volledig vermogen
{"root_cause":"Two defects: (1) Promise.all rejects as soon as any task rejects, so rejected tasks are not ignored and the function throws instead of skipping them; (2) results.find(Boolean) skips legitimate falsy fulfilled values (0, false, '') and the trailing '|| null' also converts such values to null, violating the requirement to return the first fulfilled value even when it is falsy.","replacement":"async function firstSuccessful(tasks) {\n const results = await Promise.allSettled(tasks.map((task) => task()));\n const first = results.find((result) => result.status === 'fulfilled');\n return first ? first.value : null;\n}","tests":["firstSuccessful([]) resolves to null","firstSuccessful([() => Promise.resolve('a'), () => Promise.resolve('b')]) resolves to 'a'","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve('b')]) resolves to 'b' and does not throw","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.reject(new Error('y'))]) resolves to null","firstSuccessful([() => Promise.resolve(0), () => Promise.resolve(5)]) resolves to 0","firstSuccessful([() => Promise.resolve(false), () => Promise.resolve(true)]) resolves to false","firstSuccessful([() => Promise.resolve(''), () => Promise.resolve('z')]) resolves to ''","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve(null)]) resolves to null (fulfilled null is returned as-is)","firstSuccessful([() => new Promise(r => setTimeout(() => r('slow'), 50)), () => Promise.resolve('fast')]) resolves to 'slow' (input order wins over settlement order)"],"remaining_risk":"All tasks are started concurrently and the function waits for every task to settle before returning, so a slow task delays the result even when an earlier task has already fulfilled; a sequential or early-exit strategy would be needed if latency matters. A task that throws synchronously (rather than returning a rejected promise) will still cause the function to reject, since the contract assumes tasks return promises. Promise.allSettled requires ES2020 or a polyfill."}
Beleid op basis van de eerste geldige output. De latentie is de werkelijke tijd via Anywhere, niet de native Anthropic-latentie. Het aantal tokens wordt door de provider gerapporteerd; uit deze route kunnen geen directe API-kosten worden afgeleid.
Deze Anywhere-resultaten laten zien waarom de modelkeuze moet worden afgestemd op de taak in plaats van op één enkele ranglijst. In GlobalGPT kun je dezelfde vergelijkingsmethode toepassen op je eigen prompt voor zowel Claude als andere toonaangevende modellen, en vervolgens de output kiezen die het beste aansluit bij je kwaliteitsnormen, snelheidsbehoeften en beoordelingswerk.
Hoe de vergelijking op een eerlijke manier kan worden uitgevoerd
Zet een representatieve taak in de wacht. Gebruik dezelfde intentie, hetzelfde bronmateriaal, dezelfde toegang tot hulpmiddelen en dezelfde controles op de acceptatie van doelstellingen.
Noteer de eerste geldige uitvoer. Geef één model niet stilletjes extra pogingen in de primaire vergelijking.
Maak een onderscheid tussen kwaliteit en beschikbaarheid. Fouten op het gebied van authenticatie, capaciteit en routes horen thuis in een opmerking over de beschikbaarheid, niet in de kwaliteitsscore.
Meet de volledige workflow. Houd de verstreken tijd, de inspanning van de beoordelaar, de correctietijd en het herstel na mislukte taken bij.
Kies het goedkoopste model dat aan de eisen voldoet. Voer de test opnieuw uit wanneer er wijzigingen optreden in de instructies, hulpmiddelen, modelversies of de kosten van mislukking.
Waar GlobalGPT van pas komt
Anthropic vervangt Fable 5.1 bij veeleisende taken wanneer de, meer inspannende, Opus 5-evaluaties nog steeds tekortschieten.
Per 8 september 2026 bestaat het actieve assortiment van Anthropic uit de modellen Claude Haiku 4.5, Claude Sonnet 5, Claude Opus 5 en Claude Fable 5.1. De exacte versies en model-ID's kunnen veranderen, dus controleer het officiële modeloverzicht nogmaals voordat u de implementatie uitvoert.
Wat is het verschil tussen Claude Haiku, Sonnet en Opus?
Haiku legt de nadruk op snelheid en lage basiskosten per token, Sonnet biedt een evenwicht tussen snelheid en capaciteit voor dagelijkse werkzaamheden, en Opus legt de nadruk op capaciteit voor complexe taken of taken met grote gevolgen. De juiste keuze hangt af van uw werklast en verificatiekosten, en niet van een absolute ranglijst.
Welk Claude-model kan ik het beste gebruiken voor de meeste taken?
Begin met Sonnet 5 voor de meeste dagelijkse taken op het gebied van schrijven, analyseren, programmeren, visueel inzicht en het gebruik van hulpmiddelen. Kies in plaats daarvan voor Opus 5 wanneer fouten dure gevolgen hebben of wanneer het werk diepgaander redeneren en grondiger verificatie vereist.
Welk Claude-model is het meest geschikt voor codering?
Sonnet 5 is een praktisch uitgangspunt voor dagelijkse codering, met de gebruikelijke controles en tests. Gebruik Opus 5 voor moeilijke diagnoses, complexe agentische codering, uitvoering op lange termijn of wijzigingen waarbij fouten hoge kosten met zich meebrengen.
Welk Claude-model is het meest geschikt om mee te schrijven?
Sonnet 5 vormt het evenwichtige uitgangspunt voor de meeste schrijf- en redactiewerkzaamheden. Haiku 4.5 is geschikt voor omvangrijke, strak gestructureerde teksten, terwijl het de moeite waard kan zijn om Opus 5 uit te proberen voor complexe samenvattingen of materiaal waar veel op het spel staat en dat moeilijk te verifiëren is.
Is Claude Sonnet beter dan Opus?
Dat geldt niet in alle gevallen. De Sonnet 5 is sneller en goedkoper tegen de standaard API-tarieven, terwijl de Anthropic Opus 5 geschikt maakt voor complexere taken. Het betere model is de goedkoopste optie die op betrouwbare wijze aan uw eigen acceptatiecriteria voldoet.
Vervangt Claude Fable Opus?
Nr. Anthropic positioneert Fable 5.1 als een escalatieniveau voor veeleisende redeneringen of langdurige agenttaken wanneer het intensievere Opus 5 nog steeds tekortschiet, en niet als een universele vervanging voor Opus.
Hebben Claude.ai en de Claude-API hetzelfde contextvenster?
De limieten van het Claude.ai-abonnement en de specificaties van het API-model staan los van elkaar. In de tabel met individuele abonnementen van Anthropic wordt momenteel een contextvenster van 200K vermeld, terwijl in de API-documentatie een context van 1M wordt vermeld voor Sonnet 5, Opus 5 en Fable 5.1.
Wanneer moet ik een upgrade uitvoeren van Haiku naar Sonnet of Opus?
Schakel over naar een beter model wanneer mislukte acceptatiecontroles, lastige randgevallen, de correctietijd, de verificatie-inspanning of de kosten van een fout zwaarder wegen dan het voordeel van het goedkopere model op het gebied van snelheid en tokenprijs. Schakel weer terug naar het goedkopere model wanneer dat herhaaldelijk dezelfde vastgelegde controles doorstaat.
Hoeveel kosten Claude Haiku, Sonnet en Opus via de API?
Volgens de basistarieven van Anthropic, geverifieerd op 8 september 2026, kost Haiku 4.5 $1 aan input en $5 aan output, kost Sonnet 5 $2 en $10, en Opus 5 kost $5 en $25 per miljoen tokens. Zie Anthropic’s officiële prijspagina voor de huidige tarieven en andere prijsmodellen.
Eindoordeel: Begin met het goedkoopste model dat aan de eisen voldoet
Voor algemeen gemengd gebruik blijft de Sonnet 5 de meest praktische standaardkeuze, en het was het enige model dat in onze test aan alle eisen voor startnotities voldeed. Opus 5 en Fable 5.1 evenaarden de totale score van Sonnet (26,5/30) op basis van verschillende sterke punten, terwijl Haiku 4,5 niet kon worden beoordeeld omdat de Anywhere-route bij elke toegestane poging een 503-foutmelding gaf. Beschouw deze resultaten als indicatief voor de werklast, niet als een permanente, universele ranglijst.
De volgende stap is eenvoudig: kies één concrete taak, bepaal wat een geslaagd resultaat inhoudt, test elke serieuze kandidaat onder vergelijkbare omstandigheden en reken de correctietijd mee in de uiteindelijke kosten. Het winnende model is het goedkoopste model dat betrouwbaar slaagt, niet het model met het laagste aantal tokens of de meest indrukwekkende naam.
GlobalGPT maakt deze methode onderdeel van een bredere, betaalbare AI-workflow. Gebruik Claude, GPT-5.6 Sol, Gemini 3 Pro, Kimi K3 en andere toonaangevende modellen met meerdere AI-functies in één dashboard, en breng het werk vervolgens via de GlobalGPT CLI over naar uw terminal, ontwikkelingsworkflow en bestaande productietools. Door de functies naast elkaar te testen, kunt u een keuze maken; het grootste voordeel is dat de volledige workflow geïntegreerd blijft.
Ontdek de officiële functies, API-tarieven en installatie van Eleven v4 Turbo, met zes echte geluidsfragmenten, timingresultaten en een calculator voor het aantal tekens.
Videoadvertenties lokaliseren gaat verder dan alleen vertalen: pas scripts, stemmen, ondertitels, aanbiedingen en formaten aan, met drie conceptversies en een praktische GlobalGPT-workflow.
Zet een AI-workflow voor catalogusvideo’s op met SKU-lijsten, productreferenties, validatiecontroles en overdracht naar Shopify, plus een daadwerkelijke pilot met twee producten.
Vergelijk AI-avatars en UGC-makers op basis van productbewijs, productiekosten, rechten en herzieningen, aan de hand van een synthetisch concept en een praktische GlobalGPT-workflow.