

GPT-6.1 Terraは、視覚的推論、精密なコンピュータ利用計画、自然な文章作成においてコストパフォーマンスに優れています。一方、GPT-6.1 Solは、複雑なコーディングや高度な専門業務において、より強力なデフォルトの選択肢となります。. Terraの標準レートでは、入力トークン100万枚あたり$1、出力は$5かかります。Solは$2と$10かかります。 どちらも、1.05Mトークンのコンテキストウィンドウ、128Kの出力、画像入力、および幅広いツールを提供しています。.
各モデルは互いに十分に重なり合っているため、一概に「最良」と決めつけるのは誤解を招く恐れがある。Terraはさらに、 なし 推論オプションと、2026年6月1日という新しい知識カットオフを採用している一方、Solはフラッグシップレベルの性能に近づいている。実際の選択は、1件の正解あたりのコストによって決まる。Terraは同じテストに合格できるのか、それともSolは失敗や修正を十分に減らすことで、キャッシュされていない入出力コストが2倍高いという代償に見合う価値を生み出せるのか。
GPT-6.1 Terra 対 Sol:簡単な回答
GPT-6.1 Terra 対 Sol:簡単な比較
Terraの価格設定は、スクリーンショットの選別、ユーザーインターフェースの分析、構造化された文書の処理、原稿の校正、および監督付きのコンピュータ利用計画など、頻繁に実行されるワークフローにおいて、魅力的な最初のモデルとなっています。 一方、タスクに隠れた依存関係や、自動チェックの精度が低い場合、あるいはコードとツールの相互作用が複雑な場合には、Solの方がより安全な出発点となります。いずれの役割もベンチマーク結果として捉えるべきではなく、公式な位置づけと経済的な設計が組み合わさったものです。.
次のことをすると、価格の段階がより明確になります。 SolとGPT-6 Astraを比較する. Solのキャッシュ未使用時の入出力価格はTerraの2倍であり、AstraがSolに対して5倍であるのとは異なります。そのため、混合ワークロードにおいてはSolを採用する方が理にかなっていますが、大規模な環境ではTerraが依然として大きな優位性を発揮します。.
共通の仕様と重要な相違点
どちらのモデルもテキストや画像の入力を受け付け、テキストを出力します。どちらのモデルページにも、ネイティブの音声や動画は記載されていません。どちらも、レスポンス、構造化出力、関数呼び出し、Web検索、ファイル検索、画像生成、コードインタプリタ、ホスト型シェル、パッチの適用、スキル、コンピュータ利用、MCP、ツール検索に対応しています。 ツールの呼び出しは「Responses」APIに属します。「Chat Completions」はツールを使用せずにサポートされています。.
これらの仕様は、GPT-6.1 Terraモデルの公式ページおよびGPT-6.1 Solモデルの公式ページに基づいています。OpenAIの最新モデルガイドには、各モデルの位置づけが記載されていますが、 APIの料金ページ サービス階層および長期コンテキストのルールを定義します。これらのソースタイプを区別しておくことで、マーケティング上の立場が、測定されたベンチマークと混同されるのを防ぐことができます。.
Solの公式ページには、105万トークンの総枠内で最大92万2000トークンの入力が可能であると記載されています。確認したTerraのページには、別途の最大入力数が記載されていなかったため、本記事では同ファミリーからその数値を推測することはしません。両者とも、最大出力は12万8000トークンと記載されています。 出力許容量が大きいことは、コードや長文のレポートには有用ですが、チェックポイント化された成果物が小さければ小さいほど、テストが容易になり、レビューのコストも抑えられます。.
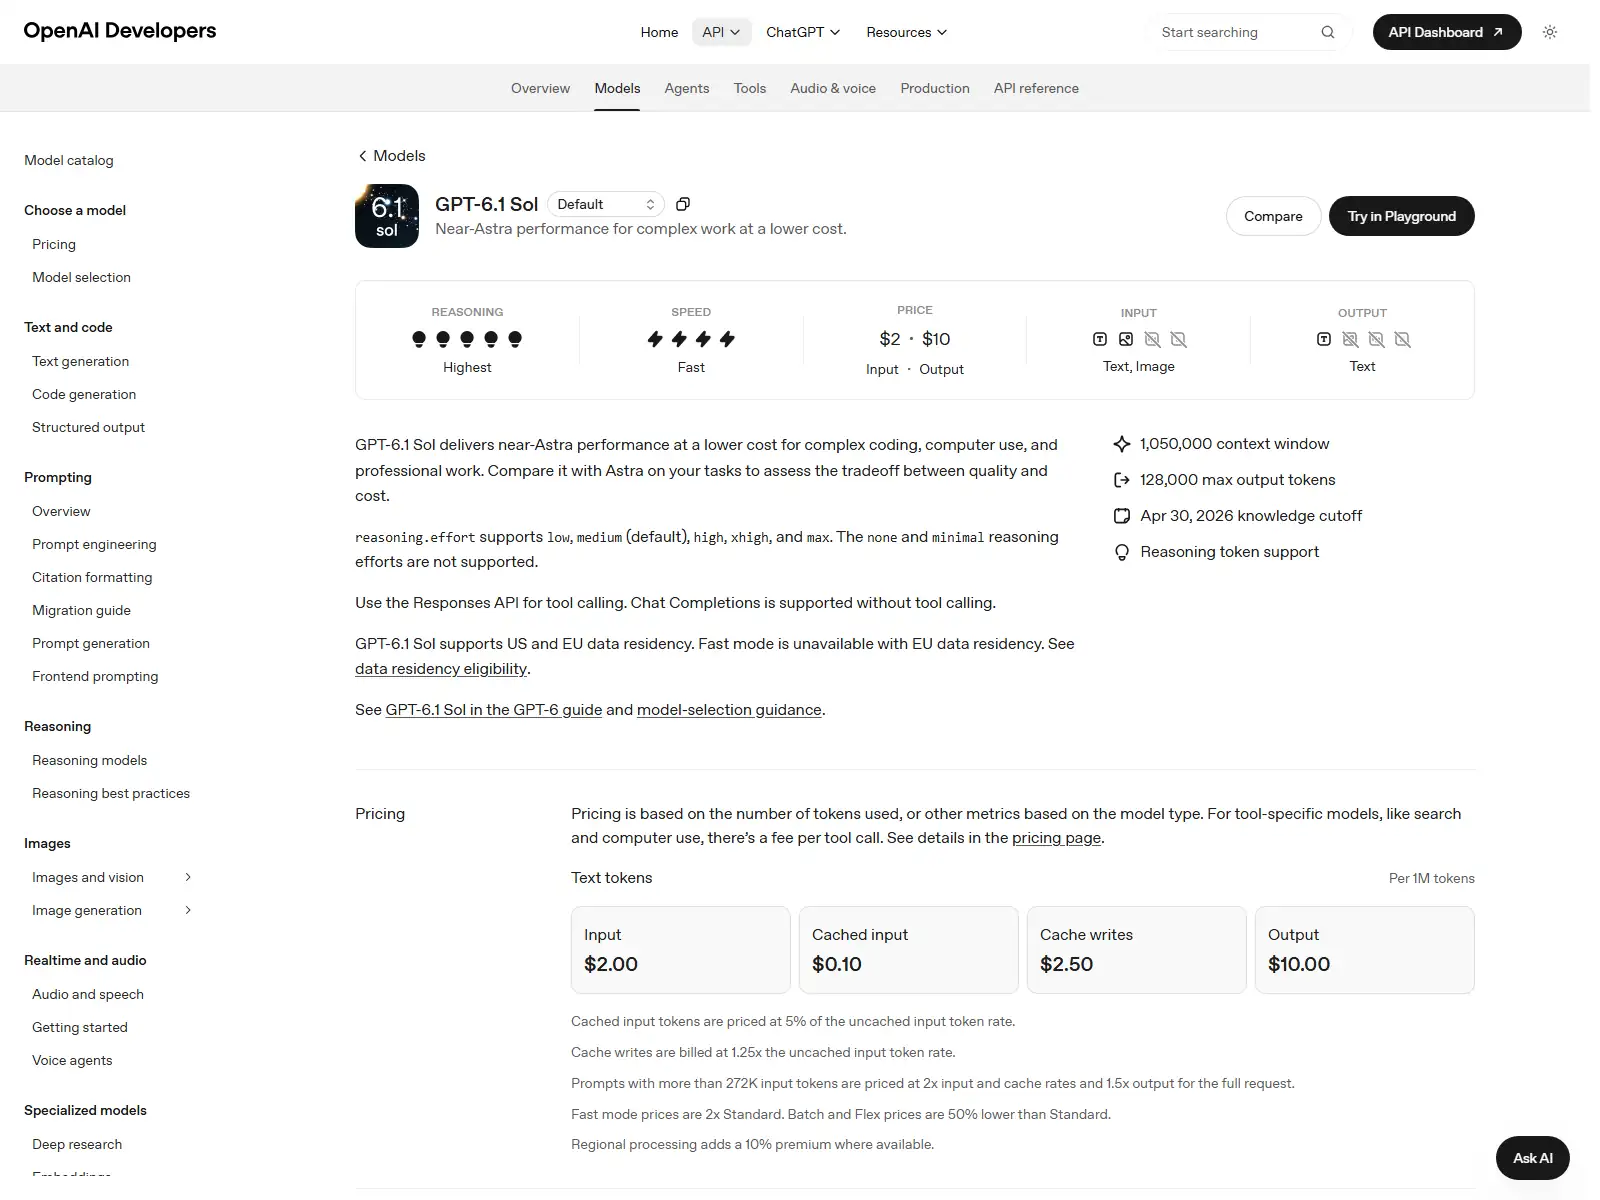
範囲の下限付近では、推論制御が異なります。Terraは以下をサポートしています なし, 、これは熟考を必要としない低遅延の変換に適しています。Solは ロー. いずれもデフォルトは「medium」で、「high」、「xhigh」、「max」まで設定可能です。効率的なポリシーとは、APIが受け付ける最高設定値ではなく、評価を確実にクリアできる最小限の労力を指します。.
Terra視覚推論テストの実践演習
我々はテラに対し、コストが記載された制御されたルート図と、コールドゾーンに入る前に青いパスが必要であるというルールを提示した。返ってきた応答は有効なJSONであり、パス発行者としてスキャナーAを特定し、ルールに違反しているように見える安価なスキャナーBのルートを拒否し、最小コストを9と算出した。そして、 START → スキャナーA → 低温ゾーン → EXIT また、同額の梱包ルートについても言及した。.
ここから得られる有用な知見は、Terraが視覚推論において万能な勝者であるということではありません。重要なのは、このモデルが視覚的な制約に従い、無効な低コスト経路を排除し、構造化された回答の中で有効な最適解を説明したという点です。 この課題では、Solは同一の画像で実行されなかったため、この結果はTerraが視覚的推論に適していることを裏付けているものの、直接的なスコア比較を意味するものではない。.
スクリーンショット―自宅待機中のコンピューター利用計画
2つ目のテストでは、合成された公開インターフェースが提供され、タイトルと本文を維持したまま、予約投稿を下書きに変更する安全な操作手順が求められた。Terraは、その計画を目に見える操作に基づいて構築し、検証手順を含め、インターフェースを実行したと主張することを避けた。スクリーンショットに基づく計画と、自律的なコンピュータ制御とは異なるため、この区別は重要である。.
Terraの公式な位置づけから、この種の作業にはまさにうってつけと言えます。画面を解釈し、操作要素を特定し、正確なアクションを提案するのです。Solは画像入力やコンピュータ利用ツールにも対応しており、その高度な推論能力は、インターフェースの状態が曖昧な場合や、ワークフローが複数のアプリケーションにまたがる場合に役立つ可能性があります。 生産の自動化においては、同じ画面上で両者を比較し、アクションの正確性、回復能力、および誤クリック率を評価してください。.
主なリスクがインターフェースの状態ではなくリポジトリの正確性にある場合は、全体を通じて同じ評価基準を適用してください。 その他のAIコーディングモデル. これにより、コンピュータ利用の結果が、それとは無関係なコードエージェントの活動に関する証拠として扱われることを防ぐことができる。.
自然文作成・推敲テスト
このライティング課題では、テラに対し、事実を正確に保ちつつ、大げさなマーケティング用語を避けながら、不自然なビジネス文を推敲するよう求められました。その結果、文章の構成が改善され、繰り返しが減り、求められた口調も維持されました。ただし、「コールドゾーン」に関するある表現は、提示された事実と照らし合わせて不正確であったため、その文は公開前に修正する必要があります。全体としては実用的な仕上がりでしたが、この事実誤認のため、完璧な結果とはなりませんでした。.
これは、モデルを選ぶ際の有用な基準となります。 Terraは、特にファクトチェッカーによる確認や情報源に基づいたワークフローが後続する場合、大量の草案作成や修正を行うのに十分なほど低コストです。一方、Solは、長文で曖昧な専門的な成果物において、些細な矛盾がもたらすコストがわずかな追加料金を上回るような場合に適しているかもしれません。いずれの場合も、「自然な文章」は事実確認の代わりにはなりません。.
範囲が明確で小規模な修正であり、両方のモデルが問題なく合格する場合、テスト GPT-6 Lunaのベースライン. より小規模なモデルが有用なのは、ワークフローにとって重要な事実や制約が維持されている場合に限られる。.
TerraとSolの価格比較
通常のキャッシュ未適用入出力の場合、Terraの価格はSolの半分です。入力10万、出力1万のワークロードの場合、標準料金ではTerraで約$0.15、Solで$0.30のコストがかかります。 Solが、追加の修正を1回防げるほど受入率を十分に引き上げた場合、一見したコスト削減効果はなくなる可能性があります。両方が合格した場合、Terraの低い請求額は処理量が増えるにつれて相乗効果をもたらします。.
どちらのモデルも、272Kを超える同じ構造を採用しています。具体的には、リクエスト全体に対して、入力およびキャッシュレートが2倍、出力レートが1.5倍となります。BatchおよびFlexでは、対象となるStandardレートが半減し、Fastでは2倍になります。地域ごとの処理が利用可能な場合、10%が追加されます。デプロイの前に、, Terraの実際のAPIコストを計算する.
確認したデータによると、Terraの12時間キャッシュ書き込みコストはSolの半分ではなく、どちらも100万トークンあたり$2.50となっています。そのため、再利用のパターンが重要になります。 Terraは依然として安価なキャッシュ読み取りの恩恵を受けていますが、長期保持プレフィックスでは、書き込みコストを回収するのに十分な再利用が必要です。異なる指標がそれぞれ異なる挙動を示す場合、全面的な比較を「2倍安い」という一文に単純化してはなりません。.
TerraとSol、それぞれいつ使うべきか
明確な基準、ビジュアル/UI関連の作業、自然な文章、あるいは大量の作業。.
正確性、ツールの選択、引用、および遅延を確認してください。.
曖昧なケース、コードが大量に含まれるケース、またはリスクの高いケースでは、Solを使用してください。.
承認された結果、再試行、人的レビュー、およびトークンコストを追跡します。.
効率的なビジュアルおよび運用ワークフローを実現するには、Terraをお選びください
Terraは、スクリーンショットの分析、インターフェースの設計、フォームやダッシュボードの解釈、視覚的な制約に関する問題、専門的なコピー作成、および反復的な業務タスクについて、まず試してみるのに適したツールです。その なし 「effort」オプションと低料金設定は、需要の変化に柔軟に対応できる製品や販売量の多い製品に適しています。候補リストにOpenAI以外のオプションが含まれている場合、, 他の主要なモデルシリーズを比較する 各プロバイダーにテラ(Terra)の役割を拡大するのではなく。.
難しいコーディングや、より専門性の高い業務にはSolをお選びください
Solは、複雑なコーディング、コンピュータの利用、およびプロフェッショナルなプロジェクトにおいて、Astraに匹敵する性能を発揮するように設計されています。リポジトリ規模の変更、アーキテクチャの検討、困難なデバッグ、重要度の高いレビュー、および不十分な計画が多くのコストのかかるツール呼び出しを引き起こしかねないエージェントループなどで活用してください。デフォルト設定にする前に、, Solがプレミアムを獲得した際のテスト.
難易度が異なる場合はルーターを使用してください
実用的なシステムでは、通常のトラフィックはTerraにルーティングし、テスト失敗、信頼性の低いケース、セキュリティ上重要な変更、および大規模な複数ファイルにわたる作業についてはSolにエスカレーションします。エスカレーションポリシーは可視化しておくようにしてください。 Terraの出力の大部分が受け入れられる場合は、その割合を拡大してください。Solがコストのかかる失敗を繰り返し防いでいる場合は、そのタスククラスを直接Solにルーティングしてください。これにより、モデル選択は恒久的な議論ではなく、運用ルールとなります。.
TerraとSolの使い方
公式APIでは、次のように使用してください。 gpt-6.1-terra または gpt-6.1-sol Responses API において、プロンプト、ツール、推論の労力、評価者を一定に保ちます。リクエスト ID、トークンの使用状況、レイテンシの測定値、ツールのトレース、および合否の結果を保存します。公平な比較を行うには、テスト環境全体ではなく、モデルのみを変更する必要があります。.
GlobalGPTは、探索的な比較を行うための便利なマルチモデルワークスペースを提供します。 モデルごとに新しい会話を開き、まったく同じプロンプトと添付ファイルを再利用し、同じ要件に基づいて結果を評価できます。正確なサービス階層、推論設定、利用メタデータ、および自動評価を維持する必要がある場合は、公式APIをご利用ください。GlobalGPTプラットフォームの課金と公式APIトークンの料金体系は、それぞれ別個のスコープとなります。.
証拠の制限と初期の社会的反応
Terraのテストは、以下のように構成された認証済みGlobalGPTルートを通じて完了しました。 gpt-6.1-terra, 、しかし、その応答には、個別のアップストリーム・モデル認証や推論処理のフィールドは含まれていませんでした。所要時間はエンドツーエンドのルート所要時間であり、純粋な推論レイテンシや最初のトークンが得られるまでの時間ではありません。Solは同じタスクで実行されていないため、本記事ではベンチマークでの同等の優位性を主張するものではありません。.
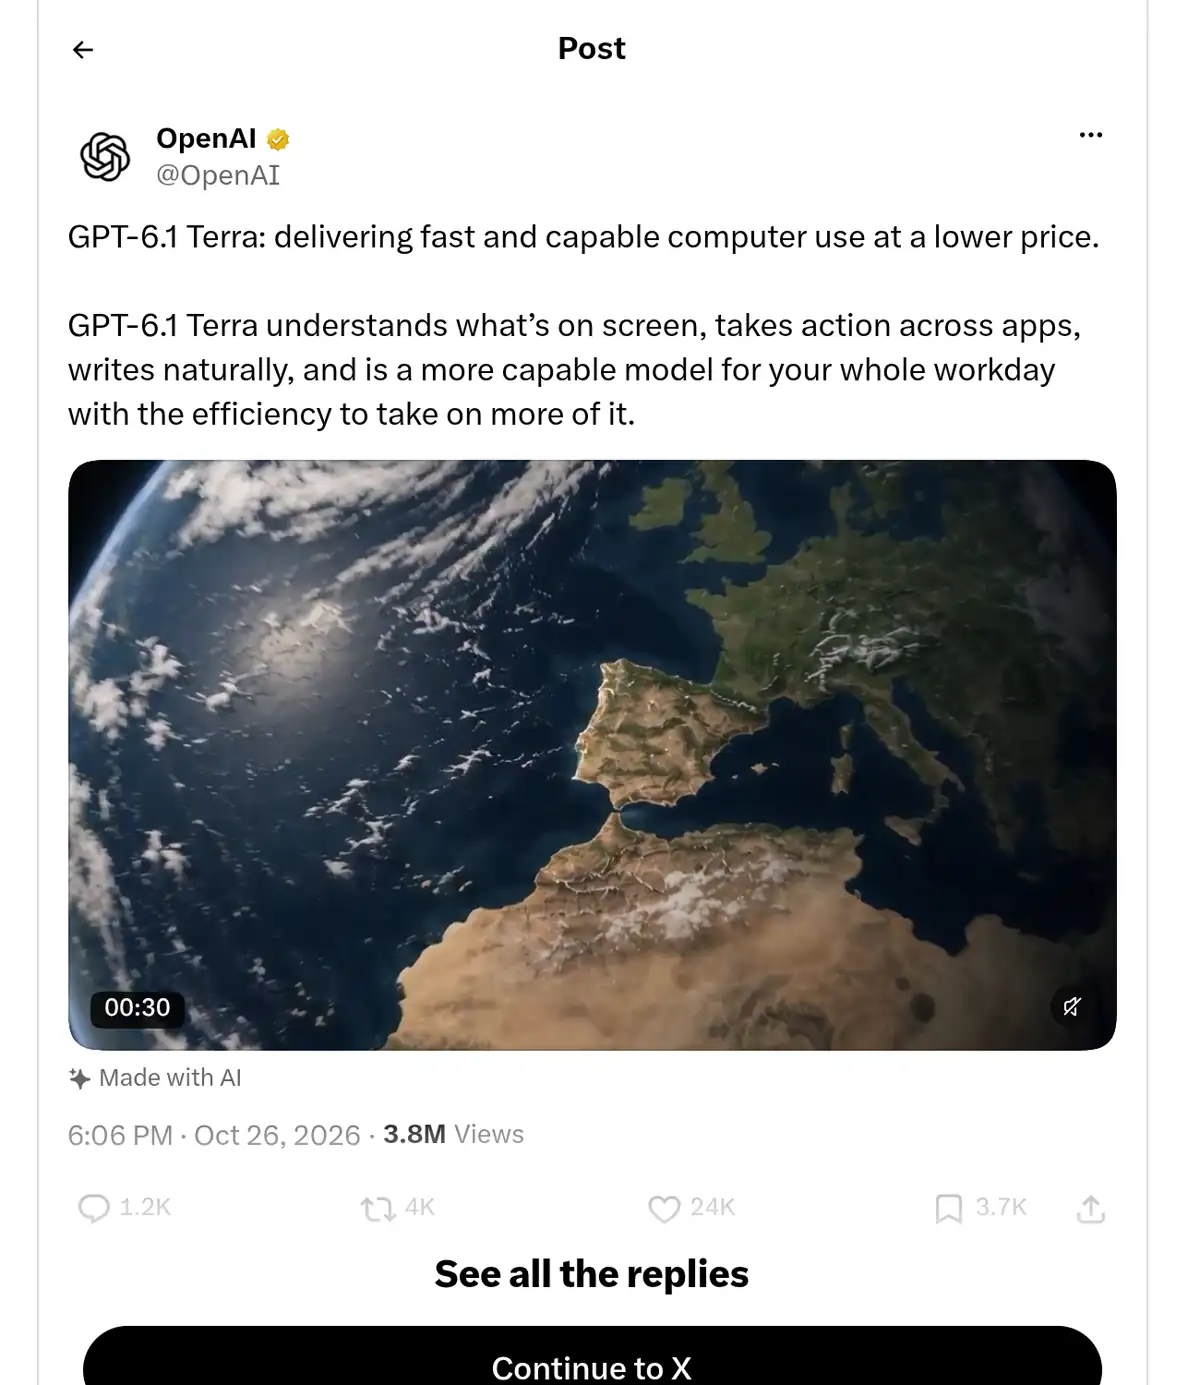
OpenAIの自社開発 Xのローンチ記事, 、以下の元の投稿URLから引用した内容によると、Terraは、画面上のコンテンツを理解し、アプリをまたいで動作し、自然な文章を書ける、手頃な価格のコンピュータとして紹介されています。これは公式の発売時の説明であり、独立したレビューやベンチマーク結果の証明ではありません。検索インデックスからは、また別の OpenAI 開発者向け投稿, 、からの評価メモ 人工分析, 、およびReddit上のTerraに関するスレッドですが、それらの元の投稿は保存されておらず、コミュニティのコンセンサスとして引用されていません。.
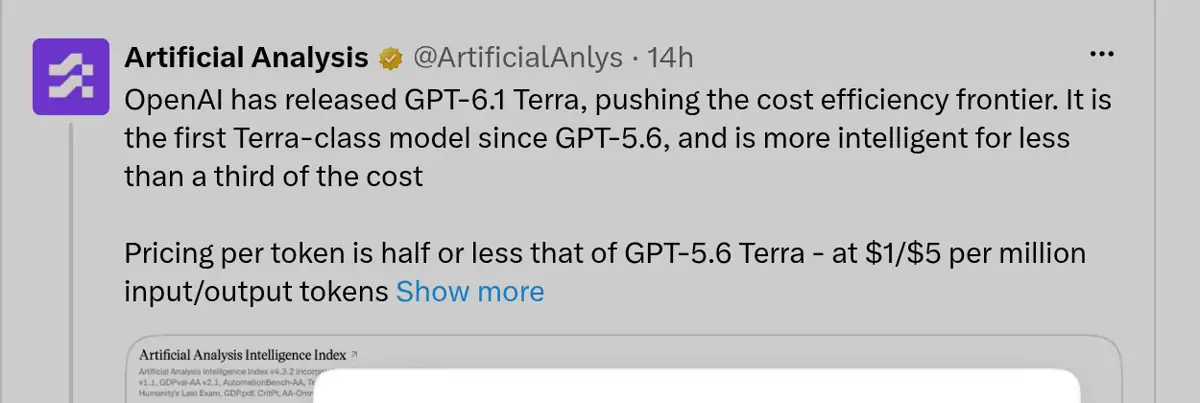
人工分析 ある独立評価機関による初期の分析を紹介し、Terraがコスト効率の限界を押し広げていると評するとともに、$1の入力レートおよび$5の出力レートを強調した。この投稿では独自のインテリジェンス指数が参照されているが、これはあくまである組織の評価システムに過ぎず、普遍的な品質の証明でも、本記事の結果と一致するものでもない。.
OpenAIのドキュメントをコマンドラインから直接取得しようとするとHTTP 403エラーが返されましたが、公開されているレンダリングサービスでは、元のTerraモデルURLの読み込みに成功し、出典が明記されたキャプチャ画像を生成しました。本記事では、その全ページのマスター画像を別途保存し、APIガイドでは読みやすいように主張部分に焦点を当てたトリミング画像を使用しています。 Solは、以前に検証済みのOpenAIモデルページのキャプチャを使用しています。独立した実地検証に基づくソーシャルメディア上の反応については依然として情報が不足しているため、本記事では、レビューア間のコンセンサスを恣意的に作り出すのではなく、保存されている3つのTerraテスト結果に依拠しています。.
GPT-6.1 Terra 対 Sol よくある質問
GPT-6.1 TerraはGPT-6.1 Solよりも優れているのでしょうか?
Terraは、低コストの視覚的推論、コンピュータ利用の計画、自然な文章作成においては、より適したデフォルトの選択肢です。Solは、その追加機能がStandardトークン価格の約2倍というコストを正当化できる場合、より高度なコーディングや専門的な推論においては、より適した選択肢となります。.
TerraはSolに比べてどれくらい安いのですか?
標準レートでは、Terraは100万トークンあたり入力$1、出力$5であるのに対し、Solは入力$2、出力$10となっています。 Terraはキャッシュ未適用時の入出力価格が半分となっており、確認済みの情報源では、いずれもキャッシュ書き込みメーターの長期値として$2.50と記載されています。.
TerraとSolは同じコンテキストウィンドウを持っていますか?
はい。どちらも、1,050,000トークンのコンテキストウィンドウと、128,000トークンの最大出力を記載しています。Solのドキュメントには、922,000トークンの最大入力についても記載されていますが、Terraについては、確認したソースコードには別途の最大入力値が記載されていませんでした。.
プログラミングにはどちらのモデルが適していますか?
リポジトリの分析、アーキテクチャ、コードエージェント関連の難しい作業には、まずSolを使用してください。範囲を限定した変換、UI関連のタスク、およびすでに堅牢なテストが整備されている大量処理のワークフローについては、Terraを本番環境のデフォルトとして使用するのが適しています。.
どちらのモデルの方が速いですか?
OpenAIという数値は、Terraが高速かつ効率的であることを示していますが、本記事では、レイテンシの面で絶対的な勝者であると主張するものではありません。Terraの測定値はエンドツーエンドのGlobalGPTルート時間であり、Solとの比較が行われていないため、公平な速度比較を行うことはできません。.
画像やスクリーンショットには、どちらのモデルが適していますか?
Terraは、視覚的推論と精密なコンピュータ操作に特化して設計されているため、スクリーンショットやインターフェースの設計において、真っ先に試すべきツールと言えます。どちらのモデルも画像入力をサポートしているため、実際の視覚的タスクにおいて、その性能を検証する必要があります。.
TerraとSolは「ツール」と呼べるのでしょうか?
はい、Responses API を通じて可能です。モデルページには、対応しているツールの概要が記載されています。「Chat Completions」はツールを呼び出すことなく利用できますので、ツールを新たに導入するシステムでは、通常は Responses を使用することをお勧めします。.
入力トークン数が272Kを超えるとどうなりますか?
どちらのモデルも、リクエスト全体を対象としたロングコンテキストの課金ルールを採用しています。つまり、入力が272Kを超えると、入力レートとキャッシュレートは2倍、出力レートは1.5倍となります。Terraの方が依然として安価ですが、コンテキストの構築は依然として重要です。.
GlobalGPTで両方のモデルを使用することはできますか?
GlobalGPTには、TerraおよびSol用のモデルルートが用意されています。インタラクティブな比較を行うには、現在のピッカーを使用してください。正確な使用方法、推論設定、およびデプロイメント制御を記録する必要がある場合は、公式APIと独自のテスト環境を使用してください。.
最終的な結論:テラか、それともソルか?
低コストで視覚処理能力を備え、実用的なモデルがテストに合格できる場合は、GPT-6.1 Terra を選択してください。複雑なコーディング、より高度な推論、あるいはエラーによるコストが高い場合など、追加の機能によって通常の入出力レートの2倍の価値が得られると判断される場合は、GPT-6.1 Sol を選択してください。. どちらのモデルも、コンテキスト、モダリティ、ツールサポートが十分に共通しているため、両モデル間のルーティングが現実的である。.
ほとんどのチームにとって、最も効果的な方針は「まずはTerraを使い、問題が発生した場合はSolに切り替える」というものです。プロンプトと評価関数を固定し、受け入れられた結果あたりのコストを測定し、エンドツーエンドのワークフローの品質を目標として扱います。 Terraの3つのテストでは、視覚的制約の適切な処理、根拠に基づいたインターフェースの設計、そして質の高い修正が確認された一方で、確認手順の抜けや事実関係に関する表現の誤りも明らかになりました。こうした結果の良し悪しが混在していることこそが、モデルのラベルよりもタスク固有の評価が重要である理由なのです。.
もしSolが、重要なタスクにおいて依然として求められる品質基準を満たしていない場合は、同じ評価者を使って そのギャップについて、GPT-6 Astraを試してみてください. より強力なモデルによって結果が変わる場合にのみ、エスカレーションを行う。.





