Muse Spark 1.2 将异常低廉的令牌定价与 100 万令牌的上下文窗口相结合,并在我们首次尝试的 API 测试套件中通过了全部三项基础模型编码任务。. Meta 于 2026年8月5日, ,该系统采用100万个令牌的上下文窗口,提供两档API定价方案,并配备了一个名为Muse Code的独立终端代理。Meta的基准测试结果令人鼓舞;但独立的公开编程排行榜尚未对相同的模型与代理组合进行验证。.
本评测将模型与代理、官方评分与独立证据、标准定价与“贡献者”层级的数据使用权衡区分开来。 在我们的测试中,该模型完成了 Python 幂等性修复、保持兼容性的 TypeScript 重构,以及一个覆盖整个代码库的 JSONL 功能,且未出现重试情况。我们未测试 Muse Code 代理的执行情况,也未测试工具调用的可靠性。如果您打算先对比更广泛的领域,请参阅我们的 最适合编码的人工智能模型 提供了更广泛的竞争背景。.
Muse Spark 1.2 评测:简要评价
简而言之: Muse Spark 1.2 是一款专注于编程的 Meta 模型,具备 100 万令牌的窗口长度、与 OpenAI SDK 兼容的 API 访问功能,以及备受瞩目的“贡献者”层级。 其最突出的公开优势在于性价比:在“贡献者”模型上,每百万令牌的输入成本为 $0.10,输出成本为 $0.20。该层级可用于改进 Meta 的产品,而成本更高的标准模型则不适用于此目的。.
关于性能的表现,需要更加审慎看待。Meta报告称,在Terminal-Bench 2.1测试中,搭载Muse Code的Muse Spark 1.2取得了82.9%的成绩,而在DeepSWE测试中则为59.3%。这些是Meta运行的测试结果。 截至2026年8月26日,公开的Terminal-Bench和DeepSWE榜单中仍未列出Muse Spark 1.2。. 人工分析 提供了独立的交叉验证:其智能指数仍为57,高于同类模型35的中位数。.
- 现在就尝试它的最佳理由: 低廉的贡献者定价、海量的语料库,以及遵循熟悉的 OpenAI 客户端模式的 API。.
- 保持谨慎的最佳理由: 三项受控的基础模型任务并不能证明 Muse Code 代理在大型生产代码库中的可靠性、工具调用质量或性能。.
- 重要的隐私选项: 对于您不希望用于改进 Meta 产品的代码或提示词,请使用标准模型。.
Muse Spark 1.2 概览
经验证的规格
Meta 将 Muse Spark 1.2 描述为一款相比 Muse Spark 1.1 具有更高首次编码准确率且工具调用更可靠的模型。这些是来自 Muse Spark 官方产品页面, ,而不是我们自己编码环节得出的结论。.
Muse Spark 1.2 与 Muse Code 对比
Muse Spark 1.2 是该模型。Muse Code 是一个独立的测试版终端代理,由该模型提供支持。. 这一区别之所以重要,是因为代理可以在底层模型周围添加规划、工具协调、存储库导航、工作树隔离、日志记录和重试行为等功能。.
保持图层分离
Muse Spark 1.2
上下文、推理、API 行为、令牌计费、输出以及工具调用决策。.
模型 ID1M 上下文应用程序接口定价
缪斯代码
终端用户体验、子代理、Git 工作树、事件日志、流程恢复、捆绑技能和协调。.
代理工作流元运行系统结果
"(《世界人权宣言》) Muse Code 官方页面 将该产品称为“beta编码剂”。这使得将其与Claude Code和Codex等产品进行比较,比假装所有观察到的工作流差异都源于基础模型调用更为有意义。我们的 Codex 与 Claude 代码对比 解释了为什么周围的环境因素对开发者体验的影响,与模型本身同样显著。.
Muse Spark 1.2 基准测试:这些分数究竟说明了什么
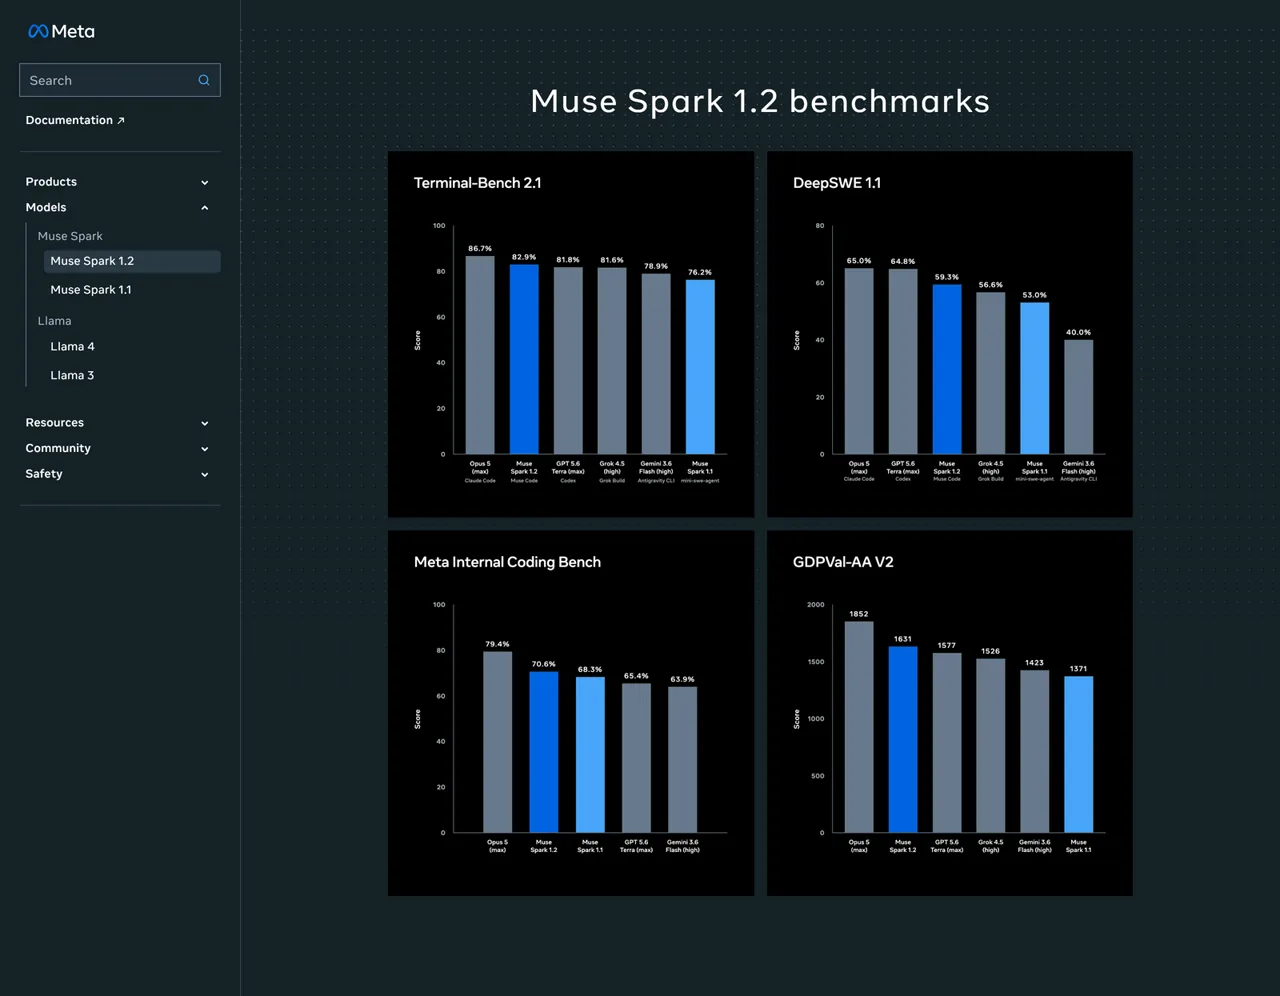
Meta的基准图表显示,Muse Spark 1.2在多项编码评估中名列前茅。这些数据值得深入分析,但并不能直接反映模型原始质量的单一、明确排名。模型、代理、测试框架、推理能力以及任务协议都可能同时发生变化。.
Meta-reported Terminal-Bench 2.1
元基准测试面板
终端平台 2.1
全部 89 个任务 · 经过五次尝试后,pass@1 通过 · 选定的模型与智能体组合
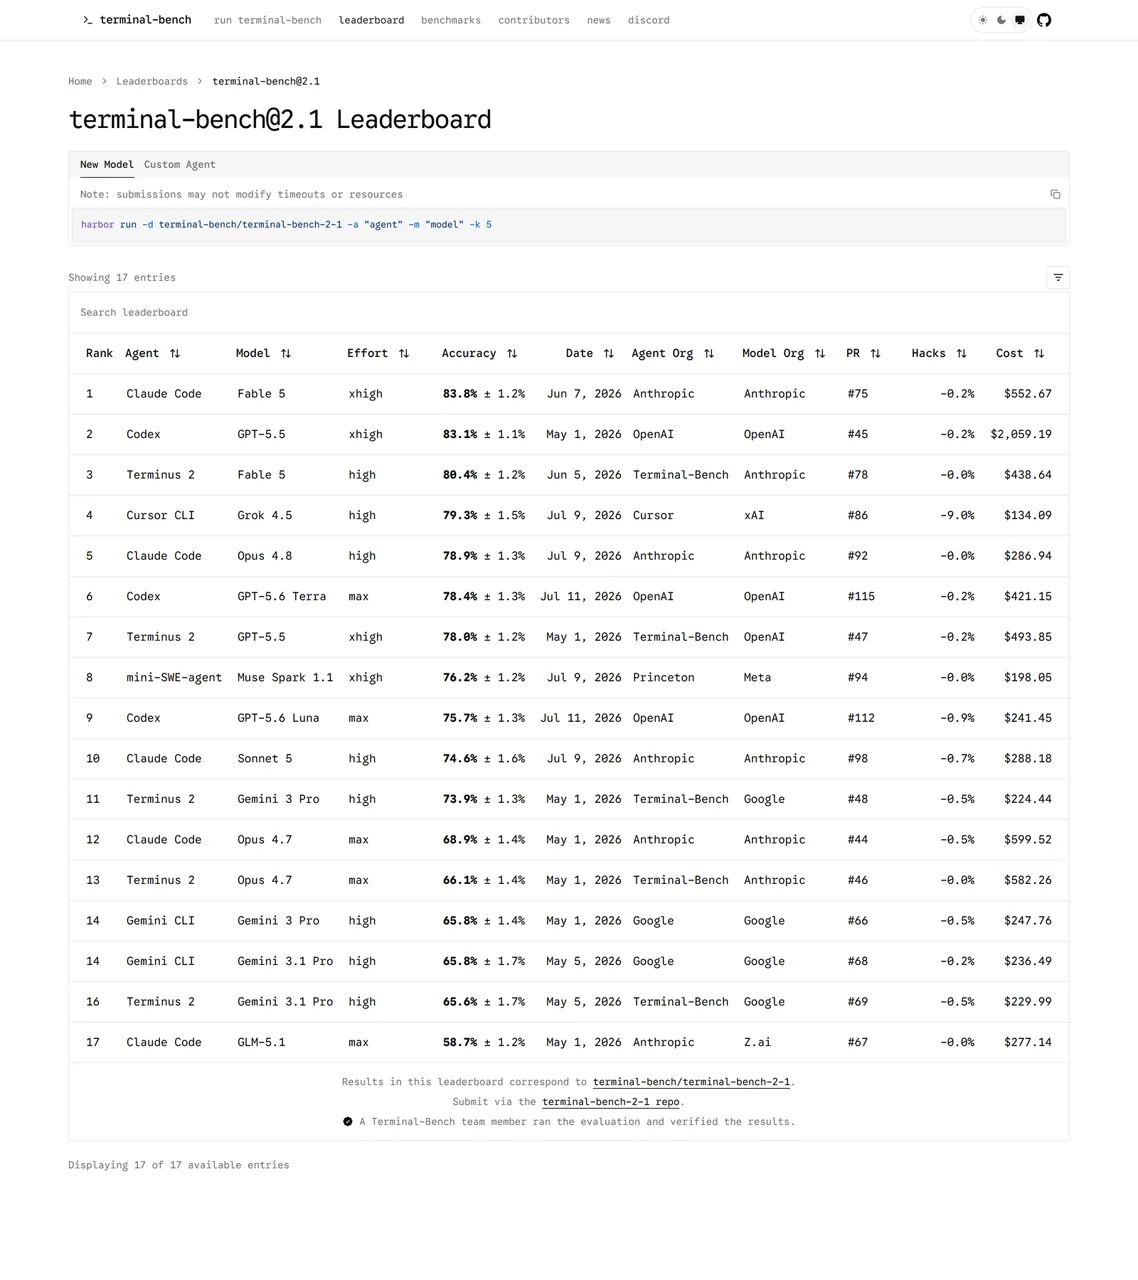
82.9%这一数值是 Meta-run Muse Code 结果. .......。 public Terminal-Bench 2.1 排行榜 2026年8月26日未将Muse Spark 1.2列入列表,因此它 未经验证的公开排行榜条目. 公开榜单确实列出了搭载 mini-SWE-agent 的 Muse Spark 1.1,其性能指标为 76.2% ±1.2%。.
DeepSWE 1.1 的元报告
元基准测试面板
DeepSWE 1.1
113 个任务 · 91 个代码库 · 五种语言 · 五次尝试中通过了 1 次
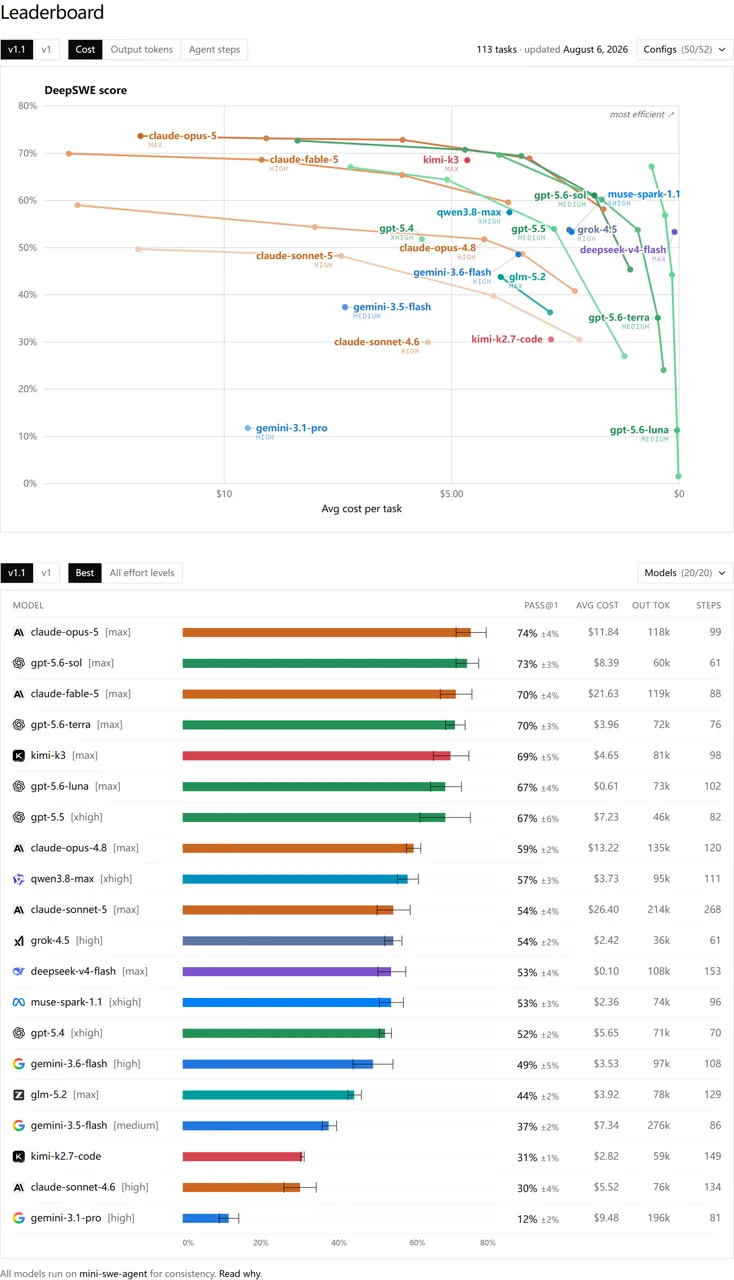
"(《世界人权宣言》) 公开版 DeepSWE v1.1 排行榜 为保持一致性,该公司在其列出的所有型号中均采用 mini-swe-agent。经核查,当时尚未将 Muse Spark 1.2 纳入其中;Muse Spark 1.1 的测试结果为 53%。Meta 的 59.3% 测试结果采用的是 Muse Code,因此这两个数值并非来自相同的测试平台。.
Meta的内部评估和通用代理评估
两种不同的评价量表
Meta 内部编码基准
440项内部任务 · 每项任务有两次尝试机会
| 模型 | 得分 |
|---|---|
| 作品第5号 | 79.4% |
| Muse Spark 1.2 | 70.6% |
| GPT-5.6 Terra | 65.4% |
| Gemini 3.6 Flash | 63.9% |
| Grok 4.5 | 未显示 |
GDPVal-AA v2
通用代理任务评估 · Elo 风格的评分
| 模型 | 得分 |
|---|---|
| 作品第5号 | 1852 |
| Muse Spark 1.2 | 1631 |
| GPT-5.6 Terra | 1577 |
| Grok 4.5 | 1526 |
| Gemini 3.6 Flash | 1423 |
Meta的 评估方法 据称,Terminal-Bench 覆盖了全部 89 个任务,并在五次尝试中均通过了 pass@1 测试。DeepSWE 则覆盖了 91 个代码库和 5 种编程语言中的 113 个任务,同样在五次尝试中均通过了 pass@1 测试。 Meta 还指出,其配置可能尚未针对第三方模型进行最优调整。有关基于实际产品决策的最新竞品对比,请参阅 Claude Opus 5 对 GPT-5.6.
方法论改变了意义
车型 + 选定的经销商
89项任务,5次尝试,推理设置各不相同,且Meta的测试框架可能并未针对第三方系统进行同等优化。.
已验证条目
检查时未发现 Muse Spark 1.2。该电路板的配置和验证状态必须从 Meta 的图表中单独查阅。.
常见的小型 Swe 代理
涉及 91 个代码库和 5 种编程语言的 113 个任务。Muse Spark 1.2 未被列入;Muse Spark 1.1 的性能指标为 53%。.
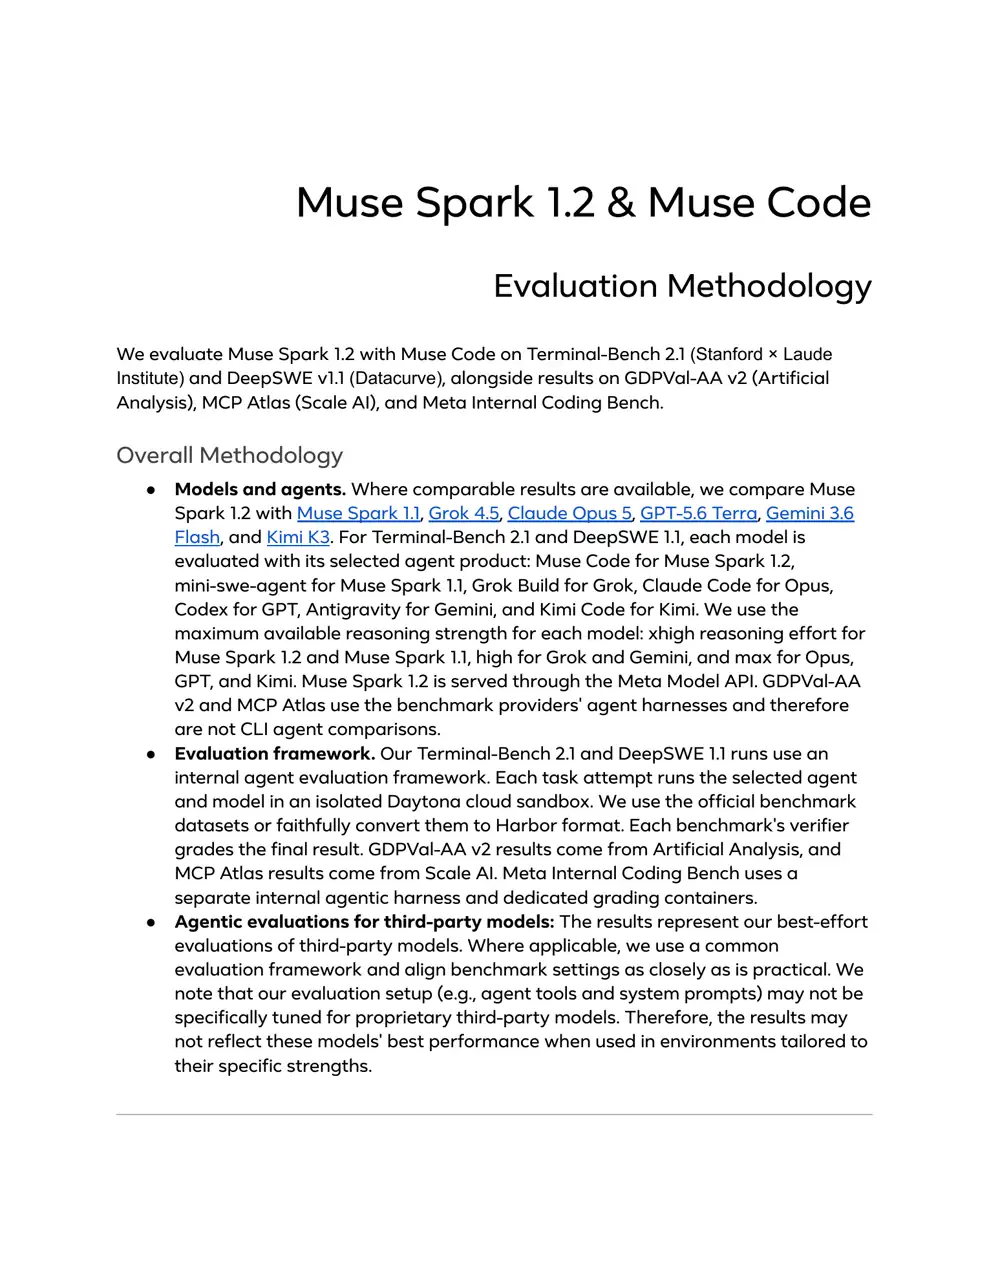
人工智能分析:有用的独立背景
"(《世界人权宣言》) 人工智能分析模型页面 将Muse Spark 1.2的智能指数评定为 57, ,高于2026年8月26日查询时同类机型35的 median 值。 其测试集在Terminal-Bench v2.1上报告80%,在GDPVal-AA v2上经标准化后为57%,在SciCode上为56%,在AA-LCR长上下文评估中为83%。.
人工分析版本漂移
从中得出的实际教训很简单:Muse Spark 1.2 看起来颇具竞争力,但没有任何单一评分能单独反映该模型的真实水平。应将 Meta 的图表视为 Muse Code 系统的佐证,将公开排行榜视为一种独立的交叉验证,并将 Artificial Analysis 视为一种配置方式不同但同样独立的评估。.
Muse Spark 1.2 的定价与隐私权衡
Meta 提供了两种价格差异巨大的 API 模型 ID。较便宜的选项不仅仅只是价格优惠:它还会改变提交数据的使用方式。.
每100万枚代币的美元价格 · 1M 语境
不用于产品改进
不用于改进Meta的产品
价格更低,但需在数据使用方面做出取舍
数据 可用于改进Meta的产品
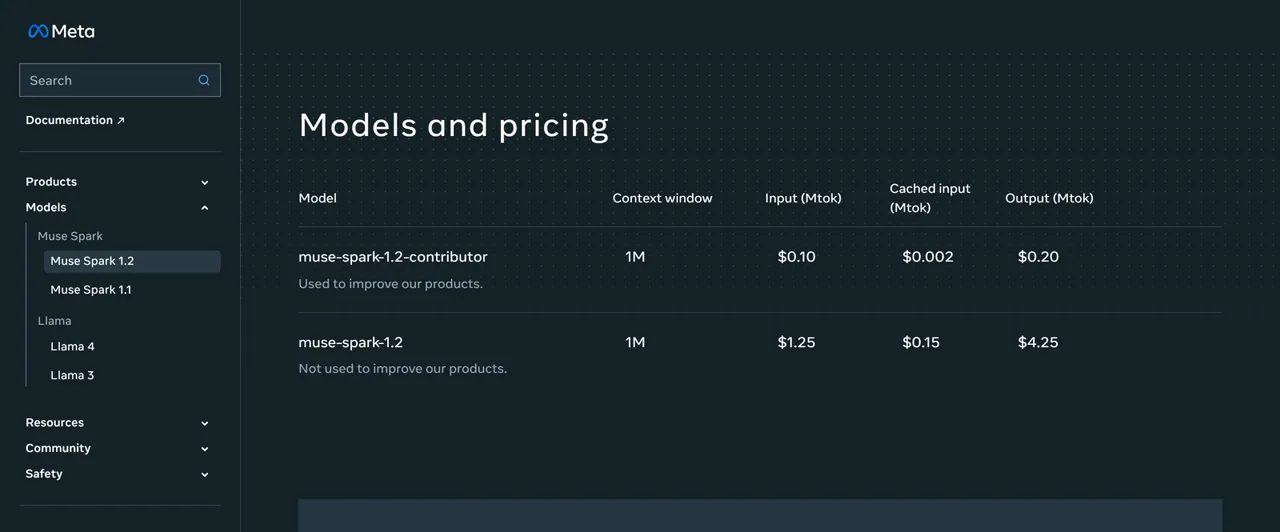
与标准层级相比,贡献者层级的输入价格便宜 12.5 倍,缓存输入价格便宜 75 倍,输出价格便宜 21.25 倍。没有一个单一的折扣百分比能准确描述所有代币类型的情况。.
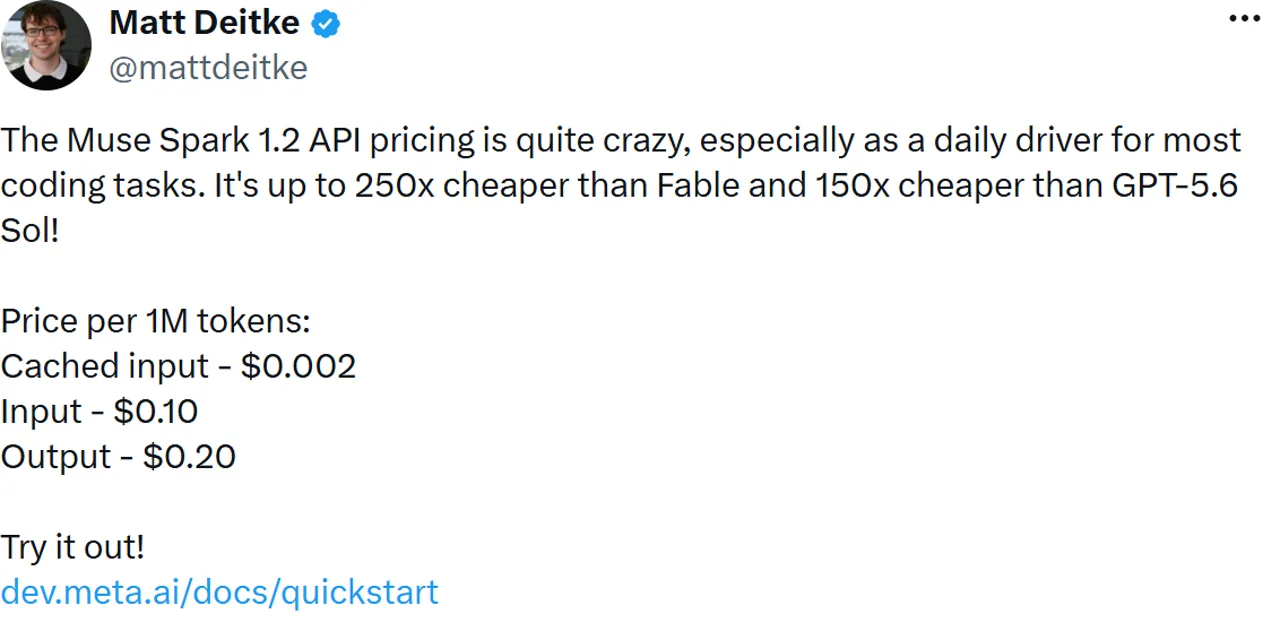
一位 Meta 研究人员宣传称,“贡献者”等级的成本比 Fable “低达 250 倍”,比 GPT-5.6 Sol “低 150 倍”。那 社会比较 采用的是“贡献者”定价,而非标准定价模式,且应始终附带“数据使用”的限定条件。读者若要比较当前竞争对手的成本,可参考我们另一份 GPT-5.6 定价指南 和 Claude 代码定价明细.
对于公共仓库、合成任务或一次性评估环境,贡献者层级可能更具吸引力。而对于私有代码、客户数据、凭据或专有架构,标准层级则是更安全的默认选择。 Meta 还表示,已开始通过销售渠道受理“零数据保留”请求,这是一种独立的访问途径,而非默认的自助设置。.
Muse Spark 1.2 API 访问与示例
三条官方通道
官方食谱库基础网址: https://api.meta.ai/v1 · 本次审查中的第 1.2 项请求:未执行
"(《世界人权宣言》) 元模型 API 支持与 OpenAI SDK 兼容的工作流。Meta 的官方指南使用了基础 URL https://api.meta.ai/v1 并从 MODEL_API_KEY. 产品页面还介绍了搜索锚定,而《食谱》一书则涵盖了聊天自动补全、流式处理、工具调用、结构化输出、提示词缓存、推理控制、视觉处理、长上下文、重试以及搜索食谱等内容。.
官方食谱示例——截图版本: "(《世界人权宣言》) 官方 GitHub 实战指南 仍在使用 muse-spark-1.1. 这证明了客户端结构和基础 URL,但并不意味着该示例已针对 1.2 版本进行了更新。.
import os

from openai import OpenAI

client = OpenAI(
    base_url="https://api.meta.ai/v1",
    api_key=os.environ["MODEL_API_KEY"],
)

response = client.chat.completions.create(
    model="muse-spark-1.1",
    messages=[{"role": "user", "content": "Hello, world!"}],
)

print(response.choices[0].message.content)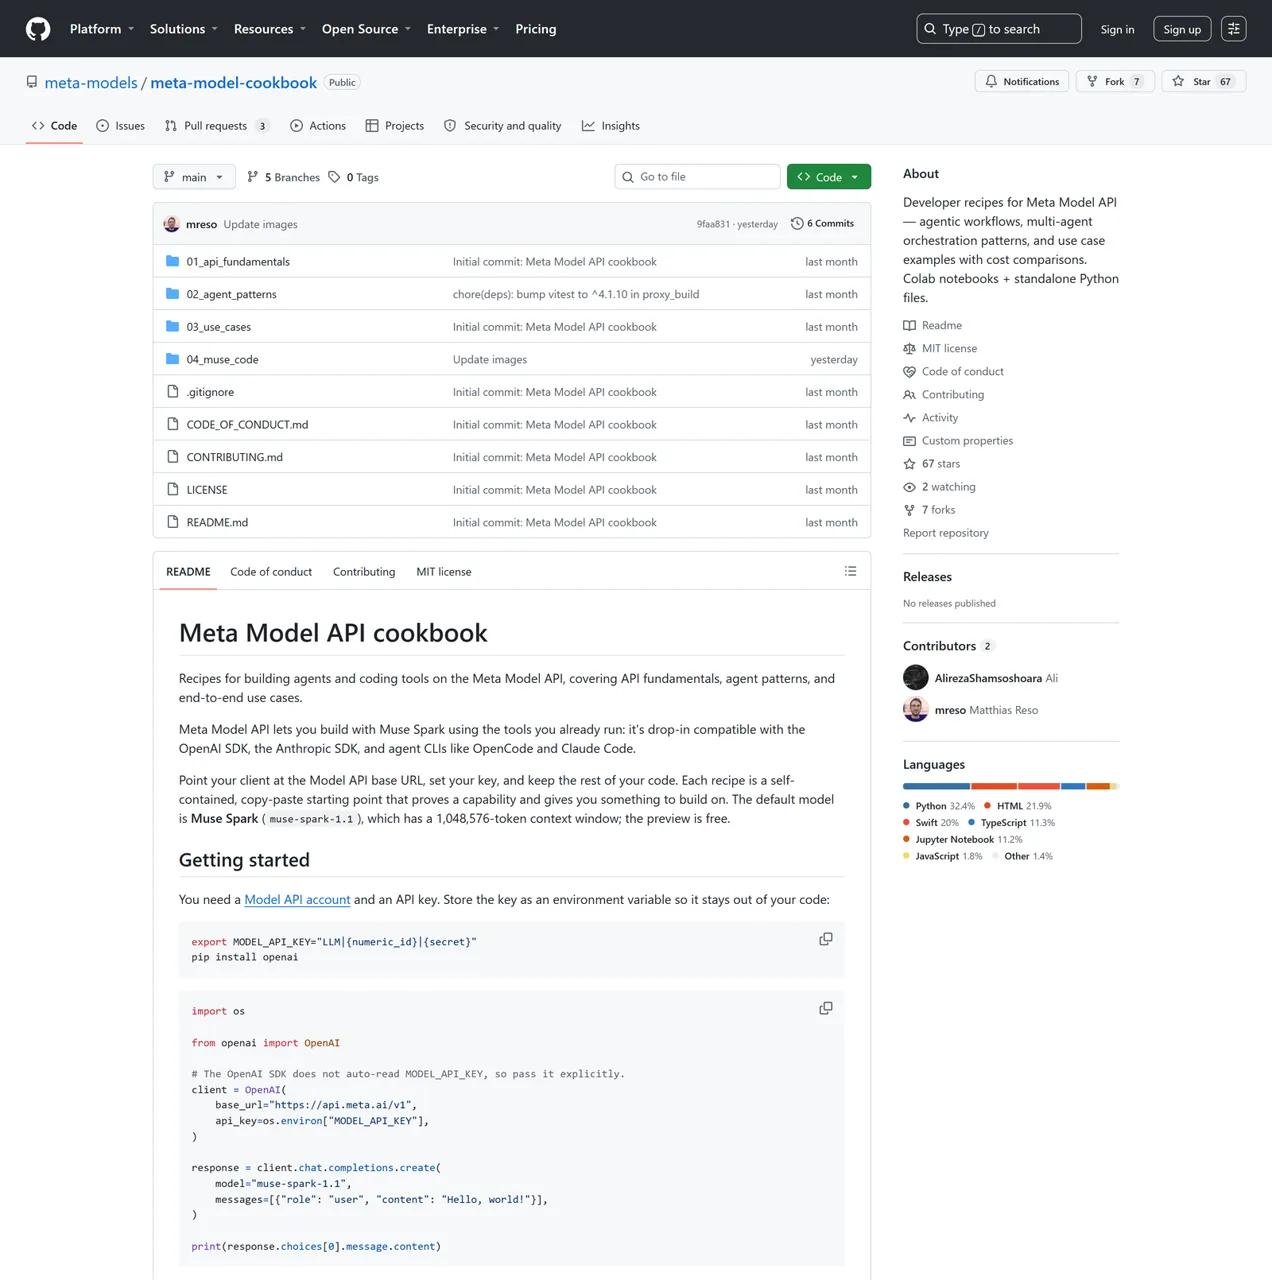
已记录的调整——未执行: Meta 另行列出 muse-spark-1.2 作为标准 1.2 型号 ID。下面的最小替换综合了两个官方事实,但在本次审查期间未发送任何付费请求。.
response = client.chat.completions.create(
    model="muse-spark-1.2",
    messages=[{"role": "user", "content": "Hello, world!"}],
)
Muse Spark 是一个推理模型,而且 推理令牌被计入输出. 这使得 $4.25 标准输出速率比乍看之下更为重要:一个看似简短的回答仍可能包含隐含的推理过程。实际延迟、首次令牌出现时间、重试率以及每项任务的成本在此仍未被测量。.
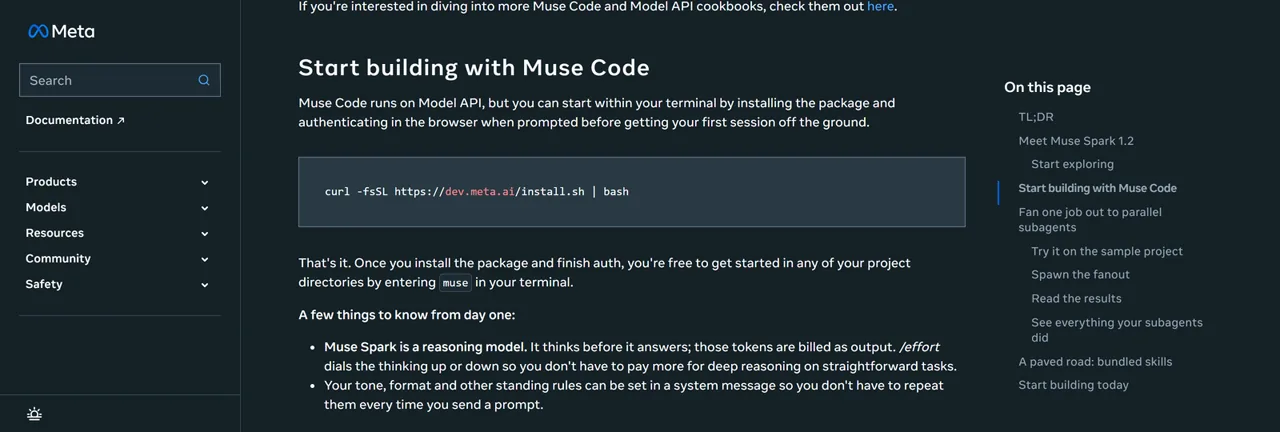
/努力 该命令会改变推理深度。. 来源:Meta 开发者指南.Muse Code 带来了什么
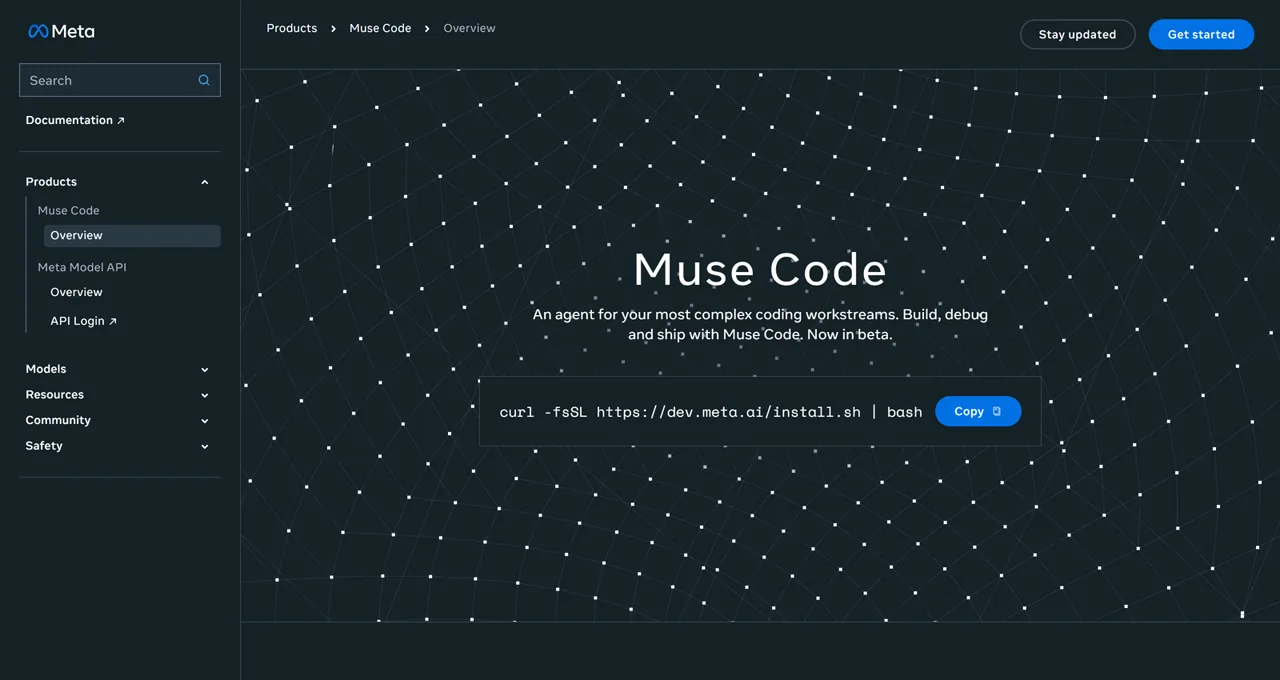
Muse Code 通过终端安装,并将 Muse Spark 1.2 封装到代理工作流中。Meta 的 开发者深度解析 描述了若干不属于纯 API 调用的行为:
- 并行代理: 任务可以在隔离的 Git 工作树中运行。.
- 仅追加式事件日志: 会话和操作会被写入本地 JSONL 文件,以供审计和回放。.
- 简历流程:
缪斯简历可以继续中断的会话。. - 推理控制: 的
/努力该命令用于调整推理强度。. - 显性技能: 元名称
/口味,/烧烤,/带文档的烧烤, 和/plan/plan.
代理产品功能
分代理商
独立任务可能会呈扇形展开。.
工作树
在并行处理期间,各分支保持分离。.
JSONL 日志
仅追加的本地事件支持重放。.
简历
缪斯简历 继续进行中断的会议。.
技能
/口味, /烧烤, /带文档的烧烤, /plan/plan.
这一功能集使Muse Code在更广泛的编程代理市场中具有重要意义,在这个市场中,规划、隔离、回放和工具规范与模型智能同样重要。该 OpenClaw 与 Claude 代码版与开放代码版指南 这对理解这些产品层面的差异很有帮助。.
发布声明与早期社区反馈
反应不等于认可
培训 + 长远规划
更强大的编码计算能力、环境多样性、协同训练,以及一项涉及1,000多个工具调用的压力测试。.
价格与OpenCode
一位Reddit用户称赞了自己早期的编程经历及其价值。.
隐私 + 可靠性
其他用户对数据使用量、标准价格、供货情况以及早期可靠性提出了担忧。.
Meta旗下的人工智能部门表示,Muse Spark 1.2在编码训练方面获得了更强的计算能力、更丰富的训练环境,更加注重整个代码仓库的生成与调试,并实现了与Muse Code的协同训练。另一份 启动主题 描述了一项在 NVIDIA Hopper GPU 上进行的、持续长达 24 小时且包含超过 1,000 次工具调用的压力测试。.
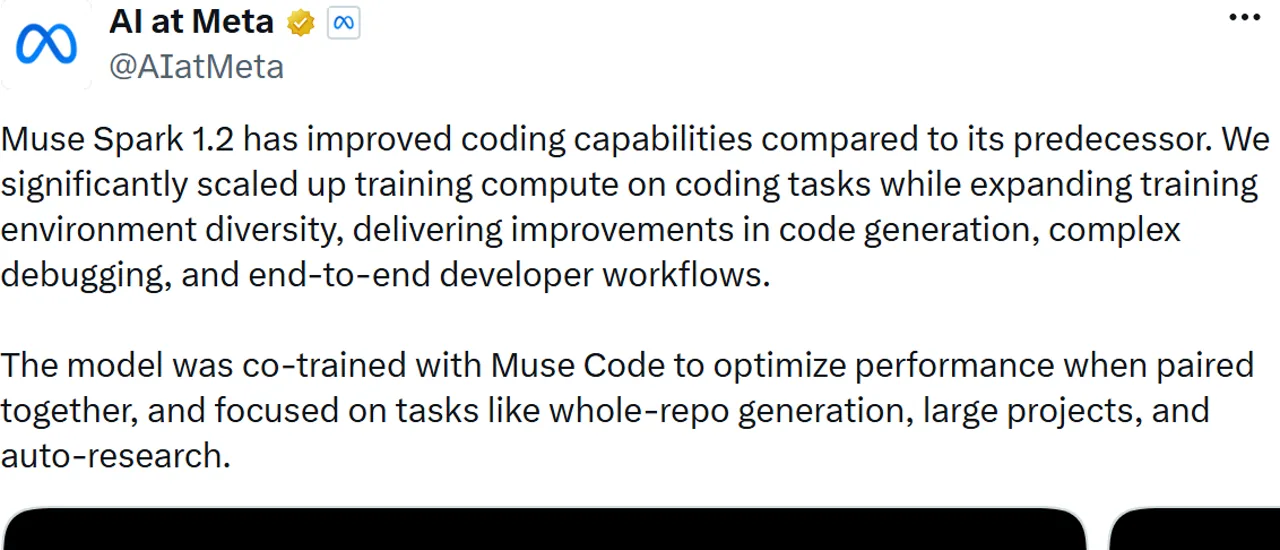
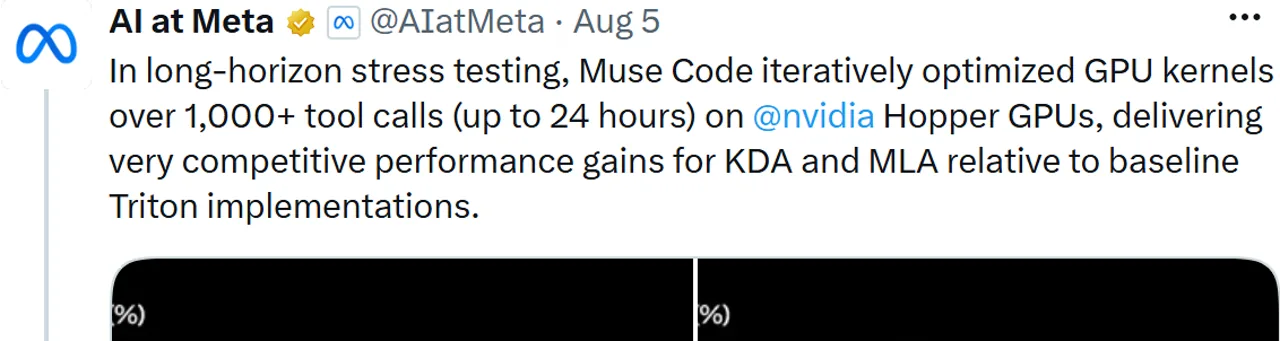
这是一次令人印象深刻的演示,但并非经过量化的总体成功率。它无法告诉我们,该代理选择正确工具的频率、从错误中恢复的频率、避免重复调用的频率,以及在无需人工干预的情况下完成常规仓库任务的频率。.
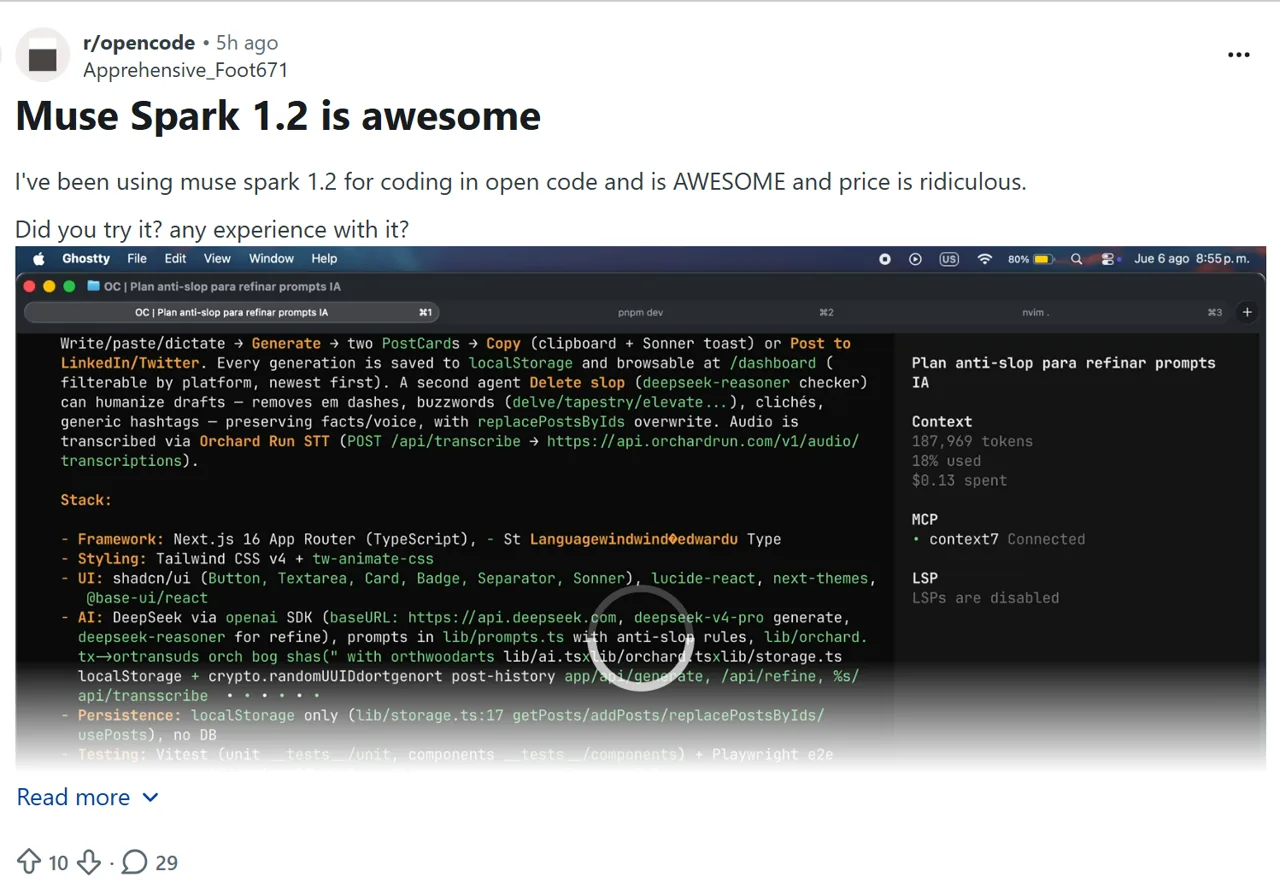
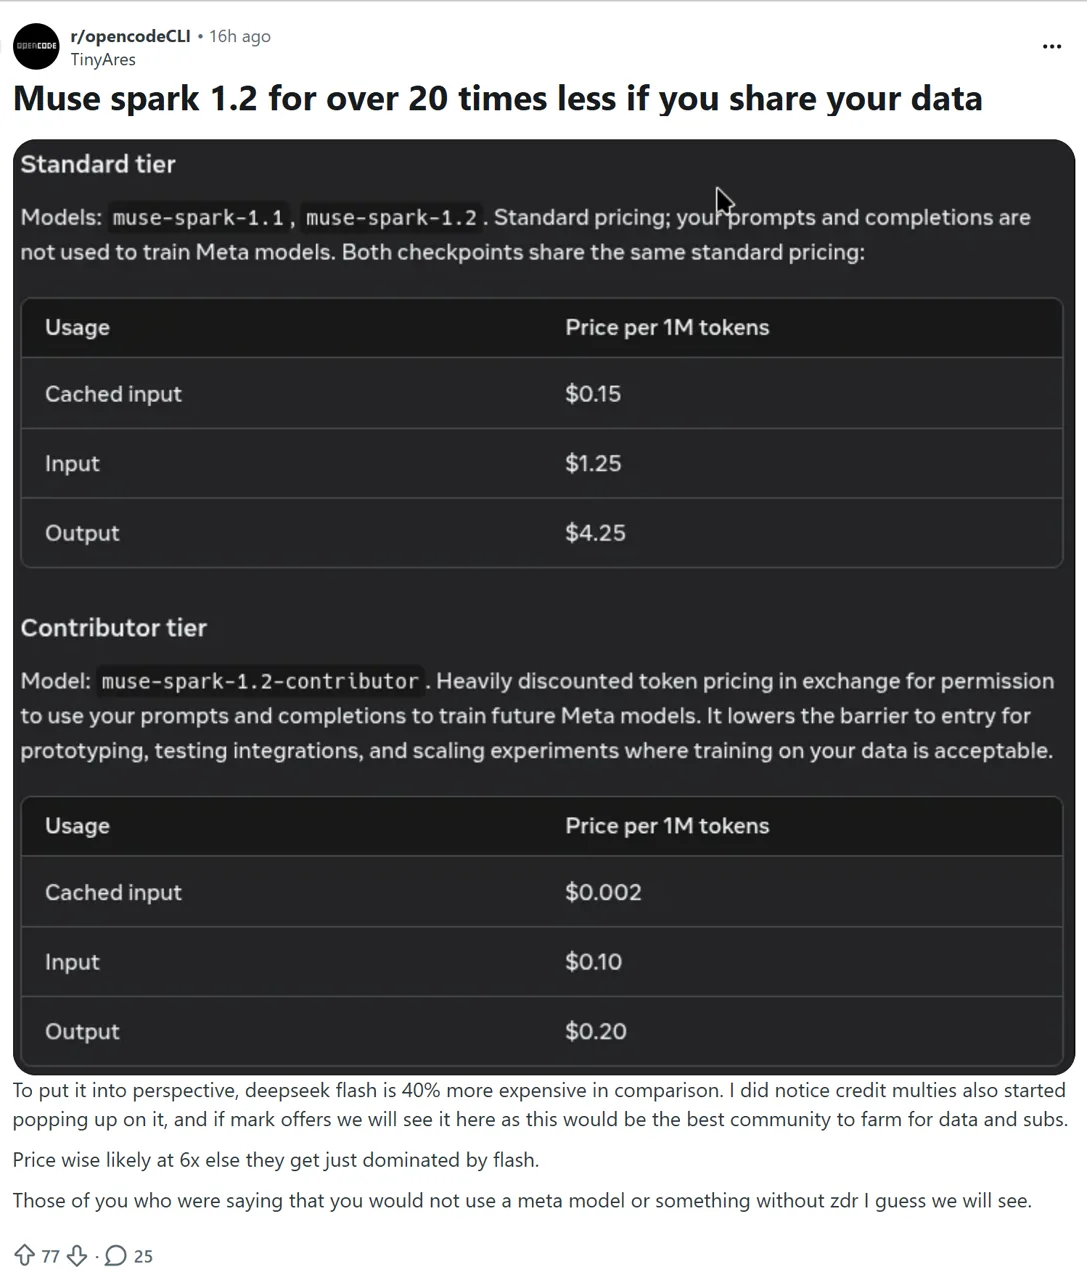
Reddit上早期的帖子同样褒贬不一。其中一篇 r/opencode 的一位用户分享了其使用 OpenCode 的积极体验 并称赞了价格。另一篇 关于贡献者定价的讨论 引发了关于数据使用量、标准套餐费用、可用性和可靠性的疑问。这些只是个人的反应,并非社区的共识。.
Muse Spark 1.2 编程测试:3/3 项任务通过
在我们的测试中,基础版 Muse Spark 1.2 模型通过一个兼容 OpenAI 标准的聊天补全 API,完成了三项受控编码任务。. 每项任务仅允许一次尝试,不允许重试,且不进行人工干预。我们根据公开和隐藏的检查规则,对一次性存储库中返回的文件进行了评估。本次测试未涉及 Muse Code 代理的执行情况,也未测试工具调用的可靠性,因此这些结果不应被视为代理性能基准测试。.
单次尝试结果
这些回复共使用了6,618个推理令牌。这三个最终理由分别是: 停止, ,且“提供商”字段报告的是Meta。.
测试 1:Python 幂等性漏洞修复 — 通过
在不更改公共 API 的情况下阻止重复转账
该模型识别出了缺失的请求 ID 保护机制,添加了最小的安全修复方案,并提供了回归测试,同时保持了原子性平衡更新。.
最初的隐藏评估器错误地要求重复调用一次才能返回 错误, ,尽管该任务仅要求避免向发件人重复收费。在纠正了这一虚构的返回值要求后,未经修改的首次响应通过了全部六项测试。我们既没有重试,也没有修改模型的输出结果。.
测试 2:TypeScript 多文件重构 — 通过
将验证、持久化和审计日志记录分离
提交的文件保留了公共路由契约、严格的 TypeScript 规范,以及同时涵盖订单和审计写入操作的单一事务。此外,还添加了针对性强的验证测试,且不依赖运行时环境。.
第一个评估器将对象与原始数据进行了比较 JSON.stringify, ,因此键插入顺序不同的等价对象看起来并不相等;其 Windows npx 在类型检查之前,启动操作也失败了。使用不区分顺序的比较器并采用 Windows 安全的命令调用方式后,原始响应通过了所有检查。同样,也没有进行模型重试。.
测试 3:JSONL 存储库功能 — 通过
全仓库范围的指令遵循
添加 JSONL 而不破坏 CSV 格式
该模型实现了扩展检测、以1为起点的格式错误检测、原子化输出、干跑安全性、重点测试、帮助文本以及README示例。.
测试结果显示: Muse Spark 1.2 能够一次性生成可用的多文件补丁、遵守兼容性约束、添加测试,并处理一个规模适中的全代码库范围的功能。报告的平均成本约为每项任务 $0.0151,但这些测试用例规模较小,不应据此预测大型代码库的成本。.
哪些人适合使用 Muse Spark 1.2?
决策指南
对照评估
公开或合成代码、可衡量的任务、大上下文需求,以及一个前景看好的3/3基础模型结果。.
需要提供代理证明
Muse Code 的行为、稳定的速率限制、重复的工具调用或广泛的代码库基准测试都是决策门。.
敏感代码或高输出
当隐私和推理令牌成本成为主要因素时,请使用标准层级或比较其他方案。.
除非贵组织已单独批准了“贡献者条款”,否则请对敏感代码使用标准模型。如果标准输出价格导致值计算发生变化,请将其与当前 Codex 定价, Claude 代码以及其他编码代理费用,然后再确定工作流程。.
Muse Spark 1.2 评测结论
Muse Spark 1.2 成功入选评估候选名单,但这并不意味着它会自动获得生产推荐。. 100万代币的发行规模、熟悉的API架构、低廉的贡献者费用、三次首次尝试的编码机会,以及在Meta-run Muse Code上取得的优异成绩,这些因素都让人难以忽视。此外,Meta在公布方法论细节方面也比许多其他项目做得更好。.
注意事项同样具体。贡献者定价模式伴随着数据使用量的权衡。标准输出和推理令牌可能会推高实际成本。 Meta公布的最高编程数据尚未在公开的Terminal-Bench或DeepSWE排行榜上以匹配条目的形式重现,而且我们的实测样本涵盖了三项基础模型任务,而非Muse Code代理的执行。.
明智的做法是在非关键代码上进行受控测试,同时保存原始使用数据和本地验证结果。将测得的成本和延迟视为小任务的样本,然后在将其投入生产环境之前,先测试您自己的代码库规模、故障恢复以及代理工作流。.
Muse Spark 1.2 常见问题解答
什么是 Muse Spark 1.2?
Muse Spark 1.2 是 Meta 推出的一款专注于编程的模型,于 2026 年 8 月 5 日发布,其上下文窗口大小为 100 万个令牌,可通过 Muse Code、Meta Model API 和 OpenRouter 进行访问。.
Muse Spark 1.2 和 Muse Code 是同一个软件吗?
不。Muse Spark 1.2 是该模型;Muse Code 是由其驱动的独立测试版终端代理。Muse Code 增加了诸如子代理、隔离的 Git 工作树、事件日志、恢复功能以及打包技能等产品功能。.
Muse Spark 1.2 API 的费用是多少?
标准模型每百万个令牌的输入成本为 $1.25,缓存输入成本为 $0.15,输出成本为 $4.25。 Contributor 模型的成本为每百万令牌 $0.10 输入、$0.002 缓存输入和 $0.20 输出。.
Meta 是否使用 Muse Spark API 数据进行训练?
Meta 表示,标准级数据不会用于改进 Meta 产品。贡献者级数据可能会用于改进 Meta 产品,因此,除非组织另有批准,否则私有或专有代码应采用标准路径。.
Muse Spark 1.2 是否出现在 Terminal-Bench 或 DeepSWE 的公开排行榜上?
2026年8月7日查询时,该模型在两个公开榜单上均未上榜。Meta报告称,该模型在搭载Muse Code的Terminal-Bench 2.1测试集上获得82.9%,在DeepSWE测试集上获得59.3%,但这些均为Meta自行运行的结果。.
本篇评测中是否对 Muse Spark 1.2 进行了实际测试?
是的。在三项单次尝试的基础模型测试中,Muse Spark 1.2 成功通过了 Python 错误修复、TypeScript 重构以及 JSONL 存储库功能测试。平均延迟为 12.98 秒,报告的总成本为 $0.045362。 Muse Code 代理和工具调用的可靠性未进行测试。.
开发人员如何获取 Muse Spark 1.2?
Meta 列出了三种实现途径:Muse Code 测试版终端代理、Meta Model API 以及 OpenRouter。官方指南中使用了一个与 OpenAI SDK 兼容的客户端,其基础 URL 为 https://api.meta.ai/v1。.