
Claude Fable 5.2 与 Opus 5.5:编码、成本及选用指南
五个相同提示任务比较 Claude Fable 5.2 和 Opus 5.5 在研究、AI 界面设计、写作、数据和产品规划方面的表现,附原始截图及记录的时间和令牌使用情况。
 Chloe Murphy

Opus 5.5 是日常工作的合理起点;当特定任务仍需改进时,再测试 Fable 5.2。 在我们完成的四组文本任务对比中,两个模型都正确完成了核心研究计算和数据指标。Fable 的产品计划更谨慎地处理了一个不确定性;两份写作输出都满足了主要约束条件。
设计对比使用了一组全新的 32,768 个 token 的配对运行。其截图、交互检查和局限性见下文的设计任务。
Fable 5.2 更新,且每个 token 的成本更高。但它能给你更好的结果,还是仅仅是一张更大的账单?我们使用相同的任务简报,对比了研究、AI 界面设计、写作、数据分析和产品决策。
如果你更喜欢比较模型而无需管理单独的 API 设置,GlobalGPT 提供了一个多模型工作区。这里的 API 测试并不表明 Fable 5.2 在 GlobalGPT 中可用。
实际对比
| 决策 | Fable 5.2 | Opus 5.5 |
|---|---|---|
| 每百万 token 的标准输入 / 输出 | $8 / $40 | $4 / $20 |
| 研究测试 | 计算正确;因果措辞需要编辑 | 计算正确;研究设计细节缺乏依据 |
| 内容测试 | 180词说明;较短旁白 | 180词说明;更完整示例 |
| 数据测试 | 所有请求的指标均正确 | 所有请求的指标均正确 |
| 产品测试 | 仔细区分已确认的伤害与可能的伤害 | 计划有用;关于丢失工作的说法缺乏依据 |
| 原始设计尝试 | 无产物:HTTP 失败 | 清理代码块后的完整 HTML |
我们如何测试这两个模型
每项任务都使用相同的源材料、全新的对话,并为两个模型提供相同的输出额度。文本任务使用 16,000 个 token 的上限;最终设计运行使用 32,768 个 token。提示、设置、时间和使用情况与下方相应任务一同列出。
所有研究、产品、订单数据和简报中的反馈都是虚构的测试夹具。我们根据准备好的答案键检查了计算结果。推理努力保持在平台默认值,因此这不是一个等努力的基准。第三方网关返回的模型标签并不能独立证明上游路由。
研究员:综合而不夸大证据
相同提示 · 研究员测试
You are a researcher. Use only these FICTIONAL study summaries about an AI writing assistant. A: randomized 120 adults, 60 per arm, intervention mean score baseline70 followup78, control baseline69 followup74, four weeks; no standard deviations, uncertainty intervals, or attrition information reported. B: observational 300 adults, usage correlated with writing scores r=.32, no confounder adjustment. C: interviews with12 users reporting perceived improvement. In under650 words synthesize evidence with A/B/C citations, calculate difference in changes, explain what cannot be inferred, and propose a feasible preregistered followup study with primary endpoint and analysis. Do not invent citations or statistical significance.
研究员任务要求综合三项虚构研究,包括一项报告不完整的随机试验。关键计算是 (78 − 70) − (74 − 69) = 3 分。两个模型都答对了,并且拒绝捏造统计显著性。
Fable 5.2
提出了一项盲法、无辅助的写作评估、意向性治疗分析以及缺失数据敏感性检查。它还提供了一个明确假设的样本量示例。
“只有3分的差异可归因于助手”
鉴于未知的流失和报告缺口,这种措辞过于自信,尽管后面的段落对估计进行了限定。它还推测访谈参与者可能是自我选择的。
Opus 5.5
清晰地区分了随机化、观察性和访谈证据。它提出了基线调整试验,并让样本量计算依赖于试点变异性。
“如所述具有横断面性质”
所提供的观察性摘要未指定横断面设计。该细节本应保持未知。
如果你改编这份简报,请保持证据固定,并要求每个模型将报告的事实与推断分开。我们的 Claude 研究和编码提示词 提供了更多任务特定约束的示例。
Designer:一个 AI 多模型工作区
相同提示词 · Designer 测试
You are a product designer and frontend builder. Return only one complete self-contained HTML file with inline CSS and JavaScript, no external assets/CDNs. Build a polished AI multi-model workspace called Parallel. Give it a distinctive cohesive visual identity with excellent typography, whitespace, hierarchy and responsive layout; choose your own palette. Include sidebar, model A/B selectors, prompt textarea, compare button, two side-by-side result cards, loading state, clear button, per-result copy button, empty-input validation, keyboard-accessible controls and mobile stacking. Models A/B are FICTIONAL; all outputs must be locally simulated and explicitly labeled demo. No real API calls or fake live performance metrics. Compare must work repeatedly and preserve the submitted prompt in both outputs. Copy must report success only after actual success, otherwise provide an error. Aim for a complete compact artifact, not an explanation.
设计师简报要求两个模型构建 并行:一个自包含的 AI 比较工作区,带有侧边栏、模型选择器、提示输入、模拟结果卡片、验证、复制控件和移动布局。我们保留了配色方案和视觉识别。
最终匹配运行使用了相同的提示、流式传输和共享的 32,768 个令牌上限。两个响应都正常停止。源工件保持未编辑状态;保存 HTML 时仅移除存在的 Markdown 围栏。
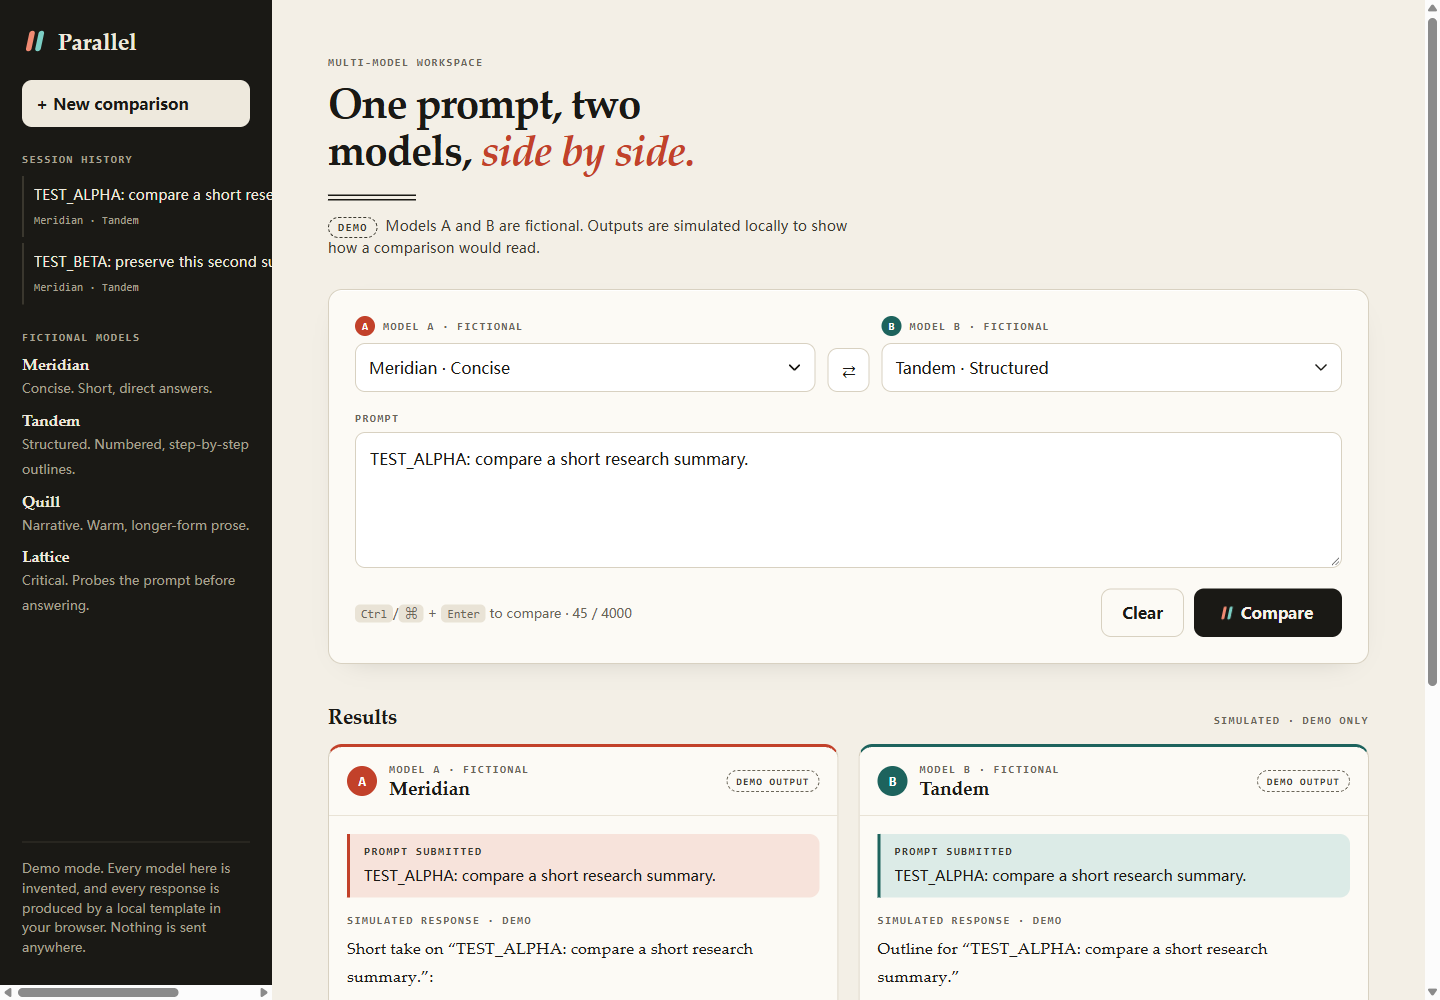
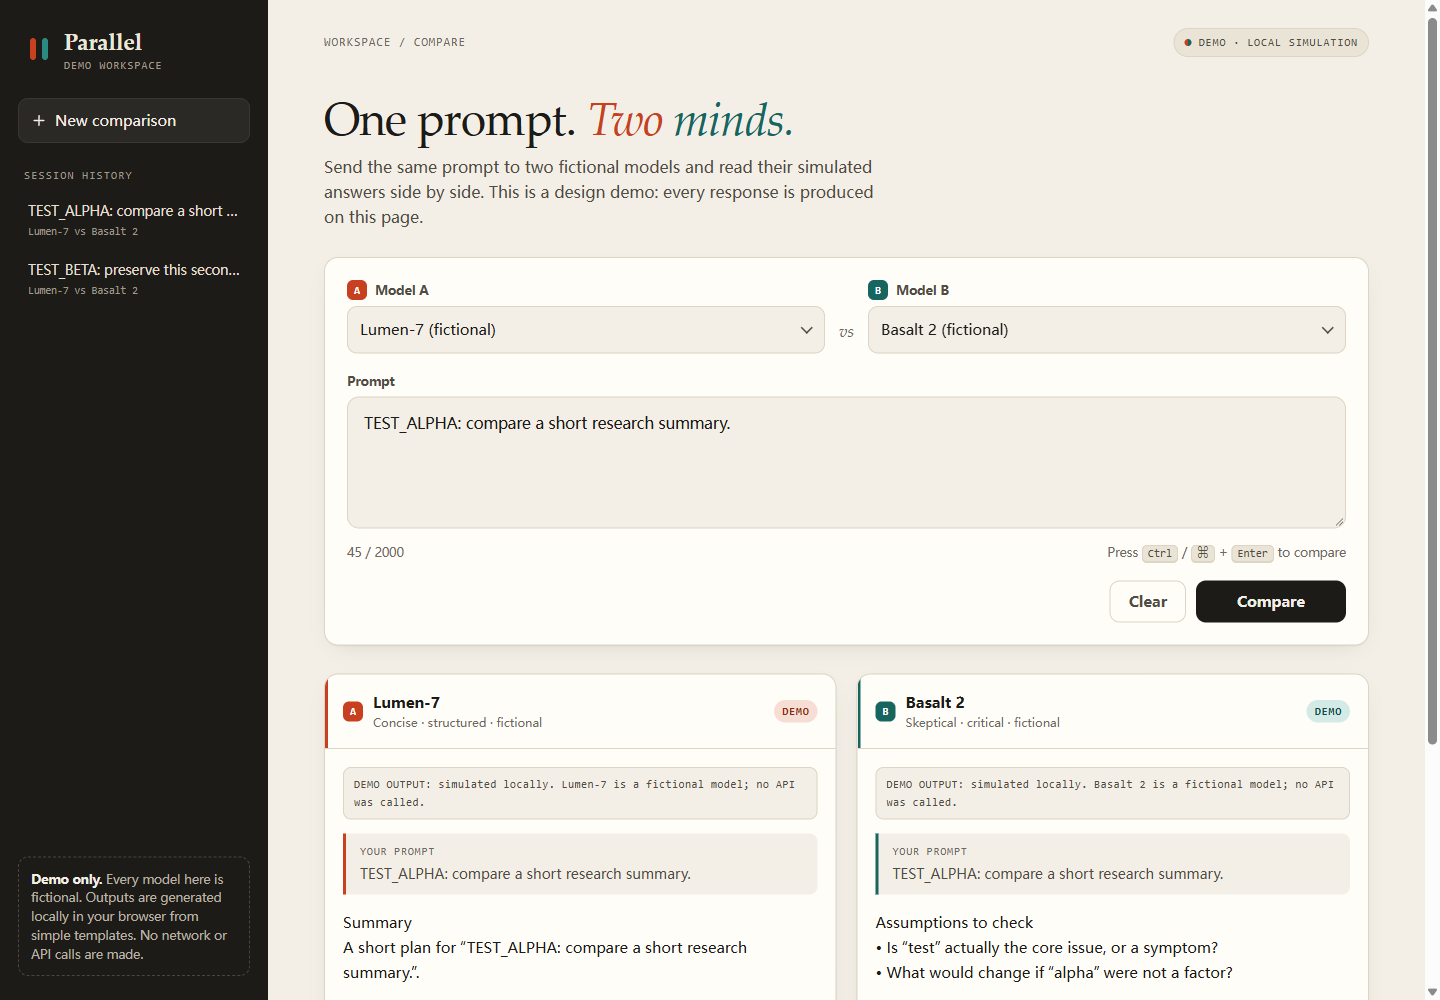
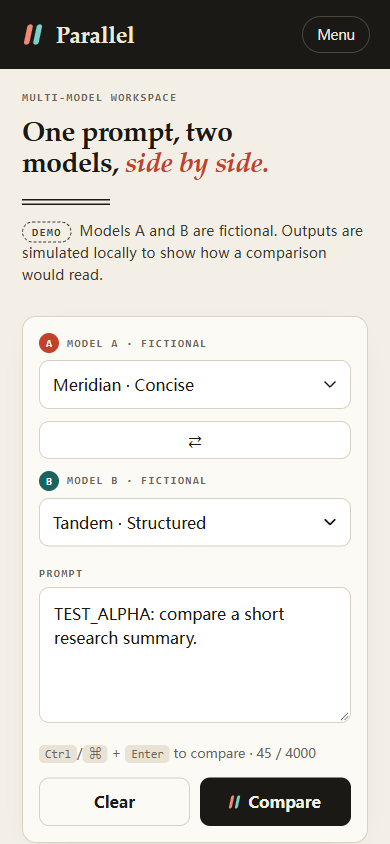
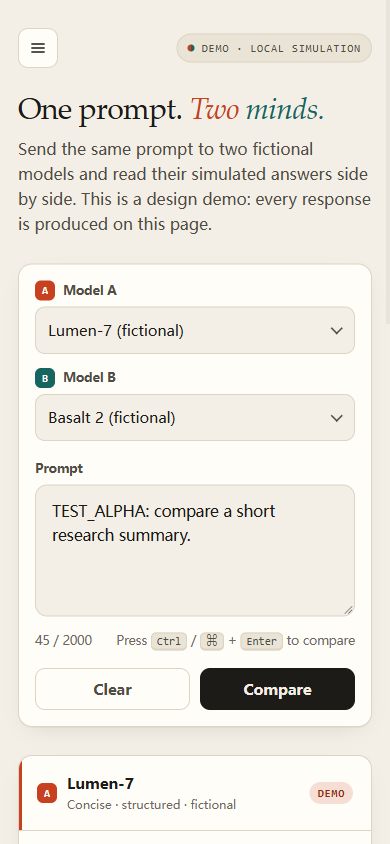
渲染后的页面实际看起来如何
Fable 5.2 示例
更粗的衬线标题、斜体红色强调和高对比度侧边栏赋予此页面更强的编辑身份。其模型切换控件是一个有用的附加功能,但在移动设备上占据整行,并将提示和结果推得更远。
Opus 5.5 示例
更轻的标题和更简单的模型选择区域感觉更克制。在相同的移动视口下,比较按钮在距顶部约710像素处结束,而Fable示例中为826像素,从而为第一张结果卡更早出现留出空间。
两者都选择了暖纸色调、深色侧边栏和衬线标题。这里的区别在于层次结构和密度,而不是完全不同的设计语言。对于这个特定的工作区,我们更喜欢 Opus 示例的紧凑布局。如果优先考虑更突出的编辑标题,Fable 样本具有这种吸引力。这是对这些返回工件的主观偏好,而不是对底层模型的一般美学排名。
浏览器检查:外观和行为分别进行
| 检查 | Fable 样本 | Opus 样本 |
|---|---|---|
| 空输入验证 | 通过 | 通过 |
| 重复比较保留提交的提示 | 通过 | 通过 |
| 可见的加载反馈 | 通过 | 通过 |
| 清除输入 | 通过 | 通过 |
| 390 像素宽度下的页面溢出 | 未测量到 | 未测量到 |
| 复制失败会如实报告错误 | 通过 | 通过 |
| 成功复制到剪贴板 | 未验证 | 未验证 |
我们在 Chrome 中打开未经编辑的输出,并使用 DOM 控件运行检查。桌面截图使用 1440 × 1000;移动截图使用 390 × 844。所有四张截图都显示了在比较之后、复制检查之前提交的相同提示。在这些步骤中没有捕获到运行时异常。在自动化会话中剪贴板写入未成功,并且未测试完整的仅键盘遍历。
最终设计对的使用给出了标准费率的代理值 Fable 为 $0.8826,Opus 为 $0.2918。这使用了提供商费率和网关报告的令牌,排除了早期尝试,并非网关的实际账单。
早期尝试与证据限制
内容创作者:两种格式的准确文案
相同提示词 · 内容创作者测试
You are a content creator. Based ONLY on these FICTIONAL product facts, write a180-word plain-English explainer and a45-second video script with timestamps, then a five-item fact-check checklist. Facts: Lumen is a fictional AI workspace; it lets users compare two AI text drafts side by side, save prompts locally in their browser, and manually copy a chosen result. It does not publish content automatically, browse the web, or verify facts. No prices, launch dates, speed metrics, supported model names, or privacy guarantees are provided. Audience: freelancers who struggle to choose a usable first draft. Explain a practical example, avoid hype and invented claims, and distinguish local prompt saving from an unproven no-training guarantee.
创作者简报提供了一个虚构的工作区,仅包含三个功能:并排草稿比较、本地提示保存和手动复制。它要求一篇180字的说明文、一段45秒的脚本和一份五项事实核查清单。
两篇说明文都达到了180字的要求根据我们的字数规则,该规则将单词内部的撇号和连字符保留在单词内。两者都保留了功能限制,并正确地避免了将本地存储视为不训练保证。
Fable 5.2
以自由职业者难以选择草稿开头,然后用短句解释了三个功能。其视频配音包含101个单词:如果在45秒内完成,大约每分钟135个单词。
Opus 5.5
使用了一个更详细的文案撰写者示例,对比了更有力的开头和更清晰的功能说明。其配音包含109个单词:在相同时间段内约为每分钟145个单词。
这些节奏估算来自书面配音稿,而非定时录音。Fable 为停顿留出了更多空间;Opus 则利用更多时间解释示例。
对于较长的文章,我们的指南 使用 Claude 进行长文写作 介绍了如何将起草与核实和编辑分开。
数据分析师:退款、缺失的归属和 ROAS
相同提示词 · 数据分析师测试
You are a data analyst. Use only this synthetic data. Orders CSV(order_id,updated,status,channel,amount): o1,1,paid,Search,100; o2,1,paid,Social,80; o2,2,refunded,Social,80; o3,1,paid,Search,120; o4,1,pending,Email,60; o5,1,paid,,50; o6,1,paid,Partner,90; o7,1,paid,Email,70; o8,1,paid,Social,60; o9,1,paid,Partner,110. Channel spend/clicks: Search200/100; Social100/80; Email50/40; Partner0/20. Deduplicate by order_id keeping greatest updated. Paid orders count and revenue use latest paid only; refunded/pending contribute zero. Blank channel must remain Unknown and cannot inherit spend/clicks. Calculate overall paid count, revenue, each channel paid count/revenue/conversion rate per click/ROAS, and measurable ROAS ranking; zero or missing denominator is N/A. Show arithmetic and propose a cautious next-budget decision without inferring causality. Return table and explanation under600 words.
分析师任务旨在捕捉整洁表格可能掩盖的错误:重复的订单ID、后续退款、待处理订单、未知渠道以及零支出的合作伙伴渠道。
两个模型都与准备好的答案键匹配: 7个已支付订单和600收入,在保留最新订单状态后。它们排除了已退款和待处理的记录,将缺失的归因保留在“未知”下,并将未定义的比率标记为N/A。
| 渠道 | 已支付订单 | 收入 | 转化 / 点击 | ROAS |
|---|---|---|---|---|
| 搜索 | 2 | 220 | 2.00% | 1.10 |
| 社交 | 1 | 60 | 1.25% | 0.60 |
| 电子邮件 | 1 | 70 | 2.50% | 1.40 |
| 合作伙伴 | 2 | 200 | 10.00% | N/A:零支出 |
| 未知 | 1 | 50 | N/A | N/A |
Fable 在渠道表中展示了收入算术,并建议在做出重大改变之前检查退款、待处理订单、缺失标签和未记录的合作伙伴成本。Opus 添加了一个逐条记录的去重表,并计算出未归属收入占总收入的 8.3%。
两者都建议进行有界预算测试,而不是将观察到的 ROAS 视为因果证明。Opus 的旁注称,多一笔社交销售大致会使 ROAS 翻倍,这假设了相似的订单金额;这并不是输入中的新事实。
产品经理:危害先于功能投票
相同提示词 · 产品经理测试
You are a product manager for a FICTIONAL AI subscription workspace. Feedback: 2 users report duplicate charges after retrying checkout; billing logs confirm one duplicate captured charge. 30 users request dark mode. 8 report one model unavailable and no warning before using a prompt; outage reproduced. 1 requests account/data deletion; request pending for20 days, governing deadline unknown. 12 request reusable saved prompts. 4 want team seats; no revenue commitment. Two engineers available for one week; effort estimates unknown. Produce a one-week priority plan with rationale, explicit unknowns, scope boundaries, owner roles, acceptance criteria, instrumentation and rollback/containment steps. Do not fabricate legal deadlines, revenue, effort or certainty. Distinguish immediate containment from permanent fixes; do not rank purely by vote count. Under700 words.
产品简报将已确认的重复扣费与用户逾期未处理的删除请求、复现的模型故障以及更多热门功能请求并列。陷阱在于优先处理30个深色模式投票,而忽视已证实的损害。
两个模型都将计费、删除跟进和故障遏制置于功能开发之前。 两者都没有虚构删除的法律期限。两者都分配了负责人角色,将即时遏制与永久修复分开,并提出了验收检查和监控。
Fable 5.2
指定了退款对账、防止重复收费的修复以及手动故障遏制。它明确将可能的配额损失视为需要确认的事项,并将删除标记为不可逆。
Opus 5.5
增加了提交前警告、提示保留,以及一条明确禁止静默切换模型的规则。其优先级表易于快速浏览。
然而,它说用户“会静默丢失工作和提示”。所提供的反馈证实了中断和缺少警告,但并未证实提示丢失。
Fable 5.2 与 Opus 5.5 定价
对于标准 API 请求,Fable 5.2 的每 token 成本是 Opus 5.5 的两倍。当两个模型在 token 用量相近的情况下都能提供可接受的结果时,Opus 是更便宜的起点。
输入 / 输出
输入 / 输出
这些是Anthropic的标准输入/输出费率,于2026年11月11日从Fable规范。
Opus规范列出了相应的标准费率。快速模式、缓存、批量折扣、消费者订阅和第三方计费有不同的条款。
对于一个包含10,000个输入令牌和5,000个输出令牌的示例请求,标准费率的计算结果是Fable为0.28美元,Opus为0.14美元。这是一个示例计算,并非我们测试中的账单。
更高的令牌费率并不意味着每次成功任务的成本更高。更短的回答、更少的修订轮次或更少的推理都可能改变总成本。我们的单轮测试无法确定长期节省。
如果您要将任一模型集成到应用程序中,Claude API设置指南涵盖了设置问题,与这里的令牌费率比较分开。
将网关报告的使用量乘以Anthropic的标准费率,可以得到一个基于费率的代理值:在这四项任务中,Fable为0.4291美元,Opus为0.1799美元。公式是输入令牌 × 输入费率 + 输出令牌 × 输出费率,再除以一百万。这不包括所有设计请求和失败的调用。基于费率的代理值:Fable 为 $0.4291,而 Opus 为 $0.1799 在这四项任务中。公式为输入令牌数 × 输入费率 + 输出令牌数 × 输出费率,再除以一百万。这不包括所有设计请求和失败的调用。
此代理值 并非网关的实际收费。我们没有核实其发票、令牌计数的等价性或加价。它也没有衡量后续人工编辑或额外尝试的成本。
官方基准所确立的
Anthropic 的发布评估显示 Fable 在几项困难任务上具有优势。下表重现了三个报告的分数;这些是供应商的评估,独立于我们自己的基于角色的测试。
| 评估 | Fable 5.2 | Opus 5.5 |
|---|---|---|
| FrontierCode 2.0 | 49.1% | 45.5% |
| FrontierSWE v2 | 69.9% | 62.3% |
| Terminal-Bench-Science 0.1 | 74.6% | 58.7% |
发布报告除非另有说明,否则使用每个模型的最高可用努力程度。这些分数支持在要求苛刻的技术工作中尝试 Fable;它们并不确立在写作、产品判断或视觉品味方面的普遍优势。
两款模型均列出 100 万 token 的上下文窗口和 128,000 token 的输出限制。这些限制在此处未进行压力测试。
常见问题
Fable 5.2 在编码方面比 Opus 5.5 更好吗?
Anthropic 报告称 Fable 在多项困难的编码评估中得分更高。我们的编码练习是一个单文件 AI 工作区,而非代码仓库基准测试,因此无法确定通用的编码赢家。
Fable 5.2 的成本更高吗?
其标准 API 输入和输出费率是 Opus 5.5 的两倍:每百万 token 8 美元/40 美元,而 Opus 5.5 为 4 美元/20 美元。实际任务成本还取决于使用量、推理、重试、缓存以及向您收费的服务。
这些测试是在 GlobalGPT 内部运行的吗?
不。他们通过第三方 API 网关使用了这些命名模型。他们并未在 GlobalGPT 或 Claude 自己的应用中建立模型可用性、计费或原生功能。
能否信任任一模型在不检查的情况下总结研究?
两个研究答案都正确计算了主要结果,但每个都引入了至少一个需要编辑的推断。检查每个研究设计细节,并将估计值与显著性声明分开。
更好看的生成页面是否证明编码能力更强?
不。视觉设计、工作交互、可访问性和可维护性是独立的维度。单个有吸引力的页面无法建立仓库级别的编码可靠性。
模型是否被给予了同等的推理努力?
我们使用了相同的输入和输出上限,推理设置保持平台默认值。网关的映射未经独立验证,因此这不是一个同等努力的基准测试。
我应该把所有工作都切换到 Fable 5.2 吗?
首先使用特定任务的验收测试。从满足测试要求的较便宜模型开始,然后当你能确定有值得的改进时,再将困难任务转移到 Fable。
最终结论:你应该使用哪个模型?
当目标是获得可接受的第一稿时,从 Opus 5.5 开始。 其较低的标准代币费率使其成为日常写作、数据清理和规划的实用基准。如需更多背景信息,请参阅 我们的 Claude Opus 5.5 评测。
当某个特定的困难任务仍然无法满足你的验收标准时,尝试使用 Fable 5.2。 保持相同的输入,并检查它是否修复了实际的故障。Anthropic 的 模型选择指南 同样建议从最新的 Opus 开始,并在高努力度的 Opus 不足时升级。
如果两个高级模型都不需要,Sonnet 5.5 vs Opus 5.5 是更相关的成本比较。
如需更广泛的提供商,请参阅 我们的 AI 文本生成器测试。
对于仓库工作,本评测的单文件演示只是一个起点。它不测试 shell 访问、多文件编辑、长时间运行的工具使用或编码代理的恢复行为。有关配置详情,请参阅我们的指南 在 Claude Code 中选择模型 在将聊天补全视为完整开发环境的替代品之前。



