先从你想发出的声音开始。. 选择“Pick Eleven Music v2”来获取歌曲和结构化的伴奏;选择“Qwen Audio 3.0 TTS Flash”来获取旁白和富有表现力的语音;当您希望将语音、环境音和音效融合成一个完整的场景时,请选择“Seed Audio 1.0”。.
您无需寻找一个‘最佳’的音频模型。创作背景音乐的创作者、录制旁白的营销人员,以及搭建火车站场景的电影制作人,他们的需求各不相同。我们针对这些实际工作场景进行了测试——而不仅仅是功能列表——您可以在下方试听全部十个初始输出结果。.
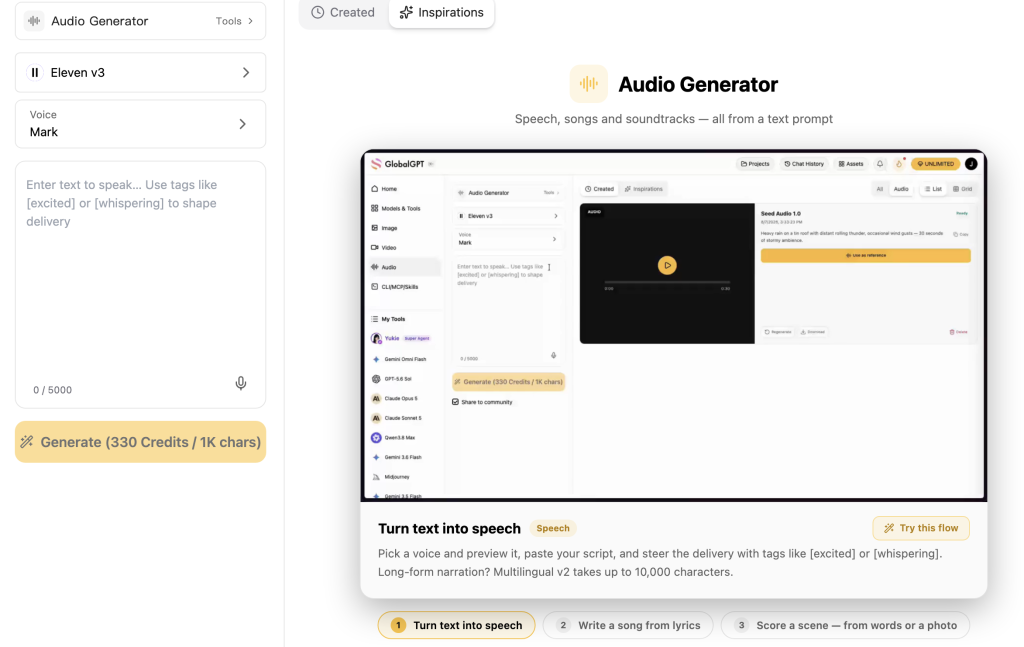
如果你想用自己的提示词尝试同样的思路,, GlobalGPT 让您可以在一个地方在这三种模式之间切换。它还是一個功能更全面的多模型工作区: 您可以使用 GPT-5.6 Sol、Claude Opus 4.8 和 Gemini 3.1 Pro 等模型进行写作和研究,当项目需要图像或视频时,再切换到 GPT Image 2 或 Seedance 2.0。 这意味着您可以起草剧本、生成音频,并继续构建项目的其余部分,而无需将一堆独立工具拼凑在一起。模型访问权限因套餐而异。.
先从你想制作的东西开始
这些只是参考起点,并非普遍适用的排名。.
简答:哪种模型适合哪种音频任务?
以下是一种简单的决策方法:根据最终成果而非品牌来选择。当最终成果是音乐时,Eleven 是理所当然的首选;Qwen TTS Flash 适合旁白和富有表现力的配音;Seed 则适合需要将对话、环境音和音效结合在一起的场景。 我们通过六项实操任务展示了每种选择在哪些场景下表现最佳,下方的十段试听示例则能让你亲自体会其中的取舍。.
| 模型 | 在以下情况下,请从这里开始…… | 我们尝试了什么 | 请记住 |
|---|---|---|---|
| Eleven Music v2 | 你需要一首歌曲或一首结构完整的器乐曲 | 两场音乐对决和一场声乐歌曲展演 | 我们没有将其用于旁白 |
| Qwen Audio 3.0 TTS Flash | 你需要旁白或富有表现力的声音 | 两场演讲对决 | 这些结果适用于所测试的 Flash 版本 |
| Seed Audio 1.0 | 你需要一个包含多种声音类型的完整场景 | 音乐、对话和一个火车站场景 | 灵活的输出不会再现上游的每个特征 |
首先,这有三种不同的音频模型
Eleven Music v2:专用的音乐工作流程
ElevenLabs 描述了 Eleven Music 作为“文本转音乐”工具,可控制音乐流派、风格和结构。文档中还展示了人声或器乐输出、多语言生成,以及按乐段或整首歌曲进行编辑的功能。这些功能使其成为本文中最为清晰的专用音乐工作流;但这并不意味着它与Qwen采用的是同一种文本转语音(TTS)方案。.

Qwen Audio 3.0 TTS Flash:本文测试的语音路径
Qwen Audio 3.0 TTS Flash——确切的“Anywhere”路径是 qwen-audio-3.0-tts-flash——这是B1和B2中采用的语音路径。. 阿里云语音合成文档 在其自定义语音上下文中列出了该确切的 Flash 名称。本文不会从其他 Qwen 行或变体中转移时长、格式或内置语音声明。.

Seed Audio 1.0:更全面的音频制作工作流程
字节跳动职位 Seed Audio 1.0 用于生成涵盖人声、音效、环境音以及统一编曲的完整场景。这使其成为在需要协调多种声音类型时的不二之选。所截取的概览图并未明显体现音乐元素,因此本文中的音乐相关观察均源自我们的实际测试,而非该图片。.

单独的 BytePlus API 页面 识别 seed-audio-1.0 作为一条不支持流媒体的路线,具备参考音频或图像输入、时序控制功能,且输出时长最长可达120秒。这些是该路线的具体信息,与更广泛的定位声明分开说明。.

我们如何测试这三种音频工作流程
我们在生成前冻结了提示词,依次提交了十个任务,并保留了每个任务的第一个有效输出。这十个请求均成功完成,且无需重试。已排除准备就绪片段;下方的测试音频即为原始的第一个有效媒体文件。.
- 官方证据: 第一方产品或 API 文档。.
- 观察到的路线证据: 本次会话的格式、时长、费用、解码及信号检查。.
- 听力材料: 某位用户对A1、A2、B1和B2的盲测成对偏好,以及对C1和C3的语义评审。.
- 限制: 未运行稳定性检查;B1和B2未被自动转录,也未逐字核对。.
十次输出的总计费用为 $0.4819752667。该数值仅用于描述本次交易,并非官方价格承诺。.
音乐测试:Eleven Music v2 与 Seed Audio 1.0 对比
A1:纪录片背景音乐
A1:纪录片背景音乐
一段30秒的纯器乐旅行纪录片配乐,旋律渐强,结尾收束得当。.
显示确切的卡住的提示词
为一部短篇旅行纪录片创作一段30秒的纯器乐配乐。开头以柔和的指弹原声吉他和温暖的钢琴声开始,在乐曲进行到前三分之一处加入轻柔的手击乐器,随后逐渐铺陈,最后以干净利落的终止式收尾。整体氛围应充满希望且富有沉思感。不包含人声、对话及音效。.
| 模型 | 确切路线 | 现状 | 实际持续时间 | 格式 | 观察成本 |
|---|---|---|---|---|---|
| Eleven Music v2 | eleven-music-v2 | 首次生效 | 30.041秒 | MP3,44.1 kHz 立体声 | $0.0750000 |
| Seed Audio 1.0 | seed-audio-1.0 | 首次生效 | 30.000s | PCM WAV,40 kHz 立体声 | $0.0700000 |
- 客观检查
- 这两个文件均解码正确,未出现明显削波现象,且以清晰的淡出结束。未记录乐器的全面合规性。.
- 听众的判断
- 听众更喜欢《Eleven Music v2》,因为其中从轻到重的过渡更自然,乐器间的配合也更和谐。.
- 任务结果
- 在这项首次输出任务中,首选“Eleven”。.
- 局限性
- 每个模型仅有一个有效的初始输出;未进行稳定性测试。.
A1听力考试
试听 A1 的首批作品
打出任意一张卡牌,即可直接比较这两款机型。.
Eleven Music v2
eleven-music-v2于2026年8月6日通过经过测试的Anywhere路径生成。获得一个有效的初始输出;未进行稳定性测试。.
Seed Audio 1.0
seed-audio-1.0于2026年8月6日通过经过测试的Anywhere路径生成。获得一个有效的初始输出;未进行稳定性测试。.
对于A1,听众选择了Eleven的第一段演奏,因为它从轻柔到强劲的过渡更为自然,且乐器间的配合也更为和谐。.
A2:结构化产品发布提示
A2:结构化产品发布提示
一段时长30秒、分为三部分的定时器乐配乐:以极简的节奏开场,随后加入鼓点并逐渐增强能量,最后以明快的升腾感收尾。.
显示确切的卡住的提示词
创作一段30秒的纯器乐产品发布过渡音乐,分为三个清晰的部分:0–8秒,简约的合成器脉冲;8–22秒,加入清脆的电子鼓点和逐渐增强的和声能量;22–30秒,呈现明亮的尾声高潮并以干净利落的结尾收尾。 风格现代且充满自信,但不过于激进。不得包含人声、语音或环境音效。.
| 模型 | 确切路线 | 现状 | 实际持续时间 | 格式 | 观察成本 |
|---|---|---|---|---|---|
| Eleven Music v2 | eleven-music-v2 | 首次生效 | 30.041秒 | MP3,44.1 kHz 立体声 | $0.0750000 |
| Seed Audio 1.0 | seed-audio-1.0 | 首次生效 | 27.704秒 | PCM WAV,40 kHz 立体声 | $0.0646436 |
- 客观检查
- 这两个文件均解码正确,几乎没有剪切现象。对于一个30秒的请求,Seed返回了27.704秒;这是路由行为,并非质量上的损失。.
- 听众的判断
- 听众更喜欢Seed Audio 1.0,因为它的开场更清晰,音乐层次更丰富;而Eleven的开场则难以听清。.
- 任务结果
- 此项首次输出任务优先选用Seed;两项音乐测试则分开进行。.
- 局限性
- 未对各区段的精确时间进行全面验证;未进行稳定性测试。.
A2听力测试
试听 A2 的首批作品
打出任意一张卡牌,即可直接比较这两款机型。.
Eleven Music v2
eleven-music-v2于2026年8月6日通过经过测试的Anywhere路径生成。获得一个有效的初始输出;未进行稳定性测试。.
Seed Audio 1.0
seed-audio-1.0于2026年8月6日通过经过测试的Anywhere路径生成。获得一个有效的初始输出;未进行稳定性测试。.
在A2测试中,Seed的首个生成结果赢得了听众的青睐,因为其前奏更为清晰,层次感也更丰富。针对30秒的请求,Seed的生成时长为27.704秒;我们将这一偏差单独记录,并不将其视为质量上的扣分项。由于两款模型各在音乐任务中胜出一次,因此音乐类别中没有最终赢家。.
语音测试:Qwen TTS Flash 与 Seed Audio 1.0 对比
B1:中立的纪录片旁白
B1:中立的纪录片旁白
与英语港口解说相同的叙述风格,语调平静、中立,语速适中,并带有自然的停顿。.
显示确切的卡住的提示词
每天早晨,港口比城市更早苏醒。渡轮在水面上穿梭,商店的灯陆续亮起,第一批通勤者踏上码头。到七点钟,这片原本宁静的海岸线已然成为白天的中心。采用清晰、中立的英语,以平静的纪录片旁白风格讲述。 语速适中,自然停顿。不使用音乐、环境音或音效。.
| 模型 | 确切路线 | 现状 | 实际持续时间 | 格式 | 观察成本 |
|---|---|---|---|---|---|
| Qwen Audio 3.0 TTS Flash | qwen-audio-3.0-tts-flash | 首次生效 | 27.507秒 | MP3,22.05 kHz 单声道 | $0.0051300 |
| Seed Audio 1.0 | seed-audio-1.0 | 首次生效 | 18.780秒 | PCM WAV,40 kHz 立体声(左右声道相同) | $0.0438200 |
- 客观检查
- 这两个文件均已正确解码,其中包含类似语音的活动和停顿。用户表示未发现明显的文本问题。.
- 听众的判断
- 听众更喜欢Qwen,认为它更自然、更具纪实风格;而Seed听起来则有些生硬,像考前提醒一样。.
- 任务结果
- 对于此首次输出任务,建议使用 Qwen。.
- 局限性
- 未验证逐字准确性;未进行稳定性测试。.
B1听力考试
试听 B1 的首批作品
打出任意一张卡牌,即可直接比较这两款机型。.
Qwen Audio 3.0 TTS Flash
qwen-audio-3.0-tts-flash于2026年8月6日通过经过测试的Anywhere路径生成。获得一个有效的初始输出;未进行稳定性测试。.
Seed Audio 1.0
seed-audio-1.0于2026年8月6日通过经过测试的Anywhere路径生成。获得一个有效的初始输出;未进行稳定性测试。.
Qwen的首次输出听起来更自然、更像纪录片;而Seed听起来则显得生硬。如果校对文字记录是您工作流程的核心环节,请参阅这篇单独的指南,其中详细说明了 ChatGPT 如何将音频转录为文字. 我们没有使用转录文本来逐字核对B1的内容。.
B2:情感发展
B2:情感发展
一个女性的声音,从紧张的低语,逐渐过渡到平淡的叙述,最后变成如释重负的兴奋。.
显示确切的卡住的提示词
“我们成功了,”玛雅轻声说道。接着,灯光重新亮了起来。“好了——现在我们可以庆祝了!”请使用一位成年女性的统一声音。第一句要轻声且紧张地表达,中间那句用中性的叙述语气,最后一句则要带着如释重负的兴奋感。情感变化要清晰,但不要过于夸张。不要使用音乐或音效。.
| 模型 | 确切路线 | 现状 | 实际持续时间 | 格式 | 观察成本 |
|---|---|---|---|---|---|
| Qwen Audio 3.0 TTS Flash | qwen-audio-3.0-tts-flash | 首次生效 | 25.913秒 | MP3,22.05 kHz 单声道 | $0.0052950 |
| Seed Audio 1.0 | seed-audio-1.0 | 首次生效 | 9.180秒 | PCM WAV,40 kHz 立体声(左右声道相同) | $0.0214200 |
- 客观检查
- 两个文件均解码正确;其中包含多个语音区域。时长差异未计入质量评分。.
- 听众的判断
- 听众更喜欢Qwen,因为它能呈现更强烈的耳语质感,营造出更令人信服的叙事氛围。.
- 任务结果
- 对于此首次输出任务,建议使用 Qwen。.
- 局限性
- 未验证逐字准确性;未进行稳定性测试。.
B2听力考试
试听 B2 的首批作品
打出任意一张卡牌,即可直接比较这两款机型。.
Qwen Audio 3.0 TTS Flash
qwen-audio-3.0-tts-flash于2026年8月6日通过经过测试的Anywhere路径生成。获得一个有效的初始输出;未进行稳定性测试。.
Seed Audio 1.0
seed-audio-1.0于2026年8月6日通过经过测试的Anywhere路径生成。获得一个有效的初始输出;未进行稳定性测试。.
Qwen的首次输出更具低语般的特质,且更具叙事感。用户在B1和B2中未察觉到明显的文本问题,但具体词汇的准确性尚未得到验证。.
单一模型工作流展示
C1:Eleven Music v2 结构化人声歌曲
C1:结构化声乐歌曲
一首30秒的独立流行歌曲,乐器配置和曲式固定,且必须包含两句歌词。.
显示确切的卡住的提示词
创作一首30秒的欢快独立流行歌曲,包含一名女主唱、明快的吉他、贝斯和拍手声。曲式结构:4秒的器乐前奏、一段简短的主歌、副歌以及干净利落的结尾。 请将以下每句歌词各使用一次:主歌:‘晨光洒在窗边,计划正展翅高飞。’副歌:‘从当下出发,让这一刻绽放光彩。’不得包含任何旁白或音效。.
| 模型 | 确切路线 | 现状 | 实际持续时间 | 格式 | 观察成本 |
|---|---|---|---|---|---|
| Eleven Music v2 | eleven-music-v2 | 首次生效 | 30.041秒 | MP3,44.1 kHz 立体声 | $0.0750000 |
- 客观检查
- 该MP3文件已正确解码。检测到一个微不足道的孤立满量程采样点,未发现大范围的削波现象。.
- 听众的判断
- 听众认为该要求部分满足:声音听起来有些不自然,且带有电子噪音般的质感。.
- 任务结果
- 对于这一项的首个成果,已部分达成。.
- 局限性
- 该观察结果仅适用于此首次输出;未进行稳定性测试。.
C1听力考试
试听 C1 的首支单曲
播放此单模型展示中的第一个有效输出。.
Eleven Music v2
eleven-music-v2于2026年8月6日通过经过测试的Anywhere路径生成。获得一个有效的初始输出;未进行稳定性测试。.
C1 部分履行了合同。听众认为声音有些不自然,并听到了类似电流噪声的声音。这是针对该样本的具体观察,并非针对产品普遍缺陷的投诉。.
C3:Seed Audio 1.0 完整的火车站场景
C3:完整的火车站场景
一段20秒的沿海车站场景,融合了环境音、行驶中的列车、站内铃声以及一段精准的广播播报。.
显示确切的卡住的提示词
制作一段20秒的黎明时分沿海火车站完整场景。以柔和的海风和远处海鸥的叫声开场。一列火车从左侧驶来,并在站台前刹车。 一位语调平和的女站务员准确播报:‘7点15分的沿海列车现已抵达2号站台。’在播报前加入一段简短柔和的音乐提示音,随后让列车声和环境音自然淡出。确保语音清晰可辨,场景在空间上保持连贯性。.
| 模型 | 确切路线 | 现状 | 实际持续时间 | 格式 | 观察成本 |
|---|---|---|---|---|---|
| Seed Audio 1.0 | seed-audio-1.0 | 首次生效 | 20.000s | PCM WAV,40 kHz 立体声 | $0.0466667 |
- 客观检查
- 该 WAV 文件解码正确,未出现接近削波的情况,且从技术层面来看,其中包含了所需的多部分场景结构。.
- 听众的判断
- 听众认为该项要求“部分满足”,因为火车的刹车和停车声听起来有些不自然。.
- 任务结果
- 对于这一项的首个成果,已部分达成。.
- 局限性
- 该公告的具体内容未被独立记录;稳定性测试未进行。.
C3听力测试
试听 C3 的首支单曲
播放此单模型展示中的第一个有效输出。.
Seed Audio 1.0
seed-audio-1.0于2026年8月6日通过经过测试的Anywhere路径生成。获得一个有效的初始输出;未进行稳定性测试。.
C3 也部分达到了合同要求:听众认为列车的刹车和停车声音有些不自然。将生成的语音与视觉内容相结合的视频创作者可能会发现这一点 对话、音频和口型同步指南 很有用,不过这里没有测试过唇形同步效果。.
成本、输出长度和路径行为
观测到的电荷与实际输出持续时间
2026年8月6日,通过Anywhere平台,每个任务仅产生一个有效的初始输出结果。收费标准基于单次观察结果,并非官方费率表。两个迷你条形图采用独立的视觉刻度;未采用双轴或综合评分。.
观测到的成本范围从 $0.00513(针对 Qwen B1)到 $0.075(针对每个 Eleven 输出)。 实际时长范围从Seed B2的9.180秒到Eleven音乐输出的30.041秒不等。这些是实测结果,而非标价或质量评分。.
为什么要在 GlobalGPT 上尝试这些音频模型?
音乐生成、富有表现力的文本转语音(TTS)以及完整的音景创作是不同的任务,因此在此领域并不存在一个通用的最佳模型。 GlobalGPT 使这种区分变得切实可行:你可以先使用 Eleven Music 制作一首曲目,然后切换到 Qwen Audio 进行旁白录制,或者使用 Seed Audio 创作一个场景,而无需为每个音频工作流程维护独立的平台。.
由于 GlobalGPT 是一个多模型工作区,而非仅限音频的工具,因此工作并不一定以生成音频文件为终点。您可以利用平台上的其他 AI 模型来起草或润色剧本、调研主题、制作辅助图片,并围绕已完成的音频素材开发视频内容。.
2026年8月10日,该 GlobalGPT 定价页面 数据显示,当选择“按年计费”并显示“按年结算”时,BASIC 套餐的月等效流量为 $5.8,PRO 套餐为 $10.8,UNLIMITED 套餐为 $25.0。 这些是该页面显示的按年计费数据;具体访问模式因套餐而异。.

您应该选择哪一款?
包含六个任务的首轮输出结果矩阵
| 工作流程 | 已测试的机型 | 结果 | 观察到的原因 | 证据类型 | 限制 |
|---|---|---|---|---|---|
| A1 · 音乐 | Eleven 对阵 Seed | 十一为佳 | 更自然的展开和更和谐的配器 | 盲听偏好 | 各一个初始输出 |
| A2 · 音乐 | Eleven 对阵 Seed | 优先考虑种子 | 更清晰的开场和更丰富的层次感 | 盲听偏好 | Seed 返回 27.704 秒 |
| B1 · 口语 | Qwen 对阵 Seed | 首选 Qwen | 更自然的纪录片风格叙述 | 盲听偏好 | 文本未逐字核对 |
| B2 · 口语 | Qwen 对阵 Seed | 首选 Qwen | 更强烈的低语感与叙事感 | 盲听偏好 | 文本未逐字核对 |
| C1 · 声乐歌曲 | 仅限11人 | 部分满足 | 声音听起来不自然,带有类似电噪声的质感 | 用户语义审查 | 针对特定样本的观察 |
| C3 · 声音景观 | 仅限种子 | 部分满足 | 火车的刹车声和停靠声听起来很不自然 | 用户语义审查 | 公告内容未转录 |
任何一轮比赛的结果都不会被转换为总分或产生统一的冠军。.
- 选择 Eleven Music v2 当工作本质上与音乐相关时:结构化的器乐作品、歌曲,或乐段级别的音乐编辑。.
- 选择 Qwen Audio 3.0 TTS Flash 当工作内容是旁白或受控的表达性演讲时。.
- 选择 Seed Audio 1.0 当输出效果必须像一个完整的场景一样,融合环境音、音效和对话时。.
这些建议总结了工作流适配情况以及六项针对首次输出结果的评估。它们并未确定一个绝对的优胜者。.
此项比较的局限性
- 每个模型和任务仅输出一个有效的初始结果;不进行稳定性重复计算。.
- B1和B2并未逐字转录或核对。.
- 听力评判具有主观性,且因样本而异。.
- “Anywhere”路线并非整个上游产品。.
- 没有任何一个公正的独立排行榜会将这三条确切路线纳入同一评定方法之下。.
- 文件格式、采样率、声道数、文件大小和播放响度均未被纳入质量评分范围。.
常见问题
01Eleven Music v2、Qwen Audio 3.0 和 Seed Audio 1.0 属于同一类型的模型吗?
No. Eleven Music v2 是一款专用的音乐工作流,Qwen Audio 3.0 TTS Flash 是本文测试的语音生成方案,而 Seed Audio 1.0 则定位于全场景音频生成。因此,本次对比分析将按任务类型分别推荐,而非强行给出一个通用的排名。.
02哪款模型是专为人工智能音乐生成而设计的?
在本次对比中,Eleven Music v2 无疑是专为音乐制作设计的最佳选择。其官方文档介绍了该软件对音乐流派、风格、结构、人声或器乐输出、多语言支持,以及乐段级或整首歌曲编辑功能的控制能力。.
03哪条经过测试的路线更适合叙述和富有表现力的演讲?
Qwen Audio 3.0 TTS Flash(此处通过精确的 Anywhere 路径 qwen-audio-3.0-tts-flash 进行标识)在叙述和富有表现力的语音测试中表现最佳。听众在 B1 和 B2 组中均更青睐其首次输出结果,但未对其稳定性和单词准确率进行测试。.
04哪款型号能够通过语音和音效营造出完整的声景?
Seed Audio 1.0 是最适合创作声音景观的工作流程。其官方定位涵盖人声、音效、环境音以及统一编排,而在 C3 测试中,该软件将车站广播、列车运行声、铃声和沿海环境音融合到了一段输出音频中。.
05我可以在GlobalGPT中同时使用这三项功能吗?
是的。您可以在 GlobalGPT 的音频工作区中尝试使用 Eleven Music 处理音乐、Seed Audio 1.0 处理完整的音频场景,以及 Qwen Audio 3.0 处理语音。GlobalGPT 还将写作、研究、图像和视频工作流整合到了同一个多模型平台中。 模型的可用性因套餐而异。.
06这次对比能得出一个最终赢家吗?
不。这些模型适用于不同的工作流程,且实测数据仅涵盖每个模型和任务的首次有效输出结果,未进行稳定性重复测试。有用的结论是附带条件的:专用音乐模型为“Eleven”,语音模型为“Qwen TTS Flash”,完整音频场景模型为“Seed”。.
尝试您自己的音频工作流程
请将您自备的音乐简报、旁白脚本或音景创作提示带到 GlobalGPT 音频发生器 并将结果与您实际需要完成的工作进行对比。请重点关注音乐结构、声线表现、场景连贯性以及对提示的遵循情况,而不是仅凭名字来选择模型。.
一旦音频方向确定,您就可以继续使用 GlobalGPT 的其他 AI 模型来推进项目,包括剧本开发、调研、辅助图片和视频创意等。这样,测试就不再是孤立的音频演示,而是变成了实用的内容工作流;仅在需要验证稳定性时才重复生成输出结果。.