
Claude Sonnet 5.5 与 Opus 5.5:价格、基准测试及实际测试
Sonnet 5.5 和 Opus 5.5 同属 Claude 5.5 代产品,但两者的定价和定位各不相同。本次对比测试让两者都接受了相同的五个提示,并报告了该路线实际返回的结果。.
两者之间的差距主要体现在成本和速度上。. 在这组包含五个提示的测试中,Sonnet 5.5 完成速度更快,消耗的输出令牌更少,且得出的算术请求成本估计值更低。Opus 5.5 消耗的令牌和时间更多,而其给出的答案往往更为冗长。任务卡显示了这些额外文本在哪些地方改变了有用的结果,以及在哪些地方两个模型都直接通过了测试。.
提示词、请求上限、工作量设置、终点以及“每个模型运行一次”的设计均与之前保持一致 Claude Opus 5.5 评测.
简答
- 本次配对跑中的速度: Sonnet 5.5 在本地用 31.930 秒完成了五个连续请求;Opus 5.5 则用了 47.725 秒。.
- 路由报告的输出令牌: Sonnet 5.5 使用了 2,686;Opus 5.5 使用了 3,952。思维领域分别为 987 和 2,214。.
- 算术法计算的建议零售价估算: 五项 Sonnet 请求的费用约为 $0.02826;五项 Opus 请求的费用约为 $0.08184,此处采用官方标准计费率,且不包括缓存、积分、税费和加价。.
- 任务结果: 这两个模型都通过了信息提取、JSON 和数学题的测试。Sonnet 在保持要求的两段式中文格式方面更为简洁;两者的代码输出均可使用,但在深度和边界情况的解释方面有所不同。.
- API 迁移: 思考无法被禁用;拒绝强制选择工具,且令牌预算中包含思考。请检查 迁移注意事项 在切换之前。.
- 决策边界: 这是通过第三方路由对每个任务进行的一次运行。它测量的是观察到的提示响应、本地实际运行时间以及路由报告的使用情况——并非一个通用的能力评分。.
官方价格和车型规格
Anthropic 当前的模型卡中,列出了两种模型:一种具有 1M 令牌的上下文窗口,另一种最大输出为 128K。Sonnet 5.5 被标记为 快速 默认设置较为繁琐;Opus 5.5 被标记为 中度 以中等默认力度进行。根据标准代币汇率,Sonnet 5.5 的输入和输出价格均为 Opus 5.5 的二分之一。.
| 模型 | API ID | 官方延迟标识 | 输入/输出 | 上下文 / 最大输出 | 默认努力 | 缓存读取 |
|---|---|---|---|---|---|---|
| Claude Sonnet 5.5简体中文(大陆) | 克劳德-十四行诗-5-5 | 活跃 · 快速 | $2 / $10 每 MTok | 1M / 128K | 高 | $0.20 / MTok |
| Claude Opus 5.5(简体中文(大陆)) | 克劳德-作品第5号-第5首 | 活跃 · 中等 | $4 / $20 每 MTok | 1M / 128K | 中型 | $0.20 / MTok |
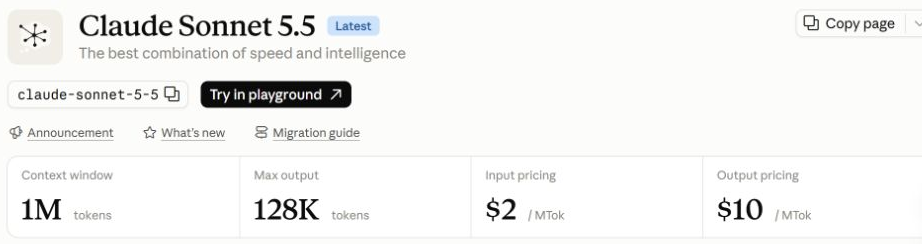
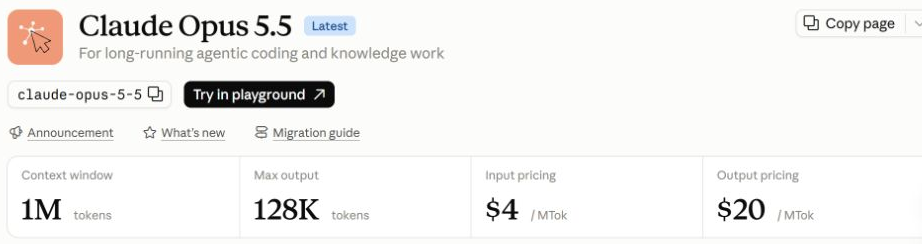
以一个简单的未缓存示例为例,该示例包含 100,000 个输入令牌和 20,000 个输出令牌,所列出的令牌速率在 Sonnet 5.5 上约为 $0.40,在 Opus 5.5 上约为 $0.80。 参见 Claude 定价与限额指南 用于计划背景。.
官方基准测试背景
Anthropic’s Sonnet 5.5 公告 将两种模型都放入一个由服务提供方报告的表格中。行模式根据基准和工作量设置而有所不同。.
| Anthropic报告的基准 | Sonnet 5.5 | 作品第5.5号 | 度量 |
|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 66.4%¹ | 施事体终端编码 |
| FrontierCode v1.1(主分支) | 46.2% Max² / 52.1% Xhigh | 54.4% | 代码更改是否会被合并 |
| CursorBench 4.0 | 55.5% | 57.8% | 模棱两可的多文件编码任务 |
| GDPval-AA v2.1 | 1844 | 1846 | 各职业中的知识型工作 |
| 人类的最后一场考试 | 64.5%(含工具) | 67.7%(含工具) | 跨学科推理 |
| OSWorld 2.1 | 80.1% 部分 | 81.8% 部分 | 计算机使用任务 |
| 制图学 | 61.6% 无需工具 | 64.4% 无需工具 | 图表识别 |
¹ Opus 5.5 Terminal-Bench 在“xhigh”工作负载下运行;² Sonnet 5.5 FrontierCode 在“Max”模式下为 46.2%,在“Xhigh”工作负载下为 52.1%。 OSWorld 的数值标注为“部分”。这些数值基于服务提供商的环境,并非在等效工作负载下独立重跑的结果。.
同一提示词的 API 方法
每个模型都通过……收到了相同的五个提示 POST https://anywhere.broly.ai/v1/messages. 客户端发送了一条用户消息,, max_tokens:8192, output_config.effort: high, ,且无需任何工具。每个请求都返回了 HTTP 200 状态码,并且 end_turn.
该测试方法遵循更广泛的 GlobalGPT 模型测试工作流. 另一个 Claude API 指南 涵盖了请求配置和令牌计费。.
时间、代币和预估成本
| 路线 | 当地时间五局 | 输入标记 | 输出标记 | 报道中的观点 | 预计请求费用* |
|---|---|---|---|---|---|
| Claude Sonnet 5.5简体中文(大陆) | 31.930秒 | 700 | 2,686 | 987 | $0.02826 |
| Claude Opus 5.5(简体中文(大陆)) | 47.725秒 | 700 | 3,952 | 2,214 | $0.08184 |
* 根据路线报告的代币数量和官方标准费率估算。在本批次中,Sonnet 5.5 的本地耗时比标准值低 33.1%,产出代币数量比标准值低 32.0%。.
五张配对任务卡
每张卡片上都汇总了任务、观察结果、当地时间、路线报告标记、状态和边界等信息。.
这些模型能否修复混合型去重功能?
任务设置: 该提示词的具体内容是从之前的 Claude Opus 5.5 评测 测试包。.
| 模型 | 时间/路线使用情况 | 简短结果标签 |
|---|---|---|
| Claude Sonnet 5.5简体中文(大陆) | 8.679秒 145 个输入 / 830 个输出 0 条思考 HTTP 200 · end_turn | 修正了函数,并增加了两道习题;解释部分有所简化。. |
| Claude Opus 5.5(简体中文(大陆)) | 15.844秒 145 输入 / 1478 输出 700种思考方式 HTTP 200 · end_turn | 修正了函数并增加了两项测试;对边界情况进行了更深入的讨论。. |
观察到的比较: 两者都返回了一个经过修正的函数和两个测试用例。Sonnet 5.5 使用了带类型标记的键,, casefold(), ,而在较短的响应中采用了列表作为备选方案;Opus 5.5 则花费了更多的输出令牌来解释其他边界情况。这两次运行均未能确定一个通用的编码优胜者。.
边界: 一个小小的 Python 修复仅检查了具体的边界情况,而未能确保跨代码库或工具驱动编码的可靠性。.
这些模型能否在不添加任何断言的情况下保留所给的五个事实?
任务设置: 该提示词的具体内容是从之前的 Claude Opus 5.5 评测 测试包。.
| 模型 | 时间/路线使用情况 | 简短结果标签 |
|---|---|---|
| Claude Sonnet 5.5简体中文(大陆) | 3.569秒 210 输入 / 209 输出 0 条思考 HTTP 200 · end_turn | 五个编号的要点;保留了原文中的事实。. |
| Claude Opus 5.5(简体中文(大陆)) | 4.374秒 210 个输入 / 312 个输出 101种思考方式 HTTP 200 · end_turn | 五个编号的要点;保留了原文中的事实。. |
观察到的比较: 两者都返回了恰好五个编号的要点,且内容均在给定事实范围内。Sonnet 5.5生成了209个输出令牌,而Opus 5.5生成了312个,但该提示仅是一段简短的笔记,而非大篇幅的上下文输入。.
边界: 这是一项基于实际环境的提取和格式检查;它不能作为百万令牌上下文性能的证据。.
这些模型能否返回与请求完全一致的结构?
任务设置: 该提示词的具体内容是从之前的 Claude Opus 5.5 评测 测试包。.
| 模型 | 时间/路线使用情况 | 简短结果标签 |
|---|---|---|
| Claude Sonnet 5.5简体中文(大陆) | 5.052秒 128个输入 / 260个输出 0 条思考 HTTP 200 · end_turn | 可解析的 JSON;请求的键和项的数量。. |
| Claude Opus 5.5(简体中文(大陆)) | 8.276秒 128 个输入 / 622 个输出 390 思考 HTTP 200 · end_turn | 可解析的 JSON;请求的键和项的数量。. |
观察到的比较: 两者均返回了包含请求键值的可解析 JSON 数据,并各列出了两项优点和两项缺点。Sonnet 5.5 的输出更简洁,仅包含 260 个令牌;这些字符串描述的是一套虚构的评论设置,并非产品事实。.
边界: 仅通过一次该模式测试,无法衡量在工具调用或长时间对话中结构化输出的可靠性。.
这些模型能否将圆整后的批处理序列一直延续到最终答案?
任务设置: 该提示词的具体内容是从之前的 Claude Opus 5.5 评测 测试包。.
| 模型 | 时间/路线使用情况 | 简短结果标签 |
|---|---|---|
| Claude Sonnet 5.5简体中文(大陆) | 2.947秒 89 个输入 / 163 个输出 0 条思考 HTTP 200 · end_turn | 正确结果:67;最终答案单独一行。. |
| Claude Opus 5.5(简体中文(大陆)) | 3.830秒 89 个输入 / 257 个输出 74 思考 HTTP 200 · end_turn | 正确结果:67;最终答案单独一行。. |
观察到的比较: 两者均计算出67,并将最终答案单独列在一行。Sonnet 5.5生成了163个输出令牌,而Opus 5.5生成了257个,但在该提示下未观察到两者的正确性存在差异。.
边界: 仅凭一个算术数列无法评估广泛推理的可靠性。.
该路线能否保持要求的两段式结构?
任务设置: 该提示词的具体内容是从之前的 Claude Opus 5.5 评测 测试包。.
| 模型 | 时间/路线使用情况 | 简短结果标签 |
|---|---|---|
| Claude Sonnet 5.5简体中文(大陆) | 11.683秒 128个输入 / 1224个输出 987 思考 HTTP 200 · end_turn | 两段中文;不加额外格式。. |
| Claude Opus 5.5(简体中文(大陆)) | 15.401秒 128个输入 / 1283个输出 949 思考 HTTP 200 · end_turn | 已涵盖要点;添加了 Markdown 格式和一条英文注释。. |
观察到的比较: Sonnet 5.5 返回了所要求的两段中文内容,未添加额外标记。Opus 5.5 也涵盖了所要求的要点,但添加了 Markdown 标记和一条英文注释。此记录反映的是单次处理流程中的格式情况,而非整体中文质量。.
边界: 该提示要求撰写关于《Opus 5.5》的开篇内容,因此文本本身并非中立语言基准。.
API 和迁移注意事项
Sonnet 5.5 默认启用自适应推理;若设置 thinking: disabled,将返回 400 错误,且 max_tokens 包含推理和响应文本的总字数。强制设置 tool_choice 为 any/tool 将被拒绝。请按类型解析内容块,并在切换前重新设定令牌预算基准。.
证据支持什么
任务层面的裁决
Sonnet 5.5: 该航线的测算成本和时间均有所降低,且在中国任务中严格遵守了格式规范。.
作品第5.5号: 在这里价格更高、范围更广;在几项开放式任务中,官方基准测试结果仍保持领先。.
利用任务层面的证据来选择一个切入点,然后验证对你而言真正重要的工作量。.
有关相关背景,请参阅 Claude 系列对比, 《Opus 5》评测, 和 Fable 5.1 评测.
常见问题
在匹配测试中,哪款机型速度更快?
在五次连续请求中,Sonnet 5.5 的本地总延迟更低:31.930 秒,而 Opus 5.5 为 47.725 秒。这包括了此处使用的路由和网络路径,因此并非服务商端的延迟。.
哪个模型生成的输出令牌更少?
Sonnet 5.5 在五项任务中共使用了 2,686 个路线报告的输出令牌,而 Opus 5.5 则使用了 3,952 个。仅凭令牌数量无法证明答案的质量。.
在这次测试中,哪款车型的价格更低?
根据官方标准 API 费率以及返回的输入/输出计数,这五个 Sonnet 5.5 请求的估算费用为 $0.02826,而 Opus 5.5 的估算费用为 $0.08184。 该计算未包含缓存费用、平台抵扣、税费及加价。.
Sonnet 5.5 在所有基准测试中都比 Opus 5.5 表现更好吗?
Anthropic 的专属表格根据基准测试和测试设置有所不同: Sonnet 5.5 在 Terminal-Bench 4.0 上的得分更高,而 Opus 5.5 则在 FrontierCode、CursorBench、GDPval-AA、Humanity’s Last Exam、OSWorld 和 Chartography 上的得分更高。这些是供应商报告的结果,并非独立重测所得。.
Sonnet 5.5 是否是直接可替换的 API?
不。迁移指南指出,默认情况下“thinking”功能处于运行状态;若将“thinking”设为“disabled”,将返回400错误;强制工具选择“any/tool”会被拒绝;客户端应按类型解析内容块。切换前,请重新设定令牌配额和工具循环的基准值。.
这是一项长上下文基准测试吗?
不。提取提示中包含一段短文。它检查事实依据和格式是否准确;并不衡量在记录的100万令牌上下文窗口附近的行为。.



