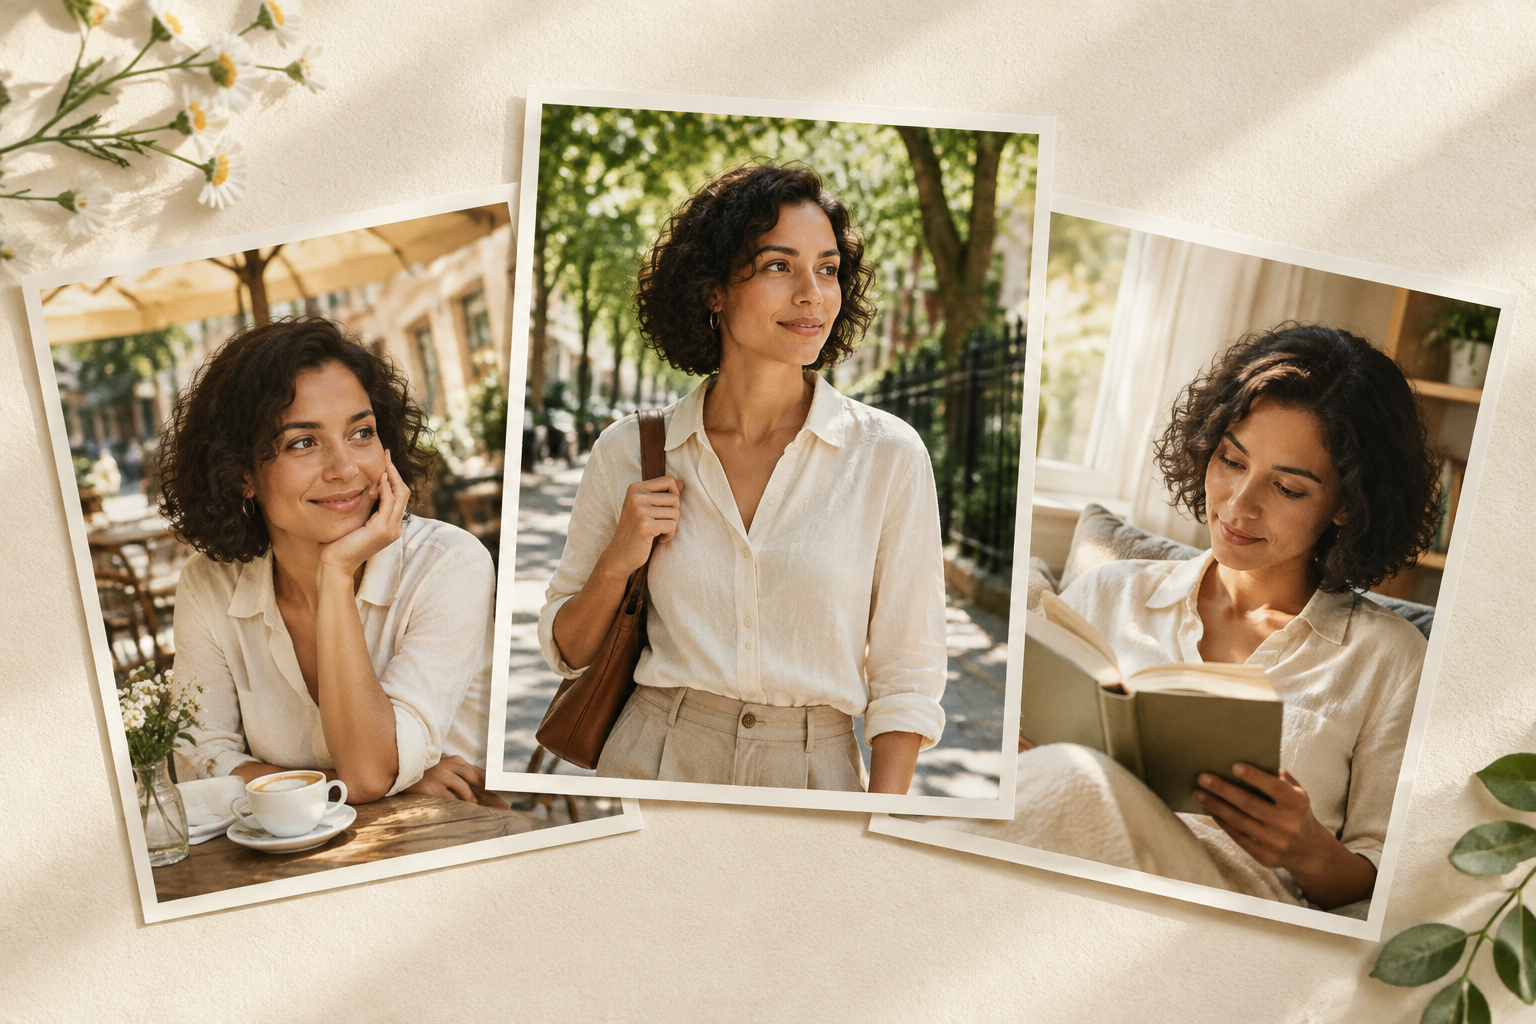
AI随拍风格的摄影作品之所以成功,在于这些照片让人感觉像是某个人生活中的片段,而不是六张毫无关联的肖像照。要达到这种效果,最可靠的方法是先确定一个简要的形象定位,然后每次只改变一个主要变量:拍摄地点、姿势、服装或构图。.
GlobalGPT 对于此工作流非常有用,因为其图像工作区允许您以参考图像为起点,并随着任务的变化在不同的图像模型之间切换。您可以 使用 Nano Banana 2 创作一组照片系列, 然后在审查每帧画面时,请保持相同的提示和参考内容。.
一场AI照片大放送拍摄需要什么
“照片合集”是一组经过精心搭配的社交媒体图片。它可以包含一张精心修饰的人像照、一张看似抓拍的场景照、一张特写照片,以及一张更宽广的环境全景照。这组照片没有固定的张数要求,但需要有一个可识别的主题、刻意营造的变化,以及连贯的视觉节奏。.
有用的定义
AI照片集是指通过同一主题的多张图片讲述的一个小故事,这些图片既要有足够的变化,让人感觉生活化,又要保持足够的连贯性,让人感觉是经过精心设计的。.
根据以下四个基准对每个生成的集合进行审查:
- 身份: 脸型、发型、肤色、眼色、身材比例,以及一两处小痣。.
- 衣橱: 对于身份锚点,哪些要素是固定的,哪些又是被有意允许发生变化的。.
- 场景与灯光: 每帧画面中,光线的来源、时间以及方向都应一目了然。.
- 社会框架: 裁剪后的图片应呈现出可供发布的状态,并为计划使用的平台预留足够的留白空间。.
为什么同一个人会出现在多张AI生成的照片中
图像模型能够同时解决多个视觉问题。当提示词同时改变人物、服装、场景、姿势、拍摄角度和光照时,模型更有可能用一个身份特征来替换另一个。一套新衣服会改变轮廓;侧脸会改变鼻梁和下巴的视觉效果;镜子前特写镜头则可能让脸上的细小瑕疵消失。.
这并不意味着每张照片都要一模一样。这意味着你应该将变量分开处理。首先制作一张可靠的基准照片。然后在保持人物和服装不变的情况下,改变场景;接着在保持人物特征不变的情况下,更换服装;最后尝试近距离裁剪或镜像效果,因为这样更容易发现细微的瑕疵。.
谷歌的图像生成指南遵循同样的实用逻辑:明确必须保持一致的内容,使用参考图片,并在重要细节出现偏差时进行迭代。如需了解更深入的参考照片工作流程,请参阅本指南: 在不同场景中保持角色的统一性.
在生成之前,先构建一个小型参考包
测试该工作流程时,无需准备庞大的训练数据集。不妨从一个形象鲜明的虚构成年角色开始,并选用一张未经过重度滤镜处理的参考图片,该图片应清晰展现面部、头发、皮肤以及上半身的比例。只有在获得授权且有明确使用理由的情况下,才可使用真实人物的肖像。.
- 建立一个身份锚点。. 请确保光线均匀、背景简洁、表情自然,并裁剪出能清晰展现面部和头发的画面。.
- 将该恒等式包写下来。. 请用通俗易懂的语言描述其头发颜色、肤色、眼睛颜色、显著特征、耳环以及身体比例。.
- 选择第一个受控变更。. 与同时出现的新场景、新装扮、新年龄段和新发型相比,新咖啡馆风潮更容易辨识。.
- 搭建场景前请先检查。. 如果第一个效果改变了面部表情或设计出了会分散注意力的配饰,请在拍摄更多镜头之前先修正这一变量。.
在 GlobalGPT 中,参考图像路径是将该软件包从一个图像传输到下一个图像的实用途径。如果工作涉及大量竖版图像,本配套指南可为您提供帮助 编写更好的AI人像摄影提示词 用于光线、构图和面部细节。.
使用“什么保留、什么改变”这一提示
可复制的提示模式
首先列出标识锚点。接着说明单一变更。最后说明摄像机和画质限制。.
显示完整图案
请根据所附的一张参考图片,为同一位虚构成年女性创作一张逼真的方形社交媒体照片。需保留她的面部特征、及肩深棕色波波头、暖橄榄色肌肤、棕色眼睛、左眼下方的美人痣、身体比例、银色圆环耳环以及[固定服装]。仅更改[一个主要变量]。 场景:[地点]、[姿势]、[光线]、[构图]。皮肤质感自然,构图需便于裁剪,无文字,无标志。.“仅更改”这一短语虽非魔法,却能让验收测试更加清晰。你可以看到模型是否确实只更改了场景,而不是悄悄地连人物也一并改了。.
首次输出测试的结果显示
我使用了一个合成成人角色,并向 GPT Image 2.5 和 Nano Banana 2 in GlobalGPT 提供了相同的三个提示词。 每个模型都收到了相同的参考图像,并针对三项任务各生成了一次初始输出:穿着固定服装的雨中咖啡馆场景、更换服装后的“黄金时刻”屋顶场景,以及酒店浴室镜子特写场景。未采用“最佳N张”筛选或稳定性重复生成。.
测试设置
- 参考: 一张1024×1024像素的虚构成年女性合成肖像。.
- 型号 GPT Image 2.5 和 Nano Banana 2.
- 任务: 咖啡馆、屋顶换装,以及在浴室镜子前自拍。.
- 规则: 保留第一个有效的输出结果;遇到缺陷时记录下来,而不是为了获得更完美的帧而重新渲染。.
任务1:固定装扮,雨中的咖啡馆
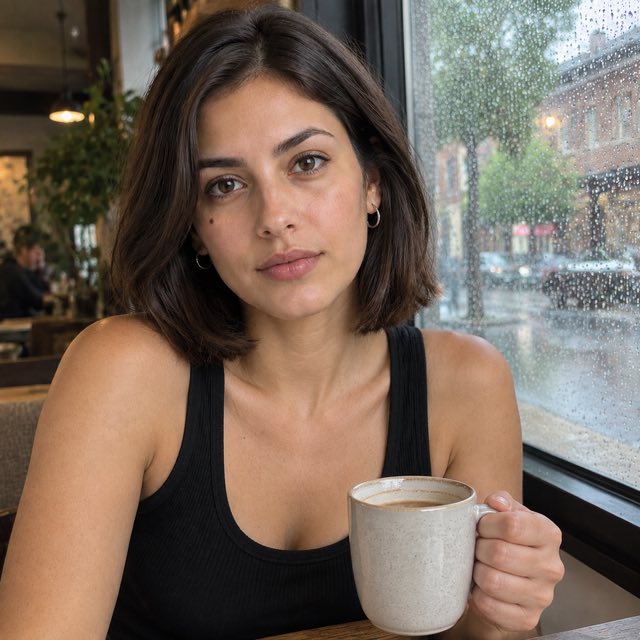
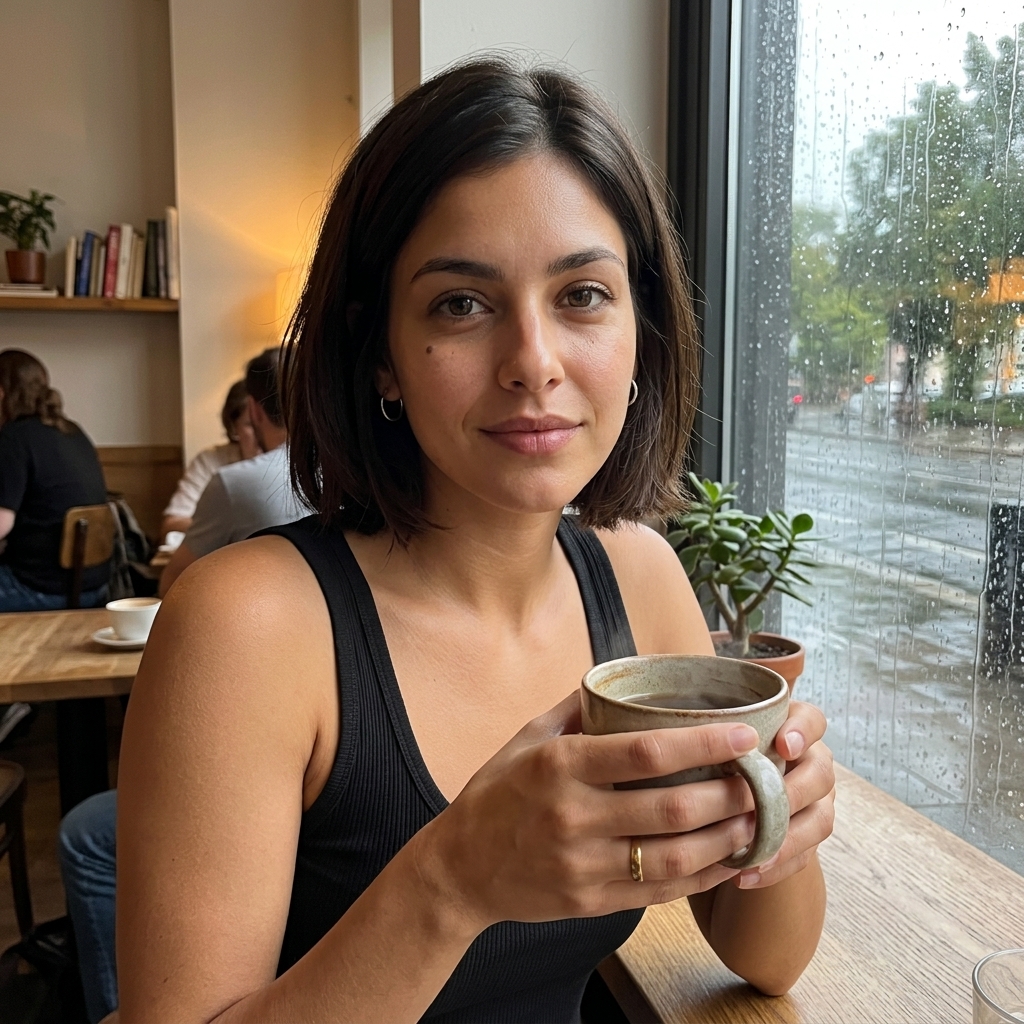
在咖啡馆任务中,要求两个模型都保留那件黑色罗纹背心,仅更改场景和姿势。两个生成的图像都保留了面部特征、波波头、暖橄榄色肤色以及美人痣。 GPT Image 2.5 采用了更紧凑的抓拍构图,人物单手环抱着咖啡杯。Nano Banana 2 营造出了一幅逼真的咖啡馆场景,窗户上布满雨滴,但人物却用双手捧着咖啡杯。.
实际结论
这两款模型都拍出了可用的第一帧。如果具体姿势很重要,在将图片添加到轮播图之前,请检查双手及与物体的接触情况。一条简单的“单手”指令,可能会变成双手的构图。.
查看确切的提示
请根据所附的参考图片,为同一位虚构的成年女性创作一张逼真的方形社交媒体照片。需保留她的面部特征、及肩深棕色波波头、暖橄榄色肤色、棕色眼睛、左眼下方的美人痣、身体比例、银色圆环耳环以及黑色罗纹背心。 仅需更改场景和姿势:雨中的社区咖啡馆窗边,坐姿三四分之三视角,一只手环抱着陶瓷马克杯,采用智能手机抓拍的自然构图,柔和的阴天窗边光线,呈现自然的肌肤质感,无文字,无标志。.任务2:换装,黄金时段的屋顶
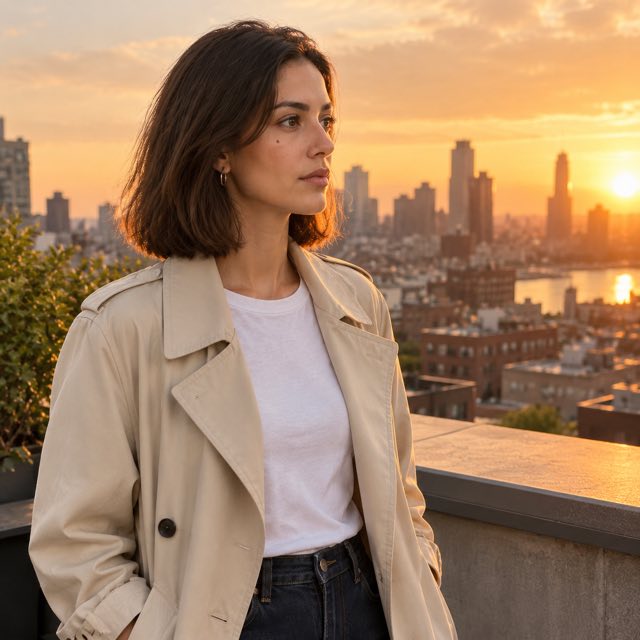
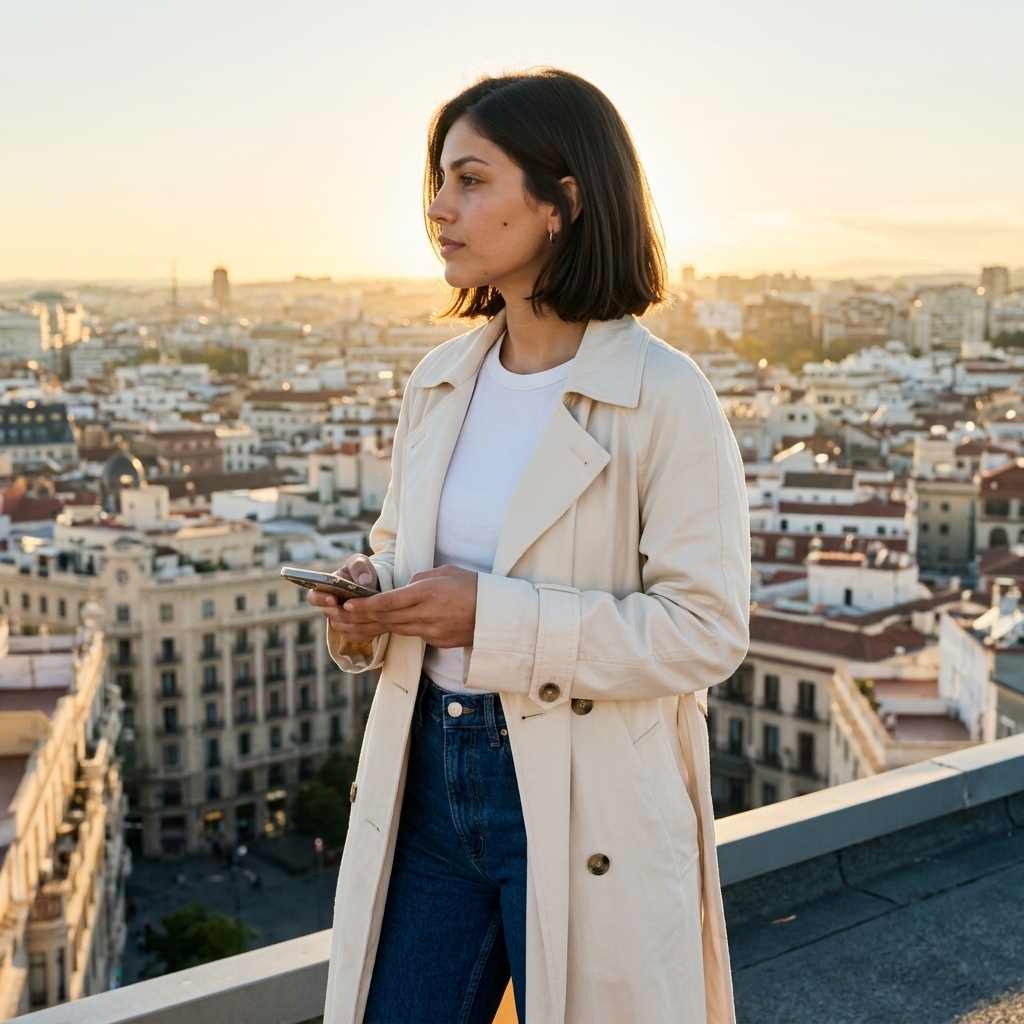
屋顶场景的拍摄中,服装换成了米色风衣、白色T恤和深色直筒牛仔裤,但人物和发型保持不变。两张图片都保留了那颗美人痣和整体形象特征。 两张成果图中,屋顶、城市、侧脸轮廓以及温暖的逆光效果均清晰可见。Nano Banana 2 版本在拍摄对象手中添加了一部手机;虽然这并未破坏画面,但这也提醒我们,即使未被要求,额外道具仍可能出现在画面中。.
实际结论
当身份特征组合重复出现时,更换服装的情况是可行的。应综合核对面部轮廓、发际线和面部细微特征;仅凭一项相符的特征不足以证明是同一人。.
查看确切的提示
根据所附的参考图片,为同一位虚构成年女性创作一张写实的方形社交媒体照片。需保留她的面部特征、及肩深棕色波波头、温暖的橄榄色肌肤、棕色眼睛、左眼下方的美人痣以及身体比例。 将服装改为米色风衣,内搭白色T恤,下身穿深色直筒牛仔裤;请勿更改她的身份或发型。场景:黄昏时分的天台,人物侧身站立并望向城市,风格为时尚杂志风格但自然的手机拍摄效果,暖色调逆光,构图需留有裁剪余地,无文字,无标志。.任务 3:特写镜头,酒店浴室镜子
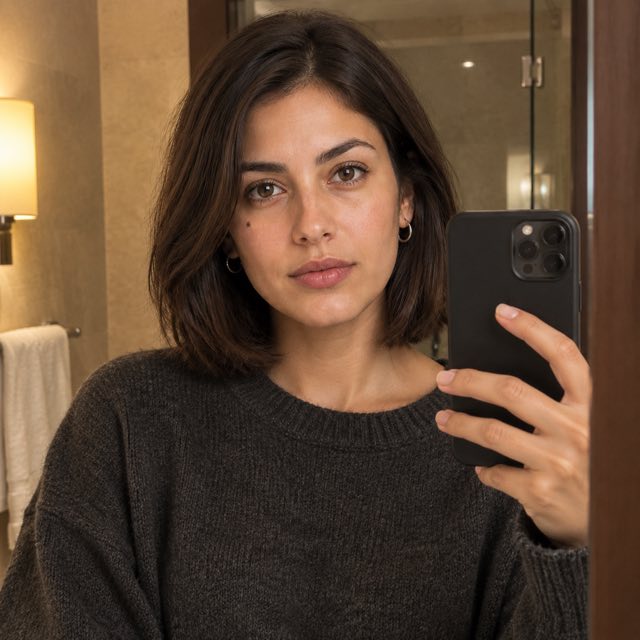
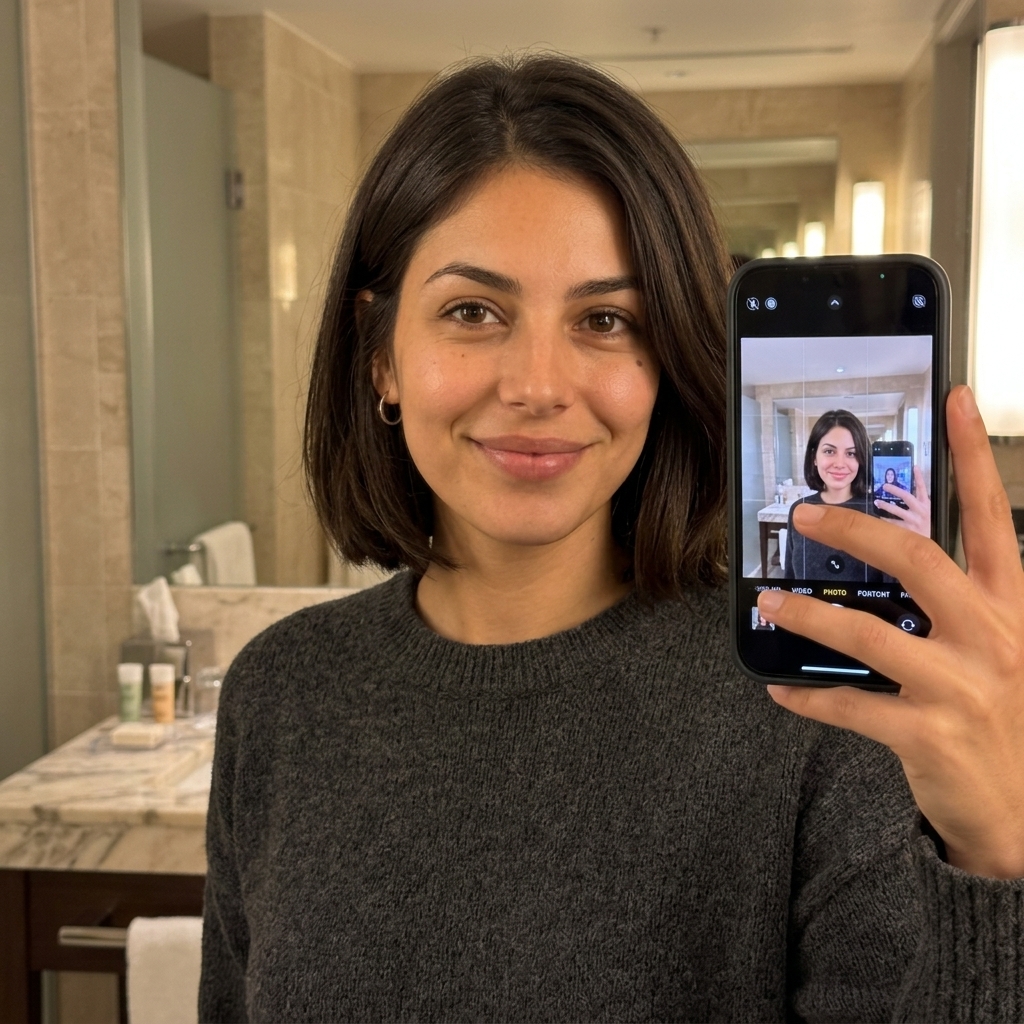
浴室任务的社交场景设置更为困难,因为镜子和手机引入了第二个视觉系统。GPT Image 2.5 生成了张清晰的半身自拍,手机部分遮挡了右侧。Nano Banana 2 保留了人物身份和毛衣,但让手机更显突出,并在屏幕上展示了一张递归自拍。 该输出结果仍可被识别为浴室自拍照,但镜中倒影和屏幕内容在发布前仍需人工仔细核查。.
实际结论
在特写镜头中,你应该最为严格。请放大观察手部、手机边缘、镜面边界以及任何类似文字的细节。只有当瑕疵不会分散观众对你希望通过轮播图讲述的故事的注意力时,才保留该镜头。.
查看确切的提示
请根据所附的参考图片,为同一位虚构成年女性创作一张逼真的方形社交媒体照片。请保留她的面部特征、及肩深棕色波波头、暖橄榄色肌肤、棕色眼睛、左眼下方的美人痣以及身体比例。服装:炭灰色针织毛衣。 场景:温馨的酒店浴室镜前,一张轻松的半身自拍照,手机部分可见,柔和的钨丝灯光,构图略有不完美,镜中倒影逼真,皮肤质感自然,无文字,无标志。.从这一比较中能得到什么启示
前六个输出结果支持得出工作流程结论,而非永久性的模型排名。两个模型在咖啡馆、屋顶和浴室这三个场景中都保留了核心身份锚点。 差异体现在细微的限制条件上:Nano Banana 2 在咖啡馆场景中使用了双手,并在浴室场景中突出了手机;GPT Image 2.5 在咖啡馆和镜子任务中,对要求的构图呈现了略为更精准的匹配。.
| 决策维度 | 这次跑步说明了什么 | 需要自行检查的内容 |
|---|---|---|
| 身份 | 这两条路线在三个场景中都保留了面部特征、鲍勃头、肤色和美人痣。. | 请对比整组照片中的面部和发际线,而不是一张一张地看。. |
| 衣橱 | 这两套造型都采用了固定的紧身背心和米色壕沟风衣的换装方案。. | 寻找额外的配饰和出人意料的道具。. |
| 姿势与物体 | 简单的说明也可能出现偏差:Nano Banana 2 用双手捧着马克杯。. | 检查双手、接触物体的情况以及可见手指的数量。. |
| 特写镜头 | 两人的浴室自拍都还算能看;相比之下,Nano的手机和递归屏幕反而更让人分心。. | 以全尺寸查看后视镜、手机、倒影以及类似文字的伪影。. |
整理最终的轮播图
排版只是工作的一半。一个好的轮播图应具有视觉节奏感,因此应避免将三张几乎一模一样的头像并排放置。.
- 以最鲜明的身份锚点或最强大的环境框架开篇。.
- 接着拍摄一个中景镜头,画面中的场景或服装发生变化。.
- 在确认解剖结构后,添加一个自然随意的物体或手部动作,例如那个马克杯。.
- 使用特写镜头来营造亲密感,但如果手机、镜子或构图显得分散注意力,请将其移除。.
- 在导出最终数据集之前,请在平台端对序列进行审核。.
最终的数量应保持灵活性。一套数量较少但内容连贯的画面,比一套固定数量却充斥着平庸变体的画面更具说服力。.
GlobalGPT 的适用场景
GlobalGPT 作为多模型图像工作区,非常适合这一工作流程。在测试场景、换装或特写镜头等图像方案时,您可以将参考包和身份包放在一起。当您希望比较实际输出效果,而无需为每次实验在不同的图像工具之间来回切换时,这一功能非常有用。.

公开的 Nano Banana 2 页面是开展基于参考图像工作的天然起点。选择与任务相匹配的模型,在提示词中明确说明哪些内容需要保留、哪些需要更改,并在确定轮播图之前先对整组图像进行评估。.
使用 Nano Banana 2 尝试“参考优先”的照片处理工作流程.
常见问题
什么是AI图片合集?
AI图片合集是指一组经过协调生成的社交媒体图片,这些图片展示了同一主题在不同时刻、地点、构图或着装下的样子。.
如何在AI生成的照片中保持人物面部特征一致?
首先选择一张清晰的参考图片,在每个提示中重复使用相同的身份锚点,并每次只更改一个主要变量。对整套生成的图像进行检查,重点关注面部、发际线、肤色以及显著特征。.
在保持人物可辨识性的前提下,服装可以改变吗?
是的。请将新服装与角色特征包分开处理,并保持发型、面部、肤色和身体比例不变。然后检查结果中是否出现了额外的配饰或轮廓变化。.
一个轮播图应该生成多少张图片?
并没有一个放之四海皆准的标准。先拍摄足够多的照片,形成广角、中景、抓拍和特写镜头交替的节奏,然后只保留那些连贯且可用的画面。.
如果第一张图片效果不佳,我应该重抽吗?
首先找出出现问题的变量。如果图像本身有效,但存在手部表现欠佳、裁剪不当或反光等问题,请将其视为对提示词和工作流程的反馈。不要因为认为每次重掷都会更好,就试图掩盖这些缺陷。.