"(《世界人权宣言》) OpenAI 语音 API 通过……将文本转换为语音 POST https://api.openai.com/v1/audio/speech. 发送一个模型、您的输入文本和一段语音;将响应保存为 MP3 或其他支持的音频格式。对于需要有关语气和表达方式指导的新集成,请从以下内容开始: gpt-4o-mini-tts.
工作请求仅仅是第一步。您还需要选择合适的计费单位、可播放的输出文件,以及针对长篇脚本的规划。OpenAI的新版TTS模型采用文本和音频令牌进行计费;其旧版TTS模型则按字符计费。在估算一个月配音工作量时,这一差异至关重要。.
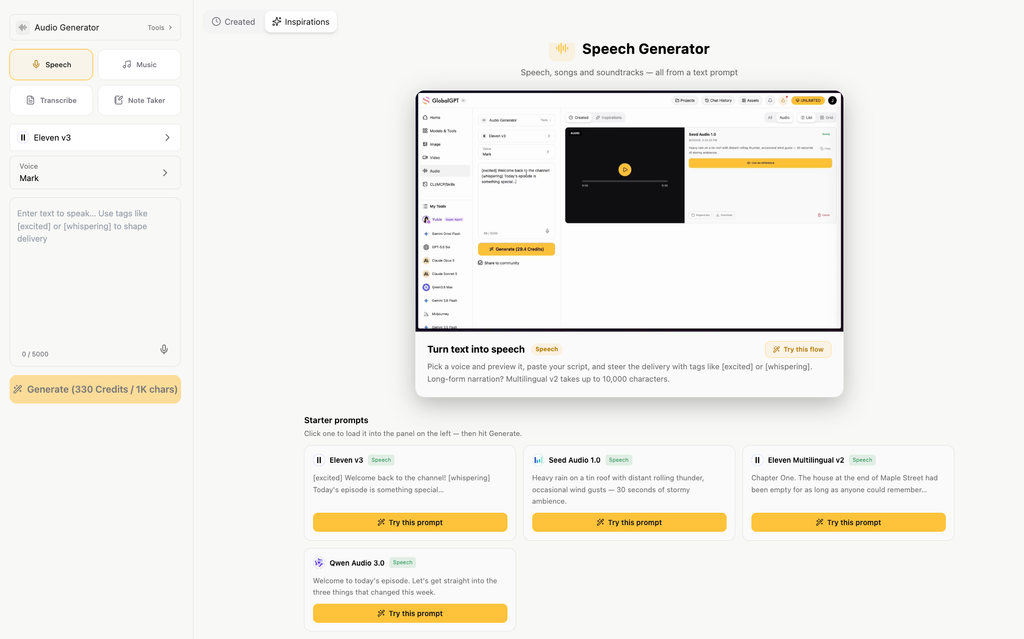
如果你的工作还包括撰写脚本、制作视觉效果以及剪辑视频,, GlobalGPT 的音频工作区 将语音生成功能融入了一个价格实惠的多模型订阅平台。您可以在一个控制面板中处理文本、语音、图像和视频,然后利用其 API 和 CLI 进行可重复的生产工作。其公开的 TTS API 采用独立的任务工作流,具体内容将在下文介绍。.
OpenAI 音频语音 API 有什么作用?
Speech API 是一个文本转语音端点:您的应用程序提供书面文字,并接收生成的语音。典型用途包括产品演示、无障碍旁白、学习资料以及简短的配音。您可以在语音播放前对文本进行控制,这在需要按照已批准的脚本进行表述时非常有用。.
在转录过程中,流程是相反的:先输入录音,再输出文本。实时语音助手则增加了另一项要求——通过对话进行倾听和回应。OpenAI的 音频记录 将这些工作流分开。当您已经拥有要朗读的文本时,请选择“语音”端点。.
语音生成功能支持流式传输,因此应用程序可以分块接收音频。将该音频流保存到文件中并不会自动在浏览器中播放,也不会自动生成对话机器人;应用程序仍需负责处理播放及任何对话逻辑。OpenAI 还要求向收听者明确说明该语音是由人工智能生成的。.
使用 OpenAI 语音 API 生成您的第一个音频文件
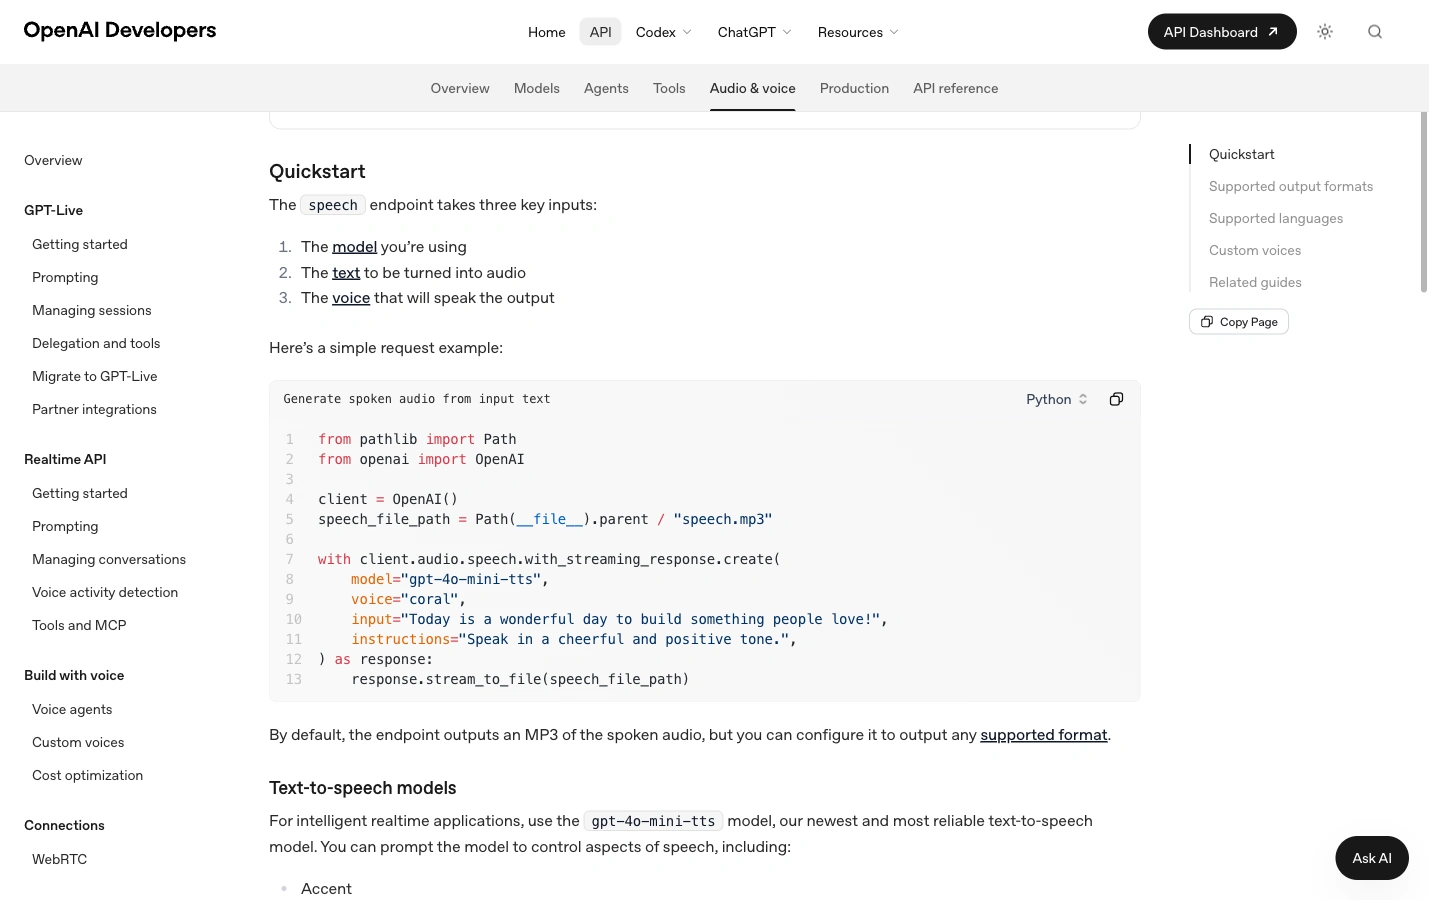
在服务器或您的开发机上运行该请求,并将 OpenAI API 密钥存储在 OPENAI_API_KEY 环境变量。请勿在浏览器 JavaScript 中使用该键。以下示例使用相同的简短产品导览脚本,并将结果保存为 openai-product-tour.mp3.
选项 1:发出一个 curl 请求
OpenAI 语音 API · curl
#!/bin/sh
# 请先在服务器环境中设置 OPENAI_API_KEY。
curl --fail-with-body --show-error \
  https://api.openai.com/v1/audio/speech \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-4o-mini-tts",
    "input": "欢迎参加 Acorn Studio 产品导览。只需三个步骤,您就可以将一段简短的脚本转换为语音导览。首先,编写内容。其次,选择语音。最后,保存音频文件并在手机上测试播放。",
    "voice": "coral",
    "instructions": "请用温暖、自然的语气清晰地说话。",
    "response_format": "mp3"
  }' \
  --output openai-product-tour.mp3
该响应包含音频字节,因此应将其保存到文件中,而不是尝试将其解析为 JSON。该 --fail-with-body 该选项会在发生 HTTP 错误时使 curl 返回失败的退出状态。在打开文件之前请检查该状态:即使收到错误响应,名为 .mp3.
选项 2:使用 Python SDK
使用以下命令安装 OpenAI 软件包: python -m pip install openai. SDK 会从环境中读取 API 密钥。此示例会在响应到达时立即将其写入,从而避免将整个音频响应加载到您自己的 Python 缓冲区中。.
OpenAI 语音 API · Python
"""安装:python -m pip install openai。在服务器上设置 OPENAI_API_KEY。"""
from pathlib import Path
from openai import OpenAI

client = OpenAI(max_retries=0)
script = (
    "欢迎参加 Acorn Studio 产品导览。只需三个步骤,您就可以将 "
    "一段简短的脚本转化为语音导览。首先,编写语音内容。接下来, "
    "选择一种声音。最后,保存音频文件并在手机上测试播放效果。"
)

with client.audio.speech.with_streaming_response.create(
    model="gpt-4o-mini-tts",
    voice="coral",
    input=script,
    instructions="请用温暖、对话式的语调清晰地朗读。",
    response_format="mp3",
) as response:
    response.stream_to_file(Path("openai-product-tour.mp3"))

print("已保存 openai-product-tour.mp3")
这三个必填字段是 模型, 输入, 和 语音. 这里,, 说明 要求采用温暖、对话式的表达方式;它引导语音,而非在口语脚本中添加词语。此字段与 GPT-4o Mini TTS 兼容,但不被 tts-1 和 tts-1-hd.
对于较长的文档,请按句子或段落分界处分割文本,对各部分进行编号,并将每个输出文件以该编号保存。各部分应保持一致的语气和指令。保留足够的上下文以确保表述自然,并在分发拼接后的录音前,仔细聆听各部分的衔接处。.
选择模型、语音和输出格式
| 模型 | 如何选择 | 配送说明 |
|---|---|---|
gpt-4o-mini-tts | 可控叙述与口语表达的起点。. | 支持 说明 在语气、风格和节奏方面。. |
tts-1 | OpenAI 使该模型能够实现低延迟的语音生成。. | 使用其支持的语音和速度控制功能;省略 说明. |
tts-1-hd | OpenAI 使该模型在语音质量方面优于 TTS-1。. | 使用其支持的语音和速度控制功能;省略 说明. |
"(《世界人权宣言》) GPT-4o 迷你 TTS 型号页面 将模型别名映射到 gpt-4o-mini-tts-2025-12-15 快照。如果可重现性对您的应用程序至关重要,请有针对性地选择一个有文档记录的快照,并将其与保存的脚本一同记录下来。.
内置音色和输入限制
Speech API 参考文档列出了 GPT-4o Mini TTS 的 13 种内置语音: 合金、灰烬、民谣、珊瑚、回声、寓言、玛瑙、新星、智者、微光、诗句、海洋和雪松. OpenAI 建议 马林 或 雪松 以获得最佳效果。这是 OpenAI 的建议:通过聆听自己念出的名字、数字和句子结构,来选择适合的发音方式。.
早期版本的 TTS 模型支持的语音集较小,包括:alloy、ash、coral、echo、fable、onyx、nova、sage 和 shimmer。请不要认为每种语音都适用于所有模型。该 语音 API 参考文档 也支持在以下范围内的速度: 0.25 和 4.0, 与 1.0 作为默认值。.
有两个输入限值需要注意:端点参考限值 输入 至 4,096个字符, ,而 Mini TTS 型号页面规定最大值为 2,000 个输入令牌. 字符和令牌是两种不同的计量单位。请同时检查 Mini TTS 的这两项限制,尤其是在处理多语言文本时,并在提交前将过长的脚本拆分成若干部分。.
选择目标文件的文件格式
| 格式 | 实际应用 |
|---|---|
| MP3 | 默认输出;一个便于分享和网络播放的压缩文件。. |
| 作品 | 适用于支持该编解码器的流媒体和通信应用程序。. |
| AAC | 请考虑在哪些情况下,您的播放环境或媒体工作流程需要使用 AAC。. |
| FLAC | 适用于需要保留音频信号的工作流的无损压缩。. |
| WAV | 采用常见容器格式的无损音频,便于编辑和处理。. |
| PCM | 24 kHz、16 位有符号小端字节序的原始样本,无文件头;您的播放器需要这些设置。. |
若需下载链接或使用简单的音频播放器,请选择 MP3 格式。若下一步需要进行编辑,请选择 WAV 格式。仅当您的应用程序能够解析原始 PCM 格式时,才应选择该格式;将文件名从 .pcm 至 .wav 不会生成 WAV 头。.
OpenAI 语音 API 的费用是多少?
根据2026年9月28日的查询结果,OpenAI将GPT-4o Mini TTS列为 每百万个文本输入令牌 $0.60 加号 每百万个音频输出令牌为 $12. TTS-1 的价格 每百万个字符 $15, ,而 TTS-1 HD 的价格为 每百万个字符 $30. 请用各自的单位计算每个模型。.
Speech API 定价:请将单位分开
OpenAI 对其较新的 TTS 模型按代币计费,而对其之前的两个 TTS 模型则按字符计费。GlobalGPT 则按积分列出其 TTS 任务。.
| 路线和车型 | 评分 | 示例 |
|---|---|---|
| OpenAI · GPT-4o 迷你TTS | $0.60 / 1M 文本输入令牌 $12 / 1M 音频输出令牌 | $0.0606,对应 1,000 个文本输入令牌 + 5,000 个音频输出令牌 |
| OpenAI · TTS-1 | $15 / 1M 个字符 | $0.015(每1,000个字符) |
| OpenAI · TTS-1 HD | $30 / 1M个字符 | $0.030(每1,000个字符) |
| GlobalGPT · Eleven v3、Eleven 多语言版 v2 或 Qwen Audio 3.0 TTS Flash | 330 学分 / 1,000 字符 | 按所列每1,000字符330学分计费;提交前请索取报价 |
这些只是定价示例,并非下方音频样本的实际收费。代币、字符、分钟和积分是不同的计量单位。GlobalGPT任务估算提供了相应的积分数量;该表格不会将积分转换为美元。.
汇率查询日期:2026年9月28日。来源: OpenAI API 定价 和 GlobalGPT API 文档.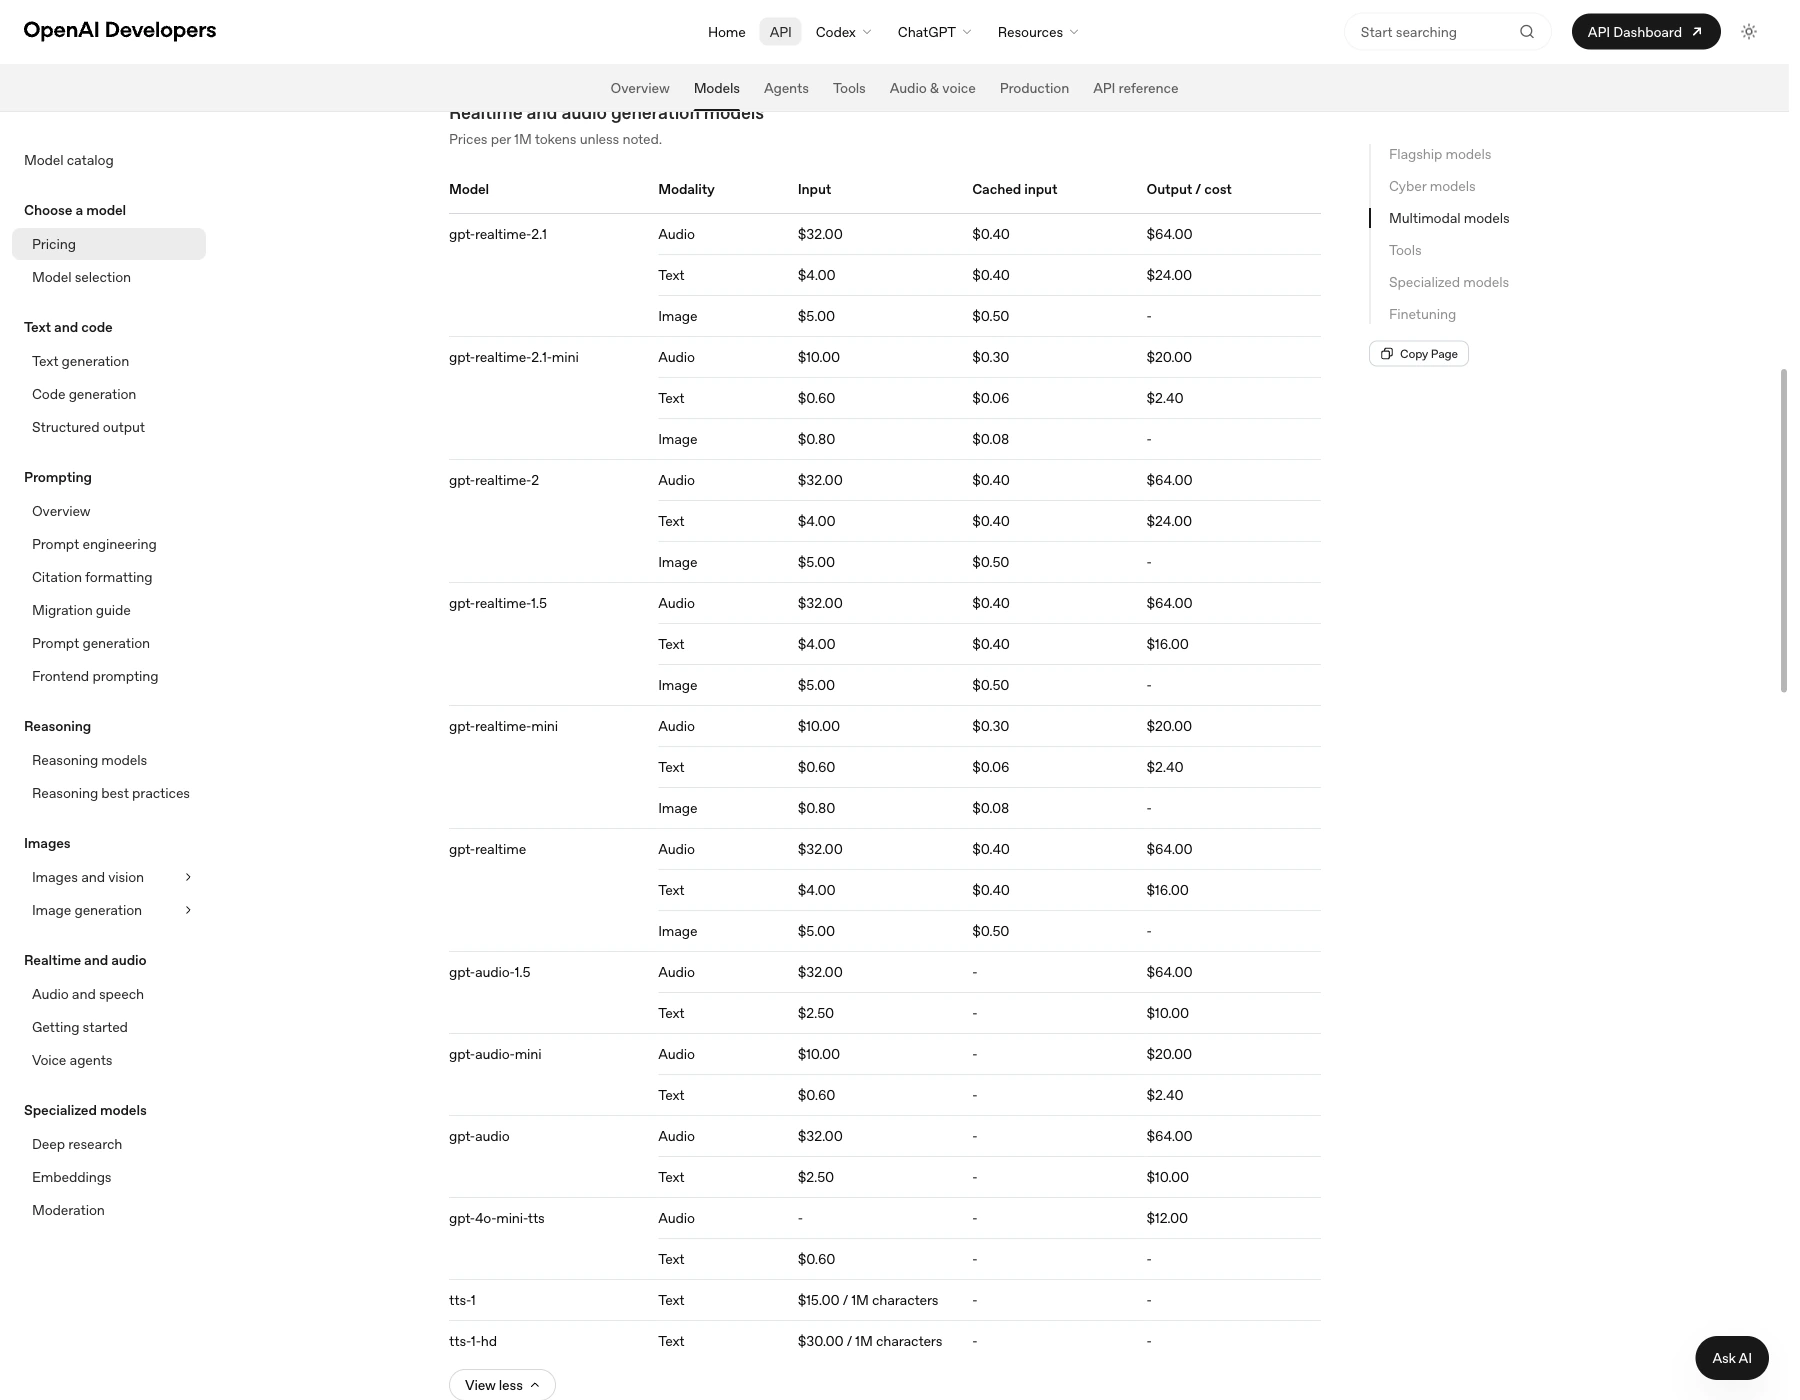
例如,100份脚本,每份1,000个字符,总计100,000个字符。按照所列费率计算,这相当于 $1.50 配 TTS-1 或 $3.00(配备 TTS-1 HD), ,在扣除其他应用成本之前。仅凭相同的字符数不足以精确计算 Mini TTS 的费用:您还需要文本输入和音频输出令牌的数量。.
估算您的语音生成成本
请输入您所选路线的计费单位。系统不会自动将字符转换为代币,也不会将分钟转换为代币。.
计算公式:字符数 × $15 ÷ 1,000,000。文本总数可能涉及多个 API 请求。.
2026年9月28日查询的费率: OpenAI · GlobalGPT. 不包括存储、托管、税费以及您申请中的其他部分。.
在进行规划时,请在计算器中输入实际使用次数或明确的假设值。在实际使用情况测得之前,请将“Mini TTS 音频代币”字段视为预算输入项。请勿将每分钟的近似数值视为每种语音、语速或语言的固定价格。.
GlobalGPT 模型目录以信用点为单位显示 TTS 价格,其估算结果会针对您打算发送的请求提供报价。请将 API 信用点的消耗与日常写作和媒体工作所需的多模型工作区订阅区分开来。这样可以更轻松地掌控预算,同时避免误以为这两项产品共享同一计费额度。.
使用 GlobalGPT API 构建 TTS 工作流
为了实现可重复的“剧本→配音→视频”工作流程,, 在 GlobalGPT 中创建语音 并将项目的其余部分保留在同一个工作区中。该 GlobalGPT API 揭示了媒体生成本质上是一系列任务,而 GlobalGPT CLI 可与您的终端和开发工具配合使用的连接。.
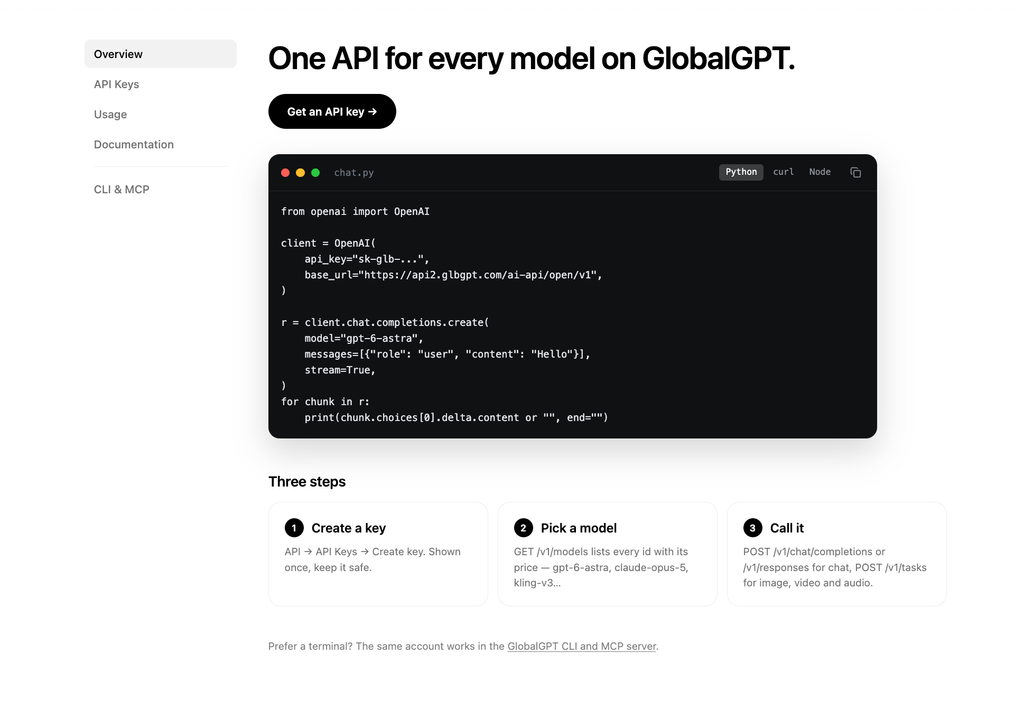
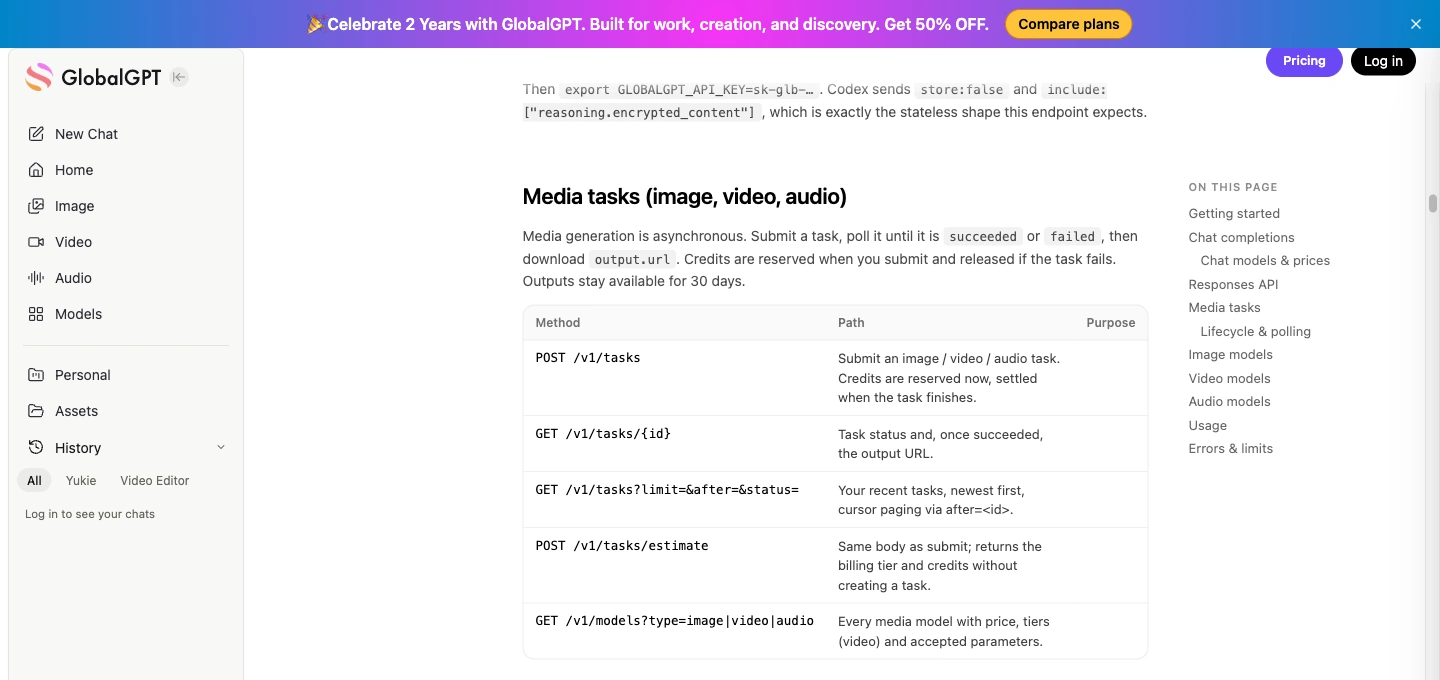
使用公共基础 URL https://api2.glbgpt.com/ai-api/open/v1. 将 TTS 请求发送至 POST /tasks, 查询 GET /tasks/{id}, ,并下载 output.url 任务成功后。该文本框是 推动. 直接实现此任务契约;它与 OpenAI 的即时音频响应不同。.
选择一个有文档记录的 GlobalGPT TTS 模型
| 型号 ID | 输入和输出 | 有用的区分 |
|---|---|---|
eleven-v3 | 最多 5,000 个字符;MP3 | 支持富媒体音频标签。. |
eleven-multilingual-v2 | 最多 10,000 个字符;MP3 | 29种语言;音频标签以文本形式显示。. |
qwen-audio-3.0-tts-flash | 最多 4,096 个字符;WAV | 49种语音;语音和语言控制使用Qwen专用的字段。. |
三项条目列表 每1,000个字符330积分. .使用 POST /tasks/estimate 附上相应报价的预期请求正文;文档中说明,此操作不会创建任务,也不会预留积分。访问公共 API 需消耗付费积分。.
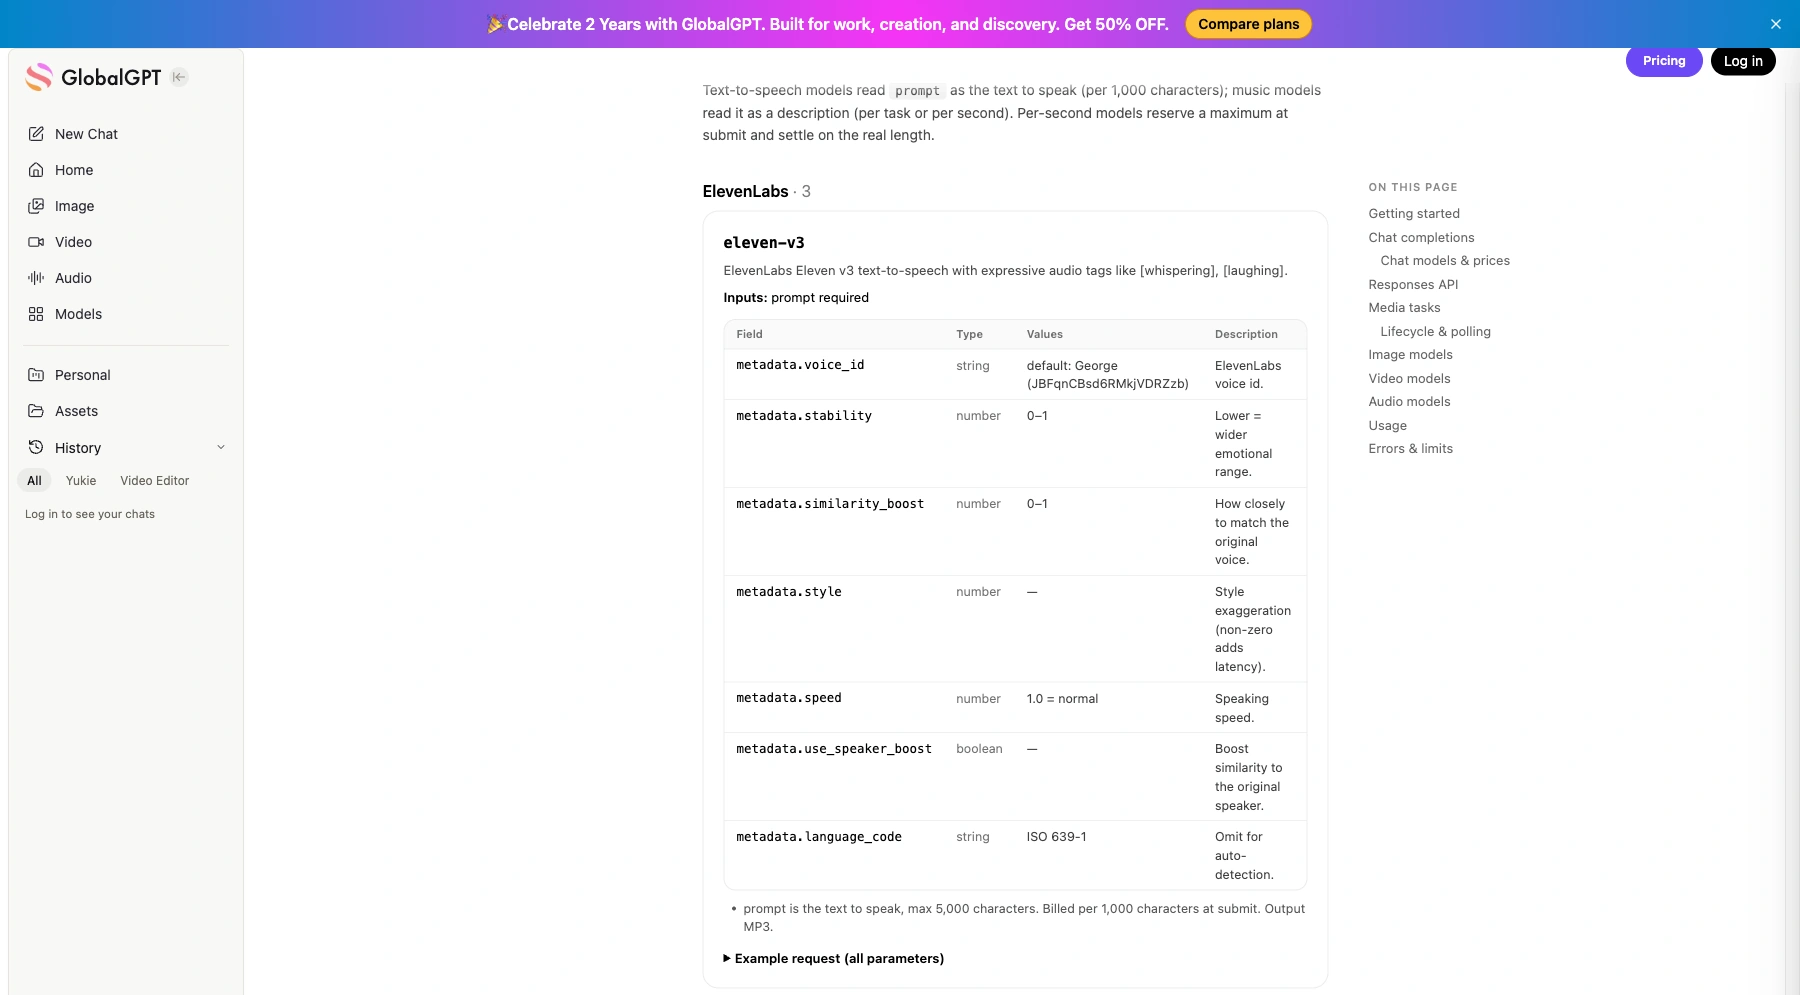
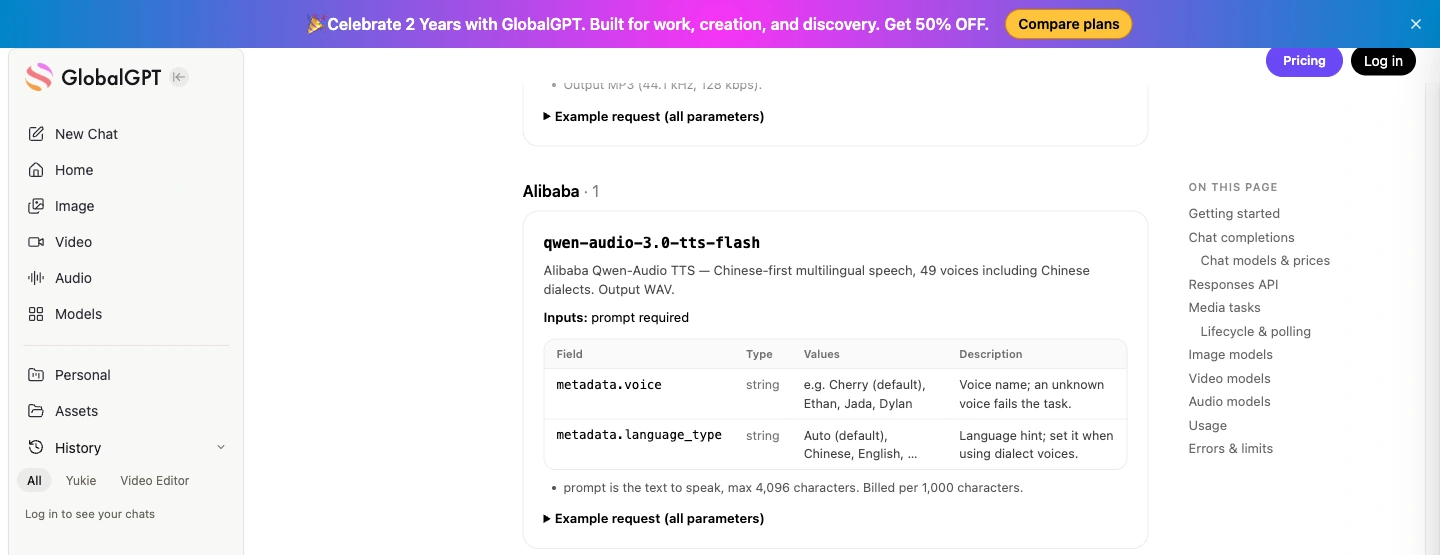
有关更全面的创建工作流程,请参阅 GlobalGPT 中的文本转语音工作流. 如果您正在研究名为 Qwen3-TTS 的开源产品系列,请阅读 Qwen3-TTS 型号和 API 选项; 请勿将上文提到的 Qwen-Audio 模型 ID 视为可互换的 Qwen3-TTS 部署。.
估算、提交一次,然后查询已保存的任务
安装 请求 与 python -m pip install requests 并设置 GLOBALGPT_API_KEY 在服务器上。下面的示例使用 Eleven v3,选择了一个已记录的公开语音 ID,并设置了一个示例性的上限为 500 个积分。在运行之前,请将该上限调整为符合您自身预算的数值。.
GlobalGPT 公共 TTS 任务 API · Python
"""安装 requests 模块;设置 GLOBALGPT_API_KEY。使用 GlobalGPT 的公共任务 API。"""
import json
import os
import time
import uuid
from pathlib import Path
import requests

BASE = "https://api2.glbgpt.com/ai-api/open/v1"
STATE = Path("globalgpt-tts-job.json")
OUTPUT = Path("globalgpt-product-tour.mp3")
MAX_CREDITS = 500  # 每项任务的信用额度上限;运行前请修改。

payload = {
    "model": "eleven-v3",
    "prompt": (
 "欢迎参加 Acorn Studio 产品导览。 只需三个步骤,您就能将"
"一段简短的脚本转化为语音指南。首先,编写内容。接下来,"
"选择一个声音。最后,保存音频文件并在手机上测试播放。"
    ),
    "metadata": {
 "voice_id": "JBFqnCBsd6RMkjVDRZzb",
 "stability": 0.5,
 "language_code": "en",
    },
}

api = requests.Session()
api.headers["Authorization"] = "Bearer " + os.environ["GLOBALGPT_API_KEY"]

if STATE.exists():
    job = json.loads(STATE.read_text())
    if job["payload"] != payload:
 raise RuntimeError("此任务属于不同的输入。请使用新的状态文件名。")
else:
    estimate = api.post(BASE + "/tasks/estimate", json=payload, timeout=30)
    estimate.raise_for_status()
    quote = estimate.json()
    print("预估积分:", quote["credits"])
    if quote["credits"] > MAX_CREDITS:
 raise RuntimeError("估算值超过了您的单个任务上限。")
    job = {"payload": payload, "idempotency_key": str(uuid.uuid4())}
    STATE.write_text(json.dumps(job, indent=2))

if "task_id" not in job:
    # 持久化键将传输重试与该特定请求绑定。
    submitted = api.post(
 BASE + "/tasks", json=payload,
 headers={"Idempotency-Key": job["idempotency_key"]}, timeout=60,
    )
    submitted.raise_for_status()
    task = submitted.json()
    job["task_id"] = task["id"]
    STATE.write_text(json.dumps(job, indent=2))
    if task.get("ignored_parameters"):
 print("被忽略的参数:", task["ignored_parameters"])

print("任务:", job["task_id"])
deadline = time.monotonic() + 600
while time.monotonic() < deadline:
    checked = api.get(BASE + "/tasks/" + str(job["task_id"]), timeout=30)
    checked.raise_for_status()
    task = checked.json()
    if task.get("ignored_parameters"):
    print("被忽略的参数:", task["ignored_parameters"])
    if task["status"] == "failed":
 raise RuntimeError("生成失败: " + json.dumps(task.get("error", {})))
    if task["status"] == "succeeded":
        # 使用新的请求:不要将 API 密钥发送给媒体主机。
 audio = requests.get(task["output"]["url"], timeout=60)
 audio.raise_for_status()
        OUTPUT.write_bytes(audio.content)
 print("已保存:", OUTPUT)
 break
    time.sleep(10)
else:
    raise TimeoutError("任务仍在处理中。请重新运行以查询已保存的任务 ID。")
作业文件会保存精确的请求、一个幂等性密钥以及任务 ID。如果连接中断,请重新运行同一作业,以便代码能够恢复现有任务的执行。若要刻意生成不同的音频,请使用新的作业文件名。如果作业文件的脚本包含机密信息,请将其设为私有。.
检查 被忽略的参数 因此,不受支持的设置不会在您不知情的情况下自动成为默认配置。ElevenLabs 控制项,例如 voice_id 与Qwen的不同之处在于 语音 和 language_type 字段。每5–10秒轮询一次,处理一个 失败 状态,并及时保存成功的文件:文档中记载的结果保留时间为 30 天.
收听两个产品演示示例
这两个由人工智能生成的示例均使用了相同的216个字符的产品导览脚本,分别通过Eleven v3和Qwen Audio 3.0 TTS Flash进行生成。 它们分别是单次请求生成的首个结果,且均采用默认语音设置。这些文件供您查看和试听,并非针对匹配语音的受控对比,也不是针对 OpenAI 语音的基准测试。.
Eleven v3:产品导览音频
eleven-v3 · 产品导览示例
- 输出
- MP3 · 单声道 · 44.1 kHz
- 长度
- 大约15.6秒
- 一代人
- 首次输出 · 1 个请求
设置: 以下为原文,采用默认语音及其他设置;未指定语音覆盖或朗读指令。未录制默认语音身份。.
状态和时间安排: 该代的生成成功了。任务的服务器时间戳显示,从提交到完成耗时13秒;这仅是一个请求,并非延迟基准测试。.
文件观察: 该 MP3 文件包含一个 44.1 kHz 的单声道音频流,大小约为 251 kB。可以读取该文件的帧数据直至文件结尾。.
费用参考: 公开目录的计费标准为每1,000个字符330个学分。针对新请求,请使用任务估算;此费率不适用于样本的开票。.
实际用途: 一个用于试听简短产品演示的紧凑型MP3文件。在正式发布中使用前,请在目标设备上检查完整文本内容并进行播放测试。.
阅读确切的输入 · 216 个字符
欢迎参加 Acorn Studio 产品导览。只需三个步骤,您就能将一段简短的脚本转化为语音导览。首先,撰写语音内容;其次,选择配音;最后,保存音频文件并在手机上测试播放效果。.
Qwen Audio 3.0 TTS Flash:产品导览音频
qwen-audio-3.0-tts-flash · 产品演示示例
- 输出
- WAV · 单声道 · 24 kHz
- 长度
- 15.52 秒的 PCM 数据
- 一代人
- 首次输出 · 1 个请求
设置: 以下为原文,采用默认语音及其他设置;未指定语音覆盖或朗读指令。未录制默认语音身份。.
状态和时间安排: 该代的生成成功了。任务的服务器时间戳显示,从提交到完成共耗时17秒;这仅是一次请求,并非延迟基准测试。.
文件观察: 该 WAV 文件包含 24 kHz 采样率的 16 位单声道 PCM 音频,大小约为 745 kB。其文件头声明的数据量大于文件实际包含的数据量;此处保留了原始输出内容。.
费用参考: 公开目录的计费标准为每1,000个字符330个学分。针对新请求,请使用任务估算;此费率不适用于样本的开票。.
实际用途: 用于评估旁白工作流的 WAV 样本。请在制作流程中解决片头长度不一致的问题,并在分发前检查完整播放效果。.
阅读确切的输入 · 216 个字符
欢迎参加 Acorn Studio 产品导览。只需三个步骤,您就能将一段简短的脚本转化为语音导览。首先,撰写语音内容;其次,选择配音;最后,保存音频文件并在手机上测试播放效果。.
在时长相近的情况下,Qwen 样本的大小约为 Eleven 样本的三倍,这反映了 WAV 和 MP3 格式之间的差异。其 WAV 头中声明的数据量也超过了文件实际包含的数据量。 这是一个值得在目标播放器中检查的文件封装问题;仅凭这一点并不能说明语音质量如何。.
解决常见的语音生成问题
| 症状 | 首先应检查什么 |
|---|---|
| 保存的 MP3 无法播放 | 检查 HTTP 状态和响应类型。API 错误可能已被保存为音频文件。. |
| 该请求拒绝了语音或指令 | 将语音和可选字段与所选模型进行匹配。较早版本的 OpenAI 语音合成模型不支持指令。. |
| 一篇篇幅较长的剧本被拒 | 检查路线的字符限制和 Mini TTS 令牌限制,然后在自然分界处进行拆分。. |
| 出现 401 或 429 响应 | 检查密钥/账户是否出现 401 错误。对于 429 错误,在重试前请区分速率限制与配额不足的情况。. |
| 一项 GlobalGPT 请求仍处于待处理状态 | 查询已保存的任务 ID 并检查状态;超时并不构成提交重复任务的理由。. |
| 该语音与所选设置不符 | 在断定该设置已生效之前,请先检查特定模型的元数据和 ignored_parameters。. |
| 音频时长或进度条显示不正常 | 将文件元数据与实际媒体有效载荷进行对比,并在目标播放器中测试整个文件。. |
对于 OpenAI 错误,请从其 错误代码指南. 对于 GlobalGPT 任务,请保存任务 ID 和返回的错误详细信息。在开发过程中,请将传输故障、计费故障和语音录音质量不佳的情况区分开来:每种情况都需要采取不同的解决措施。.
在提交旁白前,请在听众将使用的设备上试听完整的录音。检查开头、人名和数字、过渡部分以及最后一句。在播放开始前加入AI语音提示,并保留原始文本和模型设置的副本,以便能有针对性地重新生成编辑后的脚本。.
常见问题
什么是 OpenAI 语音 API 端点?
使用 POST 请求 https://api.openai.com/v1/audio/speech。必填字段包括 model、input 和 voice。响应内容为生成的音频;默认格式为 MP3。.
OpenAI 语音 API 是免费的吗?
Speech API 采用按使用量计费的模式。请根据当前的 API 费率制定预算,不要假设存在免费配额:GPT-4o Mini TTS 按文本输入和音频输出令牌计费,而 TTS-1 和 TTS-1 HD 则按字符计费。.
我可以控制语音和说话风格吗?
请选择您的模型支持的语音。GPT-4o Mini TTS 还支持语音风格指令,例如“温暖”或“平静”的语调。该指令字段不适用于 TTS-1 或 TTS-1 HD。.
Speech API 支持流式传输吗?
是的。它可以分段流式传输生成的音频。您的应用程序仍需处理播放事宜;仅靠流式传输文本转语音功能,并不能实现完整的实时语音对话。.
我能否通过修改 OpenAI 的基础 URL 来使用 GlobalGPT?
请使用 GlobalGPT 文档中记录的语音合成(TTS)媒体任务工作流:向 POST /tasks 提交请求,通过 GET /tasks/{id} 进行轮询,并在操作成功后下载 output.url。其文档中记录的 TTS 模型目录包含 ElevenLabs 和 Qwen 模型,这些模型各有独立的模型 ID 和参数。.
我应该从哪种音频格式开始呢?
若只需简单下载或使用网页播放器,建议从 MP3 开始。如果后续需要进行编辑,WAV 格式会比较实用。原始 PCM 格式因没有文件头,因此需要使用针对其采样率和位深度进行过配置的播放器。.
从一个简短的脚本、一个语音和一个保存的文件开始。一旦播放和成本变得可预测,再添加分段、重试以及媒体工作流中的其他环节。在实现过程中,请将所选 API 的请求格式、计费单位和输出处理保持一致。.
为您的下一部剧本注入声音
起草一份简短的产品导览,使用 ElevenLabs 或 Qwen 制作旁白,然后在 GlobalGPT 的多模型工作区中继续处理图片和视频。.
使用 GlobalGPT 生成语音音频