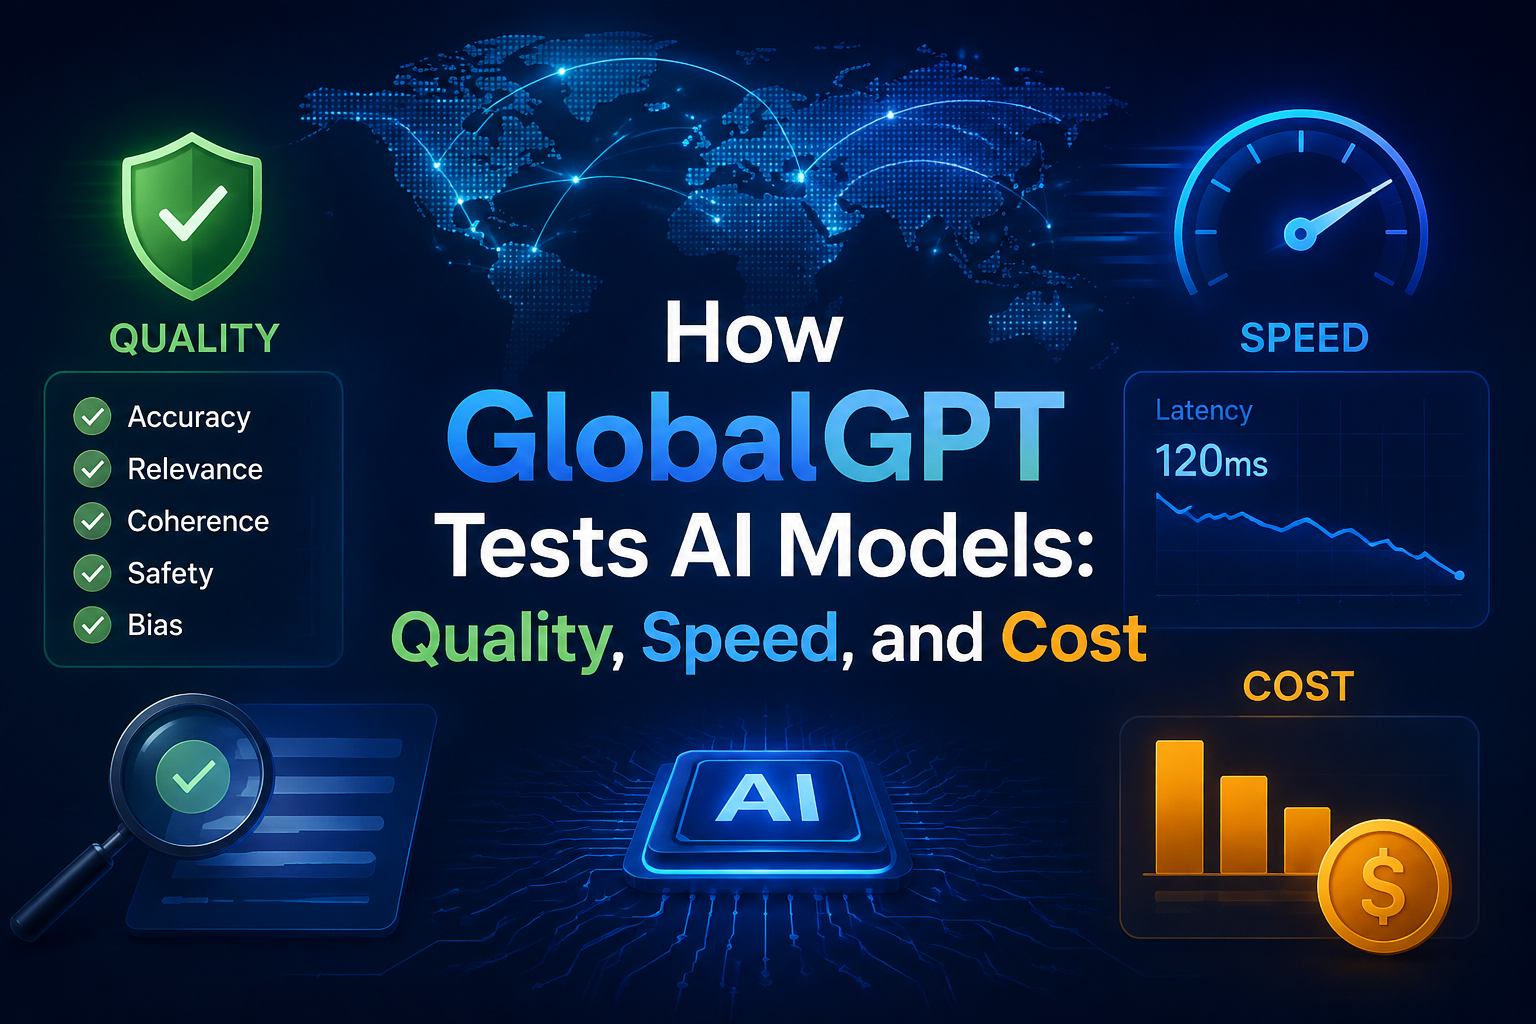
模型比較始於一項具體任務:我們提出了什麼要求,而輸出結果是否符合這些要求?我們使用 GlobalGPT CLI 在 GlobalGPT 上對 AI 模型進行測試。相關文章中會列出例外情況。.
AI 會檢查輸出內容是否有錯誤,以及是否符合提示要求。當輸出內容通過這些檢查後,我們會比較速度、價格,以及適用的情況下對代幣的使用情況。作者還會評估主觀品質,例如寫作風格和視覺吸引力。音訊評估完全由 AI 透過 Gemini 3.6 Flash 執行。.
我們是 GlobalGPT 審查小組, 隸屬於 GlobalGPT 框架。此方法論涵蓋我們在新機型推出時於部落格發布的測試報告,以及機型比較內容。基於 GlobalGPT 用戶數據所撰寫的研究報告,會針對其數據集與分析方法進行說明。.
我們的測試環境:GlobalGPT CLI
GlobalGPT CLI 是我們的預設測試環境。若測試使用不同的介面、API 路徑或原生編碼工具,則需在該環境背景下進行解讀。模型名稱、可用設定、工具及存取權限可能會因環境而異。.
產生輸出的模型與評估該輸出的 AI 扮演著不同的角色。評估者的判斷是關於回傳輸出的證據;它並不能說明受測模型的內部運作機制。.
任務設計:提示、輸入與需求
我們會向模型賦予具有明確需求具體任務。例如,寫作任務可能要求僅依據提供的筆記來撰寫摘要;程式設計任務可能要求撰寫一個能處理空輸入的函式;而圖像任務則可能要求海報上必須使用精確的文字表述。.
相較之下,提示語與輸入資料決定了每個模型被要求執行什麼任務。在解讀結果時,支援的格式、設定或可用工具之間的差異至關重要。固定提示語的比較,與透過多次嘗試來優化提示語的教學指南,所解答的問題各不相同。.
輸出評估:錯誤、指示與效率
錯誤與及時遵循
AI 會評估輸出內容是否符合任務要求,以及是否包含可辨識的錯誤。相關檢查可能涵蓋計算錯誤、缺乏依據的論點、欄位遺漏,或未遵循規定格式等情況。.
「通過」表示所執行的檢查未發現任何錯誤。. 這並不能保證輸出結果完全沒有任何可能的錯誤。AI 評估人員可能會忽略錯誤,或做出錯誤的判斷。.
執行證據是評估中的一個獨立部分。在我們的 Kimi 編碼計畫測試, 生成的程式碼後接五項局部檢查。閱讀程式碼、請模型檢視其自身的答案,以及執行測試,都能提供不同的證據。.
速度、價格與代幣用途
一旦輸出結果符合任務要求,效率便有助於區分實用的選項。一個雖能迅速得出答案卻遺漏了必要計算的結果,其完成的工作量並不如一個正確的答案。.
| 度量 | 如何閱讀 |
|---|---|
| 時間 | 請查看測量視窗。從請求到完成的時間包含相關的路徑與處理過程;這未必等同於服務提供者端的模型延遲。. |
| 代幣用途 | 請使用該服務所回傳的分類。即使輸入、輸出、快取或推理標記資料缺失,也不代表使用量為零。. |
| 成本 | 請將已記錄的 GlobalGPT 費用或退款,與根據供應商 API 價格估算的金額區分開來。訂閱費則是另一項衡量標準。. |
| 媒體世代 | 請考量輸出設定以及適用的抵免額或每項輸出的費用。代幣數量可能無法取得,或不具參考價值。. |
價格估算必須明列計算依據。若無經核實的轉換規則,則無法將積分轉換為美元;且僅憑值為零的回應欄位,並不能證明該請求是免費的。.
針對主觀任務的作者評分
作者們也會在偏好影響實用性時,對成果進行比較。就寫作或圖像而言,這可能意味著要說明哪項成果的語言更清晰、版面更易讀,或是構圖更符合創作要求。.
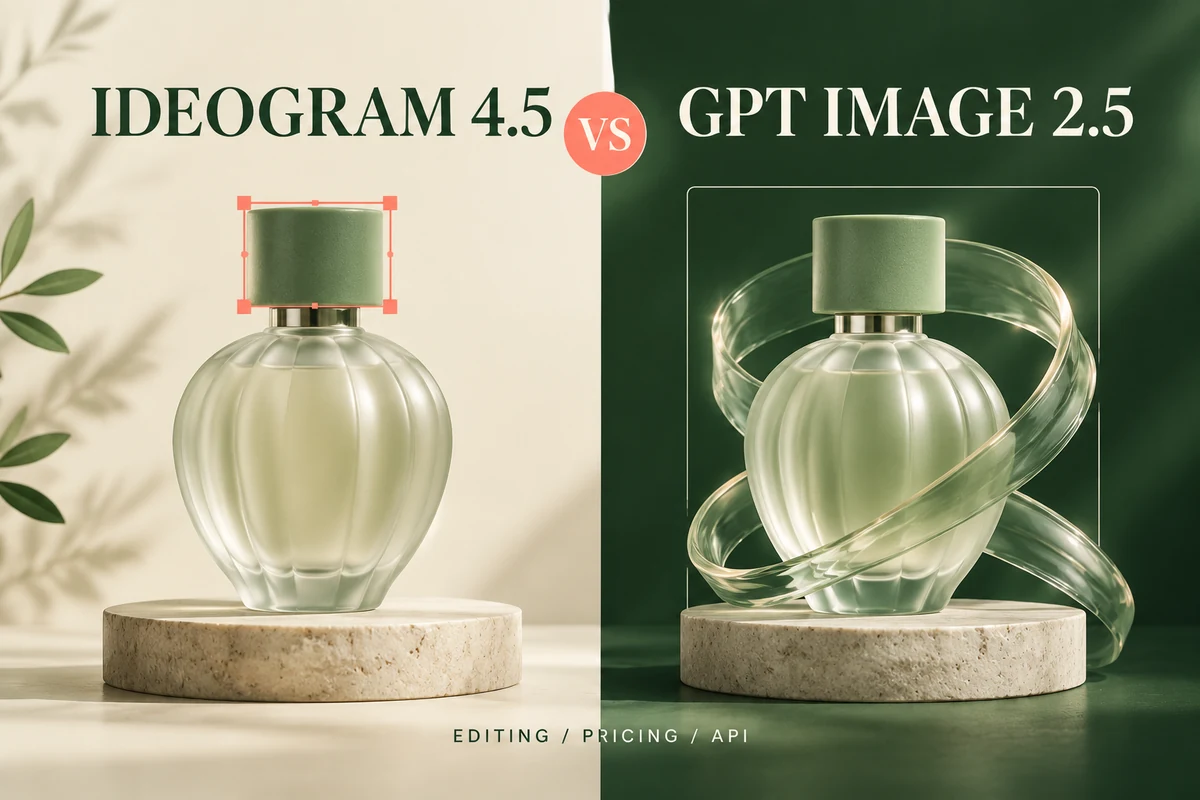
我們的 Seedream 5.0 Pro 與 GPT Image 2 比較 展示了針對特定任務的成對圖像。醒目的文字與版面配置讓讀者能同時檢視這些內容,並與作者的偏好進行對比。美學偏好與經客觀驗證的要求仍屬兩回事。.
使用 Gemini 3.6 Flash 進行 AI 音訊評估
我們的音訊聆聽評估完全由人工智慧執行。. 我們使用 Gemini 3.6 Flash 來解析實際的音訊。這些是 AI 評估結果,而非人類聽評小組的結果。.
評估取決於任務內容:所需分析的對象是語音、語言、聲音事件、時間節奏,還是音樂結構。我們的 Seed Audio 1.0 評測 包含生成的音訊,以及對內容、事件、時間點和人工痕跡的人工智慧分析。.
檔案屬性(例如格式與時長)與內容判斷是分開的。音軌的存在並不能證明所要求的詞彙或聲音是正確的。任何已發布的樂譜,都必須配合評分標準及其所描述的音檔一併參閱。.
如何解讀測試日期、設定及輸出結果
詳細的測試證據應呈列於個別文章中。有用的背景資訊包括:
- 測試日期、型號識別碼及環境。.
- 任務、提示、輸入材料及預期成果。.
- 可用的設定、嘗試次數及相關變更。.
- 評審員、所進行的核查,以及任何作者偏好的理由。.
- 實際輸出內容或節錄、螢幕截圖或媒體檔案,以及可用的時程、使用情況及成本紀錄。.
不同文章與較早期的測試中,記錄內容各不相同。遺漏的測量值無法作為觀察事實加以重建。模型彙整頁面的「部落格與指南」區塊提供了相關評測及本方法論的連結;完整的提示與輸出證據仍保留於部落格文章中。.
關於重試、請求失敗與修訂的解讀
首次產出、經篩選的結果,以及經修改後的嘗試,所傳達給讀者的訊息各不相同。文章的嘗試歷程至關重要,其中包含技術故障、空回應、不完整的答案,以及對提示語或設定的變更。.
一個已完成的請求仍可能返回無法使用的回應。一個失敗的請求可能會揭示受測路徑存在問題,但未必代表整體模型存在弱點。我們的文章採用不同的測試範圍;每項結果背後並無通用的執行次數或盲測程序。.
任務結果能告訴你什麼、不能告訴你什麼
某項結果可支持針對受測任務、模型、日期及環境所作出的結論。小型任務集與個別計時測量無法確立通用的表現排名。若比較中僅測試了一方,該證據便無法支持兩者之間存在受測的勝出者。.
官方規格、外部基準測試、過往測試結果,以及文章本身的測試結果,皆提供了不同類型的證據。任何評分都取決於其所聲明的評分標準、權重分配及排除項目。讀者應能將結論與證據相互對照,包括不完整的或未成功的測試結果。.
文章更新與模型重新測試有何不同
我們通常每兩至四週審閱一次文章,詳情請參閱我們的 編輯準則. 內容檢查並不代表每個模型測試都已重新執行。.
更新價格、修正現有輸出結果的評估,以及產生新的輸出結果,這三者是各自獨立的動作。歷史結果仍與其原始測試情境相關聯;僅憑文章更新日期較新,並不能使其成為新的測試結果。.