
證據指南 · 更新於 2026 年 9 月
Perplexity 人工智慧可以協助您查找資料來源並構建初步答案,但其引用來源並不能保證答案是正確的。. 準確度取決於問題內容、搜尋模式以及資料來源的品質。這雖是進行研究的有用起點,但針對重要論點,仍需對照原始頁面加以核實。.
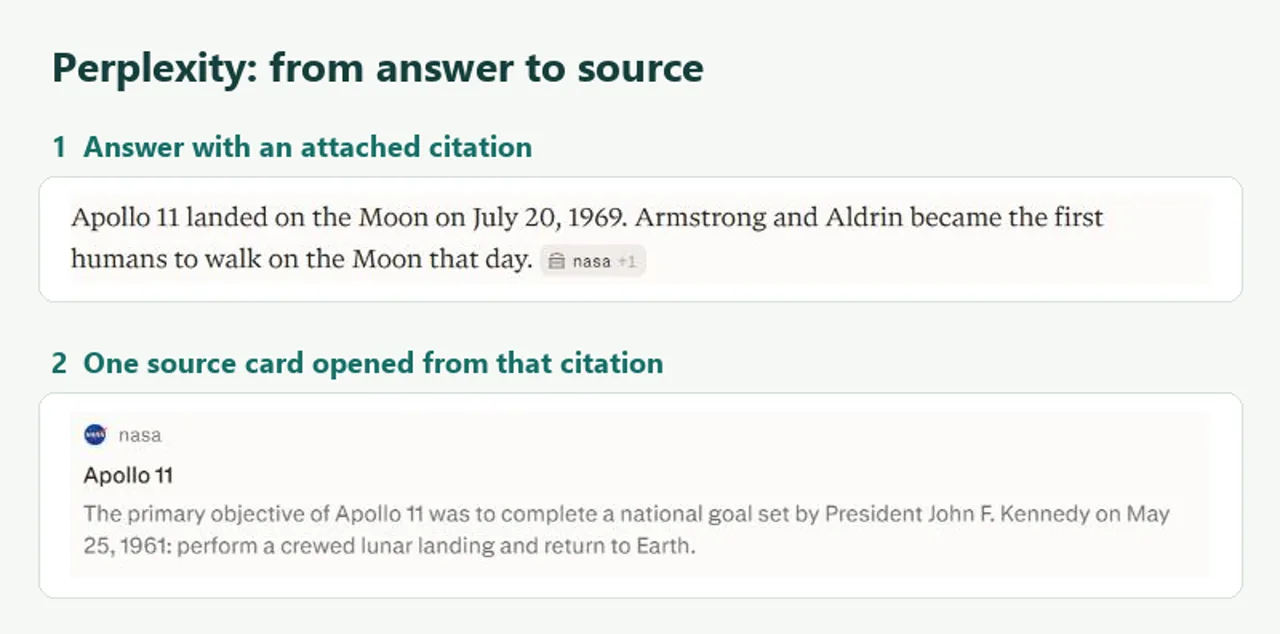
編號引用可能導向一個真實且相關的頁面,但該頁面未必附有與該引用相符的確切統計數據、日期、引文或結論。因此,Perplexity 引用的準確性不僅僅在於連結是否有效:來源必須在相同的語境下支持該論點。.
在您發布統計數據、引用論文,或依據某個答案來做出決策之前,請先開啟附件中的原始資料,找出相關段落,並將其措辭、日期及範圍與該答案進行比對。若原始資料缺失,或其內容與該答案有所不同,請將該主張視為未經證實。.
Perplexity 的準確度究竟代表什麼?
Perplexity 的準確性至少包含兩個層面:答案是否正確,以及其來源是否能支持該答案。一個百分比通常隱含著幾項不同的檢驗。一個連結即使能成功開啟,仍可能未能通過最重要的檢驗:該頁面是否能支持其附帶的主張。.
| 維度 | 問題 | 常見故障 |
|---|---|---|
| 引用解析 | 該網址是否能正常開啟並導向至預期的頁面? | 失效、被重定向或偽造的網址 |
| 來源相關性 | 這頁面的內容是否確實與該主題相關? | 僅提及該主題的即時頁面 |
| 申請支援 | 這是否能佐證該句、該數字或該日期? | 引用過度還是虛構數據 |
| 品質與新鮮度 | 這內容是否原創、權威且最新? | 過時的頁面或轉載內容 |
對出版商和品牌而言,引用存在與準確性是兩回事。某個工具或許能告訴你 Perplexity 提到了貴公司,但無法判斷該回答是否正確描述了貴公司。存在度衡量的是能見度;準確性則衡量來源與陳述是否一致。.
我們的 Perplexity AI 初學者使用指南 說明了基本的工作流程。本文著重探討答案出現後的步驟:檢視證據。.
那項最著名的 Perplexity 引用研究實際上測試了什麼?
陶中心與《哥倫比亞新聞評論》的研究方法
最具參考價值的公開基準,是由托中心(Tow Center)發布的《數位新聞學研究》報告,該報告由 《哥倫比亞新聞評論》 2025年3月6日。研究人員選取了20家新聞媒體,從每家媒體中各挑選10篇文章,並將文章摘錄提供給8個AI搜尋引擎。每個系統都必須識別出文章的標題、發佈單位、發佈日期及網址。.
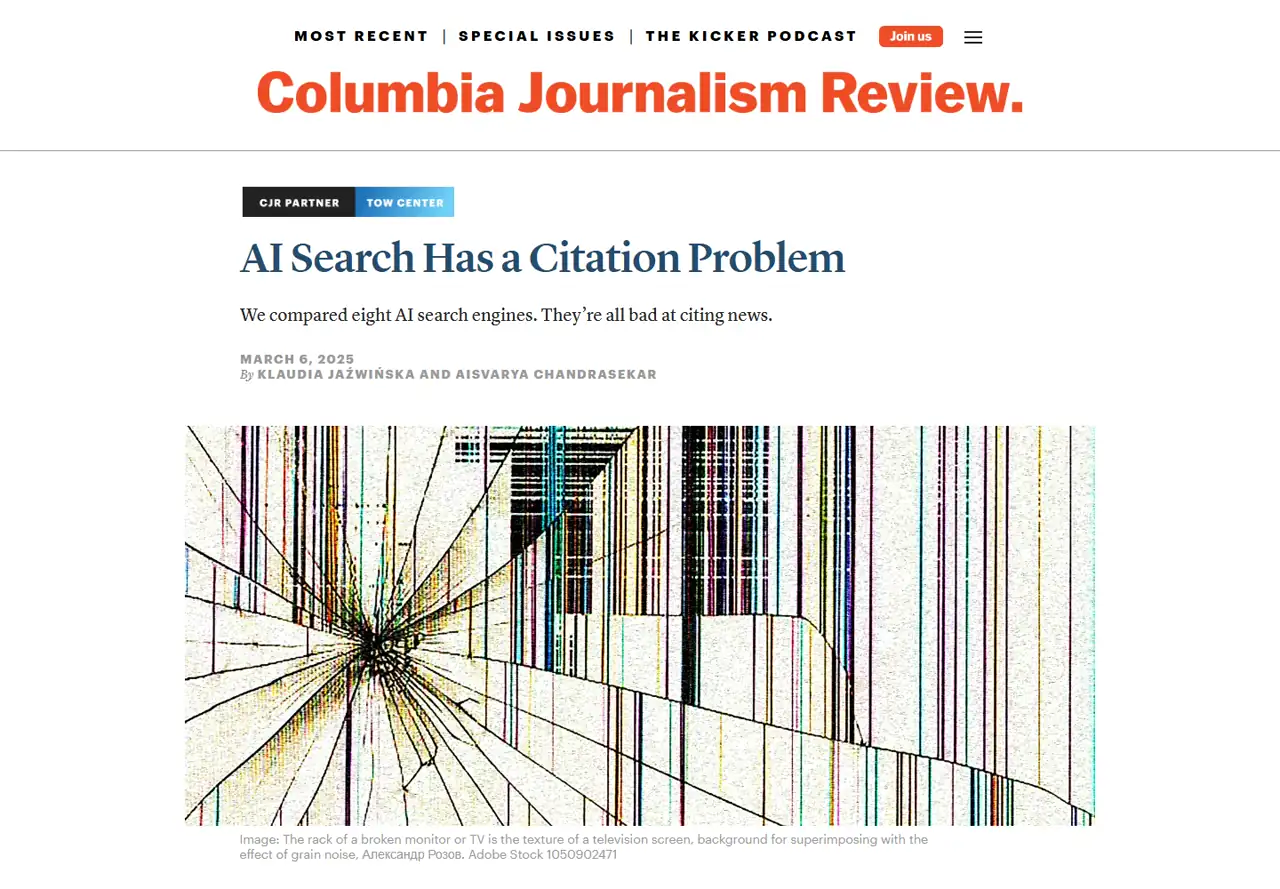
這產生了 1,600 個查詢:20 家出版商乘以 10 篇文章,再加上 8 種工具。此方法的實用之處在於,研究人員擁有已知的來源文章,並能將每個答案與之進行比對。其局限性在於,此測試僅針對新聞摘錄的來源識別能力,而非涵蓋所有研究、購物、學術、程式設計或綜合性問題。.
這項研究針對 Perplexity 的發現
| 工具 | 測試任務的結果 | 如何閱讀 |
|---|---|---|
| 困惑 | 37% 錯誤 | 特定新聞來源識別任務 |
| 聊天GPT搜尋 | 67% 錯誤 | 相同的任務與比較框架 |
| Grok 3 | 94% 錯誤 | 相同的任務與比較框架 |
原始來源: AI 搜尋面臨引用問題, 托中心/《哥倫比亞新聞評論》,2025年3月6日刊載。.
這項研究並未證明什麼
- 它並未測試所有題目,也未測試 Perplexity 模式。.
- 它並未為未來的版本建立一個永久的評分。.
- 這並不能證明每一個引用 Perplexity 的說法都是錯誤的。.
- 這並未證明它能成為每個主題的全球贏家。.
- 不應改寫為「63% 整體引用準確度」。“
Prompt Architects 的分析 也提出了同樣有價值的觀點:只有當讀者能夠了解該數字背後的樣本、評分規則、任務定義及日期時,這個數字才具有意義。.
為什麼一個 Perplexity 的引用格式看似正確,卻仍可能有誤?
引用不符比連結失效更難察覺。網頁成功載入,標題聽起來切題,而答案可能也說得頭頭是道。問題在於,當你將該論點與來源頁面的措辭及上下文進行比對時,才會顯露端倪。.
| 失效模式 | 外觀如何 | 檢查 |
|---|---|---|
| 索賠與來源不符 | 原始來源並未支持該陳述的內容。. | 找出確切的句子或數字。. |
| 引用過度 | 來源提出了一個溫和的觀點;回答則提出了一個更強有力的觀點。. | 比較措辭的力度與方向。. |
| 話題偏離 | 連結雖然有效,但文章的內容卻是關於另一個主題。. | 請閱讀標題和開頭部分。. |
| 虛幻統計數據 | 該數字出現在答案中,但頁面上並未顯示。. | 搜尋該數字及其單位。. |
| 聯播的混淆 | 轉發時引用了轉載來源,而非原始發布者。. | 找出第一方版本及日期。. |
| 過時或損壞的來源 | 頁面已變更、消失或出現錯誤。. | 在新工作階段中開啟。. |
困惑 來源標籤指引 這也設定了一個有用的預期:標籤是對整個網站的描述,而非針對每篇個別文章或主張的真實性。.
請在數字、日期、姓名、引言或推薦語上畫圈。.
請點擊該句子附帶的來源連結。.
搜尋該詞組、數字或證據。.
請查核背景、範圍、日期及來源。.
如何在兩分鐘內驗證一則 Perplexity 引用
首先從若不正確將造成最大損害的陳述著手:例如價格、百分比、日期、引言、法律條款、醫療聲明或與競爭對手的比較。.
- 請選擇索賠項目。. 請準確複製該句子或數字。.
- 請開啟附件中的引用資料。. 請使用與該句子相關的來源。.
- 搜尋此頁面。. 請使用「尋找」功能來搜尋數字、短語或命名的研究。.
- 請閱讀這段文字。. 請檢查主題、日期、範圍、單位及方向。.
- 查核來源。. 請優先採用原始版本及最新版本。若比對失敗,請標記為「未經核實」。.
可重複使用的驗證提示: 請開啟您用來佐證「[主張]」的來源。引用能佐證該主張的確切句子。若該來源中並無任何句子能佐證所述主張,請直接說明,且勿重述該主張。.
這個提示並不會讓原始檢索結果更精準。它只是迫使模型展示其運算過程。當答案即將發布,或將用於重大決策時,您仍需閱讀原始資料。.
Perplexity 深度研究是否比標準搜尋更準確?
一份篇幅較長且引用更多來源的報告可能更有用,但篇幅長短並非驗證評分標準。深度研究在檢索、整合及錯誤歸類資訊方面存在更多可能性。公開案例雖能顯示引用問題確實存在,但並不能據此為每次研究過程確立一個穩定的準確度百分比。.
將審查工作與結果相匹配。針對風險較低的概述進行抽查。若為文獻回顧、盡職調查備忘錄或包含確切統計數據的報告,請逐一核對每個數字並查閱來源。我們的 模型與模式指南 說明工作流程的差異;但這無法取代驗證程序。.
在引用方面,Perplexity 是否比 ChatGPT 更精準?
在 Tow Center 的特定新聞來源識別任務中,Perplexity 的錯誤答案數量少於 ChatGPT Search。這是一項公平的同任務比較,而非針對所有模型、查詢、日期或模式的全面性結論。.
要進行公平的比較,必須採用相同的提示、來源資料集、時間範圍、評分規則,以及對棄權的處理方式。若要了解更廣泛的工作流程背景,請參閱我們的 Perplexity 與 ChatGPT 測試.
何時使用 Perplexity 引用格式才是安全的?
| 使用案例 | 如何處理引用 |
|---|---|
| 主題與來源的發現 | 不錯的起點;開放原始碼。. |
| 時事導向 | 請核對日期、原始文件及更新內容。. |
| 簡要總結(重點不重) | 對那些包含該結論的論點進行抽查。. |
| 學術文獻回顧 | 請閱讀並引用原始論文。. |
| 醫療、法律、財務或安全方面的決策 | 請僅將輸出視為潛在客戶。. |
| 品牌與AEO監控 | 請分別追蹤「出現次數」與「準確度」。. |
在為人工智慧研究任務上傳內部文件或個人資料之前,請先查閱相關政策及工作區設定。我們的指南說明 各模型政策中的 AI 資料隱私 是一個有用的起點。.
該如何查證關於某個品牌的說法?
“「我們被引用了」僅是審計報告的第一行。請記錄查詢內容、主張的答覆、引用網址、來源類型,以及該頁面是否支持該主張。由於網路和檢索系統會有所變動,請一併記錄檢索模式和測試日期。.
| 稽核欄位 | 應記錄哪些內容 |
|---|---|
| 查詢 | 確切的提示以及市場或語言 |
| 主張 | 待檢查的句子、數字或說明 |
| 引用 | 網址、標題、發行者及存取日期 |
| 支援狀態 | 獲得支持、部分支持、遭到反駁,或未發現 |
| 來源 | 原創、聯播、官方、次級或社群 |
| 上下文 | 模式、型號、日期及變更備註 |
若您正在核對有關貴公司或競爭對手的答案,請將每項價格、功能及限制與原始產品頁面進行比對。例如,除非該頁面將某項功能列於相同的方案之下,否則僅引用價格頁面並不能作為該功能已包含在內的依據。在將該答案重新用於報告或建議之前,請先記錄任何不一致之處。.
有關相關產品的決策,請參閱我們的 困惑替代方案, ,關於……的指南 Perplexity 的運作方式與 Google 及 ChatGPT 相比如何, ,以及關於 Perplexity 的研究與引用功能.
常見問題
Perplexity 提供的資訊準確嗎?
Perplexity 能提供實用且最新的資訊,特別是在尋找資訊來源方面。其準確性取決於查詢內容、來源集、模式及陳述內容。在被引用的頁面能佐證之前,應將重要的數字、日期、引言及建議視為未經核實。.
Perplexity 的消息來源可靠嗎?
有些來源具權威性,有些則不然。來源標示雖能協助您評估該網站的可信度,但無法證明某篇文章支持某個特定論點。請查核其發布日期、來源及上下文。.
Perplexity AI 的準確度有多高?
目前尚無單一百分比能涵蓋所有查詢與模式。最知名的公開基準測試在某項新聞來源識別任務中,測得 37% 的錯誤率。請連同其樣本與任務一併報告,而非將其視為通用分數。.
Perplexity 的引用是否表示該主張已獲證實?
不。引用是指附上了來源。而驗證則需要查核該來源是否在相同的語境與範圍內,針對該具體主張提供了證據。.
Perplexity 適合用於學術寫作嗎?
它有助於發掘論文並建立閱讀清單。開啟原始論文,核實引文或研究結果,並引用該論文本身。.
Perplexity 的準確度是否高於 ChatGPT?
在托中心(Tow Center)針對特定新聞來源識別的測試中,Perplexity 的表現優於 ChatGPT Search。但這並不代表它在每個主題或模式下都能勝出。.
該如何確認 Perplexity 的引用是否正確?
開啟該引用資料,搜尋關鍵詞組或數字,閱讀周邊段落,並比較主題、範圍、日期及方向。若比對不符,請標記為「未經核實」。.
即使連結有效,Perplexity 是否仍可能引用錯誤的來源?
是的。該頁面可能已上線且內容相關,但仍無法完全支持該主張。主張與來源的比對,比僅檢查 URL 是否可解析更有用。.
想要一個附有參考文獻的研究工作區嗎? 若您希望直接體驗研究過程,並在單一平台上比較各種 AI 工作流程,請探索 Perplexity 至 GlobalGPT。.
於 GlobalGPT 開立 Perplexity 部位結論:將引用視為線索,然後核實該說法
Perplexity 的引用資訊能讓研究更有效率,因為它們為您提供了一條通往網路的途徑。但這並不代表您就不需要閱讀原始來源了。 Tow Center/CJR 的研究結果雖具參考價值,但其 37% 的數據僅適用於某項特定的新聞來源任務。這並非一個恆定且通用的 Perplexity 引用評分標準。.
當某項論點至關重要時,請先釐清該論點、查閱相關文獻、找出證據,並對照上下文。這個習慣能發現那些被精緻介面所掩蓋的錯誤,並在您需要說明答案來源時,為您提供一份站得住腳的紀錄。.









