GPT-6 Astra และ Claude Fable 5.1 มีราคา API หลักที่เริ่มต้นเท่ากัน แต่ทั้งสองไม่แสดงพฤติกรรมที่เหมือนกันในการทดสอบความเข้ากันได้ของ API ที่เราจัดขึ้น. Astra ให้ผลลัพธ์ที่ใช้งานได้จริงมากขึ้นในด้านการวิเคราะห์เหตุผล การเขียน การเขียนโค้ด การค้นหาข้อมูลในบริบทยาว และกลยุทธ์ ส่วน Fable มีผลคะแนนเท่ากันในการทดสอบความแม่นยำของบริบทยาว และเขียนข้อความประชาสัมพันธ์ที่น่าเชื่อถือได้ แต่ในเส้นทางนี้ มีหลายครั้งที่ผลลัพธ์ถูกตัดสั้นหรือว่างเปล่า.

บทสรุปสั้นๆ
GPT-6 Astra · 43/50
การค้นหาบริบทยาว · 10/10 สำหรับแต่ละข้อ
การกำหนดเส้นทางตามความเข้ากันได้อาจอธิบายได้ถึงผลลัพธ์ที่ว่างเปล่าของ Fable.
เลือก GPT-6 Astra เมื่อคุณต้องการคำตอบขั้นแรกที่เชื่อถือได้สำหรับงานที่ผสมผสานระหว่างการวิเคราะห์และด้านเทคนิค เลือก Claude Fable 5.1 เมื่อจุดปลายทางของคุณได้รับการตรวจสอบแล้วว่าสามารถจัดการผลลัพธ์ที่มองเห็นได้ และคุณให้ความสำคัญกับการตีความบริบทที่ยาวหรือสไตล์การเขียนที่วัดได้ นี่ไม่ใช่การจัดอันดับโมเดลแบบสากล: แต่เป็นการทดสอบที่ควบคุมผ่าน Broly Anywhere เมื่อวันที่ 8 กันยายน 2026.
GPT-6 Astra vs Claude Fable 5.1: เปรียบเทียบแบบสรุป
| สนาม | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| ID API | gpt-6-astra | claude-fable-5-1 |
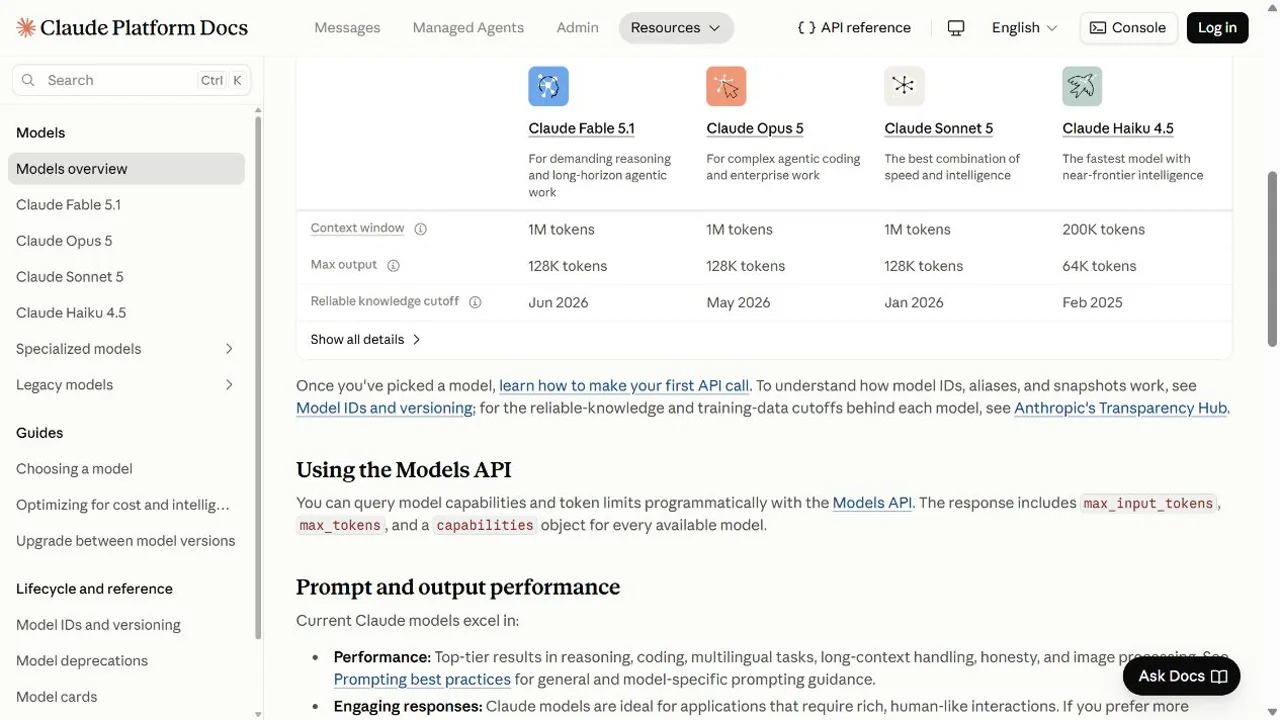
| บริบท | 1.05 ล้านโทเค็น | 1 ล้านโทเค็น |
| กำลังออกสูงสุด | โทเค็น 128K | โทเค็น 128K |
| ข้อมูลนำเข้าพื้นฐาน | $10 / 1M | $10 / 1M |
| ข้อมูลที่เก็บไว้ในแคช / การค้นหาที่ตรงกัน | $1 / 1M | $0.25 / 1M |
| ผลลัพธ์ | $50 / 1M | $50 / 1M |
| ชุด | 50% ตามมาตรฐาน | $5 (เข้า) / $25 (ออก) ต่อ 1M |
| เหตุผล | ความพยายามในการให้เหตุผลที่ปรับแต่งได้ | การคิดแบบปรับตัวได้, ทำงานอยู่เสมอ; ระดับเริ่มต้นสูง |
| คะแนนการทดสอบที่วัดได้ | 43/50 | 19/50 |
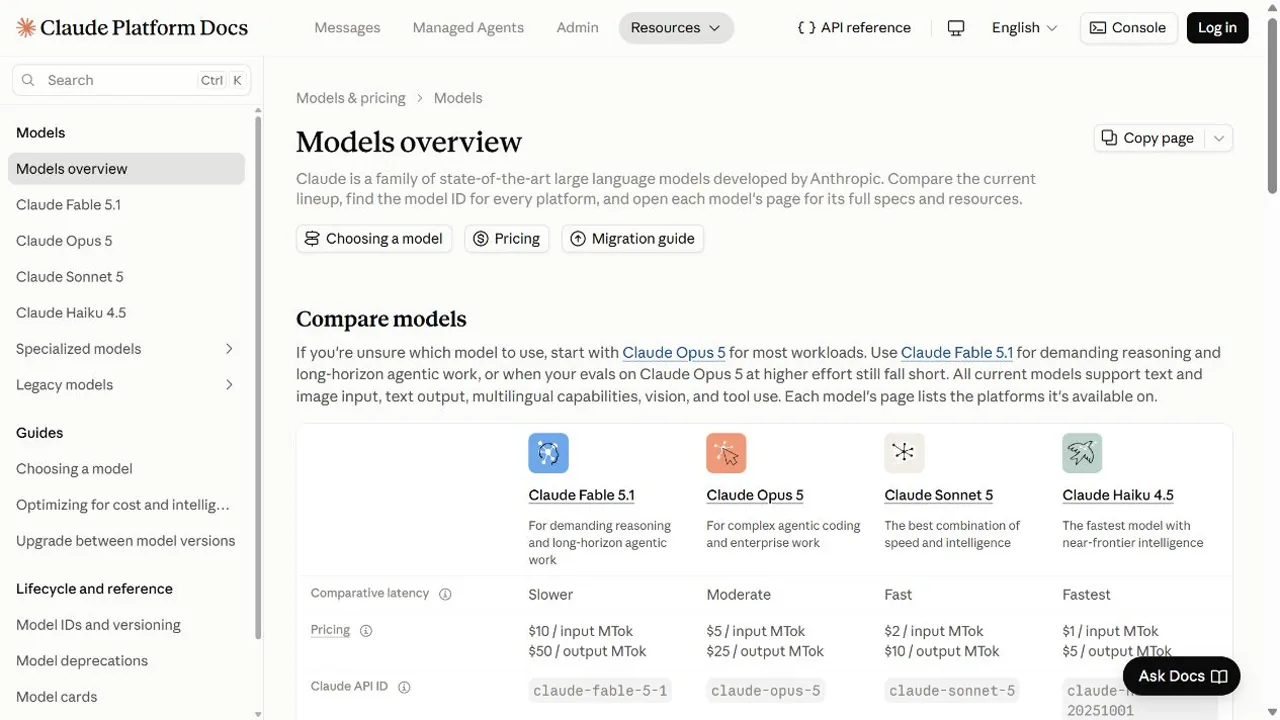
เพื่อเข้าใจบริบทของโมเดลอย่างลึกซึ้งยิ่งขึ้น โปรดดู รีวิว GPT-6 Astra, คู่มือ Claude Fable 5.1, และ การเปรียบเทียบรุ่น Claude.
ราคา, การเก็บไว้ในแคช, บริบท และข้อจำกัด
ทั้งสองรุ่นระบุค่า $10 ต่อหนึ่งล้านโทเคนข้อมูลเข้าพื้นฐาน และ $50 ต่อหนึ่งล้านโทเคนข้อมูลออก ความแตกต่างในการทำงานอยู่ที่ระบบแคช GPT-6 Astra ระบุค่า $1 ต่อหนึ่งล้านโทเคนข้อมูลเข้าที่เก็บในแคช และอัตราการเขียนข้อมูลลงแคชที่ $12.50 Fable 5.1 ระบุว่ามี cache hits $0.25, อัตราการเขียนในแคชทุก 5 นาที $12.50 และอัตราการเขียนในแคชทุก 1 ชั่วโมง $20 ต่อหนึ่งล้านโทเคน Anthropic ระบุว่าบริบทเต็ม 1 ล้านโทเคนยังคงมีราคาตามมาตรฐาน; ส่วน Astra จะใช้ราคาที่สูงขึ้นเมื่อข้อมูลเข้าเกิน 272K โทเคน.
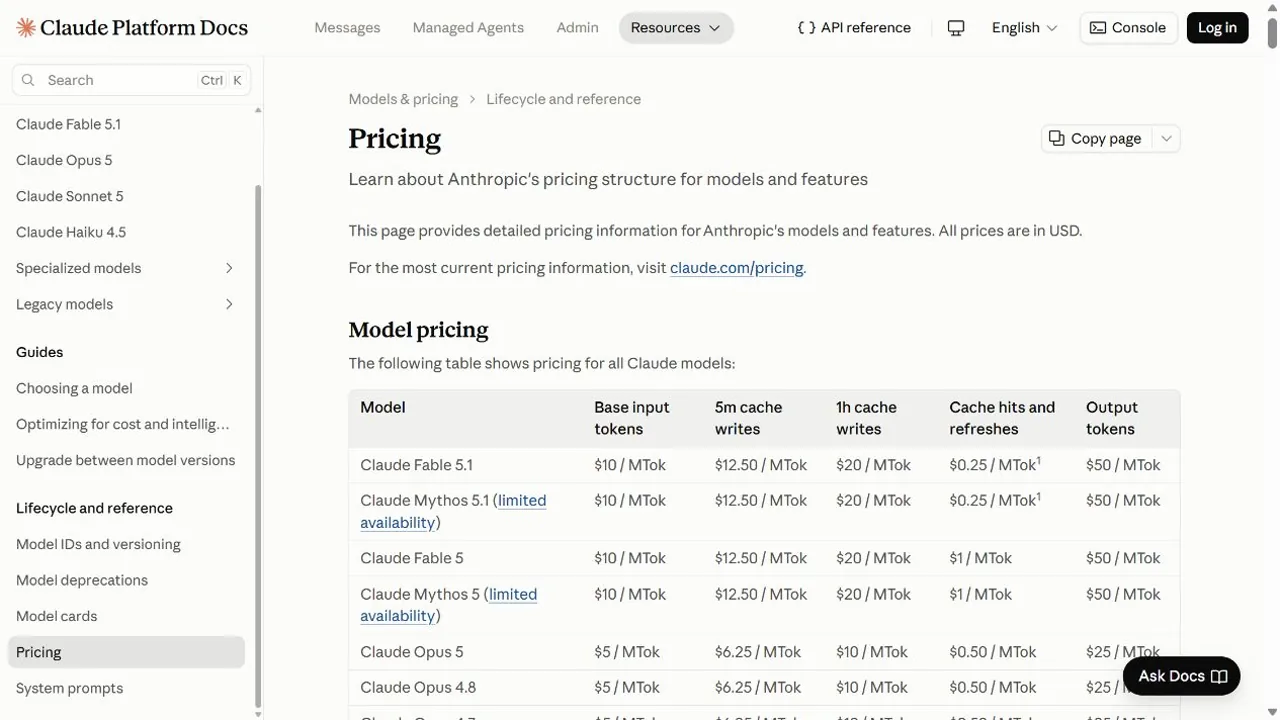
อ่านฉบับเต็ม รายละเอียดราคา GPT-6 Astra หรือเปรียบเทียบกับของเรา คู่มือราคา Claude Fable. ราคาตามรายชื่อผู้ให้บริการไม่เท่ากับเครดิต GlobalGPT หรือการคิดค่าบริการตามชั้นความเข้ากันได้โดยอัตโนมัติ.
การทดสอบ API ที่ตรงกัน 5 ครั้ง
เราได้ส่งงานเดียวกันไปยังแต่ละ ID ของโมเดลผ่านจุดปลายทางที่รองรับ OpenAI เดียวกัน การทดสอบ 1-4 อนุญาตให้ใช้โทเคนผลลัพธ์ได้สูงสุด 2,000 โทเคน ส่วนการทดสอบ 5 ใช้ 1,200 โทเคนสำหรับทั้งสองกรณี หลังจากที่เกตเวย์ได้ตัดคำขอที่ไม่ใช่แบบสตรีมมิ่งที่ยาวกว่าประมาณ 30 วินาที ทุกคะแนนใช้กฎ 5 ข้อที่กำหนดไว้ก่อนการทดสอบ ผลลัพธ์ที่ว่างเปล่าจะไม่ได้รับคะแนนสำหรับงานที่มองไม่เห็น.
เหตุผล: การตัดสินใจเกี่ยวกับค่าใช้จ่ายของ SaaS
Astra ได้เสร็จสิ้นการสร้างแบบจำลองทางการเงินแล้ว ส่วน Fable หยุดลงระหว่างขั้นตอนการตั้งสมมติฐาน.
ดูงานอย่างละเอียด
HTTP 200 · 28.98 วินาที · 242 รายการป้อนข้อมูล · 1,427 รายการเสร็จสิ้น · คะแนน 10/10
HTTP 200 · 26.01 วินาที · 357 ข้อมูลเข้า · 2,000 ข้อมูลออก · คะแนน 1/10
การเขียน: การแก้ไขเนื้อหาสำหรับการเปิดตัวผลิตภัณฑ์
ทั้งสองฉบับล้วนให้เนื้อหาที่ใช้งานได้ แต่ Fable ได้เพิ่มรายละเอียดที่ไม่มีในบันทึก.
ดูงานอย่างละเอียด
HTTP 200 · 15.47 วินาที · 165 ข้อมูลเข้า · 500 ข้อมูลออก · คะแนน 10/10
HTTP 200 · 26.01 วินาที · 263 ครั้งที่รับข้อมูล · 1,881 ครั้งที่เสร็จสิ้น · คะแนน 8/10
การเขียนโค้ด: ความพร้อมกันใน TypeScript
Astra ให้ผลการวินิจฉัยที่ชัดเจนและผลการทดสอบบางส่วน; ส่วน Fable ไม่ให้คำตอบที่ชัดเจนในเส้นทางนี้.
ดูงานอย่างละเอียด
HTTP 200 · 41.54 วินาที · 181 ข้อมูลเข้า · 2,000 ข้อมูลออก · คะแนน 9/10
HTTP 200 · 29.44 วินาที · 277 ข้อมูลเข้า · 2,000 ข้อมูลออก · คะแนน 0/10
บริบทโดยละเอียด: การปรับปรุงดินด้วยการปลูกพืช
ทั้งสองฝ่ายได้ค้นพบและอ้างอิงการแก้ไขมาตรา 417 ซึ่งเป็นบทบัญญัติที่มีผลบังคับใช้.
ดูงานอย่างละเอียด
HTTP 200 · 14.96 วินาที · 99,495 ข้อมูลเข้า · 244 ข้อมูลเสร็จ · คะแนน 10/10
HTTP 200 · 22.24 วินาที · 295,912 รายการป้อน · 1,053 รายการที่เสร็จสิ้น · คะแนน 10/10
กลยุทธ์: แผนการเข้าสู่ตลาด (GTM) 90 วัน
Astra ได้เริ่มดำเนินแผนที่วางไว้อย่างรอบคอบ แต่ถูกตัดสั้นลง; Fable ไม่ให้คำตอบที่ชัดเจนใดๆ.
ดูงานอย่างละเอียด
HTTP 200 · 34.27 วินาที · 210 ข้อมูลเข้า · 1,200 ข้อมูลออก · คะแนน 4/10
HTTP 200 · 21.09 วินาที · 338 ข้อมูลเข้า · 1,200 ข้อมูลออก · คะแนน 0/10
คุณควรเลือกรุ่นไหนดี?
- การวิเคราะห์และตัดสินใจในการปฏิบัติงาน: Astra ดูสมบูรณ์ยิ่งขึ้นมากในรอบนี้.
- การเขียน: ทั้งสองตัวล้วนใช้งานได้ดี; Astra ติดตามโน้ตต้นฉบับได้แม่นยำกว่า ส่วน Fable ฟังดูเรียบเนียน แต่สร้างรายละเอียดของอินเทอร์เฟซขึ้นมาเอง.
- การเขียนโค้ด: Astra ให้ผลการวินิจฉัยที่ชัดเจนและน่าเชื่อถือกว่า เมื่อเปรียบเทียบรูปแบบที่กว้างขึ้นใน คู่มือการเขียนโค้ด Claude vs ChatGPT.
- เอกสารที่ยาว: ทั้งสองฝ่ายต่างก็พบความขัดแย้งนั้นอย่างแม่นยำ การบันทึกโทเคนมีความแตกต่างอย่างชัดเจน ดังนั้นควรทดสอบค่าใช้จ่ายด้วยเอกสารของคุณเอง.
- กลยุทธ์เชิงตัวแทน: ทั้งสองระบบล้วนไม่สามารถเสร็จสิ้นงานที่มีข้อจำกัดภายในเวลาที่กำหนด; แต่ Astra ยังคงส่งงานบางส่วนที่สามารถใช้งานได้กลับมา.
สำหรับเฟรมเปรียบเทียบอื่น ๆ ดูได้ที่ GPT-6 Astra เทียบกับ GPT-5.6 Sol หรือ Claude Fable 5 vs GPT-5.5.
วิธีเปรียบเทียบทั้งสองใน GlobalGPT
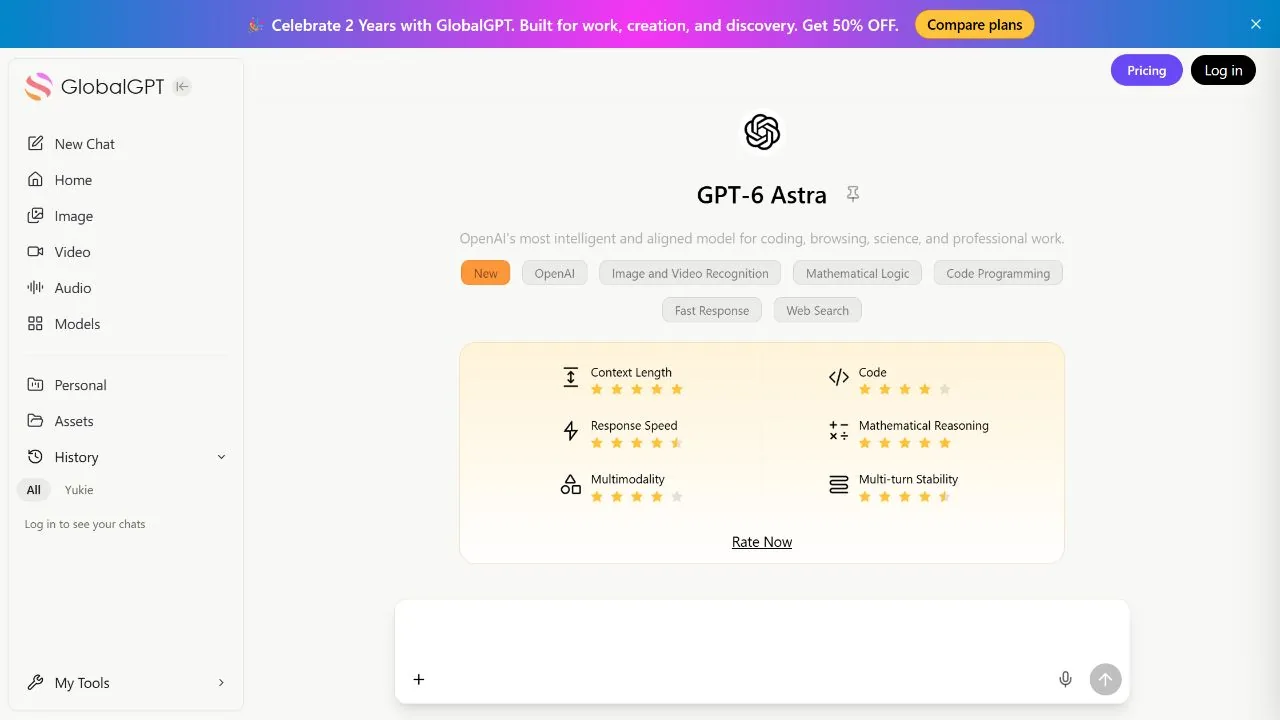
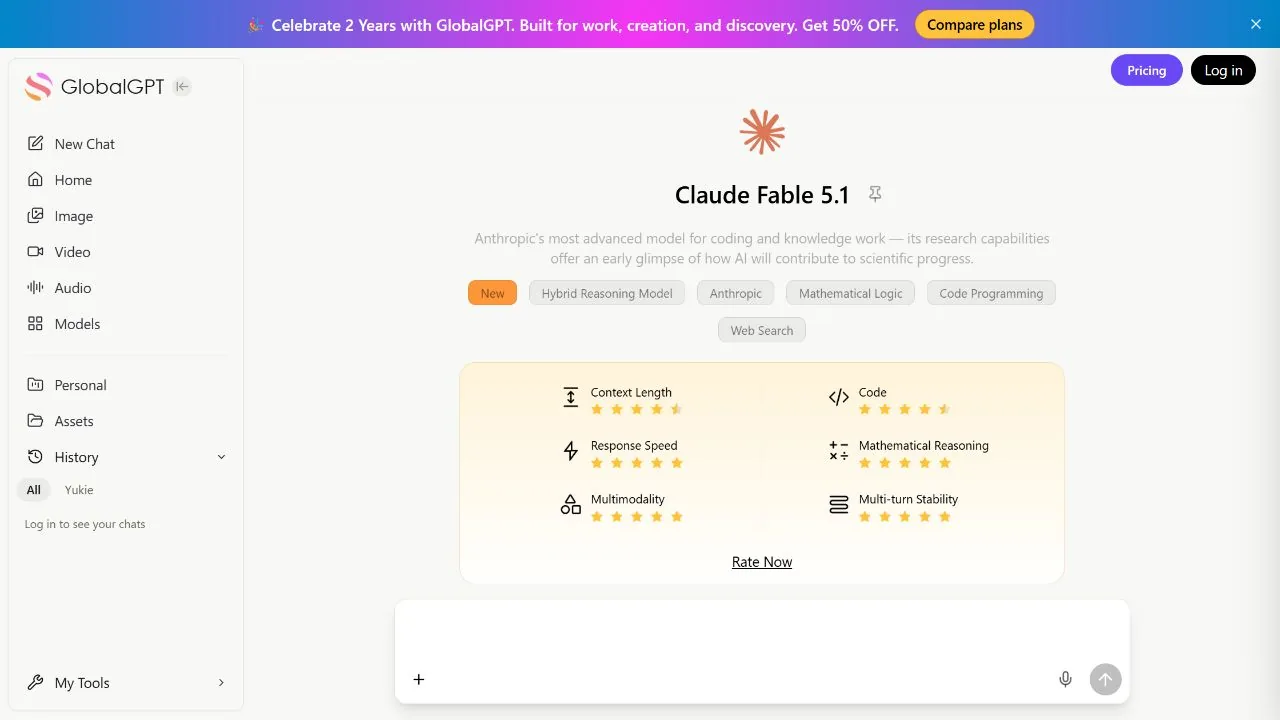
GlobalGPT แสดงเส้นทางลงจอดที่แยกกันสำหรับทั้งสองโมเดล ใช้คำสั่งป้อนข้อมูล ข้อจำกัดผลลัพธ์ และข้อมูลต้นทางเดียวกัน จากนั้นประเมินความถูกต้องที่มองเห็นได้ก่อนที่จะพิจารณาเรื่องสไตล์ บันทึกความล่าช้าและจำนวนโทเคนเมื่ออินเทอร์เฟซหรือ API ส่งคืนข้อมูลดังกล่าว สำหรับเอกสารที่ยาว ให้วัดแต่ละเส้นทางอย่างอิสระ เนื่องจากข้อความที่เหมือนกันอาจถูกแบ่งเป็นโทเคนได้แตกต่างกัน.
คำถามที่มักถูกถาม
GPT-6 Astra มีราคาถูกกว่า Claude Fable 5.1 หรือไม่?
ราคาขายตามรายการพื้นฐานสำหรับข้อมูลเข้าและออกของทั้งสองบริการนั้นเท่ากัน ส่วนราคาตามการเข้าถึงแคช (cache-hit) และกฎสำหรับบริบทยาว (long-context) นั้นแตกต่างกัน ส่วนการคิดค่าบริการแบบ GlobalGPT อาจใช้เครดิตที่แยกกัน.
รุ่นใดมีหน้าต่างบริบทที่ใหญ่กว่า?
GPT-6 Astra มีจำนวนโทเคน 1.05 ล้าน และ Claude Fable 5.1 มีจำนวนโทเคน 1 ล้าน ทั้งสองรุ่นมีขีดจำกัดการส่งออกสูงสุดที่ 128K.
อันไหนดีกว่าสำหรับการเขียนโค้ด?
GPT-6 Astra ได้สร้างคำตอบที่ชัดเจนและน่าเชื่อถือกว่าในการทดสอบ TypeScript ครั้งเดียวของเรา ส่วน Fable ไม่แสดงเนื้อหาใดๆ ผ่านช่องทางความเข้ากันได้นี้ ดังนั้นนี่จึงไม่ใช่ผลการตัดสินจากผู้ให้บริการโดยตรง.
วิธีไหนดีกว่าสำหรับการค้นหาข้อมูลในบริบทที่ยาว?
ทั้งสองฝ่ายมีคะแนนเท่ากันที่ 10/10 โดยระบุและอ้างอิงการแก้ไขข้อมูลที่ถูกใส่ไว้ล่วงหน้าเดียวกัน Fable รายงานจำนวนโทเคนข้อมูลที่ป้อนเข้าไปได้เกือบสามเท่าสำหรับเอกสารชุดเดียวกัน.
ทำไม Fable ได้คะแนนต่ำกว่า?
การเรียกใช้ Fable หลายครั้งได้ใช้โทเค็นการเสร็จสิ้น แต่กลับส่งเนื้อหาที่แสดงผลมาไม่ครบถ้วนหรือว่างเปล่า ซึ่งอาจเป็นปัญหาเกี่ยวกับชั้นความเข้ากันได้หรือการแปลงข้อมูลเป็นรูปแบบสำหรับส่งออก.
สามารถใช้ทั้งสองรุ่นใน GlobalGPT ได้หรือไม่?
ใช่ครับ ทั้งสองเส้นทาง GlobalGPT ที่จัดไว้เฉพาะนั้นยังเปิดให้บริการอยู่เมื่อตรวจสอบเมื่อวันที่ 8 กันยายน 2026.
คำตัดสินสุดท้าย
GPT-6 Astra เป็นตัวเลือกเริ่มต้นที่ปลอดภัยกว่าจากชุดทดสอบนี้: มันให้ผลลัพธ์ที่ครบถ้วนและใช้งานได้มากกว่า และได้คะแนน 43/50 เทียบกับ 19/50 ส่วน Claude Fable 5.1 ยังคงเทียบเท่ากับ Astra ในงานวัดความแม่นยำของบริบทยาว และสร้างข้อความการตลาดที่มีคุณภาพดี ก่อนที่จะปฏิเสธ Fable ให้ทำซ้ำการทดสอบผ่านจุดปลายทาง (endpoint) ของระบบผลิตจริง; ผลลัพธ์ที่ว่างเปล่าสองครั้งถือเป็นคำเตือนเกี่ยวกับพฤติกรรมของการบูรณาการไม่แพ้พฤติกรรมของโมเดล.