
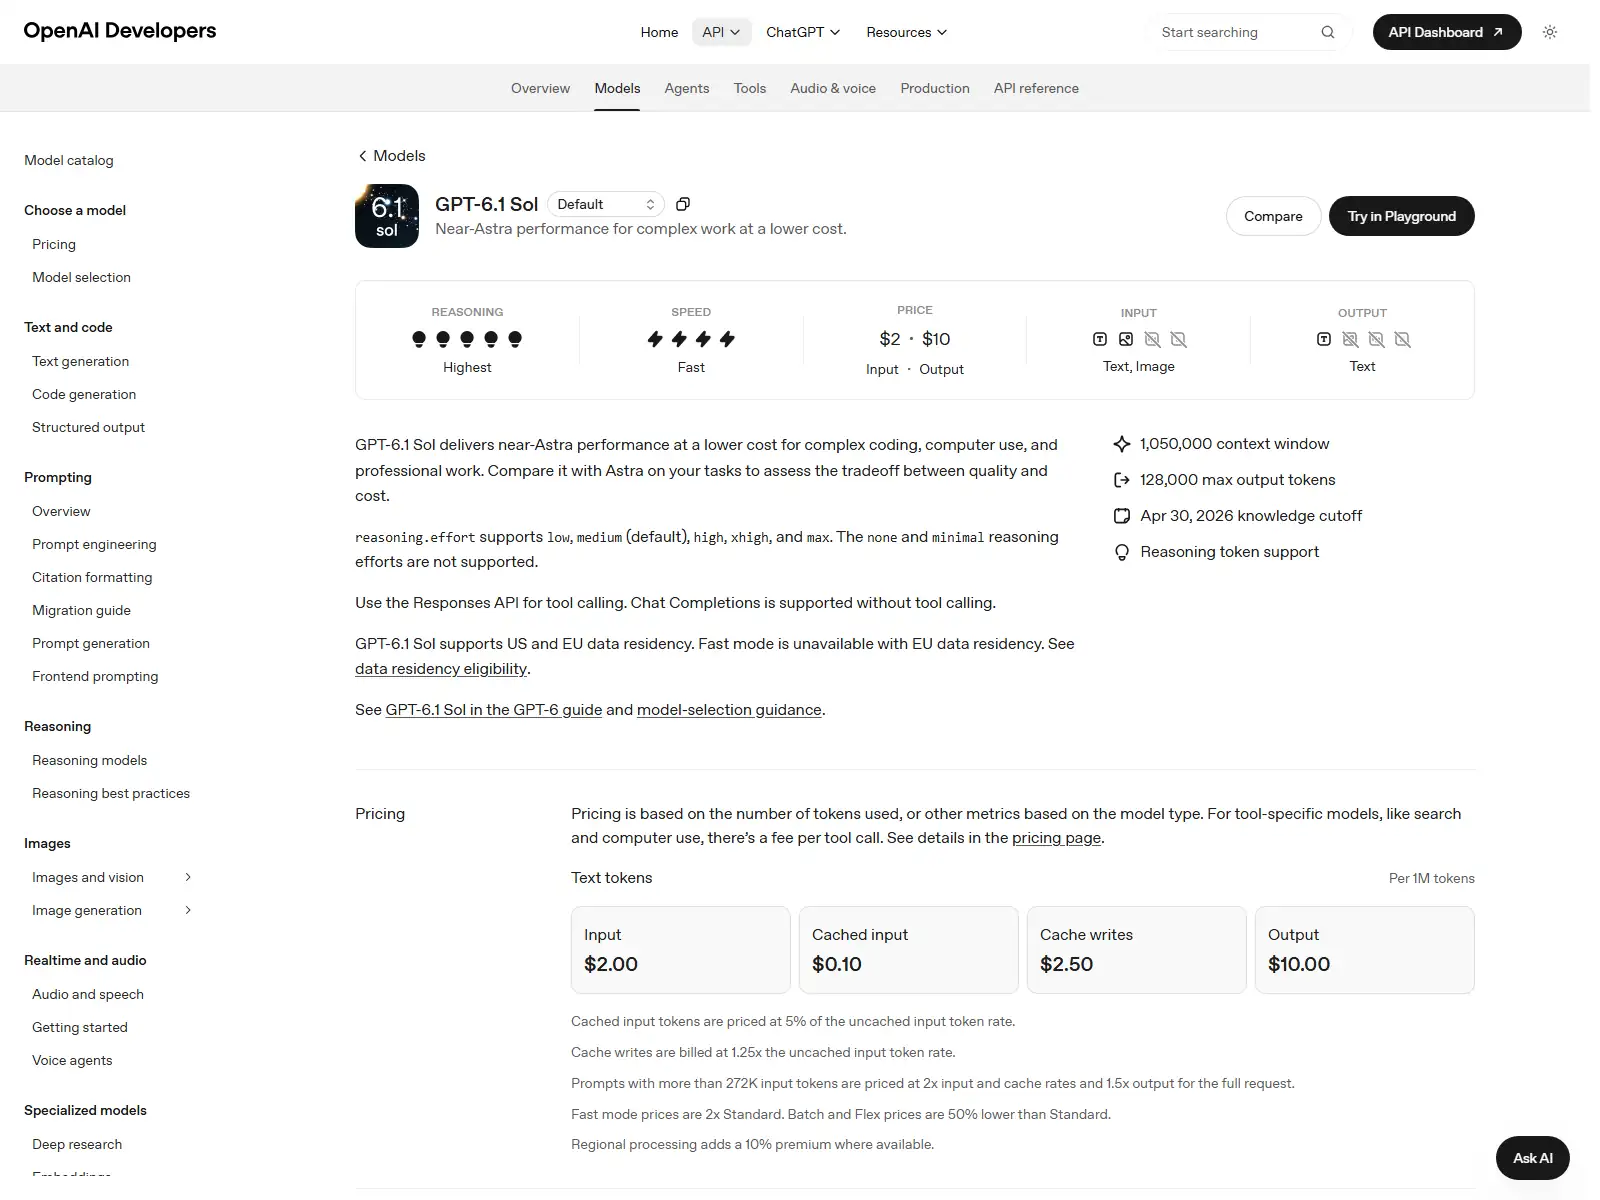
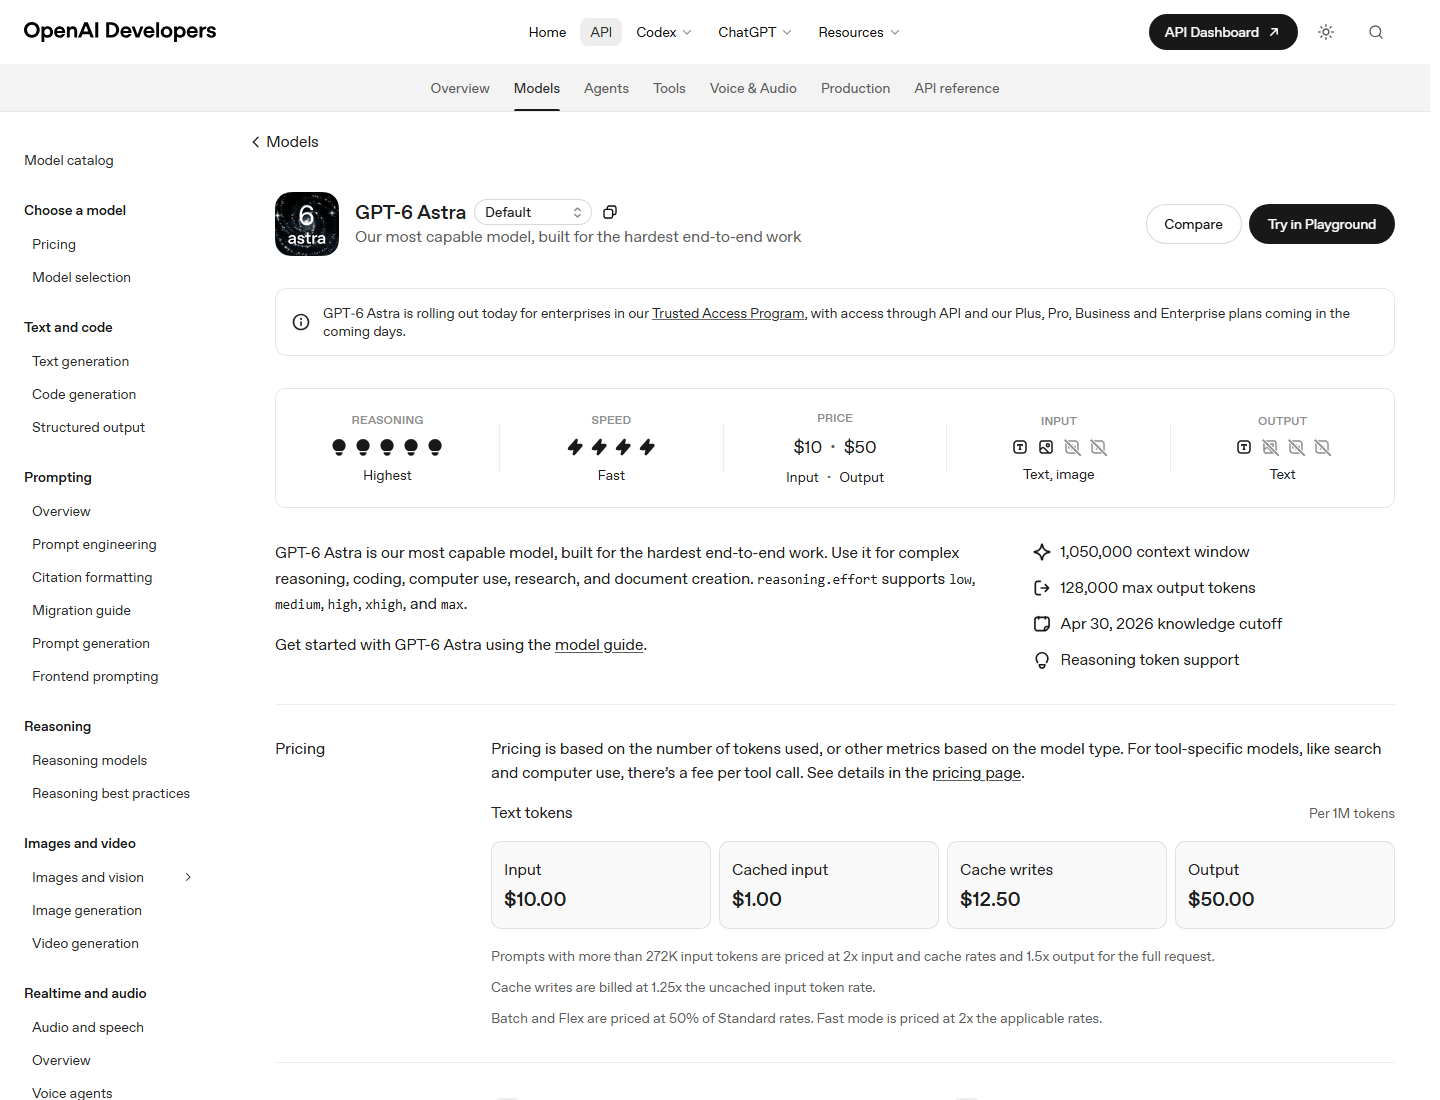
GPT-6.1 Sol เป็นค่าเริ่มต้น ส่วน GPT-6 Astra เป็นระดับคุณภาพสูงสุด. ทั้งสองต่างมีหน้าต่างบริบทขนาด 1,050,000 โทเคน ขีดจำกัดผลลัพธ์ 128,000 โทเคน การรับข้อมูลแบบหลายรูปแบบ และชุดเครื่องมือที่กว้างขวาง ความแตกต่างที่ชัดเจนอยู่ที่การวางตำแหน่งและราคา: Sol มีค่าใช้จ่าย $2 ต่อหนึ่งล้านโทเคนอินพุต และ $10 ต่อหนึ่งล้านโทเคนเอาต์พุต ส่วน Astra มีค่าใช้จ่าย $10 และ $50 กล่าวอีกนัยหนึ่ง Astra ต้องสร้างมูลค่าเพิ่มที่เพียงพอเพื่อพิสูจน์ว่าค่าใช้จ่ายในโทเคน Standard ที่สูงกว่าถึงห้าเท่านั้นมีความคุ้มค่า.
สิ่งนั้นไม่ได้ทำให้ Sol เป็น “รุ่นเดียวกันแต่ราคาถูกกว่า” OpenAI เรียก Astra เป็นรุ่นที่มีประสิทธิภาพสูงที่สุดสำหรับงาน end-to-end ที่ยากที่สุด และอธิบายว่า Sol มีประสิทธิภาพใกล้เคียงกับ Astra สำหรับงานที่ซับซ้อน แต่ด้วยต้นทุนที่ต่ำกว่า ดังนั้น การตัดสินใจที่ถูกต้องจึงเป็นเรื่องของการประเมิน ไม่ใช่การเปรียบเทียบอันดับแบรนด์ การเปรียบเทียบนี้ใช้ข้อมูลปัจจุบัน เอกสารประกอบ GPT-6.1 Sol, ที่ หน้าโมเดล GPT-6 Astra, และสถานการณ์ค่าใช้จ่ายที่เหมือนกัน ซึ่งได้รับการตรวจสอบเมื่อวันที่ 9 ตุลาคม 2026.
GPT-6.1 Sol vs GPT-6 Astra: การเปรียบเทียบแบบรวดเร็ว
ตารางนี้ช่วยให้การตัดสินใจขั้นแรกเป็นเรื่องง่าย: หากยังไม่มีหลักฐานเฉพาะสำหรับงานนั้น Sol ควรได้รับการทดลองใช้ก่อน เนื่องจากมันรักษาคุณสมบัติหลักของอินเทอร์เฟซและความสามารถไว้ได้ ในขณะที่ลดค่าใช้จ่ายของโทเคนลงอย่างมาก ส่วน Astra จะกลายเป็นตัวเลือกที่สมเหตุสมผลเมื่องานนั้นยากผิดปกติ ผลเสียจากการตอบผิดมีขนาดใหญ่ หรือผลลัพธ์ที่แม่นยำกว่าของมันช่วยหลีกเลี่ยงการต้องปรับแก้หลายรอบทั้งจากมนุษย์หรือโมเดล.
สิ่งนี้แตกต่างจากการเปรียบเทียบ Sol กับรุ่นที่มีขนาดเล็กและเร็ว คำแนะนำปัจจุบันของกลุ่มผลิตภัณฑ์ OpenAI วาง Sol ไว้ใกล้ระดับสูงสุด ไม่ใช่ระดับราคาต่ำสุด ผู้อ่านที่กำลังตัดสินใจเลือกระหว่างผลิตภัณฑ์ทั้งหมดในไลน์อัพยังสามารถใช้ คู่มือสู่โมเดล AI ที่ดีที่สุด และ บทวิจารณ์ GPT-6 Luna เพื่อทราบว่าเมื่อใดรุ่นที่เบากว่าก็เพียงพอแล้ว.
จุดร่วมระหว่าง GPT-6.1 Sol และ GPT-6 Astra
หน้าแบบอย่างอย่างเป็นทางการทั้งสองหน้าระบุหน้าต่างบริบท ปริมาณข้อมูลเข้าสูงสุด ปริมาณข้อมูลออกสูงสุด และขีดจำกัดความรู้ที่เหมือนกัน ทั้งสองแบบอย่างรับข้อมูลทั้งข้อความและภาพ และสร้างข้อความออกมา ไม่มีหน้าใดที่ระบุเสียงหรือวิดีโอเป็นข้อมูลเข้าหรือข้อมูลออกของโมเดลแบบดั้งเดิม ทั้งสองหน้ายังมีระดับความพยายามในการให้เหตุผลที่เหมือนกัน ได้แก่ ต่ำ (low), กลาง (medium), สูง (high), xสูง (xhigh) และสูงสุด (max) โดยระดับกลาง (medium) เป็นค่าเริ่มต้น ความสมมาตรนี้ช่วยให้การทดสอบ A/B ง่ายขึ้น เนื่องจากแอปพลิเคชันสามารถรักษาพารามิเตอร์คำขอส่วนใหญ่ให้คงที่ และเปลี่ยนเพียง ID ของโมเดลเท่านั้น.
ทั้งสองโมเดลสนับสนุนผลลัพธ์ที่มีโครงสร้าง การเรียกใช้ฟังก์ชัน การค้นหาบนเว็บ การค้นหาไฟล์ การสร้างภาพ เครื่องแปลโค้ด เชลล์ที่โฮสต์ การติดตั้งแพตช์ การใช้คอมพิวเตอร์ MCP ทักษะ และการค้นหาเครื่องมือ OpenAI ระบุการเรียกใช้เครื่องมือผ่าน Responses API ส่วน Chat Completions สามารถใช้งานได้เมื่อไม่เกี่ยวข้องกับเครื่องมือ การปรับแต่งละเอียด (fine-tuning) ไม่ได้รับการสนับสนุนบนหน้าของทั้งสองโมเดล นี่เป็นการประกาศความสามารถ ไม่ใช่คำสัญญาว่าทั้งสองโมเดลจะเลือกเครื่องมือด้วยความแม่นยำที่เท่ากัน.
หน้าต่างบริบทขนาดหนึ่งล้านโทเคนเป็นขีดจำกัดด้านความจุ ไม่ใช่การอนุญาตให้ละเลยการออกแบบระบบการเรียกข้อมูล คำขอที่ยาวมากจะมีค่าใช้จ่ายสูงขึ้น ยากต่อการแก้ไขข้อผิดพลาด และจะถูกคิดราคาตามขั้นราคาที่สูงกว่า 272K โทเคนข้อมูลเข้า การแบ่งเป็นชิ้นส่วน (chunking) การเรียกข้อมูล (retrieval) การสรุป (summaries) และการเก็บแคชคำสั่ง (prompt caching) ยังคงมีความสำคัญ คำเตือนเดียวกันนี้ใช้กับขีดจำกัดผลลัพธ์ 128K: ผลลัพธ์ที่ตรวจสอบได้ขนาดเล็กมักปลอดภัยกว่าการตอบกลับขนาดใหญ่เพียงครั้งเดียว.
ราคา: ช่องว่างห้าเท่า
ตามอัตราค่าบริการมาตรฐาน GPT-6.1 Sol มีค่าใช้จ่าย $2 ต่อหนึ่งล้านโทเคนข้อมูลเข้าที่ไม่ได้เก็บไว้ในแคช $0.10 สำหรับข้อมูลเข้าที่เก็บไว้ในแคช $2.50 สำหรับการเขียนข้อมูลเข้าแคช และ $10 สำหรับข้อมูลออก GPT-6 Astra มีค่าใช้จ่าย $10, $1, $12.50 และ $50 ตามลำดับ Sol มีค่าใช้จ่ายถูกกว่า 5 เท่า สำหรับข้อมูลเข้าที่ไม่ได้เก็บในแคช การเขียนข้อมูลเข้าในแคช และข้อมูลออก ส่วนข้อมูลเข้าที่เก็บในแคชมีค่าใช้จ่ายถูกกว่า 10 เท่า ตัวเลขปัจจุบันนี้มาโดยตรงจากหน้าโมเดลของ OpenAI และ เอกสารเกี่ยวกับราคา API.
อัตราที่ระบุในหัวข้อไม่ใช่ทั้งหมดของค่าใช้จ่าย เมื่อคำขอมีจำนวนโทเคนอินพุตเกิน 272K ระบบ OpenAI จะใช้อัตราอินพุตและแคชเป็นสองเท่าของอัตราปกติ และใช้อัตราเอาต์พุตเป็น 1.5 เท่าของอัตราปกติ สำหรับคำขอทั้งหมด Batch และ Flex มีราคาเท่ากับ 50% ของ Standard ส่วน Fast มีราคาเป็นสองเท่าของอัตราที่บังคับใช้ Astra ยังมีระดับ Ultrafast ให้เลือกด้วย ควรเปรียบเทียบสิ่งที่เทียบเคียงกันได้: คำขอ Sol Batch และคำขอ Astra Fast ไม่แสดงอัตราส่วนราคาต่อโมเดลที่อยู่เบื้องหลัง.
หากต้องการรายละเอียดเพิ่มเติมเกี่ยวกับระดับผลิตภัณฑ์หลัก โปรดดู คู่มือราคา GPT-6 Astra. ก่อนหน้านี้ การวิเคราะห์ราคาของ GPT-6 Sol มีประโยชน์เมื่อวางแผนการย้ายจากรุ่น Sol ก่อนหน้า แต่การประมาณการสำหรับการผลิตควรใช้ ID ของรุ่นปัจจุบันและอัตราปัจจุบันอย่างแม่นยำ.
การออกแบบในบริบทระยะยาว: ความจุเท่ากัน แต่หลักการทางเศรษฐกิจต่างกัน
หน้าต่างบริบทที่มีขนาดเท่ากันคือ 1,050,000 โทเคน อาจทำให้ Sol และ Astra ดูเหมือนสามารถใช้แทนกันได้สำหรับงานที่มีเอกสารจำนวนมาก แต่ความจุเป็นเพียงข้อจำกัดแรกเท่านั้น คำขอที่ใกล้ถึงขีดจำกัดยังคงต้องค้นหาหลักฐานที่ถูกต้อง แยกแยะคำสั่งออกจากเนื้อหาที่อ้างอิง รักษาความสัมพันธ์ระหว่างไฟล์ต่าง ๆ และส่งคืนผลลัพธ์ที่บุคคลหรือโปรแกรมสามารถตรวจสอบได้ โมเดลที่มีชื่อใหญ่กว่าไม่ได้ขจัดความจำเป็นในการจัดโครงสร้างข้อมูล จัดระเบียบแหล่งข้อมูล กำหนดขอบเขต และขอการอ้างอิงกลับไปยังตัวระบุเอกสารที่มั่นคง.
อัตราค่าใช้จ่ายที่ต่ำลงของ Sol ทำให้การทดลองในบริบทที่ยาวขึ้นกลายเป็นทางเลือกที่คุ้มค่าทางเศรษฐกิจ ทีมสามารถทดสอบกลยุทธ์การแบ่งข้อมูลเป็นชิ้นๆ หลายแบบ เกณฑ์การดึงข้อมูล และรูปแบบการสรุปข้อมูล ได้ด้วยค่าใช้จ่ายเพียงเท่ากับการรัน Astra ครั้งเดียว การค้นหาที่กว้างขึ้นนี้สามารถปรับปรุงระบบได้ แม้ Astra จะชนะในการทดสอบพรอมต์เพียงครั้งเดียว Astra จะมีความน่าสนใจมากขึ้นเมื่อกระบวนการทำงานมีความเสถียรแล้ว และข้อผิดพลาดที่ยังไม่ได้รับการแก้ไขนั้นเป็นข้อจำกัดของโมเดลอย่างแท้จริง ใน giaiบต้นของการพัฒนา การใช้งบประมาณทั้งหมดไปกับการเรียกใช้โมเดลหลักเพียงไม่กี่ครั้ง อาจให้ผลลัพธ์การเรียนรู้ที่น้อยกว่าการดำเนินการประเมิน Sol อย่างมีระเบียบในหลายกรณีที่เป็นตัวแทน.
ขีดจำกัด 272K ควรได้รับการติดตามอย่างชัดเจน คำขอที่มีโทเคนอินพุต 271K และคำขอที่มี 273K มีขนาดที่ใกล้เคียงกัน แต่คำขอที่สองจะทำให้คำขอทั้งหมดถูกจัดเข้าในแบนด์ที่สูงขึ้น สร้างการประมาณค่าโทเคนก่อนการประมวลผล (preflight) และบันทึกว่าแต่ละงานใช้แบนด์ใด หากข้อมูลเข้ามีขนาดเกินขีดจำกัดเพียงเล็กน้อย การลบส่วนโค้ดซ้ำ (boilerplate) ประวัติการสนทนาที่ล้าสมัย หรือข้อความที่ดึงมาซึ่งมีค่าต่ำ อาจช่วยลดค่าใช้จ่ายได้อย่างมีนัยสำคัญโดยไม่กระทบต่อคุณภาพ การปรับแต่งนี้ใช้ได้กับทั้งสองโมเดล แม้ว่าอัตราพื้นฐานที่สูงขึ้นของ Astra จะทำให้ข้อผิดพลาดมีค่าใช้จ่ายสูงขึ้น.
การเก็บข้อมูลในแคชแบบ Prompt มีประโยชน์มากที่สุดเมื่อส่วนนำ (prefix) ขนาดใหญ่คงที่ระหว่างการเรียก API ตัวอย่างเช่น คู่มือนโยบาย มาตรฐานการเขียนโค้ด แคตตาล็อกผลิตภัณฑ์ หรือโครงสร้างข้อมูลของเครื่องมือที่ใช้ร่วมกันโดยหลายงาน ให้จัดเนื้อหาที่คงที่ไว้ก่อน และคำสั่งที่เปลี่ยนแปลงได้ไว้ทีหลัง เมื่อพฤติกรรมการเก็บข้อมูลในแคชของ API รองรับการจัดวางดังกล่าว จากนั้นให้วัดจำนวนการเข้าถึงแคช (cache hits) แทนที่จะสมมติว่ามีอยู่ ข้อได้เปรียบของ Sol ในด้านข้อมูลนำเข้าที่ถูกเก็บไว้ในแคชมีขนาดใหญ่มาก แต่ส่วนนำที่เปลี่ยนแปลงอย่างต่อเนื่องสามารถทำให้ข้อได้เปรียบนี้หายไป การออกแบบแคชควรถูกรวมไว้ในรายงานการทดสอบประสิทธิภาพ (benchmark) พร้อมกับค่าความแม่นยำและเวลาตอบสนอง.
สำหรับการวิจัยและการวิเคราะห์เอกสาร ให้ใช้กระบวนการทำงานแบบเป็นขั้นตอน: ค้นหาหลักฐานที่มีความเป็นไปได้สูง ขอให้โมเดลสร้างแผนที่หลักฐานที่มีโครงสร้าง ตรวจสอบความถูกต้องของแหล่งอ้างอิง และเพียงหลังจากนั้นจึงขอให้โมเดลทำการสังเคราะห์ ใช้ Astra เมื่อการสังเคราะห์ยังคงมีคุณภาพต่ำแม้กระบวนการรวบรวมหลักฐานจะถูกต้องแล้ว หรือเมื่อชุดข้อมูลต้นทางมีความขัดแย้งที่ละเอียดอ่อนผิดปกติ สิ่งนี้ช่วยแยกความล้มเหลวในการค้นหาออกจากความล้มเหลวในการให้เหตุผล หากไม่มีการแยกนี้ ทีมงานมักต้องลงทุนในโมเดลที่มีประสิทธิภาพสูงกว่าเพื่อชดเชยปัญหาการสร้างบริบทที่สามารถหลีกเลี่ยงได้.
การเขียนโค้ดและการใช้เครื่องมือ
สำหรับการเขียนโค้ด คำถามที่มีประโยชน์ไม่ใช่ “โมเดลใดสามารถเขียนโค้ดได้?” เพราะทั้งสองโมเดลสามารถทำได้ คำถามคือ ความสามารถเพิ่มเติมของ Astra จะส่งผลให้ผลลัพธ์เปลี่ยนแปลงไปอย่างไร Sol มีจุดเด่นสำหรับงานในรีโพสิตอรีทั่วไป: การพัฒนาฟีเจอร์ที่มีขอบเขตชัดเจน การวินิจฉัยข้อผิดพลาดที่สามารถทำซ้ำได้ การตรวจสอบ pull request การเขียนการทดสอบ การแปลงข้อมูล และการรันลูปเครื่องมือแบบวนซ้ำ อัตราค่าใช้จ่ายที่ต่ำกว่าของ Sol ทำให้สามารถลองได้หลายครั้งมากขึ้น ตรวจสอบได้มากขึ้น และใช้ชุดข้อมูลประเมินผลที่ใหญ่ขึ้นได้ ด้วยงบประมาณเท่าเดิม.
Astra เหมาะที่สุดสำหรับงานที่ความไม่ชัดเจนและการประสานงานเป็นปัจจัยหลัก เช่น การย้ายระบบไปยัง monorepo ที่ยังไม่คุ้นเคย การตรวจสอบสถาปัตยกรรมที่มีความสำคัญด้านความปลอดภัย การใช้คอมพิวเตอร์ในระยะยาว การพอร์ตข้ามภาษาที่ซับซ้อน หรือเหตุการณ์ในระบบผลิตที่มีหลักฐานไม่ครบถ้วน โมเดลที่มีประสิทธิภาพสูงสุดอาจคุ้มค่ากับราคาที่สูงขึ้น เมื่อแผนที่ถูกต้องเพียงหนึ่งแผนสามารถช่วยประหยัดเวลาการทำงานซ้ำได้หลายชั่วโมง ของเรา โมเดล AI ที่ดีที่สุดสำหรับการเปรียบเทียบการเขียนโค้ด อธิบายว่าทำไมการทดสอบในรีโพสิตอรีจึงมีความสำคัญมากกว่าการประเมินการเขียนโค้ดแบบทั่วไป.
- คุณสมบัติที่กำหนดขอบเขตไว้อย่างชัดเจน พร้อมการทดสอบการยอมรับที่ชัดเจน
- การตรวจสอบข้อผิดพลาดและทบทวนโค้ดตามปกติ
- วงจรตัวแทนที่มีปริมาณสูง
- ร่างการย้ายระบบและการปรับปรุงโครงสร้าง
- การสร้างการทดสอบและการจัดทำเอกสาร
- ความผิดพลาดอย่างรุนแรงหลังจากพยายามใช้ Sol
- การเปลี่ยนแปลงด้านความปลอดภัยหรือข้อมูลที่มีความเสี่ยงสูง
- สถาปัตยกรรมข้ามระบบที่ไม่ชัดเจน
- งานที่ใช้คอมพิวเตอร์แบบอัตโนมัติเป็นเวลานาน
- การตรวจสอบขั้นสุดท้ายเมื่อความผิดพลาดมีราคาสูง
อย่าตัดสินทั้งสองโมเดลจากโค้ดที่ดูเพียงแต่เป็นไปได้ ให้ทั้งสองโมเดลใช้ snapshot ของ repository ที่เดียวกัน, คำแนะนำ, เครื่องมือ, งบประมาณเวลา และการทดสอบเดียวกัน บันทึกอัตราการผ่าน, การแก้ไขโดยมนุษย์, ความล้มเหลวในการเรียกใช้เครื่องมือ, จำนวน token, ความล่าช้า และค่าใช้จ่าย โมเดลที่มีค่าใช้จ่ายสูงกว่าห้าเท่าแต่ลดจำนวนความล้มเหลวลงครึ่งหนึ่งอาจมีความสมเหตุสมผล; ส่วนโมเดลที่ปรับปรุงสไตล์แต่ไม่ปรับปรุงอัตราการยอมรับนั้นไม่สมเหตุสมผล.
หลักฐานด้านประสิทธิภาพ: สิ่งที่เราสามารถและไม่สามารถสรุปได้
การกำหนดตำแหน่งของ OpenAI ให้ข้อสรุปที่แข็งแกร่งที่สุด: Astra เป็นโมเดลที่มีประสิทธิภาพสูงสุดสำหรับงานแบบ end-to-end ที่ยากที่สุด ส่วน GPT-6.1 Sol มุ่งเน้นให้ประสิทธิภาพใกล้เคียงกับ Astra สำหรับงานที่ซับซ้อน ด้วยต้นทุนที่ต่ำกว่า ข้อความเหล่านี้สนับสนุนสมมติฐานในการเลือกใช้ ไม่ใช่ช่องว่างเปอร์เซ็นต์ที่เป็นสากล ไม่มีเกณฑ์วัดประสิทธิภาพสาธารณะใดที่สามารถคาดการณ์ประสิทธิภาพการทำงานกับเอกสาร เครื่องมือ นโยบาย หรือฐานโค้ดเฉพาะของคุณได้.
วิดีโอเปิดตัวมีประโยชน์ในการเข้าใจว่าบริษัทนำเสนอผลิตภัณฑ์อย่างไร แต่ไม่ใช่การประเมินที่เป็นอิสระ เช่นเดียวกัน รีวิวจากผู้สร้างเนื้อหาแสดงอินเทอร์เฟซจริงและตัวอย่างที่มีประโยชน์ แต่แต่ละรีวิวสะท้อนถึงชุดคำสั่งเฉพาะ การตั้งค่าเครื่องมือ และกำหนดเวลาเผยแพร่ ควรพิจารณาภาพหน้าปกที่ดูดีหรือคำตัดสินจากบทรีวิวแรกเป็นจุดเริ่มต้นสำหรับแผนการทดสอบของคุณเอง ไม่ใช่หลักฐานว่า Astra หรือ Sol ชนะในทุกหมวดหมู่.
วิดีโออย่างเป็นทางการ OpenAI ข้างบนบันทึกภาพการเปิดตัวของ Astra ส่วนหน้าเว็บอิสระของ Matt Wolfe ข้างล่างแสดงให้เห็นว่าความสนใจจากฝ่ายที่สามได้มุ่งเน้นไปที่ขนาดของการเปิดตัวอย่างรวดเร็ว ทั้งสองภาพหน้าจอไม่ได้ถูกนำมาใช้ในบทความนี้เพื่อเป็นเกณฑ์วัดผลเชิงตัวเลข บทความนี้หลีกเลี่ยงอย่างตั้งใจที่จะแปลงความตื่นเต้น จำนวนการรับชม หรือชื่อของผู้สร้างเนื้อหา ให้กลายเป็นคะแนนประสิทธิภาพที่ไม่มีหลักฐานสนับสนุน.
การเปรียบเทียบที่มีคุณภาพจะใช้ชุดข้อมูลประเมินส่วนตัวที่คล้ายกับสภาพแวดล้อมจริง ให้รวมงานที่ง่าย งานทั่วไป และกรณีที่ล้มเหลวซึ่งมีค่าใช้จ่ายสูง เมื่อความชอบของมนุษย์มีบทบาทสำคัญ ให้ปิดบังผลลัพธ์ สำหรับเอเจนต์ ให้ทดสอบความสามารถในการเสร็จสิ้นงานและการกู้คืน แทนที่จะทดสอบการตอบสนองครั้งแรก OpenAI’s คำแนะนำในการเลือกแบบจำลอง ยังแนะนำให้เปรียบเทียบโมเดลในภารกิจที่เหมือนกัน และเลือกโมเดลที่มีน้ำหนักเบาที่สุดพร้อมทั้งความพยายามในการให้เหตุผลที่ผ่านเกณฑ์คุณภาพ.
วิธีดำเนินการประเมิน Sol vs Astra อย่างยุติธรรม
เริ่มด้วยการกำหนดการตัดสินใจที่การประเมินจะดำเนินการ “โมเดลใดฉลาดกว่า?” เป็นคำถามที่คลุมเครือเกินไป คำถามที่มีประโยชน์คือ “โมเดลใดควรรับผิดชอบการตรวจสอบ pull request สำหรับ repositori นี้ในระดับการให้เหตุผลระดับกลาง?” หรือ “การสังเคราะห์สัญญาขั้นสุดท้ายควรถูกส่งต่อจาก Sol ไปยัง Astra หรือไม่?” กำหนดกลุ่มงาน (task family), ระดับบริการ (service tier), ระดับความซับซ้อนในการให้เหตุผล (reasoning effort), เครื่องมือ (tools), ขีดจำกัดเวลา (time limit) และเกณฑ์การยอมรับ (acceptance criteria) ให้ชัดเจนก่อนที่จะสร้างผลลัพธ์ออกมา มิฉะนั้น ผลลัพธ์ที่ดีอาจถูกอธิบายได้จากการตั้งค่า (configuration) แทนที่จะเป็นโมเดล.
สร้างชุดข้อมูลที่มีขนาดใหญ่พอที่จะรวมกรณีทั่วไปและกรณีขอบที่มีความหมายได้ ตัวอย่าง 20 กรณีที่เลือกมาอย่างระมัดระวังสามารถเปิดเผยข้อผิดพลาดที่ชัดเจนได้ แต่นโยบายการจัดเส้นทางในระบบผลิตจริงมักต้องการข้อมูลเพิ่มเติม ใช้ตัวอย่างจากงานจริงล่าสุดหลังจากลบข้อมูลที่ละเอียดอ่อนแล้ว จากนั้นจัดประเภทแต่ละกรณีตามระดับความยากและความเสี่ยง เก็บชุดข้อมูลทดสอบ (holdout set) ที่ถูกล็อกไว้ เพื่อป้องกันไม่ให้การปรับแต่งแบบรวดเร็ว (prompt tuning) ทำให้เกิดการปรับตัวเกิน (overfitting) อย่างค่อยเป็นค่อยไปกับตัวอย่างที่ทุกคนได้เห็นแล้ว จัดเวอร์ชันชุดข้อมูลและตัวประเมิน (evaluator) เช่นเดียวกับที่คุณจัดเวอร์ชันโค้ดแอปพลิเคชัน.
ควรใช้การตรวจสอบแบบกำหนดค่าได้ (deterministic checks) เมื่อภารกิจอนุญาต ให้คอมไพล์โค้ด ดำเนินการทดสอบ ตรวจสอบความถูกต้องของ JSON ตามสคีมา เปรียบเทียบฟิลด์ที่สกัดได้กับป้ายกำกับ และตรวจสอบข้อความที่อ้างอิง ผู้ประเมินควรเน้นที่คุณสมบัติที่ระบบอัตโนมัติไม่สามารถจับได้อย่างดี เช่น ความชัดเจน การใช้ดุลยพินิจ และว่าคำแนะนำนั้นสอดคล้องกับบริบททางธุรกิจหรือไม่ ให้ซ่อนตัวตนของโมเดลและจัดเรียงลำดับผลลัพธ์แบบสุ่ม หากผู้ประเมินรู้ว่าคำตอบใดมาจาก Astra ราคาและชื่อเสียงอาจส่งผลต่อคะแนนได้โดยที่ไม่มีใครมีเจตนาที่จะลำเอียง.
ติดตามระดับความรุนแรง ไม่ใช่เพียงค่าเฉลี่ยเท่านั้น ข้อได้เปรียบด้านรูปแบบ 10 ข้อที่เล็กน้อยไม่ควรมีน้ำหนักมากกว่าคำแนะนำหนึ่งข้อที่อาจก่อให้เกิดการสูญเสียข้อมูลอย่างรุนแรง กำหนดเงื่อนไขการปฏิเสธอย่างเด็ดขาด เช่น การอ้างอิงที่สร้างขึ้นเอง คำสั่งที่ไม่ปลอดภัย ช่องข้อมูลที่จำเป็นขาดหายไป หรือการไม่ปฏิบัติตามข้อจำกัดทางกฎหมาย รายงานการกระจายตามระดับความยากและประเภทความเสี่ยง Sol อาจมีประสิทธิภาพเทียบเท่า Astra ในงานปกติ และตามหลังเพียงใน 5% ที่ยากที่สุดเท่านั้น; ผลลัพธ์นี้สนับสนุนอย่างชัดเจนให้ใช้ router แทนการย้ายระบบแบบทั้งหมดหรือไม่มีเลย.
สุดท้าย ให้คำนวณความไม่แน่นอนและรันกรณีที่ไม่เสถียรใหม่ ผลลัพธ์ของโมเดลอาจแตกต่างกันได้ ดังนั้นการเปรียบเทียบเพียงครั้งเดียวอาจทำให้ความโชคดีดูเกินจริง ให้ทำซ้ำชุดข้อมูลย่อย ตรวจสอบความไม่สอดคล้องกันระหว่างผู้ประเมิน และเก็บรักษาผลลัพธ์ดิบไว้เพื่อการตรวจสอบ คำแนะนำสุดท้ายควรระบุวันที่ทดสอบ รหัสโมเดล การตั้งค่า เวอร์ชันชุดข้อมูล ราคาที่ใช้ และช่องว่างที่ทราบ ตรวจสอบอีกครั้งหลังจากอัปเดตโมเดล เปลี่ยนแปลงพรอมต์ หรือมีการเปลี่ยนแปลงอย่างมีนัยสำคัญในปริมาณงาน การเลือกโมเดลเป็นการตัดสินใจในการผลิตที่ต้องดูแลรักษา ไม่ใช่รางวัลถาวร.
อย่าปล่อยให้ผู้ประเมินกลายเป็นโมเดลตัดสินใจที่ซ่อนอยู่ หากผู้ตัดสินอัตโนมัติมีแนวโน้มที่จะเลือกผลลัพธ์หนึ่งอย่างชัดเจน ให้สุ่มตัวอย่างการตัดสินใจเหล่านั้นเพื่อผู้เชี่ยวชาญตรวจสอบ และเปรียบเทียบผู้ตัดสินกับผลการยอมรับที่ชัดเจน แยกคุณภาพการนำเสนอออกจากความถูกต้องของงาน: การอธิบายที่สมบูรณ์แบบอาจปกปิดข้อกำหนดที่ล้มเหลวได้ ในขณะที่คำตอบที่สั้นกระชับอาจผ่านการทดสอบทุกข้อ นอกจากนี้ ให้รายงานการงดออกเสียงและผลเสมอแทนที่จะบังคับให้มีผู้ชนะ รายละเอียดเหล่านี้ทำให้ผลลัพธ์ดูไม่น่าตื่นเต้นเท่าไรนัก แต่มีประโยชน์มากกว่ามากสำหรับการจัดงบประมาณและการกำหนดเส้นทาง เป้าหมายคือกฎการดำเนินงานที่สามารถทำซ้ำได้ ซึ่งสมาชิกทีมอื่นสามารถตรวจสอบและทำซ้ำได้ ให้บันทึกผลลัพธ์ที่ถูกปฏิเสธด้วย; ตัวอย่างความล้มเหลวมักอธิบายขอบเขตการกำหนดเส้นทางได้ชัดเจนกว่าตารางคะแนนเฉลี่ย.
ตัวอย่างค่าใช้จ่ายจริง
พิจารณาการทำงานของตัวแทนการเขียนโค้ด (coding-agent) ที่ใช้โทเคนข้อมูลเข้า 200,000 โทเคนที่ยังไม่ถูกเก็บไว้ในแคช และโทเคนข้อมูลออก 20,000 โทเคน Sol มีค่าใช้จ่ายประมาณ $0.60: $0.40 สำหรับข้อมูลเข้า และ $0.20 สำหรับข้อมูลออก Astra มีค่าใช้จ่ายประมาณ $3.00: $2.00 บวก $1.00 เมื่อดำเนินการ 10,000 ครั้ง ความแตกต่างอยู่ที่ประมาณ $24,000 ก่อนหักค่าธรรมเนียมเครื่องมือ การเก็บในแคช การปรับเพิ่มตามภูมิภาค หรือการปรับระดับบริการ.
ตอนนี้ให้พิจารณาคำขอที่มีบริบทยาว ซึ่งมีโทเคนอินพุต 300,000 โทเคน และโทเคนเอาต์พุต 30,000 โทเคน เนื่องจากจำนวนอินพุตเกิน 272K จึงใช้อัตราที่สูงขึ้นกับคำขอทั้งหมด อัตราอินพุตที่มีผลของ Sol จะกลายเป็น $4 ต่อหนึ่งล้าน และอัตราเอาต์พุตจะกลายเป็น $15 ซึ่งให้ผลลัพธ์ประมาณ $1.65 Astra มีอัตราเข้าเป็น $20 และอัตราออกเป็น $75 ซึ่งให้ผลรวมประมาณ $8.25 ความสัมพันธ์ 5 เท่ายังคงอยู่ แต่ความแตกต่างในค่าสัมบูรณ์เพิ่มขึ้น.
การเก็บในแคชสามารถทำให้การคำนวณย้ายไปทาง Sol ได้มากขึ้น เนื่องจากอัตราการรับข้อมูลจากแคชของ Sol เป็นหนึ่งในสิบของ Astra สิ่งนี้มีความสำคัญต่อคำสั่งระบบที่เสถียร การอ้างอิงซ้ำๆ ในปริมาณมาก และการสร้างโครงสร้างพื้นฐานของเอเจนต์ อย่างไรก็ตาม การเขียนข้อมูลลงในแคชยังคงมีค่าใช้จ่าย และการเปลี่ยนคำนำหน้าอาจทำให้การนำกลับมาใช้ใหม่ลดลง ควรประเมินจากบันทึกการใช้งานจริง แทนที่จะสมมติว่าทุกโทเคนจะได้รับอัตราการแคชเท่ากัน.
วิธีเปรียบเทียบรุ่นต่าง ๆ ใน API
ใช้ API Responses สำหรับแอปพลิเคชันที่ใช้เครื่องมือ และรักษาการตั้งค่าการเปรียบเทียบให้เหมือนกัน ชุดทดสอบที่เรียบง่ายที่สุดแต่มีประโยชน์จะส่งข้อมูลเข้าเดียวกันไปยังทั้งสอง ID ของโมเดล บันทึกข้อมูลเมตาดาต้าของคำตอบ และเรียกใช้ตัวประเมินเดียวกัน อย่าเปิดเผยกุญแจ API ในโค้ดแหล่งต้น; ให้ใช้ตัวแปรสภาพแวดล้อมและเครื่องมือจัดการข้อมูลลับที่คุณใช้ปกติ.
ตัวอย่างนี้มีขนาดเล็กโดยตั้งใจ ระบบฮาร์เนสสำหรับการผลิตควรบันทึก ID คำขอ เวอร์ชันของตัวประเมิน การคอมมิตในรีโพซิทอรี ข้อมูลการติดตามของเครื่องมือ จำนวนการลองใหม่ และผลการยอมรับ นอกจากนี้ ยังควรคำนวณราคาจากระดับบริการและช่วงบริบทยาวที่ใช้งานจริง หลีกเลี่ยงการให้โมเดลหนึ่งเห็นข้อมูลย้อนกลับที่โมเดลอื่นไม่ได้รับ เว้นแต่คุณกำลังทดสอบลำดับการกำหนดเส้นทางอย่างชัดเจน.
กลยุทธ์การกำหนดเส้นทางจาก Sol ไปยัง Astra ที่ใช้งานได้จริง
ระบบรูเตอร์สองขั้นตอนช่วยจับประเด็นทางเศรษฐกิจที่แข็งแกร่งที่สุดสำหรับ Sol โดยไม่สมมติว่าทุกคำสั่งมีค่าเท่ากัน ส่งการจราจรปกติไปยัง Sol ด้วยระดับการให้เหตุผลระดับกลาง ให้ยกระดับการตรวจสอบเมื่อการทดสอบแบบกำหนดผลลัพธ์ล้มเหลว โมเดลรายงานความมั่นใจต่ำ งานนั้นอยู่ในหมวดหมู่ความเสี่ยงสูง หรือมีมนุษย์ขอให้ตรวจสอบโดยทีมงานหลักอย่างชัดเจน ให้กฎการยกระดับการตรวจสอบสามารถตรวจสอบได้ เพื่อป้องกันไม่ให้ค่าใช้จ่ายเพิ่มขึ้นอย่างเงียบๆ.
ใช้คำสั่ง เครื่องมือ และทดสอบการยอมรับเดียวกัน.
การทดสอบ ความมั่นใจ ระดับความเสี่ยง และการตรวจสอบโดยมนุษย์.
ส่งงานที่ล้มเหลวหรืองานที่มีความเสี่ยงสูงไปยัง Astra.
ติดตามการรับมอบงาน การปรับปรุงใหม่ ความล่าช้า และค่าใช้จ่ายรวม.
การกำหนดเส้นทางยังช่วยให้ทีมสามารถอัปเดตค่าเริ่มต้นได้อย่างมีระบบ หากอัตราการยอมรับของ Sol ในกลุ่มงานใดดีขึ้น ก็ควรเพิ่มสัดส่วนการใช้งานของกลุ่มงานนั้น หาก Astra สามารถป้องกันข้อบกพร่องที่มีค่าใช้จ่ายสูงได้อย่างต่อเนื่อง ก็ควรกำหนดเส้นทางให้หมวดหมู่นั้นโดยตรง การเปรียบเทียบนี้จึงกลายเป็นนโยบายการดำเนินงานที่ได้รับการสนับสนุนจากข้อมูล แทนที่จะเป็นการอภิปรายแบบครั้งเดียวเกี่ยวกับโมเดล สำหรับข้อมูลอ้างอิงจากรุ่นก่อนหน้า โปรดดู GPT-6 Astra เทียบกับ GPT-5.6 Sol.
ความล่าช้าและความน่าเชื่อถือควรอยู่ในนโยบายการกำหนดเส้นทางเดียวกัน โมเดลอาจให้คำตอบที่แข็งแกร่งกว่า แต่ยังคงเป็นค่าเริ่มต้นที่ผิด หากเวลาตอบสนองของมันทำให้กระบวนการทำงานแบบโต้ตอบถูกขัดจังหวะ หรือการวิเคราะห์ที่ใช้เวลานานเกินไปทำให้งานหมดเวลา วัดความล่าช้าของโทเค็นแรก ระยะเวลาทั้งหมด การกู้คืนหลังการเรียกเครื่องมือ และการเสร็จสิ้นอย่างสำเร็จภายใต้สภาวะการทำงานพร้อมกันที่สมจริง จากนั้นกำหนดวัตถุประสงค์ของบริการสำหรับแต่ละประเภทงาน Sol สามารถรับผิดชอบการรับส่งข้อมูลในระบบผลิตที่เน้นความเร็ว ในขณะที่ Astra จัดการการตรวจสอบแบบไม่พร้อมกัน หรือสามารถปรับเปลี่ยนเป็นทางตรงกันข้ามได้หากงานที่ยากมักล้มเหลวก่อนที่จะส่งต่อไปยังระดับที่สูงขึ้น การตัดสินใจของโมเดลเป็นการตัดสินใจเชิงปฏิบัติการ ไม่ใช่เพียงการตัดสินใจเชิงบรรณาธิการ.
ใครควรเลือก Sol และใครควรเลือก Astra?
เลือก GPT-6.1 Sol สำหรับการผลิตที่คำนึงถึงค่าใช้จ่าย
Sol เหมาะสำหรับทีมผลิตภัณฑ์ เอเจนซี นักวิจัย และนักพัฒนา ที่ต้องจัดการกับปริมาณงานที่ซับซ้อนและจำนวนมาก แต่ยังคงมีเกณฑ์การยอมรับที่สามารถวัดได้ ระบบนี้มีความน่าสนใจเป็นพิเศษเมื่อกระบวนการทำงานรวมถึงการวนซ้ำ (iteration): วงจรเขียนโค้ด-ทดสอบ-แก้ไข, การแก้ไขเอกสาร, การสกัดข้อมูลพร้อมการตรวจสอบความถูกต้อง, การสังเคราะห์ผลการวิจัย, และเอเจนต์ภายในที่มีหลายขั้นตอน ราคาที่ต่ำกว่าช่วยให้สามารถขยายขอบเขตการประเมินได้มากขึ้น และมีงบประมาณสำหรับการลองใหม่ได้มากขึ้น.
เลือก GPT-6 Astra สำหรับงานที่ยากที่สุดและต้องการคุณภาพสูง
Astra เหมาะสำหรับทีมที่มีงานท้าทายที่สุดซึ่งมีค่าใช้จ่ายจากข้อผิดพลาดสูง หรือระบบตรวจสอบอัตโนมัติที่ยังไม่สมบูรณ์ การตัดสินใจด้านสถาปัตยกรรมที่ซับซ้อน การตรวจสอบความปลอดภัยขั้นสุดท้าย งานวิเคราะห์ทางวิทยาศาสตร์ที่ยังไม่เคยมีมาก่อน หรือกระบวนการใช้งานคอมพิวเตอร์ที่ยาวนาน ล้วนเป็นเหตุผลที่เพียงพอที่จะลงทุนในรุ่นเรือธง นอกจากนี้ ยังเป็นตัวเลือกเริ่มต้นที่ชัดเจนที่สุดในช่วงการค้นพบเบื้องต้น เมื่อทีมยังไม่ทราบว่าโมเดลขนาดเล็กกว่าอาจพลาดข้อมูลใด และค่าใช้จ่ายยังไม่เป็นข้อจำกัดในทันที.
ใช้ทั้งสองวิธีเมื่อระดับความยากของงานแตกต่างกัน
ระบบที่พัฒนาแล้วส่วนใหญ่ไม่ควรบังคับใช้โมเดลเดียวกับทุกคำขอ ควรใช้ Sol สำหรับงานหลักในส่วนกลาง และ Astra เป็นชั้นการส่งต่อกรณีที่ซับซ้อน เพิ่ม Luna หรือโมเดลขนาดเล็กอื่น ๆ เพื่อการจำแนกประเภทและการแปลงข้อมูลที่คาดการณ์ได้ การออกแบบแบบชั้นนี้สะท้อนความหลากหลายของปริมาณงานจริง และมักประหยัดกว่าการถกเถียงเพื่อหาผู้ชนะเพียงหนึ่งเดียวที่คงอยู่ตลอดไป ของเรา วิธีการทดสอบแบบจำลอง ให้กรอบงานที่มีประโยชน์ในการแยกหลักฐานที่สามารถทำซ้ำได้ออกจากความประทับใจ.
วิธีใช้ GPT-6.1 Sol และ GPT-6 Astra บน GlobalGPT
GlobalGPT ให้บริการเส้นทางผลิตภัณฑ์แบบเรียลไทม์สำหรับทั้งสองโมเดลภายในพื้นที่ทำงานแบบหลายโมเดลเดียว เปิดพื้นที่ทำงาน เริ่มการสนทนาใหม่ และตรวจสอบตัวเลือกโมเดลปัจจุบันสำหรับ GPT-6.1 Sol หรือ GPT-6 Astra การรวมทั้งสองโมเดลไว้ในอินเทอร์เฟซเดียวมีประโยชน์สำหรับการทำงานเชิงสำรวจแบบเปรียบเทียบกัน ในขณะที่การประเมิน API ยังคงเป็นวิธีที่ดีที่สุดสำหรับการให้คะแนนอัตโนมัติ การบันทึกการใช้งานอย่างแม่นยำ และการควบคุมการปรับใช้.
เริ่มด้วย Sol ในรอบแรก แล้วรันคำสั่งที่ยากที่สุดอีกครั้งด้วย Astra และเปรียบเทียบว่ามีการเปลี่ยนแปลงอะไรที่สำคัญ.
เปิด GlobalGPTหากต้องการข้อมูลพื้นฐานที่ลึกซึ้งยิ่งขึ้นเกี่ยวกับรุ่นเฉพาะ โปรดอ่านบทความของเรา คู่มือ GPT-6.1 Sol และ รีวิว GPT-6 Astra. หน้าเหล่านั้นอธิบายแต่ละรุ่นอย่างละเอียด ส่วนหน้านี้จะเน้นไปที่การตัดสินใจซื้อและการเลือกเส้นทางระหว่างรุ่นต่าง ๆ.
คำถามที่พบบ่อย
GPT-6.1 Sol ดีกว่า GPT-6 Astra หรือไม่?
ไม่ใช่ในแง่สัมบูรณ์ OpenAI จัดให้ GPT-6 Astra เป็นโมเดลที่มีประสิทธิภาพสูงสุด และ GPT-6.1 Sol เป็นโมเดลที่มีราคาถูกกว่า แต่มีประสิทธิภาพใกล้เคียงกับ Astra สำหรับงานที่ซับซ้อน Sol เป็นตัวเลือกที่คุ้มค่ากว่าหากผ่านเกณฑ์คุณภาพของคุณ ส่วน Astra เป็นตัวเลือกที่ปลอดภัยกว่าและให้ความสำคัญกับคุณภาพเป็นอันดับแรก สำหรับงานที่ยากที่สุด.
GPT-6.1 Sol ถูกกว่า GPT-6 Astra เท่าไร?
ตามอัตราค่าบริการมาตรฐาน Sol มีค่าใช้จ่าย $2 ต่อหนึ่งล้านโทเคนเข้า และ $10 ต่อหนึ่งล้านโทเคนออก ส่วน Astra มีค่าใช้จ่าย $10 และ $50 ดังนั้น Sol จึงมีค่าใช้จ่ายถูกกว่า Astra ถึง 5 เท่า สำหรับข้อมูลเข้าและข้อมูลออกที่ไม่ได้เก็บไว้ในแคช ส่วนราคาข้อมูลเข้าที่เก็บไว้ในแคชของ Sol ที่ $0.10 นั้น เป็นเพียงหนึ่งในสิบของอัตรา $1 ของ Astra.
GPT-6.1 Sol และ GPT-6 Astra มีหน้าต่างบริบทที่เหมือนกันหรือไม่?
ใช่ครับ OpenAI ระบุว่ามีหน้าต่างบริบท (context window) ขนาด 1,050,000 โทเคน ปริมาณข้อมูลเข้าสูงสุด 922,000 โทเคน และปริมาณข้อมูลออกสูงสุด 128,000 โทเคน สำหรับทั้งสองโมเดล คำขอที่มีปริมาณข้อมูลเข้าเกิน 272K โทเคน จะถูกย้ายไปยังอัตราบริบทยาวที่สูงขึ้น.
รุ่นไหนดีกว่าสำหรับการเขียนโค้ด?
Astra เป็นตัวเลือกที่เน้นคุณภาพเป็นอันดับแรก สำหรับงานที่เกี่ยวข้องกับรีโพสิตอรีที่มีความยากเป็นพิเศษ ไม่ชัดเจน หรือมีความเสี่ยงสูง ส่วน Sol เป็นตัวเลือกมาตรฐานที่ใช้งานได้จริงสำหรับงานพัฒนาฟีเจอร์ประจำวัน การแก้ไขข้อผิดพลาด การตรวจสอบโค้ด และวงจรการทำงานของเอเจนต์ เนื่องจากค่าใช้จ่ายที่ต่ำกว่าทำให้สามารถดำเนินการซ้ำได้หลายครั้งมากขึ้น ให้ลองใช้ทั้งสองระบบกับชุดทดสอบของรีโพสิตอรีเดียวกันก่อนที่จะกำหนดมาตรฐาน.
ทั้งสองรุ่นนี้รองรับเครื่องมือและข้อมูลภาพหรือไม่?
ใช่ครับ หน้าโมเดลอย่างเป็นทางการของพวกเขาระบุไว้ว่ามีการรับข้อมูลแบบข้อความและภาพ การส่งออกข้อความ ผลลัพธ์ที่มีโครงสร้าง การเรียกฟังก์ชัน การค้นหาบนเว็บ การค้นหาไฟล์ เครื่องแปลโค้ด เชลล์ที่โฮสต์ การติดตั้งแพตช์ การใช้คอมพิวเตอร์ MCP ทักษะ และการค้นหาเครื่องมือ การเรียกเครื่องมือควรใช้ Responses API.
เมื่อไหร่ผมควรชำระค่าบริการ GPT-6 Astra?
ใช้ Astra เมื่อข้อผิดพลาดอาจก่อให้เกิดค่าใช้จ่ายสูง งานนั้นอยู่ในระดับที่ท้าทายอย่างแท้จริง หรือการประเมินที่เทียบเคียงกันแสดงให้เห็นว่าคุณภาพเพิ่มเติมของมันช่วยลดการทำงานซ้ำได้มากพอที่จะคุ้มค่ากับราคาโทเคนที่สูงกว่าห้าเท่า ตัวอย่างเช่น การย้ายระบบที่สำคัญ การใช้ระบบคอมพิวเตอร์อัตโนมัติที่ซับซ้อน และการตรวจสอบขั้นสุดท้ายของผลงานที่มีความสำคัญสูง.
ฉันควรเลือกวิธีการวิเคราะห์แบบใด?
เริ่มต้นที่ระดับกลาง ซึ่งเป็นค่าเริ่มต้นที่ระบุไว้สำหรับทั้งสองรุ่น ปรับลงเมื่อต้องการการแปลงที่เรียบง่าย และปรับขึ้นเฉพาะเมื่อความยากของงานหรือค่าใช้จ่ายจากข้อผิดพลาดต้องการเท่านั้น การตั้งค่าที่มีประสิทธิภาพคือระดับที่ใช้ความพยายามน้อยที่สุดแต่สามารถผ่านการทดสอบการยอมรับได้อย่างสม่ำเสมอ.
ผมสามารถใช้ GPT-6.1 Sol และ GPT-6 Astra บน GlobalGPT ได้ไหมครับ?
GlobalGPT มีเส้นทางแบบเรียลไทม์สำหรับทั้ง GPT-6.1 Sol และ GPT-6 Astra ในพื้นที่ทำงานแบบหลายโมเดล ความพร้อมใช้งานอาจแตกต่างกันไปตามบัญชีและอินเทอร์เฟซ ดังนั้น โปรดเปิดพื้นที่ทำงานและตรวจสอบตัวเลือกโมเดลปัจจุบันก่อนเริ่มกระบวนการทำงานในสภาพแวดล้อมการผลิต.
ผมควรส่งทุกคำสั่งไปยังโมเดลเดียวหรือไม่?
โดยทั่วไปแล้วไม่ใช่ครับ เราเตอร์แบบเรียบง่ายสามารถส่งงานปกติไปยัง Sol และส่งต่อกรณีที่มีความมั่นใจต่ำ กรณีที่ผ่านการทดสอบไม่สำเร็จ หรือกรณีที่มีความเสี่ยงสูงไปยัง Astra ได้ ซึ่งวิธีนี้ช่วยรักษาข้อได้เปรียบด้านต้นทุนของ Sol ได้ส่วนใหญ่ พร้อมทั้งเก็บ Astra ไว้สำหรับคำสั่งที่ความสามารถส่วนเพิ่มมีมูลค่าที่วัดได้.
คำตัดสินสุดท้าย
GPT-6.1 Sol ควรเป็นโมเดลแรกที่ทีมที่ให้ความสำคัญกับค่าใช้จ่ายมากที่สุดควรพิจารณา; ส่วน GPT-6 Astra ควรยังคงเป็นเป้าหมายสำหรับการปรับระดับขึ้นเมื่อต้องทำงานที่ยากที่สุด. บริบทที่ใช้ร่วมกัน ข้อจำกัดด้านผลลัพธ์ รูปแบบการทำงาน ระบบควบคุมการให้เหตุผล และแคตตาล็อกเครื่องมือ ทำให้การเปรียบเทียบครั้งนี้ชัดเจนเป็นพิเศษ Sol ให้ข้อได้เปรียบด้านเศรษฐกิจ ส่วน Astra มีข้อได้เปรียบด้านความสามารถอย่างเป็นทางการ.
ตัวชี้วัดที่ 결정สำคัญไม่ใช่เพียงราคาโทเคนหรือชื่อเสียงของโมเดลเท่านั้น แต่ควรวัดต้นทุนต่อผลลัพธ์ที่ได้รับการยอมรับภายใต้ข้อจำกัดในการดำเนินงานจริงและงบประมาณที่มีอยู่ หาก Sol ผ่านเกณฑ์ด้วยอัตราที่คล้ายกัน อัตราการรับข้อมูลเข้าและส่งออกที่ไม่ถูกเก็บไว้ในแคชที่ต่ำกว่าถึงห้าเท่าของมัน ก็ยากที่จะมองข้ามได้ หาก Astra สามารถป้องกันความล้มเหลว ลดความจำเป็นในการตรวจสอบโดยผู้เชี่ยวชาญ หรือแก้ปัญหาที่ Sol ไม่สามารถทำได้ ค่าพรีเมียมดังกล่าวก็อาจถือเป็นเรื่องที่สมเหตุสมผล เริ่มต้นด้วยงานที่เหมือนกัน รักษาการประเมินแบบไม่เปิดเผยข้อมูลเท่าที่เป็นไปได้ และส่งเสริมเฉพาะโมเดลและกระบวนการให้เหตุผลที่สมควรได้รับตำแหน่งนั้น.









