 Chloe Murphy
ไฮโดรเจน
เวลาที่สังเกตได้55.21 วินาทีโทเค็นอินพุต4,273โทเค็นเอาต์พุต8,243
การประเมินเอาต์พุต
ถูกต้อง: A+C+D ต้นทุน 16 มูลค่า 31 และระบุ A+C+E เป็นพอร์ตโฟลิโออื่นเดียวที่เป็นไปได้ซึ่งมีมูลค่าอย่างน้อย 30
เราเปรียบเทียบเกณฑ์มาตรฐานที่ Google เผยแพร่และราคา API จากนั้นทดสอบทั้งสามโมเดลในงานที่เหมือนกันพร้อมผลลัพธ์ที่ตรวจสอบแล้ว พร้อมต์ เวลา และการใช้โทเค็น

Hydrogen มีราคาโทเค็นอย่างเป็นทางการต่ำที่สุด Carbon มุ่งเป้าไปที่การให้เหตุผลเชิงลึกที่สุด Argon สร้างสมดุลระหว่างการให้เหตุผลล้ำสมัยและประสิทธิภาพ ทั้งสามโมเดลผ่านงานที่เสร็จสมบูรณ์สี่งานของเรา การทดสอบโค้ดที่ยากที่สุดเผยให้เห็นความแตกต่างในการจัดรูปแบบและคำอธิบายมากกว่าผู้ชนะด้านความถูกต้อง
Google มีโมเดล Gemini 4 สามรุ่นซึ่งชื่อแทบไม่บอกว่าควรเลือกตัวไหน คุณควรเริ่มด้วย Hydrogen ใช้ Argon สำหรับงานที่ต้องใช้ความพยายาม หรือจ่ายเงินเพื่อการให้เหตุผลเชิงลึกของ Carbon?
การเปรียบเทียบที่มีประโยชน์คือความสามารถต่องาน: แต่ละโมเดลแก้ปัญหาอะไรได้บ้าง ใช้การให้เหตุผลมากน้อยเพียงใด และคำตอบที่เสร็จสมบูรณ์มีค่าใช้จ่ายเท่าใด คะแนนมาตรฐานอย่างเป็นทางการให้จุดเริ่มต้นแก่เรา จำเป็นต้องมีงานยากที่ใช้พรอมป์เดียวกันเพื่อดูว่าความแตกต่างเหล่านี้มีความสำคัญตรงไหน
เราได้ทดสอบทั้งสามโมเดลกับงานเดียวกันผ่าน GlobalGPT หากคุณต้องการเปรียบเทียบเวิร์กโหลดของคุณเอง ให้เริ่มด้วย GlobalGPT และตรวจสอบตัวเลือกโมเดลปัจจุบันและข้อกำหนดการใช้งานของบัญชีของคุณ
สร้างขึ้นเพื่อการเขียนโค้ดประจำวันที่รวดเร็วและการดำเนินการแบบเอเจนต์
สามารถทำงานแบบสแตนด์อโลนหรือจัดการการดำเนินการร่วมกับโมเดลการให้เหตุผลเชิงลึกได้
ดัชนีที่ Google รายงาน: 51 ที่การคิดระดับสูง 54 ที่ xhigh
แหล่งที่มา: ประกาศ Hydrogen ของ Google.
โมเดล โมเดลการให้เหตุผล Gemini 4 ที่มีความสามารถสูงสุด.
มีไว้สำหรับการดีบักที่ยาก การวิจัยทางวิทยาศาสตร์ และการตรวจสอบเพิ่มเติม
อาจใช้โทเค็นการให้เหตุผลมากกว่า Argon แม้จะมีอัตราต่อโทเค็นเท่ากัน
ที่มา: ประกาศความพร้อมใช้งาน Carbon ของ Google.
การให้เหตุผลแนวหน้าอย่างมีประสิทธิภาพ สำหรับการเขียนโค้ด คณิตศาสตร์ และวิทยาศาสตร์ที่ท้าทาย
Google วางตำแหน่งให้เร็วกว่าและใช้โทเค็นน้อยกว่า Carbon
บทบาทของมันคือความสมดุลระหว่างความลึกของการให้เหตุผลและต้นทุนงาน
ที่มา: เอกสารโมเดลและราคาของ Google.
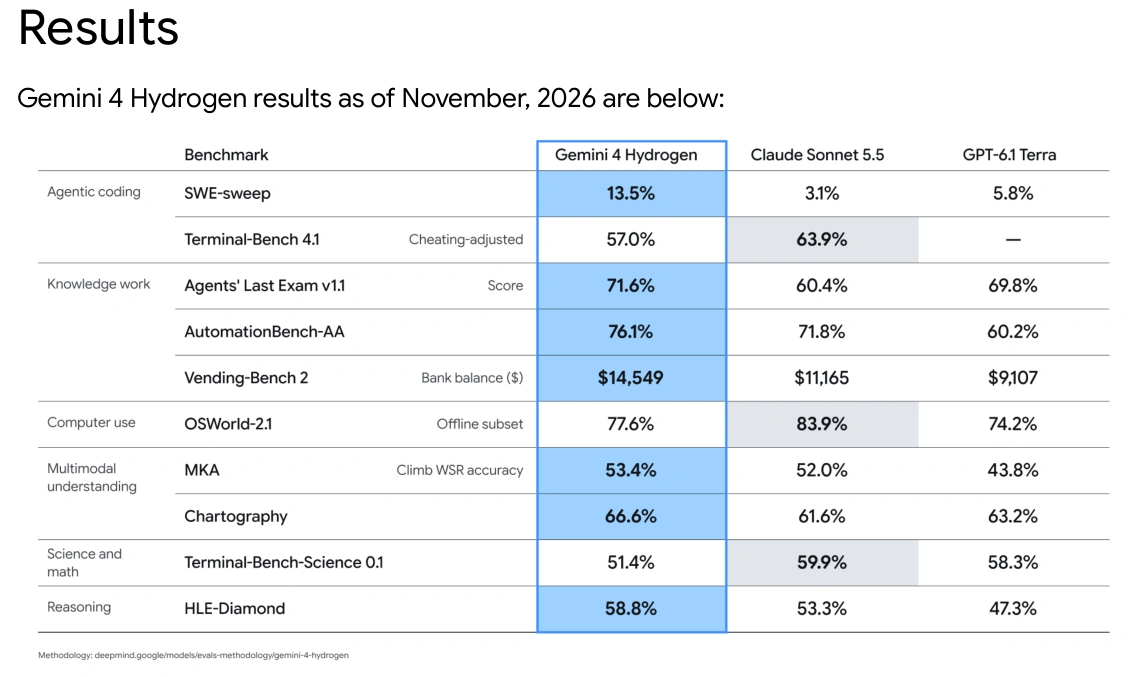
เกณฑ์มาตรฐานที่เผยแพร่ · ยิ่งสูงยิ่งดี
มุมมองอย่างรวดเร็วของคะแนนที่ Google รายงาน
นี่คือผลลัพธ์ที่เผยแพร่ซึ่ง Google รายงาน ตรวจสอบเมื่อวันที่ 15 พฤศจิกายน 2026 ไม่ใช่คะแนนจากการทดสอบของเราเอง ตัวเลขของ Carbon มาจาก ประกาศ; ตัวเลขของ Hydrogen และ Argon มาจากประกาศ Hydrogen ข้างต้น นี่คือการเปรียบเทียบแหล่งที่มาระหว่างประกาศต่างๆ ไม่ใช่การรันลีดเดอร์บอร์ดสามโมเดลใหม่ด้วยการตั้งค่าที่เหมือนกันซึ่งตรวจสอบอย่างอิสระ
อย่าใส่ตัวเลขของ Terminal-Bench 4.0 และ 4.1 ไว้ในคอลัมน์จัดอันดับเดียวกัน เวอร์ชันการประเมินที่เปลี่ยนไปอาจเปลี่ยนความยากของงานได้ ดังนั้นเปอร์เซ็นต์จึงไม่สนับสนุนข้อสรุปการเปรียบเทียบโดยตรงอย่างเป็นธรรม
ราคา Gemini API มาตรฐานเป็นดอลลาร์สหรัฐต่อหนึ่งล้านโทเค็น ตรวจสอบเมื่อ 15 พฤศจิกายน 2026:
GEMINI API มาตรฐาน · ดอลลาร์สหรัฐต่อ 1 ล้านโทเค็น
อินพุต
เอาต์พุต · รวมการคิด
อินพุต
เอาต์พุต · รวมการคิด
อินพุต
เอาต์พุต · รวมการคิด
*อัตราที่เผยแพร่ปัจจุบันของ Hydrogen ไม่ได้ระบุการเพิ่มขึ้นในเดือนธันวาคม นี่ไม่ใช่การรับประกันว่าจะไม่มีการเปลี่ยนแปลงในอนาคต การเรียกเก็บเงินเอาต์พุตรวมโทเค็นการคิด ค่าค้นหาและเครื่องมืออื่นๆ แยกต่างหาก นี่คืออัตรา Google API ไม่ใช่ราคาสมัครสมาชิกหรือการแปลงเครดิตของ GlobalGPT
ที่จำนวนโทเค็นคงที่ Hydrogen มีค่าใช้จ่ายน้อยกว่า 25% กว่า Carbon หรือ Argon ในอัตราเริ่มต้น เมื่อเทียบกับอัตราเดือนธันวาคมที่ประกาศ ความแตกต่างนั้นกลายเป็น 62.5%. ต้นทุนงานจริงยังขึ้นอยู่กับโทเค็นการให้เหตุผล การลองใหม่ และการใช้เครื่องมือ
ตัวอย่างเช่น โทเค็นอินพุต 100,000 รายการและโทเค็นเอาต์พุตที่เรียกเก็บเงินได้ 20,000 รายการมีค่าใช้จ่าย $0.30 บน Hydrogen, $0.40 บน Carbon หรือ Argon จนถึงวันที่ 30 พฤศจิกายน และ $0.80 บน Carbon หรือ Argon ตั้งแต่วันที่ 1 ธันวาคม การคำนวณนี้ไม่รวมเครื่องมือ การแคช ส่วนลดแบบกลุ่ม และการลองใหม่ และไม่ได้คาดการณ์ว่าแต่ละโมเดลต้องใช้โทเค็นจำนวนเท่าใด
Hydrogen มีระดับ API ฟรีที่จำกัดอัตรา Carbon และ Argon ไม่มี การสมัครสมาชิกสำหรับผู้บริโภคเป็นการซื้อแยกต่างหากโดยมีกฎการเข้าถึงของตนเอง
แหล่งที่มา: ราคา Google API.
เราทดสอบ Hydrogen, Carbon และ Argon กับงานที่เหมือนกันสี่งาน สามงานแรกตรวจสอบความแม่นยำหลัก งานสุดท้ายต้องใช้โปรแกรมค้นหาแบบตรงทั้งหมดซึ่งเรารันและตรวจสอบกับคำตอบที่คำนวณอย่างอิสระ
อินพุตและคำสั่งระบบเดียวกันสำหรับแต่ละงาน
คำขอใหม่ ปิดใช้งานบริบทของโปรเจกต์ และไม่มีการใช้เครื่องมือของโมเดล
ประเมินความถูกต้อง รูปแบบเอาต์พุต เวลา และการใช้โทเค็นแยกกัน
การทดสอบ 1 · ค่าพื้นฐานความแม่นยำ
เลือกพอร์ตโฟลิโอที่เหมาะสมที่สุดและระบุทางเลือกที่มีคุณสมบัติครบทุกข้อ
Solve exactly, showing verifiable arithmetic and a proof of optimality. Six indivisible projects have (cost, value): A(7,13), B(6,12), C(5,10), D(4,8), E(3,7), F(2,4). Budget=16. C requires A. D and E cannot both be selected. B requires at least one of D or F. Select projects maximizing total value; break ties by lower cost then alphabetically sorted project-list. Give chosen list, cost, value and enumerate all feasible candidates with value at least 30. No external tools or web.
ถูกต้อง: A+C+D ต้นทุน 16 มูลค่า 31 และระบุ A+C+E เป็นพอร์ตโฟลิโออื่นเดียวที่เป็นไปได้ซึ่งมีมูลค่าอย่างน้อย 30
ถูกต้อง: A+C+D ต้นทุน 16 มูลค่า 31 และระบุ A+C+E เป็นพอร์ตโฟลิโออื่นเดียวที่เป็นไปได้ซึ่งมีมูลค่าอย่างน้อย 30
ถูกต้อง: A+C+D ต้นทุน 16 มูลค่า 31 และยังระบุ A+C+E เป็นพอร์ตโฟลิโออื่นเพียงรายการเดียวที่เป็นไปได้ซึ่งมีมูลค่าอย่างน้อย 30
คำตัดสินของงาน: ทั้งสามผ่านการตรวจสอบคำตอบหลัก
การทดสอบ 2 · เส้นฐานความแม่นยำ
แยกการแปลงรวมออกจากผลกระทบระดับอุปกรณ์และการเพิ่มขึ้นมาตรฐาน
Analyze a randomized experiment using only these counts. Variant A: mobile 90 purchases/900 visitors; desktop 80/100. Variant B: mobile 20/100; desktop 630/900. Show overall and device-specific conversion rates, absolute lifts B-A, and a standardized B-A lift using 50% mobile/50% desktop. Explain the reversal, distinguish observational aggregate from randomized causal interpretation, and state exactly what randomization details are missing. May we claim B wins overall and in both devices? Do not invent significance or revenue. No external tools or web.
ถูกต้อง: B นำโดยรวม 48 จุดเปอร์เซ็นต์ แต่แพ้ 10 จุดบนเดสก์ท็อป ส่วนผสมอุปกรณ์ 50/50 ทั่วไปให้ ลิฟต์เป็นศูนย์. ปฏิเสธชัยชนะในทั้งสองกลุ่ม
ถูกต้อง: B นำโดยรวม 48 จุดเปอร์เซ็นต์ แต่แพ้ 10 จุดบนเดสก์ท็อป ส่วนผสมอุปกรณ์ 50/50 ทั่วไปให้ ลิฟต์เป็นศูนย์. ปฏิเสธชัยชนะในทั้งสองกลุ่ม
ถูกต้อง: B นำโดย 48 จุดเปอร์เซ็นต์โดยรวม แต่แพ้ 10 จุดบนเดสก์ท็อป การผสมอุปกรณ์ 50/50 ทั่วไปให้ ศูนย์ลิฟต์. ปฏิเสธชัยชนะในทั้งสองกลุ่ม
คำตัดสินของงาน: ทั้งสามผ่านการตรวจสอบคำตอบหลัก
การทดสอบ 3 · เส้นฐานความแม่นยำ
ใช้การแก้ไข การทำให้เป็นโมฆะ และการคืนเงินอย่างถูกต้อง จากนั้นส่งคืน JSON ที่เข้มงวด
Return valid JSON only, no Markdown. Reconcile event ledger by event_id: retain highest revision, then exclude void=true. Amounts are integer cents; refund amounts subtract from captured revenue even when received before capture; group by order_id; ignore pending. Ledger: [e1,r1,o1,capture,1000,false];[e1,r2,o1,capture,1200,false];[e2,r1,o1,refund,200,false];[e3,r1,o2,refund,300,false];[e4,r1,o2,capture,2000,false];[e5,r1,o3,capture,500,false];[e5,r2,o3,capture,500,true];[e6,r1,o3,pending,900,false];[e7,r1,o4,capture,700,false];[e8,r1,o4,refund,800,false];[e8,r2,o4,refund,600,false];[e9,r1,o2,refund,100,false]. Output keys orders (array sorted by order_id with order_id,net_cents,retained_event_ids sorted lexically), total_net_cents, excluded_event_ids (superseded event versions written as event_id:rN plus void and pending versions). Include o3 with zero net. No external tools or web.
ถูกต้อง: ยอดรวมคำสั่งซื้อ 1,000, 1,600, 0 และ 100 เซนต์; รวม 2,700 เซนต์ เอาต์พุตดิบถูกแยกวิเคราะห์เป็น JSON โดยไม่ต้องทำความสะอาด
ถูกต้อง: ยอดรวมคำสั่งซื้อ 1,000, 1,600, 0 และ 100 เซนต์; รวม 2,700 เซนต์ เอาต์พุตดิบถูกแยกวิเคราะห์เป็น JSON โดยไม่ต้องทำความสะอาด
ถูกต้อง: ยอดรวมคำสั่งซื้อ 1,000, 1,600, 0 และ 100 เซนต์; รวม 2,700 เซนต์ เอาต์พุตดิบถูกแยกวิเคราะห์เป็น JSON โดยไม่ต้องทำความสะอาด
คำตัดสินของงาน: ทั้งสามผ่านการตรวจสอบคำตอบหลัก
การทดสอบ 4 · งานเขียนโค้ดแบบฮาร์ดโค้ด
สร้าง Python ที่เรียกใช้งานได้สำหรับการค้นหาแบบมีข้อจำกัด เราได้รันทุกโปรแกรมเทียบกับข้อมูลอ้างอิงแบบละเอียดถี่ถ้วนอิสระ
Find the EXACT top 5 feasible portfolios, ranked by highest total value, then lowest total cost, then lexicographic sorted ID string. Items (ID,cost,value): [('A', 9, 19), ('B', 7, 16), ('C', 11, 25), ('D', 6, 13), ('E', 8, 18), ('F', 5, 12), ('G', 10, 23), ('H', 4, 9), ('I', 12, 29), ('J', 3, 8), ('K', 7, 17), ('L', 6, 15), ('M', 9, 22), ('N', 5, 11), ('O', 8, 20), ('P', 4, 10), ('Q', 11, 27), ('R', 2, 5)]. Budget 55; choose between 6 and 9 items inclusive. Dependencies: C requires A; G requires B and D; I requires E; M requires F and H; Q requires J and K. Mutually exclusive pairs: (A,B),(E,F),(L,N),(O,Q). At least 2 of C,G,I,M,Q. Exactly 2 of D,H,L,P. At least one of B,F,J,N,R. If O is selected then P is selected and K is absent. If R is selected then exactly one of A,E is selected. Return ONLY executable Python 3 code, at most 120 lines. Implement an exact exhaustive search, print JSON with keys feasible_count and top5 (each row [sorted_ID_string,cost,value]). Do NOT manually calculate or hardcode the answer. State complexity in a code comment. Use only itertools and json; no filesystem, network, subprocess or other imports. The code will be executed and checked against an independent exhaustive reference.ผ่าน: โค้ดที่เรียกใช้งานได้ส่งคืน 121 พอร์ตโฟลิโอที่เป็นไปได้ และ ห้าอันดับแรกที่ถูกต้อง. รวมจำนวนชุดค่าผสมที่ถูกต้องและคำอธิบายความซับซ้อนที่สมบูรณ์ยิ่งขึ้น
ผ่าน: ส่งคืนโค้ดที่ปฏิบัติการได้ 121 พอร์ตโฟลิโอที่เป็นไปได้ และ ห้าอันดับแรกที่ถูกต้อง. จำนวนชุดค่าผสมถูกต้อง แต่หมายเหตุความซับซ้อนละเว้นเทอมการเรียงลำดับสุดท้าย
ผ่านหลังจากลบรั้ว Markdown: ส่งคืนโค้ด 121 พอร์ตโฟลิโอที่เป็นไปได้ และ ห้าอันดับแรกที่ถูกต้อง. ความคิดเห็นอ้างว่ามี 115,379 ชุดค่าผสมแทนที่จะเป็น 142,766 และละเว้นการเรียงลำดับในหมายเหตุความซับซ้อน
คำตัดสินของงาน: ความถูกต้องเชิงฟังก์ชันเสมอกัน. Hydrogen ให้การผสมผสานที่สะอาดที่สุดระหว่างรูปแบบที่ปฏิบัติการได้และคำอธิบายในการรันครั้งนี้
เวลาเป็นการสังเกตแบบ end-to-end จากการรันครั้งเดียวรวมถึงเวลาเครือข่ายและคิว โดยคำขอถูกดำเนินการพร้อมกัน โทเค็นรายงานการใช้งานอินพุต/เอาต์พุตและอาจรวมถึงโทเค็นการให้เหตุผลหรือตัวห่อคำขอ ซึ่งไม่ใช่ค่าใช้จ่ายเป็นดอลลาร์ ความพยายามตอบโดยตรงแยกต่างหากถึงขีดจำกัดอัตราหรือหมดเวลาในเครื่องและถูกแยกออกจากการให้คะแนนคุณภาพ งานเขียนโค้ดข้างต้นใช้พรอมต์ที่จับคู่ใหม่
เริ่มต้นด้วย Hydrogen เมื่ออัตราโทเค็นอย่างเป็นทางการที่ต่ำกว่าเหมาะกับเวิร์กโหลดของคุณ เก็บ Argon ไว้ในการเปรียบเทียบหากคุณให้ความสำคัญกับการให้เหตุผลแนวหน้าอย่างมีประสิทธิภาพ: มันแก้ปัญหางานเขียนโค้ดแบบค้นหาแม่นยำของเราได้อย่างถูกต้องหลังจากการทำความสะอาดรูปแบบ ประเมิน Carbon กับงานที่ต้องการการสำรวจที่ลึกขึ้น ชุดทดสอบนี้ไม่ได้แสดงข้อได้เปรียบด้านความถูกต้องที่จะ justify การเลือกโดยค่าเริ่มต้น ตรวจสอบค่าธรรมเนียมแพลตฟอร์มที่แสดงแยกจากอัตรา Google API
Hydrogen มีอัตรา API มาตรฐานที่ต่ำที่สุด: $1.50 ต่อโทเค็นอินพุตหนึ่งล้าน และ $7.50 ต่อโทเค็นเอาต์พุตหนึ่งล้าน ตรวจสอบเมื่อ 15 พฤศจิกายน 2026
อัตราโทเค็นมาตรฐานที่ระบุไว้เท่ากัน Carbon อาจยังมีค่าใช้จ่ายต่อภารกิจสูงกว่าหากใช้โทเค็นการให้เหตุผลหรือขั้นตอนการตรวจสอบมากขึ้น
ไม่ ตรวจสอบเวอร์ชันของเกณฑ์มาตรฐานและการตั้งค่าการคิด จากนั้นทดสอบโมเดลกับงานที่เป็นตัวแทนซึ่งมีคำตอบที่ตรวจสอบได้อย่างอิสระ
เรารันตัวแก้ปัญหา Python ที่สร้างขึ้นแต่ละตัวและเปรียบเทียบจำนวนที่เป็นไปได้และพอร์ตโฟลิโอห้าอันดับแรกกับข้อมูลอ้างอิงการค้นหาแบบละเอียดถี่ถ้วนอิสระ
คู่มือการเข้าถึง Argon ของเราอธิบายความแตกต่างระหว่างการเข้าถึงแพลตฟอร์ม การสมัครสมาชิก Google, AI Studio และการเรียกเก็บเงิน API
สำหรับรายละเอียดการเข้าถึง โปรดอ่าน วิธีใช้ Gemini 4 Argon. หากต้องการเปรียบเทียบโมเดลในบัญชีเดียว ให้เริ่มด้วย GlobalGPT และตรวจสอบโมเดลที่เลือกและข้อกำหนดการใช้งานที่แสดง