
Claude Fable 5.2 เทียบกับ Opus 5.5: การเขียนโค้ด ต้นทุน และการเลือกใช้
งานห้าอย่างที่ใช้พรอมปต์เดียวกันเปรียบเทียบ Claude Fable 5.2 และ Opus 5.5 ในด้านการวิจัย การออกแบบอินเทอร์เฟซ AI การเขียน ข้อมูล และการวางแผนผลิตภัณฑ์ พร้อมภาพหน้าจอต้นฉบับและบันทึกเวลาและการใช้โทเค็น
 Chloe Murphy

Opus 5.5 เป็นจุดเริ่มต้นที่สมเหตุสมผลสำหรับงานประจำ ทดสอบ Fable 5.2 เมื่องานเฉพาะยังต้องปรับปรุง ในงานข้อความสี่คู่ที่เสร็จสมบูรณ์ของเรา ทั้งสองโมเดลคำนวณการวิจัยหลักและเมตริกข้อมูลได้ถูกต้อง แผนผลิตภัณฑ์ของ Fable จัดการกับความไม่แน่นอนหนึ่งอย่างอย่างระมัดระวังมากขึ้น ผลงานเขียนทั้งสองชิ้นตรงตามข้อจำกัดหลัก
การเปรียบเทียบการออกแบบใช้การรันแบบจับคู่ใหม่ขนาด 32,768 โทเค็น ภาพหน้าจอ การตรวจสอบการโต้ตอบ และข้อจำกัดปรากฏในงานออกแบบด้านล่าง
Fable 5.2 ใหม่กว่าและมีค่าใช้จ่ายต่อโทเค็นสูงกว่า แต่มันให้ผลลัพธ์ที่ดีกว่าหรือเป็นเพียงบิลที่แพงขึ้น? เราเปรียบเทียบการวิจัย การออกแบบอินเทอร์เฟซ AI การเขียน การวิเคราะห์ข้อมูล และการตัดสินใจด้านผลิตภัณฑ์โดยใช้บรีฟงานเดียวกันสำหรับแต่ละโมเดล
หากคุณต้องการเปรียบเทียบโมเดลโดยไม่ต้องจัดการการตั้งค่า API แยกกัน GlobalGPT มีพื้นที่ทำงานหลายโมเดล การทดสอบ API ที่นี่ไม่ได้ยืนยันว่า Fable 5.2 พร้อมใช้งานภายใน GlobalGPT
การเปรียบเทียบเชิงปฏิบัติ
| การตัดสินใจ | Fable 5.2 | Opus 5.5 |
|---|---|---|
| อินพุต / เอาต์พุตมาตรฐานต่อล้านโทเค็น | $8 / $40 | $4 / $20 |
| การทดสอบวิจัย | การคำนวณถูกต้อง แต่ถ้อยคำเชิงสาเหตุต้องแก้ไข | การคำนวณถูกต้อง แต่รายละเอียดการออกแบบการศึกษาไม่มีหลักฐานสนับสนุน |
| การทดสอบเนื้อหา | คำอธิบาย 180 คำ; เสียงพากย์สั้นกว่า | คำอธิบาย 180 คำ; ตัวอย่างที่สมบูรณ์ยิ่งขึ้น |
| การทดสอบข้อมูล | ตัวชี้วัดที่ขอทั้งหมดถูกต้อง | ตัวชี้วัดที่ขอทั้งหมดถูกต้อง |
| การทดสอบผลิตภัณฑ์ | แยกแยะอย่างรอบคอบระหว่างอันตรายที่ยืนยันแล้วกับอันตรายที่อาจเกิดขึ้น | แผนมีประโยชน์ แต่ข้ออ้างเรื่องงานที่สูญหายไม่มีหลักฐานสนับสนุน |
| ความพยายามออกแบบดั้งเดิม | ไม่มีอาร์ติแฟกต์: HTTP ล้มเหลว | HTML สมบูรณ์หลังทำความสะอาดบล็อกโค้ด |
วิธีที่เราทดสอบสองโมเดล
แต่ละงานใช้แหล่งข้อมูลเดียวกัน บทสนทนาใหม่ และขีดจำกัดเอาต์พุตเดียวกันสำหรับทั้งสองโมเดล งานข้อความใช้เพดาน 16,000 โทเค็น ส่วนการรันออกแบบขั้นสุดท้ายใช้ 32,768 โทเค็น พรอมต์ การตั้งค่า เวลา และการใช้งานจะแสดงพร้อมกับงานที่เกี่ยวข้องด้านล่าง
การศึกษาทั้งหมด ผลิตภัณฑ์ ข้อมูลคำสั่งซื้อ และข้อเสนอแนะในบทสรุปเป็นอุปกรณ์ทดสอบที่สมมติขึ้น เราตรวจสอบการคำนวณกับเฉลยที่เตรียมไว้ ความพยายามในการให้เหตุผลยังคงอยู่ที่ค่าเริ่มต้นของแพลตฟอร์ม ดังนั้นนี่จึงไม่ใช่เกณฑ์มาตรฐานที่ใช้ความพยายามเท่ากัน ป้ายกำกับโมเดลที่ส่งคืนโดยเกตเวย์บุคคลที่สามไม่ได้ยืนยันการกำหนดเส้นทางต้นน้ำอย่างอิสระ
นักวิจัย: การสังเคราะห์โดยไม่กล่าวเกินจริงเกี่ยวกับหลักฐาน
พรอมต์เดียวกัน · การทดสอบนักวิจัย
You are a researcher. Use only these FICTIONAL study summaries about an AI writing assistant. A: randomized 120 adults, 60 per arm, intervention mean score baseline70 followup78, control baseline69 followup74, four weeks; no standard deviations, uncertainty intervals, or attrition information reported. B: observational 300 adults, usage correlated with writing scores r=.32, no confounder adjustment. C: interviews with12 users reporting perceived improvement. In under650 words synthesize evidence with A/B/C citations, calculate difference in changes, explain what cannot be inferred, and propose a feasible preregistered followup study with primary endpoint and analysis. Do not invent citations or statistical significance.
งานของนักวิจัยขอให้สังเคราะห์การศึกษาสมมติสามชิ้น รวมถึงการทดลองแบบสุ่มที่มีการรายงานไม่สมบูรณ์ การคำนวณที่สำคัญคือ (78 − 70) − (74 − 69) = 3 คะแนน. ทั้งสองโมเดลตอบถูกและปฏิเสธที่จะสร้างนัยสำคัญทางสถิติขึ้นมา
Fable 5.2
เสนอการประเมินการเขียนแบบปกปิดและไม่มีการช่วยเหลือ การวิเคราะห์แบบ intention-to-treat และการตรวจสอบความไวต่อข้อมูลที่ขาดหายไป นอกจากนี้ยังให้ตัวอย่างขนาดตัวอย่างที่เป็นสมมติฐานอย่างชัดเจน
“เฉพาะความแตกต่าง 3 คะแนนเท่านั้นที่มาจากผู้ช่วย”
ถ้อยคำดังกล่าวมั่นใจเกินไปเมื่อพิจารณาจากการสูญหายของผู้เข้าร่วมและช่องว่างในการรายงานที่ไม่ทราบ แม้ว่าย่อหน้าถัดมาจะจำกัดการประมาณการไว้ก็ตาม นอกจากนี้ยังคาดเดาว่าผู้เข้าร่วมการสัมภาษณ์น่าจะเลือกเอง
Opus 5.5
แยกหลักฐานแบบสุ่ม แบบสังเกต และแบบสัมภาษณ์อย่างชัดเจน เสนอการทดลองที่ปรับตามค่าพื้นฐานและคงการคำนวณขนาดตัวอย่างให้ขึ้นอยู่กับความแปรปรวนของโครงการนำร่อง
“มีลักษณะภาคตัดขวางตามที่อธิบาย”
บทสรุปเชิงสังเกตที่ให้มาไม่ได้ระบุการออกแบบภาคตัดขวาง รายละเอียดนั้นควรคงไม่ทราบต่อไป
หากคุณปรับใช้บทสรุปนี้ ให้คงหลักฐานไว้และขอให้แต่ละโมเดลแยกข้อเท็จจริงที่รายงานออกจากการอนุมาน พรอมปต์ Claude สำหรับการวิจัยและการเขียนโค้ด นำเสนอตัวอย่างเพิ่มเติมของข้อจำกัดเฉพาะงาน
Designer: พื้นที่ทำงานหลายโมเดล AI
พรอมปต์เดียวกัน · การทดสอบ Designer
You are a product designer and frontend builder. Return only one complete self-contained HTML file with inline CSS and JavaScript, no external assets/CDNs. Build a polished AI multi-model workspace called Parallel. Give it a distinctive cohesive visual identity with excellent typography, whitespace, hierarchy and responsive layout; choose your own palette. Include sidebar, model A/B selectors, prompt textarea, compare button, two side-by-side result cards, loading state, clear button, per-result copy button, empty-input validation, keyboard-accessible controls and mobile stacking. Models A/B are FICTIONAL; all outputs must be locally simulated and explicitly labeled demo. No real API calls or fake live performance metrics. Compare must work repeatedly and preserve the submitted prompt in both outputs. Copy must report success only after actual success, otherwise provide an error. Aim for a complete compact artifact, not an explanation.
บทสรุปของนักออกแบบขอให้ทั้งสองโมเดลสร้าง ขนาน: พื้นที่ทำงานเปรียบเทียบ AI แบบครบวงจรพร้อมแถบด้านข้าง ตัวเลือกโมเดล ช่องป้อนพรอมต์ การ์ดผลลัพธ์จำลอง การตรวจสอบ ปุ่มคัดลอก และเลย์เอาต์มือถือ เราเปิดจานสีและเอกลักษณ์ทางภาพไว้
การรันที่ตรงกันครั้งสุดท้ายใช้พรอมต์เดียวกัน การส่งข้อมูลแบบสตรีม และเพดานโทเค็นร่วมกันที่ 32,768 โทเค็น การตอบสนองทั้งสองถึงจุดหยุดปกติ อาร์ติแฟกต์ต้นฉบับยังคงไม่ถูกแก้ไข การบันทึก HTML จะลบเฉพาะรั้ว Markdown ที่ล้อมรอบเมื่อมีอยู่
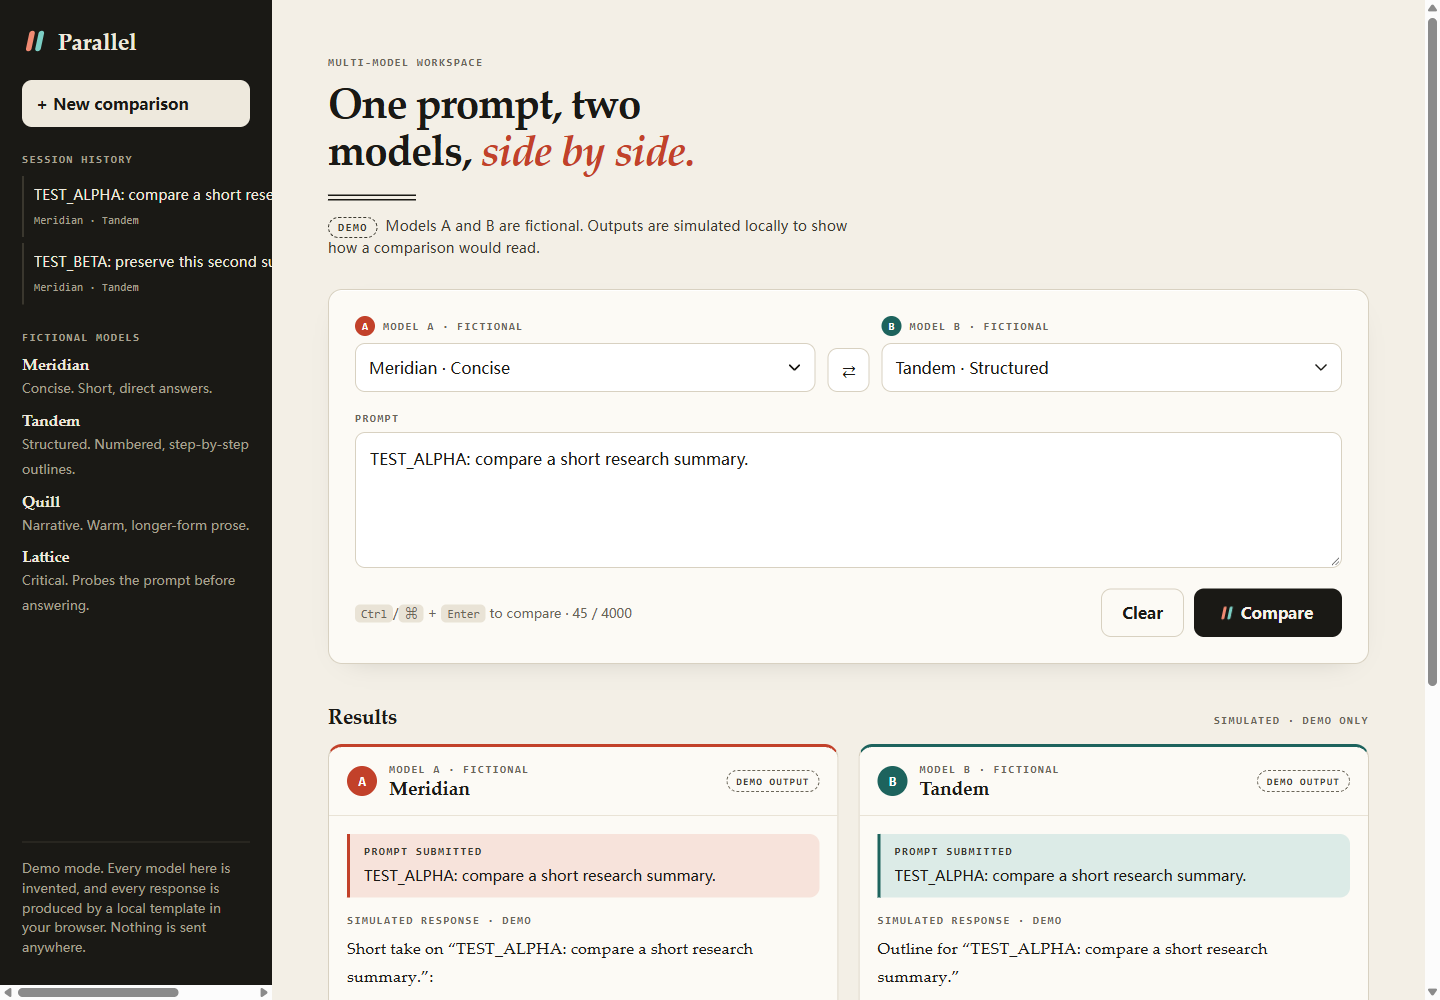
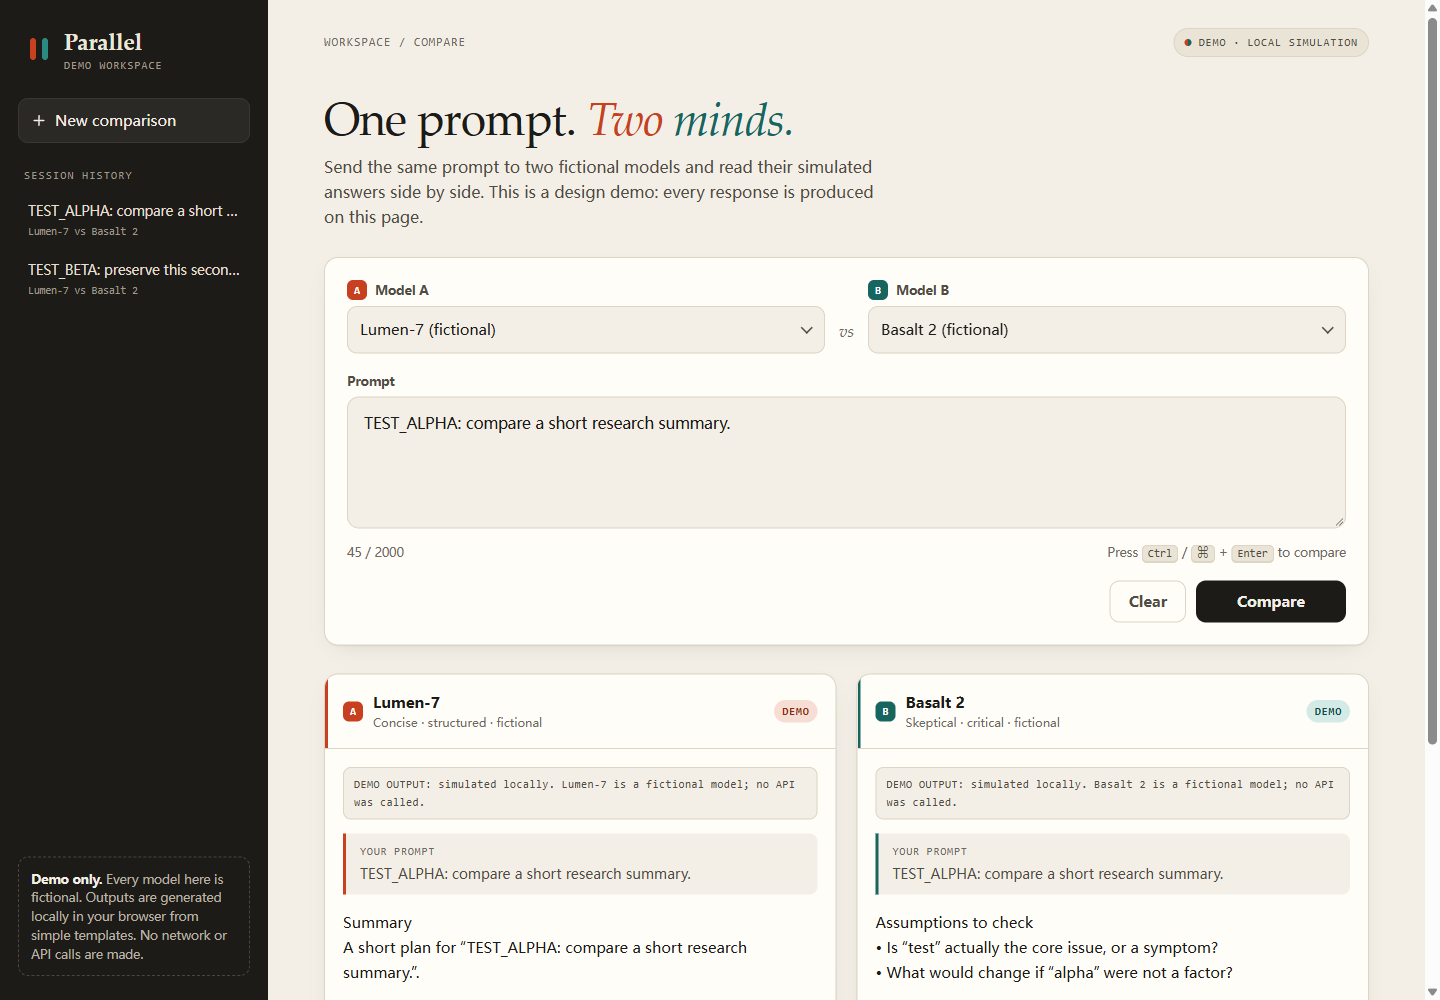
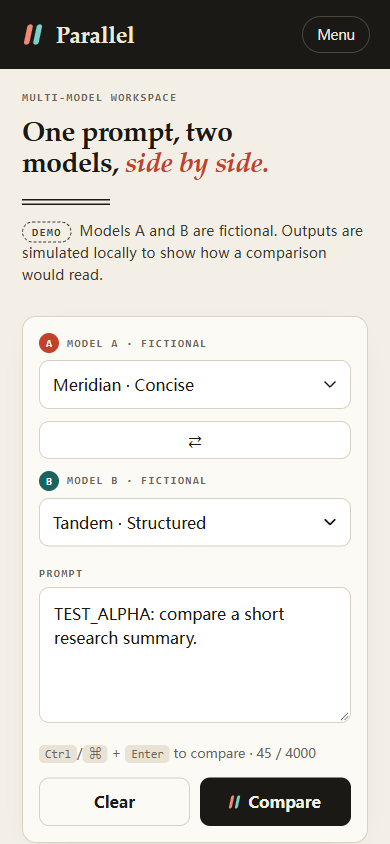
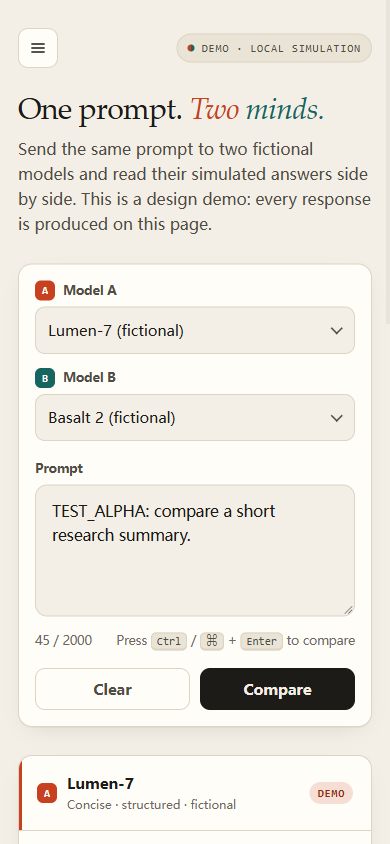
หน้าเว็บที่แสดงผลจริงมีลักษณะอย่างไร
ตัวอย่าง Fable 5.2
หัวเรื่องแบบ serif ที่หนักขึ้น การเน้นสีแดงตัวเอียง และแถบด้านข้างที่มีคอนทราสต์สูงทำให้หน้านี้มีเอกลักษณ์ด้านบรรณาธิการที่แข็งแกร่งขึ้น การควบคุมการสลับโมเดลเป็นส่วนเสริมที่มีประโยชน์ แต่ใช้พื้นที่เต็มแถวบนมือถือและดันพรอมต์และผลลัพธ์ลงไปด้านล่าง
ตัวอย่าง Opus 5.5
หัวเรื่องที่เบากว่าและพื้นที่เลือกโมเดลที่เรียบง่ายกว่ารู้สึกยับยั้งมากขึ้น ที่วิวพอร์ตมือถือเดียวกัน ปุ่มเปรียบเทียบสิ้นสุดที่ประมาณ 710 พิกเซลจากด้านบน เทียบกับ 826 พิกเซลในตัวอย่าง Fable ทำให้เหลือพื้นที่ให้การ์ดผลลัพธ์แรกปรากฏเร็วขึ้น
ทั้งคู่เลือกโทนกระดาษอบอุ่น แถบด้านข้างสีเข้ม และหัวเรื่องแบบ serif ความแตกต่างอยู่ที่ลำดับชั้นและความหนาแน่น ไม่ใช่ภาษาการออกแบบที่แตกต่างอย่างสิ้นเชิงสำหรับพื้นที่ทำงานเฉพาะนี้ เราชอบเลย์เอาต์ที่กะทัดรัดของตัวอย่าง Opusหากให้ความสำคัญกับพาดหัวข่าวเชิงบรรณาธิการที่เด่นชัดกว่า ตัวอย่าง Fable ก็มีเสน่ห์เช่นนั้น นี่เป็นความชอบส่วนบุคคลระหว่างอาร์ติแฟกต์ที่ส่งคืนเหล่านี้ ไม่ใช่การจัดอันดับความสวยงามทั่วไปของโมเดลพื้นฐาน
การตรวจสอบเบราว์เซอร์: ลักษณะที่ปรากฏและพฤติกรรมแยกกัน
| ตรวจสอบ | ตัวอย่าง Fable | ตัวอย่าง Opus |
|---|---|---|
| การตรวจสอบอินพุตว่าง | ผ่าน | ผ่าน |
| การเปรียบเทียบซ้ำจะรักษาพรอมต์ที่ส่งไว้ | ผ่าน | ผ่าน |
| ข้อเสนอแนะการโหลดที่มองเห็นได้ | ผ่าน | ผ่าน |
| ล้างอินพุต | ผ่าน | ผ่าน |
| หน้าเว็บล้นที่ความกว้าง 390 พิกเซล | ไม่พบการวัด | ไม่พบการวัด |
| การคัดลอกล้มเหลวรายงานข้อผิดพลาดอย่างตรงไปตรงมา | ผ่าน | ผ่าน |
| คัดลอกไปยังคลิปบอร์ดสำเร็จ | ไม่ได้รับการยืนยัน | ไม่ได้รับการยืนยัน |
เราเปิดเอาต์พุตที่ไม่ได้แก้ไขใน Chrome และใช้การควบคุม DOM เพื่อรันการตรวจสอบ ภาพหน้าจอเดสก์ท็อปใช้ 1440 × 1000; ภาพหน้าจอมือถือใช้ 390 × 844 ทั้งสี่ภาพแสดงพรอมต์ที่ส่งเดียวกันหลังจากการเปรียบเทียบและก่อนการตรวจสอบการคัดลอก ไม่มีการจับข้อยกเว้นรันไทม์ระหว่างขั้นตอนเหล่านี้ การเขียนคลิปบอร์ดไม่สำเร็จในเซสชันอัตโนมัติ และไม่ได้ทดสอบการนำทางด้วยแป้นพิมพ์เพียงอย่างเดียวแบบเต็มรูปแบบ
การใช้งานคู่การออกแบบสุดท้ายให้ค่าพร็อกซีอัตรามาตรฐานเท่ากับ $0.8826 สำหรับ Fable และ $0.2918 สำหรับ Opus. สิ่งนี้ใช้อัตราผู้ให้บริการและโทเค็นที่รายงานโดยเกตเวย์ ไม่รวมความพยายามก่อนหน้านี้ และไม่ใช่บิลจริงของเกตเวย์
ความพยายามก่อนหน้านี้และข้อจำกัดของหลักฐาน
ผู้สร้างเนื้อหา: สำเนาที่ถูกต้องในสองรูปแบบ
พรอมต์เดียวกัน · การทดสอบผู้สร้างเนื้อหา
You are a content creator. Based ONLY on these FICTIONAL product facts, write a180-word plain-English explainer and a45-second video script with timestamps, then a five-item fact-check checklist. Facts: Lumen is a fictional AI workspace; it lets users compare two AI text drafts side by side, save prompts locally in their browser, and manually copy a chosen result. It does not publish content automatically, browse the web, or verify facts. No prices, launch dates, speed metrics, supported model names, or privacy guarantees are provided. Audience: freelancers who struggle to choose a usable first draft. Explain a practical example, avoid hype and invented claims, and distinguish local prompt saving from an unproven no-training guarantee.
บรีฟผู้สร้างได้จัดเตรียมพื้นที่ทำงานสมมติที่มีเพียงสามฟีเจอร์: การเปรียบเทียบฉบับร่างแบบเคียงข้าง การบันทึกพรอมป์ในเครื่อง และการคัดลอกด้วยตนเอง โดยต้องการคำอธิบาย 180 คำ สคริปต์ 45 วินาที และรายการตรวจสอบข้อเท็จจริงห้ารายการ
คำอธิบายทั้งสองเป็นไปตามข้อกำหนด 180 คำตามกฎการนับคำของเรา ซึ่งเก็บเครื่องหมายอะพอสทรอฟีและยัติภังค์ภายในไว้ในคำเดียว ทั้งสองรักษาข้อจำกัดของฟีเจอร์และหลีกเลี่ยงการปฏิบัติต่อการจัดเก็บในเครื่องเป็นการรับประกันว่าไม่มีการฝึกอย่างถูกต้อง
Fable 5.2
เริ่มด้วยความยากลำบากของฟรีแลนซ์ในการเลือกฉบับร่าง จากนั้นอธิบายฟีเจอร์ทั้งสามเป็นประโยคสั้นๆ เสียงพากย์ของวิดีโอมี 101 คำ: ประมาณ 135 คำต่อนาทีหากพูดใน 45 วินาที
Opus 5.5
ใช้ตัวอย่างนักเขียนคำโฆษณาที่ละเอียดขึ้น โดยเปรียบเทียบการเปิดเรื่องที่แข็งแกร่งกว่ากับคำอธิบายฟีเจอร์ที่ชัดเจนกว่า เสียงพากย์มี 109 คำ: ประมาณ 145 คำต่อนาทีในช่วงเวลาเดียวกัน
การประมาณจังหวะเหล่านี้มาจากบทเสียงพากย์ที่เขียนขึ้น ไม่ใช่การบันทึกแบบจับเวลา Fable เว้นที่ว่างสำหรับการหยุดมากกว่า ส่วน Opus ใช้เวลามากขึ้นในการอธิบายตัวอย่าง
สำหรับบทความที่ยาวขึ้น คู่มือของเรา การใช้ Claude สำหรับการเขียนข้อความยาว อธิบายวิธีแยกการร่างออกจากการตรวจสอบและการแก้ไข
นักวิเคราะห์ข้อมูล: การคืนเงิน การระบุแหล่งที่มาที่ขาดหายไป และ ROAS
พรอมต์เดียวกัน · การทดสอบนักวิเคราะห์ข้อมูล
You are a data analyst. Use only this synthetic data. Orders CSV(order_id,updated,status,channel,amount): o1,1,paid,Search,100; o2,1,paid,Social,80; o2,2,refunded,Social,80; o3,1,paid,Search,120; o4,1,pending,Email,60; o5,1,paid,,50; o6,1,paid,Partner,90; o7,1,paid,Email,70; o8,1,paid,Social,60; o9,1,paid,Partner,110. Channel spend/clicks: Search200/100; Social100/80; Email50/40; Partner0/20. Deduplicate by order_id keeping greatest updated. Paid orders count and revenue use latest paid only; refunded/pending contribute zero. Blank channel must remain Unknown and cannot inherit spend/clicks. Calculate overall paid count, revenue, each channel paid count/revenue/conversion rate per click/ROAS, and measurable ROAS ranking; zero or missing denominator is N/A. Show arithmetic and propose a cautious next-budget decision without inferring causality. Return table and explanation under600 words.
งานของนักวิเคราะห์ถูกออกแบบมาเพื่อจับข้อผิดพลาดที่ตารางเรียบร้อยอาจซ่อนไว้: รหัสคำสั่งซ้ำ การคืนเงินภายหลัง คำสั่งซื้อที่รอดำเนินการ ช่องทางที่ไม่รู้จัก และช่องทางพันธมิตรที่ไม่มีการใช้จ่าย
ทั้งสองโมเดลตรงกับคีย์คำตอบที่เตรียมไว้: คำสั่งซื้อที่ชำระแล้ว 7 รายการและรายได้ 600 หลังจากคงสถานะคำสั่งซื้อล่าสุดไว้ พวกเขาไม่รวมบันทึกที่คืนเงินแล้วและรอดำเนินการ เก็บการระบุแหล่งที่มาที่ขาดหายไปไว้ภายใต้ ไม่ทราบ และทำเครื่องหมายอัตราส่วนที่ไม่ได้กำหนดเป็น N/A
| ช่องทาง | คำสั่งซื้อที่ชำระแล้ว | รายได้ | การแปลง / คลิก | ROAS |
|---|---|---|---|---|
| ค้นหา | 2 | 220 | 2.00% | 1.10 |
| โซเชียล | 1 | 60 | 1.25% | 0.60 |
| อีเมล | 1 | 70 | 2.50% | 1.40 |
| พาร์ทเนอร์ | 2 | 200 | 10.00% | N/A: ไม่มีการใช้จ่าย |
| ไม่ทราบ | 1 | 50 | N/A | N/A |
Fable แสดงการคำนวณรายได้ในตารางช่องทาง และแนะนำให้ตรวจสอบการคืนเงิน คำสั่งซื้อที่รอดำเนินการ แท็กที่หายไป และต้นทุนพันธมิตรที่ไม่ได้บันทึก ก่อนที่จะเปลี่ยนแปลงอะไรมาก Opus เพิ่มตารางการลบรายการซ้ำแบบรายระเบียน และคำนวณว่ารายได้ที่ไม่ระบุแหล่งที่มาคิดเป็น 8.3% ของทั้งหมด
ทั้งคู่แนะนำให้ทดสอบด้วยงบประมาณที่จำกัด แทนที่จะถือว่า ROAS ที่สังเกตได้เป็นหลักฐานเชิงสาเหตุ ข้อสังเกตของ Opus ที่ว่ายอดขายจากโซเชียลเพิ่มขึ้นหนึ่งรายการจะทำให้ ROAS เพิ่มขึ้นประมาณสองเท่านั้น ตั้งสมมติฐานว่ายอดคำสั่งซื้อใกล้เคียงกัน ซึ่งไม่ใช่ข้อเท็จจริงใหม่ในข้อมูลนำเข้า
ผู้จัดการผลิตภัณฑ์: อันตรายก่อนการโหวตฟีเจอร์
พรอมต์เดียวกัน · การทดสอบผู้จัดการผลิตภัณฑ์
You are a product manager for a FICTIONAL AI subscription workspace. Feedback: 2 users report duplicate charges after retrying checkout; billing logs confirm one duplicate captured charge. 30 users request dark mode. 8 report one model unavailable and no warning before using a prompt; outage reproduced. 1 requests account/data deletion; request pending for20 days, governing deadline unknown. 12 request reusable saved prompts. 4 want team seats; no revenue commitment. Two engineers available for one week; effort estimates unknown. Produce a one-week priority plan with rationale, explicit unknowns, scope boundaries, owner roles, acceptance criteria, instrumentation and rollback/containment steps. Do not fabricate legal deadlines, revenue, effort or certainty. Distinguish immediate containment from permanent fixes; do not rank purely by vote count. Under700 words.
บทสรุปผลิตภัณฑ์จับคู่การเรียกเก็บเงินซ้ำที่ยืนยันแล้วกับคำขอลบที่เกินกำหนดสำหรับผู้ใช้ การหยุดทำงานของโมเดลที่ทำซ้ำได้ และคำขอฟีเจอร์ยอดนิยมเพิ่มเติม กับดักคือการจัดลำดับความสำคัญของคะแนนโหวตโหมดมืด 30 เสียงเหนืออันตรายที่พิสูจน์แล้ว
ทั้งสองโมเดลให้ความสำคัญกับการเรียกเก็บเงิน การติดตามการลบ และการควบคุมการหยุดทำงานก่อนการสร้างฟีเจอร์ ไม่มีตัวใดสร้างกำหนดเวลาทางกฎหมายสำหรับการลบขึ้นมา ทั้งคู่กำหนดบทบาทเจ้าของ แยกการควบคุมทันทีออกจากการแก้ไขถาวร และเสนอการตรวจสอบการยอมรับและการติดตาม
Fable 5.2
ระบุการกระทบยอดการคืนเงิน การแก้ไขเพื่อป้องกันการเรียกเก็บเงินซ้ำ และการควบคุมการหยุดทำงานด้วยตนเอง โดยปฏิบัติต่อการสูญเสียโควตาที่เป็นไปได้อย่างชัดเจนว่าเป็นสิ่งที่ต้องยืนยัน และทำเครื่องหมายการลบว่าไม่สามารถย้อนกลับได้
Opus 5.5
เพิ่มคำเตือนก่อนส่ง การเก็บรักษาพรอมป์ และกฎที่ชัดเจนห้ามสลับโมเดลอย่างเงียบ ๆ ตารางลำดับความสำคัญสแกนได้รวดเร็ว
อย่างไรก็ตาม มันกล่าวว่าผู้ใช้ "สูญเสียงานและพรอมป์อย่างเงียบ ๆ" ข้อเสนอแนะที่ให้มายืนยันการหยุดทำงานและคำเตือนที่ขาดหายไป ไม่ใช่การสูญเสียพรอมป์ที่พิสูจน์ได้
ราคา Fable 5.2 เทียบกับ Opus 5.5
สำหรับคำขอ API มาตรฐาน Fable 5.2 มีค่าใช้จ่ายต่อโทเค็นเป็นสองเท่าของ Opus 5.5 นั่นทำให้ Opus เป็นจุดเริ่มต้นที่ถูกกว่าเมื่อทั้งสองโมเดลให้ผลลัพธ์ที่ยอมรับได้โดยใช้โทเค็นใกล้เคียงกัน
อินพุต / เอาต์พุต
อินพุต / เอาต์พุต
นี่คืออัตราอินพุต/เอาต์พุตมาตรฐานของ Anthropic ตรวจสอบเมื่อวันที่ 11 พฤศจิกายน 2026 จากข้อกำหนด Fable.
ข้อกำหนด Opus แสดงอัตรามาตรฐานที่เกี่ยวข้อง โหมดเร็ว การแคช ส่วนลดแบบกลุ่ม การสมัครสมาชิกสำหรับผู้บริโภค และการเรียกเก็บเงินจากบุคคลที่สามมีข้อกำหนดที่แตกต่างกัน
สำหรับคำขอตัวอย่างที่มีโทเค็นอินพุต 10,000 รายการและโทเค็นเอาต์พุต 5,000 รายการ การคำนวณอัตรามาตรฐานคือ $0.28 สำหรับ Fable และ $0.14 สำหรับ Opus นี่เป็นตัวอย่างการคำนวณ ไม่ใช่ใบเรียกเก็บเงินจากการทดสอบของเรา
อัตราโทเค็นที่สูงขึ้นไม่ได้หมายความว่าต้นทุนต่องานที่สำเร็จจะสูงขึ้น คำตอบที่สั้นลง รอบการแก้ไขน้อยลง หรือการใช้เหตุผลน้อยลงสามารถเปลี่ยนยอดรวมได้ การทดสอบแบบเทิร์นเดียวของเราไม่สามารถระบุการประหยัดในระยะยาวได้
หากคุณกำลังรวมโมเดลใดโมเดลหนึ่งเข้ากับแอป คู่มือการตั้งค่า Claude API ครอบคลุมคำถามเกี่ยวกับการตั้งค่าแยกต่างหากจากการเปรียบเทียบอัตราโทเค็นที่นี่
การคูณการใช้งานที่รายงานโดยเกตเวย์ด้วยอัตรามาตรฐานของ Anthropic จะให้ค่าประมาณตามอัตราเป็น $0.4291 สำหรับ Fable เทียบกับ $0.1799 สำหรับ Opus ในงานทั้งสี่นั้น สูตรคือ โทเค็นอินพุต × อัตราอินพุต + โทเค็นเอาต์พุต × อัตราเอาต์พุต หารด้วยหนึ่งล้าน ซึ่งไม่รวมคำขอออกแบบทั้งหมดและการเรียกที่ล้มเหลวพร็อกซีตามอัตรา $0.4291 สำหรับ Fable เทียบกับ $0.1799 สำหรับ Opus ในงานทั้งสี่นี้ สูตรคือ โทเค็นอินพุต × อัตราอินพุต + โทเค็นเอาต์พุต × อัตราเอาต์พุต หารด้วยหนึ่งล้าน ซึ่งไม่รวมคำขอออกแบบทั้งหมดและการเรียกที่ล้มเหลว
พร็อกซีนี้ ไม่ใช่ค่าใช้จ่ายจริงของเกตเวย์. เราไม่ได้ตรวจสอบใบแจ้งหนี้ ความเท่าเทียมกันของการนับโทเค็น หรือส่วนเพิ่ม และไม่ได้วัดต้นทุนของการแก้ไขโดยมนุษย์ในภายหลังหรือความพยายามเพิ่มเติม
สิ่งที่เกณฑ์มาตรฐานอย่างเป็นทางการกำหนดขึ้น
การประเมินการเปิดตัวของ Anthropic ทำให้ Fable ได้เปรียบในงานยากหลายอย่าง ตารางด้านล่างแสดงคะแนนที่รายงานสามรายการ ซึ่งเป็นการประเมินของผู้ให้บริการ แยกจากการทดสอบตามบทบาทของเราเอง
| การประเมิน | Fable 5.2 | Opus 5.5 |
|---|---|---|
| FrontierCode 2.0 | 49.1% | 45.5% |
| FrontierSWE v2 | 69.9% | 62.3% |
| Terminal-Bench-Science 0.1 | 74.6% | 58.7% |
รายงานการเปิดตัว ใช้ความพยายามสูงสุดที่มีของแต่ละโมเดล เว้นแต่จะระบุไว้เป็นอย่างอื่น คะแนนเหล่านี้สนับสนุนการลองใช้ Fable ในงานเทคนิคที่ท้าทาย แต่ไม่ได้สร้างข้อได้เปรียบสากลในด้านการเขียน การตัดสินผลิตภัณฑ์ หรือรสนิยมทางภาพ
ทั้งสองโมเดลระบุหน้าต่างบริบทหนึ่งล้านโทเค็นและขีดจำกัดเอาต์พุต 128,000 โทเค็น ขีดจำกัดเหล่านี้ไม่ได้ถูกทดสอบความเครียดที่นี่
คำถามที่พบบ่อย
Fable 5.2 ดีกว่า Opus 5.5 สำหรับการเขียนโค้ดหรือไม่
Anthropic รายงานคะแนน Fable ที่สูงขึ้นในการประเมินการเขียนโค้ดที่ยากหลายรายการ แบบฝึกหัดการเขียนโค้ดของเราเป็นพื้นที่ทำงาน AI ไฟล์เดียว ไม่ใช่เกณฑ์มาตรฐานของที่เก็บโค้ด ดังนั้นจึงไม่สามารถระบุผู้ชนะทั่วไปในการเขียนโค้ดได้
Fable 5.2 มีค่าใช้จ่ายมากกว่าหรือไม่
อัตราอินพุตและเอาต์พุต API มาตรฐานของมันเป็นสองเท่าของ Opus 5.5: $8/$40 เทียบกับ $4/$20 ต่อล้านโทเค็น ต้นทุนงานจริงยังขึ้นอยู่กับการใช้งาน การให้เหตุผล การลองใหม่ การแคช และบริการที่เรียกเก็บเงินจากคุณ
การทดสอบเหล่านี้ทำงานภายใน GlobalGPT หรือไม่
ไม่ พวกเขาใช้โมเดลที่มีชื่อผ่านเกตเวย์ API ของบุคคลที่สาม พวกเขาไม่ได้สร้างความพร้อมใช้งานของโมเดล การเรียกเก็บเงิน หรือฟีเจอร์เนทีฟภายใน GlobalGPT หรือแอปของ Claude เอง
สามารถเชื่อถือโมเดลใดโมเดลหนึ่งในการสรุปงานวิจัยโดยไม่ตรวจสอบได้หรือไม่
คำตอบการวิจัยทั้งสองคำนวณผลลัพธ์หลักได้อย่างถูกต้อง แต่แต่ละคำตอบมีการอนุมานอย่างน้อยหนึ่งรายการที่ต้องแก้ไข ตรวจสอบรายละเอียดการออกแบบการศึกษาทุกรายการและแยกการประมาณการออกจากการอ้างความมีนัยสำคัญ
หน้าที่สร้างขึ้นดูดีกว่าพิสูจน์ความสามารถในการเขียนโค้ดที่ดีกว่าได้หรือไม่
ไม่ การออกแบบภาพ การโต้ตอบที่ทำงานได้ การเข้าถึง และความสามารถในการบำรุงรักษาเป็นมิติที่แยกจากกัน หน้าเดียวที่สวยงามไม่สามารถสร้างความน่าเชื่อถือในการเขียนโค้ดระดับที่เก็บข้อมูลได้
โมเดลได้รับความพยายามในการให้เหตุผลเท่าเทียมกันหรือไม่
เราใช้ข้อมูลนำเข้าและเพดานผลลัพธ์ที่เหมือนกัน โดยตั้งค่าการให้เหตุผลไว้ที่ค่าเริ่มต้นของแพลตฟอร์ม การแมปของเกตเวย์ไม่ได้รับการตรวจสอบอย่างอิสระ ดังนั้นนี่จึงไม่ใช่การเปรียบเทียบประสิทธิภาพที่ใช้ความพยายามเท่ากัน
ฉันควรเปลี่ยนงานทั้งหมดไปใช้ Fable 5.2 หรือไม่
ใช้การทดสอบการยอมรับเฉพาะงานก่อน เริ่มต้นด้วยโมเดลที่ถูกกว่าซึ่งผ่านเกณฑ์ จากนั้นย้ายงานที่ยากไปยัง Fable เมื่อคุณระบุการปรับปรุงที่คุ้มค่าได้
คำตัดสินสุดท้าย: คุณควรใช้โมเดลใด
เริ่มต้นด้วย Opus 5.5 เมื่อเป้าหมายคือร่างแรกที่ยอมรับได้ อัตราโทเค็นมาตรฐานที่ต่ำกว่าทำให้เป็นพื้นฐานที่ใช้งานได้จริงสำหรับการเขียนประจำ การล้างข้อมูล และการวางแผน สำหรับบริบทเพิ่มเติม โปรดดู รีวิว Claude Opus 5.5 ของเรา.
ลองใช้ Fable 5.2 เมื่องานยากเฉพาะอย่างยังไม่ผ่านเกณฑ์การยอมรับของคุณ คงอินพุตเดิมไว้และตรวจสอบว่าสามารถแก้ไขความล้มเหลวที่เกิดขึ้นจริงได้หรือไม่ คำแนะนำการเลือกโมเดล แนะนำให้เริ่มต้นด้วย Opus ล่าสุดและเพิ่มระดับเมื่อ Opus ที่ใช้ความพยายามสูงขึ้นยังไม่เพียงพอ
หากไม่จำเป็นต้องใช้โมเดลพรีเมียมทั้งสอง Sonnet 5.5 vs Opus 5.5 เป็นการเปรียบเทียบต้นทุนที่เกี่ยวข้องมากกว่า
สำหรับผู้ให้บริการที่หลากหลายยิ่งขึ้น โปรดดู การทดสอบเครื่องสร้างข้อความ AI ของเรา.
สำหรับงานกับที่เก็บโค้ด การสาธิตไฟล์เดียวในรีวิวนี้เป็นเพียงจุดเริ่มต้นเท่านั้น ไม่ได้ทดสอบการเข้าถึงเชลล์ การแก้ไขหลายไฟล์ การใช้เครื่องมือเป็นเวลานาน หรือพฤติกรรมการกู้คืนของเอเจนต์เขียนโค้ด สำหรับรายละเอียดการกำหนดค่า โปรดดูคำแนะนำของเรา การเลือกโมเดลใน Claude Code ก่อนที่จะถือว่าการเติมข้อความแชทเป็นสิ่งทดแทนสภาพแวดล้อมการพัฒนาเต็มรูปแบบ



