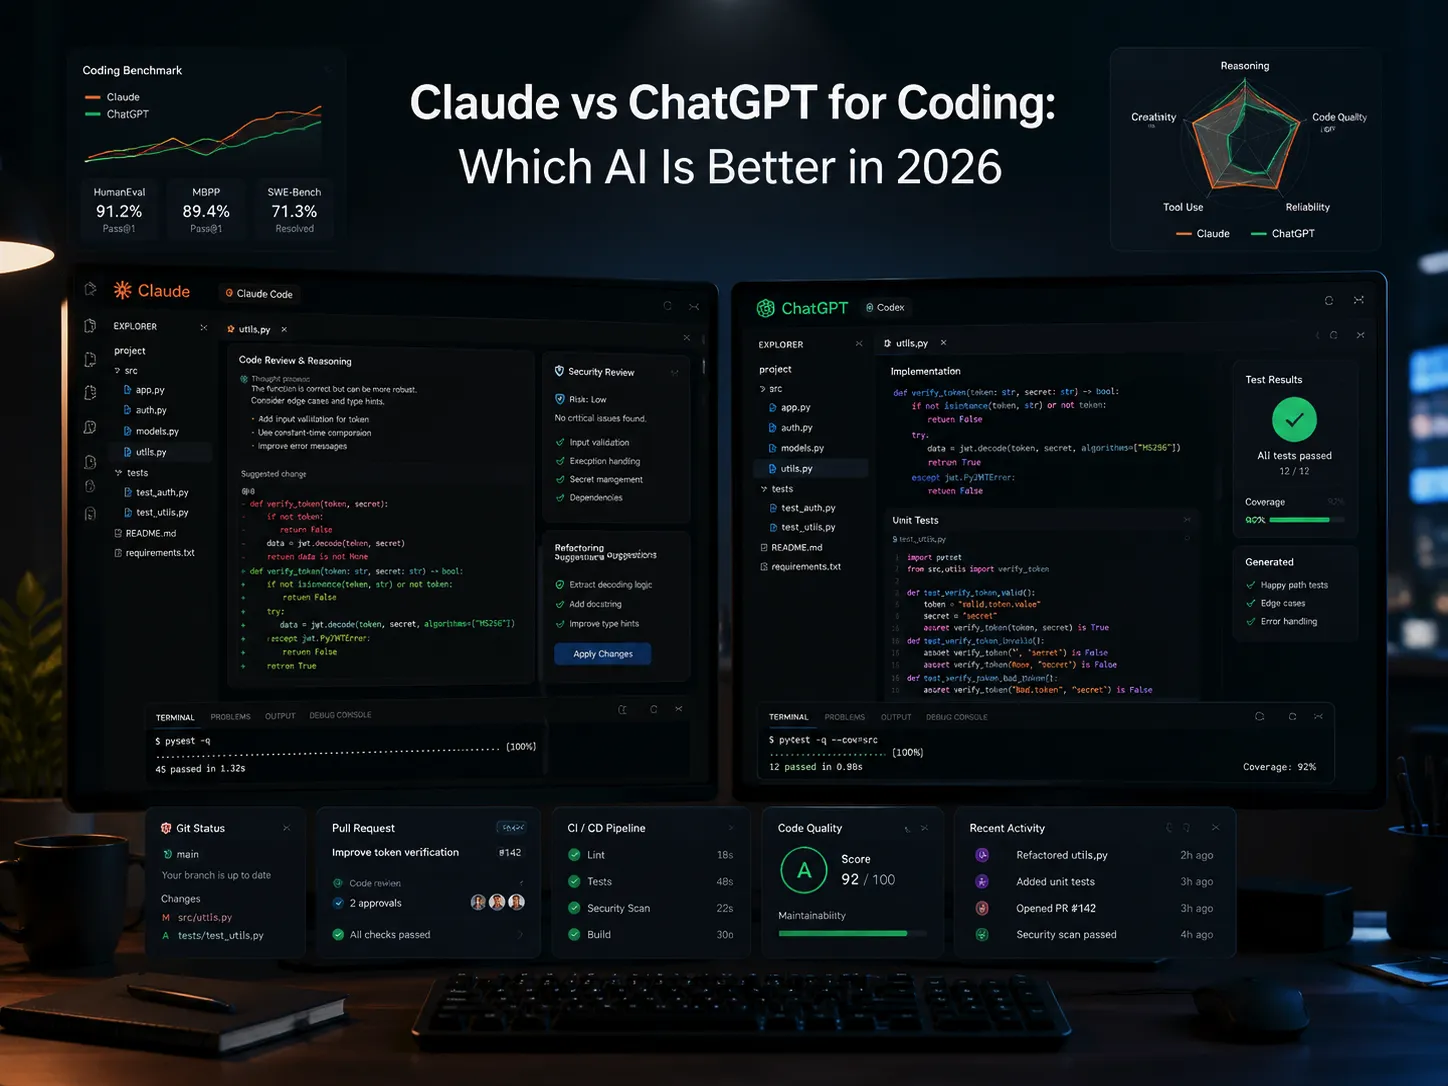
Для большинства задач по программированию Claude Sonnet 5 лучше подходит в качестве первого этапа для рецензирования кода, анализа первопричин, планирования архитектуры и рассуждений с учетом широкого контекста. ChatGPT лучше подходит в качестве первого этапа, когда требуется полный черновой вариант реализации, готовый к запуску тестовый каркас или готовые к копированию примеры. При работе на уровне репозитория сравнивайте Claude Code с Codex, а не оценивайте компании, основываясь исключительно на информации из окна чата.
Полезное деление не сводится просто к формулам “Claude выигрывает” или “ChatGPT выигрывает”. По состоянию на 31 июля 2026 года текущий линейка кодирующих устройств Anthropic включает Claude Fable 5, Opus 5 и Sonnet 5, в то время как модели GPT-5.6 Sol, Terra и Luna от OpenAI доступны в рамках ChatGPT, Codex и API. Приведенные ниже разделы с практическими примерами представляют собой устаревшее сравнение моделей Claude Sonnet 5 и GPT-5.5, протестированных с использованием одних и тех же промптов 7 июля 2026 года.
Если вы хотите сравнить модели, не заморачиваясь с отдельными подписками, GlobalGPT — это практичная мультимодельная рабочая среда с доступ к GPT 5.5, Клод Опус 4.8, Gemini 3.5 Flash, Perplexity и другие модели, если они доступны. Этот инструмент полезен для сравнения решений по программированию, планирования, написания кода и проведения исследований, но он не заменяет Claude Code, Codex, официальные API, IDE или рабочий процесс разработки с использованием репозиториев.
Содержание
- Клод против ChatGPT в программировании: краткий ответ
- Что изменилось в 2026 году
- Текущий ассортимент моделей кодирования
- Обзор тестов производительности: SWE-Bench, Terminal-Bench и их значение
- Как мы тестировали Claude и ChatGPT на способность писать код
- Тест 1: отладка и анализ первопричин
- Тест 2: рефакторинг и удобство сопровождения
- Тест 3: логическое мышление и планирование с использованием нескольких файлов
- Тест 4: модульные тесты и верификация
- Тест 5: оценка безопасности и надежности
- «Claude Code» и «Codex»: когда чата недостаточно
- Цены: Claude, ChatGPT, Codex и GlobalGPT
- Какую конфигурацию кодирования выбрать?
- Почему многие разработчики по-прежнему используют и то, и другое
- ЧАСТО ЗАДАВАЕМЫЕ ВОПРОСЫ
«Клод» против ChatGPT в программировании: краткий ответ
В наших тестах чата с одинаковыми запросами, проведённых 7 июля, модель Claude Sonnet 5 показала лучшие результаты на первом этапе, когда задача была неоднозначной: она расставила приоритеты среди вероятных причин, отсеяла лишнюю информацию и чётко объяснила риски. Модель GPT-5.5 показала лучшие результаты, когда следующим шагом была разработка более полного проекта реализации с импортами, тестовой инфраструктурой и более подробным кодом. Эти наблюдения относятся именно к данному тесту, а не ко всем будущим версиям модели.
Для повседневной разработки оптимальный рабочий процесс обычно выглядит следующим образом:
- Сначала воспользуйтесь «Клод» для проверки кода, классификации ошибок, принятия решений по архитектуре и ответов на вопросы типа “С чего мне начать проверку?”.
- Сначала воспользуйтесь ChatGPT для создания начальной реализации, написания тестовых шаблонов, подготовки примеров и воплощения плана в код.
- Используйте оба для миграций, изменений, связанных с безопасностью, платежей, аутентификации, загрузки файлов и всего, что может привести к повреждению производственных данных.
| Потребность в программировании | Лучший первый выбор | Почему |
|---|---|---|
| Устранение сложной ошибки | Клод первый | В ходе нашего тестирования система Claude определила вероятную причину как приоритетную и четко объяснила схему отказа. |
| Написание полного проекта реализации | Сначала ChatGPT | В ходе нашего тестирования GPT-5.5 предоставил более полный код и больше готовых к использованию шаблонов. |
| Анализ рисков, связанных с безопасностью или надежностью | Сначала Клод, потом ChatGPT | В версии Claude была четко определена степень серьезности; в версии ChatGPT были добавлены конкретные шаблоны реализации. |
| Изменение файлов в репозитории | Claude «Код» или «Кодекс» | Контекст репозитория, выполнение команд, тесты и сравнения кода важнее, чем ответ, состоящий исключительно из чата. |
Если ваш главный вопрос заключается в том, какая семейство моделей лучше всего подходит для программирования в целом, то в более широком смысле Лучшая модель искусственного интеллекта для кодирования Это сравнение станет полезным материалом для дальнейшего чтения. Если вы планируете остаться в экосистеме OpenAI, то лучшая модель ChatGPT для кодирования В этом руководстве более подробно описан процесс выбора модели GPT.
Что изменилось в 2026 году
Чтобы провести обоснованное сравнение с 2026 годом, необходимо учесть три изменения.
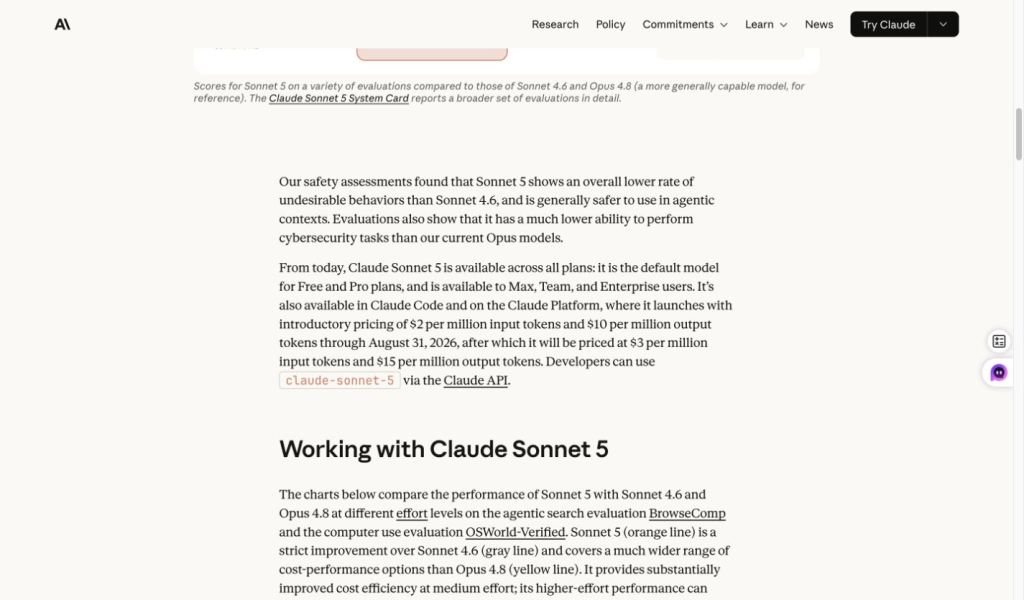
Во-первых, «Клод: Сонет № 5» изменил позицию Клода в этом решении. Компания Anthropic сообщает, что Sonnet 5 доступен во всех тарифных планах и в рамках Claude Code, а разработчикам предоставляется доступ к платформе Claude. Это важно, поскольку Claude больше не является лишь чат-помощником для объяснения кода; он является частью рабочего процесса программистских агентов компании Anthropic.
Во-вторых, GPT-5.6 в настоящее время является действующим семейством моделей OpenAI, предназначенным для кодирования. 9 июля 2026 года компания OpenAI вывела модель GPT-5.6 из режима ограниченного предварительного доступа. Sol — это флагманская модель, Terra — сбалансированный вариант, а Luna — более доступный вариант для массового производства. По данным OpenAI, данное семейство доступно в ChatGPT, Codex и API, причём точный доступ к моделям зависит от тарифного плана и функционала продукта.


В-третьих, чат-боты и программы для написания кода выполняют разные части работы. Обычный чат полезен для обмена фрагментами кода, отладки, объяснений и планирования. Claude Code и Codex — это рабочие процессы с поддержкой репозиториев, предназначенные для просмотра файлов, запуска команд, тестирования изменений и работы над крупными задачами. Объективное сравнение позволяет отделить качество вывода в чате от возможностей самого продукта-кодирующего агента.
Текущий ассортимент моделей Coding
По состоянию на июль 2026 года сравнение кодов представляет собой выбор из нескольких вариантов, а не простое противостояние «Claude против ChatGPT»:
| Боковая часть | Актуальные модели, на которые стоит обратить внимание | Лучшие примеры использования кода |
|---|---|---|
| Клод | Claude Fable 5, Claude Opus 5, Claude Sonnet 5 и Claude Haiku 4,5 | Анализ в широком контексте, планирование, отладка, агентское программирование и рабочие процессы Claude Code. |
| ChatGPT / OpenAI | GPT-5.6 Sol, GPT-5.6 Terra и GPT-5.6 Luna — при условии наличия соответствующего тарифного плана и доступа к продукту | Реализация, работа над интерфейсом, тестирование, рабочие процессы с использованием инструментов и задачи по Codex. |
| GlobalGPT | Несколько моделей GPT, Claude, Gemini, Perplexity и других, при наличии | Сравнение подсказок в параллельном режиме, повседневные вопросы по коду, исследования и оценка подходов. |

Если вы отслеживаете доступ к Claude и детали плана, ознакомьтесь с отдельным Планы «Claude AI» на 2026 год руководство и более глубокое Руководство по ценообразованию ИИ Клода. Если вы сравниваете тарифные планы OpenAI, то Тарифные планы ChatGPT на 2026 год «Breakdown» — это более лаконичная версия этой работы.
Обзор тестов производительности: SWE-Bench, Terminal-Bench и их значение
Тесты производительности полезны тем, что показывают, как модели ведут себя при выполнении контролируемых задач кодирования. Главное — правильно понимать, что именно измеряет каждый тест. Результаты теста в виде задачи в репозитории, теста «терминал-агент» и официальной таблицы запуска модели — это не одно и то же, поэтому их следует использовать в сочетании с приведенными ниже практическими тестами.
GPT-5.5: Данные о кодировании по дате проведения теста
Приведенный ниже материал по серии GPT-5.5 сохранен, поскольку он соответствует модели, использовавшейся в практическом сравнении от 7 июля. Он подтверждает выводы тестового раздела, основанные на конкретных реализациях, но его не следует рассматривать как актуальный модельный ряд OpenAI; в настоящее время активным семейством, охватывающим ChatGPT, Codex и API, является GPT-5.6.
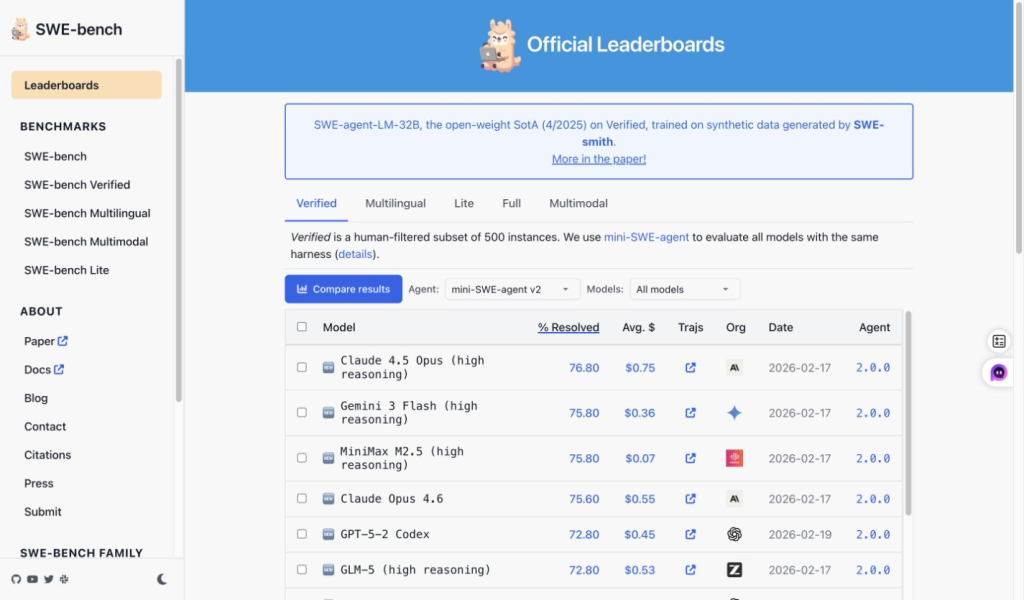
SWE-Bench: устранение проблем с репозиторием
SWE-Bench это полезно, поскольку более близко к реальному сопровождению программного обеспечения, чем подсказка в виде короткого фрагмента кода. Система анализирует задачи в репозитории и проверяет, может ли модель сгенерировать изменения, позволяющие решить поставленную задачу. Что касается сравнения Claude и ChatGPT, это даёт некоторое представление об уровне программно-технической компетенции, но всё же не раскрывает всей картины в отношении качества объяснений, оценки рецензирования или того, насколько полезным воспринимается ответ в контексте чата.
SWE-Bench Pro: более сложные задачи по программированию и показатель успешности решения
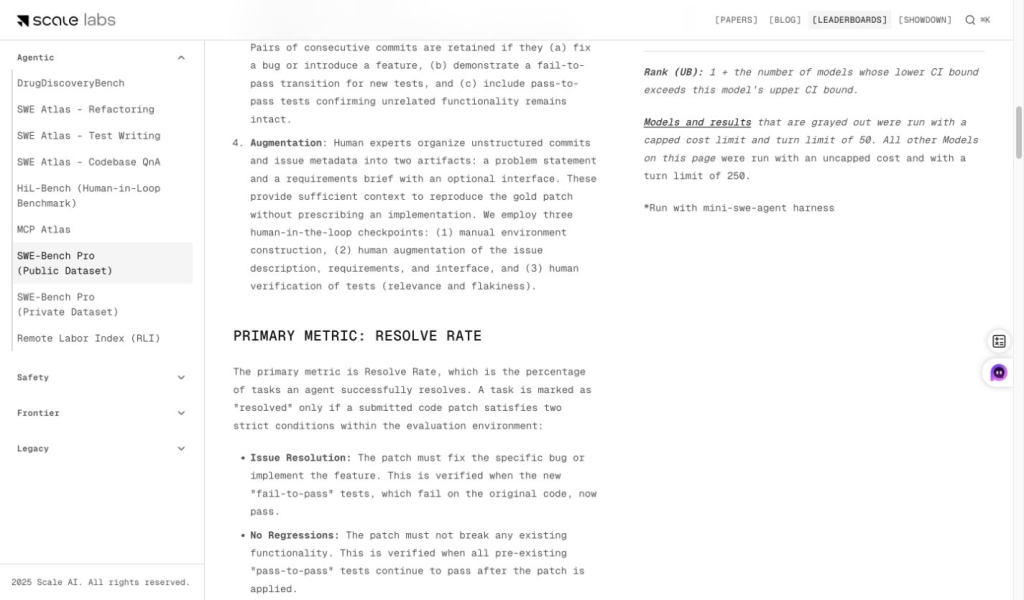
Публичная таблица лидеров SWE-Bench Pro от Scale является более строгим показателем, поскольку он ориентирован на более сложные задачи, связанные с репозиторием, и использует коэффициент устранения ошибок в качестве основного показателя. Это особенно полезно, когда вас интересуют реальные возможности агента по устранению ошибок: не просто способность модели объяснить причину ошибки, а её способность привести репозиторий к рабочему исправлению в условиях тестового набора.
Terminal-Bench: задачи командной строки и рабочих процессов агентов
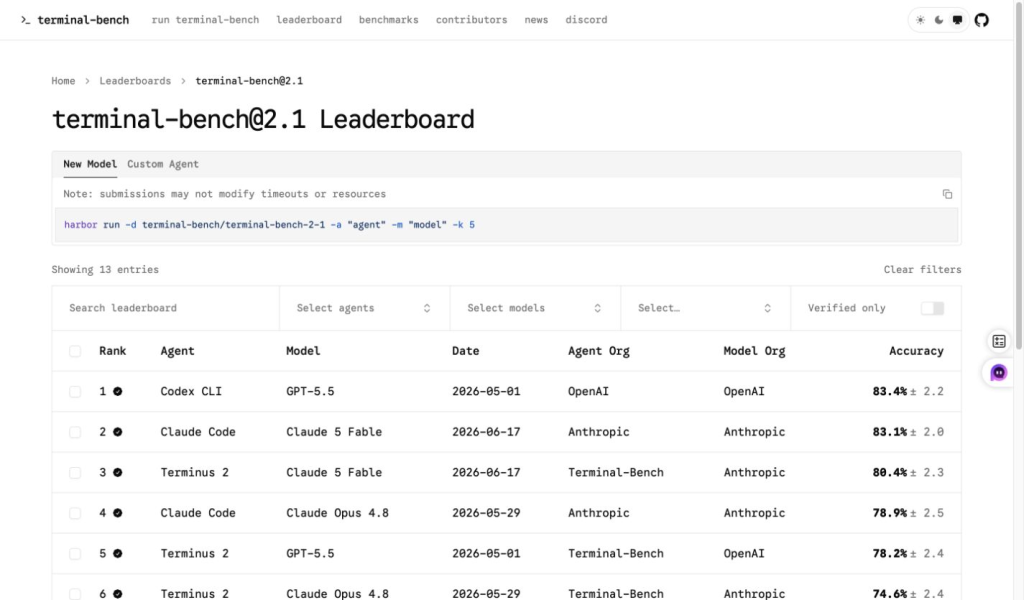
Terminal-Bench 2.1 отличается от SWE-Bench тем, что ориентирован на выполнение задач в терминале и командной строке с помощью настроек агентов и моделей. Благодаря этому он более актуален для рабочих процессов в стиле Claude Code и ChatGPT Codex, чем для обычного чат-запроса типа “напиши эту функцию”. Если вы выбираете помощника по программированию для работы на уровне репозитория или в командной строке, этот тест следует учесть при принятии решения.
| Доказательства | Лучшее чтение для | Практические выводы |
|---|---|---|
| Учебные материалы по программированию OpenAI GPT-5.5 | Программирование GPT-5.5 и агентный подход в программной инженерии. | Широкая поддержка ChatGPT в качестве помощника по программированию, ориентированного на практическую реализацию. |
| SWE-Bench | Решение проблем в репозитории и задачи по сопровождению программного обеспечения. | Хороший показатель навыков программирования, особенно когда контекст репозитория имеет значение. |
| SWE-Bench Pro | Более сложные задачи репозитория и сравнение показателей успешного решения. | Полезно для оценки серьезных способностей к агентивному кодированию. |
| Terminal-Bench 2.1 | Задачи терминала, выполнение команд и настройка агентов/моделей. | Это имеет большее отношение к рабочим процессам Claude Code и Codex, чем простые подсказки в чате. |
Результаты тестов делают оба семейства моделей достойными вариантами для программирования, но они не определяют выбор в повседневной работе. В приведенных ниже разделах используются одинаковые задания по отладке, рефакторингу, планированию, модульным тестам и проверке безопасности, чтобы вы могли увидеть, в чем на практике различались ответы.
Как мы тестировали Claude и ChatGPT на способность писать код
Мы протестировали модели GPT-5.5 и Claude Sonnet 5 в июле 2026 года в среде GlobalGPT, используя тот же интерфейс и те же подсказки. Цель заключалась не в том, чтобы воссоздать полноценный тест производительности агента IDE, а в том, чтобы сравнить повседневную помощь в программировании: отладку, рефакторинг, анализ нескольких файлов, написание тестов и проверку безопасности.

Система оценки была проста: правильность, анализ первопричин, удобство сопровождения кода, охват пограничных случаев, верификация и соблюдение инструкций. Это позволяет максимально точно отразить реальные условия использования разработчиками ИИ-помощников по программированию.
Тест 1: Отладка и анализ первопричин
В первом задании обеим моделям было предложено проанализировать функцию на JavaScript, которая группирует заявки по приоритету. Ошибка незаметная, но довольно распространённая: функция пытается добавить в acc[ticket.priority] до того, как этот массив появится.
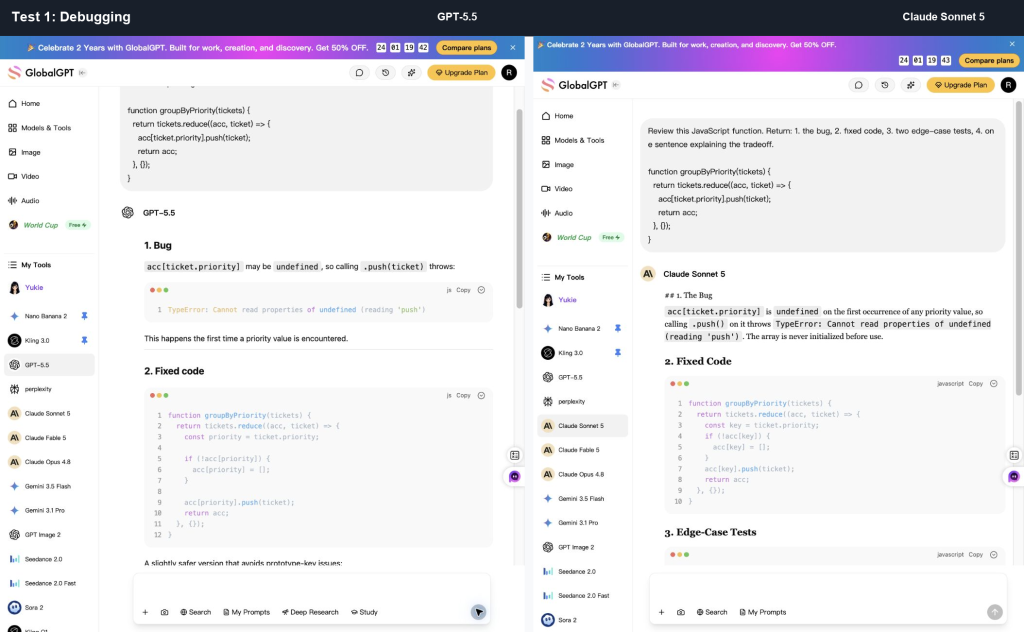
Что у ChatGPT получилось хорошо: GPT-5.5 обнаружил ошибку, предоставил исправленный код, добавил тесты для крайних случаев и включил более надежный Object.create(null) вариант. Эта дополнительная деталь реализации пригодится в тех случаях, когда ключи объектов могут вступать в конфликт с унаследованными свойствами.
Что у Клода получилось хорошо: Клод Соннет 5 обнаружил ту же ошибку и дал более исчерпывающий ответ. Он также указал на крайний случай с неопределённым приоритетом — именно такие практические граничные ситуации должен учитывать рецензент.
Победитель: Ничья, с небольшим преимуществом ChatGPT в плане нюансов реализации. Claude был лаконичнее; GPT-5.5 — полнее.
Тест 2: Рефакторинг и удобство обслуживания
Во втором задании предлагалось провести рефакторинг с целью повышения читаемости кода без изменения его поведения. Это хороший тест, поскольку во многих ответах, сгенерированных ИИ, происходит чрезмерный рефакторинг небольших утилит, в результате чего создается больше «движущихся частей», чем требуется исходному коду.
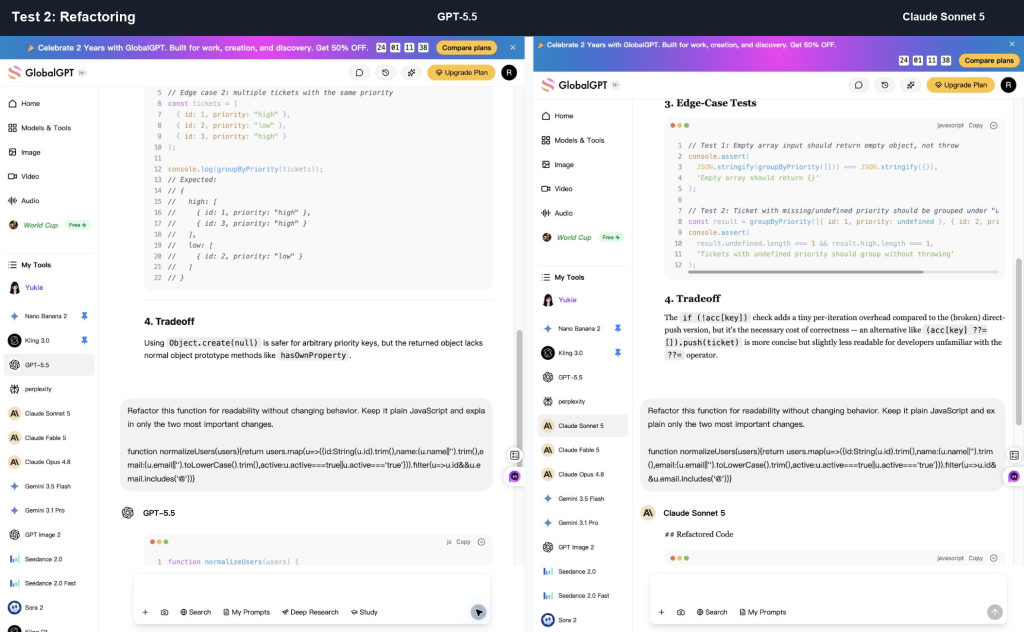
Что у ChatGPT получилось хорошо: GPT-5.5 сохранил структуру, близкую к исходной, ввёл именованные промежуточные значения и четко выполнил инструкцию “только два важных изменения”. Это ценно в тех случаях, когда пользователю требуется консервативный рефакторинг.
Что у Клода получилось хорошо: Claude Sonnet 5 выделил вспомогательные функции, такие как нормализатор и валидатор. В результате текст стал проще для просмотра, но его структура изменилась в большей степени, чем при использовании GPT-5.5.
Победитель: ChatGPT — для сдержанности; Claude — для модульной читаемости. Если вам нужен безопасный минимальный рефакторинг, начните с ChatGPT. Если вы хотите сделать именование в предметной области более понятным, обратитесь к Claude для повторного прохода.
Тест 3: Анализ и планирование с использованием нескольких файлов
В третьем задании было представлено небольшое дерево файлов Next.js и сообщение об ошибке: авторизованные пользователи могут загружать небольшие файлы, но при попытке загрузки файлов размером более 8 МБ происходит скрытая ошибка после того, как индикатор выполнения достигает значения 100%.
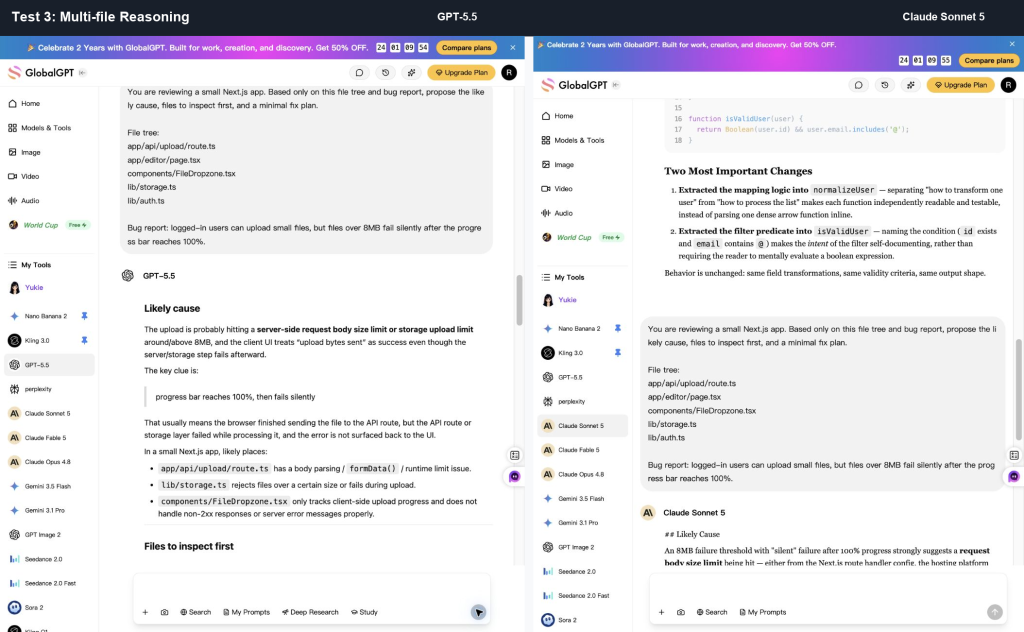
Что у ChatGPT получилось хорошо: GPT-5.5 сформировал подробный план, ориентированный на реализацию. В нём упоминались проверки размера сервера, обработка ответов клиентов и распространение ошибок хранилища.
Что у Клода получилось хорошо: Клод Соннет 5 сразу же сосредоточился на пороге в 8 МБ, вероятных ограничениях, связанных с платформой или размером корпуса, семантике индикатора выполнения и пути проверки 7 МБ/8 МБ/9 МБ. Это больше походило на заметку старшего специалиста по проверке.
Победитель: Клод. Это позволило быстрее определить вероятную причину и выработать более четкий план минимальных проверок.
Тест 4: Модульные тесты и верификация
В четвёртом задании обеим моделям было предложено написать модульные тесты на TypeScript для вспомогательной функции, возвращающей ограничения плана на загрузку файлов и доступ к Codex. Это позволяет проверить, способна ли модель защитить логику ветвления от возможных регрессий в будущем.
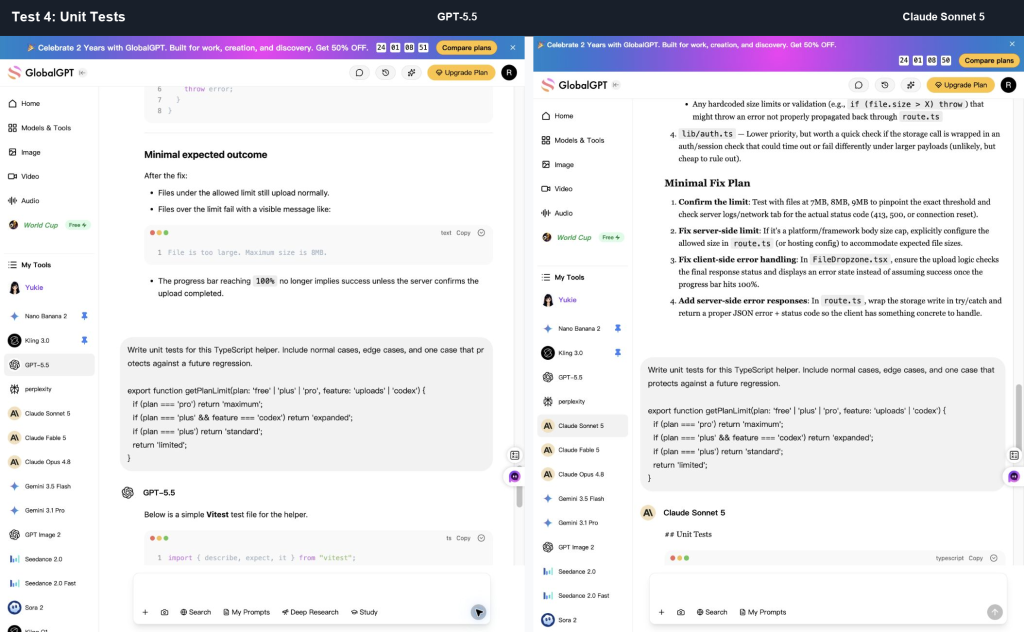
Что у ChatGPT получилось хорошо: GPT-5.5 импортировал библиотеки тестовой инфраструктуры и сгенерировал файл Vitest, который выглядел готовым к запуску. Он охватывал все ожидаемые комбинации и позволял легко вставить готовый код в проект.
Что у Клода получилось хорошо: Клод Соннет в своём «Сонете № 5» лучше объяснил реальный риск регрессии: pro + codex должно вызывать сбой до выполнения проверок, специфичных для данной функции. Это был более убедительный ответ с точки зрения логики, хотя с точки зрения готовности к использованию в виде отдельного файла он был менее удобен.
Победитель: Claude — для разработки тестов; ChatGPT — для генерации исходного файла. На практике используйте ChatGPT для создания первого чернового варианта тестов, а Claude — для оценки того, обеспечивают ли эти тесты проверку правильного поведения.
Тест 5: Анализ безопасности и надёжности
В пятом задании обеим моделям было предложено проанализировать конечную точку веб-хука Express. Правильный ответ должен учитывать проверку подписи, требования к необработанному телу запроса, идемпотентность, валидацию, обработку ошибок базы данных и ограничения на размер запроса.
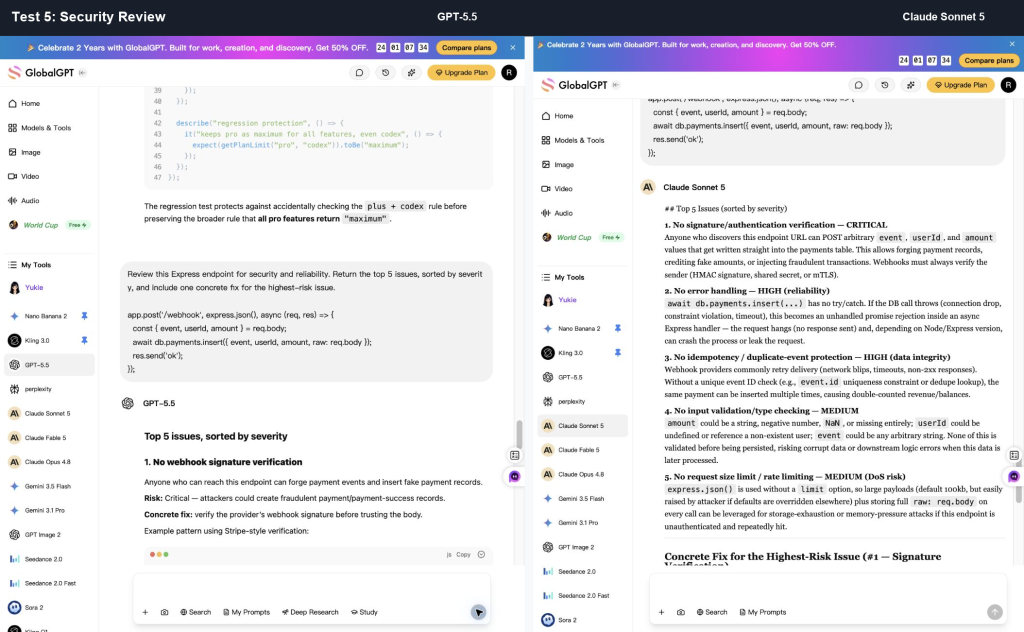
Что у ChatGPT получилось хорошо: GPT-5.5 предложил решение в стиле провайдера, включая решение, подобное Stripe, express.raw() шаблон. Это полезно, когда следующим шагом становится реализация конкретного обработчика веб-хука.
Что у Клода получилось хорошо: В «Claude Sonnet 5» было представлено более четкое обоснование строгости и включены более надежные детали сравнения подписей с использованием подходов, основанных на сравнении за постоянное время. Благодаря этому ранжирование рисков стало более точным.
Победитель: Ничья, с небольшим преимуществом модели «Клод» в плане объяснения аспектов безопасности. Обе модели оказались достаточно убедительными, чтобы быть полезными, но ни один из этих подходов не должен заменять реальную экспертизу безопасности процессов оплаты или аутентификации.
Claude Code против ChatGPT Codex
Вывод чата — это лишь одна из составляющих процесса принятия решений при программировании. Claude Code и Codex — это отдельные рабочие процессы для разработки агентов, предназначенные для задач, связанных с файлами, командами, тестами, запросами на слияние или более масштабными изменениями в кодовой базе.


| Рабочий процесс | Лучшая посадка | Важная граница |
|---|---|---|
| Чат с Клодом | Анализ, отладка, проверка, разъяснение и планирование. | Он учитывает только тот контекст, который вы ему предоставляете, если только он не связан с какими-либо инструментами или более широким рабочим процессом. |
| Чат ChatGPT | Проекты реализации, тесты, примеры и вопросы по использованию API. | Даже убедительный ответ все равно необходимо проверить в рамках вашего проекта. |
| Код Клода | Программирование с учетом репозиториев, навигация по кодовой базе, тестирование и планирование крупных задач. | Перед утверждением изменений ознакомьтесь с правами доступа, политикой безопасности и предложенным списком изменений. |
| Кодекс | Реализация с учетом Repo, отладка, тестирование, рецензирование и рабочие процессы программирования, интегрированные с OpenAI. | Условия доступа, использования и доступность моделей отличаются от обычного чата и могут меняться со временем. |
Практический подход: используйте чат-модели для анализа, объяснений и выполнения небольших задач; прибегайте к Claude Code или Codex, когда для работы требуется контекст репозитория и последовательность исполняемых шагов.
Цены: Claude, ChatGPT, Codex и GlobalGPT
Для начала спросите себя, за что вы платите. Тарифный план «Чат» предусматривает ежедневную интерактивную помощь в программировании. Тарифный план «Кодирующий агент» предусматривает выполнение задач с учетом репозиториев, таких как CLI, IDE, веб-задачи, облачные задачи или интеграции. Тарифы на API рассчитываются за миллион токенов. Тарифный план «Мультимодельное рабочее пространство» позволяет легко переключаться между моделями Claude, GPT, Gemini, Perplexity и другими в одном месте.

По состоянию на 7 июля 2026 года общественность Страница с ценами на продукцию Claude, Страница с ценами на OpenAI Codex, Документация по ценам на платформу Claude, и Страница заказа GlobalGPT показать следующие цены:
| Продукт или тарифный план | Указанная цена | Что это означает для программирования |
|---|---|---|
| Клод Фри | $0 | Этого достаточно, чтобы решить простые задачи по программированию и опробовать стиль Claude перед тем, как заплатить. |
| Клод Про | $17/месяц с годовым выставлением счетов или $20/месяц с ежемесячным выставлением счетов | Первый полноценный уровень «Клод» для более интенсивного использования чата; на странице «Клод» также указан «Код Клода» в версии Pro. |
| Клод Макс | От $100 в месяц | Идеально подходит для разработчиков, которые достигли лимитов версии Pro или активно используют Claude в процессе исследования, планирования и программирования. |
| ChatGPT / Codex — бесплатно | $0/месяц | Подходит для быстрых тестовых версий и несложных задач по программированию; объем доступа к Codex может варьироваться в зависимости от тарифного плана. |
| ChatGPT / Codex Go | $8/месяц | Недорогое решение для упрощения кодирования и расширения возможностей использования. |
| ChatGPT / Codex Plus | $20/месяц | Практическая отправная точка OpenAI для регулярных заданий по программированию и сессий Codex. |
| ChatGPT / Codex Pro | От $100 в месяц | Для более интенсивного использования и более высоких лимитов; перед оформлением подписки ознакомьтесь со страницей тарифного плана «Codex». |
| API «Клод Соннет 5» | Вход $2/M и выход $10/M до 31 августа 2026 года; вход $3/M и выход $15/M с 1 сентября 2026 года | Сбалансированный вариант Claude для инструментов кодирования и рабочих процессов с большим контекстом. |
| Claude Opus 5 API | Вход $5/M и выход $25/M | Рекомендуемая отправная точка Anthropic для работы со сложным агентивным кодированием и корпоративными проектами. |
| GlobalGPT Basic | $5,8 в месяц, оплата ежегодно; на карте также указано $11,9 в месяц | Экономичный способ сравнить несколько семейств моделей для повседневных задач кодирования и научных исследований. |
| GlobalGPT Pro | $10,8 в месяц, оплата ежегодно; на карте также указано $19,9 в месяц | Более удобно при переключении между несколькими семействами моделей в ходе повседневной работы. |
| GlobalGPT Unlimited | $25,0 в месяц, оплата ежегодно; на карте также указано $49,9 в месяц | Для частого сравнения нескольких моделей в одном рабочем пространстве. |
Для большинства индивидуальных разработчиков вопрос заключается не в том, “какая компания дешевле?”, а в том, “какая цена соответствует моему рабочему процессу?”. Если вы в основном задаете вопросы и вставляете фрагменты кода, вам может хватить Claude Pro или ChatGPT Plus. Если вам нужна реализация с поддержкой репозиториев, сравните возможности Claude Code и Codex. Если вы ежедневно сравниваете несколько моделей, GlobalGPT может стать более удобным рабочим пространством для повседневной работы, поскольку его стоимость привязана к одному мультимодельному тарифу, а не к нескольким отдельным подпискам.
В случае инструментов для программирования, интенсивно использующих API, цены на подписку не являются подходящим критерием сравнения. Более важную роль играет стоимость токенов, поскольку объем контекста кода значителен. Claude Sonnet 5 обходится дешевле, чем Claude Opus 4.8, с точки зрения затрат на ввод и вывод данных через API, хотя Opus 4.8 позиционируется как более мощная модель премиум-класса. При работе с API OpenAI используйте актуальную таблицу цен на API OpenAI для конкретной модели и конечной точки, к которой вы планируете обратиться, поскольку цены на планы ChatGPT и Codex не отражают стоимость использования API.
Какую конфигурацию кодирования выбрать?
Не ориентируйтесь исключительно на название модели. Ориентируйтесь на тот вид программистской работы, которым вы фактически занимаетесь. Один и тот же человек может использовать ChatGPT для первоначальной реализации, Claude — для рецензирования, Codex — для работы с репозиториями исполняемых файлов, а GlobalGPT — для быстрой параллельной проверки моделей в ходе обычного рабочего дня.
Начинающий программист: Начните с ChatGPT. Обычно он предоставляет больше примеров, больше подсказок и предлагает более понятный путь от “Я не понимаю эту ошибку” до “Вот рабочий вариант”.”
Младший разработчик, устраняющий ошибки: Если проблема пока неясна, начните с Claude. Claude хорошо справляется с сужением круга вероятных причин, указывает, что следует проверить в первую очередь, и помогает сосредоточить внимание на сути объяснения. После этого воспользуйтесь ChatGPT, если вам нужен конкретный патч, тестовый случай или пример реализации.
Старший инженер, проверяющий изменение: Начните с Claude. Эта модель лучше подходит для поиска компромиссных решений, оценки степени серьезности проблем, решения архитектурных вопросов и лаконичной критики. Для задач, связанных с большими кодовыми базами, переходите из чата в Claude Code или Codex, чтобы модель могла работать с файлами и командами, а не с вставленным фрагментом кода.
Инструмент для разработки интерфейса или пользовательского интерфейса: Для первого прохода начните с ChatGPT. Он, как правило, генерирует более полный код компонентов, механизмы управления состоянием и каркасы тестов. Затем воспользуйтесь Claude, чтобы проверить доступность, границы компонентов, именование, а также то, не является ли код слишком «хитроумным» для данного дизайна.
Сопровождающий обширную кодовую базу: Выбирайте «Claude Code» или «Codex» в зависимости от вашего стека, прав доступа к учетной записи, политики безопасности и предпочтительного рабочего процесса. Когда задача затрагивает несколько файлов, рабочий процесс агента обычно имеет большее значение, чем то, какой ответ в чате звучит лучше.
Одиночный основатель или небольшая команда: Если позволяет бюджет, используйте оба семейства моделей. Практичным вариантом является использование GlobalGPT для ежедневного сравнения моделей и генерации кода на основе идей, а также Claude Code или Codex — когда для выполнения задачи требуется доступ к репозиторию и выполнение конкретных шагов.
| Тип разработчика | Лучший вариант для начала | Почему |
|---|---|---|
| Новичок, изучающий программирование | ChatGPT | Больше примеров, более подробные объяснения и пошаговые инструкции для начинающих. |
| Младший разработчик, занимающийся исправлением ошибок | Клод первый | Более четкое анализ первопричин и более четкие рекомендации по тому, “что следует проверить в первую очередь”. |
| Старший инженер, проверяющий изменение | Клод | Более подходящий подход для анализа компромиссов, оценки рисков и лаконичной критики. |
| Разработчик интерфейса пользователя (Frontend/UI) | Сначала ChatGPT, потом Claude | ChatGPT составляет черновой вариант компонента; Claude проверяет его доступность, структуру и удобство обслуживания. |
| Ответственный за сопровождение обширного кода | «Claude Code» или «Codex» — в зависимости от стека и способа доступа | Файлы, команды, тесты и права доступа имеют большее значение, чем один ответ в чате. |
| Единственный основатель | И то, и другое — зачастую в рамках одной мультимодельной рабочей среды | Быстрое создание черновых вариантов, тщательная проверка и оперативная смена моделей — все это имеет значение, когда за продукт отвечает один человек. |
Если вы выбираете между новыми семействами моделей Claude и GPT, то «Клод Фэйбл 5» против GPT-5.5 Сравнение позволяет лучше понять контекст конкретной модели. Если вы выбираете между платными тарифными планами OpenAI, то ChatGPT Plus vs Pro Такое сравнение поможет определить, оправдывает ли себя более интенсивное использование.
Почему многие разработчики по-прежнему используют и то, и другое
Использование и «Клода», и ChatGPT — это не проявление нерешительности. Это более эффективный цикл контроля качества.
- Планируем вместе с Клодом, реализуем с помощью ChatGPT: Это полезно, когда нужно, чтобы Клод оценил степень риска, а GPT-5.5 сгенерировал первоначальный вариант реализации.
- Составьте черновик с помощью ChatGPT, проверьте его с помощью Claude: Это пригодится, когда вам нужен быстро написанный код, но при этом вы хотите получить более строгую оценку со стороны.
- Прежде чем приступить к производству, уточните следующее: полезно для осуществления платежей, аутентификации, загрузки данных, миграции, кэширования и операций, приводящих к необратимым изменениям в базе данных.
- Используйте агент, если для выполнения задачи требуются файлы: «Claude Code» или «Codex» могут оказаться важнее обычного чата, когда модели требуется контекст из репозитория.
GlobalGPT подходит для сценария “использования обоих”, когда речь идет о сравнении промптов, повседневной помощи в программировании, планировании или исследовательской работе. Он особенно полезен для ежедневного сравнения моделей, доработки черновых вариантов, получения быстрого второго мнения и выбора стиля модели, который лучше всего подходит для следующей работы.
Если вы оцениваете исключительно доступ к Claude, то Лучшие альтернативы Claude AI Этот список представляет собой более обширное руководство на случай, если что-то пойдет не так.
ЧАСТО ЗАДАВАЕМЫЕ ВОПРОСЫ
Что лучше для программирования в 2026 году: Claude или ChatGPT?
Сначала выбирайте Claude для рецензирования кода, устранения неоднозначных ошибок, планирования архитектуры и рассуждений, требующих учета длительного контекста. Сначала выбирайте ChatGPT для черновых вариантов реализации, примеров, работы с интерфейсом и создания каркаса тестов. Если для выполнения задачи требуется доступ к репозиторию, выполнение команд, проведение тестов или редактирование нескольких файлов, сравнивайте код Claude с Codex, а не полагайтесь исключительно на чат.
Клод лучше ChatGPT для отладки?
Claude часто лучше подходит для первого этапа отладки, поскольку он, как правило, выделяет наиболее вероятную причину и чётко объясняет цепочку сбоев. В наших тестах на JavaScript и Next.js модель Claude Sonnet 5 особенно хорошо справлялась с лаконичной диагностикой. ChatGPT по-прежнему показывал хорошие результаты в тех случаях, когда для исправления требовались более подробные сведения о реализации.
ChatGPT Codex лучше, чем Claude Code?
Ни один из них не является автоматически лучшим решением для любой команды. ChatGPT Codex подходит для рабочих процессов, ориентированных на OpenAI, и задач агентов, требующих значительных усилий по внедрению. Claude Code демонстрирует свои преимущества в тех случаях, когда в работе полезны такие особенности Claude, как планирование, анализ и способность к рассуждениям в условиях длинного контекста. Выбор оптимального варианта зависит от доступа к репозиторию, стоимости, технологического стека, прав доступа и политики команды.
Что лучше подходит для большого кодового базы?
В случае обширной кодовой базы рабочий процесс агента имеет большее значение, чем сама по себе модель чата. Используйте Claude Code или Codex, когда помощнику необходимо просматривать файлы, запускать команды, выполнять тесты или отслеживать поведение между модулями. Оставляйте проверку человеком для вопросов, связанных с разрешениями, рискованными командами и окончательным сравнением изменений.
Что лучше подходит для начинающих, изучающих программирование?
ChatGPT, как правило, проще для новичков, поскольку он, как правило, предоставляет больше примеров, более полные объяснения и готовые к использованию фрагменты кода. Claude может оказаться более подходящим, когда новичок заходит в тупик, пытаясь понять, почему что-то не работает, и нуждается в более понятном концептуальном объяснении.
Что лучше подходит для написания HTML-кода и кода пользовательского интерфейса?
ChatGPT часто лучше подходит для создания первоначального черновика кода HTML, CSS или компонентов. Claude полезен для проверки структуры, упрощения макета и выявления проблем с доступностью или удобством обслуживания. Для доработки фронтенд-кода используйте ChatGPT для создания черновика, а Claude — для его проверки.
Какая модель лучше подходит для написания тестов?
ChatGPT лучше подходит, если вам нужен полноценный тестовый файл с импортами и структурой, которая выглядит готовой к запуску. Claude лучше подходит, если вам нужно понять, какое поведение требует защиты и почему регрессионное тестирование имеет значение. Эффективный рабочий процесс заключается в том, чтобы сначала сгенерировать тесты с помощью ChatGPT, а затем спросить у Claude, какие пограничные случаи были упущены.
Помогают ли такие тесты производительности, как SWE-Bench, определить, какой помощник в программировании лучше?
Нет. Показатели SWE-Bench, SWE-Bench Pro и Terminal-Bench являются ценными индикаторами, особенно для рабочих процессов агентного кодирования, но они не позволяют в полной мере предсказать эффективность ежедневной помощи в кодировании. Тесты измеряют работу в контролируемой среде; реальным разработчикам также необходимы четкое обоснование, удобный в использовании код, изменения, которые легко поддерживать, и качественные этапы проверки.
Стоит ли разработчикам использовать и Claude, и ChatGPT?
Да, особенно для серьёзной работы. Используйте Claude для разработки плана, анализа рисков и диагностики. Используйте ChatGPT для создания черновых вариантов реализации, примеров и тестовых каркасов. Затем запустите код, проанализируйте разницу в коде и проверьте поведение в своём собственном проекте.
Можно ли сравнить Claude и ChatGPT в GlobalGPT?
Да. GlobalGPT удобно использовать для сравнения ответов Claude и ChatGPT в одном рабочем пространстве, если там доступны необходимые модели. Этот инструмент хорошо подходит для повседневных вопросов по коду, планирования, исследований и получения второго мнения. Он не заменяет Claude Code, Codex, IDE, официальные API или инструменты на уровне репозитория.