
Claude Sonnet 5.5 против Opus 5.5: цена, тесты производительности и практические испытания
Модели Sonnet 5.5 и Opus 5.5 относятся к одному поколению Claude 5.5, однако их цены и позиционирование различаются. В рамках данного сравнения обе модели прошли тестирование по пяти одинаковым запросам, и в отчете приведены фактические результаты, полученные при их использовании.
Разница, по сути, заключается в стоимости и скорости. В этом наборе из пяти заданий модель Sonnet 5.5 завершила работу быстрее, использовала меньше токенов вывода и дала более низкую оценку арифметической стоимости запроса. Модель Opus 5.5 затратила больше токенов и времени, при этом её ответы зачастую были более развернутыми. На карточках с заданиями показано, в каких случаях этот дополнительный текст повлиял на полезный результат, а в каких обе модели просто справились с задачей.
Параметры запросов, верхний предел запросов, настройка интенсивности, конечная точка и подход «один прогон на модель» были сохранены в соответствии с предыдущим Обзор Claude Opus 5.5.
Краткий ответ
- Скорость в этом заезде с равными соперниками: Sonnet 5.5 выполнил пять последовательных запросов локально за 31,930 секунд; у Opus 5.5 это заняло 47,725 секунд.
- Токены вывода, указанные в маршруте: В Sonnet 5.5 использовалось 2 686; в Opus 5.5 — 3 952. Количество полей анализа составило 987 и 2 214 соответственно.
- Расчетная стоимость по прейскуранту: стоимость пяти запросов на Sonnet составила примерно $0.02826; стоимость пяти запросов на Opus составила примерно $0.08184 — при использовании официальных стандартных ставок за токены и без учета кэша, кредитов, налогов и наценки.
- Результат выполнения задачи: Обе модели справились с задачами по извлечению информации, работе с JSON и математическим задачам. Sonnet более аккуратно соблюдал заданный формат из двух абзацев на китайском языке; результаты кодирования обеих моделей были пригодны для использования, но различались по глубине и объяснению крайних случаев.
- Миграция API: Мышление нельзя отключить; принудительный выбор инструмента неприемлем, а бюджеты токенов включают в себя мышление. Проверьте предостережения, связанные с миграцией перед переключением.
- Граница принятия решения: Это один прогон каждой задачи по маршруту стороннего поставщика. При этом измеряются наблюдаемые времена отклика на запросы, локальное время выполнения и показатели использования, предоставляемые маршрутом — это не универсальный показатель производительности.
Официальная цена и технические характеристики модели
В текущем списке моделей Anthropic указаны обе модели с контекстным окном размером 1 млн токенов и максимальным объемом вывода 128 тыс. Sonnet 5.5 обозначена как Быстрый с высокой степенью сложности; Opus 5.5 обозначен как Умеренный при среднем уровне усилия по умолчанию. Стандартные курсы токенов составляют Sonnet 5.5, что в два раза меньше цены входа и выхода у Opus 5.5.
| Модель | Идентификатор API | Официальная маркировка задержки | Ввод / вывод | Контекст / максимальная мощность | Стандартная нагрузка | Чтение из кэша |
|---|---|---|---|---|---|---|
| Claude Sonnet 5,5 | claude-sonnet-5-5 | Активный · Быстрый | $2 / $10 на MTok | 1 М / 128 К | Высокий | $0.20 / MTok |
| Claude Opus 5,5 | Клод, опус 5, № 5 | Активный · Умеренный | $4 / $20 на MTok | 1 М / 128 К | Средний | $0.20 / MTok |
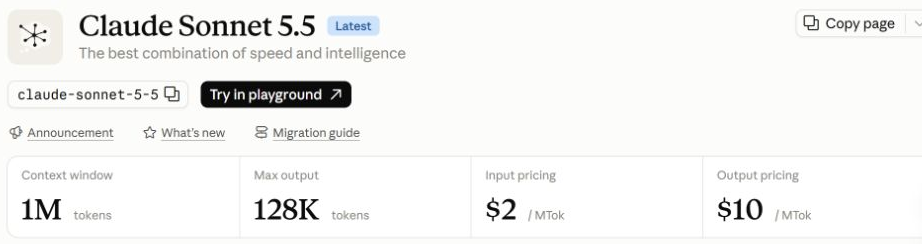
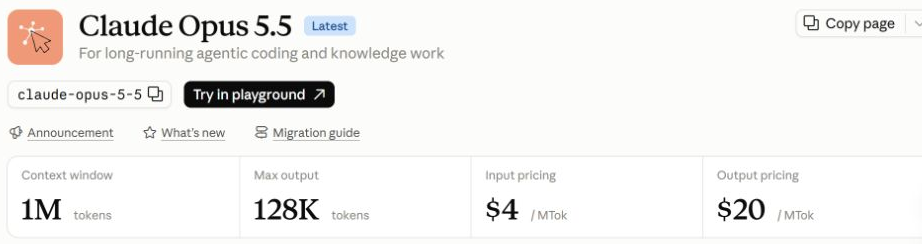
Для простого примера без кэширования с 100 000 входных токенов и 20 000 выходных токенов указанные показатели производительности составляют примерно $0,40 на Sonnet 5.5 и $0,80 на Opus 5.5. См. Руководство по ценам и лимитам Claude для контекста плана.
Контекст официального теста
Anthropic Объявление Sonnet 5.5 обе модели помещаются в одну таблицу, составленную на основе данных поставщиков. Структура строк варьируется в зависимости от эталона и уровня затрат.
| Результаты тестирования, представленные в отчете Anthropic | Sonnet 5.5 | Опус 5.5 | Мера |
|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 66,41 TP40T¹ | Кодирование агентных терминалов |
| FrontierCode v1.1 (Основная версия) | 46,21 TP40T Max² / 52,11 TP40T Xhigh | 54.4% | Будут ли изменения в коде включены в сборку |
| CursorBench 4.0 | 55.5% | 57.8% | Неоднозначные задачи кодирования нескольких файлов |
| GDPval-AA v2.1 | 1844 | 1846 | Интеллектуальный труд в различных профессиях |
| Последний экзамен человечества | 64,51 TP40T с инструментами | 67,71 TP40T с инструментами | Междисциплинарное мышление |
| OSWorld 2.1 | 80.1% частичный | 81,81 TP40T частичный | Задания, связанные с использованием компьютера |
| Картография | 61,61 TP40T без инструментов | 64,41 TP40T без инструментов | Визуальное распознавание диаграмм |
¹ Opus 5.5 Terminal-Bench использует режим xhigh; ² Sonnet 5.5 FrontierCode показывает 46,21 TP40T в режиме Max и 52,11 TP40T в режиме Xhigh. Значения OSWorld отмечены как частичные. Они относятся к контексту провайдера, а не являются результатом независимого повторного тестирования при равных нагрузках.
Метод API с одинаковым запросом
Каждая модель получила одни и те же пять подсказок посредством ПОСТ https://anywhere.broly.ai/v1/messages. Клиент отправил одно пользовательское сообщение, max_tokens: 8192, output_config.effort: high, и никаких инструментов. Каждый запрос возвращал статус HTTP 200 и конец хода.
Подход к тестированию соответствует более общему Рабочий процесс тестирования модели GlobalGPT. Отдельный Руководство по API Claude охватывает настройку запросов и учет токенов.
Время, токены и ориентировочная стоимость
| Маршрут | Пять часов по местному времени | Вводные токены | Выходные токены | Изложенные мысли | Ориентировочная стоимость запроса* |
|---|---|---|---|---|---|
| Claude Sonnet 5,5 | 31,930 с | 700 | 2,686 | 987 | $0.02826 |
| Claude Opus 5,5 | 47,725 с | 700 | 3,952 | 2,214 | $0.08184 |
* Расчет основан на данных о токенах, зарегистрированных на маршруте, и официальных стандартных ставках. В данной группе Sonnet 5.5 показал результат на 33,11 TP40T ниже по местному времени прохождения и на 32,01 TP40T ниже по количеству выданных токенов.
Пять пар карточек с заданиями
На каждой карте в одном месте собраны данные о задаче, наблюдениях, местном времени, маркерах, отмеченных на маршруте, статусе и границах.
Могут ли эти модели восстановить функцию дедупликации смешанного типа?
Настройка задачи: Точный текст запроса был скопирован из предыдущего Обзор Claude Opus 5.5 пробный набор.
| Модель | Время / использование маршрута | Краткое название результата |
|---|---|---|
| Claude Sonnet 5,5 | 8,679 с 145 входов / 830 выходов 0 размышлений HTTP 200 · end_turn | Исправленная функция плюс два теста; более краткое объяснение. |
| Claude Opus 5,5 | 15,844 с 145 входов / 1478 выходов 700 размышлений HTTP 200 · end_turn | Исправлена функция и добавлены два теста; более подробное обсуждение крайних случаев. |
Наблюдаемое сравнение: Оба вернули исправленную функцию и два теста. В Sonnet 5.5 использовались ключи с типовыми метками, casefold(), а также резервный вариант в виде списка в более кратком ответе; Opus 5.5 потратил больше токенов вывода на объяснение дополнительных крайних случаев. Ни один из этих вариантов не позволяет определить общего победителя по коду.
Граница: Один небольшой патч на Python проверяет конкретные крайние случаи, но не обеспечивает надежность при работе с разными репозиториями или при программировании с использованием инструментов.
Могут ли модели сохранить пять заданных фактов, не добавляя при этом никаких утверждений?
Настройка задачи: Точный текст запроса был скопирован из предыдущего Обзор Claude Opus 5.5 пробный набор.
| Модель | Время / использование маршрута | Краткое название результата |
|---|---|---|
| Claude Sonnet 5,5 | 3,569 с 210 входов / 209 выходов 0 размышлений HTTP 200 · end_turn | Пять пронумерованных маркеров; приведенные факты сохранены. |
| Claude Opus 5,5 | 4,374 с 210 входов / 312 выходов 101 способ мышления HTTP 200 · end_turn | Пять пронумерованных маркеров; приведенные факты сохранены. |
Наблюдаемое сравнение: Оба модели выдали ровно пять пронумерованных пунктов и не вышли за рамки предоставленных фактов. Модель Sonnet 5.5 использовала 209 токенов в выводе, тогда как Opus 5.5 — 312, однако заданка представляла собой краткую заметку, а не ввод с обширным контекстом.
Граница: Это тщательная проверка извлечения и форматирования; она не является доказательством производительности при работе с контекстом объемом в миллион токенов.
Могут ли модели возвращать структуру, точно соответствующую запросу?
Настройка задачи: Точный текст запроса был скопирован из предыдущего Обзор Claude Opus 5.5 пробный набор.
| Модель | Время / использование маршрута | Краткое название результата |
|---|---|---|
| Claude Sonnet 5,5 | 5,052 с 128 входов / 260 выходов 0 размышлений HTTP 200 · end_turn | Анализируемый JSON; запрашиваемые ключи и количество элементов. |
| Claude Opus 5,5 | 8,276 с 128 входов / 622 выхода 390 размышлений HTTP 200 · end_turn | Анализируемый JSON; запрашиваемые ключи и количество элементов. |
Наблюдаемое сравнение: Оба варианта вернули JSON-данные, пригодные для синтаксического анализа, с запрашиваемыми ключами, а также двумя преимуществами и двумя недостатками. Вариант Sonnet 5.5 оказался более лаконичным — его вывод состоял из 260 токенов; приведенные строки описывают вымышленную ситуацию с отзывами и не являются фактами о продукте.
Граница: Однократное прохождение этой схемы не позволяет оценить надежность структурированного вывода при вызовах инструментов или в ходе длительных диалогов.
Могут ли модели проследить за последовательностью округлений до получения окончательного ответа?
Настройка задачи: Точный текст запроса был скопирован из предыдущего Обзор Claude Opus 5.5 пробный набор.
| Модель | Время / использование маршрута | Краткое название результата |
|---|---|---|
| Claude Sonnet 5,5 | 2,947 с 89 входов / 163 выхода 0 размышлений HTTP 200 · end_turn | Правильный результат: 67; окончательный ответ следует указывать в отдельной строке. |
| Claude Opus 5,5 | 3,830 с 89 входов / 257 выходов 74 размышления HTTP 200 · end_turn | Правильный результат: 67; окончательный ответ следует указывать в отдельной строке. |
Наблюдаемое сравнение: Оба вычислили значение 67 и вывели окончательный ответ в отдельной строке. Модель Sonnet 5.5 использовала 163 выходных токена по сравнению с 257 у Opus 5.5, при этом разницы в корректности ответов на данный запрос не наблюдалось.
Граница: Одной арифметической прогрессии недостаточно для оценки надежности абстрактного мышления.
Можно ли сохранить в маршруте требуемую структуру из двух абзацев?
Настройка задачи: Точный текст запроса был скопирован из предыдущего Обзор Claude Opus 5.5 пробный набор.
| Модель | Время / использование маршрута | Краткое название результата |
|---|---|---|
| Claude Sonnet 5,5 | 11,683 с 128 входов / 1224 выхода 987 размышлений HTTP 200 · end_turn | Два абзаца на китайском языке; без дополнительных рамок. |
| Claude Opus 5,5 | 15,401 с 128 входов / 1283 выхода 949 размышлений HTTP 200 · end_turn | Рассмотрел все пункты; добавил Markdown и примечание на английском языке. |
Наблюдаемое сравнение: Sonnet 5.5 вернул два запрошенных абзаца на китайском языке без дополнительного форматирования. Opus 5.5 также охватил запрошенные моменты, но добавил форматирование Markdown и примечание на английском языке. Здесь фиксируется формат записи, полученный в результате одного прогона, а не общее качество перевода на китайский язык.
Граница: В задании предлагается написать вступление об «Opus 5.5», поэтому сам текст не является эталоном нейтрального языка.
Особенности API и миграции
В Sonnet 5.5 адаптивное мышление включено по умолчанию; при значении «thinking: disabled» возвращается ошибка 400, а параметр max_tokens охватывает как мышление, так и текст ответа. Принудительный выбор инструмента «any/tool» отклоняется. Перед переключением необходимо разбить блоки контента по типам и пересчитать базовые лимиты токенов.
Что подтверждают факты
Решение на уровне задачи
Sonnet 5.5: снижение затрат и времени на данном маршруте при строгом соблюдении требований к формату в рамках китайского задания.
Опус 5.5: здесь это дороже и требует большего объёма ресурсов; официальные тестовые наборы по-прежнему лидируют по ряду задач с открытым исходом.
Используйте данные на уровне задач, чтобы выбрать отправную точку, а затем оцените рабочую нагрузку, которая важна именно для вас.
Для ознакомления с сопутствующей информацией см. Сравнение семейства Claude, Рецензия на «Opus 5», и Обзор Fable 5.1.
ЧАСТО ЗАДАВАЕМЫЕ ВОПРОСЫ
Какая модель оказалась быстрее в сравнительном тесте?
Sonnet 5.5 показал меньшее общее время на местном уровне: 31,930 секунд против 47,725 секунд у Opus 5.5 по результатам пяти последовательных запросов. Эти данные учитывают использованный здесь маршрут и сетевой путь, поэтому речь не идет о задержке со стороны провайдера.
Какая модель использовала меньше выходных токенов?
В модели Sonnet 5.5 в пяти задачах было использовано 2 686 токенов выходных данных, полученных по маршруту, по сравнению с 3 952 токенами в модели Opus 5.5. Само по себе количество токенов не свидетельствует о качестве ответа.
Какая модель оказалась дешевле в этом тесте?
С учетом официальных стандартных показателей производительности API и возвращаемого количества операций ввода-вывода общий объем пяти запросов Sonnet 5.5 оценивается в $0.02826, тогда как для Opus 5.5 он составляет $0.08184. В расчёте не учтены сборы за использование кэша, кредитные средства платформы, налоги и наценка.
Превосходит ли Sonnet 5.5 Opus 5.5 по всем тестам?
Результаты тестов для модели № Anthropic представлены в таблице с учетом различных настроек тестов и нагрузки: Sonnet 5.5 показывает более высокие результаты в тесте Terminal-Bench 4.0, в то время как Opus 5.5 лидирует в тестах FrontierCode, CursorBench, GDPval-AA, Humanity’s Last Exam, OSWorld и Chartography. Это результаты, предоставленные поставщиком, а не данные независимого повторного тестирования.
Является ли Sonnet 5.5 полноценной заменой API?
Нет. В руководстве по миграции указано, что функция «thinking» запускается по умолчанию, запрос «thinking: disabled» возвращает ошибку 400, принудительный выбор инструмента «any/tool» отклоняется, а клиентам следует анализировать блоки контента по типу. Перед переходом необходимо перенастроить базовые значения бюджетов токенов и циклов инструментов.
Это был тест с длительным контекстом?
Нет. Задание на извлечение содержит короткий отрывок. В нем проверяется соответствие фактам и точность форматирования; при этом не оценивается поведение вблизи задокументированного контекстного окна длиной 1 млн токенов.



