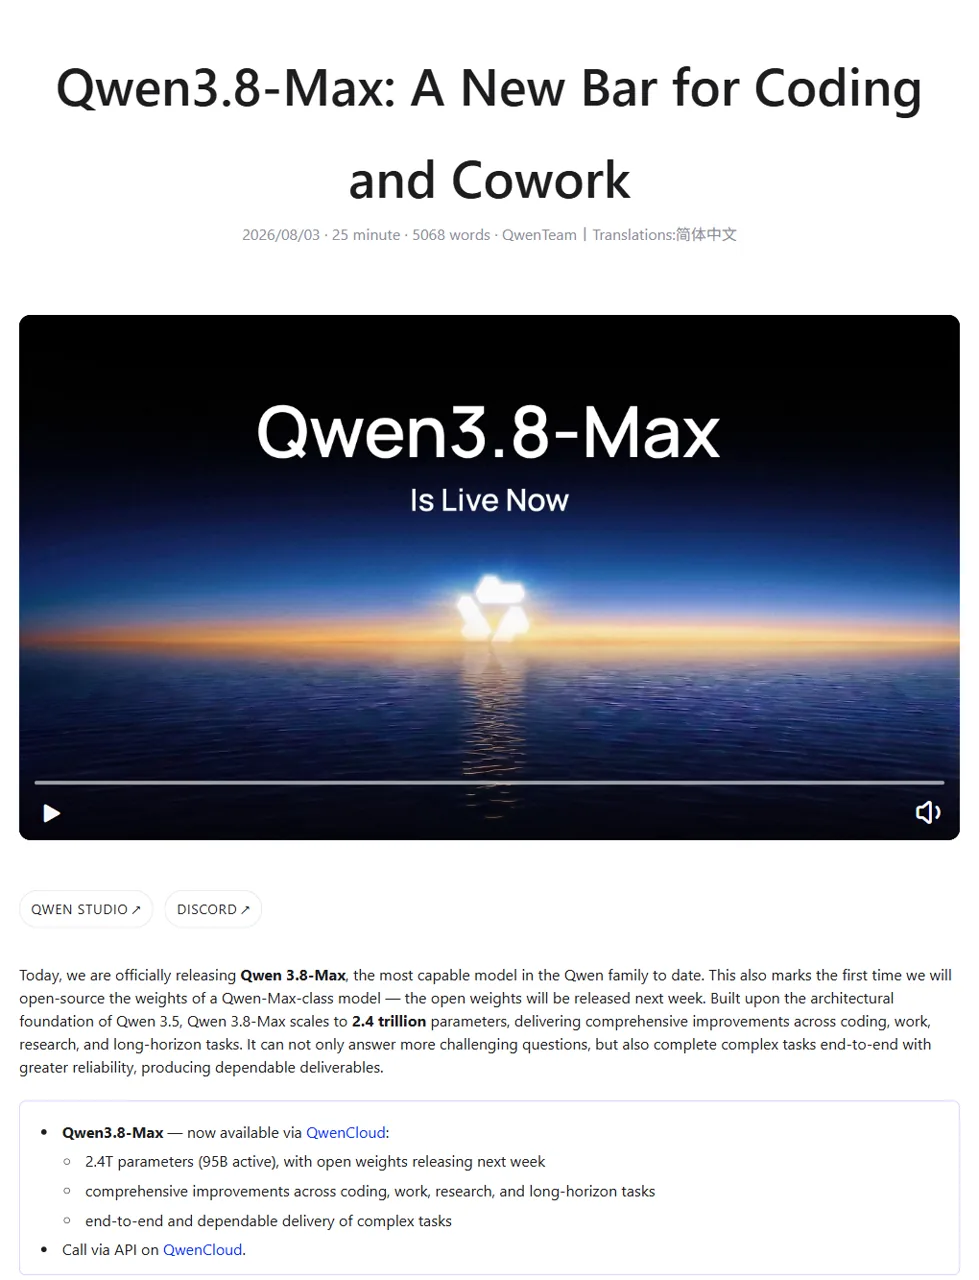
O Qwen 3.8 Max é o novo modelo emblemático da Alibaba Qwen para programação, trabalho profissional, agentes de longa duração e tarefas multimodais. Seu nome oficial é Qwen3.8-Max, foi anunciado em 3 de agosto de 2026 com um total de 2,4 trilhões de parâmetros, 95 bilhões de parâmetros ativos e uma janela de contexto de 1 milhão de tokens.
O lançamento vai além de uma simples atualização de referência de rotina. O Qwen está posicionando o modelo como um agente capaz de planejar, utilizar ferramentas, analisar feedback visual e continuar trabalhando em longas cadeias de tarefas — e não apenas como um chatbot que responde a uma solicitação por vez. Isso o coloca na mesma discussão de vendas que o os melhores modelos de IA para o trabalho prático, mas o preço da API, o plano de peso aberto e os requisitos de implantação merecem uma análise mais detalhada antes de você mudar.
O que é o Qwen3.8-Max?
O Qwen3.8-Max é um grande modelo de mistura de especialistas desenvolvido pela equipe Qwen da Alibaba. Ele possui 2,4 trilhões de parâmetros no total, mas ativa 95 bilhões de parâmetros para cada token. O modelo combina texto, código, compreensão visual, uso de ferramentas e planejamento de longo prazo em um único sistema projetado para realizar trabalhos complexos do início ao fim.
O Lançamento oficial do Qwen descreve quatro objetivos centrais: codificação autônoma mais robusta, resultados profissionais com qualidade de produção, tarefas de ciclo fechado mais longas e agentes multimodais nativos. Em termos práticos, o Qwen busca que o modelo passe de “responda a esta pergunta” para “assuma este objetivo, elabore um plano, utilize as ferramentas disponíveis, verifique o resultado e continue até que o trabalho esteja concluído”.”
Qwen 3.8 Especificações máximas
A contagem de parâmetros precisa ser contextualizada. Um modelo com 2,4 trilhões de parâmetros é enorme, mas o Qwen3.8-Max não utiliza todos os parâmetros para cada token. Seu design do tipo “mistura de especialistas” encaminha cada token por uma parte ativa menor da rede. O número de 95 bilhões de parâmetros ativos é, portanto, mais útil para compreender o comportamento de inferência do que apenas a contagem total, embora nenhum dos dois números, por si só, indique a latência real ou os requisitos de hardware.
A janela de contexto de 1 milhão de tokens é mais útil no dia a dia. Ela pode armazenar grandes repositórios, conjuntos extensos de documentos, históricos detalhados de agentes ou meses de registros operacionais em uma única solicitação. Isso não garante uma recuperação perfeita de todos os tokens, mas oferece aos desenvolvedores muito mais espaço para preservar instruções, resultados de ferramentas, código e decisões intermediárias sem a necessidade de cortes drásticos.
O que o Qwen3.8-Max pode fazer?
Codificação autônoma
Os materiais de lançamento do Qwen destacam projetos que vão muito além de uma simples solicitação de geração de código. A empresa descreve um desenvolvimento autônomo com duração de mais de 10 dias, partindo de uma pasta vazia até um projeto de produção, ao mesmo tempo em que se adapta a erros e novos requisitos. Essa é a direção certa para agentes em escala de repositório, embora os compradores ainda devam validar o modelo em suas próprias linguagens, conjuntos de testes, regras de segurança e ambiente de implantação.
No dia a dia da engenharia, as questões práticas são mais simples: o modelo consegue processar vários arquivos ao mesmo tempo? Ele preserva as interfaces durante a refatoração? Ele escreve testes, analisa falhas e corrige seu próprio patch? Esses critérios são mais importantes do que uma pontuação em um ranking na hora de escolher o melhor modelo de IA para codificação.
Tarefas profissionais de “cowork”
A palavra “cowork” refere-se a produtos de trabalho, e não a conversas casuais. O Qwen destaca relatórios, pesquisas, apresentações, análises, documentos e outros resultados em centenas de profissões. Um bom modelo de “cowork” precisa seguir um briefing, organizar as evidências, usar o formato correto e gerar algo que a pessoa possa editar ou entregar — não apenas um parágrafo plausível.
Agentes de horizonte de longo prazo
O Qwen também relata tarefas em nível de sistema que se estendem por centenas de turnos. Seus exemplos incluem mais de 500 turnos de otimização de projeto de chips e simulação de estratégia de comércio eletrônico com duração de um ano. Trata-se de demonstrações dos fornecedores, não de uma promessa de que todos os agentes funcionarão sem supervisão por dias a fio. Elas mostram, porém, qual é o objetivo do produto: planejamento persistente, avaliação em circuito fechado e melhoria contínua, em vez de respostas isoladas.
Planejamento multimodal e feedback visual
O Qwen3.8-Max trata imagens e telas como parte do ciclo do agente. Um agente visual pode inspecionar uma página, escolher uma ação, observar o que mudou e revisar seu plano. Isso possibilita tarefas de uso do computador, compreensão de documentos, testes de interface, programação visual, gráficos e raciocínio espacial. A parte difícil não é apenas reconhecer uma imagem; é manter as observações visuais conectadas ao objetivo do agente ao longo de várias etapas.
Testes práticos: resultados úteis, respostas lentas e uma execução sem dados
Executei três solicitações independentes no qwen3.8-max ID do modelo por meio da API compatível com o Anywhere OpenAI em 4 de agosto de 2026. Trata-se de pequenas verificações práticas, e não de um benchmark independente ou de uma afirmação sobre todas as implantações do Qwen. Elas são úteis porque mostram tanto a qualidade da resposta visível quanto o comportamento do caminho do gateway testado.
Depuração do Retry-helper
A primeira tarefa utilizou uma função de repetição de tentativa com falha, proveniente de um cenário de webhook de pagamento. A instrução limitou o modelo a três tentativas, dois intervalos de espera exatos, retorno imediato em caso de sucesso e reativação da terceira exceção após falha total.
A resposta identificou três falhas distintas: um comando de suspensão incondicional após cada tentativa, um comando não atribuído resultado após exceções e uma verificação de “truthiness” que atrasou ou tratou incorretamente o sucesso. A linha esperada era "paid" com os argumentos [0,1; 0,2] da função sleep_fn.
Então, executei o código localmente, em vez de confiar na explicação. Ele passou em três casos: duas falhas seguidas de sucesso, um valor de sucesso “falso” na primeira chamada de 0, e três falhas em que o resultado final RuntimeError("falha-3") teve que ser reenviada. Essa foi uma boa solução de engenharia. O sacrifício foi a latência: a resposta visível levou 51,577 segundos ao passar pelo gateway testado.
Síntese de evidências conflitantes
A segunda tarefa testou se o modelo era capaz de distinguir os fatos oficiais atuais de anotações antigas, alegações de fornecedores, um comentário da comunidade e uma rota da plataforma não verificada.
O modelo lidou corretamente com o conflito inserido. Ele não repetiu o contexto de 256K nem o preço de entrada $1.20 como atual, não converteu um comentário sobre quatro GPUs em um requisito de hardware e não afirmou que o GlobalGPT já possuía uma rota dedicada Qwen3.8-Max. Ele também classificou a tabela oficial de benchmarks como “relatada pelo fornecedor”. A resposta levou 94,973 segundos, portanto, este foi mais um resultado que priorizou a qualidade em vez de uma extração rápida.
O que deu errado na prova de planejamento?
Uma terceira solicitação pedia um plano de migração do CMS de duas horas, envolvendo dois engenheiros, com etapas de aprovação/rejeição e reversão explicitamente definidas. A primeira solicitação foi encerrada após 133,682 segundos, quando a conexão com o servidor upstream foi encerrada. Um conjunto de tentativas de repetição mais curto max_completion_tokens para 1.200, mas a API informou motivo_da_conclusão: "duração", esgotou todo o orçamento de raciocínio e não retornou nenhuma resposta visível após 32,899 segundos.
Esse é um aviso operacional útil, mas não constitui prova de que o Qwen3.8-Max não seja capaz de planejar migrações. Não havia nenhum plano disponível para avaliação. Por meio desse gateway, o planejamento complexo requer uma margem de conclusão maior, streaming ou um prompt em etapas, para que o raciocínio interno não consuma todo o orçamento de resposta antes que o texto visível seja emitido.
Qwen 3.8: Resultados máximos em benchmarks
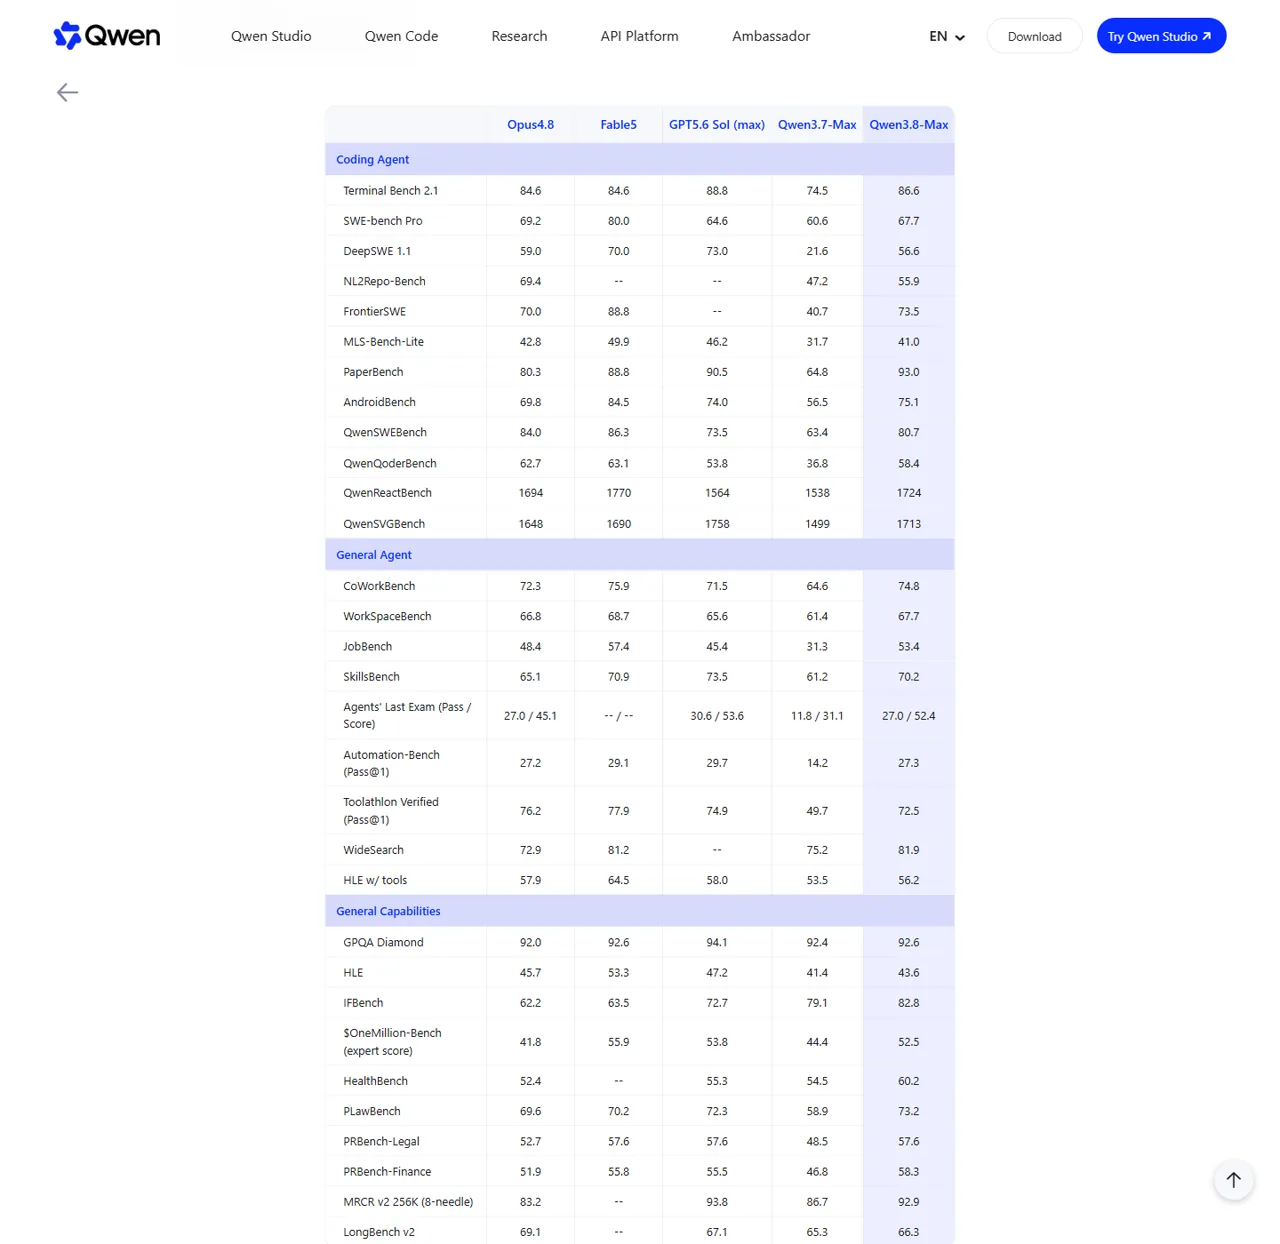
O pacote oficial de testes de desempenho do Qwen apresenta o Qwen3.8-Max como um agente multimodal e de codificação robusto, mas os resultados são mistos, em vez de uma vitória esmagadora. Ele lidera os modelos listados em alguns testes, fica próximo do líder em outros e fica atrás do GPT-5.6 Sol ou do Fable 5 em várias categorias. Essa é uma interpretação mais equilibrada do que resumir dezenas de testes a um único rótulo de “melhor modelo”.
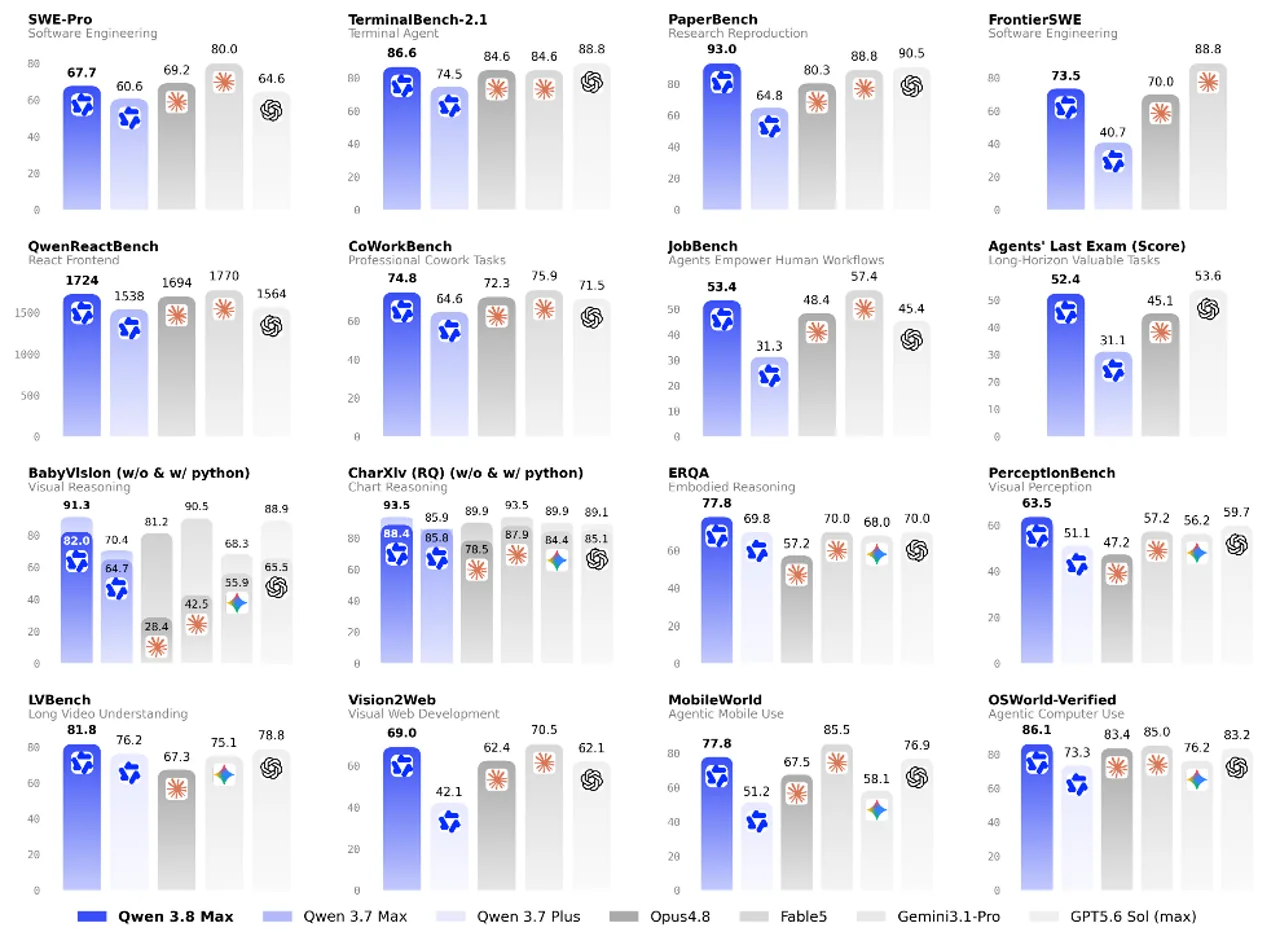
Resultados selecionados da tabela oficial do Qwen
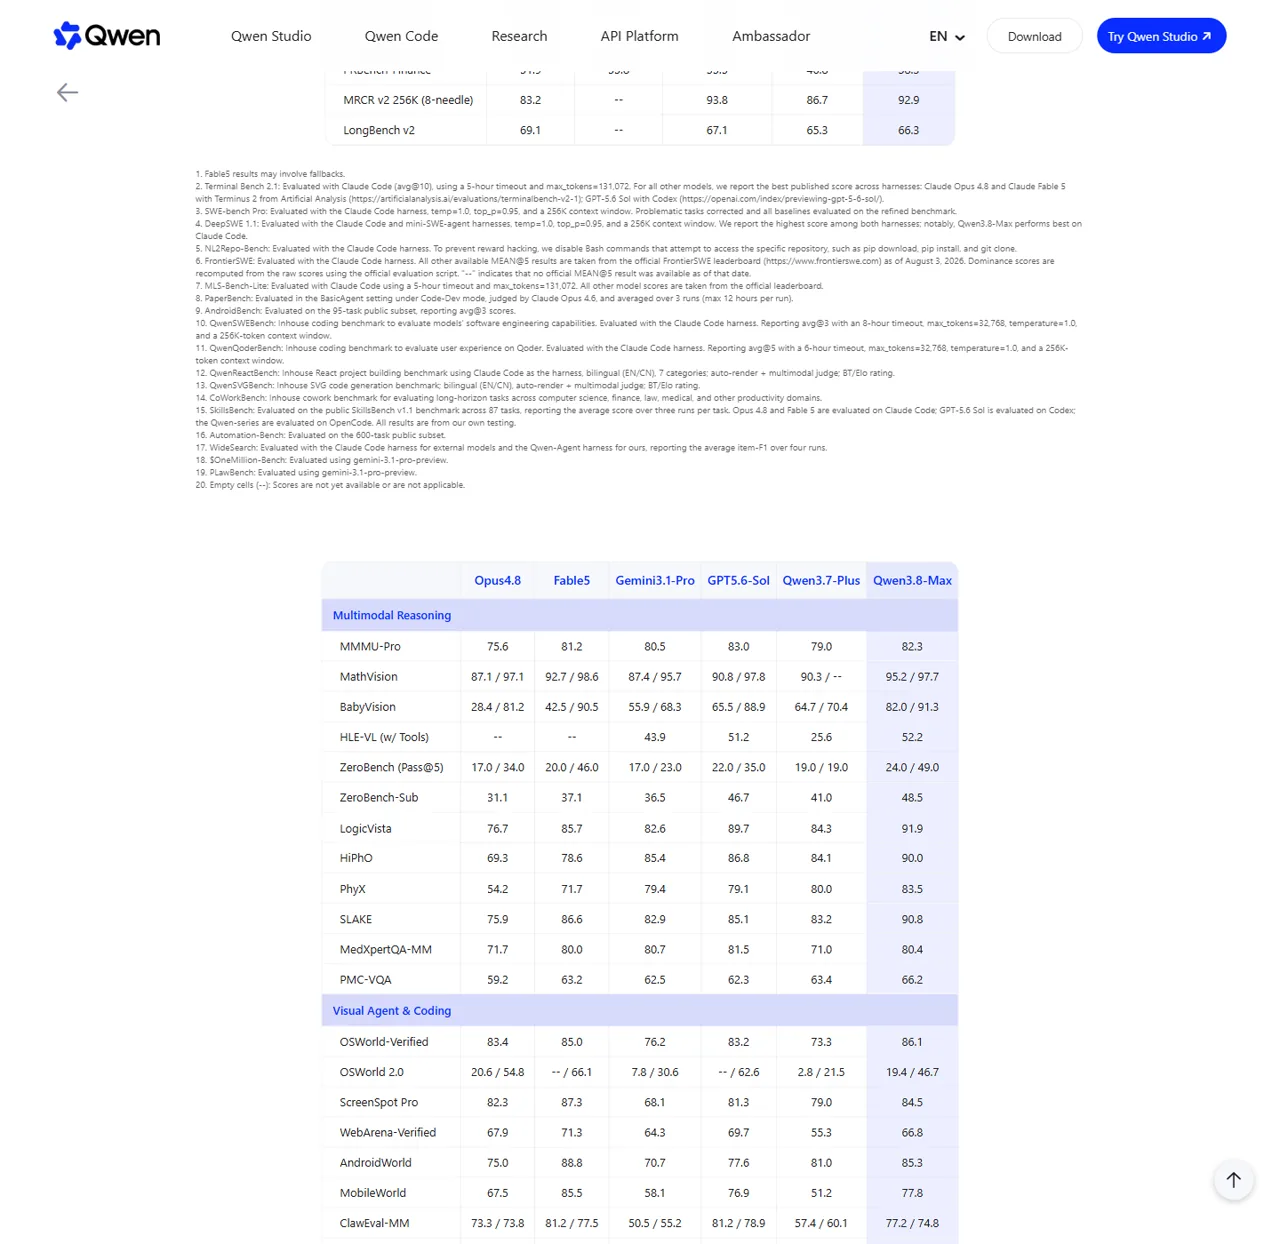
Esses números foram extraídos dos próprios materiais divulgados pela Qwen. As notas de rodapé indicam que a tabela combina relatórios oficiais dos modelos, fichas técnicas, tabelas de classificação públicas e avaliações internas da Qwen. Os conjuntos de cabos e as configurações também variam entre alguns modelos. Use a tabela para identificar pontos fortes promissores e, em seguida, verifique a lista de finalistas por conta própria antes de tomar uma decisão que envolva um alto custo.
O que significam os resultados da codificação
A vantagem mais evidente é o equilíbrio. O Qwen3.8-Max se destaca em tarefas de terminal, engenharia de software, implementação de documentos, tarefas colaborativas, pesquisa na web e execução de instruções. Ele não precisa vencer em todas as categorias para ser útil; um agente que se mantenha consistentemente forte em planejamento, programação, ferramentas e verificações visuais pode ser mais confiável do que um modelo otimizado para um único teste específico.
A tabela oficial também mostra por que os testes comparativos são importantes. O GPT-5.6 Sol lidera várias linhas relacionadas a raciocínio ou orientadas a terminais, enquanto o Fable 5 continua sendo especialmente competitivo em tarefas de colaboração, interface e visuais. Uma tabela separada Comparação entre GPT-5.6 e Fable 5 pode ajudá-lo a traduzir essas famílias de modelos em casos de uso do dia a dia antes de incluir o Qwen3.8-Max na lista de finalistas.
O que significam os resultados multimodais
O Qwen3.8-Max apresenta resultados oficiais sólidos em raciocínio multimodal, ancoragem visual, uso de computador, trabalho com documentos e compreensão espacial. Sua pontuação de 86,1 no OSWorld-Verified é particularmente relevante para agentes que operam em telas, pois mede a conclusão de tarefas em ambientes de desktop, e não apenas a descrição de uma imagem.
Como o Qwen3.8-Max se compara
Não há uma resposta responsável, resumida em uma única frase, para a pergunta: “O Qwen3.8-Max é melhor que o GPT, o Claude ou o Gemini?”. Os próprios dados do Qwen mostram que os líderes da categoria variam de linha para linha. A adequação do produto também depende da confiabilidade da ferramenta, da qualidade da saída, da latência, da disponibilidade regional, dos controles de privacidade e da interface que envolve o modelo.
O Qwen3.8-Max parece ser a opção mais atraente quando se deseja um único modelo que abranja programação, documentos, pesquisa, tarefas demoradas e agentes visuais. O GPT-5.6 Sol ainda pode ser a melhor opção para cargas de trabalho nas quais sua capacidade de raciocínio e resultados finais mais sólidos se aplicam ao seu ambiente. O Fable 5 merece uma análise mais detalhada para tarefas de colaboração e com grande uso de interface do usuário; o Comparação entre Fable 5 e Opus 4.8 fornece mais contexto sobre essa parte da decisão.
Os pesos abertos previstos para o modelo podem se tornar sua maior vantagem estrutural. Atualmente, o desempenho exclusivamente por meio da API é importante, mas os pesos que podem ser baixados oferecem opções para ajuste fino, infraestrutura privada, pesquisa e implantação regional. O valor final dependerá da licença divulgada, dos formatos dos pesos, do suporte à quantização e do hardware necessário para executar o modelo a uma velocidade útil.
Preços do Qwen3.8-Max API
A Qwen listou os seguintes preços de lançamento em seu comunicado oficial:
Uma estimativa simples é:
custo estimado = entrada não armazenada em cache × $2/M + entrada armazenada em cache × $0,25/M + saída × $6/M
Por exemplo, uma execução utilizando 10 milhões de tokens de entrada não armazenados em cache e 2 milhões de tokens de saída custaria cerca de $32 às taxas de lançamento, antes de quaisquer outras cobranças da plataforma: $20 para a entrada mais $12 para a saída. Um agente que relê um grande repositório a cada turno pode gastar muito mais, o que torna o armazenamento em cache e o gerenciamento de contexto tão importantes quanto o preço de entrada anunciado.
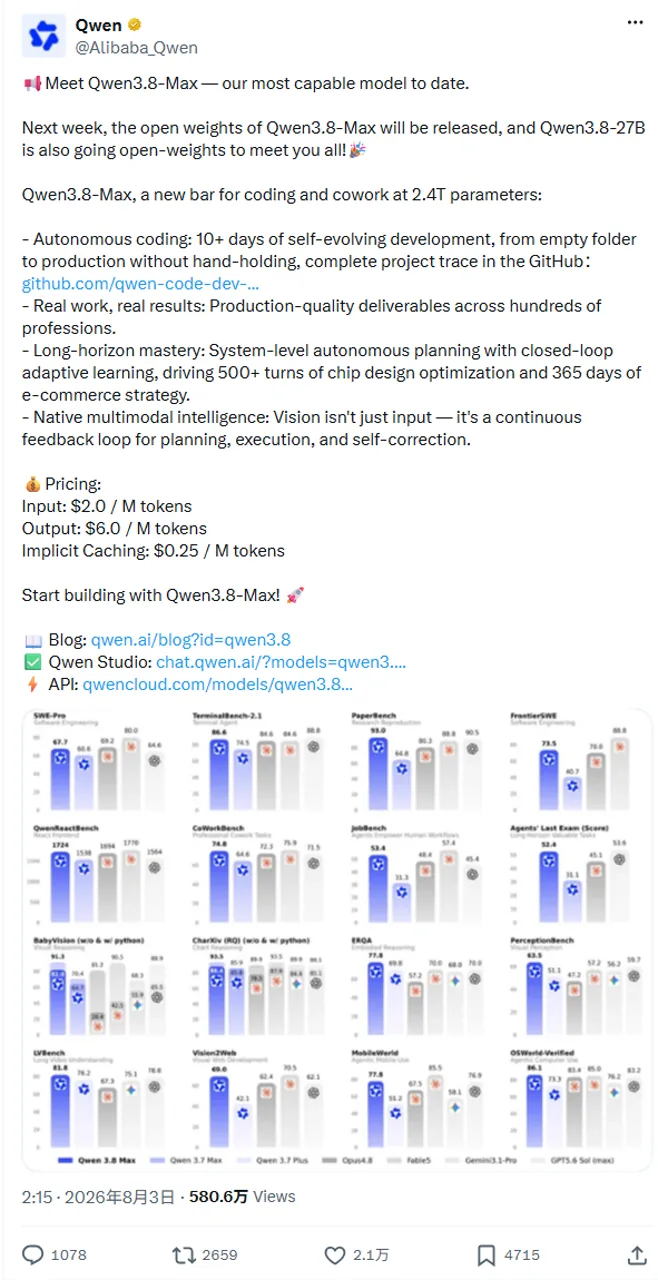
O Qwen3.8-Max também é compatível com esforço_de_raciocínio controles. A seção oficial da API lista xalto como padrão para a análise complexa, médio para equilibrar precisão e velocidade, e baixo para um trabalho mais rápido e eficiente. preserve_thinking está ativado por padrão. Esses controles podem reduzir custos, mas devem ser avaliados em relação à qualidade das tarefas, em vez de serem tratados como modos intercambiáveis.
A comparação de preços entre diferentes provedores exige o mesmo cuidado. Um modelo com uma taxa por token mais baixa ainda pode sair mais caro se exigir prompts mais longos, mais tentativas ou chamadas adicionais a ferramentas. O Guia de preços da API Gemini 3.1 Pro é um exemplo útil de por que o comprimento do contexto e os níveis de uso são importantes, além da taxa básica.
Como acessar o Qwen3.8-Max
1. Utilize o Qwen Studio para avaliação direta
O caminho mais rápido para dar uma primeira olhada é Estúdio Qwen. Comece com uma tarefa real, em vez de um desafio trivial: apresente um briefing confuso, um problema de programação envolvendo vários arquivos, um conjunto de documentos ou um fluxo de trabalho baseado em imagens. Verifique se o resultado é preciso, editável e completo o suficiente para economizar tempo.
2. Utilize a API QwenCloud para aplicativos
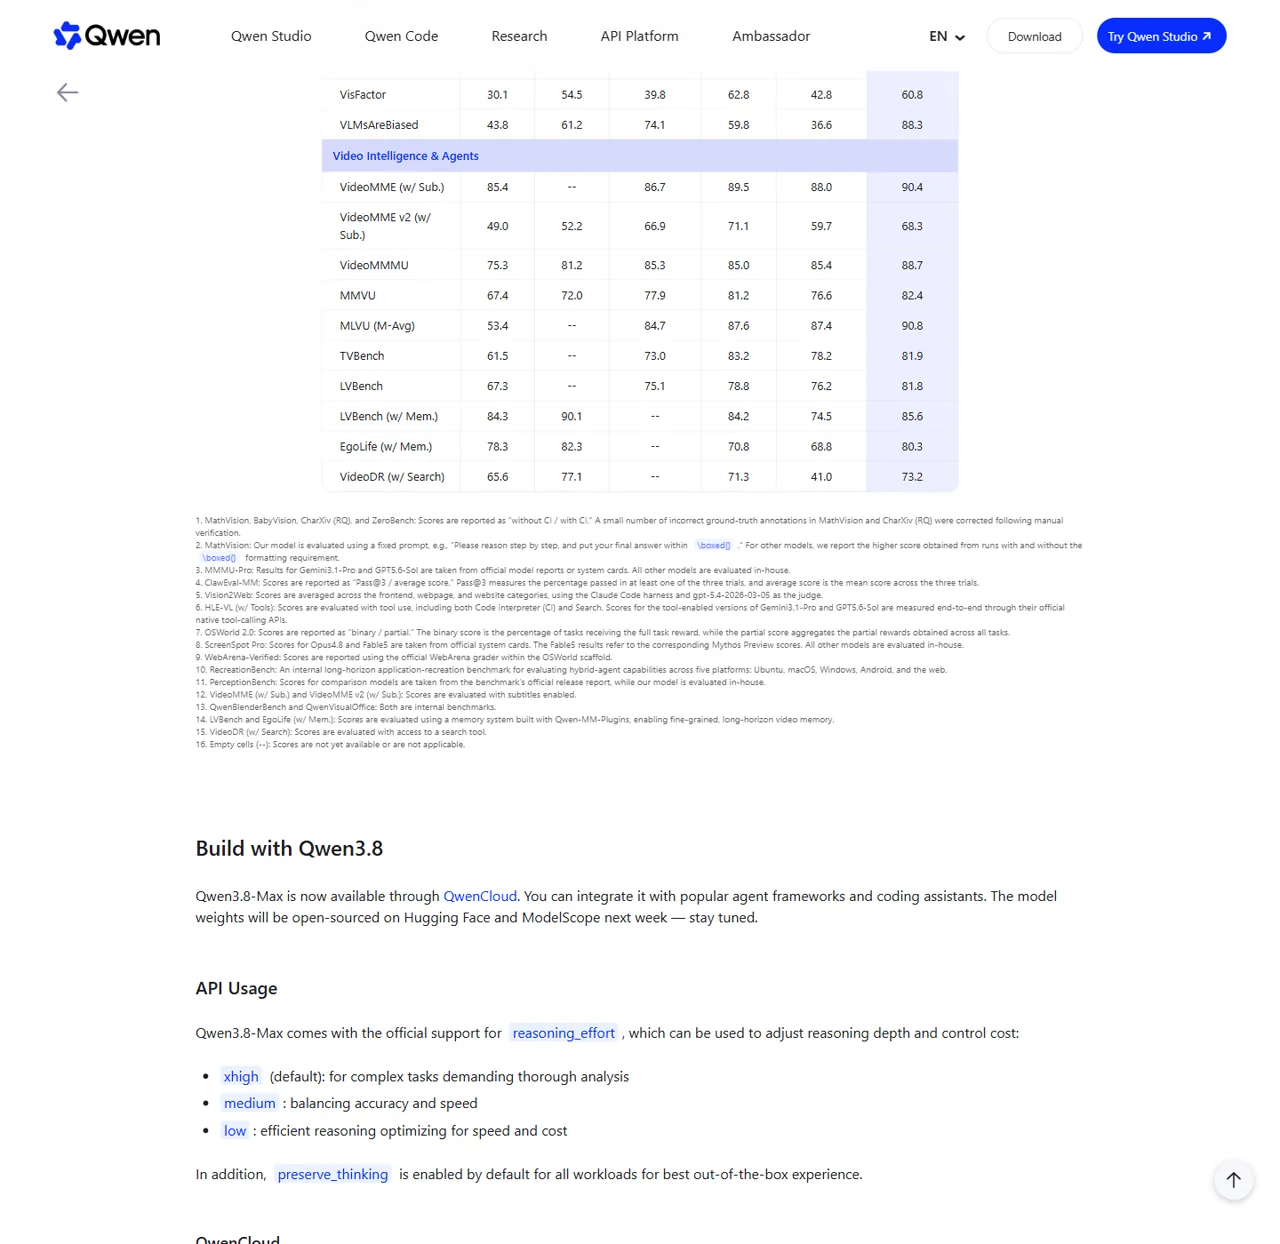
O Qwen3.8-Max está disponível por meio de QwenCloud. A página de lançamento informa que sua API oferece suporte a protocolos padrão do setor para autocompletar mensagens e respostas, compatíveis com a especificação OpenAI, além de uma interface compatível com Anthropic. Isso facilita a migração, mas você ainda deve verificar os nomes dos modelos, os parâmetros, o comportamento de streaming, os esquemas das ferramentas e o tratamento de erros na documentação oficial.
3. Conecte-o às ferramentas de programação e de agentes
A página de lançamento do Qwen inclui integrações com o Qwen Code, o Claude Code, o Codex e o OpenClaw. O modelo pode, portanto, ser incorporado a um fluxo de trabalho existente de terminal ou agente sem a necessidade de criar uma nova interface. O suporte à integração não elimina o custo da ferramenta associada; portanto, compare a fatura do modelo com a fatura separada Estrutura de preços do Codex antes de padronizar o fluxo de trabalho de uma equipe.
Os usuários do código Claude também devem separar o custo do produto de codificação da API do modelo externo. Os planos disponíveis e as formas de cobrança estão resumidos no Guia de preços do código Claude.
Os usuários do OpenClaw têm uma dúvida adicional: qual modelo oferece a melhor combinação entre uso de ferramentas, velocidade e preço para um agente específico. O Comparação do modelo OpenClaw oferece uma estrutura prática para fazer essa escolha, em vez de optar automaticamente pelo modelo maior.
4. Manter a integridade do fluxo de trabalho multimodelo
No lançamento, o QwenCloud é a rota de produção comprovada para o Qwen3.8-Max. Se você também comparar as alternativas GPT, Claude, Gemini ou Fable, o Espaço de trabalho multimodelo GlobalGPT pode reduzir a necessidade de alternar entre as abas nos modelos compatíveis. Use a rota oficial Qwen para o Qwen3.8-Max até que uma página dedicada ao modelo GlobalGPT seja verificada; não presuma que exista uma nova URL para o modelo só porque ele foi anunciado.
Qwen3.8 – Peso máximo em aberto
A Qwen anunciou que os pesos do Qwen3.8-Max seriam divulgados na semana seguinte ao lançamento, em 3 de agosto. O mesmo postagem oficial no X Também foi informado que o Qwen3.8-27B passaria a ser de peso aberto. Essa é uma boa notícia para a implantação e a pesquisa locais, mas o anúncio por si só não é suficiente para planejar um cluster de produção.
Antes de baixar ou fazer o orçamento do hardware, verifique cinco itens da ficha técnica final:
- Os termos exatos da licença e de uso comercial.
- URLs oficiais dos repositórios do Hugging Face ou do ModelScope.
- Formatos de precisão e quantização disponíveis.
- Requisitos mínimos e recomendados de CPU, GPU, memória RAM e armazenamento.
- Se o modelo divulgado corresponde ao comportamento da API hospedada e ao comprimento do contexto.
“Peso aberto” e “código aberto” nem sempre são sinônimos. O termo “peso aberto” indica que os parâmetros do modelo podem ser baixados; a licença determina o que você pode modificar, redistribuir ou usar comercialmente. Até que os repositórios e a licença estejam disponíveis, as páginas que prometem o download do Qwen3.8-Max, a compilação do GGUF ou requisitos precisos de hardware local estão se antecipando aos fatos.
O anúncio do 27B deve ser tratado da mesma forma. Ele pode se tornar a opção mais realista para os usuários locais, mas sua arquitetura, comprimento do contexto, necessidades de memória e resultados de benchmarks devem ser baseados em sua própria ficha técnica oficial — e não copiados do modelo Max.
Qwen3.8 – Limitações máximas e melhor ajuste
Limitações a serem consideradas
- A maior parte das evidências sobre o lançamento provém do Qwen. Avaliações independentes podem utilizar diferentes instruções, ferramentas ou regras de pontuação.
- O contexto longo não é sinônimo de memória perfeita. Um modelo pode aceitar 1 milhão de tokens e, mesmo assim, deixar passar um detalhe ou seguir uma instrução imprecisa.
- Agentes que geram grande volume de saída podem se tornar caros. A taxa de saída de $6 por milhão é importante quando um fluxo de trabalho gera códigos longos, relatórios ou rastros de raciocínio repetidos.
- Os detalhes da implantação local permanecerão incompletos até que os pesos e a placa do modelo cheguem. Um sistema 2.4T de parâmetros totais não funcionará como um pequeno modelo de mesa.
- O uso de ferramentas acrescenta mais uma camada de falhas. O estado do navegador, as permissões, os erros de rede e esquemas de ferramentas mal definidos podem comprometer o funcionamento de um modelo que, de outra forma, seria eficaz.
- As informações sobre o lançamento mudam rapidamente. Os preços, repositórios, integrações e disponibilidade devem ser verificados novamente antes da publicação ou da aquisição.
Quem deveria experimentar agora?
A questão, em resumo, é que o Qwen3.8-Max merece um teste sério, mas não uma migração às cegas. Utilize uma tarefa exigente com uma condição clara de sucesso, registre o total de tokens e tentativas, e compare o resultado final — não apenas a primeira resposta.
Perguntas frequentes
Quando foi lançado o Qwen 3.8 Max?
O Qwen3.8-Max foi anunciado oficialmente em 3 de agosto de 2026. O modelo hospedado ficou disponível por meio do Qwen Studio e do QwenCloud logo no lançamento. A Qwen informou que os pesos abertos seriam lançados na semana seguinte; portanto, a disponibilidade da API e a disponibilidade dos pesos para download devem ser consideradas como marcos distintos.
O Qwen3.8-Max é de código aberto?
A Qwen anunciou os pesos abertos para o Qwen3.8-Max, mas o repositório final e a licença determinam o que os usuários podem executar, modificar, redistribuir ou utilizar comercialmente. Até que esses arquivos estejam disponíveis e sejam verificados, a afirmação “lançamento com pesos abertos anunciado” é mais precisa do que presumir que todas as permissões de código aberto ou formatos locais já estejam disponíveis.
Quantos parâmetros o Qwen3.8-Max possui?
O Qwen3.8-Max possui 2,4 trilhões de parâmetros no total e ativa 95 bilhões de parâmetros por token. Ele utiliza uma arquitetura do tipo “mistura de especialistas” (mixture-of-experts), de modo que o número total de parâmetros e o número de parâmetros ativos descrevem partes diferentes do sistema. Nenhum desses números, por si só, permite prever a velocidade em condições reais ou a demanda de hardware.
O que é a janela de contexto Qwen3.8-Max?
A versão oficial indica uma janela de contexto de 1 milhão de tokens. Isso é suficiente para códigos extensos, documentos, resultados de ferramentas e histórico de agentes, mas o contexto máximo não garante uma recuperação perfeita. Teste o modelo com a posição, o formato e a densidade das informações utilizadas em seu fluxo de trabalho real.
Quanto custa a API Qwen3.8-Max?
No lançamento, o Qwen estabeleceu os seguintes valores: $2 por milhão de tokens de entrada, $6 por milhão de tokens de saída e $0,25 por milhão de tokens armazenados implicitamente em cache. Considere esses valores como preços de lançamento e verifique-os antes de elaborar seu orçamento. Os custos do agente também dependem da reutilização de contexto, do esforço de raciocínio, das tentativas de repetição e do tamanho das saídas geradas.
O Qwen3.8-Max é melhor do que o GPT-5.6 Sol ou o Fable 5?
Não em todos os testes. A tabela oficial do Qwen mostra que o Qwen3.8-Max lidera alguns benchmarks de programação, pesquisa, execução de instruções e uso do computador, enquanto o GPT-5.6 Sol ou o Fable 5 lideram outros. O melhor modelo depende da tarefa, do ambiente de ferramentas, da latência, do preço e da qualidade do produto final.
Posso executar o Qwen3.8-Max localmente?
A Qwen anunciou pesos para download para a semana seguinte ao lançamento, mas a viabilidade local depende dos arquivos finais, da precisão, do suporte à quantização, da licença e das orientações de hardware. Aguarde a ficha técnica oficial do modelo antes de confiar nas estimativas exatas de RAM, VRAM ou armazenamento. As variantes menores do Qwen3.8 podem ser mais práticas assim que forem oficialmente documentadas.
O que é o Qwen3.8-27B?
A publicação de lançamento do Qwen informa que o Qwen3.8-27B também será lançado com pesos abertos. O artigo sobre o lançamento do Max não fornece detalhes suficientes para reutilizar as especificações do modelo Max na versão 27B. Consulte a ficha técnica do modelo para obter informações sobre sua arquitetura, janela de contexto, benchmarks, licença e instruções de download.
Posso usar o Qwen3.8-Max no GlobalGPT?
Uma rota GlobalGPT dedicada para o Qwen3.8-Max não havia sido verificada até o momento da publicação. Use o Qwen Studio ou o QwenCloud para acesso direto. O GlobalGPT continua sendo útil para comparar outros modelos disponíveis, como GPT, Claude, Gemini e Fable, sem precisar trocar de plataforma.
Veredicto final
Utilize o Qwen Studio ou o QwenCloud para uma avaliação direta do Qwen3.8-Max. Utilize o GlobalGPT para comparar outros modelos verificados, sem que isso implique que já exista uma rota dedicada para o Qwen3.8-Max.
Compare os modelos disponíveisO Qwen 3.8 Max é um dos lançamentos de modelo mais ambiciosos de 2026: 2,4 trilhões de parâmetros no total, 95 bilhões de parâmetros ativos, uma janela de contexto de 1 milhão de tokens, resultados oficiais sólidos em tarefas de programação e agentes multimodais, além de um caminho anunciado para pesos abertos. O preço da API de lançamento é competitivo o suficiente para permitir testes, especialmente quando o cache reduz os custos de contexto repetidos.
A razão mais forte para se interessar por isso não é uma única vitória em um benchmark. É a tentativa de combinar programação, entregas profissionais, planejamento de longo prazo, feedback visual e uso de ferramentas em um único modelo. Comece com o Qwen Studio ou uma avaliação controlada do QwenCloud, avalie a qualidade das tarefas concluídas e o custo total, e aguarde a divulgação oficial dos pesos e da licença antes de fazer promessas de implantação local.
Fontes primárias verificadas em 4 de agosto de 2026: Lançamento oficial do Qwen3.8-Max e Postagem oficial de lançamento da @Alibaba_Qwen.