Os testes foram realizados nos dias 7 e 11 de setembro de 2026; as fontes foram verificadas novamente em 16 de setembro de 2026.
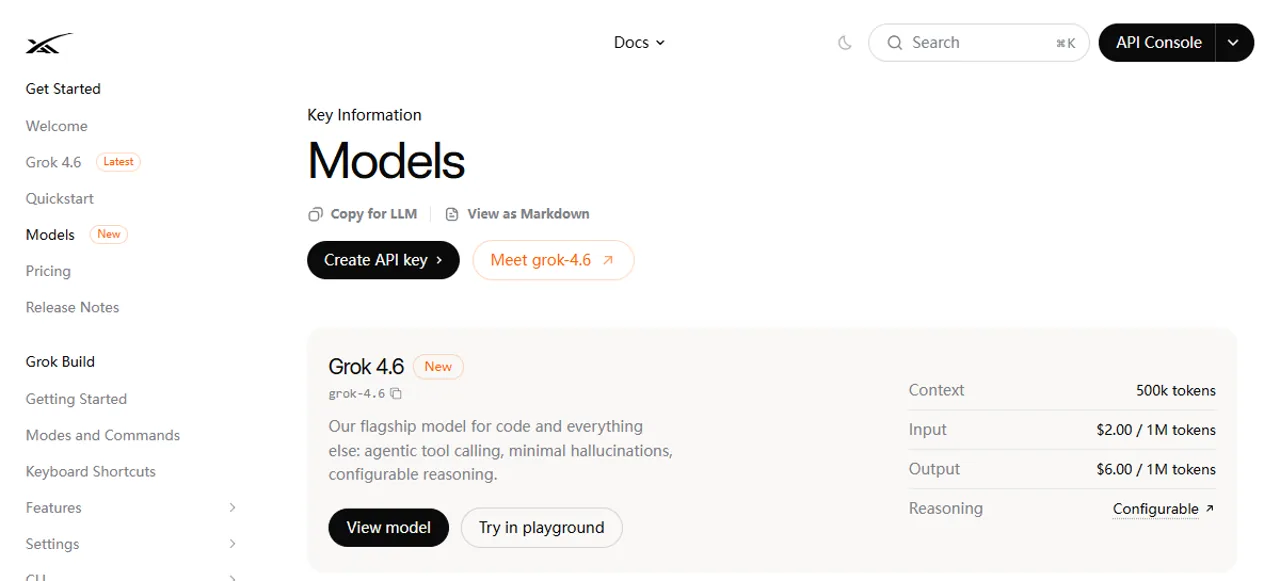
O nome precisa de um esclarecimento. As pessoas ainda pesquisam por “Grok 4”, mas o modelo que testamos foi Grok 4,6, e não o lançamento original previsto para julho de 2025. O atual Catálogo de modelos xAI recomenda Grok 4.6 para o código, enquanto o original grok-4-0709 O nome da API foi descontinuado. Vou manter esses produtos e datas separados ao longo desta análise.
Se você estiver comparando vários assistentes antes de escolher um, comece pelo mais abrangente melhor modelo de IA para comparação de códigos. Aqui, a questão mais específica é se o Grok consegue transformar um briefing de programação preciso em um trabalho que você possa realmente verificar.
Resposta rápida: o Grok 4 é bom para programação?
O Grok 4.6 é bom o suficiente para ser útil na depuração de uma função isolada, na geração de uma primeira implementação, na explicação de código desconhecido e na elaboração de testes. No entanto, não é confiável o suficiente para ser aceito sem execução. As falhas em nosso pequeno conjunto de testes não foram meras divergências de estilo obscuras: uma refatoração resultou na exclusão de líquido de cada resultado não vazio, e um conjunto de testes gerado não conseguiu distinguir um atraso de um carimbo de data/hora absoluto.
A prática recomendada é simples: defina um contrato restrito, solicite uma alteração e realize verificações independentes. Um modelo que gera código plausível rapidamente ainda pode apagar um campo, enfraquecer uma invariante ou seguir o requisito de código, mas ignorar o requisito de formato da resposta.
Você pode tente Grok 4,6 no GlobalGPT para prompts limitados e comparações lado a lado. O GlobalGPT é uma plataforma independente; ele não substitui o Grok Build, um IDE, o acesso ao repositório, o console da API nativa do xAI nem seu pipeline de CI.
O que realmente testamos
Avaliamos quatro pequenas tarefas em JavaScript: corrigir a fusão de intervalos, depurar a alocação de assentos com base em prioridade, refatorar uma função de resumo de alterações e escrever testes para um Retry-After analisador. Cada tarefa contava com um prompt fixo e um avaliador local determinístico. Três delas foram executadas em 11 de setembro de 2026; a tarefa de intervalo reutilizou uma execução de 7 de setembro, que verificamos novamente em relação ao prompt armazenado, à resposta bruta e ao avaliador.
- Local: API de agregação do Broly autorizada pelo usuário, Completamentos de bate-papo.
- Modelo solicitado e devolvido:
grok-4.6. - Tentativas: uma solicitação por tarefa, sem tentativas de repetição.
- Execução: O código JavaScript retornado foi isolado e executado localmente com fixtures ou mutants pré-declarados.
- Indisponível para o modelo: um IDE, um repositório, acesso à internet, execução de ferramentas de xAI e sistemas de produção.
A etiqueta do gateway é uma informação útil sobre a proveniência, mas não comprova, por si só, a implantação a montante. O tempo decorrido inclui a sobrecarga da rede e do gateway, e as contagens de tokens relatadas não constituem faturamento oficial do xAI. Para uma visão mais ampla no nível do produto, consulte o documento separado Análise e testes reais do Grok 4.6.
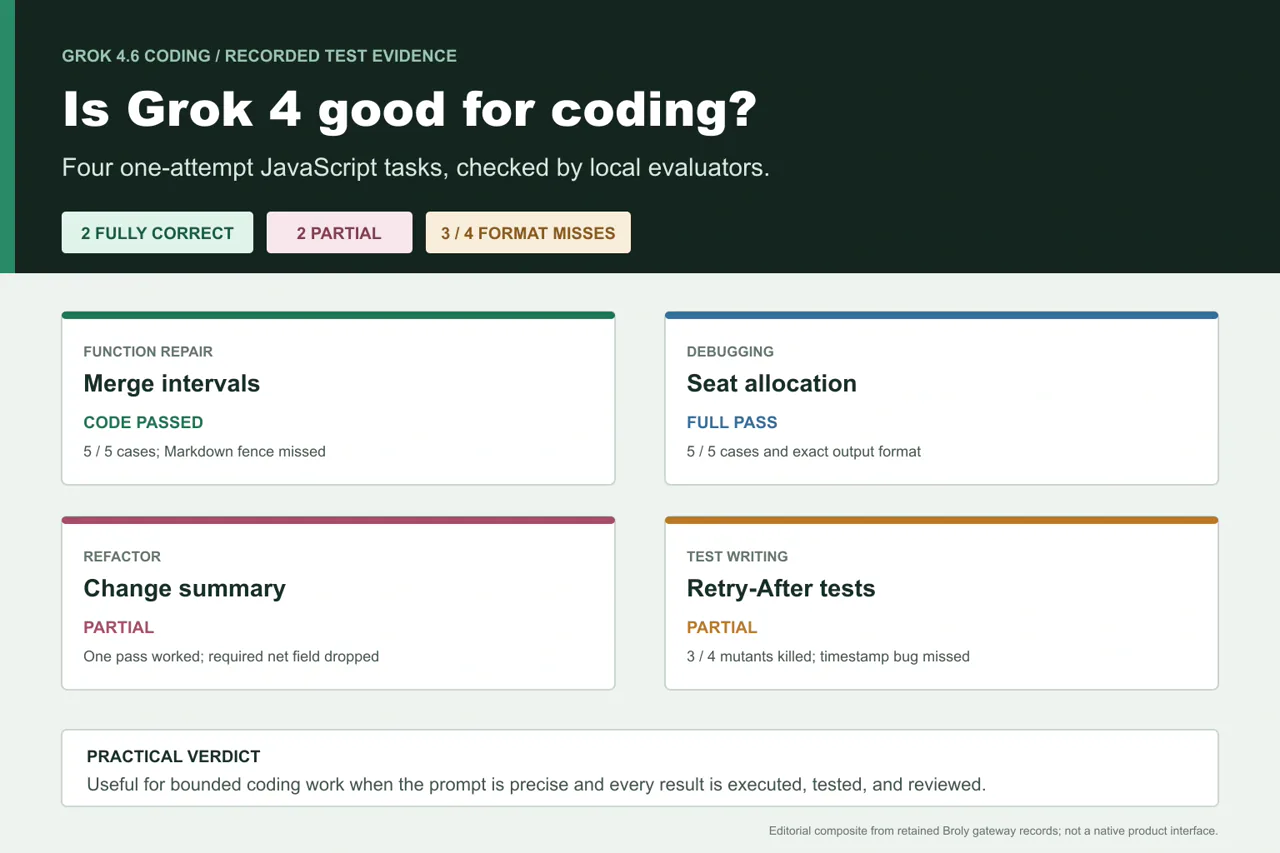
Visão geral dos resultados do teste de codificação
líquido.O melhor resultado não foi a resposta mais longa. Foi a correção da alocação de assentos: concisa, com formatação correta e comportamentalmente completa. O erro mais instrutivo foi a refatoração, pois a implementação parecia limpa e atendia ao requisito de “uma única passagem”, ao mesmo tempo em que alterava silenciosamente o contrato de saída.
Teste 1: reparo de uma função de intervalo de mesclagem
A primeira função alterava sua entrada, travava ao receber um array vazio, não conseguia mesclar pontos finais adjacentes e podia reduzir um intervalo maior quando um intervalo aninhado aparecia posteriormente. O prompt tornou essas invariantes explícitas.
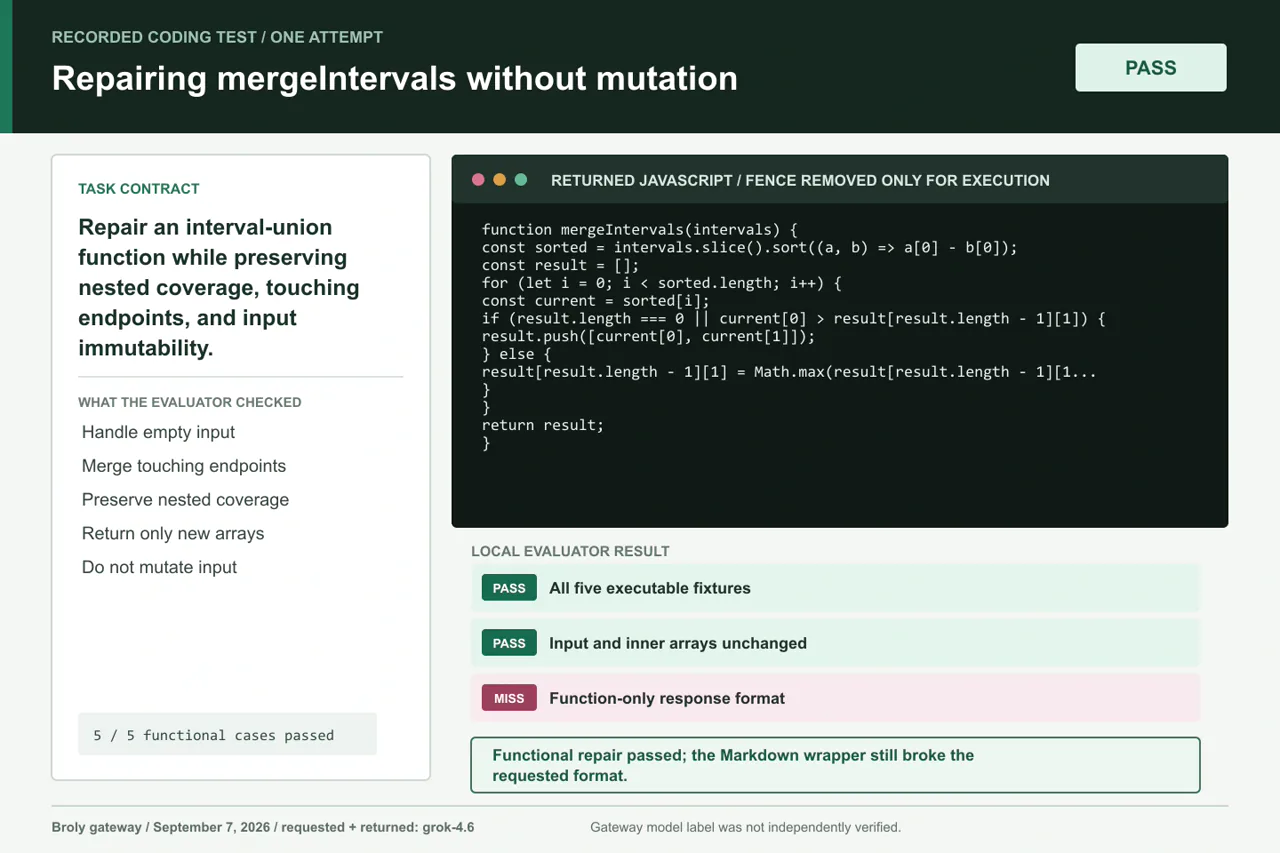
Limite-chave: A correção funcional foi aprovada após a remoção apenas da barreira externa do Markdown para execução.
Resultado: Todos os cinco casos de execução foram aprovados. A função retornou novas matrizes, não alterou os dados de entrada, preservou a cobertura aninhada e mesclou pontos finais adjacentes. Ela ainda falhou em uma instrução explícita ao envolver o código em Markdown. Após remover apenas essa barreira externa de execução, o resultado funcional ficou correto.
Conclusão prática: O Grok lidou bem com uma correção compacta quando o prompt indicou os casos-limite ocultos. A falha de formatação é insignificante para uma pessoa, mas pode interromper um pipeline que espera texto diretamente executável.
Teste 2: depuração da alocação de assentos com base em prioridade
Essa tarefa combinava o tratamento estável de empates, prioridade descendente, ausência de mutação, capacidade exata e uma regra de “pular e continuar”. O código original classificava na direção errada, alterava o array de entrada e parava prematuramente quando uma solicitação excedia o limite de tamanho.
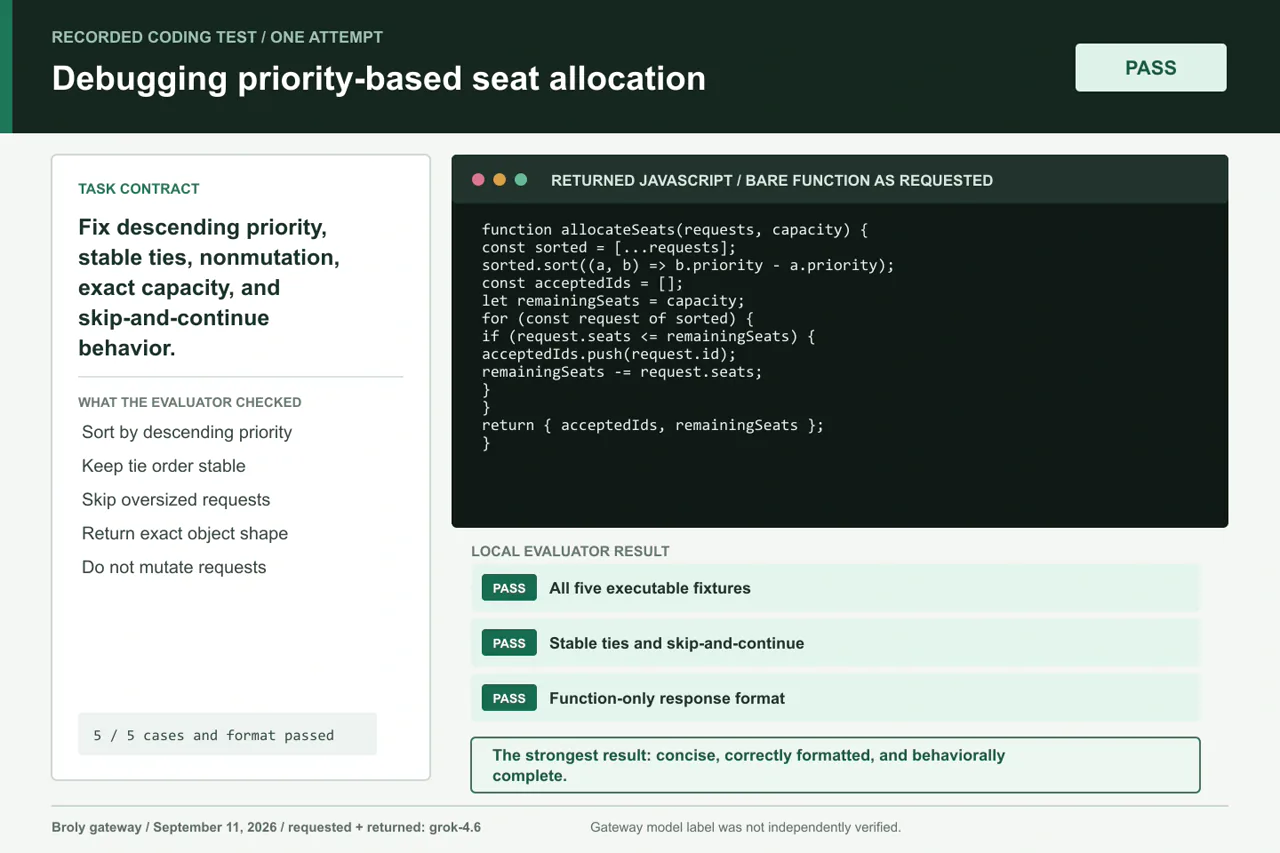
Limite-chave: Essa foi a única resposta que atendeu tanto ao contrato de comportamento quanto ao formato exato de saída.
Resultado: Todos os cinco casos foram aprovados, incluindo ordem de prioridade igual, uma solicitação principal com tamanho excessivo, capacidade exata, capacidade zero e uma lista vazia. A entrada permaneceu inalterada, ids aceitos era um novo array, e o modelo retornou apenas a função solicitada.
Conclusão prática: Esse é o tipo de trabalho para o qual o Grok é ideal: uma única função, um contrato claro e casos-limite que podem ser executados imediatamente.
Teste 3: refatoração sem comprometer o comportamento
A terceira instrução solicitou que o Grok substituísse as varreduras repetidas por uma única passagem de agregação, preservando a ordem, os nomes incomuns dos arquivos e a estrutura exata da saída. Esse é um risco realista da refatoração: o código pode se tornar mais rápido e mais limpo, mas perder parte do comportamento.
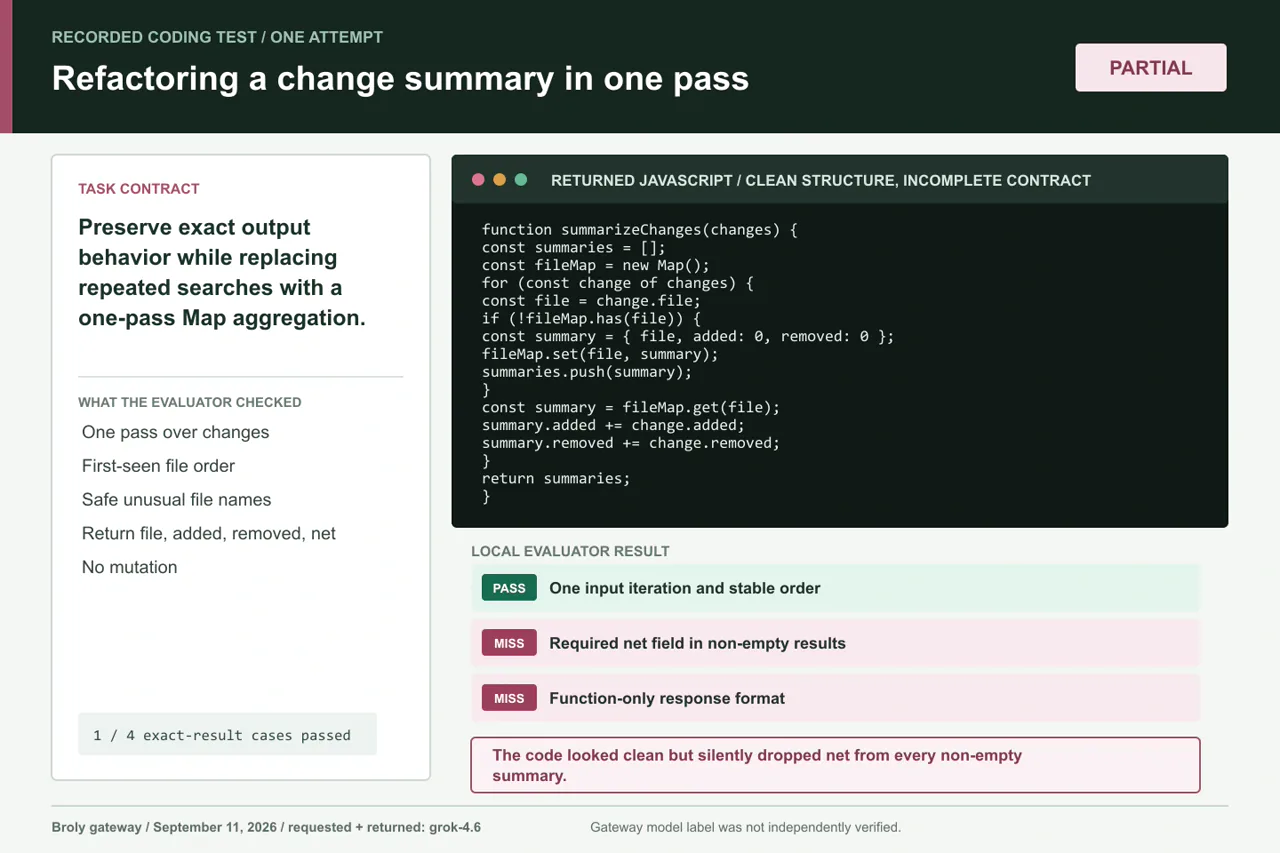
Limite-chave: A abordagem do mapa de uma única passagem parecia correta, mas omitiu silenciosamente o campo “net” exigido.
Resultado: a resposta utilizou uma passagem, uma Mapa, ordenação correta pela primeira aparição, tratamento seguro de __proto__ e construtor, e sem mutação na entrada. Mas ele nunca calculou nem retornou líquido. O caso vazio foi aprovado porque não continha objetos de resultado; todos os três casos não vazios falharam na comparação exata.
Conclusão prática: Nunca avalie uma refatoração apenas com base na complexidade algorítmica ou na limpeza do código. Faça um snapshot das saídas antigas, verifique todos os campos obrigatórios e compare o comportamento antes de aceitar a nova versão.
Teste 4: escrevendo testes que detectem erros plausíveis
A tarefa final inverteu o procedimento habitual: o Grok escreveu os testes, e nosso conjunto de testes os executou contra uma implementação de referência rigorosa e quatro implementações deliberadamente incorretas. O objetivo não era a cobertura de linha. O que se buscava era verificar se as entradas escolhidas conseguiam distinguir semânticas aparentemente semelhantes.
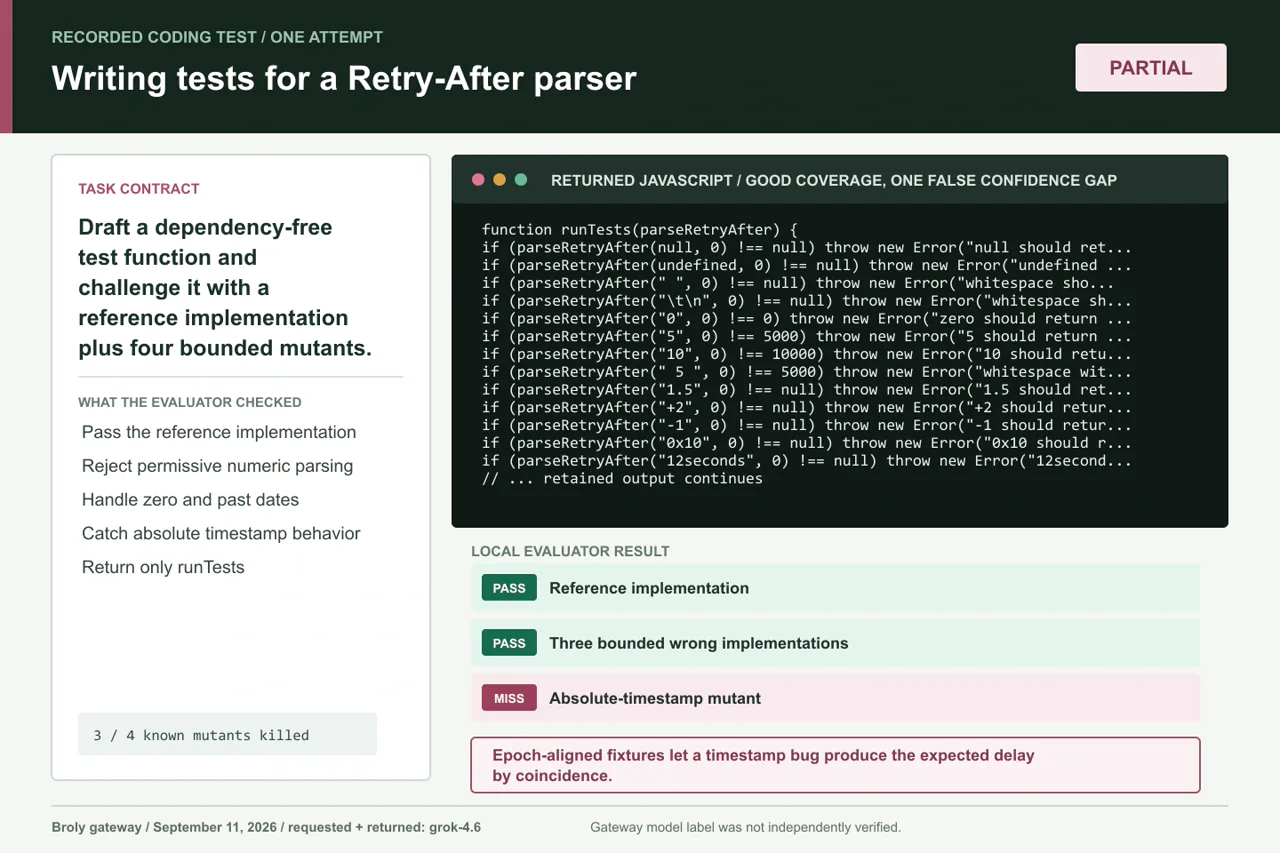
Limite-chave: Os formadores de data alinhados à época permitem que um bug relacionado a carimbos de data e hora absolutos persista por coincidência.
Resultado: A suíte passou no teste de referência e detectou a análise numérica permissiva, o zero tratado como valor falso e um atraso negativo para uma data passada. Ela não detectou o caso anômalo que retornou o timestamp absoluto da data analisada. Ambos os testes de data utilizaram valores alinhados à época, de modo que o atraso esperado acabou sendo igual ao timestamp.
Conclusão prática: Os testes escritos por IA são uma primeira análise útil, mas não constituem prova de correção. Pergunte o que cada fixture identifica. Testes de mutação, testes de propriedade e valores deliberadamente desalinhados podem revelar uma suíte de testes que apenas parece completa.
Grok 4, Grok 4.6 e Grok Build não são a mesma coisa
Contexto do lançamento em julho de 2025. O antigo slug da API foi posteriormente descontinuado.
O rótulo retornado pelo gateway nessas quatro tarefas isoladas.
Um agente independente capaz de operar por meio de um fluxo de trabalho de repositório interativo ou sem interface gráfica.
Uma ferramenta Python em ambiente isolado que deve ser ativada em uma solicitação compatível.
O Anúncio original Grok 4 trata-se do contexto histórico do lançamento. Não descreve o modelo utilizado em nossos testes de 2026.
da xAI Aviso de migração de 15 de maio de 2026 diz grok-4-0709 agora redireciona para o Grok 4.3 com baixo nível de raciocínio. Isso não significa que todos os produtos com o nome da família Grok 4 tenham desaparecido; significa que o ID exato do modelo é importante.
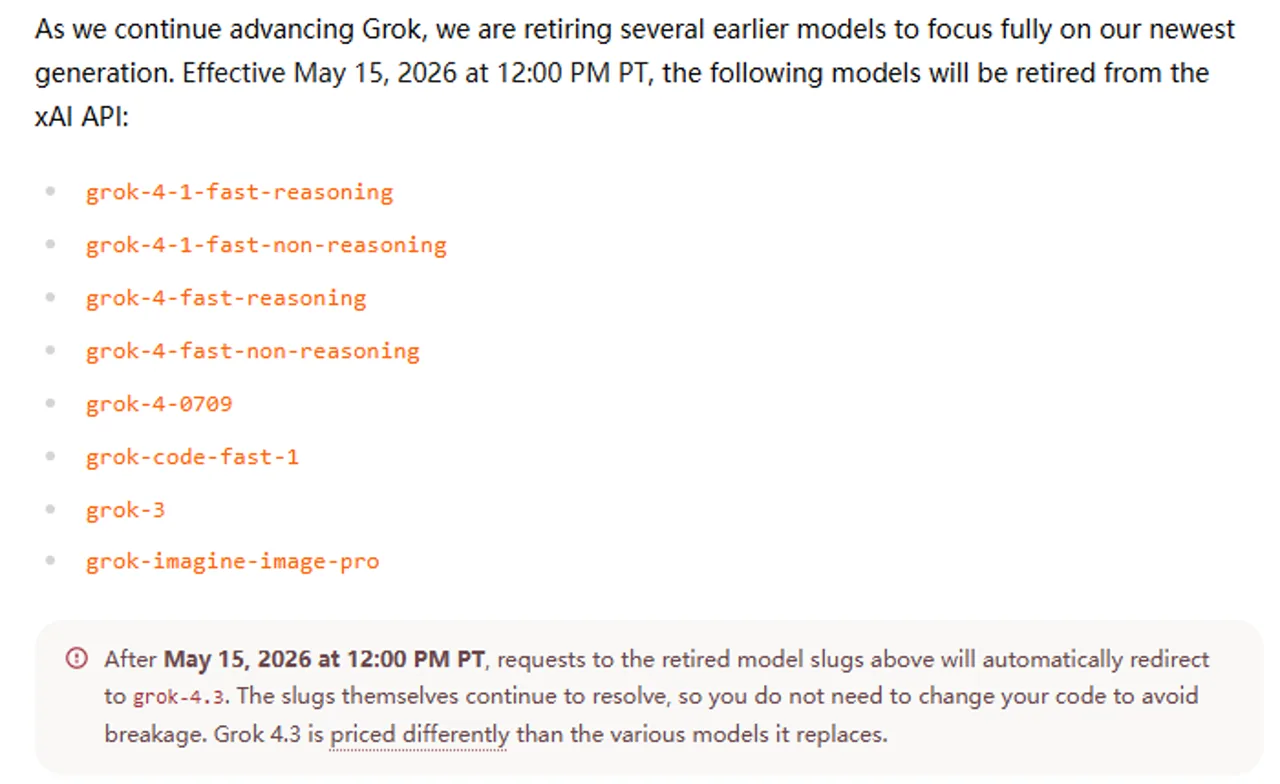
O Grok 4.6 é o modelo atual recomendado pela xAI para código. O site oficial Especificação Grok 4.6 A lista inclui chamadas de função, pesquisa na web, pesquisa no X e execução de código entre as ferramentas suportadas. O suporte não é o mesmo que ativação automática: o produto que faz a chamada ou a solicitação de API ainda determina o que o modelo pode ver e fazer.
O Anúncio do Grok 4.6 posiciona o modelo para agentes de longa duração e trabalho com base de código. Essa é uma afirmação oficial do produto, não algo que nossas quatro tarefas isoladas em JavaScript tenham medido de forma independente.
Versão Grok é o agente de codificação independente. Sua interface de terminal interativa e seu modo sem interface gráfica podem operar em um fluxo de trabalho de repositório. Se você estiver escolhendo entre nomes de modelos em vez de produtos de codificação, o Melhor modelo Grok por tarefa O guia explica a família atual.
O ferramenta de execução de código xAI é um ambiente Python opcional em sandbox. Ele não estava ativo em nossos testes com o Broly; portanto, o modelo não executou seu próprio JavaScript nem analisou o feedback do avaliador antes de responder.
Melhores casos de uso de codificação para o Grok
Depuração de uma falha isolada
O Grok é mais útil quando a falha pode ser reduzida a uma função, um rastreamento de pilha, um fixture com falha ou um diff curto. Inclua o que deveria acontecer, o que realmente aconteceu e o limite que você não deseja que seja alterado. O resultado da alocação de assentos mostra como um caso-limite preciso pode transformar uma solicitação vaga do tipo “corrija isso” em um patch verificável.
Criação de uma primeira implementação
Para adaptadores, analisadores, funções de transformação e exemplos de API, o Grok pode eliminar o atrito causado por páginas em branco. Solicite a menor unidade completa, as versões da biblioteca de pinos e execute o trecho de código. O Guia de integração da API Grok 4 é o próximo passo quando o trabalho envolve a API, em vez de uma solução isolada de código.
Revisão ou elaboração de provas
Solicite ao Grok os casos de limite ausentes, invariantes e mutantes candidatos. Em seguida, verifique se cada entrada distingue o comportamento que alega testar. A suíte Retry-After era abrangente no papel, mas um par de carimbos de data/hora alinhados permitiu que um bug semântico passasse despercebido.
Comparando abordagens alternativas
O Grok também é útil como uma segunda opinião sobre um algoritmo, uma estrutura de dados ou uma hipótese de depuração. Quando a decisão diz respeito à adequação do assistente, e não a uma correção específica, o Comparação entre as codificações Grok e ChatGPT adiciona uma visão que abrange todos os modelos.
Quando a codificação Grok requer supervisão
Reestruturações que preservam o comportamento: O modelo pode atender ao algoritmo solicitado, embora falte um campo de saída. Execute testes de regressão e compare saídas serializadas, erros, ordem, mutações e efeitos colaterais.
Alterações no repositório com vários arquivos: Nossas evidências não abrangem a detecção de dependências, sistemas de compilação, pesquisa de código, arquivos gerados, migrações ou edições coordenadas. Utilize um agente de programação real com acesso restrito ao repositório e, em seguida, analise seus comandos e o diff. O Comparação entre o Codex e o agente de código Claude mostra por que o fluxo de trabalho envolvido é tão importante quanto o modelo.
Trabalhos de segurança e produção: Não considere uma resposta afirmativa como um modelo de ameaças, uma auditoria de dependências ou uma aprovação de implantação. Mantenha a integração contínua (CI), a análise estática, a verificação de segredos, o ambiente de teste, a reversão e a revisão humana como parte do processo.
Formatos estritos de comunicação máquina a máquina: Três das quatro respostas brutas utilizaram uma cerca de Markdown, apesar das instruções explícitas contra o uso de Markdown. Valide e analise a saída no ponto de verificação; nunca passe o texto do modelo diretamente para a execução apenas porque ele se parece com código.
Custos e longas sequências de raciocínio: Nosso gateway registrou 4.260 tokens de conclusão para uma solicitação com max_tokens: 4096, principalmente como tokens de raciocínio. Essa observação não comprova o comportamento de faturamento ou de limite da xAI. Verifique o canal oficial atual e compare-o com o Grok 4 – Guia de preços e configuração da API antes de estimar um orçamento de produção.
Um fluxo de trabalho prático para usar o Grok em código
1. Reduzir o problema
Forneça ao Grok o menor cenário de reprodução em que o problema ainda ocorra. Inclua o erro, o código relevante e um resultado esperado. Remova o histórico do projeto e os segredos que não sejam relevantes.
2. Redija um contrato, não uma lista de desejos
Indique o nome da função, os dados de entrada aceitos, a forma exata do resultado, a ordem, as regras de mutação, os limites de dependência e o formato de saída. O Guia de uso do Grok 4 abrange o processo mais amplo de criação de contas e de geração de prompts.
3. Peça um troco
Prefira uma função ou uma alteração pontual em vez de uma reescrita abrangente. Peça para que o código preserve o comportamento público e identifique qualquer suposição que tenha sido necessária fazer.
4. Realizar verificações independentes
Execute o código fora da resposta do modelo. Adicione casos extremos que distingam semânticas semelhantes, verifique alterações na entrada, compare todos os campos de saída e teste as falhas esperadas. Para conjuntos de testes gerados, execute variantes conhecidas quando o risco justificar isso.
5. Analise as diferenças e assuma a responsabilidade pela decisão
Leia o diff final como se ele tivesse sido criado por um colaborador humano. Confirme as alterações nas dependências, os limites de segurança, a observabilidade e a reversão. A pessoa responsável pela fusão ou implantação continua sendo responsável pelo resultado.
O que os desenvolvedores divulgam publicamente
A experiência do público é variada e depende muito da tarefa, do produto, do prompt e da data. Dois comentários no Hacker News ilustram essa variedade, mas nenhum deles constitui uma referência ou uma pesquisa representativa.
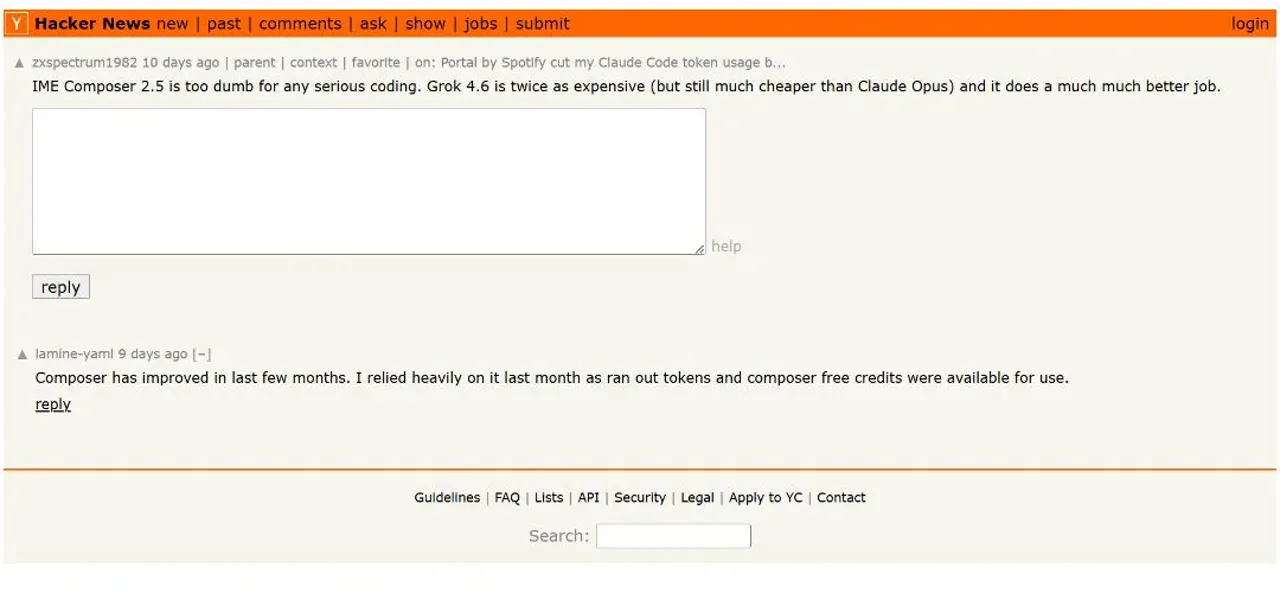
Em 5 de setembro de 2026, um usuário do Hacker News zxspectrum1982 descreveu o Grok 4.6 como tendo um desempenho muito melhor do que o Composer 2.5 em tarefas sérias de programação, embora também tenha mencionado que ele custa mais. Essa é a comparação de um usuário, não uma afirmação geral sobre desempenho.
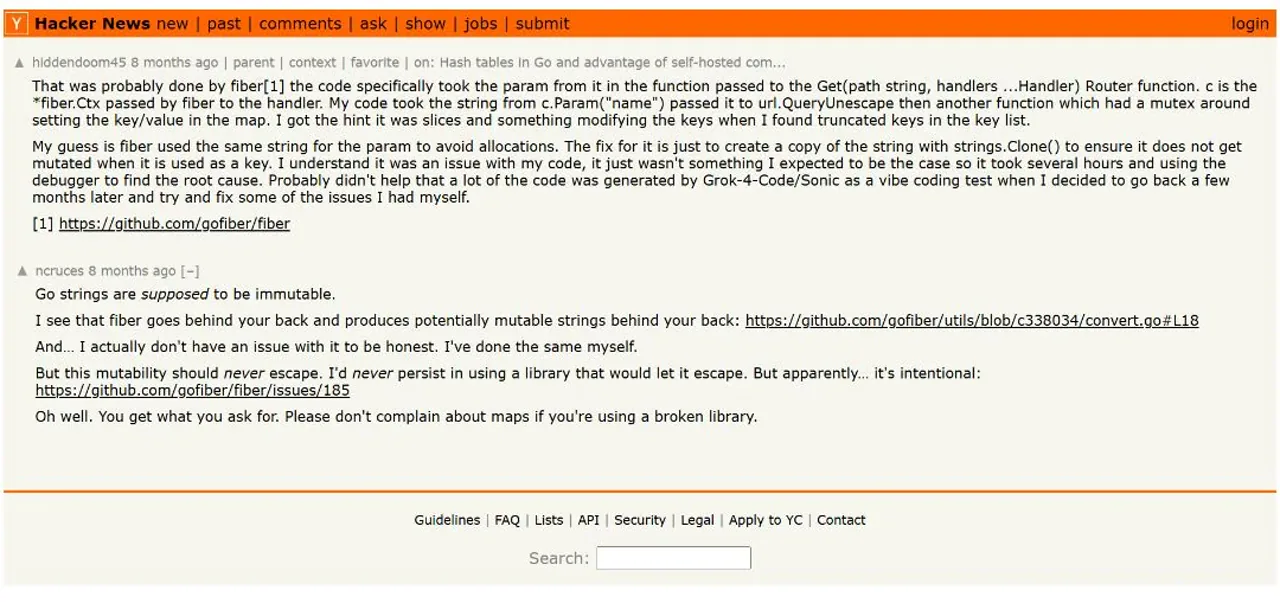
Em 20 de dezembro de 2025, um usuário do Hacker News hiddendoom45 descreveu ter identificado um bug sutil relacionado ao tempo de vida de strings no Go/Fiber posteriormente, com um depurador, após a geração do código durante um experimento Grok-4-Code/Sonic. Esse relato histórico corrobora a importância da depuração manual e da revisão que leve em conta o tempo de vida; ele não estabelece uma taxa de falha de Grok 4.6.
O ponto em comum não é que o Grok sempre dê certo ou dê errado. É que a qualidade da programação só se torna visível depois que a resposta se depara com uma tarefa concreta, uma cadeia de ferramentas e um revisor. O mesmo se aplica ao caso separado Análise da realidade da codificação ChatGPT: a qualidade do assistente é indissociável da verificação.
Perguntas frequentes
O Grok 4 é adequado para iniciantes em programação?
Sim, para explicações, pequenos exemplos e depuração orientada. Os iniciantes devem, mesmo assim, executar cada trecho de código, perguntar o que cada linha altera e evitar colar informações confidenciais ou implantar código desconhecido sem revisão prévia.
Qual modelo Grok devo usar para a codificação?
Conforme verificado em 11 de setembro de 2026, a xAI recomenda Grok 4.6 para o código. Confirme o ID exato do modelo em seu produto, pois o slug original da API grok-4-0709 foi descontinuado.
O Grok 4.6 consegue editar um repositório inteiro?
O modelo pode auxiliar no trabalho com repositórios quando utilizado dentro de um agente com acesso restrito a arquivos e comandos. Nossos testes consistiram em comandos isolados; portanto, não comprovam a capacidade autônoma de lidar com vários arquivos nem a prontidão para uso em produção.
O comando “Grok Build” é o mesmo que usar “Grok” no chat?
O No. Grok Build é um agente de codificação interativo ou sem interface gráfica independente. Um chat comum ou uma autocompletagem via API não recebe automaticamente o contexto do repositório, o terminal, as permissões ou o ciclo de ferramentas desse agente.
Posso usar o Grok 4.6 para codificação no GlobalGPT?
Sim. O GlobalGPT oferece uma rota Grok 4.6 verificada para prompts de codificação restritos e comparações de modelos. Trata-se de uma plataforma independente e não substitui o Grok Build, um IDE ou as ferramentas de API nativas da xAI.
Devo confiar no código gerado pelo Grok sem testá-lo?
Não. Execute o código, adicione casos extremos, verifique as diferenças e execute suas verificações habituais de lint, tipos, segurança e CI. Nossa refatoração parecia correta, mas omitiu um campo obrigatório em todos os resultados não vazios.
Veredicto final
O Grok 4 é bom para programação? O modelo atual Grok 4.6 é um assistente de programação competente para correções limitadas, pequenas funções, explicações e testes de primeira passagem. Em nosso conjunto de quatro tarefas, ele produziu duas soluções totalmente corretas, uma refatoração que comprometeu o comportamento do código e um conjunto de testes incompleto. Além disso, ignorou uma instrução estrita de não usar Markdown em três respostas.
Utilize-a em casos em que a detecção de falhas tenha um custo baixo: escopo restrito, contratos explícitos, fixtures executáveis e revisão humana. Não considere essas evidências como autorização para alterações não supervisionadas no repositório, aprovação de segurança ou implantação em produção.
Para um teste prático, abrir Grok 4,6 em GlobalGPT, execute um dos comandos completos acima e compare o resultado com seus próprios testes antes de decidir se ele deve ser incluído no seu fluxo de trabalho.