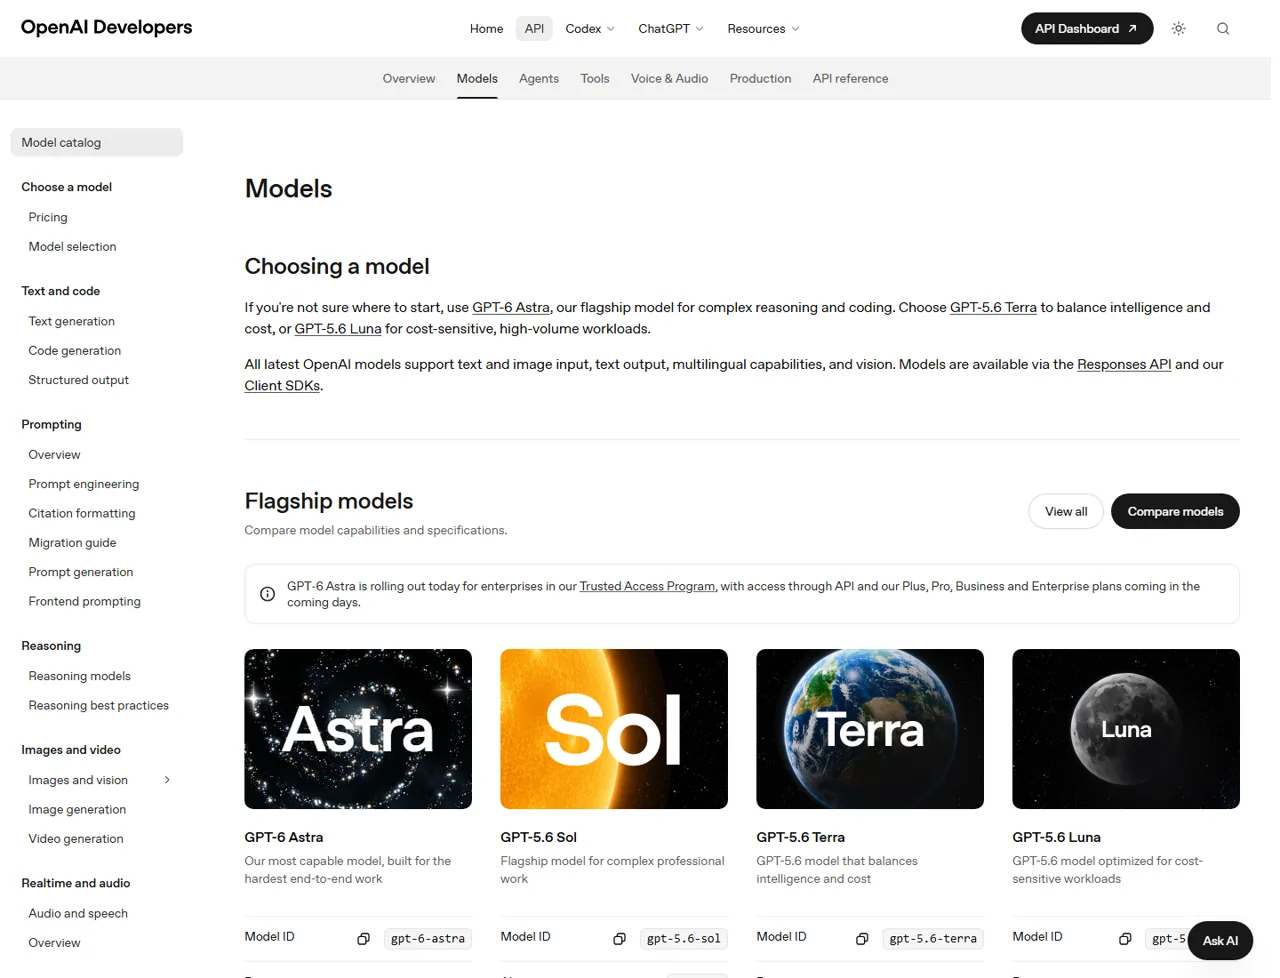
Resposta rápida: Preços do GPT-6 Astra $10 por 1 milhão de tokens de entrada, $1 por 1 milhão de tokens de entrada armazenados em cache, $12,50 por 1 milhão de tokens de gravação em cache, e $50 por 1 milhão de tokens emitidos com tarifas padrão, desde que o prompt tenha 272 mil tokens de entrada ou menos. Acima de 272 mil, a solicitação completa passa para a tarifação de contexto longo: $20 de entrada, $2 de entrada em cache, $25 de gravações em cache e $75 de saída por 1 milhão de tokens. OpenAI documenta uma janela de contexto de 1,05 milhão de tokens e uma saída máxima de 128 mil.
Esses números tornam o Astra potente, mas caro o suficiente para exigir um planejamento. Uma solicitação repetida pode se tornar muito mais barata quando o cache funciona, enquanto uma solicitação que mal ultrapassa 272 mil tokens de entrada pode se tornar significativamente mais cara. Este guia distingue os preços oficiais dos exemplos calculados e das nossas observações práticas da API, realizadas em 5 de setembro de 2026.

Preços da API do GPT-6 Astra
O OpenAI divide a precificação padrão em contexto de curto e longo prazo. O limite é baseado em tokens de entrada, e não a soma total da entrada e da saída. O contexto curto abrange prompts com até 272 mil tokens de entrada; o contexto longo se aplica a partir desse limite.
Custo por 1 milhão de tokens
A faixa de preço mais alta se aplica a toda a solicitação. Os preços apresentados são por 1 milhão de tokens.
O detalhe mais importante é que ultrapassar os 272 mil não gera uma fatura com alíquotas mistas. De acordo com Documentação sobre preços da API do OpenAI, as tarifas mais altas se aplicam a toda a solicitação quando a entrada excede o limite. As equipes que estiverem comparando o Astra com um produto-destaque anterior devem, portanto, ir além do preço de entrada anunciado; nosso Guia de preços do GPT-5.6 fornece um contexto útil para essa discussão sobre o orçamento.
O armazenamento em cache de prompts pode reduzir substancialmente os custos de entradas repetidas, mas a criação do cache não é gratuita. Uma gravação no cache custa 1,25 vez a taxa de entrada não armazenada em cache aplicável. O processamento em lote e o processamento Flex custam 50% do plano Standard, enquanto o Fast custa o dobro da taxa aplicável. O processamento regional elegível acrescenta 10%, e o Fast não está disponível para o Astra com residência de dados na UE.
Quanto custa uma chamada à API do GPT-6 Astra?
Para uma solicitação padrão, calcule cada categoria de token faturada separadamente e, em seguida, some os resultados:
Custo total = custo de entrada não armazenada em cache + custo de entrada armazenada em cache + custo de gravação em cache + custo de saída.
(0,0125 × $10) + (0,002 × $50)$0.225(0,1 × $10) + (0,005 × $50)$1.25(0,1 × $1) + (0,005 × $50)$0.35(0,3 × $20) + (0,01 × $75)$6.75As estimativas com tarifa padrão não incluem ferramentas, acréscimos regionais e outros serviços cobrados separadamente.
Os 100 mil exemplos mostram por que os prefixos reutilizáveis são importantes: a estimativa de modelo-token cai de $1,25 para $0,35 quando todas as entradas são consideradas armazenadas em cache. Trata-se de uma ilustração de preço, não de uma garantia de que todo prompt repetido resultará em um acerto no cache. Para um orçamento multimodelo mais abrangente, compare as premissas do fluxo de trabalho em nosso Guia completo sobre modelos de IA “tudo em um”.
Tokens do GPT-6 Astra, janela de contexto e limites de saída
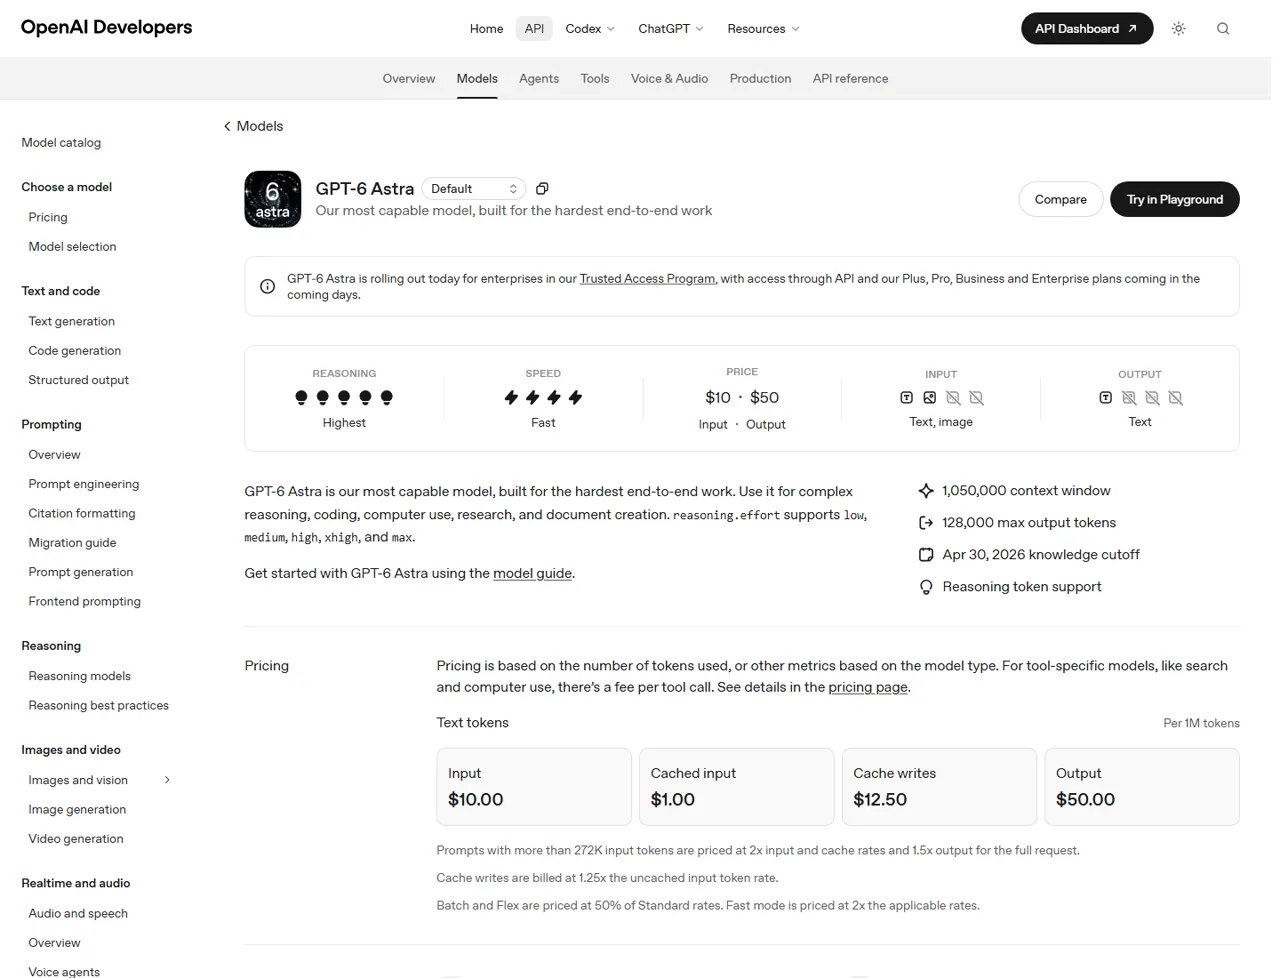
O página oficial do modelo GPT-6 Astra documenta um Janela de contexto com 1.050.000 tokens e um Produção máxima de 128.000 tokens. Seu limite de conhecimento é 30 de abril de 2026. Ele aceita entradas de texto e imagens, retorna texto e oferece opções de configuração do nível de esforço de raciocínio baixo, médio, alto, xalto, e máx..
Uma janela de contexto ampla é uma capacidade, não uma recomendação para atender a todas as solicitações. A recuperação, a seleção de documentos, a síntese e a estrutura do prompt podem manter a entrada abaixo do limite de 272 mil. A escolha do modelo também é importante: desenvolvedores com foco em programação podem comparar as vantagens e desvantagens em nosso melhor modelo de IA para codificação análise, em vez de partir do princípio de que o modelo com a janela maior é, automaticamente, o que melhor se ajusta aos dados.
Seis tarefas práticas para testar a API do GPT-6 Astra
Status do teste: O GPT-6 Astra ficou disponível por meio da API de compatibilidade do Broly Anywhere em 5 de setembro de 2026. Executamos as seis tarefas divulgadas abaixo. Cinco delas geraram respostas HTTP 200 utilizáveis; a solicitação de limite de 272 mil terminou com uma falha de transporte e permanece não verificada.
Instruções e resultados observados
ID do modelo gpt-6-astra. Cada resultado corresponde a uma execução observada, e não a um teste de desempenho oficial. O tempo real inclui o atraso no gateway e o atraso upstream.
Contabilidade básica de tokens
O modelo apresentou o resultado esperado pelo cálculo teórico. O uso real da API foi de 54 tokens de entrada e 26 tokens de saída.
Cache de prompts
Ambas as consultas estavam corretas, mas o prefixo repetido registrou zero token de cache e zero token de gravação em cache nas duas respostas.
Limite de preço de 272 mil
A grande solicitação sintética foi encerrada antes que uma resposta HTTP fosse recebida. Nenhum objeto de uso foi retornado; portanto, a faixa de taxa e o comportamento de cobrança permanecem sem medição.
Raciocínio “mínimo versus máximo”
Ambas as execuções resultaram em $265,20. A execução do Max demorou mais e gerou 88 tokens de raciocínio; essa única tarefa aritmética não apresentou melhoria na qualidade das respostas.
Parâmetro de saída de 128K
O endpoint de compatibilidade retornou “OK” em vez de rejeitar um token acima do limite máximo oficial. Trata-se de um comportamento do gateway, e não de uma indicação de que a janela de saída suportada seja maior.
Tarifários e níveis de serviço
As respostas normais não continham os cabeçalhos “remaining-request” nem “remaining-token”. As sondagens “Flex” e “priority” foram bem-sucedidas, mas retornaram “service_tier: default”.
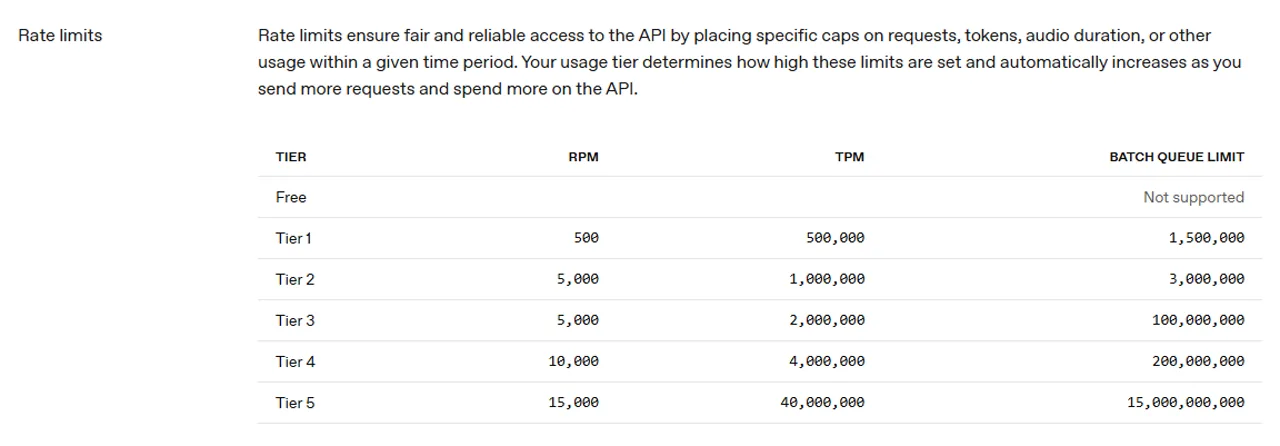
Limites de taxa da API do GPT-6 Astra
O GPT-6 Astra não é compatível com o plano gratuito. Os limites publicados aumentam de acordo com o nível de uso, mas os cabeçalhos dos projetos ativos continuam sendo a fonte prática de informações sobre a capacidade restante e o momento da reinicialização.
A capacidade aumenta acentuadamente no Nível 5
A altura da barra serve apenas como exemplo. Os valores exatos de RPM, TPM e fila de lotes acima são determinantes.
As opções “Batch” ou “Flex” podem reduzir pela metade as tarifas de tokens do modelo quando respostas imediatas não são necessárias. A opção “Fast” pode ser adequada para tarefas sensíveis à latência, mas dobra o preço aplicável e não está disponível com a residência de dados na UE para o Astra. Antes de implementar uma carga de trabalho em produção, compare o custo do modelo com as despesas relacionadas à plataforma; nosso Guia de preços do Codex ilustra por que as assinaturas de produtos e o faturamento por API não devem ser misturados.
O que os primeiros críticos estão apontando
O criador independente Matt Wolfe publicou um vídeo com uma prévia, abordando programação, uso de computadores e demonstrações do Blender e do Unreal Engine. Esses exemplos são úteis para compreender os tipos de fluxos de trabalho que os avaliadores estão explorando, mas não constituem evidências de benchmark controladas e não substituem os testes de API mencionados acima. Comparações mais amplas, como ChatGPT x Claude x Gemini deve, da mesma forma, ser interpretada como uma orientação específica para cada carga de trabalho, e não como um ranking universal.
Quem deve usar o GPT-6 Astra?
O Astra é uma opção plausível para tarefas de codificação complexas, fluxos de trabalho autônomos, análise de documentos extensos e trabalhos multimodais, nos quais um raciocínio mais robusto ou uma janela de contexto muito ampla podem compensar o custo elevado por token. As equipes devem testá-lo em uma tarefa específica e mensurável e comparar a qualidade por dólar, e não apenas a qualidade do resultado final. Nossa Visão geral dos melhores modelos de IA oferece um quadro de seleção mais amplo.
- Use o Astra quando: a tarefa é complexa, os erros custam caro, é necessário um contexto extenso ou o modelo pode substituir várias passagens menos eficazes.
- Opte por um modelo mais barato quando: o trabalho consiste em classificação rotineira, extração, reescrita ou geração em grande volume, com requisitos de qualidade simples.
- Otimize primeiro quando: as instruções ultrapassam repetidamente 272 mil, prefixos estáticos grandes podem ser armazenados em cache ou a latência não exige processamento Padrão ou Rápido.
Para os leitores que estejam comparando opções premium semelhantes, o Comparação entre GPT-5.6, Fable 5 e GPT-5.5 oferece uma outra perspectiva sobre custo, capacidade e adequação à carga de trabalho. O GlobalGPT possui um Página de destino do GPT-6 Astra. Nossas observações da API foram registradas separadamente por meio do endpoint de compatibilidade do Broly Anywhere.
Perguntas frequentes
Qual é o preço da API GPT-6 Astra?
A tarifação padrão para contexto curto é de $10/M de entrada, $1/M de entrada em cache, $12,50/M de gravações em cache e $50/M de saída. Acima de 272 mil tokens de entrada, a solicitação completa utiliza $20/M de entrada, $2/M de entrada em cache, $25/M de gravações em cache e $75/M de saída.
O que acontece quando uma solicitação ultrapassa 272 mil tokens de entrada?
OpenAI transfere toda a solicitação para a faixa de contexto longo. Não se trata de uma combinação mista em que apenas os tokens acima de 272 mil custam mais.
O que é a janela de contexto do GPT-6 Astra?
O OpenAI apresenta uma janela de contexto de 1.050.000 tokens, uma entrada máxima de 922.000 tokens e uma saída máxima de 128.000 tokens. Os tokens de raciocínio também ocupam espaço no contexto e são contabilizados como saída.
O GPT-6 Astra suporta entrada de imagens?
Sim. A documentação do modelo indica como entradas texto e imagens, com saída em texto. Áudio e vídeo não constam como modalidades de entrada para este modelo.
Esses exemplos de custos são faturas oficiais?
Não. São exemplos aritméticos que utilizam as tarifas documentadas. Sua fatura também pode refletir a contabilização de tokens armazenados em cache, o modo de processamento, o processamento regional e outros serviços cobrados separadamente.
Quais modos de processamento estão disponíveis?
Os planos Standard, Batch, Flex, Fast e Ultrafast têm preços documentados na Astra. Os planos Batch e Flex custam metade do preço do Standard, o Fast custa o dobro do Standard e o Ultrafast custa seis vezes o preço do Standard na mesma faixa de contexto. O processamento regional elegível acrescenta 10%; a disponibilidade depende do modo e do ponto de extremidade.
Como o GPT-6 Astra é faturado por meio do GlobalGPT?
A API do GlobalGPT indica 23 créditos por 1 mil tokens de entrada e 117 créditos por 1 mil tokens de saída para o GPT-6 Astra. Os tokens de raciocínio são cobrados como saída. Essas são as taxas de crédito do GlobalGPT; o uso da API do OpenAI segue sua própria tabela de preços em dólares americanos.
Veredicto final
O GPT-6 Astra combina uma janela de contexto de 1,05 milhão de tokens e uma saída máxima de 128 mil, com um preço premium. Sua tarifa Padrão para contexto curto começa em $10 por 1 milhão de tokens de entrada e $50 por 1 milhão de tokens de saída, mas o limite de 272 mil, os tokens de raciocínio, as gravações em cache, o modo de processamento e o acréscimo regional podem alterar significativamente o valor da fatura. Faça uma estimativa dos tokens antes de enviar prompts grandes, verifique o armazenamento em cache a partir dos dados de uso e avalie o Astra com base no valor da tarefa concluída, e não apenas no preço nominal.