 Chloe Murphy
Hidrogênio
Tempo observado55,21 sTokens de entrada4,273Tokens de saída8,243
Avaliação da saída
Correto: A+C+D, custo 16, valor 31. Também identificou A+C+E como a única outra carteira viável com valor de pelo menos 30.
Comparamos os benchmarks publicados pelo Google e os preços da API, e depois testamos os três modelos em tarefas idênticas com resultados verificados, prompts, tempo e uso de tokens.

Hydrogen tem o menor preço oficial de token; Carbon visa o raciocínio mais profundo; Argon equilibra raciocínio de ponta e eficiência. Todos os três passaram em nossas quatro tarefas concluídas. O teste de código mais difícil expôs diferenças de formatação e explicação em vez de um vencedor em correção.
O Google agora tem três modelos Gemini 4 com nomes que dizem muito pouco sobre qual escolher. Você deve começar com Hydrogen, usar Argon para trabalhos exigentes ou pagar pelo raciocínio mais profundo do Carbon?
A comparação útil é a capacidade por tarefa: o que cada modelo pode resolver, quanto raciocínio ele usa e quanto custa uma resposta completa. As pontuações oficiais de benchmark nos dão um ponto de partida; tarefas difíceis com o mesmo prompt são necessárias para ver onde essas diferenças importam.
Testamos os três modelos nas mesmas tarefas através do GlobalGPT. Se você quiser comparar sua própria carga de trabalho, comece com o GlobalGPT e verifique as opções de modelo atuais e os termos de uso da sua conta.
Desenvolvido para codificação diária rápida e execução agêntica.
Pode ser executado de forma independente ou lidar com a execução juntamente com modelos de raciocínio mais profundo.
Índice relatado pelo Google: 51 em pensamento alto, 54 em xhigh.
Fonte: O anúncio do Hydrogen do Google.
O modelo de raciocínio Gemini 4 de maior capacidade.
Destinado a depuração difícil, pesquisa científica e verificação estendida.
Pode usar mais tokens de raciocínio do que o Argon, apesar de taxas por token iguais.
Fonte: O anúncio de disponibilidade do Carbon do Google.
Raciocínio de fronteira eficiente para codificação, matemática e ciência exigentes.
O Google o posiciona como mais rápido e menos intensivo em tokens do que o Carbon.
Seu papel é um equilíbrio entre profundidade de raciocínio e custo da tarefa.
Fonte: A documentação de modelos e preços do Google.
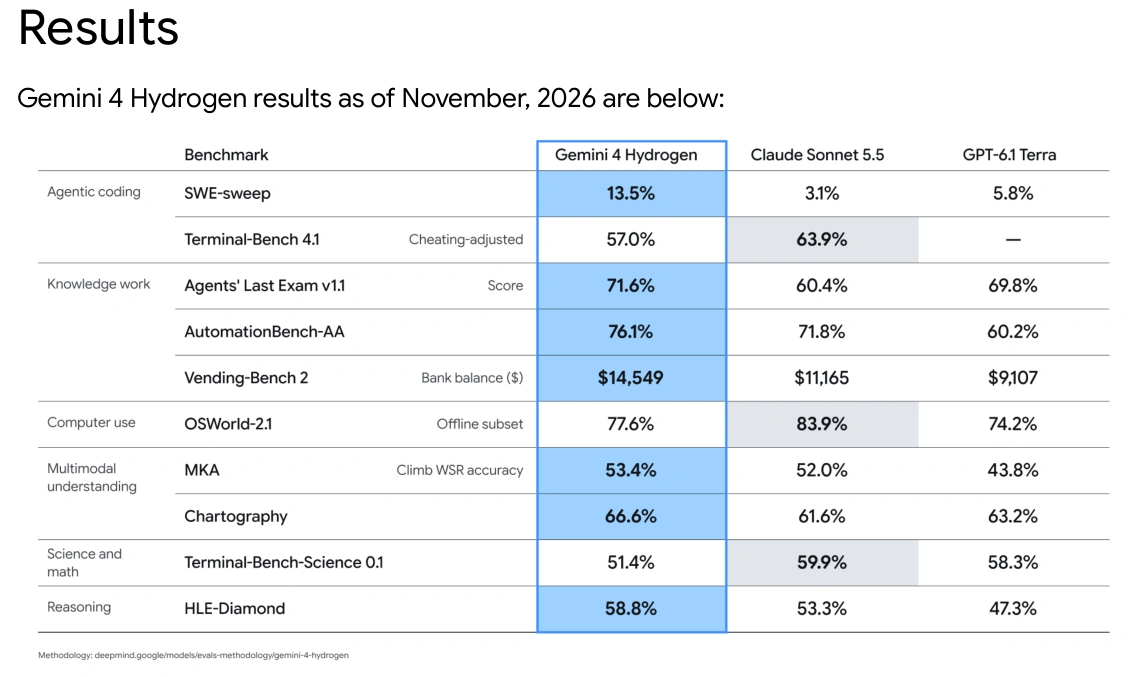
BENCHMARK PUBLICADO · MAIS ALTO É MELHOR
Uma visão rápida das pontuações relatadas pelo Google.
Estes são resultados publicados relatados pelo Google, verificados em 15 de novembro de 2026. Não são pontuações de nossos próprios testes. O número do Carbon vem de seu anúncio; os números do Hydrogen e Argon vêm do anúncio do Hydrogen acima. Esta é uma comparação de fontes entre anúncios, em vez de uma nova execução de leaderboard de três modelos com configurações idênticas verificadas de forma independente.
Não coloque os números do Terminal-Bench 4.0 e 4.1 na mesma coluna classificada. Uma versão de avaliação alterada pode mudar a dificuldade da tarefa, portanto as porcentagens não apoiariam uma conclusão justa de comparação direta.
Preços padrão da API Gemini em USD por um milhão de tokens, verificados em 15 de novembro de 2026:
API GEMINI PADRÃO · USD POR 1 MILHÃO DE TOKENS
Entrada
SAÍDA · INCLUINDO PENSAMENTO
Entrada
SAÍDA · INCLUINDO PENSAMENTO
Entrada
SAÍDA · INCLUINDO PENSAMENTO
*As tarifas publicadas atuais do Hydrogen não especificam aumento em dezembro; isso não é garantia contra mudanças futuras. A cobrança de saída inclui tokens de pensamento. Taxas de pesquisa e outras ferramentas são separadas. Estas são as tarifas da API do Google, não os preços de assinatura ou conversões de crédito do GlobalGPT.
Em contagens fixas de tokens, o Hydrogen custa25% menos do que o Carbon ou Argon em suas tarifas introdutórias. Em relação às tarifas anunciadas de dezembro, essa diferença se torna 62,5%. O custo real da tarefa também depende de tokens de raciocínio, novas tentativas e uso de ferramentas.
Por exemplo, 100.000 tokens de entrada e 20.000 tokens de saída faturáveis custam US$ 0,30 no Hydrogen, US$ 0,40 no Carbon ou Argon até 30 de novembro e US$ 0,80 no Carbon ou Argon a partir de 1º de dezembro. Este cálculo exclui ferramentas, cache, descontos por lote e novas tentativas; não prevê quantos tokens cada modelo precisa.
O Hydrogen tem um nível de API gratuito com limite de taxa. O Carbon e o Argon não têm. As assinaturas de consumidores são uma compra separada com suas próprias regras de acesso.
Fonte: Preços da API do Google.
Testamos o Hydrogen, o Carbon e o Argon em quatro tarefas idênticas. As três primeiras verificaram a precisão central; a tarefa final exigia um programa completo de busca exata que executamos e verificamos com uma resposta calculada de forma independente.
Mesma entrada e instrução do sistema para cada tarefa.
Novas solicitações, contexto do projeto desativado e sem uso de ferramentas do modelo.
Correção, formato de saída, tempo e uso de tokens avaliados separadamente.
TESTE 1 · LINHA DE BASE DE PRECISÃO
Selecione o portfólio ideal e identifique todas as alternativas qualificadas.
Solve exactly, showing verifiable arithmetic and a proof of optimality. Six indivisible projects have (cost, value): A(7,13), B(6,12), C(5,10), D(4,8), E(3,7), F(2,4). Budget=16. C requires A. D and E cannot both be selected. B requires at least one of D or F. Select projects maximizing total value; break ties by lower cost then alphabetically sorted project-list. Give chosen list, cost, value and enumerate all feasible candidates with value at least 30. No external tools or web.
Correto: A+C+D, custo 16, valor 31. Também identificou A+C+E como a única outra carteira viável com valor de pelo menos 30.
Correto: A+C+D, custo 16, valor 31. Também identificou A+C+E como a única outra carteira viável com valor de pelo menos 30.
Correto: A+C+D, custo 16, valor 31. Também identificou A+C+E como a única outra carteira viável com valor de pelo menos 30.
Veredito da tarefa: Todos os três passaram nas verificações de resposta principal.
TESTE 2 · LINHA DE BASE DE PRECISÃO
Separe a conversão agregada dos efeitos no nível do dispositivo e do aumento padronizado.
Analyze a randomized experiment using only these counts. Variant A: mobile 90 purchases/900 visitors; desktop 80/100. Variant B: mobile 20/100; desktop 630/900. Show overall and device-specific conversion rates, absolute lifts B-A, and a standardized B-A lift using 50% mobile/50% desktop. Explain the reversal, distinguish observational aggregate from randomized causal interpretation, and state exactly what randomization details are missing. May we claim B wins overall and in both devices? Do not invent significance or revenue. No external tools or web.
Correto: B lidera por 48 pontos percentuais no geral, mas perde 10 pontos no desktop. Uma mistura de dispositivos comum 50/50 dá lift zero. Rejeitou uma vitória em ambos os segmentos.
Correto: B lidera por 48 pontos percentuais no geral, mas perde 10 pontos no desktop. Uma mistura de dispositivos comum 50/50 dá lift zero. Rejeitou uma vitória em ambos os segmentos.
Correto: B lidera por 48 pontos percentuais no geral, mas perde 10 pontos no desktop. Uma mistura comum de dispositivos 50/50 dá zero aumento. Rejeitou uma vitória em ambos os segmentos.
Veredito da tarefa: Todos os três passaram nas verificações de resposta principal.
TESTE 3 · LINHA DE BASE DE PRECISÃO
Aplique revisões, anulações e reembolsos corretamente e, em seguida, retorne JSON estrito.
Return valid JSON only, no Markdown. Reconcile event ledger by event_id: retain highest revision, then exclude void=true. Amounts are integer cents; refund amounts subtract from captured revenue even when received before capture; group by order_id; ignore pending. Ledger: [e1,r1,o1,capture,1000,false];[e1,r2,o1,capture,1200,false];[e2,r1,o1,refund,200,false];[e3,r1,o2,refund,300,false];[e4,r1,o2,capture,2000,false];[e5,r1,o3,capture,500,false];[e5,r2,o3,capture,500,true];[e6,r1,o3,pending,900,false];[e7,r1,o4,capture,700,false];[e8,r1,o4,refund,800,false];[e8,r2,o4,refund,600,false];[e9,r1,o2,refund,100,false]. Output keys orders (array sorted by order_id with order_id,net_cents,retained_event_ids sorted lexically), total_net_cents, excluded_event_ids (superseded event versions written as event_id:rN plus void and pending versions). Include o3 with zero net. No external tools or web.
Correto: totais de pedido de 1.000, 1.600, 0 e 100 centavos; total 2.700 centavos. Saída bruta analisada como JSON sem limpeza.
Correto: totais de pedido de 1.000, 1.600, 0 e 100 centavos; total 2.700 centavos. Saída bruta analisada como JSON sem limpeza.
Correto: totais de pedido de 1.000, 1.600, 0 e 100 centavos; total 2.700 centavos. Saída bruta analisada como JSON sem limpeza.
Veredito da tarefa: Todos os três passaram nas verificações de resposta central.
TESTE 4 · TAREFA DE CODIFICAÇÃO HARD
Gere Python executável para uma busca restrita; executamos cada programa contra uma referência exaustiva independente.
Find the EXACT top 5 feasible portfolios, ranked by highest total value, then lowest total cost, then lexicographic sorted ID string. Items (ID,cost,value): [('A', 9, 19), ('B', 7, 16), ('C', 11, 25), ('D', 6, 13), ('E', 8, 18), ('F', 5, 12), ('G', 10, 23), ('H', 4, 9), ('I', 12, 29), ('J', 3, 8), ('K', 7, 17), ('L', 6, 15), ('M', 9, 22), ('N', 5, 11), ('O', 8, 20), ('P', 4, 10), ('Q', 11, 27), ('R', 2, 5)]. Budget 55; choose between 6 and 9 items inclusive. Dependencies: C requires A; G requires B and D; I requires E; M requires F and H; Q requires J and K. Mutually exclusive pairs: (A,B),(E,F),(L,N),(O,Q). At least 2 of C,G,I,M,Q. Exactly 2 of D,H,L,P. At least one of B,F,J,N,R. If O is selected then P is selected and K is absent. If R is selected then exactly one of A,E is selected. Return ONLY executable Python 3 code, at most 120 lines. Implement an exact exhaustive search, print JSON with keys feasible_count and top5 (each row [sorted_ID_string,cost,value]). Do NOT manually calculate or hardcode the answer. State complexity in a code comment. Use only itertools and json; no filesystem, network, subprocess or other imports. The code will be executed and checked against an independent exhaustive reference.Aprovado: o código executável retornou 121 carteiras viáveis e os os cinco primeiros corretos. Incluiu a contagem correta de combinações e uma explicação mais completa da complexidade.
Aprovado: código executável retornado 121 carteiras viáveis e os os cinco primeiros corretos. A contagem de combinações estava correta; a nota de complexidade omitiu o termo de ordenação final.
Aprovado após remover uma cerca Markdown: código retornado 121 carteiras viáveis e os os cinco primeiros corretos. O comentário afirmava 115.379 combinações em vez de 142.766 e omitia a ordenação na nota de complexidade.
Veredito da tarefa: Correção funcional empatada. O Hydrogen deu a combinação mais limpa de formatação executável e explicação nesta execução.
Os tempos são observações de execuções ponta a ponta em uma única execução, incluindo tempo de rede e de fila, com solicitações executadas simultaneamente. Os tokens relatam o uso de entrada/saída e podem incluir tokens de raciocínio ou de invólucro de solicitação; eles não são cobranças em dólares. Uma tentativa separada de resposta direta atingiu limites de taxa ou um tempo limite local e foi excluída da pontuação de qualidade. A tarefa de codificação acima usou um novo prompt correspondente.
Comece com o Hydrogen quando suas taxas oficiais de token mais baixas se adequarem à sua carga de trabalho. Mantenha o Argon em sua comparação se você valoriza o raciocínio de fronteira eficiente: ele resolveu corretamente nossa tarefa de codificação de busca exata após a limpeza de formatação. Avalie o Carbon em trabalhos que precisam de exploração mais profunda; este conjunto de testes não demonstrou uma vantagem de correção que justificasse escolhê-lo por padrão. Verifique a cobrança da plataforma exibida separadamente das taxas da API do Google.
O Hydrogen tem as taxas de API padrão listadas mais baixas: US$ 1,50 por milhão de tokens de entrada e US$ 7,50 por milhão de tokens de saída, verificadas em 15 de novembro de 2026.
Suas taxas de token padrão listadas são iguais. O Carbon ainda pode custar mais por tarefa se usar mais tokens de raciocínio ou etapas de verificação.
Não. Verifique a versão do benchmark e a configuração de raciocínio e, em seguida, teste o modelo em tarefas representativas com respostas verificáveis de forma independente.
Executamos cada solucionador Python gerado e comparamos sua contagem viável e as cinco principais carteiras com uma referência independente de busca exaustiva.
Nosso guia de acesso ao Argon explica as diferenças entre acesso à plataforma, assinaturas do Google, AI Studio e cobrança de API.
Para detalhes de acesso, leia como usar o Gemini 4 Argon. Para comparar modelos em uma conta, comece com o GlobalGPT e verifique o modelo selecionado e os termos de uso exibidos.