
Claude Fable 5.2 vs Opus 5.5: programação, custo e qual usar
Cinco tarefas com os mesmos prompts comparam Claude Fable 5.2 e Opus 5.5 em pesquisa, design de interface de IA, redação, dados e planejamento de produto, com capturas de tela originais e uso registrado de tempo e tokens.
 Chloe Murphy

O Opus 5.5 é o ponto de partida sensato para o trabalho rotineiro; teste o Fable 5.2 quando uma tarefa específica ainda precisar de melhorias. Em nossos quatro pares de tarefas de texto concluídos, ambos os modelos acertaram o cálculo central da pesquisa e as métricas de dados. O plano de produto da Fable lidou com uma incerteza de forma mais cuidadosa; ambos os resultados de escrita atenderam às principais restrições.
A comparação de design usa uma nova execução pareada de 32.768 tokens. Suas capturas de tela, verificações de interação e limitações aparecem na tarefa de design abaixo.
O Fable 5.2 é mais novo e custa mais por token. Mas será que oferece um resultado melhor — ou simplesmente uma conta maior? Comparamos pesquisa, design de interface de IA, redação, análise de dados e decisões de produto usando o mesmo briefing de tarefa para cada modelo.
Se você prefere comparar modelos sem gerenciar configurações de API separadas, a GlobalGPT oferece um espaço de trabalho multimodelo. Os testes de API aqui não estabelecem a disponibilidade do Fable 5.2 dentro da GlobalGPT.
A comparação prática
| Decisão | Fable 5.2 | Opus 5.5 |
|---|---|---|
| Entrada / saída padrão por milhão de tokens | $8 / $40 | $4 / $20 |
| Teste de pesquisa | Cálculo correto; redação causal precisa de edição | Cálculo correto; detalhe do desenho do estudo sem suporte |
| Teste de conteúdo | Explicação de 180 palavras; narração mais curta | Explicação de 180 palavras; exemplo mais completo |
| Teste de dados | Todas as métricas solicitadas estão corretas | Todas as métricas solicitadas estão corretas |
| Teste de produto | Distinção cuidadosa entre dano confirmado e dano possível | Plano útil; alegação sem suporte de trabalho perdido |
| Tentativa de design original | Sem artefato: falha HTTP | HTML completo após limpeza dos blocos de código |
Como testamos os dois modelos
Cada tarefa usou material de origem idêntico, uma conversa nova e o mesmo limite de saída para ambos os modelos. As tarefas de texto usaram um teto de 16.000 tokens; a execução de design final usou 32.768. Prompts, configurações, tempo e uso aparecem com a tarefa correspondente abaixo.
Todos os estudos, produtos, dados de pedidos e feedback nos briefings eram fixtures de teste fictícias. Verificamos os cálculos em relação a uma chave de resposta preparada. O esforço de raciocínio permaneceu no padrão da plataforma, portanto este não é um benchmark de esforço igual. Os rótulos de modelo retornados pelo gateway de terceiros não estabelecem independentemente o roteamento upstream.
Pesquisador: síntese sem exagerar as evidências
Mesmo prompt · Teste do pesquisador
You are a researcher. Use only these FICTIONAL study summaries about an AI writing assistant. A: randomized 120 adults, 60 per arm, intervention mean score baseline70 followup78, control baseline69 followup74, four weeks; no standard deviations, uncertainty intervals, or attrition information reported. B: observational 300 adults, usage correlated with writing scores r=.32, no confounder adjustment. C: interviews with12 users reporting perceived improvement. In under650 words synthesize evidence with A/B/C citations, calculate difference in changes, explain what cannot be inferred, and propose a feasible preregistered followup study with primary endpoint and analysis. Do not invent citations or statistical significance.
A tarefa do pesquisador pedia uma síntese de três estudos fictícios, incluindo um ensaio randomizado com relato incompleto. O cálculo essencial era (78 − 70) − (74 − 69) = 3 pontos. Ambos os modelos acertaram e se recusaram a inventar significância estatística.
Fable 5.2
Propôs uma avaliação de escrita cega e sem assistência, uma análise de intenção de tratar e verificações de sensibilidade a dados ausentes. Também forneceu um exemplo explicitamente hipotético de tamanho de amostra.
“Apenas a diferença de 3 pontos é atribuível ao assistente”
Essa redação era confiante demais, dada a atrito desconhecido e lacunas de relato, mesmo que parágrafos posteriores qualificassem a estimativa. Também especulou que os participantes da entrevista provavelmente eram autosselecionados.
Opus 5.5
Separou claramente as evidências randomizadas, observacionais e de entrevista. Propôs um ensaio ajustado à linha de base e manteve o cálculo do tamanho da amostra dependente da variabilidade piloto.
“de natureza transversal como descrito”
O resumo observacional fornecido não especificava um desenho transversal. Esse detalhe deveria ter permanecido desconhecido.
Se você adaptar este briefing, mantenha as evidências fixas e peça a cada modelo para separar fatos relatados de inferências. Nossos Prompts do Claude para pesquisa e codificação oferecem mais exemplos de restrições específicas da tarefa.
Designer: um espaço de trabalho multi-modelo de IA
Mesmo prompt · Teste do Designer
You are a product designer and frontend builder. Return only one complete self-contained HTML file with inline CSS and JavaScript, no external assets/CDNs. Build a polished AI multi-model workspace called Parallel. Give it a distinctive cohesive visual identity with excellent typography, whitespace, hierarchy and responsive layout; choose your own palette. Include sidebar, model A/B selectors, prompt textarea, compare button, two side-by-side result cards, loading state, clear button, per-result copy button, empty-input validation, keyboard-accessible controls and mobile stacking. Models A/B are FICTIONAL; all outputs must be locally simulated and explicitly labeled demo. No real API calls or fake live performance metrics. Compare must work repeatedly and preserve the submitted prompt in both outputs. Copy must report success only after actual success, otherwise provide an error. Aim for a complete compact artifact, not an explanation.
O briefing do designer pedia que ambos os modelos construíssem Paralelo: um espaço de trabalho de comparação de IA autônomo com barra lateral, seletores de modelo, entrada de prompt, cartões de resultados simulados, validação, controles de cópia e layout móvel. Deixamos a paleta de cores e a identidade visual em aberto.
A execução final correspondente usou o mesmo prompt, transporte de streaming e um teto compartilhado de 32.768 tokens. Ambas as respostas atingiram uma parada normal. Os artefatos de origem permanecem sem edição; salvar HTML remove apenas uma cerca Markdown envolvente quando presente.
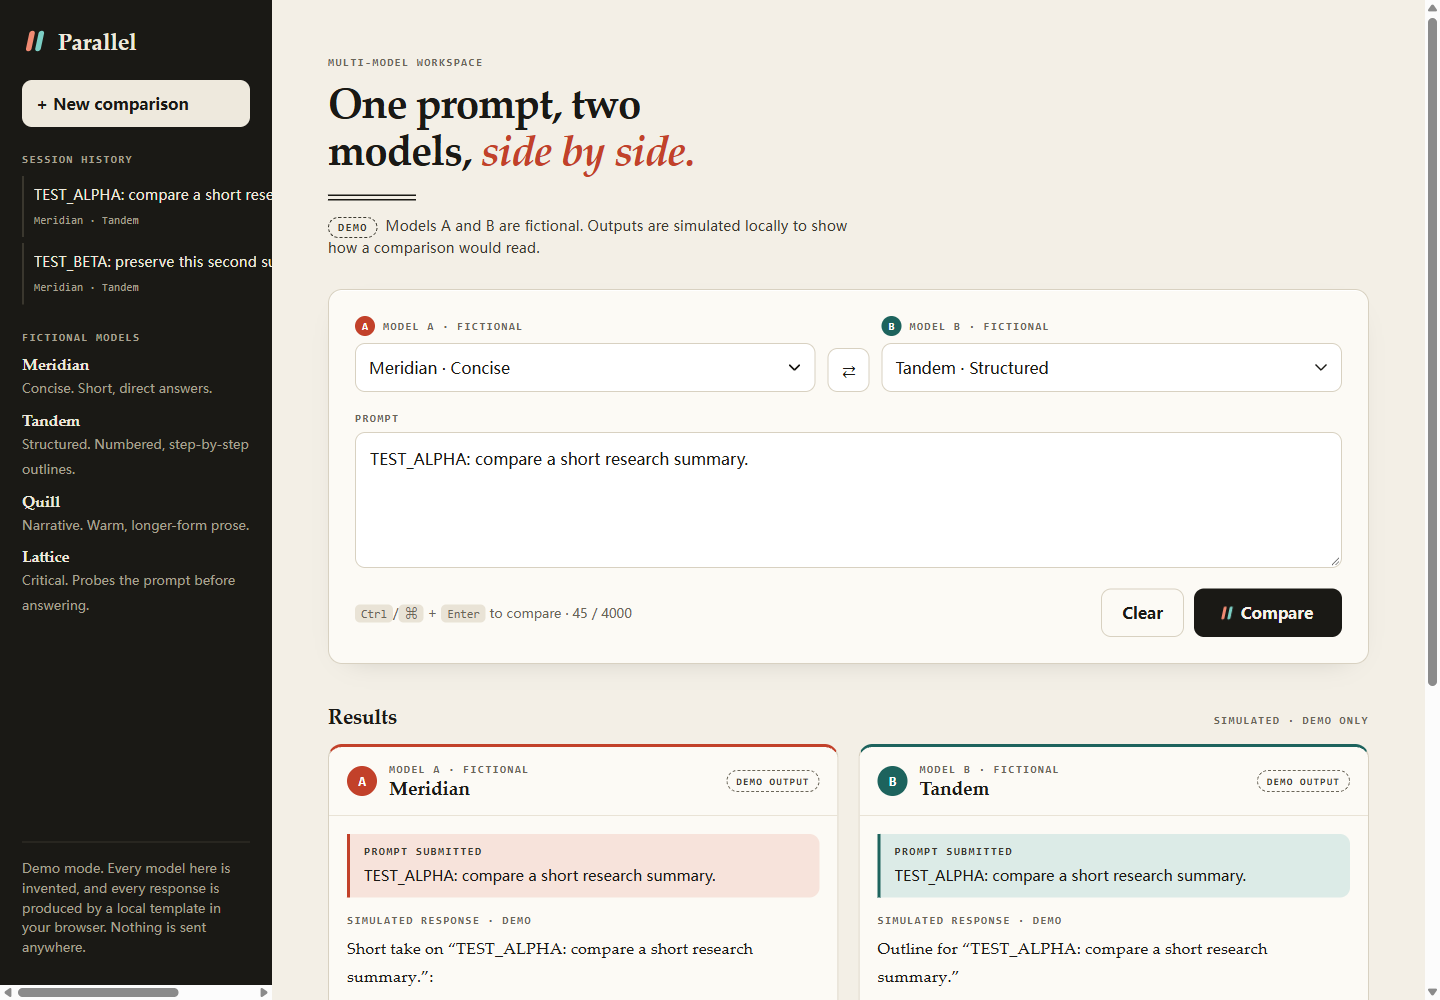
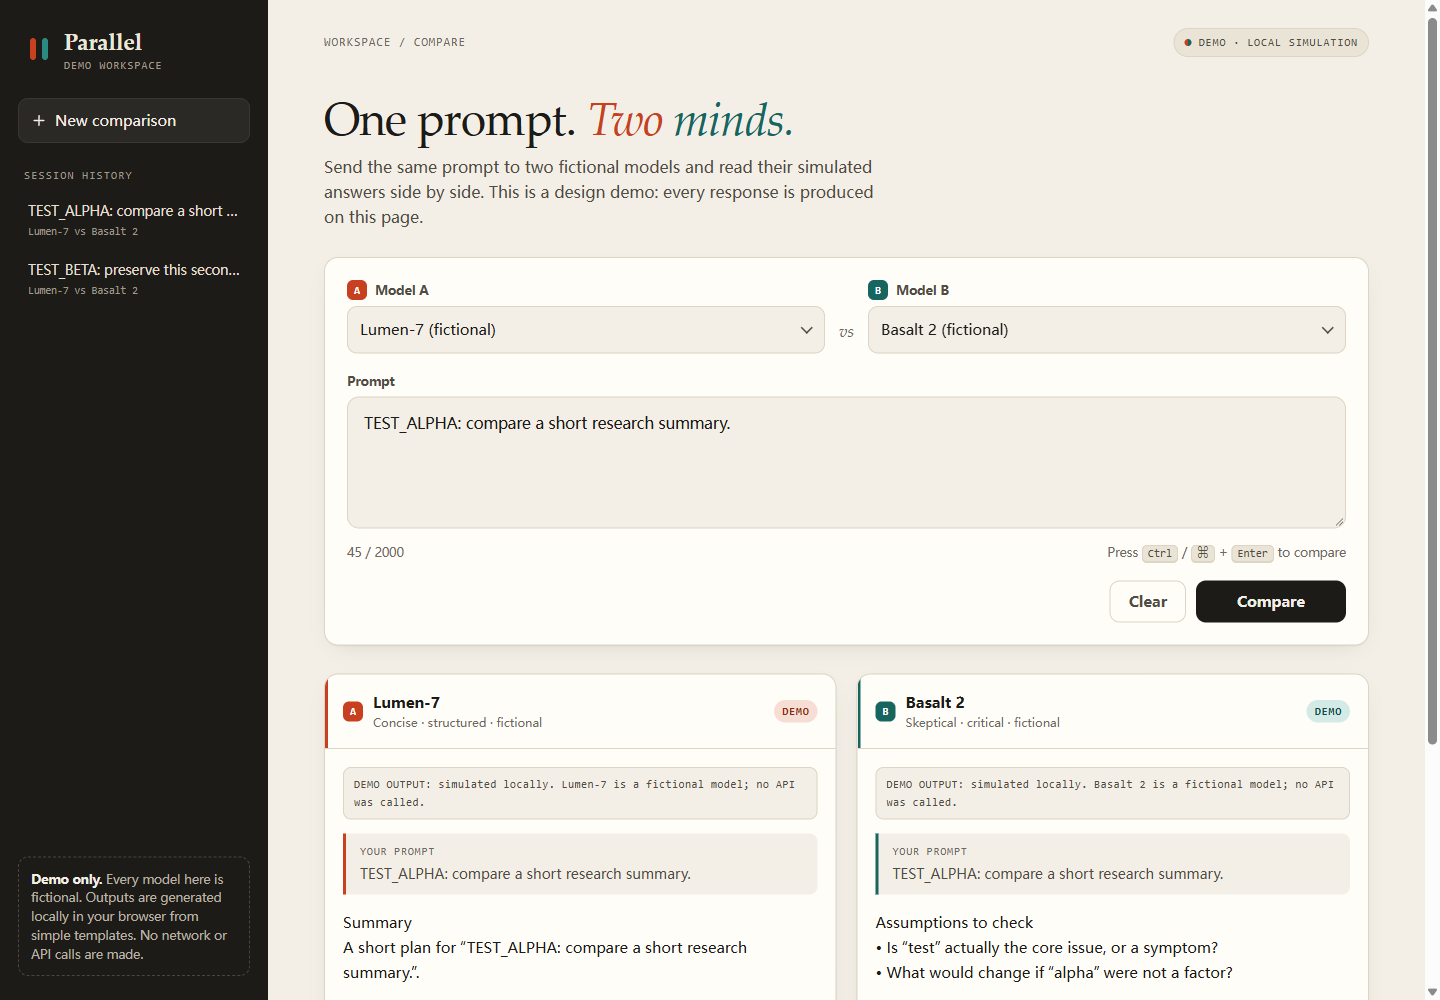
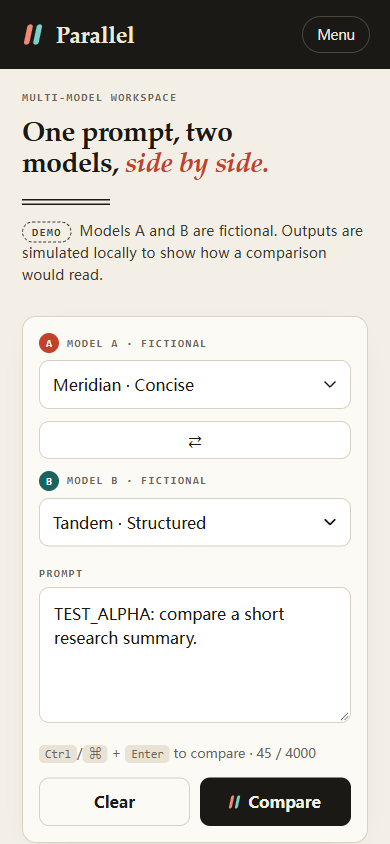
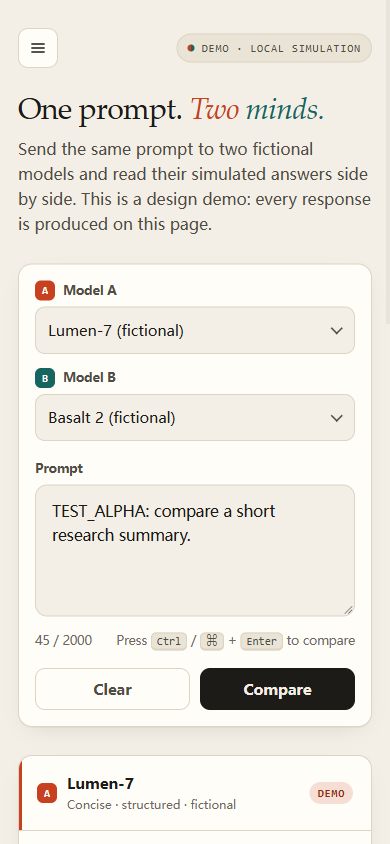
Como as páginas renderizadas realmente pareciam
Exemplo Fable 5.2
Um título serifado mais pesado, ênfase vermelha em itálico e uma barra lateral de alto contraste dão a esta página uma identidade editorial mais forte. Seu controle de troca de modelo é um extra útil, mas ocupa uma linha inteira no celular e empurra o prompt e os resultados para baixo.
Exemplo do Opus 5.5
O título mais leve e a área de seleção de modelo mais simples parecem mais contidos. No mesmo viewport móvel, o botão Comparar termina em torno de 710 pixels do topo, contra 826 pixels na amostra do Fable, deixando espaço para o primeiro cartão de resultado aparecer mais cedo.
Ambos escolheram tons de papel quentes, barras laterais escuras e títulos serifados. A diferença aqui está na hierarquia e na densidade, não em uma linguagem de design completamente diferente.Para este espaço de trabalho específico, preferimos o layout compacto da amostra do Opus.Se a prioridade for um título editorial mais proeminente, a amostra do Fable tem esse apelo. Esta é uma preferência subjetiva entre esses artefatos retornados, não uma classificação estética geral dos modelos subjacentes.
Verificações do navegador: aparência e comportamento separadamente
| Verificar | Amostra do Fable | Amostra do Opus |
|---|---|---|
| Validação de entrada vazia | Aprovado | Aprovado |
| Comparações repetidas preservam o prompt enviado | Aprovado | Aprovado |
| Feedback de carregamento visível | Aprovado | Aprovado |
| Limpar entrada | Aprovado | Aprovado |
| Estouro de página na largura de 390 pixels | Nenhum medido | Nenhum medido |
| Falha na cópia relata um erro honestamente | Aprovado | Aprovado |
| Cópia bem-sucedida para a área de transferência | Não verificado | Não verificado |
Abrimos as saídas não editadas no Chrome e usamos controles DOM para executar as verificações. Capturas de tela de desktop usam 1440 × 1000; capturas de tela móveis usam 390 × 844. Todas as quatro mostram o mesmo prompt enviado após a comparação e antes da verificação de cópia. Nenhuma exceção de tempo de execução foi capturada durante essas etapas. As gravações na área de transferência não tiveram sucesso na sessão automatizada, e uma travessia completa somente com teclado não foi testada.
O uso do par de design final fornece um proxy de taxa padrão de $0.8826 para Fable e $0.2918 para Opus. Isso usa taxas de provedores e tokens relatados pelo gateway, exclui tentativas anteriores e não é a fatura real do gateway.
Tentativas anteriores e limites de evidência
Criador de conteúdo: cópia precisa em dois formatos
Mesmo prompt · Teste do criador de conteúdo
You are a content creator. Based ONLY on these FICTIONAL product facts, write a180-word plain-English explainer and a45-second video script with timestamps, then a five-item fact-check checklist. Facts: Lumen is a fictional AI workspace; it lets users compare two AI text drafts side by side, save prompts locally in their browser, and manually copy a chosen result. It does not publish content automatically, browse the web, or verify facts. No prices, launch dates, speed metrics, supported model names, or privacy guarantees are provided. Audience: freelancers who struggle to choose a usable first draft. Explain a practical example, avoid hype and invented claims, and distinguish local prompt saving from an unproven no-training guarantee.
O briefing do criador forneceu um espaço de trabalho fictício com apenas três recursos: comparação lado a lado de rascunhos, salvamento local de prompts e cópia manual. Pedia um texto explicativo de 180 palavras, um roteiro de 45 segundos e uma lista de verificação de fatos com cinco itens.
Ambos os textos explicativos atenderam ao requisito de 180 palavrasde acordo com nossa regra de contagem de palavras, que mantém apóstrofos e hífens internos dentro de uma palavra. Ambos preservaram os limites dos recursos e evitaram corretamente tratar o armazenamento local como uma garantia de não treinamento.
Fable 5.2
Começou com a dificuldade do freelancer em escolher um rascunho e depois explicou os três recursos em frases curtas. Sua narração de vídeo continha 101 palavras: cerca de 135 palavras por minuto se entregue em 45 segundos.
Opus 5.5
Usou um exemplo de redator mais detalhado, contrastando uma abertura mais forte com explicações de recursos mais claras. Sua narração continha 109 palavras: cerca de 145 palavras por minuto no mesmo intervalo.
Essas estimativas de ritmo vêm da narração escrita, não de uma gravação cronometrada. O Fable deixa mais espaço para pausas; o Opus usa mais do intervalo para explicar o exemplo.
Para artigos mais longos, nosso guia usar o Claude para escrita de textos longos explica como separar a redação da verificação e edição.
Analista de dados: reembolsos, atribuição ausente e ROAS
Mesmo prompt · Teste de analista de dados
You are a data analyst. Use only this synthetic data. Orders CSV(order_id,updated,status,channel,amount): o1,1,paid,Search,100; o2,1,paid,Social,80; o2,2,refunded,Social,80; o3,1,paid,Search,120; o4,1,pending,Email,60; o5,1,paid,,50; o6,1,paid,Partner,90; o7,1,paid,Email,70; o8,1,paid,Social,60; o9,1,paid,Partner,110. Channel spend/clicks: Search200/100; Social100/80; Email50/40; Partner0/20. Deduplicate by order_id keeping greatest updated. Paid orders count and revenue use latest paid only; refunded/pending contribute zero. Blank channel must remain Unknown and cannot inherit spend/clicks. Calculate overall paid count, revenue, each channel paid count/revenue/conversion rate per click/ROAS, and measurable ROAS ranking; zero or missing denominator is N/A. Show arithmetic and propose a cautious next-budget decision without inferring causality. Return table and explanation under600 words.
A tarefa do analista foi projetada para detectar erros que uma tabela organizada pode esconder: IDs de pedidos duplicados, um reembolso posterior, um pedido pendente, um canal desconhecido e um canal de parceiro sem gastos.
Ambos os modelos corresponderam à chave de resposta preparada: 7 pedidos pagos e 600 em receita após manter o status mais recente do pedido. Eles excluíram os registros reembolsados e pendentes, mantiveram a atribuição ausente sob Desconhecido e marcaram as proporções indefinidas como N/A.
| Canal | Pedidos pagos | Receita | Conversão / clique | ROAS |
|---|---|---|---|---|
| Pesquisa | 2 | 220 | 2.00% | 1.10 |
| Social | 1 | 60 | 1.25% | 0.60 |
| 1 | 70 | 2.50% | 1.40 | |
| Parceiro | 2 | 200 | 10.00% | N/A: zero gastos |
| Desconhecido | 1 | 50 | N/A | N/A |
A Fable mostrou a aritmética da receita na tabela de canais e sugeriu verificar os reembolsos, pedidos pendentes, tags ausentes e custos de parceiros não registrados antes de mudar muito. O Opus adicionou uma tabela de deduplicação registro por registro e calculou que a receita não atribuída era 8,3% do total.
Ambos recomendaram um teste com orçamento limitado, em vez de tratar o ROAS observado como prova causal. A observação do Opus de que uma venda social extra aproximadamente dobraria o ROAS pressupõe um valor de pedido semelhante; não era um fato novo na entrada.
Gerente de produto: dano antes dos votos em recursos
Mesmo prompt · Teste de gerente de produto
You are a product manager for a FICTIONAL AI subscription workspace. Feedback: 2 users report duplicate charges after retrying checkout; billing logs confirm one duplicate captured charge. 30 users request dark mode. 8 report one model unavailable and no warning before using a prompt; outage reproduced. 1 requests account/data deletion; request pending for20 days, governing deadline unknown. 12 request reusable saved prompts. 4 want team seats; no revenue commitment. Two engineers available for one week; effort estimates unknown. Produce a one-week priority plan with rationale, explicit unknowns, scope boundaries, owner roles, acceptance criteria, instrumentation and rollback/containment steps. Do not fabricate legal deadlines, revenue, effort or certainty. Distinguish immediate containment from permanent fixes; do not rank purely by vote count. Under700 words.
O briefing do produto combinou uma cobrança duplicada confirmada com um pedido de exclusão atrasado para o usuário, uma interrupção do modelo reproduzida e mais solicitações de recursos populares. A armadilha era priorizar 30 votos para o modo escuro em vez do dano demonstrado.
Ambos os modelos colocaram cobrança, acompanhamento de exclusão e contenção de interrupções antes da construção de recursos. Nenhum dos dois inventou um prazo legal para exclusão. Ambos atribuíram funções de proprietário, separaram a contenção imediata das correções permanentes e propuseram verificações de aceitação e monitoramento.
Fable 5.2
Especificou a reconciliação de reembolsos, uma correção para prevenir cobranças repetidas e a contenção manual de interrupções. Tratou explicitamente a possível perda de cota como algo a confirmar e sinalizou a exclusão como irreversível.
Opus 5.5
Foi adicionado um aviso antes do envio, preservação de prompts e uma regra explícita contra a troca silenciosa de modelos. Sua tabela de priorização era rápida de examinar.
No entanto, dizia que os usuários “perdem trabalho e prompts silenciosamente”. O feedback fornecido estabelecia uma interrupção e um aviso ausente, não uma perda comprovada de prompts.
Preços do Fable 5.2 versus Opus 5.5
Para solicitações de API padrão, o Fable 5.2 custa o dobro por token em relação ao Opus 5.5. Isso torna o Opus o ponto de partida mais barato quando ambos os modelos entregam um resultado aceitável com uso de token semelhante.
Entrada / saída
Entrada / saída
Estas são as taxas padrão de entrada/saída da Anthropic, verificadas em 11 de novembro de 2026, daespecificação Fable.
A especificação Opus lista a taxa padrão correspondente. Modo rápido, cache, descontos por lote, assinaturas de consumidores e cobrança de terceiros têm termos diferentes.
Para uma solicitação ilustrativa com 10.000 tokens de entrada e 5.000 tokens de saída, a aritmética da taxa padrão é de US$ 0,28 para Fable e US$ 0,14 para Opus. Este é um exemplo resolvido, não uma fatura de nossos testes.
Uma taxa de token mais alta não implica um custo mais alto por tarefa bem-sucedida. Uma resposta mais curta, menos rodadas de revisão ou menos raciocínio podem alterar o total. Nossos testes de turno único não podem estabelecer economias de longo prazo.
Se você estiver integrando qualquer um dos modelos em um aplicativo, guia de configuração da API Claude cobre as questões de configuração separadamente da comparação de taxas de token aqui.
Multiplicar o uso relatado pelo gateway pelas taxas padrão da Anthropic resulta em um proxy baseado em taxas de US$ 0,4291 para Fable versus US$ 0,1799 para Opus nessas quatro tarefas. A fórmula é tokens de entrada × taxa de entrada + tokens de saída × taxa de saída, dividido por um milhão. Isso exclui todas as solicitações de design e chamadas com falha.proxy baseado em tarifas de $0,4291 para Fable versus $0,1799 para Opus nessas quatro tarefas. A fórmula é tokens de entrada × taxa de entrada + tokens de saída × taxa de saída, dividido por um milhão. Isso exclui todas as solicitações de design e chamadas com falha.
Este proxy é não é a cobrança real do gateway. Não verificamos sua fatura, a equivalência da contabilidade de tokens ou a margem. Também não mede o custo de edição humana posterior ou de tentativas adicionais.
O que os benchmarks oficiais estabelecem
A avaliação de lançamento da Anthropic dá ao Fable uma vantagem em várias tarefas difíceis. A tabela abaixo reproduz três pontuações relatadas; estas são avaliações do provedor, separadas de nossos próprios testes baseados em funções.
| Avaliação | Fable 5.2 | Opus 5.5 |
|---|---|---|
| FrontierCode 2.0 | 49.1% | 45.5% |
| FrontierSWE v2 | 69.9% | 62.3% |
| Terminal-Bench-Science 0.1 | 74.6% | 58.7% |
O relatório de lançamento usa o esforço mais alto disponível de cada modelo, salvo indicação em contrário. Essas pontuações apoiam a experimentação do Fable em trabalhos técnicos exigentes; elas não estabelecem uma vantagem universal em escrita, julgamento de produto ou gosto visual.
Ambos os modelos listam uma janela de contexto de um milhão de tokens e um limite de saída de 128.000 tokens. Esses limites não foram submetidos a testes de estresse aqui.
Perguntas frequentes
O Fable 5.2 é melhor que o Opus 5.5 para programação?
A Anthropic relata pontuações mais altas do Fable em várias avaliações de codificação difíceis. Nosso exercício de codificação é um espaço de trabalho de IA de arquivo único, não um benchmark de repositório, portanto não pode estabelecer um vencedor geral de codificação.
O Fable 5.2 custa mais?
Suas taxas padrão de entrada e saída de API são o dobro das do Opus 5.5: US$ 8/US$ 40 contra US$ 4/US$ 20 por milhão de tokens. O custo real da tarefa também depende do uso, raciocínio, novas tentativas, cache e do serviço que cobra você.
Esses testes foram executados dentro do GlobalGPT?
Não. Eles usaram os modelos nomeados por meio de um gateway de API de terceiros. Eles não estabelecem disponibilidade de modelo, cobrança ou recursos nativos dentro do GlobalGPT ou dos aplicativos do próprio Claude.
Pode-se confiar em qualquer um dos modelos para resumir pesquisas sem verificar?
Ambas as respostas de pesquisa calcularam o resultado principal corretamente, mas cada uma introduziu pelo menos uma inferência que precisou de edição. Verifique cada detalhe do desenho do estudo e separe estimativas de alegações de significância.
Uma página gerada com melhor aparência prova melhor capacidade de codificação?
Não. Design visual, interações funcionais, acessibilidade e manutenibilidade são dimensões separadas. Uma única página atraente não pode estabelecer confiabilidade de codificação em nível de repositório.
Os modelos receberam esforço de raciocínio igual?
Usamos entradas e limites de saída idênticos, com as configurações de raciocínio deixadas no padrão da plataforma. O mapeamento do gateway não foi verificado de forma independente, portanto, este não é um benchmark de esforço igual.
Devo mudar todo o meu trabalho para o Fable 5.2?
Use primeiro um teste de aceitação específico da tarefa. Comece com o modelo mais barato que o atenda e depois mude para o Fable quando conseguir identificar uma melhoria que valha a pena.
Veredito final: qual modelo você deve usar?
Comece com o Opus 5.5 quando o objetivo for um primeiro rascunho aceitável. Sua taxa de token padrão mais baixa o torna a base prática para escrita rotineira, limpeza de dados e planejamento. Para mais contexto, consulte nossa análise do Claude Opus 5.5.
Experimente o Fable 5.2 quando uma tarefa difícil específica ainda estiver falhando em seus critérios de aceitação. Mantenha as mesmas entradas e verifique se ele corrige a falha real. As orientações de seleção de modelo também recomenda começar com o Opus mais recente e escalar quando o Opus de maior esforço for insuficiente.
Se nenhum dos dois modelos premium for necessário, Sonnet 5.5 vs Opus 5.5 é a comparação de custos mais relevante.
Para um conjunto mais amplo de provedores, consulte nossos testes de gerador de texto com IA.
Para trabalho em repositório, a demonstração de arquivo único desta análise é apenas um ponto de partida. Ela não testa acesso ao shell, edições de vários arquivos, uso prolongado de ferramentas ou comportamento de recuperação de um agente de codificação. Para detalhes de configuração, consulte nosso guia escolher um modelo no Claude Code antes de tratar uma conclusão de chat como substituta de um ambiente de desenvolvimento completo.



