
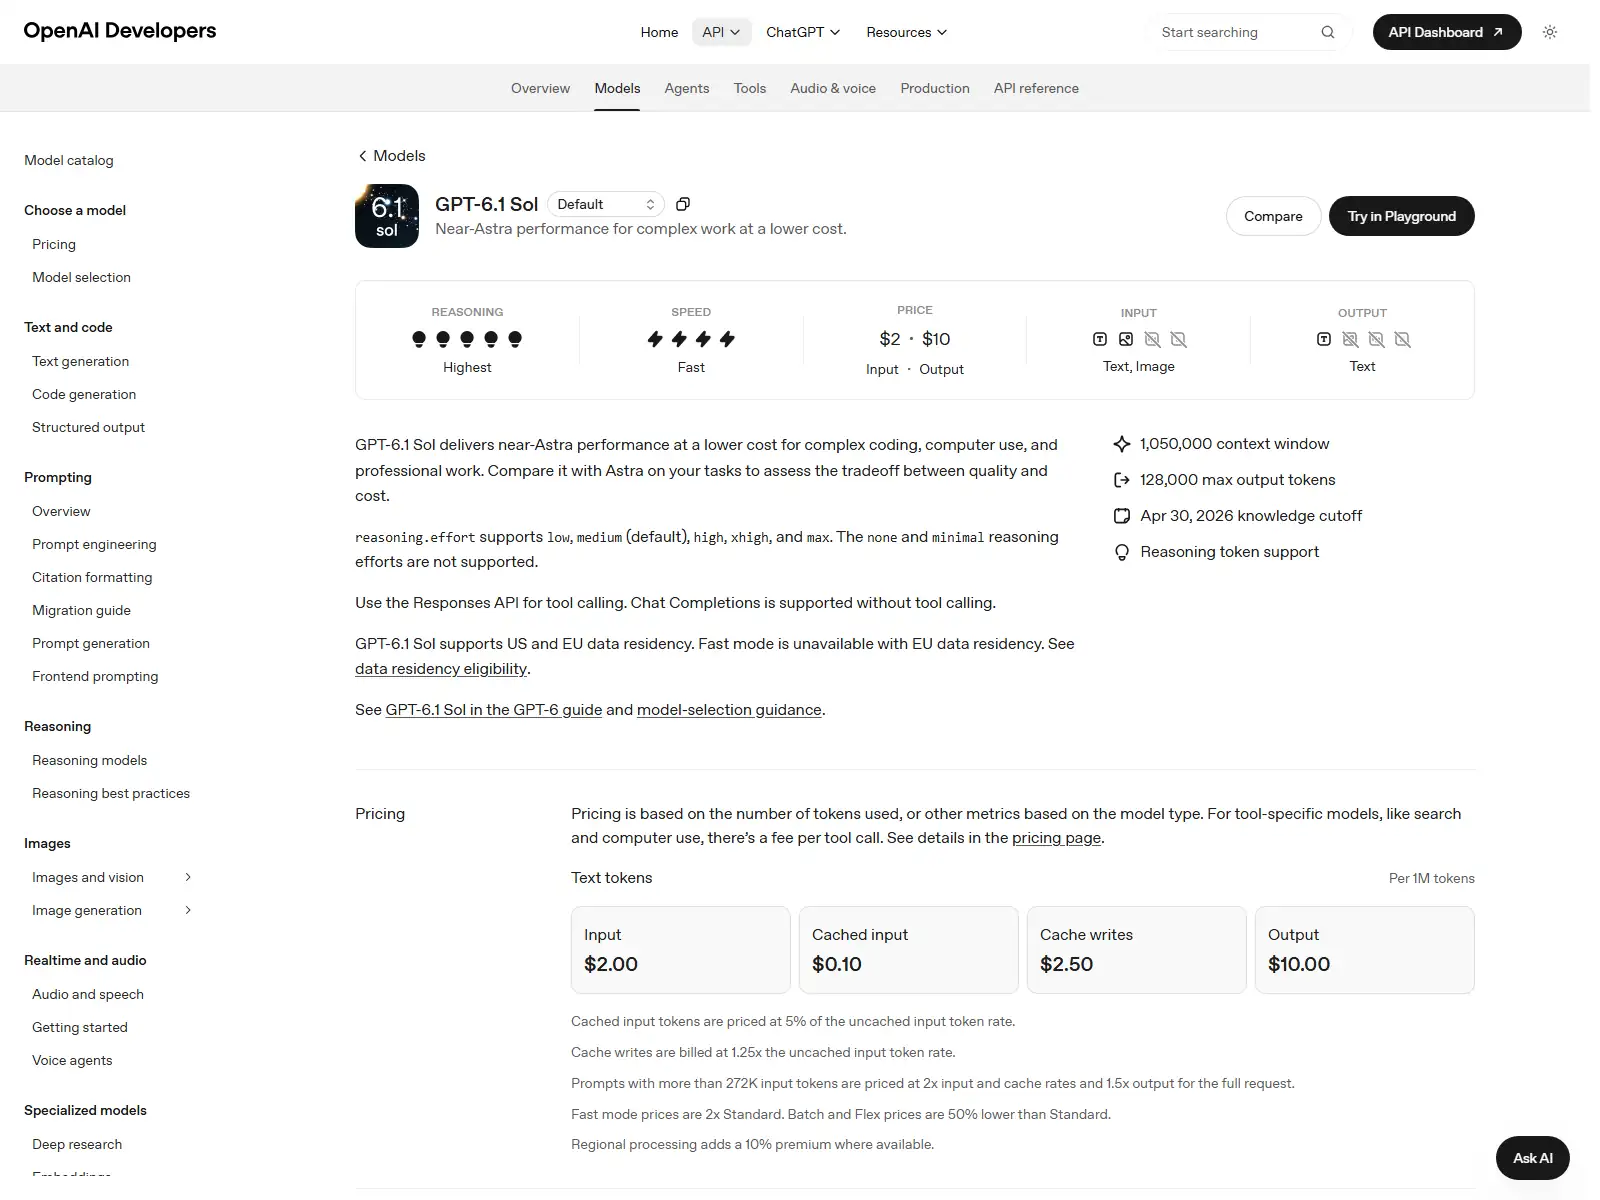
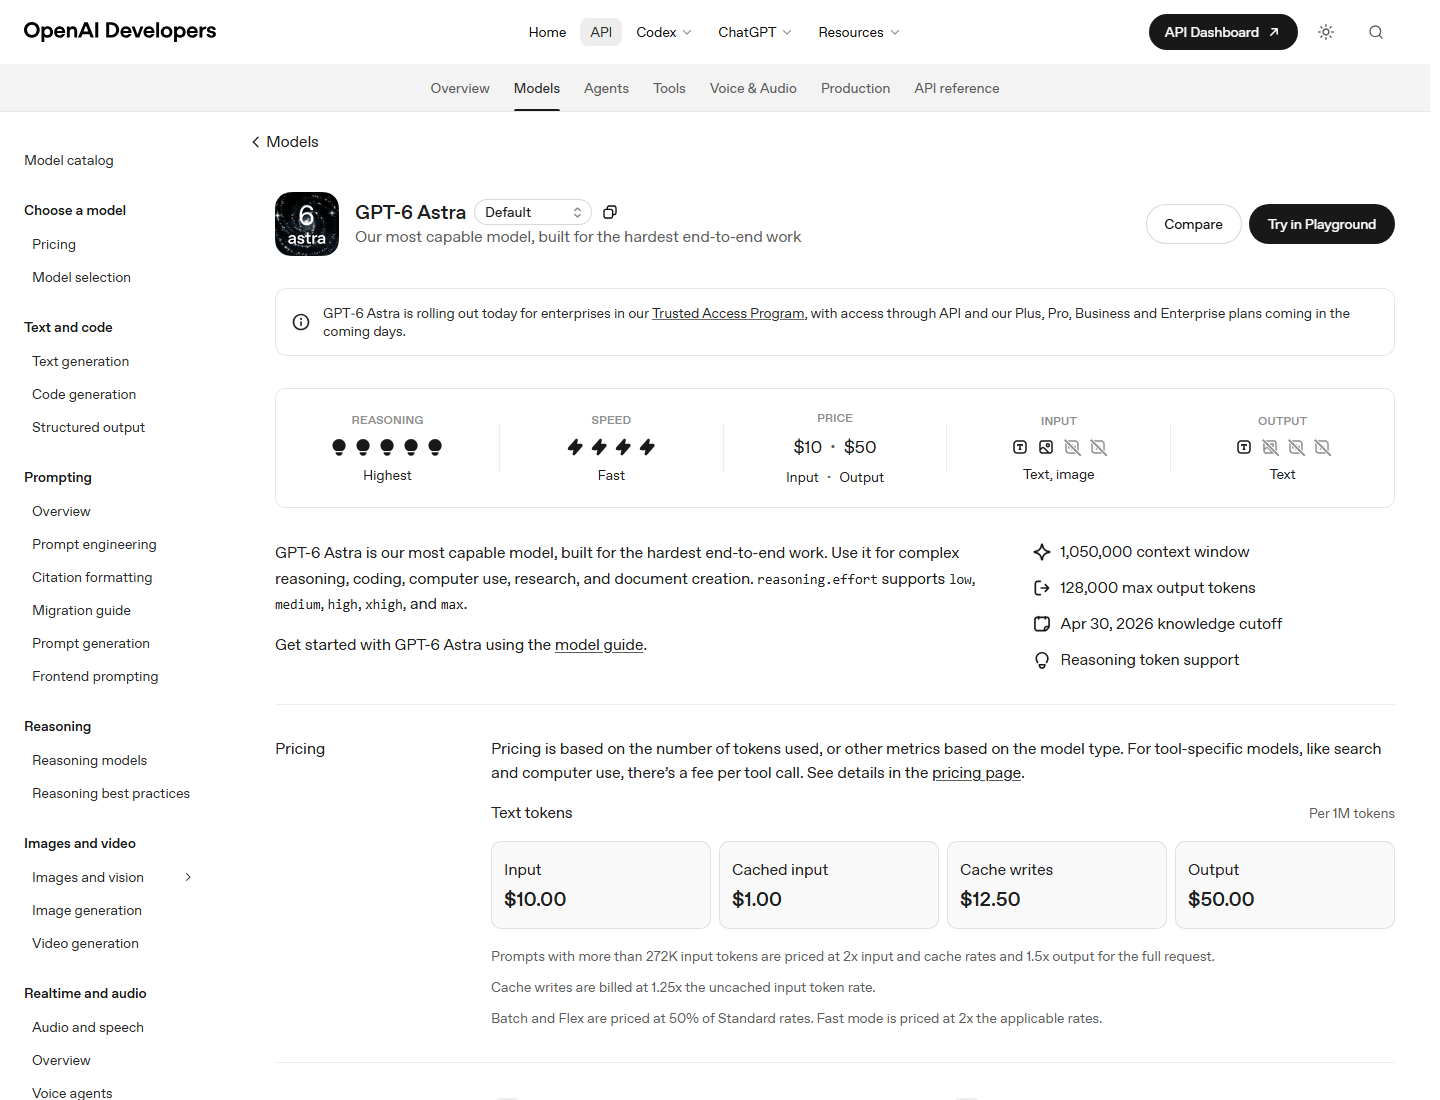
GPT-6.1 Sol is de standaardwaarde; GPT-6 Astra is de maximale kwaliteit. Beide bieden hetzelfde contextvenster van 1.050.000 tokens, een uitvoerlimiet van 128.000 tokens, multimodale invoer en een uitgebreide set aan tools. Het doorslaggevende verschil zit hem in de positionering en de prijs: Sol kost $2 per miljoen invoertokens en $10 per miljoen uitvoertokens, terwijl Astra $10 en $50 kost. Met andere woorden: Astra moet voldoende extra waarde creëren om de vijf keer hogere kosten in Standard-tokens te rechtvaardigen.
Dat betekent niet dat de Sol “hetzelfde model voor minder geld” is. OpenAI noemt de Astra zijn krachtigste model voor de zwaarste end-to-end-taken en beschrijft de Sol als een model dat bij complexe taken prestaties levert die bijna die van de Astra evenaren, maar dan tegen lagere kosten. De juiste keuze is daarom een kwestie van afweging, en geen kwestie van het rangschikken van merken. Deze vergelijking is gebaseerd op de huidige Documentatie bij GPT-6.1 Sol, de GPT-6 Astra-modelpagina, en identieke kostenscenario’s die op 9 oktober 2026 zijn gecontroleerd.
GPT-6.1 Sol versus GPT-6 Astra: korte vergelijking
De tabel maakt de eerste beslissing eenvoudig: als je nog geen taakspecifiek bewijs hebt, verdient Sol de eerste poging, omdat dit de belangrijkste interface- en capaciteitskenmerken behoudt en tegelijkertijd de tokenkosten aanzienlijk verlaagt. Astra wordt de rationele keuze wanneer het werk buitengewoon moeilijk is, de nadelen van een fout antwoord groot zijn, of wanneer het betere resultaat meerdere rondes van menselijke of modelherziening voorkomt.
Dit is iets anders dan Sol vergelijken met een klein, snel model. Volgens de huidige richtlijnen van de OpenAI-serie behoort Sol tot de top van het assortiment, en niet tot de goedkoopste modellen. Lezers die een keuze maken uit het volledige assortiment, kunnen ook gebruikmaken van onze gids voor de beste AI-modellen en de Recensie van de GPT-6 Luna om te zien wanneer een lichter model volstaat.
Wat GPT-6.1 Sol en GPT-6 Astra gemeen hebben
Op de twee officiële modelpagina’s staan hetzelfde contextvenster, dezelfde maximale invoer, maximale uitvoer en kennisgrens vermeld. Beide modellen accepteren tekst en afbeeldingen en genereren tekst. Geen van beide vermeldt audio of video als native modelinvoer of -uitvoer. Ze hebben ook dezelfde redeneringsinspanningen: laag, gemiddeld, hoog, xhoog en maximaal, waarbij gemiddeld de standaardinstelling is. Die symmetrie vereenvoudigt A/B-testen, omdat een applicatie de meeste verzoekparameters constant kan houden en alleen de model-ID hoeft te wijzigen.
Beide modellen ondersteunen gestructureerde uitvoer, het aanroepen van functies, zoeken op het web, zoeken in bestanden, het genereren van afbeeldingen, een code-interpreter, een gehoste shell, het toepassen van patches, computergebruik, MCP, vaardigheden en het zoeken naar tools. OpenAI geeft een overzicht van het aanroepen van tools via de Responses API; Chat Completions is beschikbaar wanneer er geen tools bij betrokken zijn. Fijnafstemming wordt op geen van beide modelpagina’s ondersteund. Dit zijn verklaringen over de mogelijkheden, geen beloften dat de twee modellen tools met identieke nauwkeurigheid zullen kiezen.
Een contextvenster van een miljoen tokens is een capaciteit, geen vrijbrief om het opvraagontwerp te negeren. Zeer lange verzoeken zijn duurder, moeilijker te debuggen en vallen onder de prijsstap boven de 272K invoertokens. Chunking, opvragen, samenvattingen en het in de cache opslaan van prompts blijven belangrijk. Dezelfde waarschuwing geldt voor de limiet van 128K output: kleinere, verifieerbare artefacten zijn doorgaans veiliger dan één enorm antwoord.
Prijzen: de vijfvoudige kloof
Volgens de standaardtarieven kost GPT-6.1 Sol $2 per miljoen niet-gecachete invoertokens, $0,10 voor gecachete invoer, $2,50 voor schrijfbewerkingen naar de cache en $10 voor uitvoer. GPT-6 Astra kost respectievelijk $10, $1, $12,50 en $50. Sol is vijf keer goedkoper voor niet-gecacheerde invoer, schrijfbewerkingen naar de cache en uitvoer; gecacheerde invoer is tien keer goedkoper. De huidige cijfers zijn rechtstreeks afkomstig van de modelpagina’s van OpenAI en Documentatie over API-prijzen.
De hoofdtariefstructuur is niet het volledige verhaal. Zodra een verzoek meer dan 272K invoertoken bevat, past OpenAI het dubbele van de normale invoer- en cachetarieven en 1,5 keer het normale uitvoertarief toe op het volledige verzoek. Batch en Flex worden geprijsd tegen 50% van Standard, terwijl Fast het dubbele van het geldende tarief kost. Astra biedt ook een Ultrafast-niveau aan. Vergelijk gelijksoortige diensten: een Sol Batch-verzoek en een Astra Fast-verzoek geven geen inzicht in de onderliggende model-prijsverhouding.
Voor een uitgebreider overzicht van het vlaggenschipsegment, zie onze Prijsgids voor de GPT-6 Astra. De eerdere Prijsanalyse van GPT-6 Sol Dit is handig bij het plannen van een migratie vanuit de vorige Sol-generatie, maar bij het maken van productieramingen moet gebruik worden gemaakt van de exacte huidige model-ID en de huidige tarieven.
Ontwerp met een brede context: dezelfde capaciteit, andere economische aspecten
Door het identieke contextvenster van 1.050.000 tokens lijken Sol en Astra misschien onderling uitwisselbaar voor werk met veel documenten, maar de capaciteit is slechts de eerste beperking. Een verzoek dat de limiet bijna bereikt, moet nog steeds het juiste bewijsmateriaal vinden, instructies onderscheiden van geciteerd materiaal, relaties tussen vele bestanden behouden en een resultaat opleveren dat door een persoon of programma kan worden geverifieerd. Het model met de grotere naam neemt de noodzaak van een informatiearchitectuur niet weg. Organiseer bronnen, markeer grenzen en vraag om verwijzingen naar stabiele documentidentificatoren.
De lagere kosten van Sol maken het economisch haalbaar om experimenten met een lange context uit te voeren. Een team kan verschillende chunking-strategieën, opvraagdrempels en samenvattingsformaten testen voor de prijs van één Astra-run. Die bredere verkenning kan het systeem verbeteren, zelfs als Astra bij slechts één prompt de beste resultaten levert. Astra is aantrekkelijker zodra de workflow stabiel is en de onopgeloste fouten daadwerkelijk aan het model zelf te wijten zijn. In de vroege ontwikkelingsfase levert het besteden van het volledige budget aan een paar toonaangevende prompts mogelijk minder leerresultaten op dan het uitvoeren van een gedisciplineerde Sol-evaluatie over een groot aantal representatieve gevallen.
De drempel van 272K verdient uitdrukkelijke aandacht. Een verzoek met 271K invoertokens en een verzoek met 273K zijn qua omvang vrijwel gelijk, maar het tweede verzoek valt hierdoor volledig in de hogere bandbreedte. Maak vooraf een schatting van het aantal tokens en noteer in welke bandbreedte elke taak viel. Als een invoer net boven de grens ligt, kan het verwijderen van dubbele standaardtekst, verouderde gespreksgeschiedenis of opgehaalde passages met lage waarde de kosten aanzienlijk verlagen zonder dat dit ten koste gaat van de kwaliteit. Deze optimalisatie geldt voor beide modellen, hoewel fouten bij Astra door de hogere basistarieven duurder uitvallen.
Het cachen van prompts is vooral nuttig wanneer een groot prefix bij verschillende aanroepen stabiel blijft. Voorbeelden hiervan zijn beleidshandleidingen, codeerstandaarden, een productcatalogus of een toolschema dat door veel taken wordt gedeeld. Plaats stabiele inhoud eerst en variabele instructies daarna, mits het cachegedrag van de API deze indeling ondersteunt. Meet vervolgens het aantal cache-hits in plaats van er zomaar vanuit te gaan. Het voordeel van Sol’s gecacheerde invoer is bijzonder groot, maar een voortdurend veranderend prefix kan dit tenietdoen. Het cacheontwerp hoort thuis in het benchmarkrapport, naast nauwkeurigheid en latentie.
Gebruik voor onderzoek en documentanalyse een gefaseerde werkwijze: verzamel waarschijnlijk bewijsmateriaal, vraag het model om een gestructureerde bewijskaart, controleer de bronvermeldingen en vraag pas daarna om een synthese. Gebruik Astra wanneer de synthese nog steeds zwak is nadat de bewijspijplijn deugdelijk is, of wanneer de bronnenverzameling ongewoon subtiele tegenstrijdigheden bevat. Hierdoor wordt een onderscheid gemaakt tussen mislukkingen bij het verzamelen van bewijsmateriaal en mislukkingen bij het redeneren. Zonder dat onderscheid betalen teams vaak voor een krachtiger model om een vermijdbaar probleem bij het opbouwen van de context te compenseren.
Programmeren en het gebruik van hulpmiddelen
Wat programmeren betreft, is de relevante vraag niet: “Welk model kan code schrijven?” Beide kunnen dat namelijk. De vraag is waar de extra mogelijkheden van Astra het resultaat beïnvloeden. Sol is aantrekkelijk voor gangbare repository-taken: het implementeren van functies binnen een bepaalde scope, het opsporen van reproduceerbare bugs, het beoordelen van pull-verzoeken, het schrijven van tests, het transformeren van gegevens en het uitvoeren van iteratieve tool-loops. Dankzij het lagere tarief zijn er meer pogingen, meer verificatie en grotere evaluatiesets mogelijk binnen hetzelfde budget.
Astra is vooral geschikt voor taken waarbij onduidelijkheid en coördinatie een grote rol spelen: een onbekende migratie naar een monorepo, een beveiligingsgevoelige architectuurbeoordeling, computergebruik op de lange termijn, een lastige port naar een andere programmeertaal of een productie-incident met onvolledige bewijsmaterialen. Het meest geavanceerde model kan zijn hogere prijs waard zijn wanneer één goed plan uren aan herwerk voorkomt. Onze het beste AI-model voor het vergelijken van programmeercodes legt uit waarom tests in de repository belangrijker zijn dan algemene indrukken over de code.
- Functies met een afgebakende scope en duidelijke acceptatietests
- Regelmatige foutopsporing en codebeoordeling
- Lussen voor agenten met een hoog verwerkingsvolume
- Ontwerpen voor migraties en herstructureringen
- Het genereren en documenteren van tests
- Ernstige storingen na een poging tot Sol
- Beveiligingsmaatregelen of gegevenswijzigingen met een hoog risico
- Dubbelzinnige systeemoverschrijdende architectuur
- Langdurige, zelfstandig uit te voeren computertaken
- Eindcontrole wanneer fouten veel kosten
Beoordeel geen van beide modellen op basis van code die alleen maar aannemelijk lijkt. Geef beide modellen dezelfde repository-snapshot, instructies, tools, tijdsbudget en tests. Leg het slagingspercentage, menselijke correcties, mislukte tool-aanroepen, tokens, latentie en kosten vast. Een model dat vijf keer zoveel kost maar het aantal mislukte pogingen halveert, kan gerechtvaardigd zijn; een model dat de stijl verbetert zonder de acceptatie te verbeteren, is dat niet.
Bewijs van prestaties: wat we wel en niet kunnen concluderen
De positionering van OpenAI biedt de sterkste onderbouwde samenvatting: Astra is het meest capabele model voor de zwaarste end-to-end-taken, terwijl GPT-6.1 Sol streeft naar prestaties die dicht bij die van Astra liggen bij complexe taken, tegen lagere kosten. Deze uitspraken ondersteunen een selectiehypothese, niet een universeel procentueel verschil. Geen enkele openbaar beschikbare benchmark kan de prestaties voorspellen voor uw eigen documenten, tools, beleidsregels of codebase.
Lanceringsvideo’s zijn waardevol om te begrijpen hoe een bedrijf een product presenteert, maar het zijn geen onafhankelijke beoordelingen. Ook laten reviews van contentmakers echte interfaces en nuttige voorbeelden zien, maar elke review weerspiegelt een specifieke reeks opdrachten, toolconfiguratie en publicatiedeadline. Beschouw een positieve thumbnail of een eerste indruk als een aanwijzing voor je eigen testplan, niet als bewijs dat Astra of Sol in elke categorie wint.
De officiële OpenAI-video hierboven toont hoe de lancering van Astra in beeld werd gebracht. De onafhankelijke pagina van Matt Wolfe hieronder laat zien dat de aandacht van derden al snel uitging naar de omvang van de release. Geen van beide screenshots wordt hier gebruikt als numerieke maatstaf. Het artikel vermijdt bewust om enthousiasme, het aantal weergaven of de titel van een maker om te zetten in een ongefundeerde prestatiescore.
Voor een degelijke vergelijking wordt gebruikgemaakt van een interne evaluatieset die overeenkomt met de productieomgeving. Neem eenvoudige taken, typische taken en kostbare foutgevallen op. Verberg de uitkomsten wanneer menselijke voorkeuren van belang zijn. Test bij agenten de voltooiing en het herstel in plaats van de eerste reactie. OpenAI’s richtlijnen voor modelkeuze beveelt tevens aan om modellen te vergelijken op basis van identieke taken en te kiezen voor het lichtste model en de minste redeneringsinspanning waarmee aan de kwaliteitsnorm wordt voldaan.
Hoe voer je een eerlijke vergelijking tussen Sol en Astra uit?
Begin met het vaststellen van de beslissing die de evaluatie moet nemen. “Welk model is slimmer?” is te vaag. Een nuttige vraag is: “Welk model moet de beoordeling van pull-requests voor deze repository uitvoeren bij een gemiddeld redeneerniveau?” of “Moet de definitieve contractsynthese worden geëscaleerd van Sol naar Astra?” Leg de taakfamilie, serviceniveau, redeneringsinspanning, tools, tijdslimiet en acceptatiecriteria vast voordat je output genereert. Anders kan een gunstig resultaat worden verklaard door de configuratie in plaats van door het model.
Stel een dataset samen die groot genoeg is om zowel gangbare gevallen als zinvolle randgevallen te bevatten. Twintig zorgvuldig geselecteerde voorbeelden kunnen voor de hand liggende fouten aan het licht brengen, maar een routeringsbeleid voor de productieomgeving heeft doorgaans meer nodig. Neem voorbeelden uit recent praktijkwerk, nadat je gevoelige gegevens hebt verwijderd, en label elk geval vervolgens op basis van moeilijkheidsgraad en risico. Houd een afgesloten testset achter de hand, zodat snelle aanpassingen niet geleidelijk leiden tot overfitting op de voorbeelden die iedereen al heeft gezien. Beheer de dataset en de evaluator in versies, net zoals je dat doet met applicatiecode.
Geef de voorkeur aan deterministische controles wanneer de taak dit toelaat. Compileer code, voer tests uit, valideer JSON aan de hand van een schema, vergelijk geëxtraheerde velden met labels en controleer geciteerde passages. Menselijke beoordelaars moeten zich richten op kwaliteiten die automatisering niet goed kan vastleggen, zoals duidelijkheid, beoordelingsvermogen en de vraag of een aanbeveling de zakelijke context respecteert. Maak de identiteit van het model onzichtbaar en willekeur de volgorde van de uitvoer. Als beoordelaars weten welk antwoord afkomstig is van Astra, kunnen prijs en reputatie de score beïnvloeden zonder dat iemand opzettelijk vooringenomen is.
Houd niet alleen de gemiddelden bij, maar ook de ernst. Tien kleine stijlvoordelen mogen niet zwaarder wegen dan één kritieke aanbeveling met betrekking tot gegevensverlies. Definieer harde veto's, zoals verzonnen citaten, onveilige commando's, ontbrekende verplichte velden of het niet naleven van een wettelijke beperking. Rapporteer de verdeling naar moeilijkheidsgraad en risicocategorie. Sol kan op normaal werk gelijk staan met Astra en alleen achterblijven bij de moeilijkste vijf procent; dat resultaat pleit sterk voor een router in plaats van een alles-of-niets-migratie.
Bereken ten slotte de onzekerheid en voer onstabiele gevallen opnieuw uit. Modelresultaten kunnen variëren, waardoor een eenmalige vergelijking het toeval overdrijft. Herhaal een deelverzameling, onderzoek verschillen tussen evaluatoren en bewaar de ruwe resultaten voor controle. De definitieve aanbeveling moet de testdatum, model-ID’s, instellingen, datasetversie, gebruikte prijzen en bekende hiaten vermelden. Herzie deze aanbeveling na een modelupdate, een wijziging in de prompt of een significante verschuiving in de werklast. De keuze voor een model is een doorlopende productiebeslissing, geen permanente trofee.
Laat de beoordelaar niet het verborgen beslissingsmodel worden. Als een geautomatiseerde beoordelaar een sterke voorkeur heeft voor één uitkomst, leg dan een steekproef van die beslissingen voor aan een deskundige en vergelijk de beoordelaar met harde acceptatieresultaten. Maak een onderscheid tussen de kwaliteit van de presentatie en de juistheid van de taak: een gepolijste uitleg kan een niet-voldane eis verbergen, terwijl een beknopt antwoord mogelijk alle tests doorstaat. Rapporteer ook onthoudingen en gelijke standen in plaats van een winnaar op te dringen. Die details maken het resultaat minder spectaculair, maar veel bruikbaarder voor budgettering en doorsturing. Het doel is een herhaalbare werkregel die een ander teamlid kan controleren en reproduceren. Leg ook afgewezen uitkomsten vast; voorbeelden van mislukkingen verduidelijken de grenzen van de doorsturing vaak beter dan een tabel met gemiddelde scores.
Voorbeelden van werkelijke kosten
Neem bijvoorbeeld een coderingsagent die wordt uitgevoerd met 200.000 niet-gecachete invoertokens en 20.000 uitvoertokens. Sol kost ongeveer $0,60: $0,40 voor de invoer en $0,20 voor de uitvoer. Astra kost ongeveer $3,00: $2,00 plus $1,00. Over 10.000 runs bedraagt het verschil ruwweg $24.000, exclusief toolkosten, caching, regionale toeslagen of aanpassingen aan het serviceniveau.
Laten we nu eens kijken naar een verzoek met een lange context, met 300.000 invoertokens en 30.000 uitvoertokens. Omdat de invoer meer dan 272K bedraagt, gelden de hogere tarieven voor het gehele verzoek. Het effectieve invoertarief van Sol wordt $4 per miljoen en het uitvoertarief wordt $15, wat neerkomt op ongeveer $1,65. Voor Astra wordt dit $20 voor de invoer en $75 voor de uitvoer, wat neerkomt op ongeveer $8,25. De verhouding van vijf blijft bestaan, maar het absolute verschil neemt toe.
Caching kan de berekening verder in de richting van Sol verschuiven, omdat de snelheid van de ingeslagen input een tiende is van die van Astra. Dat is van belang voor stabiele systeeminstructies, grote herhaalde verwijzingen en het opbouwen van agents. Het schrijven naar de cache brengt echter nog steeds kosten met zich mee, en het wijzigen van het voorvoegsel kan het hergebruik verminderen. Maak een schatting op basis van daadwerkelijke gebruikslogs in plaats van ervan uit te gaan dat elk token de cache-snelheid zal krijgen.
Hoe je de modellen in de API kunt vergelijken
Gebruik de Responses API voor toepassingen die gebruikmaken van tools en zorg ervoor dat de configuratie voor de vergelijking identiek blijft. De eenvoudigste bruikbare testopstelling stuurt dezelfde invoer naar beide model-ID’s, registreert de metagegevens van de respons en voert dezelfde evaluator uit. Maak API-sleutels niet zichtbaar in de broncode; gebruik een omgevingsvariabele en je gebruikelijke beheerprogramma voor geheimen.
De steekproef is bewust klein gehouden. Een productie-harnas moet verzoek-ID’s, evaluatorversies, repository-commits, tooltraces, het aantal herpogingen en acceptatieresultaten opslaan. Het moet ook de prijs berekenen op basis van het daadwerkelijk gebruikte serviceniveau en de daadwerkelijk gebruikte long-context-band. Zorg ervoor dat het ene model geen feedback te zien krijgt die het andere model niet heeft ontvangen, tenzij je expliciet een routeringsvolgorde test.
Een praktische routingstrategie van Sol naar Astra
Een router met twee fasen benut het sterkste economische argument voor Sol, zonder te doen alsof elke prompt even belangrijk is. Stuur normaal verkeer naar Sol met een gemiddelde redeneringsgraad. Escaleren wanneer deterministische tests mislukken, het model een lage betrouwbaarheid rapporteert, de taak in een categorie met hoog risico valt, of een mens expliciet om een vlaggenschipbeoordeling vraagt. Houd de escalatieregels inzichtelijk, zodat de kosten niet ongemerkt oplopen.
Gebruik dezelfde instructies, tools en acceptatietests.
Tests, betrouwbaarheid, risicoklasse en menselijke beoordeling.
Stuur mislukte pogingen of risicovolle werkzaamheden door naar Astra.
Houd de acceptatie, herbewerking, doorlooptijd en totale kosten bij.
Routing biedt teams bovendien een gestructureerde manier om standaardinstellingen bij te werken. Als het acceptatiepercentage van Sol binnen een taakgroep verbetert, vergroot dan het aandeel daarvan. Als Astra herhaaldelijk dure defecten voorkomt, leid die categorie dan rechtstreeks door. De vergelijking wordt zo een op gegevens gebaseerd operationeel beleid in plaats van een eenmalige discussie over het model. Zie voor een verwijzing naar een eerdere generatie GPT-6 Astra versus GPT-5.6 Sol.
Latentie en betrouwbaarheid horen thuis in hetzelfde routeringsbeleid. Een model kan een sterker antwoord opleveren, maar toch de verkeerde standaardinstelling zijn als de responstijd een interactieve workflow verstoort of als de langere redenering ervoor zorgt dat taken in time-out gaan. Meet de latentie van het eerste token, de totale duur, het herstel na een tool-call en de succesvolle voltooiing onder realistische gelijktijdigheidsomstandigheden. Definieer vervolgens een servicedoelstelling voor elke taakklasse. Sol kan het tijdgevoelige productieverkeer voor zijn rekening nemen, terwijl Astra de asynchrone beoordeling afhandelt, of het omgekeerde kan gerechtvaardigd zijn als een moeilijke taak routinematig mislukt voordat deze wordt geëscaleerd. De beslissing van het model is operationeel, niet louter redactionaal.
Voor wie is Sol geschikt, en voor wie is Astra geschikt?
Kies voor GPT-6.1 Sol voor een kostenbewuste productie
Sol is geschikt voor productteams, bureaus, onderzoekers en ontwikkelaars die grote hoeveelheden complex werk verwerken, maar toch over meetbare acceptatiecriteria beschikken. Het is vooral aantrekkelijk wanneer iteratie deel uitmaakt van het proces: code-test-fix-cycli, documentherziening, extractie met validatie, onderzoekssynthese en interne processen met meerdere stappen. Dankzij de lagere prijs is er ruimte voor een uitgebreidere evaluatie en meer herhalingspogingen.
Kies voor de GPT-6 Astra voor de meest veeleisende, kwaliteitsgevoelige taken
Astra is geschikt voor teams waarvan de moeilijkste taken hoge foutkosten met zich meebrengen of waarvoor de geautomatiseerde controles tekortschieten. Een lastige architectuurkeuze, een afsluitende beveiligingsbeoordeling, een baanbrekende wetenschappelijke redeneertaak of een langdurige reeks computerbewerkingen kunnen een reden zijn om voor het vlaggenschipmodel te kiezen. Het is ook de meest zuivere standaardkeuze tijdens de vroege ontdekkingsfase, wanneer het team nog niet weet wat een kleiner model over het hoofd ziet en de kosten nog geen directe beperking vormen.
Gebruik beide wanneer de moeilijkheidsgraad van de taak varieert
De meeste volwassen systemen zouden niet bij elk verzoek één bepaald model moeten opleggen. Gebruik Sol voor het brede middensegment en Astra als escalatielaag. Voeg Luna of een ander kleiner model toe voor voorspelbare classificatie en transformatie. Dit gelaagde ontwerp weerspiegelt de daadwerkelijke diversiteit van de werklast en is doorgaans voordeliger dan te discussiëren over één enkele definitieve winnaar. Onze methodologie voor het testen van modellen biedt een nuttig kader om herhaalbare bevindingen te onderscheiden van indrukken.
Hoe gebruik je GPT-6.1 Sol en GPT-6 Astra op GlobalGPT
GlobalGPT biedt live productroutes voor beide modellen binnen één multimodale werkruimte. Open de werkruimte, start een nieuw gesprek en selecteer in de huidige modelkiezer GPT-6.1 Sol of GPT-6 Astra. Het is handig om beide modellen in één interface te hebben voor vergelijkend verkennend werk, terwijl API-evaluatie de betere keuze blijft voor geautomatiseerde scoring, nauwkeurige registratie van het gebruik en implementatiecontroles.
Begin met Sol voor de eerste doorloop, voer vervolgens de moeilijkste prompt opnieuw uit met Astra en vergelijk wat er wezenlijk is veranderd.
Open GlobalGPTVoor meer modelspecifieke achtergrondinformatie kun je ons artikel lezen GPT-6.1 Sol: handleiding en Recensie van de GPT-6 Astra. Op die pagina’s wordt elk model afzonderlijk behandeld; deze pagina richt zich op de keuze tussen deze modellen bij de aankoop en de routebepaling.
Veelgestelde vragen
Is GPT-6.1 Sol beter dan GPT-6 Astra?
Niet in absolute zin. OpenAI positioneert GPT-6 Astra als zijn krachtigste model en GPT-6.1 Sol als een goedkoper model dat voor complexe taken prestaties levert die bijna op het niveau van Astra liggen. Sol biedt de beste prijs-kwaliteitverhouding als het aan uw kwaliteitseisen voldoet; Astra is de veiligere keuze waarbij kwaliteit voorop staat voor de zwaarste taken.
Hoeveel goedkoper is GPT-6.1 Sol dan GPT-6 Astra?
Volgens de standaardtarieven kost Sol $2 per miljoen invoertokens en $10 per miljoen uitvoertokens, terwijl Astra $10 en $50 kost. Sol is daarom vijf keer goedkoper voor niet-gecacheerde invoer en uitvoer. De prijs van $0,10 voor gecacheerde invoer bedraagt een tiende van het tarief van $1 van Astra.
Hebben GPT-6.1 Sol en GPT-6 Astra hetzelfde contextvenster?
Ja. In OpenAI worden voor beide modellen een contextvenster van 1.050.000 tokens, een maximale invoer van 922.000 en een maximale uitvoer van 128.000 vermeld. Bij verzoeken met meer dan 272.000 invoertoken wordt het volledige verzoek doorgestuurd naar tarieven voor langere context.
Welk model is beter om te programmeren?
Astra is de beste keuze als het gaat om bijzonder moeilijke, dubbelzinnige of risicovolle repository-taken. Sol is de praktische standaardkeuze voor routinematige feature-ontwikkeling, foutopsporing, reviews en agent-loops, omdat de lagere kosten meer iteraties mogelijk maken. Test beide op dezelfde repository-tests voordat je een standaardkeuze maakt.
Ondersteunen beide modellen tools en afbeeldingen als invoer?
Ja. Op hun officiële modelpagina’s staan de volgende functies vermeld: tekst- en afbeeldingsinvoer, tekstuitvoer, gestructureerde uitvoer, het aanroepen van functies, zoeken op internet, zoeken in bestanden, code-interpreter, gehoste shell, patches toepassen, computergebruik, MCP, vaardigheden en zoeken naar tools. Voor het aanroepen van tools moet de Responses API worden gebruikt.
Wanneer moet ik voor GPT-6 Astra betalen?
Gebruik Astra wanneer een fout veel kost, de taak echt baanbrekend is, of wanneer uit een vergelijkende evaluatie blijkt dat de extra kwaliteit ervan het aantal herbewerkingen zodanig vermindert dat dit vijf keer de tokenprijs rechtvaardigt. Voorbeelden hiervan zijn kritieke migraties, complex gebruik van autonome computers en de eindcontrole van opleveringen met hoge inzet.
Welke redeneermethode moet ik kiezen?
Begin op het gemiddelde niveau, de vastgelegde standaardinstelling voor beide modellen. Verlaag het niveau voor eenvoudige transformaties en verhoog het alleen wanneer de moeilijkheidsgraad van de taak of de foutkosten dit vereisen. De efficiënte instelling is de instelling die met de minste inspanning consequent voldoet aan je acceptatietests.
Kan ik GPT-6.1 Sol en GPT-6 Astra gebruiken op GlobalGPT?
GlobalGPT biedt in zijn multimodale werkruimte live routes voor zowel GPT-6.1 Sol als GPT-6 Astra. De beschikbaarheid kan per account en interface verschillen, dus open de werkruimte en controleer de huidige modelkiezer voordat je aan een productieworkflow begint.
Moet ik elke prompt naar één model sturen?
Meestal niet. Een eenvoudige router kan normale taken naar Sol sturen en gevallen met een lage betrouwbaarheid, mislukte tests of een hoog risico doorsturen naar Astra. Zo wordt het grootste deel van het kostenvoordeel van Sol benut, terwijl Astra wordt gereserveerd voor situaties waarin marginale capaciteit een meetbare meerwaarde biedt.
Eindoordeel
GPT-6.1 Sol zou het eerste model moeten zijn dat de meeste kostenbewuste teams in overweging nemen; GPT-6 Astra zou het doel moeten blijven voor de meest veeleisende taken. Dankzij hun gemeenschappelijke context, outputlimiet, modaliteiten, redeneermechanismen en toolcatalogus is de vergelijking buitengewoon overzichtelijk. Sol biedt het economische voordeel. Astra heeft het officiële voordeel op het gebied van capaciteiten.
De doorslaggevende maatstaf is niet alleen de prijs van het token of het prestige van het model. Meet de kosten per geaccepteerd resultaat onder reële operationele beperkingen en budgetten. Als Sol een vergelijkbaar slagingspercentage haalt, zijn de vijf keer lagere invoer- en uitvoersnelheden (zonder cache) moeilijk te negeren. Als Astra fouten voorkomt, de noodzaak van beoordeling door experts vermindert of taken oplost die Sol niet aankan, kan de meerprijs gerechtvaardigd zijn. Begin met identieke taken, houd de evaluatie waar mogelijk blind en promoot alleen het model en de redenering die hun plaats verdienen.









