
Claude Fable 5.2 versus Opus 5.5: programmeren, kosten en keuze
Vijf taken met dezelfde prompts vergelijken Claude Fable 5.2 en Opus 5.5 op onderzoek, AI-interfaceontwerp, schrijven, data en productplanning, met originele screenshots en geregistreerde tijd- en tokenverbruik.
 Chloe Murphy

Opus 5.5 is het verstandige startpunt voor routinewerk; test Fable 5.2 wanneer een specifieke taak nog verbetering behoeft. In onze vier voltooide teksttaakparen hebben beide modellen de kernberekening van het onderzoek en de datametrieken correct uitgevoerd. Fables productplan ging zorgvuldiger om met één onzekerheid; beide schrijfresultaten voldeden aan de belangrijkste beperkingen.
De ontwerpvergelijking maakt gebruik van een nieuwe, gematchte run van 32.768 tokens. De schermafbeeldingen, interactiecontroles en beperkingen staan in de ontwerptaak hieronder.
Fable 5.2 is nieuwer en kost meer per token. Maar levert het een beter resultaat op – of gewoon een hogere rekening? We vergeleken onderzoek, AI-interfaceontwerp, schrijven, data-analyse en productbeslissingen met dezelfde taakomschrijving voor elk model.
Als u modellen liever vergelijkt zonder afzonderlijke API-configuraties te beheren, biedt GlobalGPT een werkruimte voor meerdere modellen. De API-tests hier tonen niet aan dat Fable 5.2 beschikbaar is binnen GlobalGPT.
De praktische vergelijking
| Beslissing | Fable 5.2 | Opus 5.5 |
|---|---|---|
| Standaardinvoer / -uitvoer per miljoen tokens | $8 / $40 | $4 / $20 |
| Onderzoekstest | Correcte berekening; causale formulering moet worden bewerkt | Correcte berekening; niet-onderbouwd detail van onderzoeksopzet |
| Inhoudstest | Uitleg van 180 woorden; kortere voice-over | Uitleg van 180 woorden; vollediger voorbeeld |
| Datatest | Alle gevraagde statistieken correct | Alle gevraagde statistieken correct |
| Producttest | Zorgvuldig onderscheid tussen bevestigde en mogelijke schade | Nuttig plan; niet-onderbouwde bewering over verloren werk |
| Oorspronkelijke ontwerppoging | Geen artefact: HTTP-fout | Volledige HTML na opschonen van codeblokken |
Hoe we de twee modellen hebben getest
Elke taak gebruikte identiek bronmateriaal, een nieuw gesprek en dezelfde uitvoerlimiet voor beide modellen. De teksttaken gebruikten een limiet van 16.000 tokens; de uiteindelijke designrun gebruikte 32.768. Prompts, instellingen, tijd en gebruik verschijnen bij de bijbehorende taak hieronder.
Alle onderzoeken, producten, bestelgegevens en feedback in de briefings waren fictieve testfixtures. We hebben de berekeningen gecontroleerd aan de hand van een voorbereide antwoordsleutel. De redeneerinspanning bleef op de standaard van het platform, dus dit is geen benchmark met gelijke inspanning. De door de gateway van derden geretourneerde modellabels vormen geen onafhankelijk bewijs van upstream-routering.
Onderzoeker: synthese zonder overdrijving van het bewijs
Zelfde prompt · Onderzoekerstest
You are a researcher. Use only these FICTIONAL study summaries about an AI writing assistant. A: randomized 120 adults, 60 per arm, intervention mean score baseline70 followup78, control baseline69 followup74, four weeks; no standard deviations, uncertainty intervals, or attrition information reported. B: observational 300 adults, usage correlated with writing scores r=.32, no confounder adjustment. C: interviews with12 users reporting perceived improvement. In under650 words synthesize evidence with A/B/C citations, calculate difference in changes, explain what cannot be inferred, and propose a feasible preregistered followup study with primary endpoint and analysis. Do not invent citations or statistical significance.
De onderzoekstaak vroeg om een synthese van drie fictieve onderzoeken, waaronder een gerandomiseerde trial met onvolledige rapportage. De essentiële berekening was (78 − 70) − (74 − 69) = 3 punten. Beide modellen hadden het goed en weigerden statistische significantie te verzinnen.
Fable 5.2
Stelde een geblindeerde, niet-ondersteunde schrijfbeoordeling, een intention-to-treatanalyse en gevoeligheidscontroles voor ontbrekende gegevens voor. Het leverde ook een expliciet hypothetisch voorbeeld van de steekproefomvang.
“Alleen het verschil van 3 punten is toe te schrijven aan de assistent”
Die formulering was te zelfverzekerd gezien onbekende uitval en hiaten in de rapportage, ook al kwalificeerden latere alinea's de schatting. Het speculeerde ook dat de interviewdeelnemers waarschijnlijk zelfgeselecteerd waren.
Opus 5.5
Scheidde gerandomiseerd, observationeel en interviewbewijs duidelijk. Het stelde een baseline-gecorrigeerde proef voor en hield de steekproefomvangberekening afhankelijk van de pilotvariabiliteit.
“zoals beschreven cross-sectioneel van aard”
De geleverde observationele samenvatting specificeerde geen cross-sectioneel ontwerp. Dat detail had onbekend moeten blijven.
Als u deze briefing aanpast, houd dan het bewijsmateriaal vast en vraag elk model om gerapporteerde feiten van gevolgtrekkingen te scheiden. Onze Claude-prompts voor onderzoek en programmeren bieden meer voorbeelden van taakspecifieke beperkingen.
Designer: een AI-werkruimte voor meerdere modellen
Zelfde prompt · Designer-test
You are a product designer and frontend builder. Return only one complete self-contained HTML file with inline CSS and JavaScript, no external assets/CDNs. Build a polished AI multi-model workspace called Parallel. Give it a distinctive cohesive visual identity with excellent typography, whitespace, hierarchy and responsive layout; choose your own palette. Include sidebar, model A/B selectors, prompt textarea, compare button, two side-by-side result cards, loading state, clear button, per-result copy button, empty-input validation, keyboard-accessible controls and mobile stacking. Models A/B are FICTIONAL; all outputs must be locally simulated and explicitly labeled demo. No real API calls or fake live performance metrics. Compare must work repeatedly and preserve the submitted prompt in both outputs. Copy must report success only after actual success, otherwise provide an error. Aim for a complete compact artifact, not an explanation.
De designer-briefing vroeg beide modellen om Parallel: een op zichzelf staande AI-vergelijkingswerkruimte met een zijbalk, modelselectors, promptinvoer, gesimuleerde resultaatkaarten, validatie, kopieerknoppen en een mobiele lay-out. We hebben het kleurenpalet en de visuele identiteit opengelaten.
De uiteindelijke gematchte run gebruikte dezelfde prompt, streamingtransport en een gedeelde limiet van 32.768 tokens. Beide antwoorden bereikten een normale stop. De bronartefacten blijven onbewerkt; bij het opslaan van HTML wordt alleen een omsluitende Markdown-omheining verwijderd indien aanwezig.
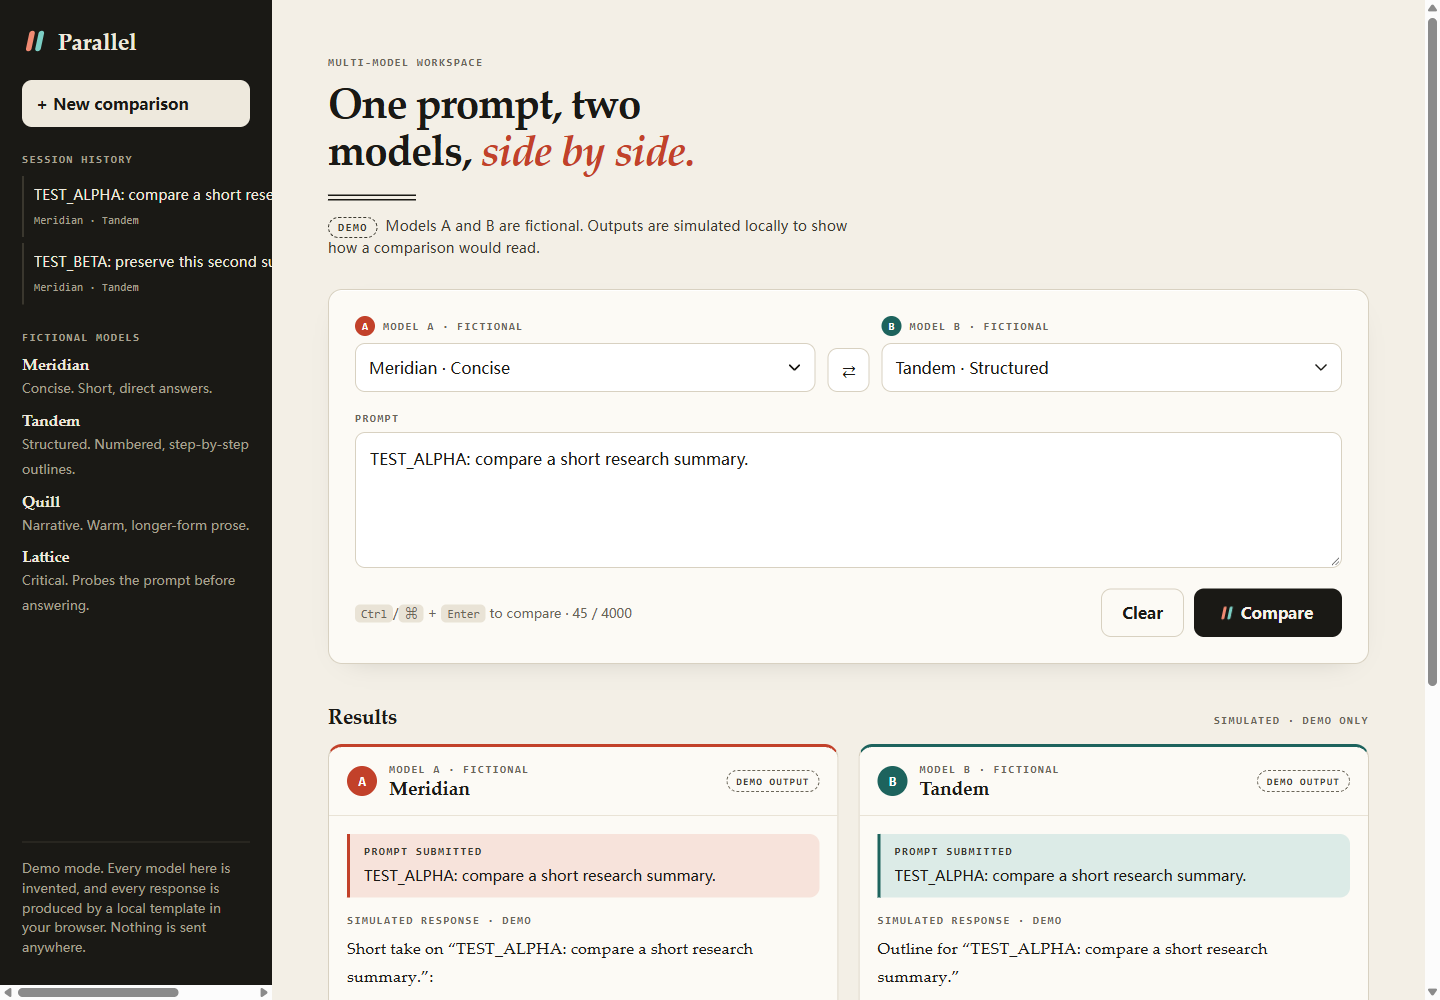
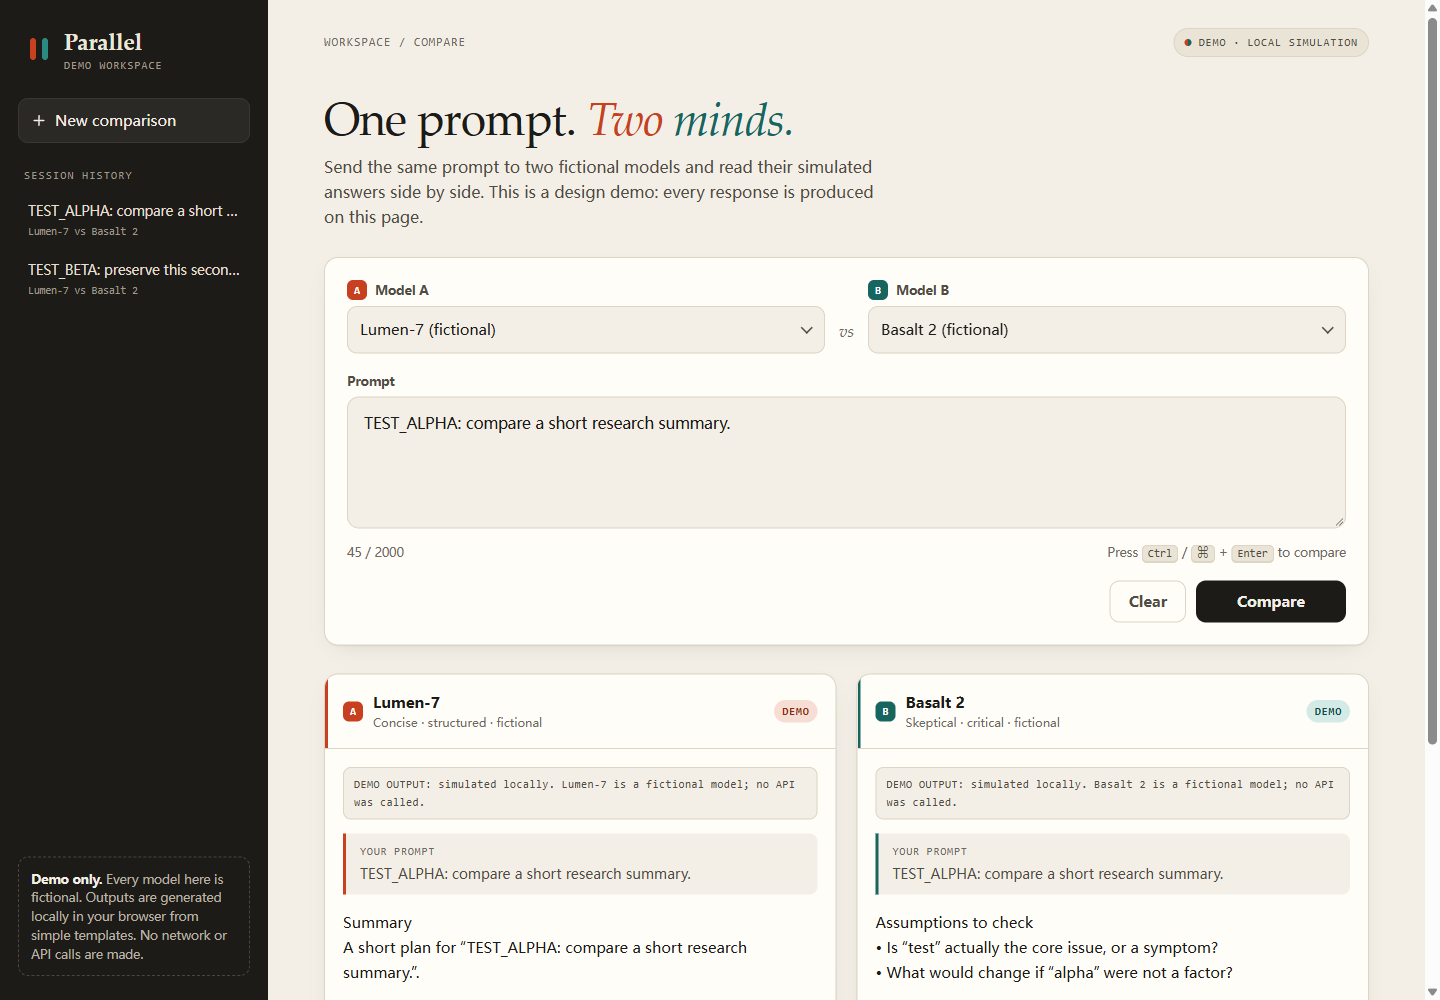
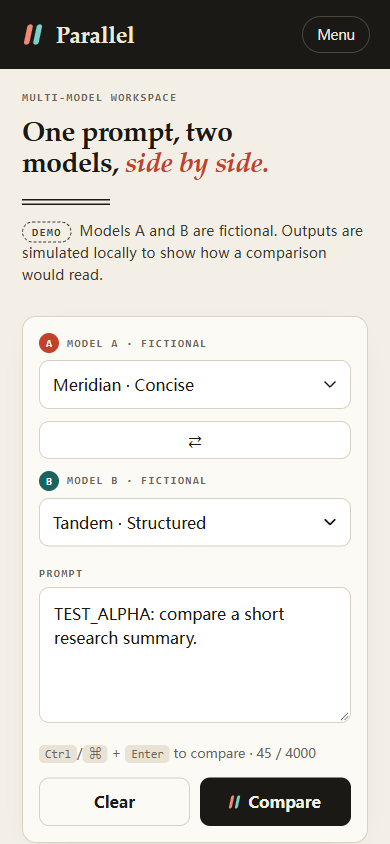
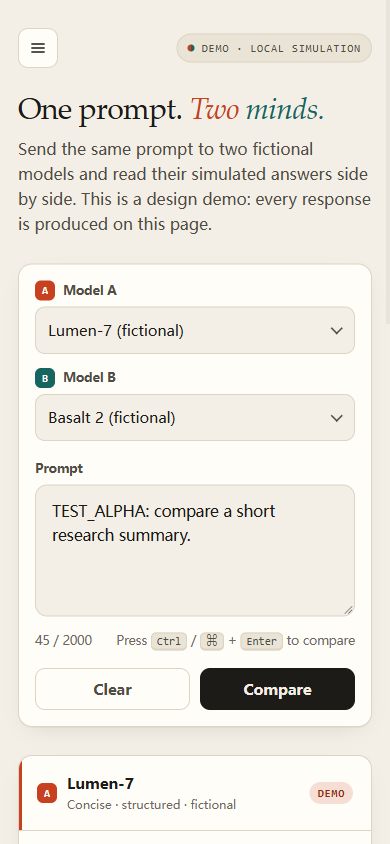
Hoe de weergegeven pagina's er werkelijk uitzagen
Fable 5.2 voorbeeld
Een zwaardere schreefloze kop, cursieve rode nadruk en een zijbalk met hoog contrast geven deze pagina een sterkere redactionele identiteit. De modelwisselknop is een nuttige extra, maar neemt op mobiel een hele rij in beslag en duwt de prompt en resultaten verder naar beneden.
Opus 5.5 voorbeeld
De lichtere kop en het eenvoudigere modelselectiegebied voelen ingetogener aan. Bij dezelfde mobiele viewport eindigt de knop Vergelijken ongeveer 710 pixels vanaf de bovenkant, versus 826 pixels in het Fable-voorbeeld, waardoor er ruimte overblijft voor de eerste resultaatkaart om eerder te verschijnen.
Beide kozen voor warme papiertinten, donkere zijbalken en schreefloze koppen. Het verschil zit hier in hiërarchie en dichtheid, niet in een totaal andere ontwerptaal.Voor deze specifieke werkruimte geven we de voorkeur aan de compacte lay-out van het Opus-voorbeeld.Als de prioriteit een prominentere redactionele kop is, heeft het Fable-voorbeeld die aantrekkingskracht. Dit is een subjectieve voorkeur tussen deze geretourneerde artefacten, geen algemene esthetische rangschikking van de onderliggende modellen.
Browsercontroles: uiterlijk en gedrag afzonderlijk
| Controleren | Fable-voorbeeld | Opus-voorbeeld |
|---|---|---|
| Validatie bij lege invoer | Geslaagd | Geslaagd |
| Herhaalde vergelijkingen behouden de ingediende prompt | Geslaagd | Geslaagd |
| Zichtbare laadfeedback | Geslaagd | Geslaagd |
| Invoer wissen | Geslaagd | Geslaagd |
| Pagina-overloop bij 390 pixels breedte | Geen gemeten | Geen gemeten |
| Kopieerfout meldt een fout eerlijk | Geslaagd | Geslaagd |
| Succesvol kopiëren naar klembord | Niet geverifieerd | Niet geverifieerd |
We openden de onbewerkte uitvoer in Chrome en gebruikten DOM-besturingselementen om de controles uit te voeren. Desktop-screenshots gebruiken 1440 × 1000; mobiele screenshots gebruiken 390 × 844. Alle vier tonen dezelfde ingediende prompt na de vergelijking en vóór de kopieercontrole. Tijdens deze stappen werden geen runtime-uitzonderingen vastgelegd. Schrijfacties naar het klembord slaagden niet in de geautomatiseerde sessie en een volledige alleen-toetsenbordnavigatie werd niet getest.
Het gebruik van het uiteindelijke ontwerppaar geeft een proxy tegen standaardtarief van $0.8826 voor Fable en $0.2918 voor Opus. Dit gebruikt provider-tarieven en door de gateway gerapporteerde tokens, sluit eerdere pogingen uit en is niet de werkelijke factuur van de gateway.
Eerdere pogingen en bewijslimieten
Contentmaker: nauwkeurige copy in twee formaten
Zelfde prompt · Contentmaker-test
You are a content creator. Based ONLY on these FICTIONAL product facts, write a180-word plain-English explainer and a45-second video script with timestamps, then a five-item fact-check checklist. Facts: Lumen is a fictional AI workspace; it lets users compare two AI text drafts side by side, save prompts locally in their browser, and manually copy a chosen result. It does not publish content automatically, browse the web, or verify facts. No prices, launch dates, speed metrics, supported model names, or privacy guarantees are provided. Audience: freelancers who struggle to choose a usable first draft. Explain a practical example, avoid hype and invented claims, and distinguish local prompt saving from an unproven no-training guarantee.
De opdrachtomschrijving voor de maker bevatte een fictieve werkruimte met slechts drie functies: vergelijking van concepten naast elkaar, lokaal opslaan van prompts en handmatig kopiëren. Er werd gevraagd om een uitleg van 180 woorden, een script van 45 seconden en een checklist voor feitencontrole met vijf items.
Beide uitleggen voldeden aan de eis van 180 woordenvolgens onze woordtelregel, die interne apostrofs en koppeltekens binnen een woord houdt. Beide behielden de functiebeperkingen en vermeden correct om lokale opslag te behandelen als een garantie voor geen training.
Fable 5.2
Begon met de moeilijkheid van de freelancer om een concept te kiezen en legde vervolgens de drie functies uit in korte zinnen. De voice-over van de video bevatte 101 woorden: ongeveer 135 woorden per minuut als deze in 45 seconden wordt uitgesproken.
Opus 5.5
Gebruikte een gedetailleerder copywriter-voorbeeld, waarin een sterkere opening werd afgezet tegen duidelijkere uitleg van functies. De voice-over bevatte 109 woorden: ongeveer 145 woorden per minuut over dezelfde tijdsduur.
Die tempocchattingen komen uit de geschreven voice-over, niet uit een getimede opname. Fable laat meer ruimte voor pauzes; Opus gebruikt meer van de tijd om het voorbeeld uit te leggen.
Voor langere artikelen vindt u in onze gids Claude gebruiken voor het schrijven van lange teksten leest u hoe u het opstellen scheidt van verificatie en redactie.
Data-analist: terugbetalingen, ontbrekende attributie en ROAS
Zelfde prompt · Data-analisttest
You are a data analyst. Use only this synthetic data. Orders CSV(order_id,updated,status,channel,amount): o1,1,paid,Search,100; o2,1,paid,Social,80; o2,2,refunded,Social,80; o3,1,paid,Search,120; o4,1,pending,Email,60; o5,1,paid,,50; o6,1,paid,Partner,90; o7,1,paid,Email,70; o8,1,paid,Social,60; o9,1,paid,Partner,110. Channel spend/clicks: Search200/100; Social100/80; Email50/40; Partner0/20. Deduplicate by order_id keeping greatest updated. Paid orders count and revenue use latest paid only; refunded/pending contribute zero. Blank channel must remain Unknown and cannot inherit spend/clicks. Calculate overall paid count, revenue, each channel paid count/revenue/conversion rate per click/ROAS, and measurable ROAS ranking; zero or missing denominator is N/A. Show arithmetic and propose a cautious next-budget decision without inferring causality. Return table and explanation under600 words.
De analistentaak was ontworpen om fouten te vangen die een nette tabel kan verbergen: dubbele order-ID's, een latere terugbetaling, een openstaande bestelling, een onbekend kanaal en een partnerkanaal zonder uitgaven.
Beide modellen kwamen overeen met de voorbereide antwoordsleutel: 7 betaalde bestellingen en 600 omzet na het behouden van de laatste orderstatus. Ze sloten de terugbetaalde en openstaande records uit, hielden ontbrekende toewijzing onder Onbekend en markeerden ongedefinieerde verhoudingen als N/B.
| Kanaal | Betaalde bestellingen | Omzet | Conversie / klik | ROAS |
|---|---|---|---|---|
| Zoeken | 2 | 220 | 2.00% | 1.10 |
| Sociaal | 1 | 60 | 1.25% | 0.60 |
| 1 | 70 | 2.50% | 1.40 | |
| Partner | 2 | 200 | 10.00% | N/B: geen uitgaven |
| Onbekend | 1 | 50 | N/B | N/B |
Fable toonde de omzetberekening in de kanaaltabel en stelde voor om vóór grote wijzigingen de terugbetalingen, openstaande bestellingen, ontbrekende tags en niet-geregistreerde partnerkosten te controleren. Opus voegde een deduplicatietabel per record toe en berekende dat niet-toegewezen omzet 8,3% van het totaal bedroeg.
Beide adviseerden een test met een begrensd budget in plaats van de waargenomen ROAS als causaal bewijs te behandelen. De opmerking van Opus dat één extra verkoop via social de ROAS ruwweg zou verdubbelen, gaat uit van een vergelijkbaar orderbedrag; het was geen nieuw feit in de invoer.
Productmanager: schade vóór feature-stemmen
Zelfde prompt · Productmanager-test
You are a product manager for a FICTIONAL AI subscription workspace. Feedback: 2 users report duplicate charges after retrying checkout; billing logs confirm one duplicate captured charge. 30 users request dark mode. 8 report one model unavailable and no warning before using a prompt; outage reproduced. 1 requests account/data deletion; request pending for20 days, governing deadline unknown. 12 request reusable saved prompts. 4 want team seats; no revenue commitment. Two engineers available for one week; effort estimates unknown. Produce a one-week priority plan with rationale, explicit unknowns, scope boundaries, owner roles, acceptance criteria, instrumentation and rollback/containment steps. Do not fabricate legal deadlines, revenue, effort or certainty. Distinguish immediate containment from permanent fixes; do not rank purely by vote count. Under700 words.
De productbrief combineerde een bevestigde dubbele afschrijving met een verwijderingsverzoek dat te laat was voor de gebruiker, een gereproduceerde modelstoring en meer populaire functieverzoeken. De valkuil was om 30 dark-mode-stemmen prioriteit te geven boven aangetoonde schade.
Beide modellen plaatsten facturering, opvolging van verwijdering en indamming van storingen vóór het bouwen van functies. Geen van beide verzon een wettelijke deadline voor verwijdering. Beide wezen eigenaarsrollen toe, scheidden onmiddellijke indamming van permanente oplossingen en stelden acceptatietests en monitoring voor.
Fable 5.2
Specificeerde terugbetalingsafstemming, een oplossing ter voorkoming van herhaalde afschrijvingen en handmatige indamming van storingen. Het behandelde mogelijk quotumverlies expliciet als iets om te bevestigen en markeerde verwijdering als onomkeerbaar.
Opus 5.5
Er is een waarschuwing vóór het indienen, behoud van prompts en een expliciete regel tegen het stilletjes wisselen van modellen toegevoegd. De prioriteringstabel was snel te scannen.
Er werd echter gezegd dat gebruikers “stilletjes werk en prompts verliezen”. De geleverde feedback wees op een storing en een ontbrekende waarschuwing, niet op bewezen verlies van prompts.
Prijzen van Fable 5.2 versus Opus 5.5
Voor standaard API-verzoeken kost Fable 5.2 twee keer zoveel per token als Opus 5.5. Daarmee is Opus het goedkopere startpunt wanneer beide modellen bij vergelijkbaar tokenverbruik een acceptabel resultaat leveren.
Invoer / uitvoer
Invoer / uitvoer
Dit zijn de standaard invoer-/uitvoertarieven van Anthropic, gecontroleerd op 11 november 2026, uit deFable-specificatie.
De Opus-specificatie vermeldt het bijbehorende standaardtarief. Snelle modus, caching, batchkortingen, consumentenabonnementen en facturering door derden hebben verschillende voorwaarden.
Voor een illustratief verzoek met 10.000 invoertokens en 5.000 uitvoertokens is de rekenkunde tegen het standaardtarief $0,28 voor Fable en $0,14 voor Opus. Dit is een uitgewerkt voorbeeld, geen factuur uit onze tests.
Een hoger tokentarief betekent niet hogere kosten per succesvolle taak. Een korter antwoord, minder revisierondes of minder redeneren kan het totaal veranderen. Onze tests met één ronde kunnen geen besparingen op lange termijn aantonen.
Als u een van beide modellen in een app integreert, Claude API-installatiegids behandelt de installatievragen afzonderlijk van de token-tariefvergelijking hier.
Het vermenigvuldigen van het door de gateway gerapporteerde gebruik met de standaardtarieven van Anthropic geeft een op tarieven gebaseerde proxy van $0,4291 voor Fable versus $0,1799 voor Opus over die vier taken. De formule is invoertokens × invoertarief + uitvoertokens × uitvoertarief, gedeeld door één miljoen. Dit sluit alle ontwerpverzoeken en mislukte oproepen uit.op tarief gebaseerde proxy van $0,4291 voor Fable versus $0,1799 voor Opus over die vier taken. De formule is invoertokens × invoertarief + uitvoertokens × uitvoertarief, gedeeld door één miljoen. Dit sluit alle ontwerpverzoeken en mislukte aanroepen uit.
Deze proxy is niet de werkelijke kosten van de gateway. We hebben de factuur, de equivalentie van de tokenboekhouding of de opslag niet geverifieerd. Het meet ook niet de kosten van latere menselijke bewerking of extra pogingen.
Wat de officiële benchmarks vaststellen
De lanceringsevaluatie van Anthropic geeft Fable een voorsprong op verschillende moeilijke taken. De onderstaande tabel geeft drie gerapporteerde scores weer; dit zijn evaluaties van de aanbieder, los van onze eigen rolgebaseerde tests.
| Evaluatie | Fable 5.2 | Opus 5.5 |
|---|---|---|
| FrontierCode 2.0 | 49.1% | 45.5% |
| FrontierSWE v2 | 69.9% | 62.3% |
| Terminal-Bench-Science 0.1 | 74.6% | 58.7% |
Het lanceringsrapport gebruikt de hoogst beschikbare inspanning van elk model, tenzij anders vermeld. Deze scores ondersteunen het uitproberen van Fable voor veeleisend technisch werk; ze vestigen geen universeel voordeel op het gebied van schrijven, productbeoordeling of visuele smaak.
Beide modellen vermelden een contextvenster van één miljoen tokens en een uitvoerlimiet van 128.000 tokens. Deze limieten zijn hier niet aan een stresstest onderworpen.
Veelgestelde vragen
Is Fable 5.2 beter dan Opus 5.5 voor coderen?
Anthropic rapporteert hogere Fable-scores op verschillende moeilijke codeerevaluaties. Onze codeeroefening is een AI-werkruimte met één bestand, geen repository-benchmark, dus er kan geen algemene codeerwinnaar worden vastgesteld.
Kost Fable 5.2 meer?
De standaard API-invoer- en uitvoertarieven zijn twee keer zo hoog als die van Opus 5.5: $8/$40 versus $4/$20 per miljoen tokens. De werkelijke taakkosten hangen ook af van gebruik, redeneren, nieuwe pogingen, caching en de service die u factureert.
Zijn deze tests binnen GlobalGPT uitgevoerd?
Nee. Ze gebruikten de genoemde modellen via een API-gateway van een derde partij. Ze stellen geen modelbeschikbaarheid, facturering of native functies vast in GlobalGPT of de eigen apps van Claude.
Kan een van beide modellen worden vertrouwd om onderzoek samen te vatten zonder te controleren?
Beide onderzoeksantwoorden berekenden het hoofdresultaat correct, maar elk introduceerde ten minste één gevolgtrekking die bewerkt moest worden. Controleer elk detail van de onderzoeksopzet en scheid schattingen van significantieclaims.
Bewijst een mooier ogende gegenereerde pagina betere codeervaardigheid?
Nee. Visueel ontwerp, werkende interacties, toegankelijkheid en onderhoudbaarheid zijn afzonderlijke dimensies. Een enkele aantrekkelijke pagina kan geen betrouwbaarheid van codering op repositoryniveau vaststellen.
Kregen de modellen gelijke redeneerinspanning?
We gebruikten identieke invoer en uitvoerlimieten, met redeneerinstellingen op de standaardwaarde van het platform. De mapping van de gateway werd niet onafhankelijk geverifieerd, dus dit is geen benchmark met gelijke inspanning.
Moet ik al mijn werk overschakelen naar Fable 5.2?
Gebruik eerst een taakspecifieke acceptatietest. Begin met het goedkopere model dat eraan voldoet, en schakel vervolgens over naar Fable wanneer u een waardevolle verbetering kunt vaststellen.
Eindoordeel: Welk model moet u gebruiken?
Begin met Opus 5.5 wanneer een acceptabele eerste versie het doel is. Het lagere standaardtoken tarief maakt het de praktische basis voor routinematig schrijven, gegevensopschoning en planning. Voor meer context, zie onze Claude Opus 5.5 review.
Probeer Fable 5.2 wanneer een specifieke moeilijke taak nog steeds niet aan uw acceptatiecriteria voldoet. Houd dezelfde invoer aan en controleer of het daadwerkelijke probleem wordt opgelost. De richtlijnen voor modelselectie raadt eveneens aan om met de nieuwste Opus te beginnen en op te schalen wanneer Opus met hogere inspanning tekortschiet.
Als geen van beide premiummodellen nodig is, Sonnet 5.5 vs Opus 5.5 is de relevantere kostenvergelijking.
Voor een breder scala aan aanbieders, zie onze AI-tekstgeneratortests.
Voor repositorywerk is de demo met één bestand in deze review slechts een startpunt. Het test geen shell-toegang, bewerking van meerdere bestanden, langdurig toolgebruik of het herstelgedrag van een coderingsagent. Zie voor configuratiedetails onze gids een model kiezen in Claude Code voordat u een chatvoltooiing als vervanging voor een volledige ontwikkelomgeving beschouwt.



