DeepSeek V4.1 Flash is de release van DeepSeek van 10 september 2026, met onder meer native beeldinvoer, een kleinere cache-voetafdruk, betere scores van agenten volgens leveranciers en lagere API-tarieven. Het is vooral geschikt voor ontwikkelaars die agents met een hoog verwerkingsvolume of veel invoer draaien. Het belangrijkste voorbehoud: DeepSeek heeft de gepubliceerde benchmarks uitgevoerd, en V4 Pro loopt nog steeds voorop bij geselecteerde tests op het gebied van grensverleggende redeneringen.

Wat is DeepSeek V4.1 Flash?
DeepSeek V4.1 Flash is een multimodaal model met open gewichten, ontwikkeld voor codering, het gebruik van gereedschap, visueel begrip en agentworkflows met een lange context. DeepSeek heeft het model op 10 september 2026 uitgebracht en publiceert de gewichten als DeepSeek-V4.1-Flash, en stelt het gehoste model beschikbaar via de deepseek-flash API-naam.
Deze release is belangrijk omdat er meer verandert dan alleen de benchmarkscores. Flash ondersteunt nu tekst en afbeeldingen, biedt een contextvenster van één miljoen tokens en vermindert het benodigde geheugen voor de key-value-cache aanzienlijk. DeepSeek heeft bovendien de tarieven voor de gehoste API verlaagd ten opzichte van het uitlopende V4 Pro-tarief. Die combinatie pakt een praktisch knelpunt aan: het betaalbaar houden van langlopende agents wanneer prompts, repository-context, screenshots en toolgeschiedenis zich opstapelen.
deepseek-flashDe denkmodus is standaard ingeschakeld, hoewel er ook een modus zonder denkfunctie beschikbaar is. JSON-uitvoer en tool-aanroepen worden ondersteund. DeepSeek biedt bovendien compatibiliteit met de Responses API en de Anthropic API, wat de migratie-inspanningen vermindert voor applicaties die al rond deze interfaces zijn opgebouwd.
Wat is er nieuw in DeepSeek V4.1 Flash?
Een 552B MoE-backbone met asymmetrische rekenkracht
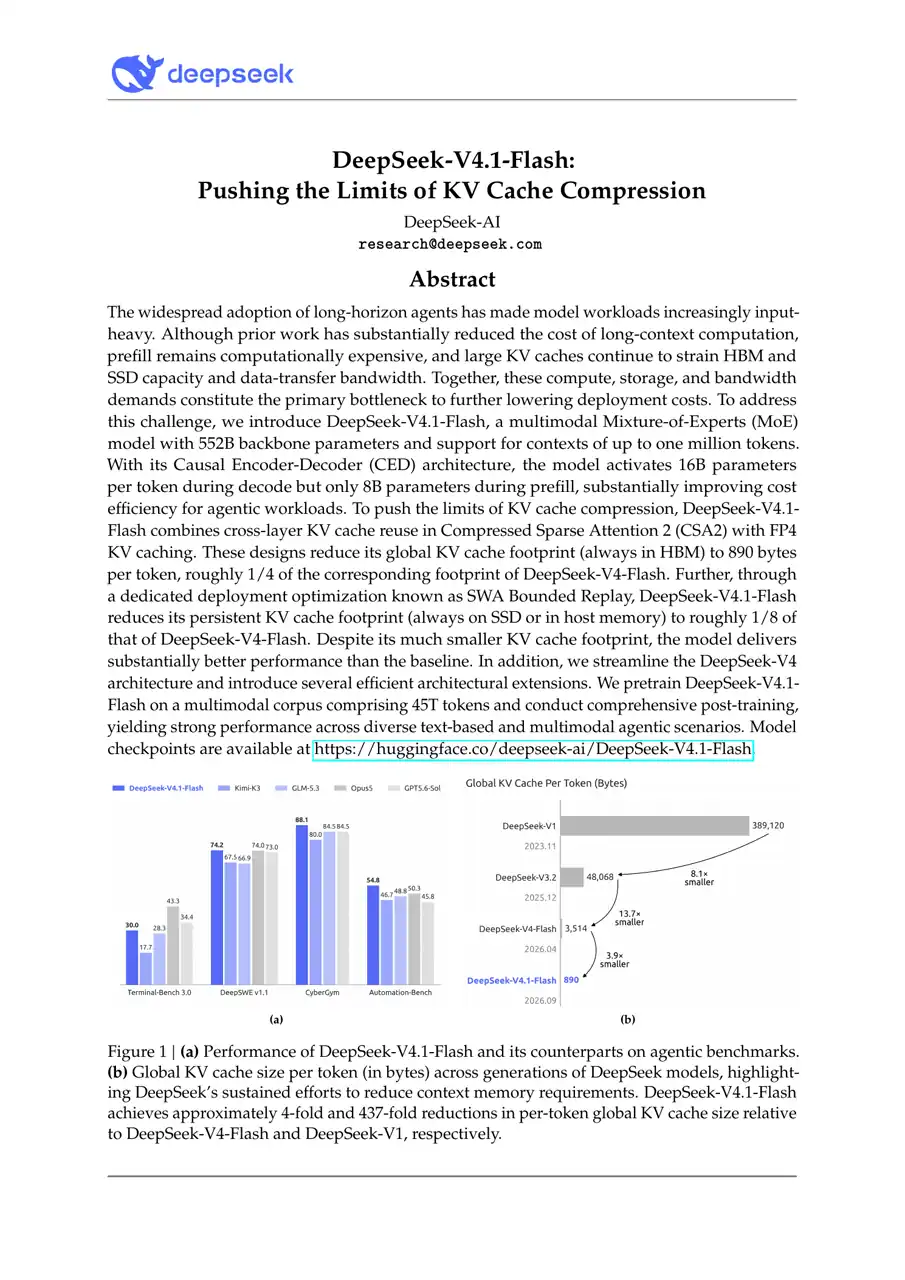
Volgens de Technisch rapport DeepSeek V4.1, het model maakt gebruik van een 'mixture-of-experts'-backbone met 552 miljard parameters, met een causale encoder van 20 lagen en een decoder van 20 lagen. Het totale aantal parameters is niet het aantal dat voor elk token wordt gebruikt: DeepSeek rapporteert ongeveer 8 miljard actieve parameters tijdens het voorvullen en 16 miljard tijdens het decoderen.
Door dat asymmetrische ontwerp krijgen de prefill-fase en de generatiefase verschillende rekenbudgetten toegewezen. De prefill-fase is de fase waarin de prompt, documenten, afbeeldingen en eerdere conversaties worden verwerkt; tijdens het decoderen wordt het antwoord token voor token gegenereerd. Het lagere actieve rekenverbruik tijdens de prefill-fase is met name relevant voor workloads op repository-schaal en voor onderzoeksagenten, waarbij veel rekenkracht wordt besteed aan het lezen voordat er wordt geschreven.
Een veel kleinere KV-cache
In het rapport wordt een wereldwijde KV-cachegrootte vermeld van 890 bytes per token, ongeveer een kwart van de cache van V4 Flash in geheugen met hoge bandbreedte. Volgens DeepSeek bedraagt de benodigde permanente cache ongeveer een achtste van die van de vorige generatie. Voor een context met een miljoen tokens is dit eerder een implementatiekenmerk dan een abstract architectuurdetail: de cachegrootte bepaalt hoeveel langdurige sessies een server kan ondersteunen en hoeveel geheugen elke sessie verbruikt.
Invoer van afbeeldingen in de oorspronkelijke indeling en multimodale voortraining
V4.1 Flash verwerkt afbeeldingen rechtstreeks, in plaats van via een apart eindpunt van het merk Vision. Volgens DeepSeek is het model vooraf getraind op een multimodaal corpus van 45 biljoen tokens. In de praktijk betekent dit dat schermafbeeldingen, grafieken, gescande tabellen, interfacestaten en visuele debugging-inputs deel uitmaken van hetzelfde agentgesprek als code en tekst.
Een context van 1 miljoen tokens kan grote opslagplaatsen, lange documentreeksen en uitgebreide agentgeschiedenis bevatten, mits de gecombineerde limiet voor invoer en uitvoer wordt nageleefd.
JPEG-, PNG-, GIF- en WebP-bestanden kunnen worden gecombineerd met tekst voor het extraheren van tabellen, het analyseren van schermafbeeldingen en het beantwoorden van visuele vragen.
Het aanroepen van tools, gestructureerde JSON-uitvoer en agentgerichte training maken het model geschikt voor workflows waarbij moet worden gecontroleerd, besloten en de status moet worden gewijzigd.
DeepSeek V4.1-benchmarks: wat de officiële resultaten laten zien
De sterkste prestaties van DeepSeek’s V4.1 Flash komen vooral tot uiting in benchmarks op het gebied van codering en agenten. De leverancier heeft het instructiemodel geëvalueerd met een experimentele inspanningsgraad van 100, die openbaar is gemaakt als de maximale redeneringsinspanning, met behulp van temperatuur=1,0 en top_p=0,95. Bij de tests met de code-agent werd gebruikgemaakt van benoemde testomgevingen en een context van één miljoen tokens; bij de tests met de visuele agent werd gebruikgemaakt van Claude Code met een context van 512K tokens.
| Benchmark | V4.1 Flash | V4 Pro | V4 Flash | Leider |
|---|---|---|---|---|
| Codeforces beoordeling | 3471 | 3348 | 3289 | V4.1 Flash |
| Terminal-Bench 2.1 Pass@1 | 90.6 | 87.9 | 82.7 | V4.1 Flash |
| DeepSWE v1.1 besloten | 74.2 | 62.7 | 54.4 | V4.1 Flash |
| CyberGym Pass@1 | 88.1 | 83.3 | 76.7 | V4.1 Flash |
| Automatiseringsbank Pass@1 | 54.8 | 43.2 | 37.7 | V4.1 Flash |
| GPQA Diamant Pass@1 | 90.9 | 92.4 | 89.9 | V4 Pro |
| HLE alleen tekst Pass@1 | 39.1 | 42.7 | 37.8 | V4 Pro |
Bron: Technisch rapport DeepSeek V4.1, tabel 3. Binnen elke rij geldt: hoe hoger, hoe beter. Codeforces is een rating; de overige weergegeven waarden zijn gebaseerd op de in het rapport genoemde meetwaarden in procenten. Vergelijk de grootteordes niet tussen de rijen onderling.

Het patroon is nuttig, maar minder algemeen dan de algemene bewering dat het om een “beter model” gaat. V4.1 Flash presteert beter dan V4 Pro op de vijf hierboven weergegeven rijen: coderen, terminals, beveiliging en automatisering. V4 Pro blijft voorop lopen op GPQA Diamond en de tekst-only-subset van Humanity’s Last Exam. Ontwikkelaars die een bredere shortlist van coderingsmodellen vergelijken, kunnen gebruikmaken van onze Gids voor het beste AI-model voor programmeren, maar een evaluatie op applicatieniveau is nog steeds belangrijker dan één tabel.
De mate van redeneringsinspanning beïnvloedt ook de kosten en het resultaat. In het rapport van DeepSeek leidde een verhoging van de experimentele inspanning van 25 naar 100 tot een stijging van DeepSWE v1.1 van 66,0 naar 74,2 en van Terminal-Bench 2.1 van 82,4 naar 90,6, terwijl er ongeveer 2,5 keer zoveel output-tokens werden verbruikt. De acht agentconfiguraties in het rapport leverden ook wezenlijk verschillende resultaten op vanuit hetzelfde checkpoint, dus de keuze van het framework maakt deel uit van het gemeten systeem.
DeepSeek stelt dat de robuustheid bij extreme invoer nog niet volledig in kaart is gebracht. In het rapport wordt opgemerkt dat selectiefouten bij CSA2 en de benaderende reconstructie van de ‘sliding-window-attention’-toestand de prestaties kunnen verminderen in grensgevallen die buiten de testsuite vallen. Ook wordt erkend dat er nog een achterstand bestaat bij de moeilijkste taken op het gebied van grensverkenning en randgevallen. Deze kanttekeningen moeten bij de hoofdscores worden vermeld.
Twee reproduceerbare opdrachten voor het evalueren van V4.1 Flash
De volgende opdrachten testen concreet gedrag zonder een niet-uitgevoerde prompt als bewijs te presenteren. Gebruik de exacte prompt, noteer de instellingen voor het model en de inspanningsgraad in je verslag, en beoordeel het antwoord aan de hand van de vermelde criteria. De resultaten van één run moeten worden gerapporteerd als een gedateerde waarneming, niet als een algemene benchmark.
DeepSeek V4.1 Flash-prijzen
De prijsstelling van de DeepSeek API is gebaseerd op twee tariefschema’s, en alle onderstaande bedragen zijn uitgedrukt in Amerikaanse dollars per miljoen tokens. De piekperiodes zijn 01:00-04:00 UTC en 06:00-10:00 UTC, van maandag tot en met vrijdag. Alle andere momenten vallen buiten de piekuren. Voor in de cache opgeslagen invoer, niet in de cache opgeslagen invoer en uitvoer gelden verschillende tarieven.
De laagste tarieven voor gehoste API’s
- In cache opgeslagen invoer
- $0.003
- Niet-gecacheerde invoer
- $0.15
- Uitgang
- $0.60
Per 1 miljoen tokens; buiten de piekuren op weekdagen.
Het dubbele van het tarief buiten de spits
- In cache opgeslagen invoer
- $0.006
- Niet-gecacheerde invoer
- $0.30
- Uitgang
- $1.20
Per 1 miljoen tokens; 01:00-04:00 en 06:00-10:00 UTC, op weekdagen.
Om een eenvoudig rekenvoorbeeld te geven: een verzoek buiten de piekuren met 800.000 niet-gecachete invoertokens en 20.000 uitvoertokens zou ongeveer $0.132: $0,12 voor invoer plus $0,012 voor uitvoer. Hetzelfde aantal tellingen bij piektarieven zou ongeveer $0.264 kosten. Deze berekening is ter illustratie en geen daadwerkelijk gemeten factuur voor de werklast; cache-hits, herpogingen, tool-omwentelingen en de lengte van de redenering beïnvloeden het totaal.
In beide tariefschema’s is ingevoerde data uit de cache vijftig keer goedkoper dan ingevoerde data zonder cache, waardoor stabiele promptprefixen en herbruikbare context economisch gezien van groot belang zijn. Het openbare DeepSeek API-tarief staat los van de toegang tot en facturering van GlobalGPT. Beschouw deze tokenprijzen niet als abonnements- of kredietprijzen voor GlobalGPT.
DeepSeek V4.1: API, visie en beperkingen
De directe DeepSeek-API maakt gebruik van deepseek-flash. Ontwikkelaars kunnen het standaard-eindpunt aanroepen op https://api.deepseek.com, de Responses API op dezelfde basis, of de Anthropic-compatibele basis op https://api.deepseek.com/anthropic. Functiegereedschappen worden ondersteund in Responses. DeepSeek beschrijft ook de patch toepassen aangepast hulpprogramma; andere ingebouwde hulpprogrammatypen worden genegeerd in plaats van uitgevoerd.
deepseek-flashDe standaardinstelling is 'denken'; er zijn voorinstellingen beschikbaar voor 'laag', 'hoog' en 'maximaal' inspanningsniveau.
Kies de compatibiliteitslaag die bij de bestaande toepassing past.
Zorg ervoor dat de totale invoer en uitvoer binnen het contextvenster van 1 miljoen tokens blijven.
Beeldformaten en plaatsingsregels
DeepSeek ondersteunt afbeeldingen in de formaten JPEG, PNG, GIF en WebP. Een inline afbeelding mag maximaal 32 MiB groot zijn, terwijl een afbeelding in een bestand maximaal 64 MiB mag zijn. De gedocumenteerde gedeelde limiet staat maximaal 600 afbeeldingen per verzoek toe. Dat maximum is geen aanbeveling: grote batches vergroten de promptgrootte, de latentie en de moeilijkheid om na te gaan welke afbeelding bij een antwoord hoorde.
Bij de Responses API hoort afbeeldingsinhoud thuis in gebruikersberichten. Afbeeldingen die zijn geplaatst in systeem of assistent berichten retourneren een HTTP 400-foutcode. De compatibiliteitslaag accepteert geen algemene bestandsinvoer als invoeritems, dus moeten applicaties de gedocumenteerde ‘image-input’-formaten volgen in plaats van ervan uit te gaan dat er volledige functionaliteitsovereenstemming is met OpenAI-responsen.
Context-, uitvoer- en gelijktijdigheidslimieten
De maximale contextomvang bedraagt één miljoen tokens en de maximale uitvoer is 384.000 tokens. De invoer en uitvoer moeten samen binnen het contextvenster passen. Flash staat 2.500 gelijktijdige verbindingen per account toe; verzoeken die deze accountlimiet overschrijden, krijgen een HTTP 429-foutmelding. Bij capaciteitsplanning moet daarom rekening worden gehouden met het aantal actieve verbindingen en het herhalingsgedrag.
DeepSeek V4.1 Flash versus V4 Pro
V4.1 Flash is de praktischer standaardkeuze voor coderingsagenten die grote hoeveelheden verwerken, visuele invoer en toepassingen met een lange context. V4 Pro blijft relevant als referentiepunt voor redeneringen tijdens de korte overgangsperiode, maar biedt geen ondersteuning voor beeldverwerking en heeft een lagere gedocumenteerde gelijktijdigheidscapaciteit. Onze eerdere Recensie van de DeepSeek V4 Pro behandelt dat controlepunt op zijn eigen voorwaarden; de praktische resultaten ervan mogen niet worden geherclassificeerd als bewijs voor V4.1.
| Beslissende factor | V4.1 Flash | V4 Pro vóór de wijziging in de routering |
|---|---|---|
| Beste pasvorm | Agenten, codering, lange invoer, beeldverwerking | Een selectie van redeneeropgaven op grensgebied |
| Afbeelding invoeren | Ondersteund | Niet ondersteund |
| Gelijktijdigheid/account | 2.500 verbindingen | 500 verbindingen |
| Invoer buiten piekuren die niet in de cache is opgeslagen | $0,15 / 1M | $0,66 / 1M |
| Productie buiten de piekuren | $0,60 / 1M | $1,98 / 1M |
| Officieel scorepatroon | Weergegeven leads per makelaar/coderingrij | Leads GPQA Diamond en HLE (alleen tekst) |
De prijzen zijn gebaseerd op de DeepSeek API-tarieven, niet op de GlobalGPT-prijzen. Vóór de aangekondigde routewijziging van 14 september gelden de Pro-tarieven.
Bij daluren-tarieven is de niet-gecacheerde invoer van Flash ongeveer 77% goedkoper dan het vermelde Pro-tarief, en is de Flash-uitvoer ongeveer 70% goedkoper. Deze percentages zijn rekenkundige berekeningen op basis van het officiële tarief, geen gemeten besparingen. De daadwerkelijke besparingen zijn afhankelijk van het hergebruik van de cache, de lengte van de uitvoer, het aantal herhalingspogingen en of de workload de betere resultaten van Pro nodig heeft voor de geselecteerde redeneringsrijen.
Het belangrijkste onderscheid is van operationele aard. DeepSeek houdt de deepseek-v4-pro naam, terwijl het onderliggende model tijdelijk wordt aangepast. Een stabiele API-naam biedt geen garantie voor stabiel uitvoergedrag. Bewaar representatieve V4 Pro-antwoorden, tooltraces, latentie en foutgevallen van vóór 14 september, en voer vervolgens dezelfde acceptatietests uit na de routeringswijzigingen. Zie voor het oudere framework voor het vergelijken van checkpoints DeepSeek V4 Pro versus Flash.
Wat ontwikkelaars zeggen
De eerste reacties zijn positief wat betreft doorvoersnelheid, cache-efficiëntie en agent-scores, maar de bevindingen zijn wisselend. Sommige opmerkingen hebben betrekking op een preview-eindpunt in plaats van het definitieve productiecontrolepunt, en sommige rapporten geven een samenvatting van demonstraties in plaats van gecontroleerde tests. De meest nuttige openbare discussie gaat daarom over de vraag waar er getest moet worden, en niet of één cijfer op de lanceringsdag de beslissing definitief bepaalt.
In de lanceringsanalyse wordt aanbevolen om de V4 Pro-basisversie te behouden en het vrijgegeven Flash-model te testen vóór de routeringswijziging op 14 september. Ook wordt benadrukt dat de prestatiewinst varieert per benchmark, framework en instelling van de rekenintensiteit.
Lees de analyseIn een samenvatting van de demonstraties tijdens de World of AI-preview benadrukte het tijdschrift een waargenomen pieksnelheid van 427 tokens per seconde en wees het op overdenken en een minder goed presterende fysicasimulatie. Dit is geen officiële snelheidsgarantie.
Lees het artikel met een vooruitblikIn de lanceringsdiscussie had de commentator bezwaar tegen het stilletjes omleiden van gevalideerde Pro-workflows naar een ander model en pleitte hij voor een vastgestelde overgangsperiode. Dit is één specifieke mening uit de community, geen consensus.
Open de opmerkingDe AI Pentest Lead van Aikido meldde verbeteringen op het gebied van recall bij één doorloop, pass@3 recall, precisie en cache-hitpercentage in een cyberbeveiligingsbenchmark. In zijn bericht wordt een preview-eindpunt genoemd waarvan de geldigheidsduur afloopt, dus dit geldt niet als bewijs voor het definitieve controlepunt.
Bekijk het voorbeeldrapportDeze reacties wijzen op drie controles die bij elke daadwerkelijke implementatie de moeite waard zijn: vergelijk de uitvoerkwaliteit bij een vaste inspanningsinstelling, let erop of langdurige redeneringen de uitvoerkosten opdrijven, en voer regressietests opnieuw uit wanneer een alias het model achter een eindpunt wijzigt. Voorlopige resultaten op het gebied van doorvoer en beveiliging kunnen als leidraad dienen bij het ontwerpen van tests, maar ze mogen niet worden gecombineerd met tabel 3 van DeepSeek alsof ze afkomstig zijn uit één gecontroleerde benchmark.
Toegang krijgen tot de DeepSeek V4.1-flash
Er zijn drie verschillende toegangsopties. Maak een keuze op basis van of u directe API-controle nodig hebt, zelfgehoste gewichten wilt gebruiken of een browserwerkruimte nodig hebt die het wisselen van modellen vergemakkelijkt. De voorwaarden, prijzen en operationele verantwoordelijkheid verschillen per optie.
DeepSeek API
Gebruik de officiële deepseek-flash model voor native, Responses of Anthropic-compatibele integraties.
Open gewichten
Download de modelkaart en de onder de MIT-licentie vrijgegeven gewichten. Controleer of de serving-stack wordt ondersteund en wat de infrastructuurvereisten zijn voordat je de wijzigingen vastlegt.
Open de modelrepositoryGlobalGPT
Gebruik de speciale V4.1 Flash-vermelding binnen een werkruimte voor meerdere modellen. De facturering voor GlobalGPT staat los van het API-tarief van DeepSeek.
Probeer DeepSeek V4.1 Flash eens uit
De directe API is de meest voor de hand liggende keuze wanneer je programmatische besturing, gebruiksregistratie en toegang tot de gedocumenteerde interfaces van DeepSeek nodig hebt. Open weights zijn bedoeld voor teams die de ondersteuning voor inferentie kunnen valideren en een zeer groot MoE-model kunnen beheren. GlobalGPT is de meest soepele manier voor interactief gebruik en vergelijkingen binnen een alles-in-één-workflow voor AI-modellen.
In het officiële aankondigingsbericht van DeepSeek staat dat het bedrijf samen met de open-sourcegemeenschap zal werken aan ondersteuning voor inferentie en meer implementatiemogelijkheden zal onderzoeken. Beschouw dit als een verklaring over de roadmap, niet als bewijs dat elke lokale serving-stack V4.1 Flash al efficiënt ondersteunt.
Voor wie is de DeepSeek V4.1-flash bedoeld?
Geef prioriteit aan V4.1 Flash wanneer terminalwerk, navigatie door de repository, automatisering, het gebruik van tools en lange invoeropdrachten de boventoon voeren. De officiële agent-scores en lagere invoersnelheden rechtvaardigen een werkbelastingsspecifieke proef.
Dankzij de mogelijkheid om afbeeldingen rechtstreeks in te voeren is Flash de betere keuze dan V4 Pro voor schermafbeeldingen, grafieken, tabellen en bewijsmateriaal uit de gebruikersinterface. Controleer de nauwkeurigheid van de extractie aan de hand van bekende antwoorden.
V4 Pro staat bovenaan in de weergegeven rijen met alleen tekst voor GPQA Diamond en HLE. Vergelijk de vaste prompts en inspanningsinstellingen voordat u een gevalideerde redeneringsworkflow vervangt.
De MIT-licentie is ruim, maar een 552B MoE-backbone is geen lichtgewicht lokaal model. Controleer de hardware, de cachestrategie, de kwantisering en de ondersteuning voor het aanbieden van modellen.
Voor een bredere modelkeuze is de Vergelijking tussen GPT-5.5 en DeepSeek V4 zet de context van één miljoen tokens en de prijspositie naast een andere grensoptie. Teams die zich richten op de stijl van de code-output kunnen ook de DeepSeek versus ChatGPT: test van Python-code. Die artikelen geven antwoord op aanverwante vragen; geen van beide vormt echter een vervanging voor het testen van het exacte V4.1 Flash-eindpunt dat in de productieomgeving wordt gebruikt.
Gewone gebruikers die tussen verschillende ecosystemen moeten kiezen, zullen wellicht merken dat de bredere Vergelijking tussen DeepSeek en ChatGPT nuttiger dan een evaluatie op architectuurniveau. V4.1 Flash komt het best tot zijn recht wanneer de specifieke voordelen ervan – lange invoer, beeldherkenning, tools en lage tokenkosten – aansluiten bij een daadwerkelijke workflow.
Uitspraak
De lagere API-tarieven, de context van 1 miljoen, de native afbeeldingsinvoer, de limiet van 2.500 verbindingen en de door DeepSeek gerapporteerde verbeteringen in de prestaties van de agent vormen sterke argumenten om het model te evalueren. Het is geen universele vervanging voor de Pro-versie: V4 Pro presteert nog steeds beter op bepaalde redeneergebieden, scores bij maximale inspanning gaan gepaard met een hoger gebruik van output-tokens, en wijzigingen in de routing van eindpunten kunnen het gevalideerde gedrag beïnvloeden.
DeepSeek V4.1-flashprogramma openen in GlobalGPTBegin met een kleine acceptatietestsuite: één representatieve codeertaak, één op afbeeldingen gebaseerde extractietaak, één geval met een lange context en één toolworkflow. Leg de redeneringsinstellingen vast, registreer de modelrouting en vergelijk zowel de faalmodi als de gemiddelde kwaliteit. Dat levert een besluit op dat je kunt verdedigen, zonder de benchmarks van leveranciers of reacties op de lanceringsdag te beschouwen als een garantie voor de prestaties van de applicatie.
Veelgestelde vragen
Wat is DeepSeek V4.1 Flash?
DeepSeek V4.1 Flash is een multimodaal ‘mixture-of-experts’-model met open gewichten dat op 10 september 2026 is uitgebracht. Het ondersteunt tekst- en afbeeldingsinvoer, tekstuitvoer, een contextvenster van één miljoen tokens, denk- en niet-denkmodi, JSON-uitvoer en tool-aanroepen.
Hoeveel kost de DeepSeek V4.1 Flash API?
De API-tarieven voor DeepSeek buiten de piekuren bedragen $0,003 per 1 miljoen in de cache opgeslagen invoertokens, $0,15 per 1 miljoen niet in de cache opgeslagen invoertokens en $0,60 per 1 miljoen uitvoertokens. De tarieven tijdens piekuren bedragen respectievelijk $0,006, $0,30 en $1,20. Dit zijn DeepSeek API-tarieven, geen GlobalGPT-tarieven.
Welke API-modelnaam moet ik gebruiken voor de DeepSeek V4.1 Flash?
Gebruik deepseek-flash met de officiële DeepSeek-API. DeepSeek ondersteunt ook Responses API-aanroepen op https://api.deepseek.com en Anthropic-compatibele oproepen op https://api.deepseek.com/anthropic.
Wat zijn de beperkingen met betrekking tot de context, de uitvoer en de gelijktijdigheid?
DeepSeek V4.1 Flash heeft een contextvenster van één miljoen tokens en een maximale uitvoer van 384.000 tokens; de invoer en uitvoer samen moeten binnen de context passen. DeepSeek ondersteunt 2.500 gelijktijdige verbindingen per account; bij overschrijding van deze limiet wordt een HTTP 429-statuscode geretourneerd.
Is de DeepSeek V4.1 Flash beter dan de V4 Pro?
Dat hangt af van de taak. In de door de leverancier opgestelde tabel van DeepSeek scoort V4.1 Flash beter dan V4 Pro op het gebied van weergave, codering, beveiliging en automatisering, terwijl V4 Pro beter presteert dan GPQA Diamond en HLE (alleen tekst). Flash is bovendien goedkoper, ondersteunt beeldverwerking en biedt ruimte voor meer gelijktijdige verbindingen.
Ondersteunt DeepSeek V4.1 Flash afbeeldingen?
Ja. Het ondersteunt JPEG-, PNG-, GIF- en WebP-bestanden als invoer en genereert tekst. DeepSeek verwerkt documenten tot 32 MiB voor inline afbeeldingen, 64 MiB voor afbeeldingen in bestanden en 600 afbeeldingen per verzoek binnen de gedeelde limieten. Afbeeldingen uit de API-responsen moeten in gebruikersberichten worden geplaatst.
Zijn de Flash-gewichten voor DeepSeek V4.1 beschikbaar om te downloaden?
Ja. DeepSeek publiceert de modelgewichten van DeepSeek-V4.1-Flash op Hugging Face onder de MIT-licentie. Deze soepele licentie neemt de vereiste infrastructuur niet weg: teams hebben nog steeds compatibele serving-software en voldoende hardware nodig voor de 552B MoE-backbone.
Kan ik de DeepSeek V4.1-flash gebruiken op de GlobalGPT?
Ja. GlobalGPT beschikt over een speciale DeepSeek V4.1 Flash-toegang voor gebruik via de browser. De toegang en facturering hiervoor staan los van het directe API-tarief van DeepSeek, en de beschikbaarheid op het platform vormt geen onafhankelijke verificatie van de door DeepSeek gepubliceerde benchmarkresultaten.