テストは2026年9月7日と11日に実施され、情報源の再確認は2026年9月16日に行われた。.
この名称について、一点説明が必要です。今でも「Grok 4」と検索する人はいますが、私たちがテストしたモデルは Grok 4.6, 、当初予定されていた2025年7月のリリースではなく。現在の xAIモデルカタログ コードには Grok 4.6 を推奨していますが、元の grok-4-0709 API名は廃止されました。本レビューでは、これらの製品と日付を区別して記載していきます。.
アシスタントを1人選ぶ前にいくつか比較検討する場合は、まずは大まかな点から コーディング比較に最適なAIモデル. 。ここで、より具体的な疑問は、Grokが、正確なコーディング要件を、実際に検証可能な成果物に変換できるかどうかという点である。.
手短な答え:Grok 4はコーディングに適していますか?
Grok 4.6 は、関数のデバッグ、初期実装の生成、不慣れなコードの説明、テストの草案作成には十分に役立つレベルです。しかし、実行せずにそのまま採用するには信頼性が不十分です。私たちの小さなテストスイートで見つかった見落としは、単なるスタイル上の意見の相違といった曖昧なものではありませんでした。あるリファクタリングによって、 net 空でないすべての結果のうち、生成されたテストスイートの1つが、遅延と絶対タイムスタンプを区別できなかった。.
実用上の基準は単純です。契約を厳格に設定し、1か所の変更を求め、独立した検証を行うことです。もっともらしいコードを素早く生成するモデルであっても、あるフィールドを削除したり、ある不変条件を弱めたり、あるいはコードの要件には従いながらも応答形式の要件を無視したりする可能性があります。.
あなたは GlobalGPTでGrok 4.6を試してみてください 制限付きプロンプトや並列比較については。GlobalGPTは独立したプラットフォームであり、Grok Build、IDE、リポジトリへのアクセス、xAIのネイティブAPIコンソール、あるいはCIパイプラインの代わりとなるものではありません。.
実際にテストした内容
4つの小規模なJavaScriptタスクについて評価を行いました。具体的には、区間結合の修正、優先順位に基づく座席割り当てのデバッグ、変更要約関数のリファクタリング、および 再試行間隔 パーサー。各タスクには、固定されたプロンプトと決定論的なローカル評価器が割り当てられていた。2026年9月11日に3つのタスクが実行された。間隔タスクについては、9月7日に実行されたものを再利用し、保存されていたプロンプト、生の応答、および評価器と照合して再確認を行った。.
- 会場: ユーザー認証済みのブロリー集計API、チャット補完機能。.
- 要求されたモデルおよび返却されたモデル:
grok-4.6. - 試行回数: 1つのタスクにつき1回のリクエストとし、再試行は行わない。.
- 実行: 返されたJavaScriptは分離され、あらかじめ定義されたフィクスチャやミュータントに対してローカルで実行されました。.
- モデルでは利用不可: IDE、リポジトリ、インターネット接続、xAIツールの実行環境、および本番システム。.
ゲートウェイラベルは出所の確認に役立ちますが、それだけでは上流でのデプロイメントを単独で証明するものではありません。経過時間にはネットワークおよびゲートウェイのオーバーヘッドが含まれており、報告されたトークン数はxAIの正式な課金根拠とはなりません。製品レベルでのより広範な概要については、別の Grok 4.6:レビューと実機テスト.
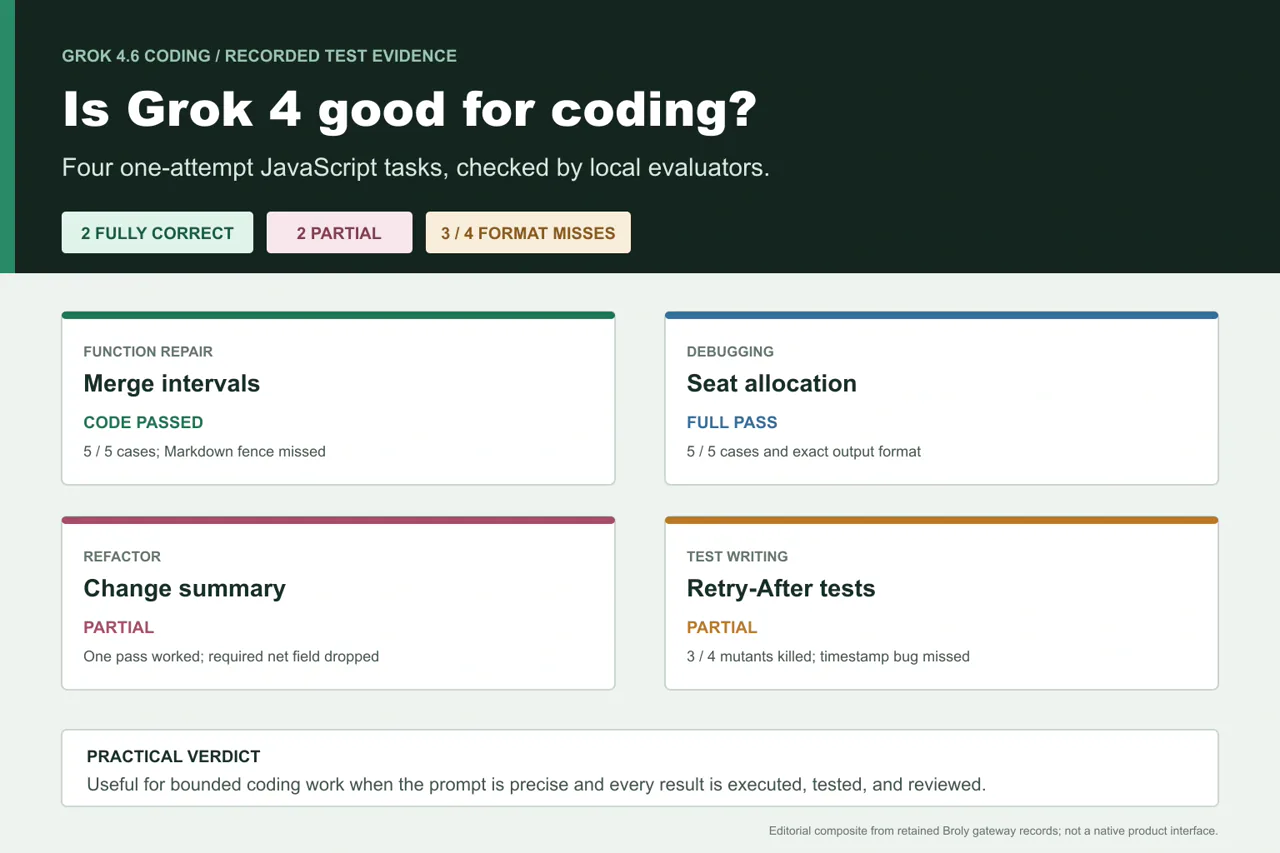
コーディングテストの結果概要
net.最良の結果は、最も長い解答ではありませんでした。それは「座席割り当ての修正」でした。簡潔で、書式も正しく、動作的にも完全だったからです。最も参考になった失敗例はリファクタリングでした。その実装はすっきりとしており、1パス要件も満たしていたものの、出力契約を黙って変更していたからです。.
テスト 1:マージ区間関数の修正
最初の関数は、入力値を変更してしまい、空の配列に対してクラッシュし、隣接する端点を結合できず、後続のネストされた区間が出現した際に、より大きな区間を縮小してしまうという問題がありました。プロンプトによって、これらの不変条件が明示されました。.
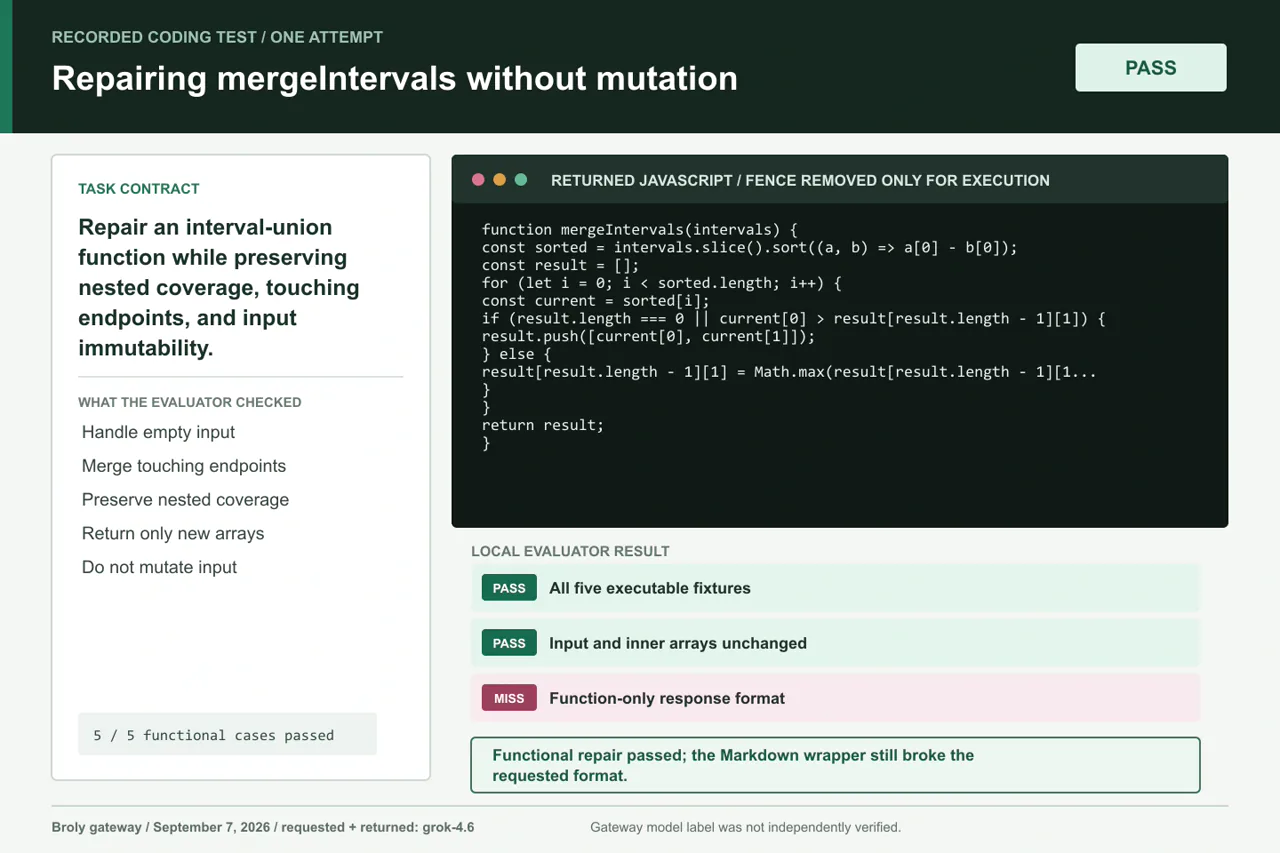
主要な境界: 実行のために外側のMarkdownフェンスのみを削除したところ、機能的な修復が成功しました。.
結果 5つの実行可能ケースすべてが成功した。この関数は新しい配列を返し、入力データを変更せず、ネストされたカバレッジを維持し、隣接するエンドポイントを統合した。ただし、コードをMarkdownでラップしたため、1つの明示的な命令については依然として失敗した。実行時のその外側のフェンスのみを削除したところ、機能的な結果は正しくなった。.
実践的な学び: Grokは、プロンプトが隠れたエッジケースを指定した際、コンパクトな修正をうまく処理しました。フォーマットの不一致は人間にとっては些細なことですが、直接実行可能なテキストを想定しているパイプラインでは動作しなくなる可能性があります。.
テスト 2:優先度に基づく座席割り当てのデバッグ
この課題では、安定したタイの処理、降順優先、不変性、正確な容量、および「スキップして継続」というルールが組み合わされていました。元のコードは、ソートの方向が間違っており、入力配列を変更してしまい、1つのリクエストが容量オーバーだった際に早すぎる段階で処理を停止してしまいました。.
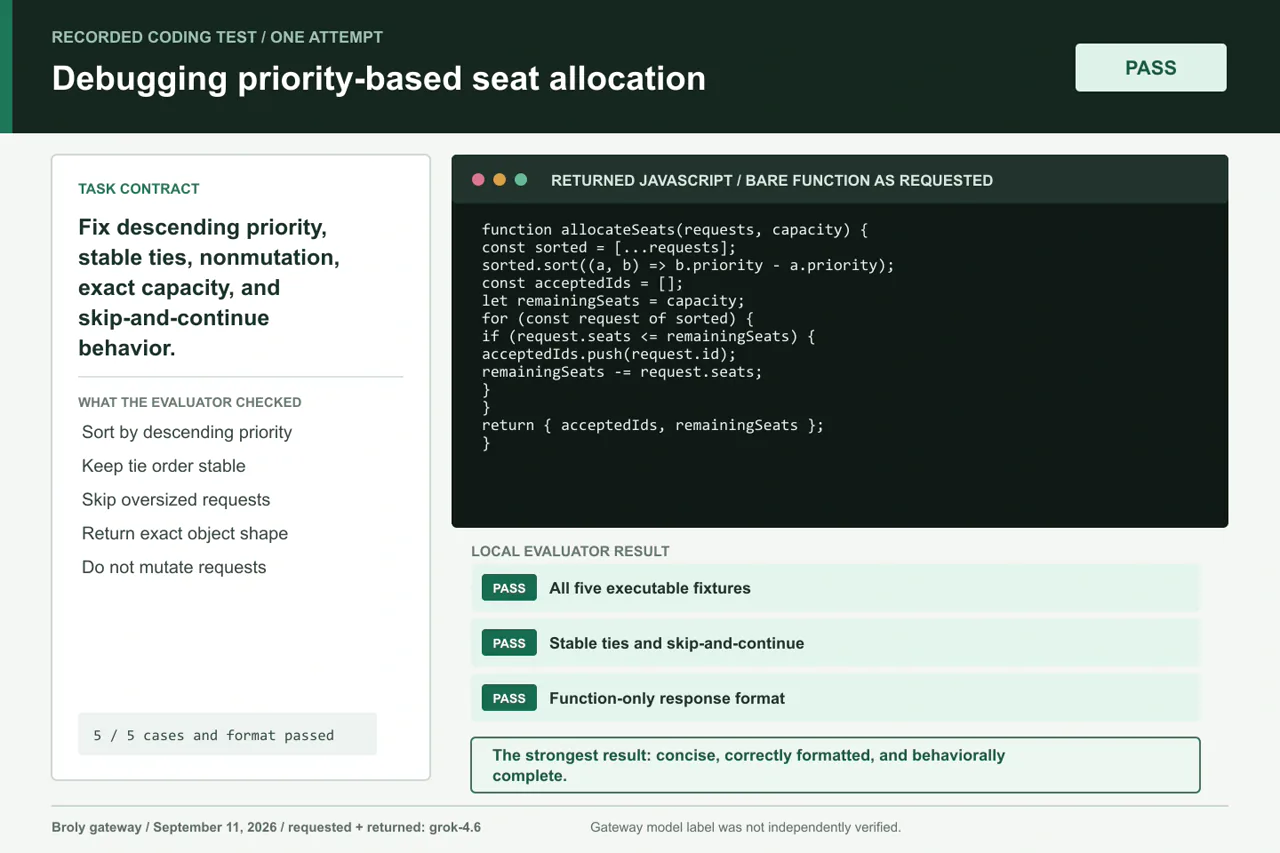
主要な境界: これは、行動契約と正確な出力形式の両方を満たした唯一の回答でした。.
結果 優先度が等しい順序、サイズ超過の先頭リクエスト、正確な容量、容量ゼロ、および空のリストを含む、5つのケースすべてが通過しました。入力は変更されず、, 承認済みID 新しい配列であり、モデルは要求された関数のみを返しました。.
実践的な学び: Grokが特に適している仕事とは、このようなものです。つまり、1つの機能、明確な契約内容、そして即座に実行可能な境界ケースがある仕事です。.
テスト 3:動作を損なわないリファクタリング
3つ目のプロンプトでは、Grokに対し、順序、特殊なファイル名、および出力形状を正確に維持しつつ、繰り返されるスキャンを1回の集約パスに置き換えるよう求めました。これは現実的なリファクタリングのリスクです。コードの速度や可読性が向上する一方で、挙動が失われる可能性があるからです。.
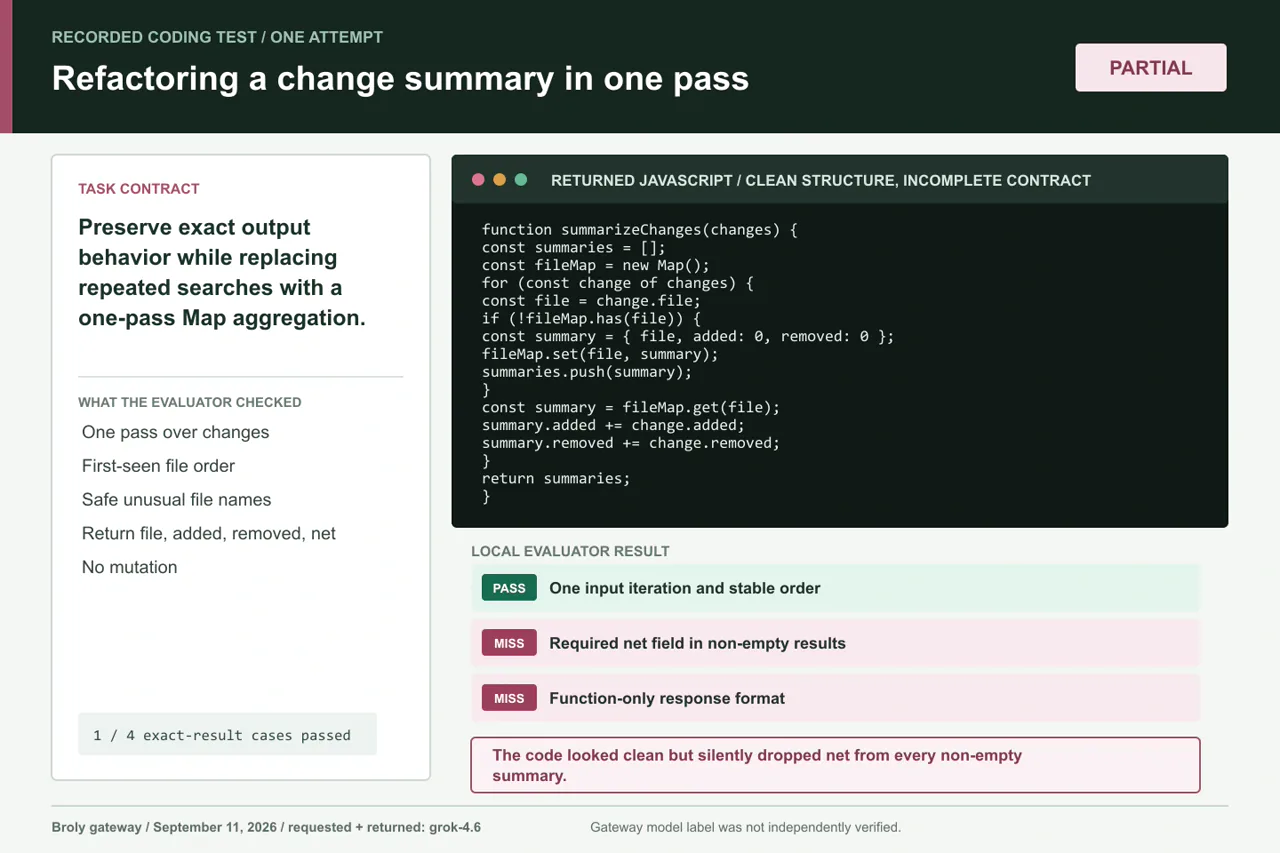
主要な境界: ワンパス・マップのアプローチは一見正しく見えたが、必要なネットフィールドを黙って省略していた。.
結果 この応答では1回のパスが使用され、a 地図, 初回出現順の修正、以下の安全な取り扱い __proto__ そして コンストラクタ, 、かつ入力の変異もなかった。しかし、計算も返値も行われなかった net. 結果オブジェクトが含まれていなかったため、空のケースは通過しました。一方、空ではない3つのケースはすべて、厳密比較で失敗しました。.
実践的な学び: リファクタリングを、アルゴリズムの複雑さやコードの整然さだけで判断してはいけません。新しいバージョンを採用する前に、旧バージョンの出力をスナップショットで記録し、必要なフィールドをすべてアサートし、動作を比較してください。.
テスト 4:起こりうるバグを検出するテストの作成
最後の課題では、通常の設定とは逆の手法が採用されました。Grokがテストを作成し、私たちのテストハネスが、1つの厳格な参照実装と、意図的に誤った4つの実装に対してそれらのテストを実行しました。目的は行カバレッジではありませんでした。選択された入力が、一見似たようなセマンティクスを区別できるかどうかを確認することでした。.
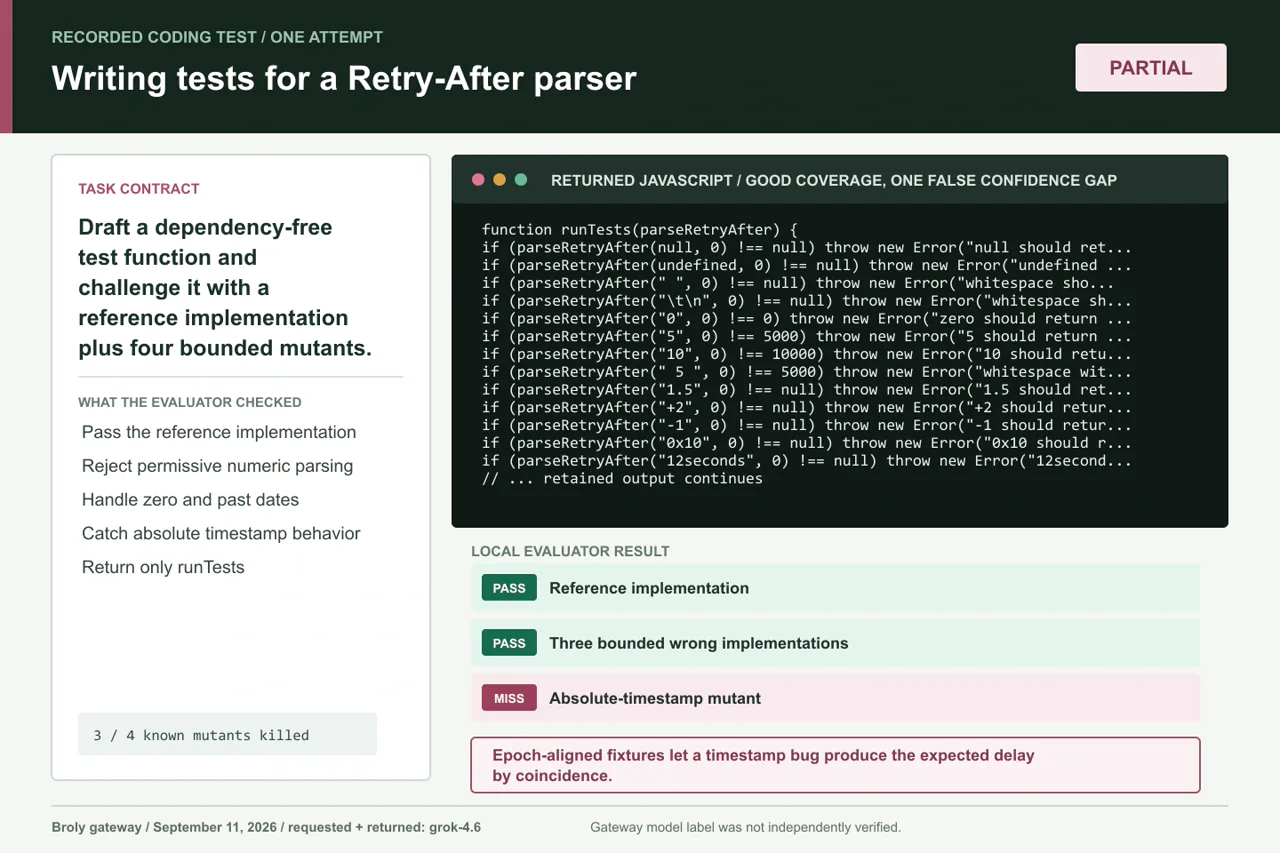
主要な境界: エポックに同期された日付フィクスチャにより、絶対タイムスタンプに関連するバグが偶然にも見過ごされてしまう。.
結果 このスイートは参照テストに合格し、許容範囲の広い数値解析、ゼロが「偽」として扱われること、および過去の日付に対する負の遅延を検出しました。ただし、解析された日付の絶対タイムスタンプを返す「変種」のケースは見逃しました。両方の日付テストではエポックに揃えられた値が使用されていたため、期待される遅延がたまたまタイムスタンプと一致してしまったのです。.
実践的な学び: AIが作成したテストは、有用な初期段階のチェックにはなりますが、正しさの証明にはなりません。各フィクスチャが何を区別しているのかを確認してください。ミューテーションテスト、プロパティテスト、意図的に整合性を欠いた値を用いることで、一見徹底しているように見えるテストスイートに隠れた問題点を明らかにすることができます。.
Grok 4、Grok 4.6、および Grok Build は同じものではありません
2025年7月のリリース状況。旧APIのスラグはその後廃止されました。.
これら4つの独立したタスクにおいて、ゲートウェイから返されたラベル。.
対話型またはヘッドレスのリポジトリワークフローを通じて動作可能な、独立したエージェント。.
サポート対象のリクエストで有効にする必要がある、サンドボックス化されたPythonツールです。.
について オリジナル Grok 第4回告知 これは過去の打ち上げ状況に関するものです。2026年の試験で使用されたモデルについては説明していません。.
xAIの 2026年5月15日 移行に関するお知らせ によると grok-4-0709 現在は、推論精度の低い「Grok 4.3」にリダイレクトされるようになっています。これは、「Grok 4」という製品ファミリー名の付いた製品がすべて消えたという意味ではなく、正確なモデルIDが重要であることを意味します。.
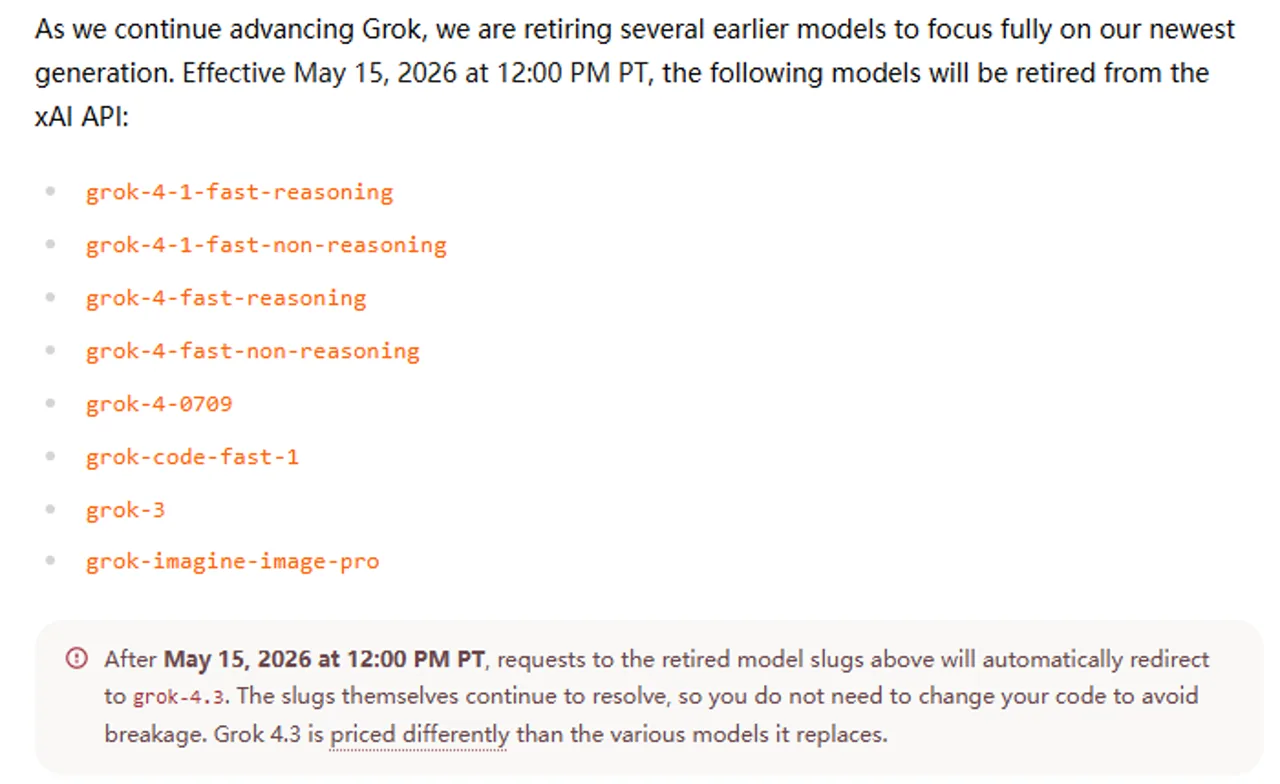
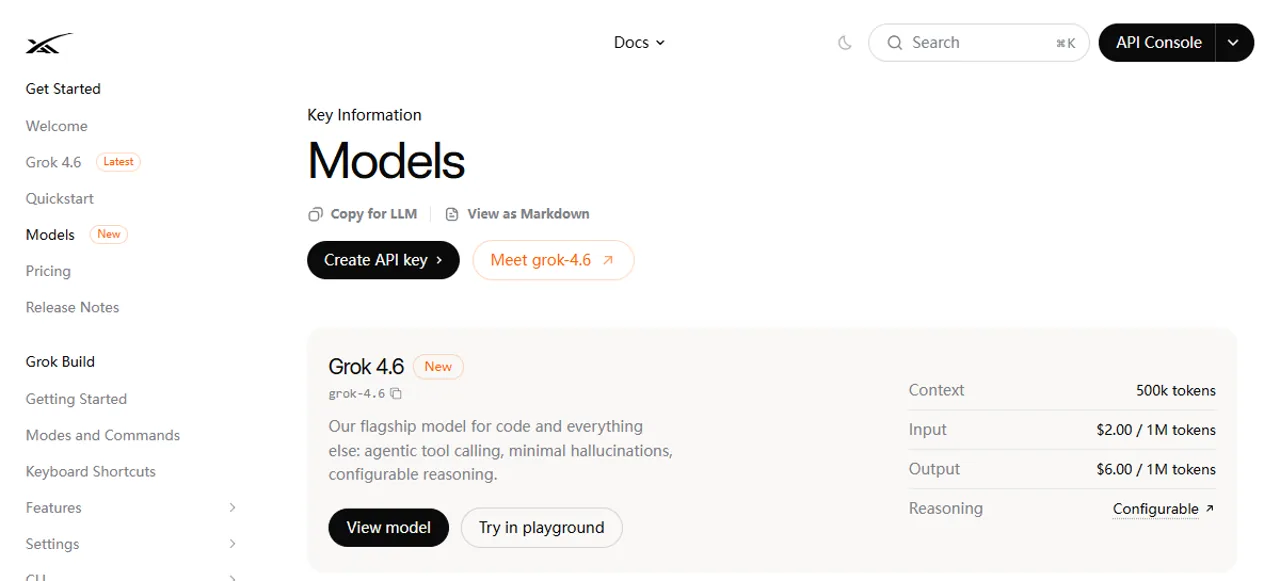
Grok 4.6 は、xAIが現在コード作成用に推奨しているモデルです。公式には Grok 4.6 仕様 サポートされているツールには、関数呼び出し、Web検索、X検索、コード実行などが挙げられます。サポートされているからといって自動的に実行されるわけではありません。モデルが何を認識し、何ができるかは、依然として呼び出し元となる製品やAPIリクエストによって決定されます。.
について Grok 4.6 に関するお知らせ このモデルは、長時間実行されるエージェントやコードベースの作業に適しています。これは公式な製品主張であり、4つの独立したJavaScriptタスクが個別に測定した結果ではありません。.
Grok ビルド は独立したコーディングツールです。その対話型ターミナルインターフェースとヘッドレスモードにより、リポジトリのワークフロー内で動作させることができます。コーディング成果物ではなくモデル名のうちから選択する場合は、 タスク別のおすすめGrokモデル このガイドでは、現在のファミリーについて解説しています。.
について xAIコード実行ツール これはオプションのサンドボックス化されたPython環境です。Brolyのテストではこれが有効になっていなかったため、モデルは回答する前に独自のJavaScriptを実行したり、評価者からのフィードバックを確認したりしませんでした。.
Grokの最適なコーディング活用例
封じ込められた障害のデバッグ
Grokは、不具合を関数、スタックトレース、不具合のあるフィクスチャ、あるいは短いdiffに絞り込める場合に最も有用です。本来どうあるべきか、実際に何が起きたか、そして変更してほしくない境界条件を明記してください。座席割り当ての結果は、正確なエッジケースが、曖昧な「これを修正して」という依頼を、検証可能なパッチへと変えることができることを示しています。.
最初の実装を生成する
アダプタ、パーサー、変換関数、およびAPIのサンプルについては、Grokが「空白ページ」による障壁を取り除きます。最小の完全なユニットやピンライブラリのバージョンを確認し、スニペットを実行してみてください。その Grok 4 API 統合ガイド その作業が、単体のコードによる回答ではなくAPIを扱うものである場合、それが次のステップとなります。.
試験問題の確認または作成
欠落している境界ケース、不変条件、および候補となる変異について、Grokに問い合わせてください。その後、各入力が、テスト対象とする動作を確実に区別できているかどうかを確認してください。「Retry-After」テストスイートは、理論上は広範囲をカバーしているはずでしたが、1組のタイムスタンプの整合性により、意味論的なバグが見逃されてしまいました。.
代替アプローチの比較
Grokは、アルゴリズムやデータ構造、あるいはデバッグの仮説についてセカンドオピニオンを求める際にも役立ちます。決定が単一のパッチではなく、アシスタントの適性に関するものである場合、 Grok と ChatGPT のコーディング比較 モデル横断的なビューを追加します。.
Grokのコーディングに監督が必要な場合
動作を保持するリファクタリング: このモデルは、出力フィールドが1つ欠けていても、要求されたアルゴリズムを満たすことができます。回帰テストを実行し、シリアライズされた出力、エラー、順序、変更、および副作用を比較してください。.
複数ファイルのリポジトリの変更: 当社の検証対象には、依存関係の発見、ビルドシステム、コード検索、生成ファイル、マイグレーション、および協調編集は含まれていません。リポジトリへのアクセス権限を範囲限定した実際のコーディングエージェントを使用し、そのコマンドと差分を確認してください。その CodexとClaudeコードのエージェント比較 モデルと同じくらい、その周辺のワークフローが重要である理由を示しています。.
セキュリティおよび制作業務: 自信に満ちた回答を、脅威モデルや依存関係監査、あるいはデプロイ承認と見なしてはなりません。CI、静的解析、シークレットスキャン、ステージング、ロールバック、および人的レビューをプロセスに組み込んでください。.
厳格なマシン間フォーマット: 4件の生の応答のうち3件は、明示的に「Markdownを使用しない」という指示があったにもかかわらず、Markdownフェンスを使用していました。境界で出力を検証・解析してください。モデルテキストがコードのように見えるからといって、決してそれを直接実行に渡してはいけません。.
コストと長い推論トレース: 当社のゲートウェイは、以下のリクエストに対して4,260個の完了トークンを報告しました。 max_tokens: 4096, 、主に推論トークンとして使用されています。この観察結果だけでは、xAIの課金や上限設定の挙動を証明するものではありません。現在の公式発表を確認し、それを Grok 4 API の価格設定および設定ガイド 制作予算を見積もる前に。.
コードでGrokを使用するための実用的なワークフロー
1. 問題を軽減する
Grokについて、失敗する最小限の再現手順を提示してください。エラー内容、関連するコード、および期待される結果の1つを含めてください。プロジェクトの履歴や機密情報は削除してください。.
2. 単なる希望ではなく、契約書を作成する
関数名、受け付ける入力、正確な戻り値の形状、順序、変更ルール、依存関係の制限、および出力形式を明記してください。その Grok 4の使い方ガイド より広範な処理とプロンプトのワークフローについて解説しています。.
3. 小銭を頼む
全面的な書き換えよりも、1つの機能や1つの重点的な変更を優先してください。公開されている動作は維持するよう求め、そのためにどのような仮定を置かざるを得なかったかを明記してください。.
4. 独立した検証を行う
モデルの応答の外部でコードを実行してください。類似した意味論を区別するエッジケースを追加し、入力の改ざんを確認し、すべての出力フィールドを比較し、想定される失敗をテストしてください。生成されたテストスイートについては、リスクに見合うと判断される場合は、既知の変異体を実行してください。.
5. 差分を確認し、決定に責任を持つ
最終的な差分ファイルを、まるで人間の貢献者から提供されたものとして確認してください。依存関係の変更、セキュリティ境界、可観測性、およびロールバックについて確認してください。マージやデプロイを行う担当者は、その結果について引き続き責任を負います。.
開発者が公の場で報告していること
一般ユーザーからの評価はまちまちで、タスク、製品、プロンプト、時期によって大きく左右されます。Hacker Newsのコメント2件がその幅の広さを示していますが、いずれもベンチマークや代表的な調査というわけではありません。.
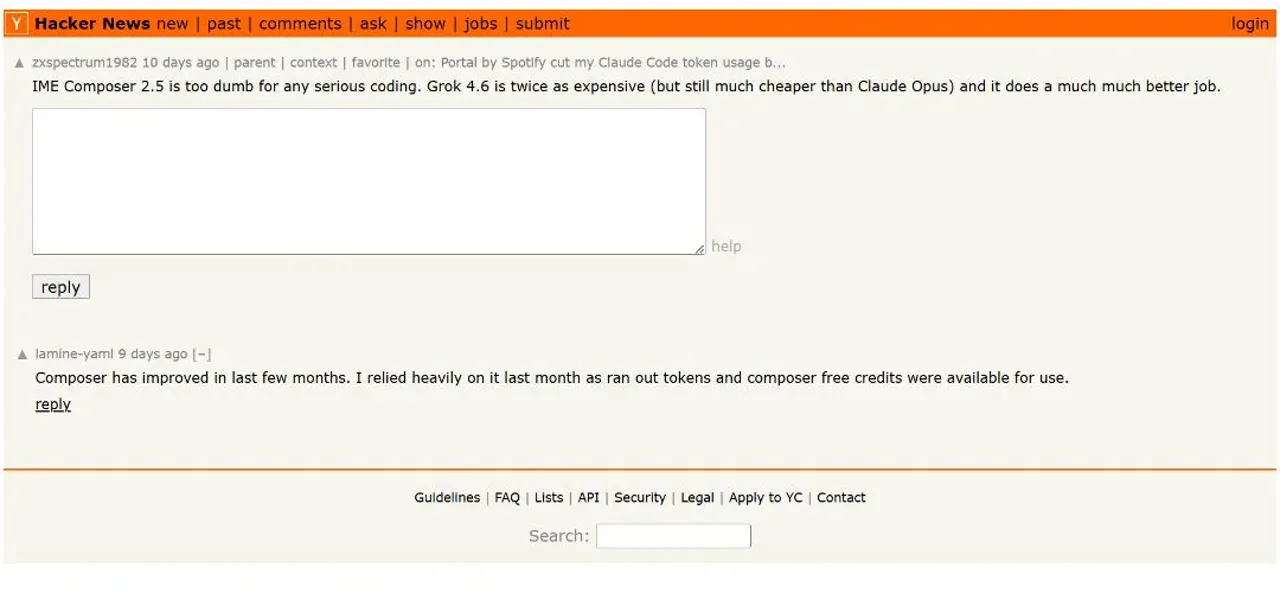
2026年9月5日、Hacker Newsのユーザー zxspectrum1982 Grok 4.6については、本格的なコーディングにおいてComposer 2.5よりもはるかに優れた性能を発揮すると評されている一方で、価格も高いとされている。これはあるユーザーによる比較であり、一般的な性能に関する主張ではない。.
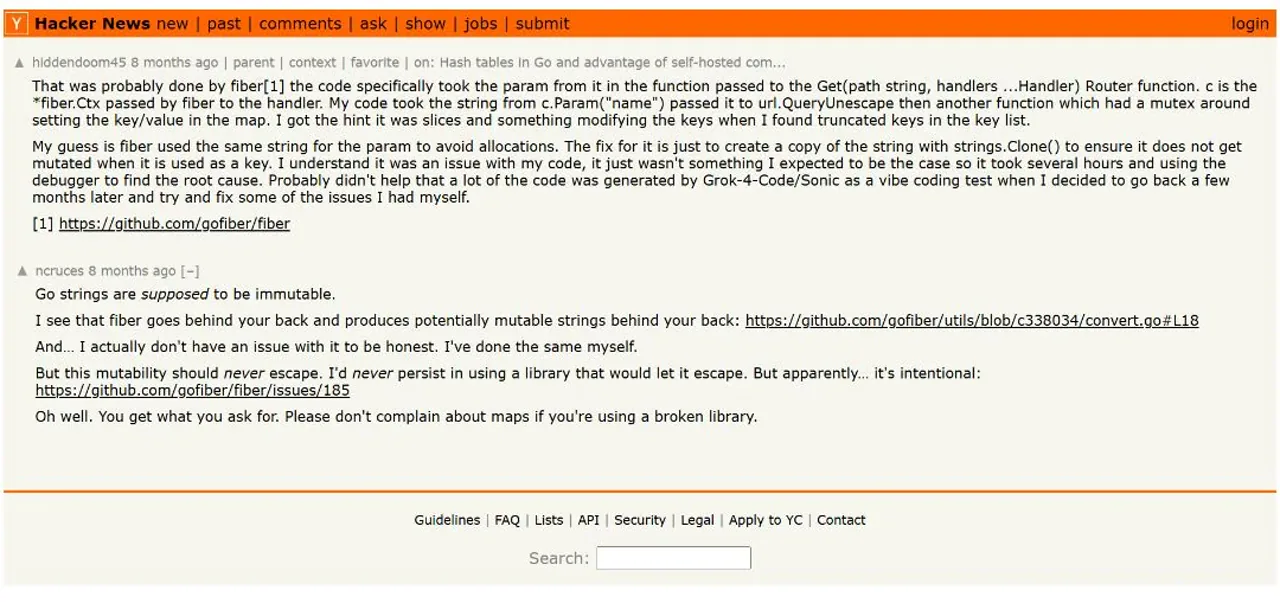
2025年12月20日、Hacker Newsのユーザー hiddendoom45 Grok-4-Code/Sonic実験中にコードが生成された後、デバッガーを用いてGo/Fiberの文字列のライフタイムに関する微妙なバグを発見したとの報告があった。この過去の事例は、手動によるデバッグやライフタイムを意識したレビューの重要性を裏付けているが、Grok 4.6の故障率を示すものではない。.
ここでの共通点は、Grokが常に成功したり失敗したりすることではありません。重要なのは、コードの品質が、そのコードが具体的なタスク、ツールチェーン、そしてレビュー担当者に直面して初めて明らかになるということです。別の ChatGPT コーディングの現実検証: アシスタントの品質は、検証と切り離して考えることはできません。.
よくある質問
Grok 4は、プログラミング初心者に適していますか?
はい、説明や簡単な例、デバッグの指針として活用してください。ただし、初心者の皆さんは、すべてのスニペットを実際に実行し、各行がどのような変更をもたらすのかを確認し、機密情報をそのまま貼り付けたり、レビューなしに慣れないコードをデプロイしたりすることは避けてください。.
コーディングには、Grokのどのモデルを使えばよいでしょうか?
2026年9月11日時点の確認によると、xAIはコードとして「Grok 4.6」を推奨しています。元の「grok-4-0709」APIスラグは廃止されているため、お使いの製品における正確なモデルIDをご確認ください。.
Grok 4.6 では、リポジトリ全体を編集できますか?
このモデルは、ファイルおよびコマンドへのアクセス範囲が制限されたエージェント内で使用された場合、リポジトリ作業を支援することができます。当社のテストは個別のプロンプトによるものであったため、自律的な複数ファイル処理や本番環境での運用準備が整っていることを示すものではありません。.
「Grok Build」は、チャットで「Grok」を使うのと同じことですか?
No. Grok Build は、独立した対話型またはヘッドレス型のコーディングエージェントです。通常のチャットや API 補完では、そのリポジトリのコンテキスト、ターミナル、権限、またはツールループが自動的に引き継がれることはありません。.
Grok 4.6をGlobalGPTでのコーディングに使用することはできますか?
はい。GlobalGPTは、バウンドコーディングのプロンプトやモデル比較のための、検証済みのGrok 4.6ルートを提供しています。これは独立したプラットフォームであり、Grok BuildやIDE、xAIのネイティブAPIツールに代わるものではありません。.
Grokによって生成されたコードを、テストせずに信頼してもいいのでしょうか?
いいえ。コードを実行し、境界ケースを追加して、差分を確認し、通常のリントチェック、型チェック、セキュリティチェック、CIチェックを実行してください。私たちのリファクタリングは一見クリーンに見えましたが、空でない結果のすべてにおいて、必須フィールドが省略されていました。.
最終評決
Grok 4はコーディングに適していますか? 現在の Grok 4.6 モデルは、範囲限定の修正、小規模な関数、説明、および初回テストにおいて、有能なコーディングアシスタントとして機能します。4つのタスクからなるテストスイートにおいて、このモデルは2つの完全に正しい解決策を生成しましたが、1つの動作を損なうリファクタリングと、1つの不完全なテストスイートも生成しました。また、3つの応答において、「Markdown を使用しない」という厳格な指示を無視しました。.
この手法は、失敗の検出コストが低い場面で活用してください。具体的には、範囲が限定的である場合、契約内容が明示されている場合、実行可能なフィクスチャが利用可能な場合、および人間によるレビューが行われる場合です。この証拠を、監視なしのリポジトリ変更、セキュリティ承認、あるいは本番環境へのデプロイを許可する根拠として扱ってはいけません。.
実践的な試みとして、, Grok 4.6をGlobalGPTで開く, 、上記の完全なプロンプトのいずれかを実行し、その出力をご自身のテスト結果と比較した上で、ワークフローに組み込むかどうかを判断してください。.