コーディングのパフォーマンスを重視しつつも、API呼び出しのたびにフラッグシップモデル並みのコストをかけたくないという方には、GLM-5.3 Flashというモデルがおすすめです。. Z.AIはこれをネイティブなマルチモーダルGLM-5シリーズモデルとして位置付けており、公式の価格差は明らかだ。現在のプロモーション価格は、入力トークン100万トークンあたり$0.075、出力トークン100万トークンあたり$0.25であるのに対し、 一方、同じZ.AIの価格ページでは、GLM-5.3およびGLM-5.2は、入力100万トークンあたり$1.40、出力100万トークンあたり$4.40と掲載されている。.
とはいえ、GLM-5.3 Flashがあらゆるタスクにおいて迷う余地のない選択肢であるとは限りません。当社が実施した制御されたAPIテストでは、コストは低く見えたものの、推論や出力設定の影響を強く受けることが判明しました。 OpenAI互換のデフォルトリクエストのいくつかは、HTTP 200を返したものの、完了トークンの大半を推論に費やし、目に見える回答はほとんど、あるいは全く生成されませんでした。GLMスタイルの推論設定に切り替え、出力上限を拡大したところ、コーディング・デバッグタスクが実用可能な状態になりました。.
このガイドでは、以下を分解して説明します GLM-5.3 フラッシュ価格, 、APIへのアクセス、公式仕様、ベンチマークデータ、および実機テストの結果など。特定のスタックを決定する前に各モデルを比較したい場合は、, GLBGPT 複数のモデルの出力を比較するには、こちらの方がより簡単ですが、GLM-5.3 Flash APIの公式な詳細については、Z.AIの公式ドキュメントおよび料金ページが依然として最も信頼できる情報源です。.
【簡単解説】GLM-5.3 Flashとは?
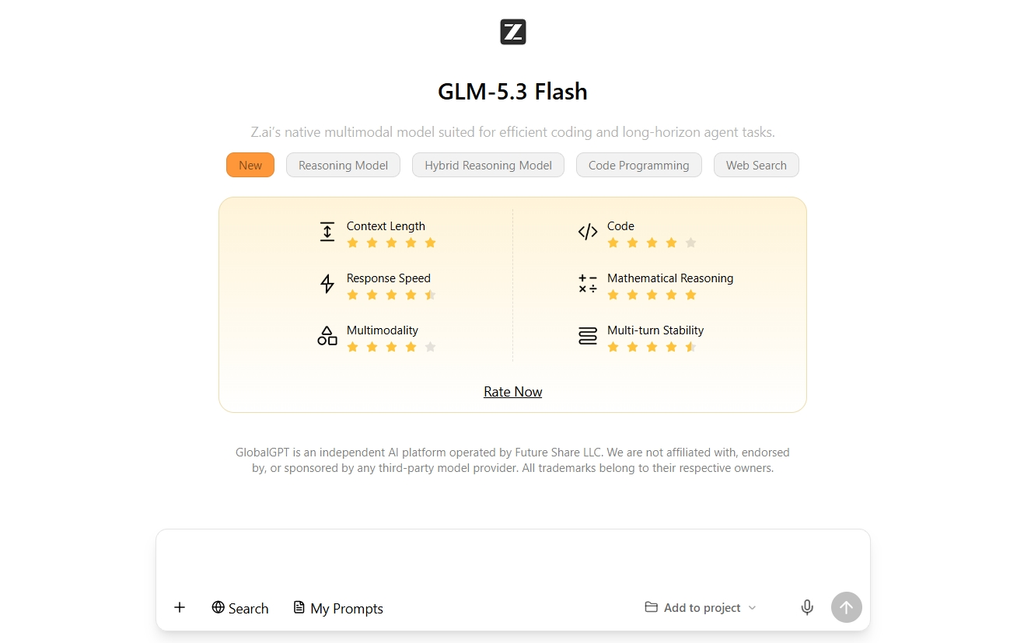
GLM-5.3 Flashは、コーディング、エージェントタスク、長文処理、およびマルチモーダル入力に対応した、Z.AIのコスト効率に優れたGLM-5モデルです。. オフィシャル GLM-5.3-Flash ドキュメント APIモデルのコードを次のように記載しています。 glm-5.3-flash, 1Mトークンのコンテキストウィンドウに対応しており、画像入力については以下で説明しています。 image_url コンテンツブロック。.
重要なのはトレードオフです。GLM-5.3 Flashは、単に同じモデルページに小さなラベルが付けられただけのものではありません。 Z.AIは、これをGLM-5シリーズ初のネイティブマルチモーダルモデルと位置付けており、総パラメータ数は320B、アクティブパラメータ数は18Bとなっています。このモデルは、長いコンテキストでの挙動を維持しつつ、サービングコストを削減することを目的としたハイブリッドアーキテクチャを基盤として構築されています。.
私の実用的な見解としては、GLM-5.3 Flashは、コスト重視のコーディングや、モデルを何度も呼び出す可能性のあるエージェントのワークロードにおいて最も有用です。APIルートや推論設定を適切に調整しない限り、カジュアルなライティングモデルとしてはあまり説得力に欠けます。なぜなら、出力の上限が低すぎると、可視化された出力が推論トークンの使用に埋もれて見えなくなってしまう可能性があるからです。.
GLM-5.3 フラッシュ価格
オフィシャル Z.AI の価格ページ は、以下の情報源の中で最も信頼性の高いものです。 GLM-5.3 フラッシュ価格. 2026年8月27日時点の確認によると、Z.AIではGLM-5.3-Flashが50%のプロモーション割引価格で掲載されています。 割引価格は、入力トークン100万トークンあたり$0.075、出力トークン100万トークンあたり$0.25となっています。 取り消し線付きの定価は、入力トークン100万トークンあたり$0.15、出力トークン100万トークンあたり$0.50となっています。.
Z.AIはまた、このキャンペーンは2026年9月9日24:00(UTC+8、シンガポール時間)に終了すると述べています。これは、長期的なコストを比較する読者にとって重要な点です。ローンチ割引は確かに適用されますが、Z.AIが期間を延長しない限り、これを恒久的な基準として扱うべきではありません。.
| モデル | 入力 / 100万トークン | キャッシュされた入力 | 出力 / 100万トークン | 価格に関する注意事項 |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.075 プロモーション価格;$0.15 定価 | $0.015 プロモーション価格;$0.03 定価 | $0.25 プロモーション価格; $0.50 定価 | 50%の割引は、2026年9月9日(UTC+8)まで |
| GLM-5.3 | $1.40 | $0.26 | $4.40 | Z.AIの価格設定に関する「Flagship GLM-5.3」の項目 |
| GLM-5.2 | $1.40 | $0.26 | $4.40 | Z.AIの価格設定に関する前回のGLMモデルに関する記述 |
| GLM-5.1 | $1.40 | $0.26 | $4.40 | 「Z.AI」テキストモデルに分類されています |
Z.AI公式の出力価格比較
出典:Z.AI公式価格ページ(2026年8月27日確認)。キャンペーン価格は期間限定です。.
そう、公式のトークン単価で見れば、GLM-5.3 FlashはGLM-5.3やGLM-5.2に比べて安いです。しかし、より重要なのは、プロンプト、推論設定、ツール呼び出し、再試行のコストを含めた場合でも、依然として安いままであるかどうかです。この点については、実機テストのセクションで詳しく解説しています。.
前世代の価格設定に関する背景情報については、別途掲載している記事をご覧ください。 GLM-5.2の価格 ガイド。そのページはGLM-5.2に焦点を当てたままにし、GLM-5.3のFlash価格、API、およびベンチマークの目的については、この記事で扱うようにします。.
GLM-5.3 Flash API へのアクセス
公式のAPIモデルコードは以下の通りです。 glm-5.3-flash. Z.AIによると、テキストパラメータはGLM-5.3と互換性があり、100万トークンのコンテキストウィンドウに対応しており、また画像入力をサポートしているとのことです。 image_url 内部のブロック messages[].content[]. つまり、GLM-5.3 Flashは単なるテキストのみのコーディングモデル以上のものなのです。.
設定に関する注記は、些細な詳細ではありません。ドキュメントでは、次のように推奨されています。 温度:1, top_p: 0.95, そして 推論の労力: 最大. また、彼らはこうも言っている。 thinking.type 対応しています 有効, 、そして以下をお勧めします thinking.clear_thinking: false. 当社独自のテストでは、この種の設定が重要な役割を果たしました。.
| API項目 | 何を使うか | なぜそれが重要なのか |
|---|---|---|
| モデルコード | glm-5.3-flash |
バリエーション名を推測するのではなく、正確なモデルIDを使用してください。. |
| 文脈 | 100万トークン | 大規模なコードベースや長文のドキュメント、エージェントのメモリ管理に有用ですが、コスト面での配慮も依然として必要です。. |
| 画像入力 | image_url コンテンツブロック |
スクリーンショットからコードへの変換や、ビジュアルデバッグのワークフローに対応しています。. |
| 考える | thinking.type: enabled |
推論は、些細で目立たない細部として扱うことはできず、トークンの使用を左右し得るものである。. |
開発者ではない方にとって、こうした場面でマルチモデルプラットフォームが役立ちます。次のように利用できます。 GLBGPT 特定のプロバイダーのAPI設定に時間を割く前に、モデルの挙動を比較するためです。トークンの正式な課金情報やモデルパラメータについては、必ずZ.AI自身の価格表やドキュメントを確認してください。.
GLM-5.3 フラッシュ・ベンチマークと能力シグナル
ベンチマークはここで有用ですが、それはソースを明記している場合に限ります。Z.AIのドキュメントには、公式のモデル性能に関する主張やアーキテクチャの詳細が記載されています。. 人工分析 サードパーティのベンチマークデータを提供しています。. オープンルーター プロバイダー・マーケットプレイスのデータを提供しています。これらは3つの異なるエビデンスの種類です。.
Artificial Analysisのレポートによると、GLM-5.3-Flashのインテリジェンス指数は57で、表示されたグループ110件中#3位、コンテキストウィンドウは1M、出力トークン数は毎秒50.2トークンとなっています。また、入力モダリティはテキストと画像、出力はテキストであることが示されています。 これは、Flash価格帯のモデルとしては高い性能を示す指標ですが、あくまでサードパーティによるベンチマークであり、Z.AIによる公式の速度保証ではありません。.
価格と機能の概要
| モデル | 定価 | ベンチマーク信号 | 文脈 | ソース境界 |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.075(入力)/$0.25(出力)のプロモーション(100万トークンあたり) | 57 インテリジェンス指数;50.2 出力トークン/秒 | 100万トークン | 価格:Z.AI、ベンチマーク:Artificial Analysis |
OpenRouterは、マーケットプレイスでの利用状況やプロバイダー固有の数値を確認するのに役立ちますが、それらの値を公式価格表には記載しないほうがよいでしょう。OpenRouterのプロバイダーで、異なるスループットや一時的な料金が表示されている場合は、「プロバイダーのマーケットプレイスデータ」として明記してください。.
APIの実践テスト:プロンプト、トークンの使用、および結果
利用可能な5つのモデルを対象に、対照実験によるAPIテストを実施しました: glm-5.3-flash, glm-5.3, glm-5.2, gpt-5.6-luna, そして kimi-k3. これは公式のベンチマークではなく、世界的なモデルランキングとして解釈すべきではありません。この記事の目的は、より限定的かつ実用的なものでした。すなわち、同じプロンプトに対して、GLM-5.3 Flashが実用的な出力を返したかどうか、その推論トークンはどのように振る舞ったか、そしてAPIの応答からどのようなコストフィールドが返ってきたか、という点を確認することでした。
テストの設計は、意図的にシンプルにしました。コーディング課題を1つ、厳格な構造化出力課題を1つ、短い文章作成課題を1つ採用しました。この組み合わせが重要なのは、モデルがコーディングでは優れた性能を示しても、出力リソースを隠れた推論に使い果たしてしまうと、厳格なJSON出力や短い文章の作成においては扱いにくいものになってしまう可能性があるからです。.
テストカードの読み方
- パス とは、モデルがタスクに応える可視的な出力を返したことを意味する。.
- フォーマットのエラー つまり、そのコンテンツは有用ではあったものの、厳密には機械可読な出力ではなかったことを意味します。.
- 結論が出ない これは、リクエストが技術的には成功したものの、テスト対象のルートから目に見える応答がほとんど、あるいはまったく返ってこなかったことを意味します。.
- コストフィールド これらは、この管理されたAPI実行から得られた回答に基づく値であり、プロバイダーによる公式の価格保証ではありません。.
使用されたデフォルトの実行 温度:0.2 およびタスクレベルの出力上限を設定した。各モデル/タスクは1回ずつ実行し、自動再試行は行わなかった。その後、GLM-5.3 Flashについてのみ、コーディングおよびライティングタスクにおいてGLMスタイルの思考設定を用いた追跡実験を実施した。これは、デフォルトのFlashの応答において推論トークンの使用が著しく多く見られ、より公平な設定の検証が必要だったためである。.
課題A
コーディングのデバッグ:モデルは顧客グループ分けのバグを見つけられたか?
課題: TypeScriptの関数内のバグを見つけ、その原因を説明し、修正後の実装を示してください。.
正確なプロンプト
顧客IDごとに注文をグループ化し、各顧客の合計購入額を計算するTypeScriptの関数をレビューしています。 バグを見つけ、その原因を説明し、修正後の実装を示してください。コード:type Order = { id: string; customerId: string; total: number }; function summarize(orders: Order[]) { const result: Record = {}; for (const order of orders) { if (!result[order.id]) result[order.id] = { count: 0, total: 0 }; result[order.id].count += 1; result[order.id].total += order.total; } return result; }
| モデル | 出力の概要 | トークン/コストに関する注記 | 結果 |
|---|---|---|---|
glm-5.3-flash |
デフォルトの実行ではHTTP 200が返されましたが、推論に1200個の完了トークンのうち1196個が使用されたため、アシスタントからの回答は表示されませんでした。推奨設定のフォローアップでは、それが正しく特定されました。 order.id ~であるべき order.customerId そして、修正した実装を提示した。. |
デフォルト:トークン総数 1348、コストフィールド $0.0003111。フォローアップ:トークン総数 2584、コストフィールド $0.00124007598。. | 再実行後のパス |
glm-5.3 |
グループ化キーのバグを特定し、一意の注文IDが顧客レベルの集計を妨げる理由を説明しました。修正後のコードでは、以下の処理が行われました。 customerId オブジェクトのキーとして。. |
トークン総数 1348、コストフィールド $0.00534128。. | パス |
glm-5.2 |
また、次のものも見つかりました。 order.id 対 customerId この問題を解決し、実用可能な修正済み実装を作成しました。. |
トークン総数は1304です。USDでの費用は、同じレスポンスフィールドには返されませんでした。. | パス |
gpt-5.6-luna |
最も明快かつ簡潔な説明をしてくれました。アキュムレータは注文IDをインデックスとしていたため、各注文がそれぞれ独立したバケットとなっていたのです。その説明に基づき、修正されたTypeScriptコードが返されました。. | トークン総数509個。米ドルでの支払額は未確定/返金されていません。. | パス |
kimi-k3 |
同じバグを見つけ、詳細な説明と修正後の実装を提示しました。その回答は実用的なものでしたが、GPTの回答よりも長くなっていました。. | トークン総数 1423。米ドルでの支払額は未確定/返金されていません。. | パス |
収穫だ: コーディングのデバッグに関しては、GLM-5.3 Flashは、GLMスタイルの思考設定を行い、出力の上限値を大きくして初めて良好な結果が得られた。GLM-5.3、GLM-5.2、GPT-5.6 Luna、およびKimi K3は、いずれも初回実行で実用的な視覚的な回答を返した。.
課題B
厳格なJSON:モデルは機械可読な形式に従っていましたか?
課題: キーが固定されており、Markdownによる改行がない、厳密なJSONのみを返す。.
正確なプロンプト
厳密なJSON形式でのみ返してください。コーディングアシスタントの選定を検討している開発者のために、GLM-5.3-Flash、GLM-5.3、およびGPTスタイルのフラッグシップモデルを比較してください。以下のキーを使用してください:best_for、tradeoffs、cost_warning、recommendation。マークダウンは使用しないでください。.
| モデル | 出力の概要 | トークン/コストに関する注記 | 結果 |
|---|---|---|---|
glm-5.3-flash |
JSONのようなコンテンツの一部が返されましたが、クリーンアップを行わない限り、厳密な意味でのJSONとして解析することはできませんでした。これは人間が読む分には問題ありませんが、直接自動化には適していません。. | トークン総数 1267、コストフィールド $0.000305025。. | フォーマットのエラー |
glm-5.3 |
テスト対象の出力上限値の範囲内では、目に見えるアシスタントコンテンツは返されず、完了トークンのほぼすべてが推論処理に消費された。. | トークン総数 1267、コストフィールド $0.00530084。. | 結論が出ない |
glm-5.2 |
JSONのような応答が返ってきたが、不完全だったか、あるいは整理しなければ解析できなかった。. | トークンの総数は1268です。USDでの金額は、同じレスポンスフィールドには返されませんでした。. | フォーマットのエラー |
gpt-5.6-luna |
リクエストされたキーを含み、Markdownのフェンスがない、解析可能なJSONを返しました。. | トークン合計541個。米ドルでの支払額は未確定/返金されていません。. | パス |
kimi-k3 |
有用な情報が含まれたJSON風のコンテンツが返されましたが、クリーンアップを行わなければ、厳密な意味での解析可能なJSONではありませんでした。. | トークン総数1339。米ドルでの支払額は未確定/返金未了。. | フォーマットのエラー |
収穫だ: 厳密に構造化された出力という点では、この小規模な実行において「GPT-5.6 Luna」が最もクリーンな結果を出しました。「GLM-5.3 Flash」は、応答形式の制御をさらに厳格にすれば機能する可能性もありますが、このデフォルトのリクエストでは自動化に対応できませんでした。.
課題C
製品に関する簡単なメモ:このモデルは、実用的な文章を生成できたのでしょうか?
課題: GLM-5.3 Flashが、より高価なフラッグシップモデルよりも優れている場合について、宣伝色のない具体的な120語の解説文を作成してください。.
正確なプロンプト
GLM-5.3-Flashが、より重いフラッグシップモデルよりも適しているケースについて、120語程度の製品解説文を作成してください。宣伝調にならず、具体的な内容にしてください。.
| モデル | 出力の概要 | トークン/コストに関する注記 | 結果 |
|---|---|---|---|
glm-5.3-flash |
デフォルトの実行では、推論に900個の補完トークンのうち895個が使用された後、表示可能なコンテンツは返されませんでした。推奨設定による追試でも、推論に1800個の補完トークンのうち1798個が使用された後、表示可能なコンテンツは返されませんでした。. | デフォルト:トークン総数 946、コストフィールド $0.00022845。フォローアップ:トークン総数 1846、コストフィールド $0.00045345。. | 結論が出ない |
glm-5.3 |
テスト対象の出力上限値以下では、表示可能なコンテンツが返されませんでした。. | トークン総数 946、コストフィールド $0.0040244。. | 結論が出ない |
glm-5.2 |
テスト対象のルートでは、表示可能なコンテンツが返されませんでした。. | トークンの総数は947です。USDでのコストは、同じレスポンスフィールドには返されませんでした。. | 結論が出ない |
gpt-5.6-luna |
ハイスループット生成、予測可能なレイテンシ、サポート要約、抽出、分類、ルーティングといった具体的な事例を盛り込んだ実用的なメモを提出しました。文字数は依頼された120語にほぼ合致していました。. | トークン総数:983。米ドルでの支払額は未定/返金されていません。. | パス |
kimi-k3 |
テスト対象のルートでは、表示可能なコンテンツが返されませんでした。. | トークン総数 1019。米ドルでの支払額は未確定/返金されていません。. | 結論が出ない |
収穫だ: このルートでの短い書き込みにおいて、GLM-5.3 Flashは、返されたコストがごくわずかであったにもかかわらず、実用的な可視コピーを生成できませんでした。価格表だけを見てこれを選ぶことはせず、まずは具体的な設定を実際にテストしてみるべきでしょう。.
検査の結果、実際に何が明らかになったのか
- GLM-5.3 Flashは、コーディングのコストという点で実に興味深い。. GLM式の考え方に基づいて設定を調整したところ、コーディング作業は正常に動作し、その実行にかかるコストも依然としてごくわずかでした。.
- デフォルトルートはプラグアンドプレイ対応ではありませんでした。. いくつかのFlashレスポンスは、推論トークンに完了予算のほぼすべてを消費しながら、HTTP 200を返しました。.
- 厳格なJSONには、追加の検証が必要です。. JSONのように見える回答は、解析可能なJSONとは異なります。特に、その出力が自動化処理に利用される場合はなおさらです。.
- フラッシュを最初に評価する際、短編作品はその判断材料にはならない。. このテストでは、フォローアップ設定を行った後も、ライティング課題に対してFlashによる回答が表示されませんでした。.
私の見解は単純です。GLM-5.3 Flashはコスト重視のコーディングにおいて有望ですが、OpenAI互換のすべてのルートで「プラグアンドプレイ」のように扱うべきではありません。十分な出力予算を確保し、推論トークンの挙動を確認し、実際に大量の処理を移行する前に、実行を予定しているタスクタイプそのものをテストしてください。.
GLM-5.3 フラッシュの最適な活用例
GLM-5.3 Flashは、マルチモーダル入力、長いコンテキスト、および多数の繰り返し呼び出しがタスクに有効である場合に、最も適しています。単に価格表が魅力的に見えるという理由だけでこのモデルを選ぶことはありません。タスクの特性がモデルと合致する場合に、このモデルを選択します。.
- ツール呼び出しが多数あるコーディングエージェント: モデルの計画、編集、テスト、修正という一連のプロセスを繰り返す際には、トークンの価格を低く設定しておくと役立ちます。.
- スクリーンショットに基づくフロントエンド作業: 画像入力とコーディング機能に重点を置いているため、UIのデバッグやスクリーンショットからコードを生成する作業に最適な選択肢となります。.
- 長文のコードレビュー: 1Mのコンテキストウィンドウは、1つのリクエストでより多くのプロジェクトのコンテキストを保持する必要がある場合に役立ちます。.
- 書類の多い専門的な業務: Z.AIでは、Officeファイル、金融リサーチ、および業務用文書の処理における活用事例を紹介しています。.
- 予算に配慮したAPIの実験: 公式の価格差を考えると、より高スペックのモデルにステップアップする前に、まずFlashを試してみるのが賢明な選択だ。.
主に短いマーケティングコピーを作成するのであれば、単に安価という理由だけで、Flashがデフォルトとして最適だと決めつけないでください。 当社のライティングテストでは、デフォルト設定と推奨設定の両方でFlashを実行しても、選択した出力上限内で可視コンテンツがきれいに返されなかったため、結論は出ませんでした。まずはコーディングや構造化されたエンジニアリングタスクでテストを行い、その上でFlashをライティングツールスタックに組み入れるべきかどうかを判断することをお勧めします。.
注目すべきコストトリガーとAPI設定
GLM-5.3 Flashの最大のリスクは、公式のトークン価格ではありません。公式価格は低いのです。リスクとなるのは、安価なリクエストと実用的な回答との間のギャップです。.
- 推論トークン: 我々のテストでは、いくつかの実行において、推論トークンが完了予算の大部分を消費しました。.
- 出力上限: 上限値が低い場合、HTTPリクエストが成功しても、表示可能なコンテンツが返されないことがあります。.
- エージェントのループ: 各「計画・編集・テスト」のサイクルごとに、コンテキストと出力トークンの数が倍増する可能性があります。.
- 全体的な文脈: 100万トークンは便利ですが、必要以上のコンテキストを送信すると、コストやレイテンシに影響が出てしまいます。.
- 再試行回数: 失敗した、あるいは出力が得られなかった設定変更を再試行すると、利用可能な結果1件あたりの実質的なコストが変わります。.
コーディング作業において、私が出発点とするのは、公式のモデルコードを使用し、GLMスタイルの思考設定に従い、モデルに十分な可視出力領域を確保し、推論トークンと最終回答トークンを別々にログに記録することです。複数のアプローチを比較する場合は、リクエストあたりのコストではなく、完了したタスクあたりのコストを測定してください。.
GLM-5.3 Flashは買う価値があるか?
ワークロードがコーディング中心で、コスト重視かつAPI主導である場合は、GLM-5.3 Flashを試してみる価値があります。. 公式価格は魅力的で、サードパーティによるベンチマーク評価も高く、このモデルにはネイティブのマルチモーダル入力、100万のコンテキスト、そして効率的なサービングを目的に設計されたGLM-5シリーズアーキテクチャなど、有用な仕様が備わっています。.
主な用途が一般的な文章作成や、厳密に構造化された出力の生成、あるいは目に見えない推論結果が出力されることが重大な問題となるワークフローである場合は、より慎重になるべきでしょう。そのような場合は、データをフラッシュに大量に移行する前に、具体的な処理経路と設定を事前にテストしてください。モデルは安価であっても、設定には細心の注意を払う必要があります。.
APIスタックを選ぶ前にモデルの挙動を確認したい読者の方へ、, GLBGPT これにより、プロバイダーごとに個別のタブを開くことなく、モデルの出力結果を比較できる実用的な場が提供されます。自分のタスクに適したモデルが分かれば、公式のAPIや料金に関するドキュメントの評価も容易になります。.
よくあるご質問
GLM-5.3 Flashとは何ですか?
GLM-5.3 Flashは、APIモデルコードを持つZ.AI GLM-5シリーズのモデルです。 glm-5.3-flash. Z.AIは、これを100万トークンのコンテキストに対応し、コスト効率に優れたアーキテクチャを備えたネイティブのマルチモーダルモデルであると説明している。.
GLM-5.3 Flashの価格はいくらですか?
2026年8月27日時点の確認によると、Z.AIでは、50%のプロモーション期間中、GLM-5.3 Flashの料金が、入力トークン100万トークンあたり$0.075、出力トークン100万トークンあたり$0.25と表示されています。 掲載されている通常価格は、入力トークン100万トークンあたり$0.15、出力トークン100万トークンあたり$0.50となっています。.
GLM-5.3 Flashは無料ですか?
公式の価格ページには、有料APIトークンの価格が記載されています。また、恒久的な無料モデルではなく、期間限定の割引も表示されています。ルートやプランによっては別途クォータ規則が適用される場合がありますが、それについては実際に使用するアクセスインターフェースで確認する必要があります。.
GLM-5.3 Flash APIのモデルコードとは何ですか?
公式のモデルコードは次のとおりです。 glm-5.3-flash.
GLM-5.3 Flashは画像の入力をサポートしていますか?
はい。Z.AIのドキュメントには、画像入力の方法について image_url チャットメッセージのコンテンツ配列内にあるコンテンツブロック。.
GLM-5.3 Flashのコンテキストウィンドウとは何ですか?
Z.AIのドキュメントには、100万トークンのコンテキストウィンドウがサポートされていると記載されています。OpenRouterやArtificial Analysisも約100万トークンのコンテキストを表示しますが、これらは別のサードパーティのページです。.
GLM-5.3 Flashは、GLM-5.3よりも優れていますか?
必ずしもそうとは限りません。GLM-5.3は、複雑なコーディングや長期的なタスク向けのより高負荷なモデルであるのに対し、GLM-5.3 Flashははるかに安価で、ネイティブなマルチモーダル位置推定機能が追加されています。タスクの種類やコスト許容範囲に応じて選択してください。.
GLM-5.3 Flashはコーディングに適していますか?
コーディング、特にコスト重視のコーディングにおいては有望な結果が得られたようだ。GLMスタイルの思考設定とより大きなトークン上限を用いた制御されたAPIの追跡実験では、TypeScriptのグループ化に関するバグを正しく修正した。デフォルトの出力制限を低く設定した場合、レスポンスに目に見えるコンテンツがほとんど、あるいは全く含まれていなかったため、いくつかの実行では結論が出なかった。.
GLM-5.3 Flashは、GPTモデルと比べてどうでしょうか?
GLM-5.3 Flashは、公式トークン価格で見ると多くの主力コーディングモデルよりもはるかに安価ですが、価格だけが唯一の要素ではありません。当社が実施した小規模なデフォルト設定でのテストでは、GPT-5.6 Lunaは3つのタスクすべてで実用的な出力を返したのに対し、GLM-5.3 Flashはコーディングタスクにおいて推奨設定での再実行が必要でした。.
GLM-5.3 FlashとKimiを比べるとどうでしょうか?
Kimi K3は、当社のテストにおけるコーディング・デバッグ課題には合格しましたが、クリーンアップを行わない場合の厳格なJSON検証には合格せず、また、テスト対象のルートにおける短文作成課題では目に見えるコンテンツを返すことができませんでした。これはKimiの総合的な評価を低くするものではなく、あくまでこの一連の課題と設定に関する結果に過ぎません。.
GLM-5.3 Flashはどこで試すことができますか?
公式APIへのアクセスについては、Z.AIのGLM-5.3 Flashのドキュメントおよび料金ページをご利用ください。導入を決定する前に、より広範なモデル比較を行いたい場合は、GLBGPTなどのマルチモデルプラットフォームを利用することで、各モデルの出力を一か所で比較することができます。.
GLM-5.3 Flashを本番環境で使用すべきでしょうか?
実際の運用で使用する前に、具体的なタスク、ルート、設定、出力制限、およびコスト記録について十分にテストを行ってください。価格は魅力的ですが、当社のテストでは、設定の詳細によって応答が実用的なものになるかどうかが決まることが判明しました。.
最終的な要点
GLM-5.3 Flashは、単にGLM-5.3の安価な派生版というだけではありません。コストを重視したコーディング、マルチモーダル入力、および長文コンテキストを扱うAPI開発において、本格的な新たな選択肢となります。公式価格は魅力的であり、ベンチマーク結果も十分に良好であるため、試してみる価値は十分にあります。.
私が特に注意を促したいのは実用的な点です。HTTP 200のレスポンスだけで判断してはいけません。表示される出力結果、推論トークンの使用状況、そして有用な回答1件あたりのコストを確認してください。実際のタスクにおいてこれらに問題がなければ、GLM-5.3 Flashは、現在のコーディングスタックにおいて、コストパフォーマンスに優れたモデルの一つとなる可能性があります。.