Claudeモデルの比較:Haiku vs Sonnet vs Opus、そしてFableの位置づけ

claude-models-comparison-hero

速度、APIコスト、使用状況、タスクの複雑さ、そして誤った回答によるコストに基づいて選択するための、2026年版の実用ガイド。.

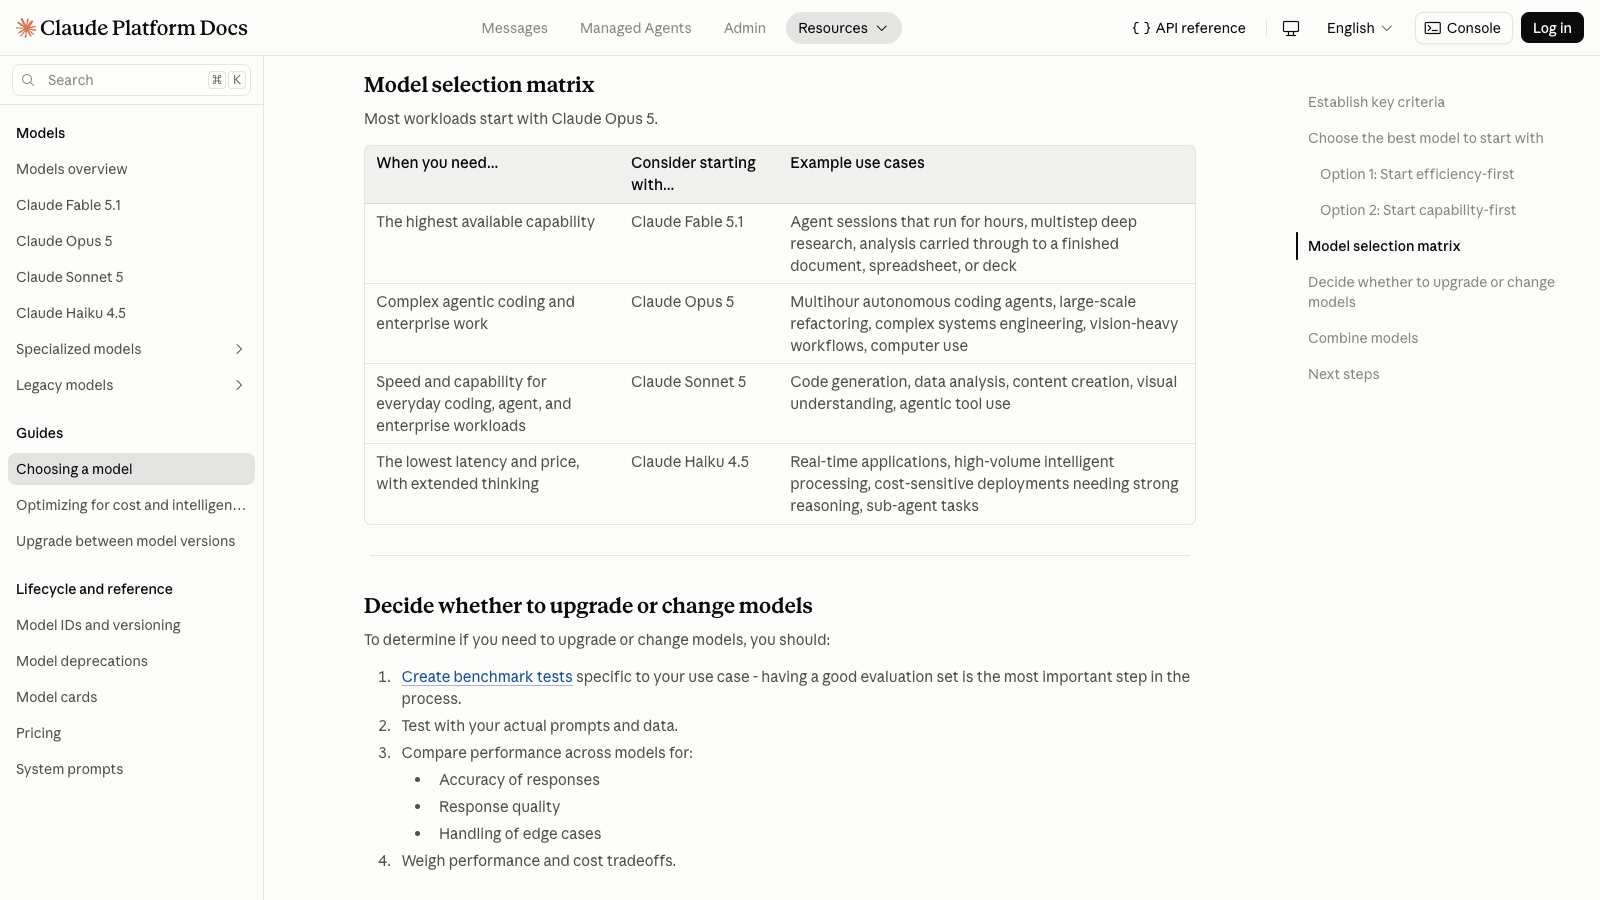
日常的な文章作成、分析、コーディング、ツール操作などの作業のほとんどについては、まずは Claude Sonnet 5 から始めましょう。難しいエッジケースへの対応よりも、低レイテンシと高スループットが重視される場合は、Haiku 4.5 を選択してください。 タスクが複雑で、検証が困難、あるいは失敗した際のコストが高い場合は、Opus 5を選択してください。Fable 5.1は、Opusの上位に位置する専門的なエスカレーションパスであり、デフォルトの選択肢ではありません。.

これらの推奨事項は、一般的な混合ワークロードを対象としたものです。Anthropicの運用ガイダンスでは、ほとんどのワークロードはOpus 5から開始すべきであるとされていますが、同社のタスクマトリックスでは、日常的な高速かつ高機能な作業にはSonnetが適していると別途位置づけられています。したがって、適切な出発点は、単にモデル名だけでなく、お客様のリスク許容度や評価プロセスによって決まります。.

GlobalGPTは、より広範なワークフローを実現します 手頃な価格の1つのサブスクリプションで実用性を発揮:Claude、GPT-5.6 Sol、Gemini 3 Pro、Kimi K3、そして複数のAI機能が、リサーチ、執筆、分析、コーディング、および改良のための単一のダッシュボードを共有します。 また、そのCLIを利用すれば、ターミナルや開発ワークフロー、既存の運用ツールからでもモデルにアクセスできます。出力の比較はワークフローにおいて有用な要素の一つです。より広範なファミリーレベルの選択肢については、当社の ChatGPT、Claude、Geminiの比較. 。このガイドの残りの部分では、Claudeの範囲内での選択に焦点を当てます。.

Claudeモデル:手短な解説

現在の4つの階層は、それぞれ異なる経済的な課題を解決しています。通話料金が最も安いからといって、必ずしもタスクの完了コストが最も安いとは限らず、また、最も高性能なモデルが、必ずしも予算の最適な活用になるとは限りません。.

Claudeモデルの選定ガイド

作業負荷と障害コストに基づいて選択する

Sonnetは、バランスの取れた日常業務に使用し、効率を重視する場合は下位のモデルに切り替え、検証が困難な場合やミスが大きな損失につながる場合は上位モデルに切り替えてください。.

俳句 4.5

効率第一

エラーの検出や修正にコストがかからず、処理量が大きく、レイテンシに敏感で、範囲が明確に定義されたタスクについては、ここから始めてください。.

次の段階に進むのは、いつエッジケースやレビュー担当者による修正の時間が、トークン価格の優位性を打ち消してしまう。.

ソネット第5番

日々のバランス

通常の評価対象となる、執筆、分析、コーディング、視覚的理解、およびツールの活用を組み合わせた課題に使用してください。.

次の段階に進むのは、いつ長期的な視点での推論、検証、あるいは失敗に伴うコストが、制約要因となる。.

作品第5番

機能第一

複雑なエージェントコーディング、大規模なプロジェクト、困難な診断、あるいは誤ると大きな損失を招くような意思決定については、まずここから始めてください。.

次の場合に下に移動しますより安価なモデルが、同じ受入検査を繰り返しクリアしている。.

Fable 5.1

例外パス

より高度な推論や長時間かかるエージェント作業の場合に限り、より手間のかかるOpusでも評価基準を満たさない場合にのみ、エスカレーションを行ってください。.

決めつけないでください品質、レビュー時間、再試行回数を考慮すると、上位のティアの方が自動的に安くなります。.

実用的なルール

代表的なタスク1つとその受け入れ検査を固定します。確実に合格する最もコストの低いモデルを選び、修正と検証にかかる時間を計測した上で、それを最も安価な選択肢とみなします。.

ソースのスナップショット:Anthropic’s 適切なモデルの選び方 そして モデルの概要, 、2026年9月8日確認。Anthropicによると、ほとんどのワークロードはOpus 5から開始される。そのタスクマトリックスでは、日常業務にはSonnet 5を、最低のレイテンシと価格を実現するにはHaiku 4.5をそれぞれ推奨している。.

現在のClaudeモデルラインナップ

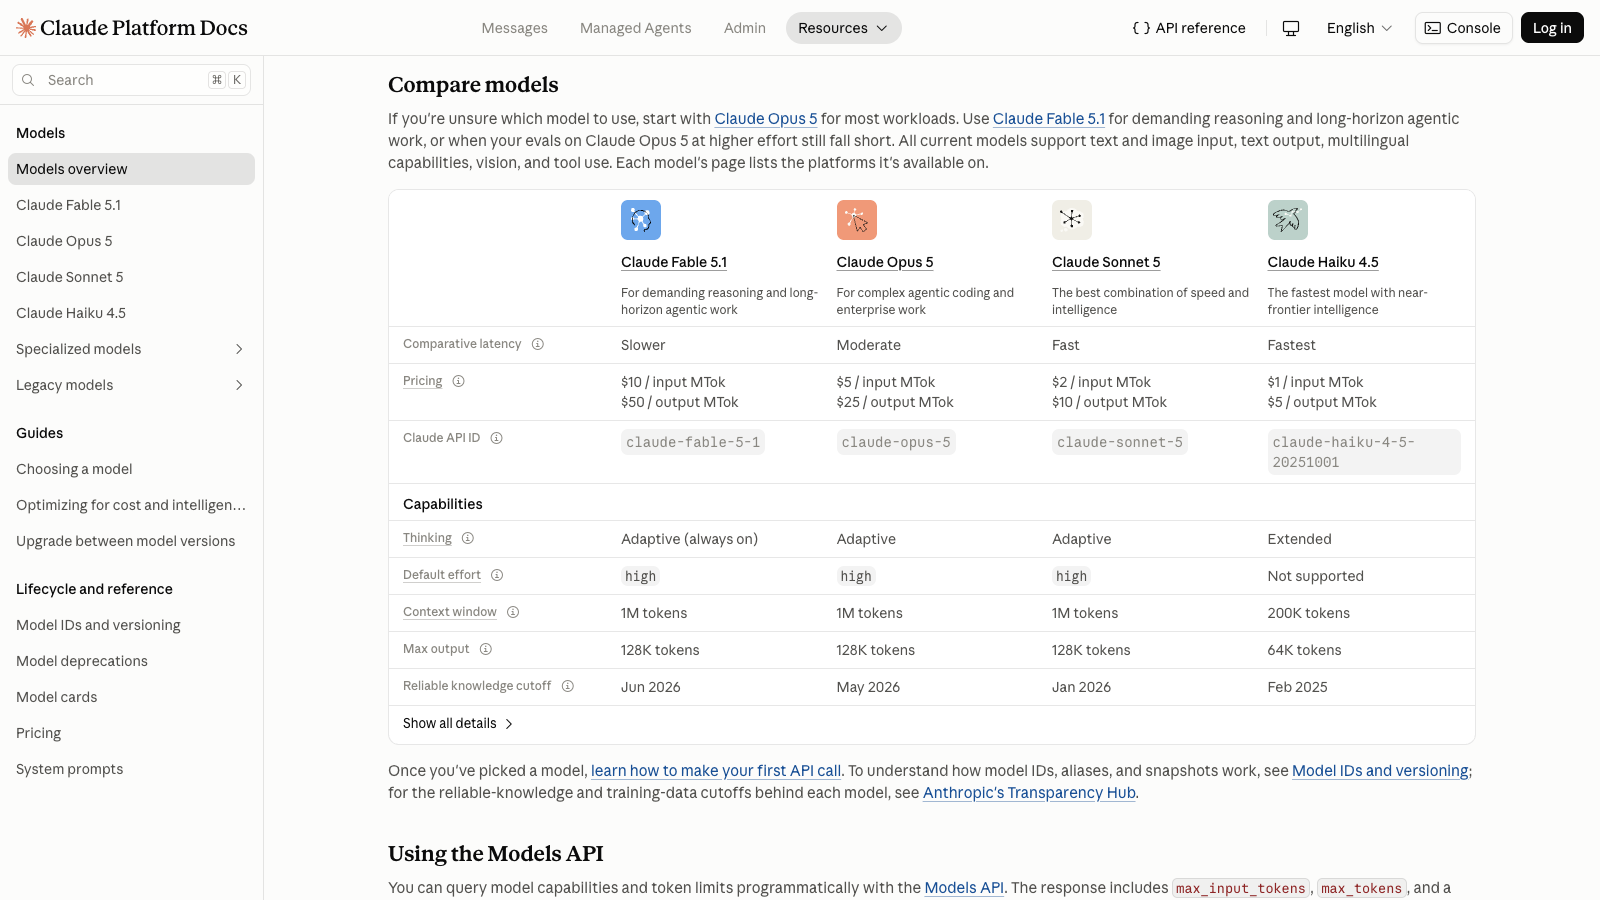
2026年9月8日現在、Anthropicの現行ラインナップには、Claude Haiku 4.5、Claude Sonnet 5、Claude Opus 5、およびClaude Fable 5.1が含まれています。 Haiku、Sonnet、Opusは長きにわたり使用されているファミリー名ですが、各ファミリーに付随するバージョンは時間とともに変化します。ファミリー名だけで常に同じスナップショットを指すと想定するのではなく、本番環境で評価した正確なモデルIDを特定するようにしてください。.

現行モデル公式の速度表示ラベルAPIコンテキスト最大出力基本APIの入力/出力
俳句 4.5最速20万64KMTokあたり $1 / $5
ソネット第5番速い1M128K$2 / $10(MTokあたり)
作品第5番中程度1M128K$5 / $25(MTokあたり)
Fable 5.1遅い1M128K$10 / $50(MTokあたり)
AnthropicおよびClaudeの現行モデルラインナップ(価格、レイテンシ、コンテキスト、出力制限を含む)
Anthropicのモデル概要には、2026年9月8日時点での現行ラインナップとして、Haiku 4.5、Sonnet 5、Opus 5、およびFable 5.1が記載されています。.

Claude.aiへのアクセスは、API仕様とは異なります

Claude.ai のプラン表には、コンシューマー向けのアクセス権限が記載されており、現在、個々のプランについて 200K のコンテキストウィンドウが設定されています。API ドキュメントには、モデルごとのコンテキストおよび出力の制限が記載されており、Sonnet 5、Opus 5、および Fable 5.1 については 1M のコンテキストが設定されています。 API テーブルを用いて特定の Claude.ai プランの内容を推測したり、コンシューマープランのテーブルを用いて API モデルの制限を推測したりしないでください。詳しくは、 Claude 価格およびプランガイド 計画レベルでの区別について。.

Claude Haiku 対 Sonnet 対 Opus:主な違い

主なトレードオフは、単純な品質ランキングによるものではありません。ラインナップの上位に移行すれば、複雑な作業に対する処理能力は向上しますが、その一方で基本トークンコストが増加し、概して処理速度が低下します。また、コンテキストの制限や推論制御についても違いがあります。.

実用上のトレードオフ

公式のラベルおよび基本API仕様に加え、一般的なワークロードに向けた実用的な導入の指針。.

寸法俳句 4.5ソネット第5番作品第5番
最適な出発点高速で、繰り返し行われ、範囲が限定された処理日常的な知識労働の混合型複雑で重大な結果を伴う業務
公式の速度表示ラベル最速速い中程度
APIのコンテキスト/出力200K / 64K1M / 128K1M / 128K
推論制御手動による拡張思考柔軟な思考と努力柔軟な思考と努力
APIの基本価格$1 入力 / $5 出力$2 入力 / $10 出力$5入力/$25出力

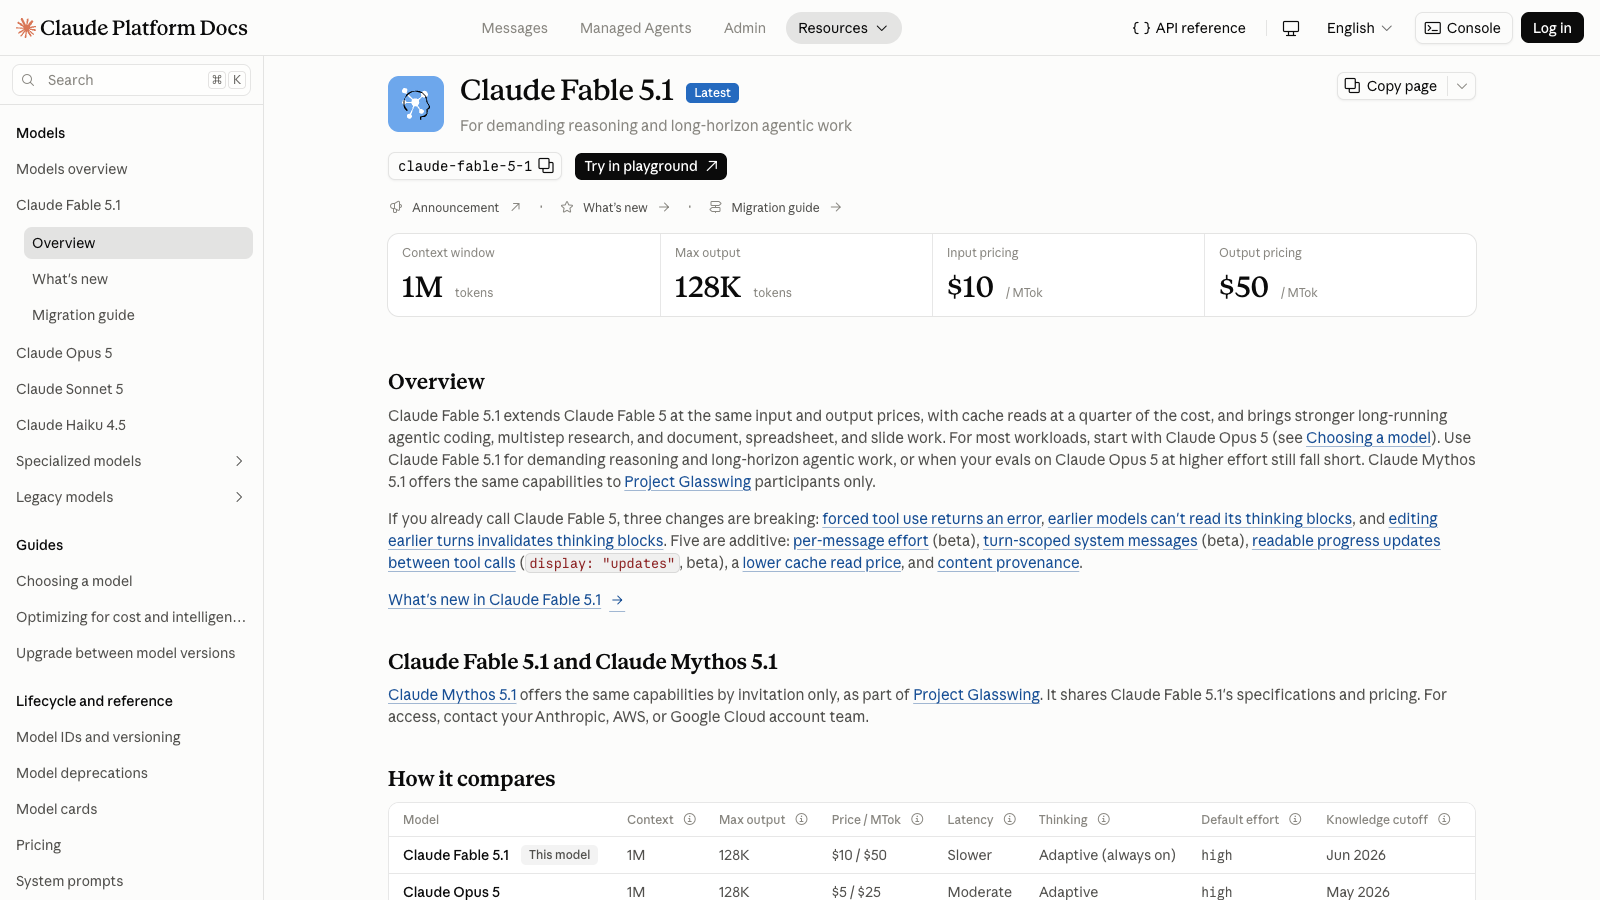
『Fable』がどのような位置づけにあるか: Fable 5.1は正式には「Slower」と分類されており、コンテキスト容量は1M、最大出力は128K、100万トークンあたりの基本入出力単価は$10/$50となっています。より高いリソースを投入したOpusでも評価基準を満たせない場合、これをエスカレーション段階として扱ってください。.

スピードとレイテンシー

AnthropicはHaiku 4.5を「最速」、Sonnet 5を「高速」、Opus 5を「中程度」、Fable 5.1を「低速」と評価しています。 これらは定性的な製品ラベルであり、測定されたミリ秒単位や1秒あたりのトークン数ではありません。実際のレイテンシは、リクエストのサイズ、推論設定、ツール、負荷、および提供モードによって異なります。.

文脈、出力、および推論の制御

HaikuのAPIコンテキストは200Kと小さく、最大出力も64Kですが、多くの制約のあるジョブにとっては依然として十分な規模です。 SonnetとOpusは、これらの制限をそれぞれ1Mと128Kまで拡張しています。Haiku 4.5は手動による拡張思考を採用しているのに対し、Sonnet 5とOpus 5は適応型思考と労力制御をサポートしています。この違いこそが、同一の推論設定ではすべてのモデルにおいて完全に同等のテストを作成できない理由の一つです。.

各タスクには、どのClaudeモデルを使用すべきか?

作業量始めようなぜアップグレード時期
分類、抽出、ルーティング、サポートの優先順位付け俳句 4.5低レイテンシと低いベーストークンコストは、明確で再現性の高い作業に適しています。.例外的なケースや修正にかかる時間によって、その節約効果は相殺されてしまう。.
執筆、分析、視覚的理解、日常的なコーディングソネット第5番多様な業務において、スピード、機能、状況、コストのバランスが取れている。.長期的な推論や検証がボトルネックとなる。.
複雑なコーディング、診断の難しさ、自律エージェント作品第5番トークンあたりの価格が最も安いことよりも、機能性が重要です。.より多くの労力を費やしたOpusであっても、厳格な代表的な評価では依然として不合格となっている。.
並外れて長期にわたる作業、あるいは推論を要する作業Fable 5.1これは、Opusより上の現在のエスカレーション経路です。.その高いコストに見合うだけのメリットが得られる場合にのみ使用すること。.

これらはあくまで出発点であり、万能な解決策というわけではありません。たとえば、短時間ではあるもののリスクの高いコード変更にはOpusが適している一方で、時間はかかるものの構造が明確な抽出作業には、依然としてHaikuが適している場合もあります。実用的なワークフローの例については、当社のガイドをご覧ください。 コーディングにはClaudeを使用.

候補リストがClaudeを超える場合、GlobalGPTを使用すれば、1つのワークスペース内でClaude、GPT-5.6 Sol、Gemini 3 Pro、およびKimi K3に対して、同じ代表的なプロンプトを実行することができます。 受け入れ基準は一定に保ってください。反復作業では処理速度が重要ですが、回答の品質と修正にかかる時間が、低コストな結果が実際に安上がりかどうかを決定づけます。.

タスクの種類だけでなく、失敗によるコストも考慮して選択する

課題ラベルは、最も重要な変数、すなわち「答えが間違っていた場合はどうなるのか」という点を隠してしまいます。以下のフレームワークは、Anthropicの「効率最優先」および「能力最優先」という指針に基づいた編集上の判断ツールです。これはAnthropicのベンチマークではありません。.

失敗コストの段階表

エラーの検出コストが低い場合は低い値から始め、検証が不完全またはコストがかかる場合は高い値から始めます。.

低コスト

例
タグ付け、ルーティング、ドラフトの整理、可逆的な要約

開始
俳句 4.5

エスカレート
修正作業によって効率の向上が失われる場合

素材

例
顧客向けの草案、レビュー済みの分析結果、テスト済みの本番用コード

開始
ソネット第5番

エスカレート
レビューでは重要な不具合を確実に検出できない場合

高い

例
自律性の高まりに伴う変化、診断の難しさ、それに伴う重要な決断

開始
作品第5番

エスカレート
「Opus」の評価が凍結され、より高負荷な処理が失敗した場合にのみ、「Fable」に移行する

Claudeモデルのアップグレードやダウングレードを行うタイミング

測定された限界値が表示された場合にのみ、次の段階に進む

俳句とソネット

エッジケース、命令のミス、またはレビュー担当者の修正にかかる時間が、それによる節約効果を上回る場合は、アップグレードを行ってください。.

『オパスへのソネット』

長期的な実行、複雑な推論、検証、あるいは失敗によるコストが制約となる場合は、アップグレードを行ってください。.

より高い負荷でのオパス

トップティアに移行する前に、凍結された受入検査を用いて、負荷の高いワークロードをテストしてください。.

『オパス・トゥ・フェイブル』

より手間のかかるOpusでも代表的な評価で失敗し、かつそのコストに見合うだけのメリットがある場合にのみ、エスカレーションを行う。.

格下げのルール: より安価なモデルが、必要なレイテンシと信頼性を満たした上で、同じ受入検査を繰り返し通過した場合は、そのモデルに切り替えてください。.

Haiku、Sonnet、Opus、Fable における Anthropic モデル選択マトリックス
Anthropicのマトリックスでは、現行のClaudeモデル4機種を、それぞれの機能、速度、およびワークロードの要件に応じて分類しています。.

固定のClaude APIコストの例

複数の標準APIリクエストにわたる、100万個の入力トークンと10万個の出力トークンからなる固定の総ワークロードの場合、基本トークンコストは、Haiku 4.5では$1.50から、Fable 5.1では$15.00の範囲となります。 これは1回のリクエストではなく、リクエストごとの出力制限を上書きするものではありません。.

1つのワークロードに対し、4台のClaudeモデル

現在のティアが上がるにつれて、同じトークンのボリュームは、ハイクの総額の2倍、5倍、あるいは10倍のコストがかかります。.

作業量
入力1.0M + 出力0.1M
複数のリクエストにわたって
モデル入力の計算出力の計算合計
俳句 4.51.0 × $10.1 × $5$1.50
ソネット第5番1.0 × $20.1 × $10$3.00
作品第5番1.0 × $50.1 × $25$7.50
Fable 5.11.0 × $100.1 × $50$15.00

内容: Anthropicの価格スナップショット1つに基づく、標準的なベースの入力および出力トークンレート。.

除外対象: プロンプトのキャッシュ、バッチAPI、高速モード、地域、ツール利用料、税金、割引、およびGlobalGPTクレジット。.

Anthropicのトークン100万単位あたりの米ドル基準レート モデルの価格設定, 、2026年9月8日確認。Sonnet 5の$2入力/$10出力レートは標準価格です。.

価格表にはトークンの費用が記載されており、完成した成果物の費用ではありません。再試行、修正、検証に要するスタッフの時間が、トークンの節約分を上回ってしまう場合、安価なモデルの方がかえって高コストになる可能性があります。.

Claudeモデルの実機テスト:同じプロンプトでも異なる故障モード

2026年9月9日、私たちはAnywhere APIを通じて、Claude Haiku 4.5、Sonnet 5、Opus 5、およびFable 5.1に対し、同じ3つのプロンプトを送信しました。 タスクの内容は、構造化されたサポートのトリアージ、証拠に基づいた文章作成、および監査可能なJavaScriptのデバッグでした。各モデルの最初の有効な出力を抽出し、回答のレビュー前に確定させていたルールに基づいて評価を行いました。.

その結果は、単なる順位付けにとどまりませんでした。「Sonnet」、「Opus」、「Fable」はいずれも30点満点中26.5点で同点でしたが、それぞれの長所と短所は大きく異なっていました。「Haiku」は、すべてのタスクにおいて許可された試行回数の両方でHTTP 503を返したため、このテストではその出力品質は不明のままです。.

試験構成と総合結果

3つの固定プロンプト、同じタスクレベルのトークン制限、ツールや検索機能は使用せず、各モデルについて最初の有効な出力を採用する。.

会場Anywhere API
日付2026年9月9日
タスク体系的なトリアージ、ローンチノート、JavaScriptのデバッグ
再試行ルール転送時、429/5xx、空の内容、または不正な形式のレスポンス
モデル完了したタスク総合品質スコア最も有用なシグナル
クロード・ハイク 4.50/3得点なし許可された6件のリクエストすべてが503を返しました。ルートのみが利用可能です。.
クロード・ソネット第5番3/326.5/30発売時の要件をすべて満たす唯一のモデル。.
Claude Opus 53/326.5/30デバッグの徹底度が高い。書き込み長さの制約を見落としていた。.
Claude Fable 5.13/326.5/30構造化された出力がクリーンです。起動時のメモは、1つの空の応答の後に切り捨てられていました。.
採点対象となった3つのモデルは、いずれも30点満点中26.5点で同点となりましたが、その理由はそれぞれ異なります。これはタスクプロファイルに基づく結果であり、モデル全体の総合的な順位を示すものではありません。Haikuについては、採点対象となる出力結果がなかったため、この同点の結果からは除外されています。.

構造化出力

テスト1:サポートチケットの優先度判定

課題の結果:Fable 5.1、10/10

「Fable」は、6つのラベルとアクションすべてが正しい状態で、直接解析可能なJSONを返した唯一のモデルでした。「Opus」と「Sonnet」はラベルは正しく処理しましたが、Markdownのフェンスを追加してしまいました。また、両モデルとも指定された締め切りを1つ厳格化し、「Sonnet」は時期尚早に修正または返金を約束してしまいました。.

モデルステータススコアあらゆる場所での遅延報告されたトークン何が起きたのか
クロード・ハイク 4.5ルートが利用できません得点なし入手不可入手不可503レスポンスが2件。品質スコアはなし。.
クロード・ソネット第5番出力は保持されました7.5/1010.39秒1005ラベルは正しいが、JSONが囲まれており、払い戻し・修正の結果が架空のものとなっている。.
Claude Opus 5出力は保持されました8.5/1011.87秒1051適切なラベル付けと強力な措置は評価できるが、JSONの制限と期限の厳格化が必要だ。.
Claude Fable 5.1出力は保持されました10/108.55秒680JSONとして直接解析可能。すべてのフローズンチェックに合格しました。.
テスト入力の全文
SaaSのサポート受信箱を管理しています。 以下のすべてのチケットを分類してください。返却するJSONには、トップレベルフィールドとして「tickets」という名前のフィールドを1つだけ含めてください。「tickets」は元の順序のままの配列でなければならず、各要素には必ず「ticket_id」、「category」、「urgency」、「action」が含まれていなければなりません。「category」は「billing」、「access」、「bug」、「feature」のいずれかでなければなりません。「urgency」は「low」、「medium」、「high」のいずれかでなければなりません。 チケットの本文のみを使用してください。ポリシーの適用結果や顧客に関する事実を推測して追加しないでください。

#481: 同じ年間更新料が二重に請求されました。給与計算の締め切りは金曜日ですので、それまでに調査をお願いします。
#482: パスワード再設定の通知でメールが送信されたと表示されていますが、届いていません。スパムフォルダを確認し、一度再送信を試みました。
#483: CSV エクスポートでは通貨金額がすべてドル単位に丸められていますが、ダッシュボードには依然としてセント単位が表示されています。
#484: 分析ダッシュボードにダークモードを追加してください。
#485: 今朝、当社のドメインが変更された後、全従業員がSSOアクセス拒否のメッセージを受け取っています。
#486: 先月の請求書のコピーを送っていただけますか?
Claude Haiku 4.5:完全稼働時の実績
モデルの出力結果は生成されませんでした。許可された「Anywhere API」への2回のリクエストはいずれもHTTP 503を返したため、このルートは利用不可とマークされ、品質スコアの評価対象から除外されました。.
Claude Sonnet 5:フル出力
```json
{
  "tickets": [
    {
 "ticket_id": "#481",
      "category": "billing",
 "urgency": "high",
 "action": "重複して請求された年間更新料金について調査し、金曜日の顧客の給与計算締め切りまでに修正または返金を行う。"
    },
    {
 "ticket_id": "#482",
      "category": "access",
 "urgency": "medium",
 "action": "アカウントのメールアドレスとメール配信状況を検証し、パスワードリセットメールを手動で送信または再送信する。"
    },
    {
 "ticket_id": "#483",
      "category": "bug",
 "urgency": "medium",
 "action": "CSVエクスポート時の四捨五入を修正し、通貨値がダッシュボードに表示されるセント単位の精度と一致するようにするため、エンジニアリングチームにエスカレーションしてください。」
    },
    {
 "ticket_id": "#484",
 "category": "feature",
 "urgency": "low",
 "action": "アナリティクスダッシュボードのダークモード実装リクエストを記録し、製品の機能バックログに追加する。"
    },
    {
 "ticket_id": "#485",
      "category": "access",
 "urgency": "high",
 "action": "変更された会社ドメインに関連するSSO設定を直ちに調査し、影響を受けた全従業員のアクセス権を復旧する。」
    },
    {
      "ticket_id": "#486",
 "category": "billing",
 "urgency": "low",
 "action": "先月の請求書を探し出し、そのコピーを顧客に送付する。"
    }
  ]
}
```
Claude Opus 5:フル出力
```json
{
  "tickets": [
    {
 "ticket_id": "481",
 "category": "billing",
 "urgency": "high",
 "action": "重複した年間更新料金を確認するため、請求部門にエスカレーションし、顧客の金曜日の給与計算締め切りまでに解決を確認すること。"
    },
    {
 "ticket_id": "482",
      "category": "access",
 "urgency": "medium",
 "action": "そのアドレス宛てのリセットメッセージのメール配信ログを確認し、未配信の場合は、ユーザーに対して検証済みリセット手順を実行する。"
    },
    {
 "ticket_id": "483",
      "category": "bug",
 "urgency": "medium",
 "action": "CSVエクスポート時の通貨端数処理に関するバグを報告し、ダッシュボードの値との不一致を指摘するとともに、再現手順またはエクスポートサンプルを依頼する。"
    },
    {
 "ticket_id": "484",
 "category": "feature",
 "urgency": "low",
 "action": "アナリティクスダッシュボードのダークモード機能リクエストとして登録し、スケジュールについては確約せずに受領確認を行う。"
    },
    {
 "ticket_id": "485",
      "category": "access",
 "urgency": "high",
 "action": "ドメイン変更に伴う組織全体のSSO障害としてエスカレーションし、ID/認証チームにSSOドメイン設定の即時確認を依頼する。"
    },
    {
      "ticket_id": "486",
 "category": "billing",
 "urgency": "low",
 "action": "要求された前月の請求書のコピーを、確認済みのアカウント担当者へ送信する。"
    }
  ]
}
```
Claude Fable 5.1:フル出力
{"tickets":[{"ticket_id":"481","category":"billing","urgency":"high","action":"報告された年間更新料金の二重請求について調査し、顧客の金曜日の給与支払期限までに回答すること。"},{"ticket_id":"482","category":"access","urgency":"medium","action":"ユーザーのメールアドレスに関するパスワードリセットメールの配信ログを確認し、再送信するか、別のリセット方法を案内する。"},{"ticket_id":"483","category":"バグ","urgency":"中","action":"CSVエクスポート時、通貨金額がドル単位の整数に丸められる現象を再現し、修正のためエンジニアリングチームにエスカレーションする。"},{"ticket_id":"484","category":"機能","urgency":"low","action":"アナリティクスダッシュボードのダークモード導入リクエストをプロダクトチームに記録し、受領確認を行う。"},{"ticket_id":"485","category":"access","urgency":"high","action":"ドメイン変更に伴う全社的なSSOアクセス拒否エラーをエスカレーションし、SSOドメインの設定を確認する。"},{"ticket_id":"486","category":"billing","urgency":"low","action":"先月の請求書のコピーを探し出し、顧客に送付する。"}]}

「最初の有効な出力」ポリシー。レイテンシはAnywhereを通過する実時間であり、ネイティブのAnthropicレイテンシではありません。トークン数はプロバイダーから報告されたものであり、このルートからは直接的なAPIコストは推測されません。.

制約の追従

テスト2:エビデンスに基づくローンチノート

課題の結果:Sonnet 5、10/10

Sonnetは、すべての「凍結」要件を満たした唯一のモデルでした。Opusは説得力のあるメモを生成しましたが、文字数制限を超過しており、回答しなかったユーザーは全員在籍学生であると推測していました。Fableの最初の応答は空でしたが、許容された再試行の結果、推奨事項や注意書きが明らかに省略されたメモが返されました。.

モデルステータススコアあらゆる場所での遅延報告されたトークン何が起きたのか
クロード・ハイク 4.5ルートが利用できません得点なし入手不可入手不可503レスポンスが2件。品質スコアはなし。.
クロード・ソネット第5番出力は保持されました10/109.94秒796「範囲」「構成」「根拠」「提言」「注意点」という要件を満たしている。.
Claude Opus 5出力は保持されました8/109.49秒826分析は的確だが、「固定文字数方式」では223語不足しており、根拠のない推論が1つある。.
Claude Fable 5.1出力は保持されました6.5/1019.27秒1685最初の応答は空でした。保持された再試行は、推奨事項と注意事項の前に切り捨てられました。.
テスト入力の全文
以下の事実のみを用いて、プロダクトディレクター向けの180~220語の社内ローンチメモを作成してください。メモには、件名、短い冒頭段落、正確に3つの箇条書き、推奨事項、および明確に表記された注意点1つを含めてください。予算案、割合、統計的有意性、因果関係については、架空のものを盛り込まないでください。

事実:
- パイロットプログラムには120名の学生が参加した。
- 3月31日のチェックポイント時点で、96名の学生が少なくとも3回のセッションに参加していた。
- 71名の回答者によるアンケートの平均スコアは5点満点中4.3点だった。
- プログラム運営シートには、予算として$18,000と記載されている。
- 財務承認書には$20,000と記載されている。この差が修正によるものか、記録上の誤りかは明記されていない。
- 参加者は無作為に割り当てられておらず、ベースラインスコアも収集されていない。
- 決定すべき事項は、第2回パイロットを実施するか否かであり、恒久的に展開するか否かではない。.
Claude Haiku 4.5:完全稼働時の実績
モデルの出力結果は生成されませんでした。許可された「Anywhere API」への2回のリクエストはいずれもHTTP 503を返したため、このルートは利用不可とマークされ、品質スコアの評価対象から除外されました。.
Claude Sonnet 5:フル出力
**件名:パイロットプログラムの結果 — 第2回パイロット実施に関する提言**

第1回パイロットプログラムは最初のチェックポイント期間を終了し、初期の参加状況や満足度に関する指標は好調です。第2回パイロットを実施する決定を下す前に、チームで共同して検討すべきデータや未解決事項がいくつかあります。

- 登録した120名の学生のうち、3月31日時点のチェックポイント時点で、96名が少なくとも3回のセッションに参加していました。
- 71名の回答者がセッション後に回答したアンケートでは、5点満点中平均4.3点のスコアが得られました。
- 予算数値が文書間で一致していません。プログラム運営シートには「$18,000」と記載されているのに対し、財務承認メモには「$20,000」と記載されています。これが修正によるものか、記録ミスによるものかは不明です。

**提言:** 出席状況およびアンケート結果を踏まえ、より広範な展開の決定を検討する前に、より体系的なデータ(理想的には、明確に定義された対照群とベースライン測定を含む)を収集するための第2回パイロットを実施することを推奨する。この第2回パイロットは、予算が確定する前に、財務部門と協力して予算の不一致を解消する機会としても活用すべきである。

**留意点:** これらの結果は慎重に解釈する必要があります。参加者は無作為に割り当てられておらず、ベースラインスコアも収集されていないため、アンケート結果や出席パターンをプログラムそのものに起因するものと断定することはできません。これは第2回パイロット実施に向けた範囲設定の決定であり、恒久的な導入に関する決定ではありません。.
Claude Opus 5:フル出力
**件名:パイロット試験の結果および第2回パイロット試験の実施に関する提言**

第1回パイロット試験は3月31日のチェックポイントを完了し、第2回パイロット試験を実施するかどうかを判断するのに十分な情報が得られました。本報告書では、観察結果、提言、および解釈上の主な制約について要約します。 現段階では、本導入に関する決定は行われていません。

- **参加登録と参加状況:** 120名の学生が登録しました。3月31日のチェックポイント時点で、そのうち96名が少なくとも3回のセッションに参加していました。
- **参加者のフィードバック:** 参加後のアンケートでは、71名の回答者に基づき、5点満点中平均4.3点でした。残りの登録学生からは回答がなかったため、このスコアは回答者グループのみを反映したものです。
- **予算の不一致:** プログラム運営シートには予算として$18,000と記載されているのに対し、財務承認メモには$20,000と記載されている。 財務承認書には、この差異が修正によるものか、記録上の誤りによるものかは明記されておらず、どちらの数値が正式なものかについては未解決のままです。

**提言:** 支出を確定する前に、財務部門とプログラム運営部門が2つの予算数値を照合し、正式な数値を1つに確定することを条件として、第2回パイロット事業の計画を進めてください。 第2回パイロット事業では、参加時のベースラインスコアも収集すべきです。

**注意点:** 参加者は無作為に割り当てられておらず、ベースラインスコアも収集されていません。したがって、参加率やアンケート結果の数値は、このグループが実際に行ったことや報告した内容を反映しているに過ぎず、プログラムがどのような効果をもたらしたか、あるいは異なる対象集団でどのような成果が得られるかを示すものではありません。.
Claude Fable 5.1:フル出力
**件名:** パイロット事業の中間評価と第2次パイロット実施に関する提言

[ディレクター]様、

以下に、3月31日時点の中間評価におけるパイロット事業の現状概要と、第2次パイロットへ進むべきかどうかの提言を記載します。本報告書は、第2次パイロットの実施判断についてのみを扱っており、恒久的な展開については対象外です。

- **登録および出席状況:** 120名の学生が登録しました。3月31日のチェックポイント時点で、96名が少なくとも3回のセッションに出席していました。
- **参加者からのフィードバック:** アンケート調査では、71名の回答者から5点満点中平均4.3点の評価が得られました。
- **予算記録:** プログラム運営シートには予算として$18,000と記載されている一方、財務承認メモには$20,000と記載されています。財務メモには、この差異が予算修正によるものか、記録上の誤りであるかは明記されていません。

**

「最初の有効な出力」ポリシー。レイテンシはAnywhereを通過する実時間であり、ネイティブのAnthropicレイテンシではありません。トークン数はプロバイダーから報告されたものであり、このルートからは直接的なAPIコストは推測されません。.

コードの正確性

テスト 3:監査可能な JavaScript デバッグ

課題の結果:Opus 5 と Fable 5.1 が同点、10/10

利用可能な3つのモデルはすべて欠陥を検出し、8つの実行可能ケースに合格した代替コードを生成しました。OpusとFableは有効なJSONを返し、10/10で同点となりました。Sonnetのコードも合格しましたが、周囲のMarkdownフェンスが「直接JSON」という要件を満たしていませんでした。.

モデルステータススコアあらゆる場所での遅延報告されたトークン何が起きたのか
クロード・ハイク 4.5ルートが利用できません得点なし入手不可入手不可503レスポンスが2件。品質スコアはなし。.
クロード・ソネット第5番出力は保持されました9/1013.17秒1471代替案は8件中8件のテストを通過したが、フェンス出力ではJSON形式の要件を満たせなかった。.
Claude Opus 5出力は保持されました10/1020.17秒1826JSONは有効であり、2つの不具合が特定され、8件の実行可能ケースすべてが成功しました。.
Claude Fable 5.1出力は保持されました10/1015.89秒1409有効なJSON、簡潔な診断、そして8件の実行可能ケースすべてに合格しました。.
テスト入力の全文
このJavaScript関数を診断し、修正してください。JSONは、root_cause(文字列)、replacement(完全な置換関数を含む文字列)、tests(テストケースの文字列の配列)、remaining_risk(文字列)の、正確に4つのフィールドのみを含む形で返してください。テストを実行したとは主張しないでください。契約を満たす、最小限かつ明確な修正を行ってください。

仕様:
- `tasks` は、プロミスを返す引数なしの関数の配列です。
- 値が 0、false、または空の文字列であっても、入力順で最初に履行された値を返してください。
- 拒否されたタスクは無視してください。
- すべてのタスクが拒否された場合、または配列が空の場合は null を返してください。

現在のコード:
async function firstSuccessful(tasks) {
  const results = await Promise.all(tasks.map((task) => task()));
  return results.find(Boolean) || null;
}
Claude Haiku 4.5:完全稼働時の実績
モデルの出力結果は生成されませんでした。許可された「Anywhere API」への2回のリクエストはいずれもHTTP 503を返したため、このルートは利用不可とマークされ、品質スコアの評価対象から除外されました。.
Claude Sonnet 5:フル出力
```json
{
  "root_cause": "Two bugs: (1) Promise.all rejects immediately if any task rejects, instead of ignoring rejected tasks; (2) results.find(Boolean) incorrectly treats falsy fulfilled values (0, false, '') as failures, causing them to be skipped in favor of null.",
  "replacement": "async function firstSuccessful(tasks) {\n  const settled = await Promise.allSettled(tasks.map((task) => task()));\n  const firstFulfilled = settled.find((r) => r.status === 'fulfilled');\n  return firstFulfilled ? firstFulfilled.value : null;\n}",
  "tests": [
    "test('returns null for empty array', async () => { expect(await firstSuccessful([])).toBeNull(); });",
    "test('returns null when all tasks reject', async () => { const tasks = [() => Promise.reject('err1'), () => Promise.reject('err2')]; expect(await firstSuccessful(tasks)).toBeNull(); });",
    "test('returns first fulfilled value even if falsy (0)', async () => { const tasks = [() => Promise.resolve(0), () => Promise.resolve(42)]; expect(await firstSuccessful(tasks)).toBe(0); });",
    "test('returns first fulfilled value even if false', async () => { const tasks = [() => Promise.resolve(false), () => Promise.resolve(true)]; expect(await firstSuccessful(tasks)).toBe(false); });",
    "test('returns first fulfilled value even if empty string', async () => { const tasks = [() => Promise.resolve(''), () => Promise.resolve('nonempty')]; expect(await firstSuccessful(tasks)).toBe(''); });",
    "test('ignores leading rejected tasks and returns first fulfilled in order', async () => { const tasks = [() => Promise.reject('err'), () => Promise.resolve('second'), () => Promise.resolve('third')]; expect(await firstSuccessful(tasks)).toBe('second'); });",
    "test('preserves input order even if later task resolves faster', async () => { const tasks = [() => new Promise((res) => setTimeout(() => res('slow-first'), 50)), () => new Promise((res) => setTimeout(() => res('fast-second'), 5))]; expect(await firstSuccessful(tasks)).toBe('slow-first'); });"
  ],
  "remaining_risk": "The fix assumes 'first fulfilled value in input order' means the first task by array index that fulfills, regardless of timing, which matches the contract wording but await Promise.allSettled waits for all tasks to complete (including slow ones) before returning, which may not be desired if early-exit performance is needed; also unhandled promise rejection warnings are avoided by allSettled, but if tasks throw synchronously instead of returning rejected promises, this is not explicitly tested here beyond the reject cases."
}
```
Claude Opus 5:フル出力
{
  "root_cause": "Two defects. (1) `Promise.all` rejects as soon as any task rejects, so a single rejected task makes the whole function reject instead of ignoring it and returning a later fulfilled value. (2) `results.find(Boolean) || null` selects by truthiness rather than by fulfillment, so legitimate fulfilled values such as 0, false, '', NaN, null, or undefined are skipped and/or coerced to null. Using `Promise.allSettled` plus a status check on the settled records fixes both, and returning `record.value` directly preserves falsy results.",
  "replacement": "async function firstSuccessful(tasks) {\n  const results = await Promise.allSettled(tasks.map((task) => task()));\n  const firstFulfilled = results.find((result) => result.status === 'fulfilled');\n  return firstFulfilled ? firstFulfilled.value : null;\n}",
  "tests": [
    "firstSuccessful([]) resolves to null (empty input).",
    "firstSuccessful([() => Promise.resolve('a'), () => Promise.resolve('b')]) resolves to 'a' (input order, not completion order).",
    "firstSuccessful([() => new Promise((res) => setTimeout(() => res('slow-first'), 50)), () => Promise.resolve('fast-second')]) resolves to 'slow-first' (order is by index, not by who settles first).",
    "firstSuccessful([() => Promise.reject(new Error('boom')), () => Promise.resolve('second')]) resolves to 'second' (rejection ignored, does not propagate).",
    "firstSuccessful([() => Promise.reject(new Error('a')), () => Promise.reject(new Error('b'))]) resolves to null (all reject).",
    "firstSuccessful([() => Promise.resolve(0)]) resolves to 0, not null (falsy number preserved).",
    "firstSuccessful([() => Promise.resolve(false)]) resolves to false (falsy boolean preserved).",
    "firstSuccessful([() => Promise.resolve('')]) resolves to '' (empty string preserved).",
    "firstSuccessful([() => Promise.resolve(undefined), () => Promise.resolve('later')]) resolves to undefined (first fulfilled wins even if its value is undefined).",
    "firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve(null), () => Promise.resolve('third')]) resolves to null because index 1 fulfilled with null — verifying null-as-value is not confused with the all-rejected sentinel by inspecting status.",
    "firstSuccessful([() => Promise.resolve(NaN)]) resolves to NaN (Number.isNaN on the result is true)."
  ],
  "remaining_risk": "The function still starts every task and awaits all of them, so there is no short-circuiting: a slow or never-settling later task delays or blocks the result, and side effects of later tasks always occur. A task that throws synchronously (rather than returning a rejected promise) will throw inside `tasks.map`, causing the returned promise to reject instead of being ignored; wrap the invocation in `Promise.resolve().then(task)` if that must also be tolerated. `null` is still returned both for all-rejected/empty input and when a task genuinely fulfills with `null`, so callers cannot distinguish those cases. Non-array or non-function inputs are not validated, and rejection reasons are discarded rather than aggregated (no AggregateError), which can hide diagnostics."
}
Claude Fable 5.1:フル出力
{"root_cause":"Two defects: (1) Promise.all rejects as soon as any task rejects, so rejected tasks are not ignored and the function throws instead of skipping them; (2) results.find(Boolean) skips legitimate falsy fulfilled values (0, false, '') and the trailing '|| null' also converts such values to null, violating the requirement to return the first fulfilled value even when it is falsy.","replacement":"async function firstSuccessful(tasks) {\n  const results = await Promise.allSettled(tasks.map((task) => task()));\n  const first = results.find((result) => result.status === 'fulfilled');\n  return first ? first.value : null;\n}","tests":["firstSuccessful([]) resolves to null","firstSuccessful([() => Promise.resolve('a'), () => Promise.resolve('b')]) resolves to 'a'","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve('b')]) resolves to 'b' and does not throw","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.reject(new Error('y'))]) resolves to null","firstSuccessful([() => Promise.resolve(0), () => Promise.resolve(5)]) resolves to 0","firstSuccessful([() => Promise.resolve(false), () => Promise.resolve(true)]) resolves to false","firstSuccessful([() => Promise.resolve(''), () => Promise.resolve('z')]) resolves to ''","firstSuccessful([() => Promise.reject(new Error('x')), () => Promise.resolve(null)]) resolves to null (fulfilled null is returned as-is)","firstSuccessful([() => new Promise(r => setTimeout(() => r('slow'), 50)), () => Promise.resolve('fast')]) resolves to 'slow' (input order wins over settlement order)"],"remaining_risk":"All tasks are started concurrently and the function waits for every task to settle before returning, so a slow task delays the result even when an earlier task has already fulfilled; a sequential or early-exit strategy would be needed if latency matters. A task that throws synchronously (rather than returning a rejected promise) will still cause the function to reject, since the contract assumes tasks return promises. Promise.allSettled requires ES2020 or a polyfill."}

「最初の有効な出力」ポリシー。レイテンシはAnywhereを通過する実時間であり、ネイティブのAnthropicレイテンシではありません。トークン数はプロバイダーから報告されたものであり、このルートからは直接的なAPIコストは推測されません。.

これらの「Anywhere」の結果は、モデルの選択が単一のリーダーボードではなく、タスクに応じて行われるべき理由を示しています。GlobalGPTでは、Claudeやその他の主要モデルに対して、自身のプロンプトに同じ比較手法を適用し、品質基準、速度要件、およびレビューの作業負荷に最も適した出力を選択することができます。.

比較を公平に行う方法

  1. 代表的なタスクを凍結する。. 意図、ソース資料、ツールへのアクセス、および目的の適合性チェックについては、これまでと同じものを使用してください。.
  2. 最初の有効な出力を記録してください。. 一次比較において、あるモデルに対してこっそりと追加の再試行を行ってはならない。.
  3. 品質と可用性を区別する。. 認証、処理能力、および経路の障害については、品質スコアではなく、可用性に関する注記に記載すべきです。.
  4. ワークフロー全体を測定する。. 経過時間、レビュー担当者の作業時間、修正時間、およびタスク失敗時の復旧時間を計測する。.
  5. 最も安価な通過モデルを選択してください。. プロンプト、ツール、モデルのバージョン、または失敗によるコストに変更があった場合は、再テストを行ってください。.

GlobalGPTの活用場面

Anthropic:Opus 5の代わりにClaude Fable 5.1を選択すべき場合に関するガイダンス
Anthropicは、より高負荷なOpus 5の評価でもまだ不十分な場合、要求の厳しい作業にFable 5.1を割り当てます。.

上位層についてさらに詳しく知りたい方は、当社の 高度なClaudeモデルの比較 または、専用の Claude Fable 5.1 ガイド.

よくある質問

現在、Claudeモデルにはどのようなものがありますか?

2026年9月8日現在、Anthropicの現行ラインナップには、Claude Haiku 4.5、Claude Sonnet 5、Claude Opus 5、およびClaude Fable 5.1が含まれています。 正確なバージョンやモデルIDは変更される可能性があるため、導入前に公式のモデル概要を再度ご確認ください。.

Claude Haiku、Sonnet、Opusの違いは何ですか?

Haikuは速度と低い基本トークンコストを重視し、Sonnetは日常業務における速度と機能性のバランスを重視し、Opusは複雑または影響の大きいタスクにおける機能性を重視しています。適切な選択は、絶対的な順位ではなく、ワークロードや検証コストによって決まります。.

一般的な作業には、Claudeシリーズのどのモデルを使えばよいでしょうか?

日常的な執筆、分析、コーディング、視覚的理解、ツールの使用といった作業のほとんどについては、まずは「Sonnet 5」から始めてください。一方、失敗の代償が大きい場合や、より深い推論や厳密な検証を必要とする作業については、代わりに「Opus 5」から始めてください。.

コーディングには、どのClaudeモデルが最適ですか?

Sonnet 5は、通常のレビューやテストを伴う日常的なコーディングにおいて、実用的な出発点となります。困難な診断、複雑なエージェント指向のコーディング、長期的な実行、あるいは誤りが大きな代償を伴う変更については、Opus 5を使用してください。.

Claudeシリーズの中で、執筆にはどのモデルが最適ですか?

Sonnet 5は、ほとんどの起草や編集作業において、バランスの取れた出発点となります。Haiku 4.5は、分量が多く、きっちりと構成された文章に適しています。一方、Opus 5は、複雑な統合が必要な場合や、検証が困難な重要な資料については、試してみる価値があります。.

Claude SonnetはOpusより優れているのでしょうか?

必ずしもそうとは限りません。Sonnet 5は基本API料金においてより高速かつ安価ですが、AnthropicはOpus 5がより複雑な作業に対応できるように設計されています。最適なモデルとは、ご自身の受け入れ基準を確実に満たす中で、最も安価な選択肢のことです。.

Claude FableはOpusに取って代わるのでしょうか?

No. Anthropicは、より高度な推論や長時間かかるエージェント作業において、より労力を要するOpus 5でも対応しきれない場合に、そのエスカレーション段階としてFable 5.1を位置づけており、Opusの万能な代替手段として位置づけているわけではない。.

Claude.ai と Claude API は、同じコンテキストウィンドウを使用していますか?

No. Claude.ai のプラン制限と API モデルの仕様は別個のものとなっています。Anthropic の個別プラン表には現在、20万のコンテキストウィンドウが記載されていますが、API ドキュメントには、Sonnet 5、Opus 5、および Fable 5.1 について 100万のコンテキストが記載されています。.

HaikuからSonnetやOpusへのアップグレードは、いつ行うべきでしょうか?

受け入れチェックに不合格となった場合、処理が困難なエッジケース、修正にかかる時間、検証の労力、あるいはエラーによるコストが、低性能モデルの処理速度やトークン価格の優位性を上回るようになったら、より高性能なモデルにアップグレードしてください。より安価なモデルが、同じ凍結チェックを繰り返し通過できるようになった場合は、再び低性能なモデルに戻してください。.

API経由でClaude Haiku、Sonnet、Opusを利用する場合、料金はいくらですか?

2026年9月8日に確認されたAnthropicの基本レートによると、Haiku 4.5のコストは入力$1、出力$5であり、Sonnet 5のコストは$2および$10、 また、Opus 5は100万トークンあたり$5と$25のコストがかかります。Anthropicの 公式価格ページ 現在の料金およびその他の料金体系については、こちらをご覧ください。.

最終的な結論:基準を満たす最安モデルから始める

一般的な混合作業においては、Sonnet 5が依然として最も実用的なデフォルト設定であり、当社のテストにおいて、すべての起動時の制約条件を満たした唯一のモデルでした。 Opus 5とFable 5.1は、それぞれ異なる強みによってSonnetの総合スコア26.5/30に並んだ一方、Haiku 4.5は、許可されたすべての試行においてAnywhereルートが503を返したため、スコアを算出することができませんでした。これらの結果は、恒久的な普遍的なランキングではなく、ワークロードに関する参考情報として捉えてください。.

次のステップは簡単です。実際のタスクを1つ固定し、合格基準を明確に定義した上で、有力な候補をすべて同等の条件下で実行し、最終コストには修正にかかる時間も含めます。勝者となるモデルは、トークン単価が最も安いモデルや、最も有名なティア名を持つモデルではなく、確実に合格できる中で最もコストの低いモデルです。.

GlobalGPTは、その手法をより広範で手頃な価格のAIワークフローの一部として組み込みます。 Claude、GPT-5.6 Sol、Gemini 3 Pro、Kimi K3 などの主要モデルを、1つのダッシュボード上で複数のAI機能と共に利用し、GlobalGPT CLIを通じて、その作業をターミナル、開発ワークフロー、および既存の生産ツールへと引き継ぐことができます。 並行テストにより適切なモデルを選択できるだけでなく、ワークフロー全体をシームレスに連携させられることが、さらなる大きなメリットとなります。.

記事を共有する

関連記事