
Claude Opus 5.5 レビュー:価格、ベンチマーク、および実際のAPIテスト
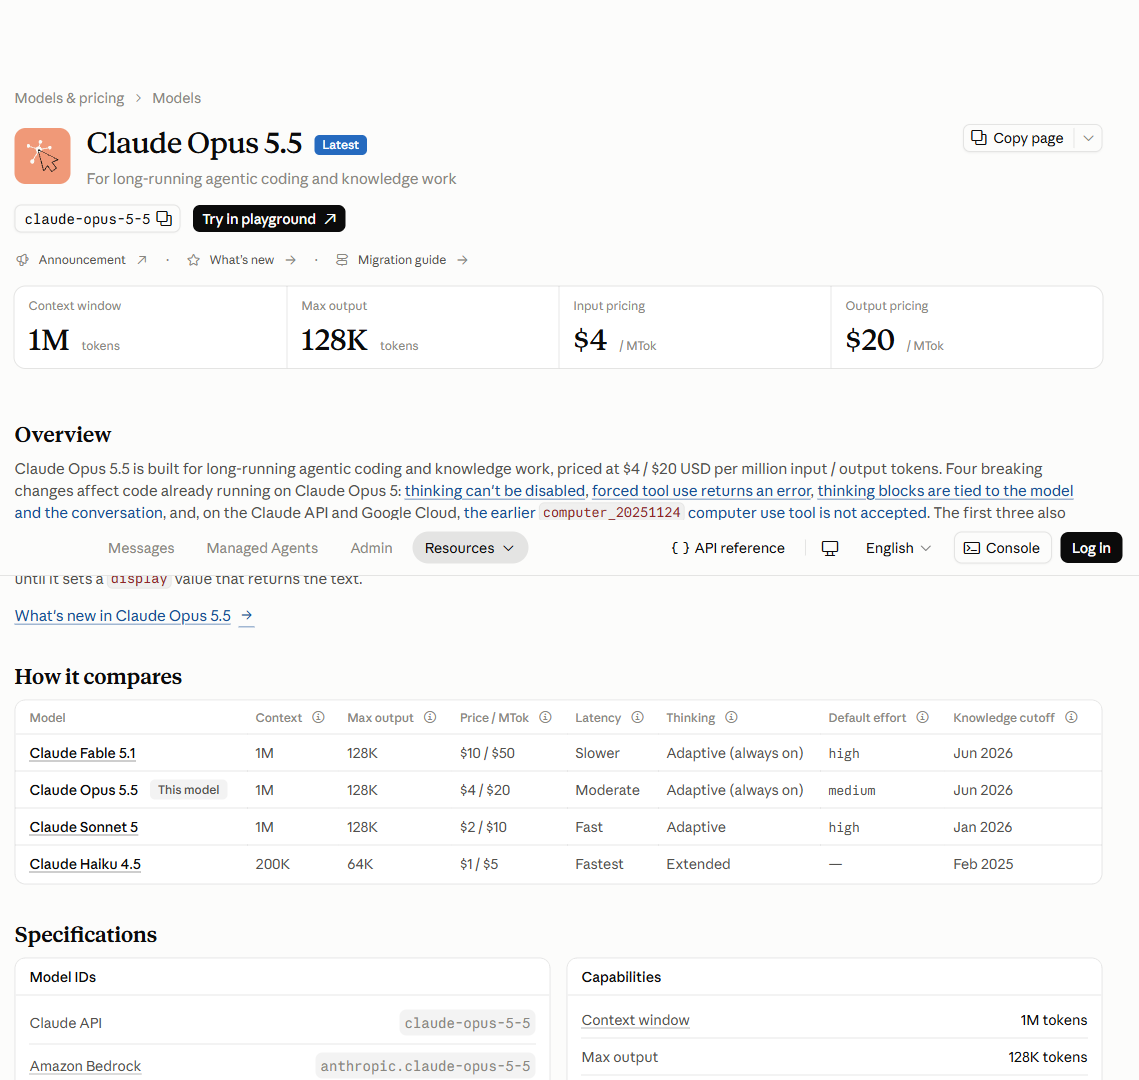
Claude Opus 5.5は、100万トークンのコンテキストウィンドウと、100万トークンあたりのAPI価格が$4/$20という設定を組み合わせたものです。 本レビューでは、Anthropicが公表した主張、独立したベンチマークのスナップショット、およびMessages API経由で行われた5つの直接的なタスク実行結果を分けて検討しています。.
測定結果は具体的です。. 3つのタスクでは、問題のない実用的な回答が得られました。コーディングタスクでは有用な回答が得られましたが、最初の1,024トークンの上限に達してしまいました。中国語の文章生成タスクでは、テストしたルート上で文字化けしたテキストが生成されました。このサンプルは、普遍的な成功率を示すものではなく、具体的な動作やルートの制限を示しています。.
簡単な回答
- パフォーマンス Anthropicは、ほとんどの作業においてFable 5.1レベルのパフォーマンスを示したのに対し、Artificial Analysisは最大限の努力をした際に知能指数58を記録した。METRによる判断能力に関するより限定的な評価結果では、Fable 5.1に比べて大きな改善は見られなかった。.
- 価格: 公式のAPIレートは 入力トークン100万枚あたり$4、出力トークン100万枚あたり$20. キャッシュの読み取りは100万回あたり$0.20のコストがかかります。5分間のキャッシュ書き込みは100万回あたり$5のコストがかかります。.
- 実機テストの結果: 記録された実行結果では、長文抽出、厳密なJSON、および算術推論が合格しました。コーディングは有用でしたが、初期の上限で切り捨てられました。中国語の結果は、モデルレベルの言語判定ではなく、ルート/エンコーディングの問題として記録されています。.
- APIに関する警告: 思考機能を無効にすることはできず、ツールの使用を強制するとエラーが発生し、思考ブロックはモデルや会話に紐付けられており、以前の
computer_20251124このツールは、Claude API および Google Cloud ルートでは使用できません。.

公式ドキュメントにはこう書かれている
Anthropicのリリースページでは、Claude Opus 5.5の発売日を2026年9月22日としており、これをClaude 5.5ファミリーの最初のモデルであると説明しています。 この発表によると、ほとんどの作業において Claude Fable 5.1 と同等のパフォーマンスを発揮し、Opus 5 よりも標準的なワークロードコストが 40% 低く、出力速度は Opus 5 より 30% 以上速いとしています。 これらはベンダー側の主張であるため、以下の独立した検証結果や実機テストの結果とは区別して記載しています。.
について Claude プラットフォームのドキュメント APIモデルIDを次のように記載してください。 クロード・作品第5番第5曲, 、100万トークンのコンテキストウィンドウ、最大128Kの出力、そして常に有効な適応型思考機能。ドキュメントには、既存のOpus 5統合に影響を与える変更点も記載されており、これについては以下の移行に関するセクションで説明しています。.
実績の証拠
ここには、単一の「パフォーマンス」数値というものは存在しません。3つの公開情報源はそれぞれ異なる項目を測定しているため、各カードでは、その測定基準と検証範囲が明確に示されています。.
Anthropicに関するお知らせ
公開された信号: Anthropicによると、Opus 5.5はほとんどの作業においてClaude Fable 5.1と同等のパフォーマンスを発揮し、一般的なワークロードではOpus 5よりも40%安く、出力の生成速度も30%以上速いとのことです。.
境界: プロバイダーが公開した位置付けおよびテスターの事例であり、独立したベンチマークではありません。.
人工分析
公開された信号: 最大努力によるスナップショットの結果は、Terminal-Bench 4.0で59.6%、Humanity’s Last Examで61.4%、SciCodeで66.9%を記録した。.
境界: スコアは、努力度、活用度、日付、および指標の定義によって異なります。これらは、すべてのAPIプロンプトを予測するものではありません。.
METR導入前評価
公開された信号: METR社によると、同社が提示した証拠では、調査対象とした判断能力に関してFable 5.1に比べて大幅な改善は見られなかったものの、一部の研究開発業務においては有意義な効率化が期待できるという。.
境界: これは、判断力とタスクの迅速化についてより限定的な評価であり、包括的な品質ランキングではありません。.
これらのカードを総合的に見ると、限定的ではあるが次のような結論が導き出される。Opus 5.5は、いくつかの過去の公開評価においてトップクラスのモデルであるが、その優位性の程度は、課題、難易度設定、および評価の設計によって異なる。これらのカードからは、普遍的な「最良のモデル」という結果は導き出されない。.
Claude Opus 5.5 価格および課金単位
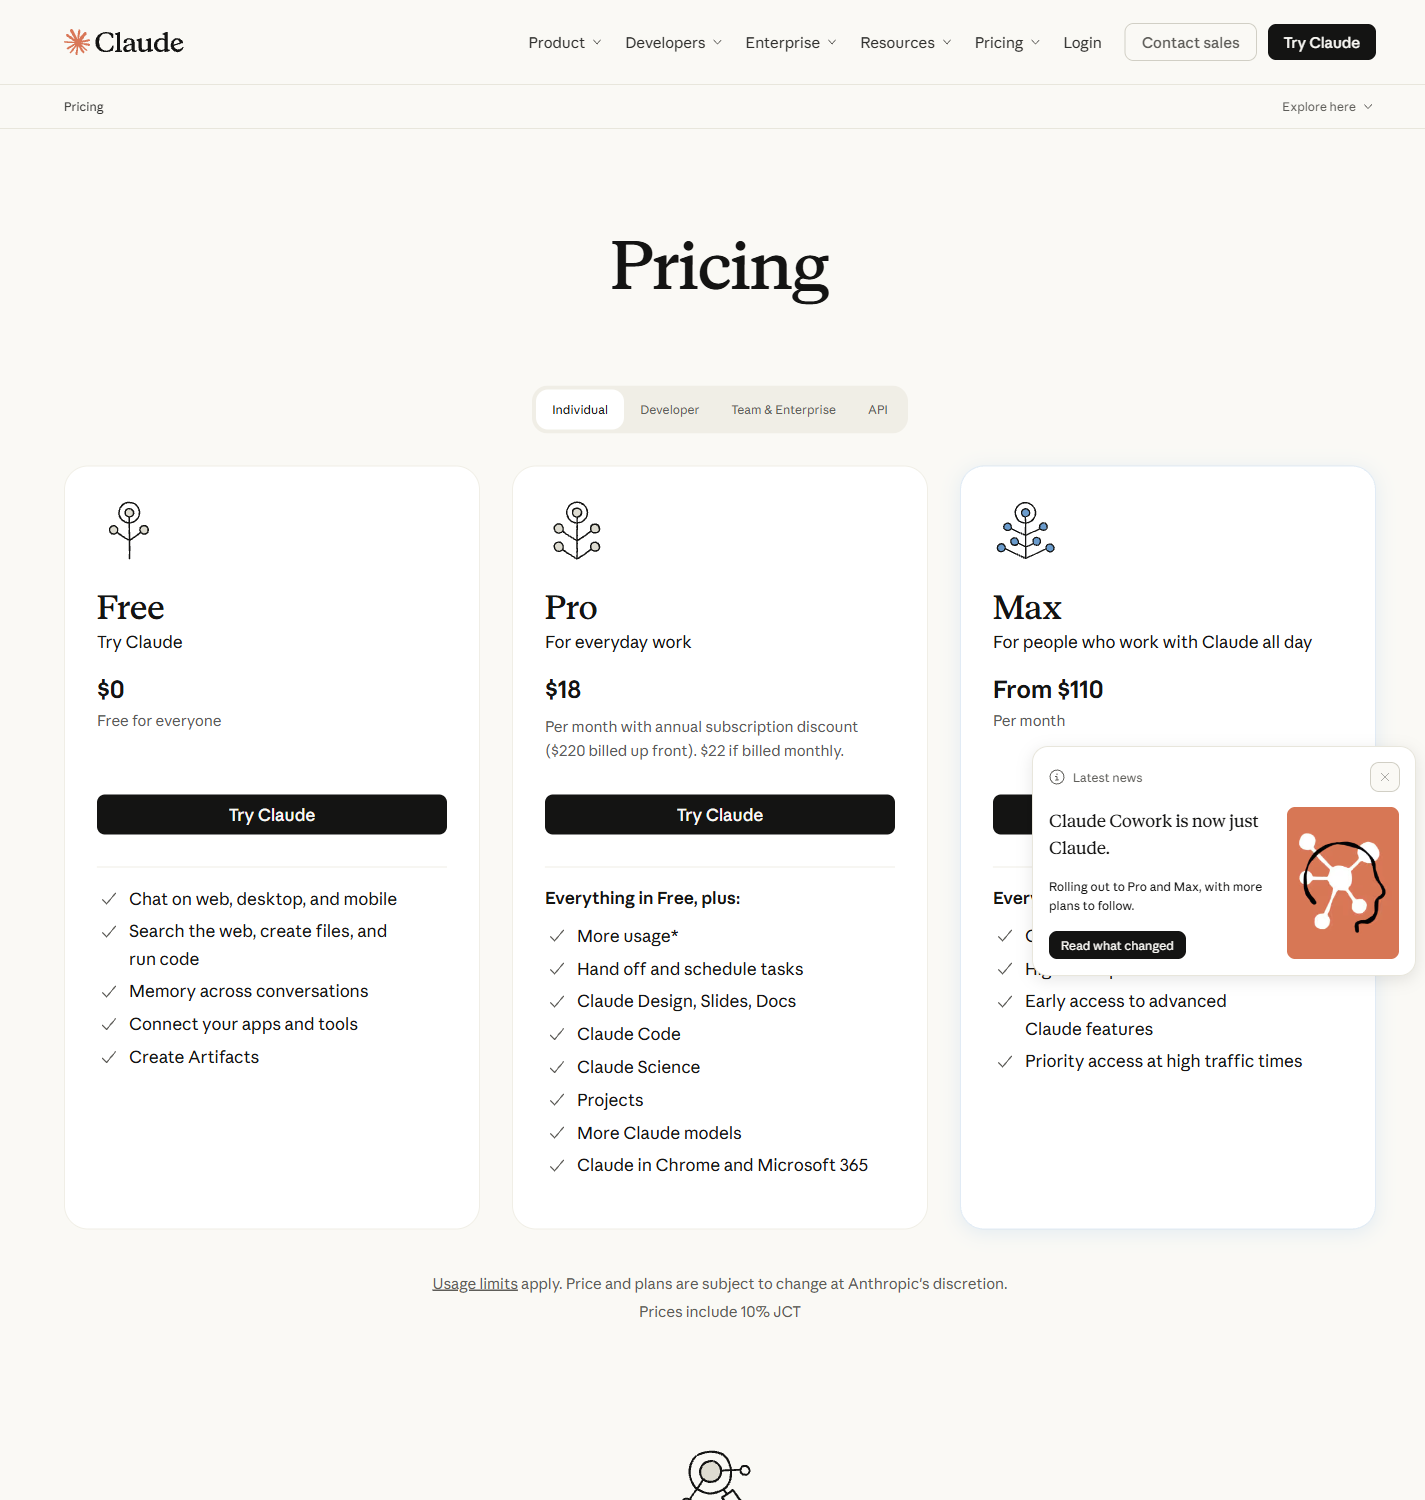
API価格とコンシューマー向けサブスクリプション価格は、それぞれ異なる商品です。以下のAPIの数値は、トークンの予算策定に使用される単価であり、コンシューマー向けの数値は、キャプチャされたブラウザ領域に表示されているプランカードの情報です。.
公式API価格
大まかな見積もり:入力トークン10,000に出力トークン2,000を加えると、キャッシュ、バッチ処理、税金、プラットフォームの手数料などを考慮する前の標準レートで、約$0.08となります。.
コンシューマープランのスクリーンショット
キャプチャされたページには、10%のJCTノートも表示されています。これらは地域によって異なる表示値であり、全地域共通の価格保証ではありません。.
トークン課金およびコンテキストウィンドウコストに関する詳細な説明については、 GPT-5.5の価格設定と背景に関するガイド. プロバイダーのAPI利用料、サブスクリプション料金、およびマルチモデルプラットフォームのクレジット残高は、予算内でそれぞれ別々に管理する必要があります。.
実機テスト:5つのタスク結果カード
2026年9月23日、モデルIDを使用して、同じ制御されたMessages APIルートを通じて5つの独立したプロンプトを送信しました。 クロード・作品第5番第5曲. 最初のパスでは、 max_tokens: 1024. 。各タスクの所要時間、入出力トークン数、停止理由、正答率、およびリテラル形式への準拠状況を記録した。中国語の記述タスクについては、最初の実行でルートの出力問題が判明したため、トークン数の上限を4,096に設定して再実行した。これは5つのタスクからなるサンプルであり、信頼性の推定値ではない。.
混合型の重複排除機能を修復することはできますか?
タスクの設定
Pythonのコードにあるバグを見つけなさい 重複排除 関数を実装し、文字列以外の値やハッシュ化できない値を処理し、最初のスペルを保持し、テストを用意する。.
その回答では、以下の点が指摘された。 .lower() 文字列以外の値では失敗したため、文字列を casefold(), 、ハッシュ化できない場合のフォールバックを追加し、修正したコードとテストケースを返しました。.
回答は1,024トークンの上限で途切れてしまいました。この修正は役に立ちましたが、設定が小さすぎてコードの全面的なレビューには不十分でした。.
カードの評価: 技術的には有用な回答が返されました。ただし、トークンの上限によって回答が切り捨てられたため、この実行ではレイテンシや完全性に関する主張を裏付けることはできません。.
事実や試験の限界を正確に記録・保存できるでしょうか?
タスクの設定
短い評価メモから、5つの番号付き調査結果を抜き出してください。その際、調査方法や、次の調査で測定されなかった事項も含めるようにしてください。.
番号付きの箇条書きがちょうど5つ返ってきました。アシスタントによる比較、20の質問法、そして長期記憶や顧客転換率に関する空白部分はそのまま維持されていました。.
これは短いソースパックだったため、1Mのコンテキストウィンドウはテストされていません。.
カードの評価: 指定された件数を維持しつつ、ソースメモの証拠範囲を保持したクリーンな抽出。.
クリーンアップを行わずに、機械可読な出力を返すことはできますか?
タスクの設定
タイトル、対象読者、2つの長所、2つの短所、および結論を含む、固定形式のJSONオブジェクトを返してください。Markdownのフェンスは使用できませんでした。.
リクエストされたキーを含む解析可能なJSONが返され、長所2つ、短所2つ、そして簡潔な推奨事項が記載されていました。Markdownラッパーは含まれていませんでした。.
1つの有効な応答があったからといって、より大規模なオブジェクトやネストされたオブジェクト全体にわたってスキーマの信頼性が証明されるわけではありません。.
カードの評価: 今回の実行では、リテラルJSONの準拠性チェックに合格しました。.
繰り返し丸めルールを正しく適用できるでしょうか?
タスクの設定
12個から始め、次のバッチごとに1.25を掛け、各バッチ終了後に切り捨て、4バッチ分の合計を報告してください。.
12、15、18、22が返され、それらを合計して 67. 中間の計算過程が確認できた。.
この課題は決定論的かつ小規模であり、広範な推論能力を表すものではありません。.
カードの評価: 正しい結果と、透明性のある中間手順。.
テストしたルートから、利用可能な中国語のテキストが返されましたか?
タスクの設定
公式な主張、価格、ベンチマーク結果、および実機テストを明確に区別した、中国語のレビューの冒頭部分を草案として作成してください。.
レスポンスの構造は存在していましたが、保存された結果では、テストした経路を通じて返された漢字が文字化けしていました。.
この証拠では、モデル言語の品質と経路やエンコーディングの挙動を区別していません。中国語の品質スコアは割り当てられていません。.
カードの評価: このルートで返されたテキストは使用できません。言語の品質について言及する前に、UTF-8が確認済みのパスを使用して再実行してください。.
4つの言語非依存または英語の実行全体において、ローカル平均は6.24秒でした。この数値は、1つのルートにおける5つの連続したリクエストを表すものであり、プロバイダー側のレイテンシではありません。 観察された最も顕著な挙動は、簡潔な抽出、JSONリテラルへの厳密な準拠、および正しい算術演算であった。未解決の課題は、コーディングにおける出力予算の制約と、テストルートにおける中国語出力の文字化けの2点であった。.
APIおよび移行に関する注意事項
これらを簡潔に挙げると、モデルの生成テキストの品質が良好に見えても、統合結果に影響を与える可能性があるからです。.
- 思考は常に続いている。. ドキュメントに記載されている「effort」パラメータを使用して、処理深度、レイテンシ、およびコストを制御してください。この機能を無効にするスイッチはありません。.
- ツールの強制使用によりエラーが発生します。. ツールの強制選択を必要とする既存のコードについては、別途移行テストを行う必要があります。.
- 思考のブロックは、モデルや会話と密接に関連しています。. モデルを変更した後でも、思考ブロックを再利用できるとは限らない。.
computer_20251124受け入れられません ドキュメントに記載されている Claude API および Google Cloud の手順について。.- 生産量の上限は重要だ。. コーディングカードには、ほんのわずかな要因によって、有用な反応が妨げられることがあることが示されています。
max_tokens値。. - バッチモードと高速モードは、それぞれ別の課金体系となっています。. 割引や追加料金は、標準のトークン価格とは別々に設定してください。.
証拠に基づく判決
Claude Opus 5.5には、確固たる過去の公開ベンチマークデータがあり、Anthropicの発表で示されたOpus 5の数値よりも低い標準APIレートが公表されています。 記録された5つのタスク実行において、同モデルはクリーンな抽出、厳密なJSON、および算術演算を生成した。コーディングの回答は有用であったが、初期の制限値によって切り詰められていた。また、テストされた経路では、中国語の出力は使用できなかった。.
したがって、妥当な結論は限定的なものとなる。このモデルは、いくつかの小規模なタスクにおいて指示への高い順応性を示したが、ルートや構成には明らかな限界が見られた。移行を決定する際には、適切な出力予算を設定して同じプロンプトを繰り返し実行し、ツール呼び出しを確認するとともに、公式のトークンレートをサブスクリプションやプラットフォームのクレジットとは区別して管理すべきである。.
比較のための別のルートをお探しの場合は、 DeepSeek V4 Pro 対 Flash テスト形式 タスクレベルの判定が、モデル全体の主張とは切り離されたまま維持される仕組みを示しています。この GPT-5.5 ユースケースガイド タスク志向の基準点を追加する一方で、 Gemini フラッシュベンチマークに関する注意事項 そして AIモデル比較ガイド 近傍モデルのコンテキストを提供します。マルチモデルへのアクセスについては、以下を参照してください。 オールインワンAIサブスクリプション そして マルチモデル・プラットフォームの比較.
よくある質問
Claude Opus 5.5の価格はいくらですか?
公式のAPIレートは、入力トークン100万トークンあたり$4、出力トークン100万トークンあたり$20です。キャッシュの読み取りはトークン100万トークンあたり$0.20、5分ごとのキャッシュ書き込みはトークン100万トークンあたり$5です。.
「Claude Opus 5.5 コンテキストウィンドウ」とは何ですか?
Claudeプラットフォームのドキュメントには、100万トークンのコンテキストウィンドウと、最大128Kトークンの出力が記載されています。別途ドキュメント化されているベータ版パスでは、メッセージバッチに対して最大300Kトークンの出力がサポートされています。.
Claude Opus 5.5はOpus 5より優れていますか?
Anthropicは、一般的なワークロードコストの低減と出力速度の向上を報告しており、独立した評価でも、いくつかの従来のタスクにおいて優れた結果を示しています。品質向上の程度は、ベンチマーク、労力設定、プロンプト、および処理経路によって異なります。.
思考はオフにできるのでしょうか?
いいえ。現在のモデルのドキュメントによると、適応的思考は常に有効になっています。思考の深さ、レイテンシ、およびコストを制御するには、effortパラメータを使用してください。.
5つのAPIタスクは信頼性を証明できたのでしょうか?
いいえ。カードには具体的な挙動や構成上の制限が示されていますが、5つのタスクだけでは一般的な成功率を見積もることはできません。「コーディングの天井」の問題と「中国ルート」の問題については、別途報告されています。.
このレビューは、中国の品質を証明したのでしょうか?
いいえ。テストしたルートでは中国語のテキストが文字化けして返されたため、UTF-8での再実行による検証が行われるまで、この結果はエンコーディングまたはルートの問題として記録されています。.









