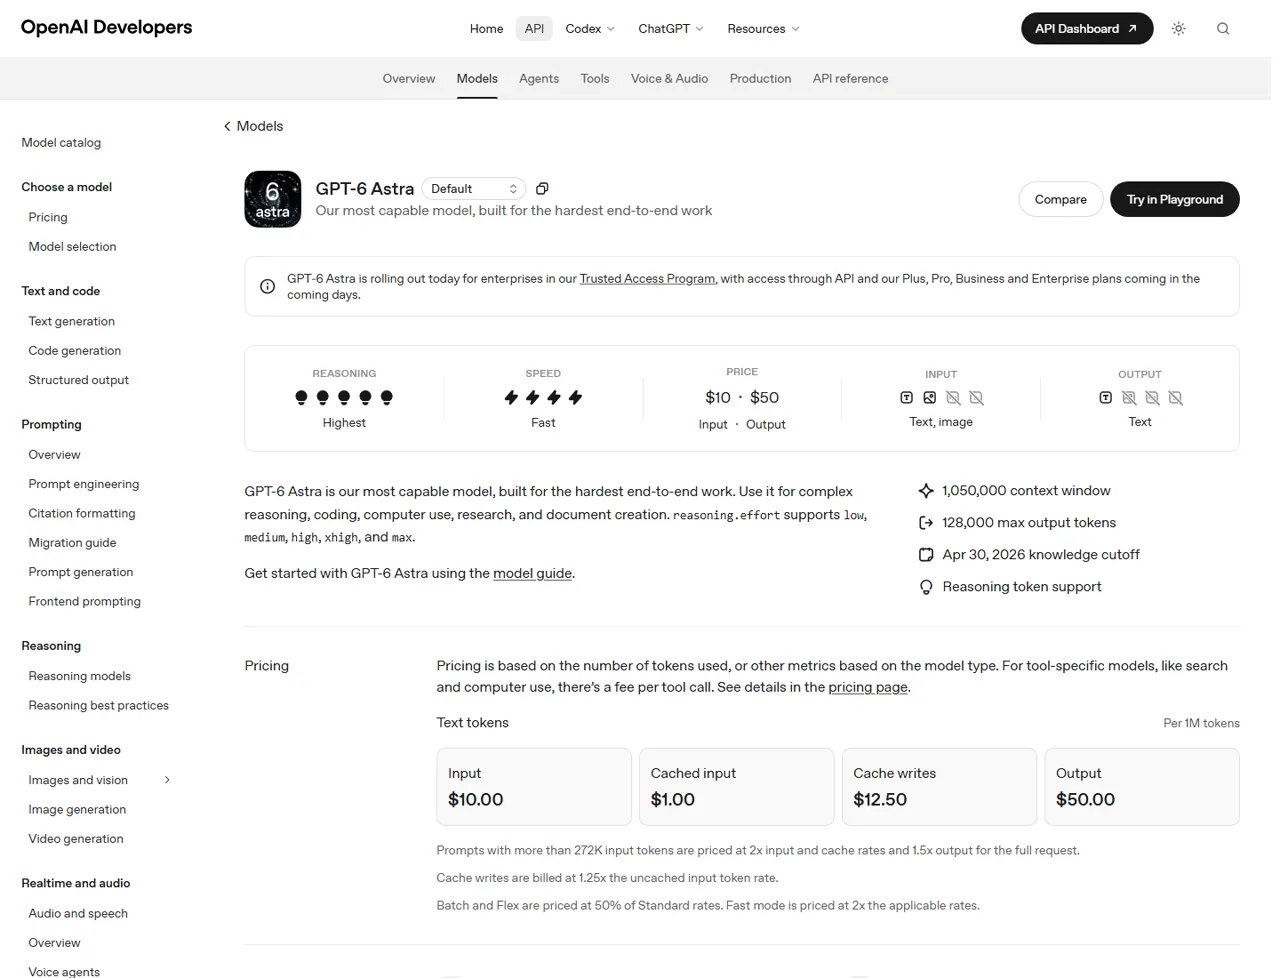
Risposta rapida: Costi di GPT-6 Astra $10 per 1 milione di token in ingresso, $1 per ogni milione di token di input memorizzati nella cache, $12,50 per 1 milione di token di scrittura nella cache, e $50 per ogni 1 milione di token emessi alle tariffe standard, purché la richiesta rimanga entro i 272K token di input. Oltre i 272K, l'intera richiesta passa a una tariffazione a contesto lungo: $20 di input, $2 di input in cache, $25 di scritture in cache e $75 di output per ogni 1 milione di token. OpenAI indica una finestra di contesto di 1,05 milioni di token e un output massimo di 128K.
Questi numeri rendono Astra potente ma anche abbastanza costosa da richiedere una pianificazione accurata. Una richiesta ripetuta può diventare molto più economica quando la cache funziona correttamente, mentre una richiesta che supera di poco i 272K token di input può diventare notevolmente più costosa. Questa guida distingue i prezzi ufficiali dagli esempi calcolati e dalle nostre osservazioni pratiche sull’API effettuate il 5 settembre 2026.
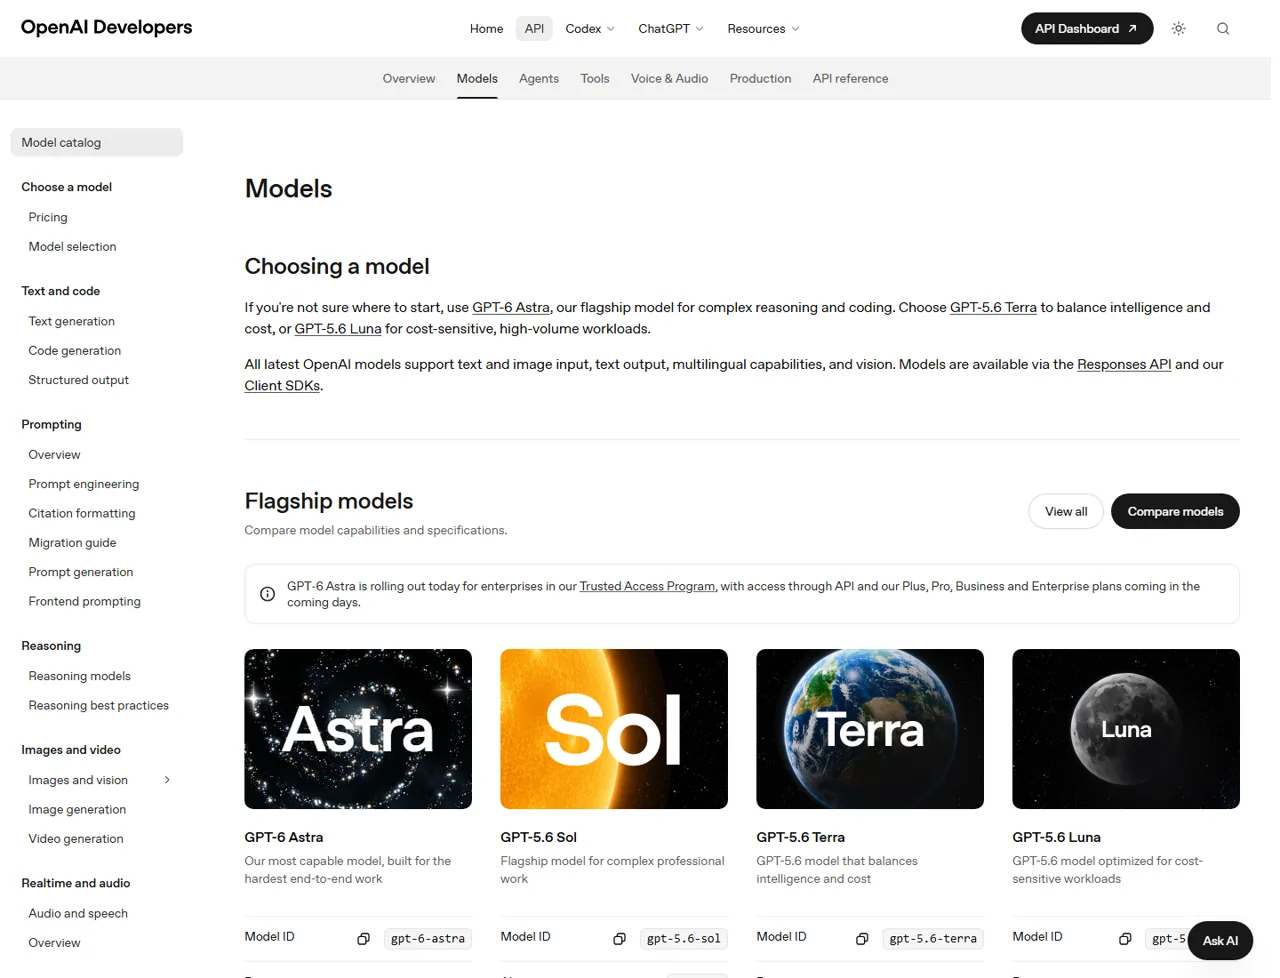

Prezzi dell'API GPT-6 Astra
OpenAI suddivide i prezzi standard in contesti a breve e a lungo termine. La soglia si basa su token di ingresso, non la somma totale di input e output. Il contesto breve copre i prompt con un massimo di 272K token di input; il contesto lungo si applica oltre tale soglia.
Costo per 1 milione di token
La fascia di prezzo più alta si applica all'intera richiesta. I prezzi indicati si intendono per 1 milione di token.
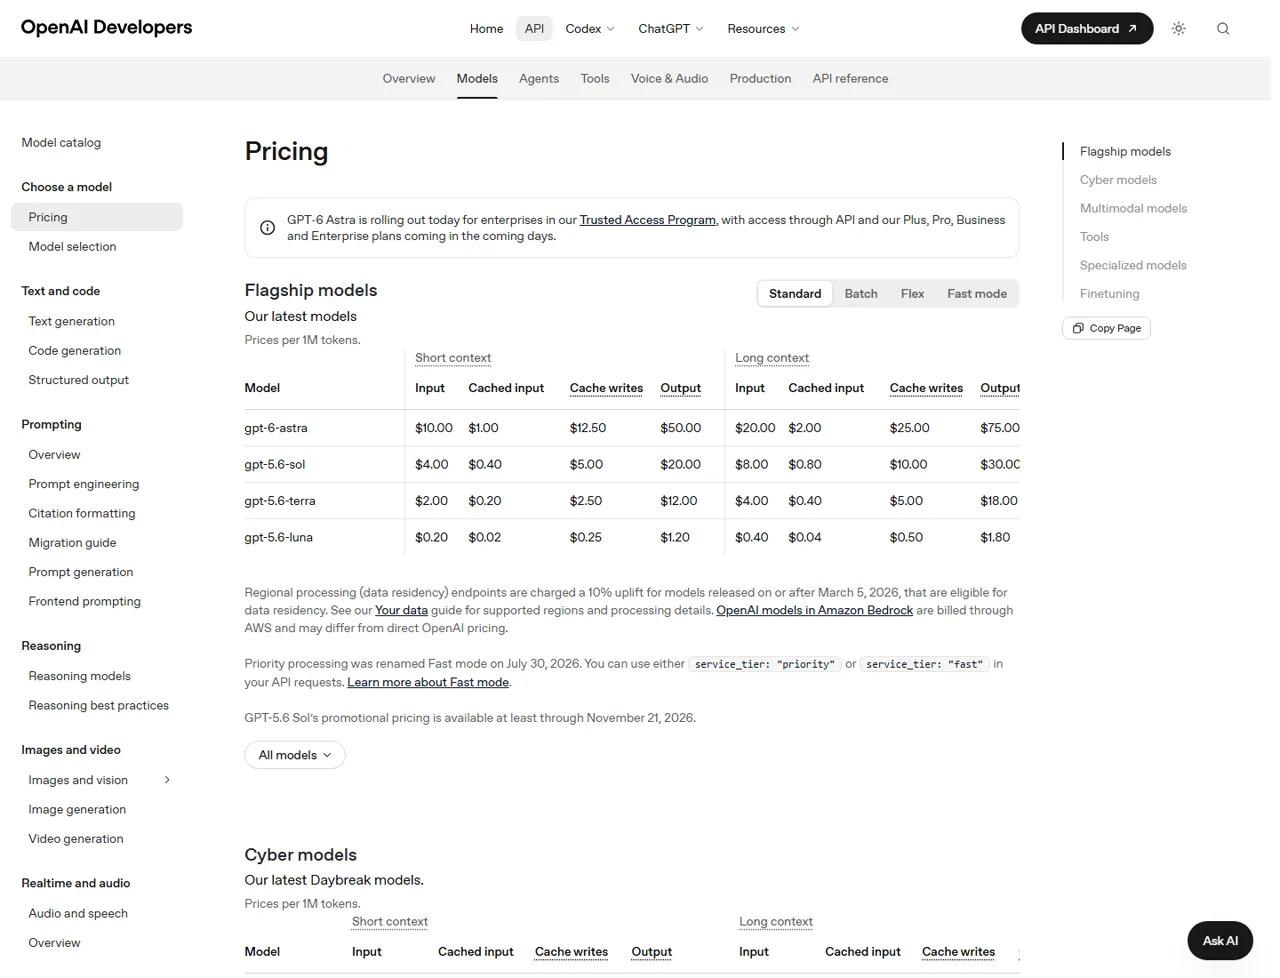
Il dettaglio più importante è che il superamento della soglia dei 272.000 non comporta l'emissione di una fattura con aliquote miste. Secondo Documentazione sui prezzi delle API di OpenAI, le tariffe più elevate si applicano all'intera richiesta quando il volume di dati immessi supera la soglia. I team che mettono a confronto Astra con un precedente modello di punta dovrebbero quindi guardare oltre il prezzo di base indicato; il nostro Guida ai prezzi GPT-5.6 fornisce un contesto utile per quella discussione sul bilancio.
La memorizzazione nella cache dei prompt può ridurre in modo sostanziale i costi legati alla reimmissione dei dati, ma la creazione della cache non è gratuita. Una scrittura nella cache costa 1,25 volte la tariffa applicabile per l’input non memorizzato nella cache. L’elaborazione in batch e Flex costa 50% di Standard, mentre Fast costa il doppio della tariffa applicabile. L’elaborazione regionale idonea aggiunge 10% e Fast non è disponibile per Astra con residenza dei dati nell’UE.
Quanto costa una chiamata all’API di Astra GPT-6?
Per una richiesta Standard, calcolare separatamente ciascuna categoria di token fatturata, quindi sommare i risultati:
Costo totale = costo degli input non memorizzati nella cache + costo degli input memorizzati nella cache + costo della scrittura nella cache + costo degli output.
(0,0125 × $10) + (0,002 × $50)$0.225(0,1 × $10) + (0,005 × $50)$1.25(0,1 × $1) + (0,005 × $50)$0.35(0,3 × $20) + (0,01 × $75)$6.75I preventivi basati sulle tariffe standard non includono gli strumenti, i supplementi regionali e altri servizi fatturati separatamente.
Gli esempi relativi a 100.000 casi dimostrano perché i prefissi riutilizzabili sono importanti: la stima del rapporto modello-token scende da $1,25 a $0,35 quando tutti gli input vengono considerati come memorizzati nella cache. Si tratta di un esempio illustrativo ai fini del prezzo, non di una garanzia che ogni prompt ripetuto produca un accesso alla cache. Per una pianificazione più ampia che coinvolga più modelli, confronta le ipotesi relative al flusso di lavoro nel nostro Guida ai modelli di IA "tutto in uno".
Token GPT-6 Astra, finestra di contesto e limiti di output
Il pagina ufficiale del modello GPT-6 Astra documenta a Finestra contestuale da 1.050.000 gettoni e un Produzione massima di 128.000 token. Il suo limite temporale per le conoscenze è il 30 aprile 2026. Accetta input sotto forma di testo e immagini, restituisce testo e supporta le impostazioni relative allo sforzo di ragionamento basso, medio, alto, xhigh, e max.
Una finestra di contesto ampia è una capacità, non una raccomandazione a soddisfare ogni richiesta. Il recupero, la selezione dei documenti, la sintesi e la struttura del prompt possono mantenere l’input al di sotto del limite di 272K. Anche la scelta del modello è importante: gli sviluppatori che si concentrano sulla programmazione possono confrontare i compromessi nel nostro Il miglior modello di AI per la codifica un'analisi, anziché dare per scontato che il modello con la finestra più ampia sia automaticamente quello che meglio si adatta ai dati.
Sei esercizi pratici per testare l'API GPT-6 Astra
Stato dei test: GPT-6 Astra è diventato disponibile tramite l'API di compatibilità Broly Anywhere il 5 settembre 2026. Abbiamo eseguito le sei attività indicate di seguito. Cinque hanno prodotto risultati HTTP 200 utilizzabili; la richiesta relativa al limite di 272K si è conclusa con un errore di trasporto e rimane non verificata.
Istruzioni e risultati osservati
ID modello gpt-6-astra. Ogni risultato corrisponde a un'esecuzione osservata, non a un benchmark ufficiale. Il tempo effettivo include il ritardo del gateway e quello a monte.
Contabilità di base dei token
Il modello ha restituito il risultato previsto dal calcolo teorico. L'utilizzo effettivo dell'API è stato di 54 token in ingresso e 26 in uscita.
Caching del prompt
Entrambe le ricerche erano corrette, ma il prefisso ripetuto ha registrato zero token memorizzati nella cache e zero token scritti nella cache in entrambe le risposte.
Soglia di prezzo di 272K
La richiesta sintetica di grandi dimensioni si è conclusa prima che arrivasse una risposta HTTP. Non è stato restituito alcun oggetto di utilizzo, pertanto la fascia di velocità e il comportamento di fatturazione rimangono non misurati.
Ragionamento "minimo vs massimo"
Entrambe le esecuzioni hanno restituito il risultato $265,20. Max ha impiegato più tempo e ha restituito 88 token di ragionamento; questo singolo compito aritmetico non ha mostrato alcun miglioramento nella qualità della risposta.
Parametro di uscita a 128K
L'endpoint di compatibilità ha restituito "OK" invece di rifiutare un token in eccesso rispetto al limite massimo ufficiale. Si tratta di un comportamento tipico del gateway, non di una prova che la finestra di output supportata sia più ampia.
Tariffe e livelli di servizio
Le risposte normali non contenevano intestazioni "remaining-request" o "remaining-token". Sia le richieste Flex che quelle di priorità hanno avuto esito positivo, ma hanno restituito "service_tier: default".
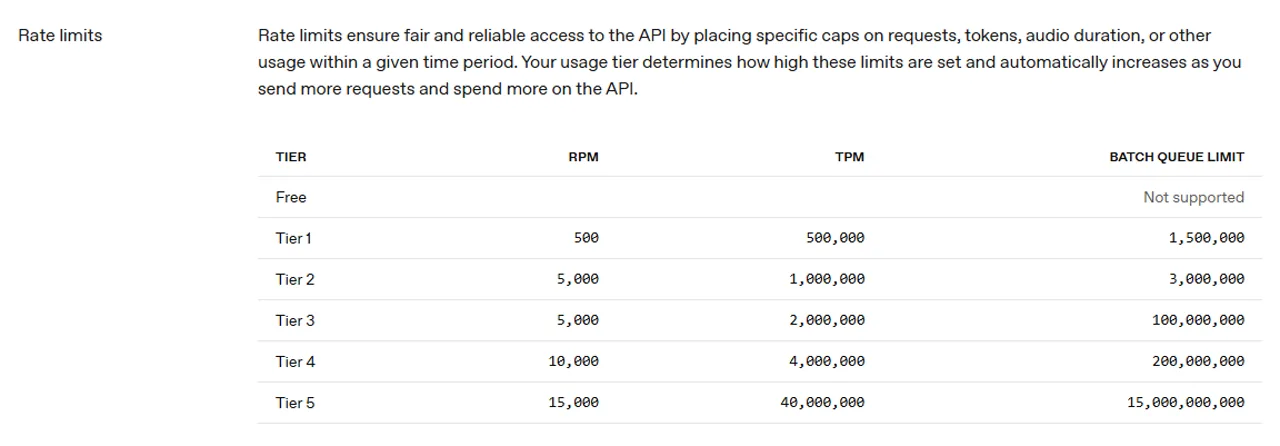
Limiti di velocità dell'API GPT-6 Astra
GPT-6 Astra non è supportato nel piano gratuito. I limiti pubblicati aumentano in base al livello di utilizzo, ma le intestazioni dei progetti attivi rimangono la fonte più attendibile per conoscere la capacità residua e i tempi di ripristino.
La capacità registra un forte aumento al Livello 5
L'altezza del bar è indicativa. I valori esatti di RPM, TPM e coda dei lotti sopra indicati sono determinanti.
Le opzioni "Batch" o "Flex" possono dimezzare le tariffe relative ai token dei modelli quando non sono necessarie risposte immediate. L’opzione "Fast" può essere adatta a attività sensibili alla latenza, ma raddoppia il prezzo applicabile e non è disponibile con la residenza dei dati nell’UE per Astra. Prima di impegnare un carico di lavoro in produzione, confronta il costo del modello con le spese correlate alla piattaforma; il nostro Guida ai prezzi del Codex illustra perché gli abbonamenti ai prodotti e la fatturazione tramite API non dovrebbero essere combinati tra loro.
Cosa stanno rivelando le prime recensioni
Il creatore indipendente Matt Wolfe ha pubblicato un primo video di anteprima che illustra la programmazione, l'uso del computer e alcune dimostrazioni relative a Blender e Unreal Engine. Questi esempi sono utili per comprendere i tipi di flussi di lavoro che i recensori stanno esplorando, ma non costituiscono prove di benchmark controllate e non sostituiscono i test API sopra citati. Confronti più ampi come ChatGPT vs Claude vs Gemini dovrebbe essere intesa come una guida specifica per determinati carichi di lavoro, non come una classifica universale.
A chi è destinato GPT-6 Astra?
Astra è una soluzione plausibile per attività di codifica complesse, flussi di lavoro basati su agenti, analisi di documenti di grandi dimensioni e attività multimodali in cui un ragionamento più approfondito o una finestra contestuale molto ampia possono compensare un costo elevato per token. I team dovrebbero testarla su un’attività circoscritta e misurabile e confrontare la qualità in termini di rapporto qualità-prezzo, non limitandosi a valutare la qualità del risultato finale. Il nostro Panoramica dei migliori modelli di IA offre un quadro di selezione più ampio.
- Utilizza Astra quando: il compito è complesso, gli errori comportano costi elevati, è necessario un contesto ampio oppure il modello può sostituire diversi passaggi meno efficaci.
- Utilizza un modello più economico quando: il lavoro consiste in attività di routine quali classificazione, estrazione, riscrittura o generazione di grandi volumi di dati, con requisiti di qualità semplici.
- Ottimizzare innanzitutto quando: i prompt superano ripetutamente i 272K, è possibile memorizzare nella cache prefissi statici di grandi dimensioni oppure la latenza non richiede l'elaborazione in modalità Standard o Fast.
Per i lettori che stanno valutando diverse opzioni premium simili, il Confronto tra GPT-5.6, Fable 5 e GPT-5.5 offre un’altra prospettiva in termini di costi, funzionalità e adeguatezza al carico di lavoro. GlobalGPT dispone di un Pagina di destinazione di GPT-6 Astra. I dati relativi alle nostre API sono stati registrati separatamente tramite l'endpoint di compatibilità di Broly Anywhere.
Domande frequenti
Qual è il prezzo dell'API GPT-6 Astra?
Il prezzo standard per contesti brevi è di $10/M in ingresso, $1/M in ingresso in cache, $12,50/M in scrittura in cache e $50/M in uscita. Oltre i 272K token in ingresso, la richiesta completa utilizza $20/M in ingresso, $2/M in ingresso nella cache, $25/M di scritture nella cache e $75/M in uscita.
Cosa succede quando un prompt supera i 272.000 token di input?
OpenAI sposta l'intera richiesta nella fascia a contesto lungo. Non si tratta di una formula mista in cui solo i token superiori a 272K costano di più.
Qual è la finestra di contesto di GPT-6 Astra?
OpenAI prevede una finestra di contesto di 1.050.000 token, un input massimo di 922.000 token e un output massimo di 128.000 token. Anche i token di ragionamento occupano spazio nel contesto e vengono conteggiati come output.
GPT-6 Astra supporta l'inserimento di immagini?
Sì. La documentazione del modello indica come input testo e immagini e come output testo. L'audio e il video non figurano tra le modalità di input di questo modello.
Questi esempi di costi sono fatture ufficiali?
No. Si tratta di esempi aritmetici basati sulle tariffe documentate. La fattura può inoltre includere la contabilizzazione dei token memorizzati nella cache, la modalità di elaborazione, l’elaborazione regionale e altri servizi fatturati separatamente.
Quali modalità di elaborazione sono disponibili?
I prezzi documentati di Astra sono Standard, Batch, Flex, Fast e Ultrafast. Batch e Flex costano la metà rispetto a Standard, Fast costa il doppio rispetto a Standard e Ultrafast costa sei volte rispetto a Standard nella stessa fascia di contesto. L’elaborazione regionale idonea aggiunge 10%; la disponibilità dipende dalla modalità e dall’endpoint.
Come viene fatturato GPT-6 Astra tramite GlobalGPT?
L'API di GlobalGPT indica 23 crediti per ogni 1.000 token in ingresso e 117 crediti per ogni 1.000 token in uscita per GPT-6 Astra. I token di ragionamento vengono fatturati come output. Queste sono le tariffe in crediti di GlobalGPT; l'utilizzo dell'API OpenAI segue un proprio sistema di prezzi in USD.
Verdetto finale
GPT-6 Astra combina una finestra di contesto da 1,05 milioni di token e un output massimo di 128K con una tariffa premium. La sua tariffa Standard per contesti brevi parte da $10 per 1 milione di token in ingresso e da $50 per 1 milione di token in uscita, ma il limite di 272.000, i token di ragionamento, le scritture nella cache, la modalità di elaborazione e il sovrapprezzo regionale possono modificare in modo sostanziale il costo finale. Stimate il numero di token prima di inviare prompt di grandi dimensioni, verificate la cache in base ai dati di utilizzo e valutate Astra in base al valore dell’attività completata piuttosto che al solo prezzo di listino.